「高并发实测」系列第 4 篇。
环境:Spring AI + 内存向量库(SimpleVectorStore),语料是我自己几份项目文档按空行粗切成 chunk,embedding 走百炼;评测用 Java 复刻的 RAGAS 四指标(LLM-as-judge,5 题 gold 集,temperature=0)。排序质量另用
/evalrank数答案块在候选池里的首现排名------这一项是确定性计算,不经过模型裁判。一句话结论 :
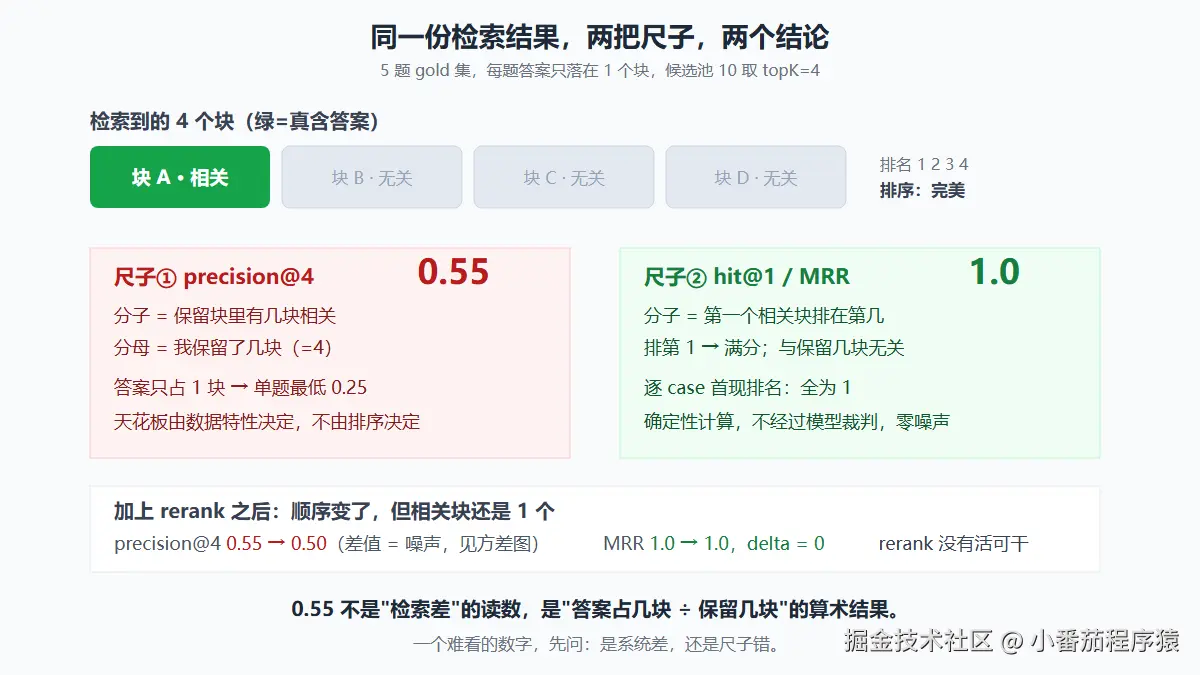
context-precision@4 = 0.55这个难看的数字,测的不是"检索好不好",而是"我的数据里答案占了几块"。换成 hit@1 / MRR 一测,纯向量排序早就满分(1.0),rerank 一点提升空间都没有。 我差点花钱去优化一个根本没坏的东西。而这篇文章真正想写的,是后面两层:我纠正了第一次"尺子错"之后,又犯了第二次------而且是在我自己定的判据上犯的。
〇、一分钟带走版
同一套 RAG,五种测法,五个结论:
| 我用的尺子 | 读数 | 它到底在测什么 |
|---|---|---|
/eval 关键词命中 |
5/6 = 83% | 召回对不对,粗 |
RAGAS context-precision@4 |
0.55 | 不是排序质量------是"答案块数 ÷ 保留块数" |
RAGAS answer-relevancy |
0.76 至 0.87 | 答案切题度,LLM 裁判,有噪声 |
hit@1 / mrr_vector |
1.0 / 1.0 | 排序质量,确定性计算,零噪声 |
mrr_rerank − mrr_vector |
0 | rerank 的净贡献 |
三层反转,一层比一层难看:
- 第一次反转 :precision 0.55 难看 → 上 rerank → 变成 0.50,更差了 → 我准备继续加钱换更好的 rerank。但我先去数了一下排名:
hit@1 = 1.0,5 道题答案块全部排第 1,delta_mrr = 0。 排序早就满分------0.55 不是检索差,是"答案只在 1 块、我却保留 4 块"的必然结果。我差点优化一个没坏的东西。 - 第二次反转 :为了确认 0.55→0.50 是不是真变差,我用
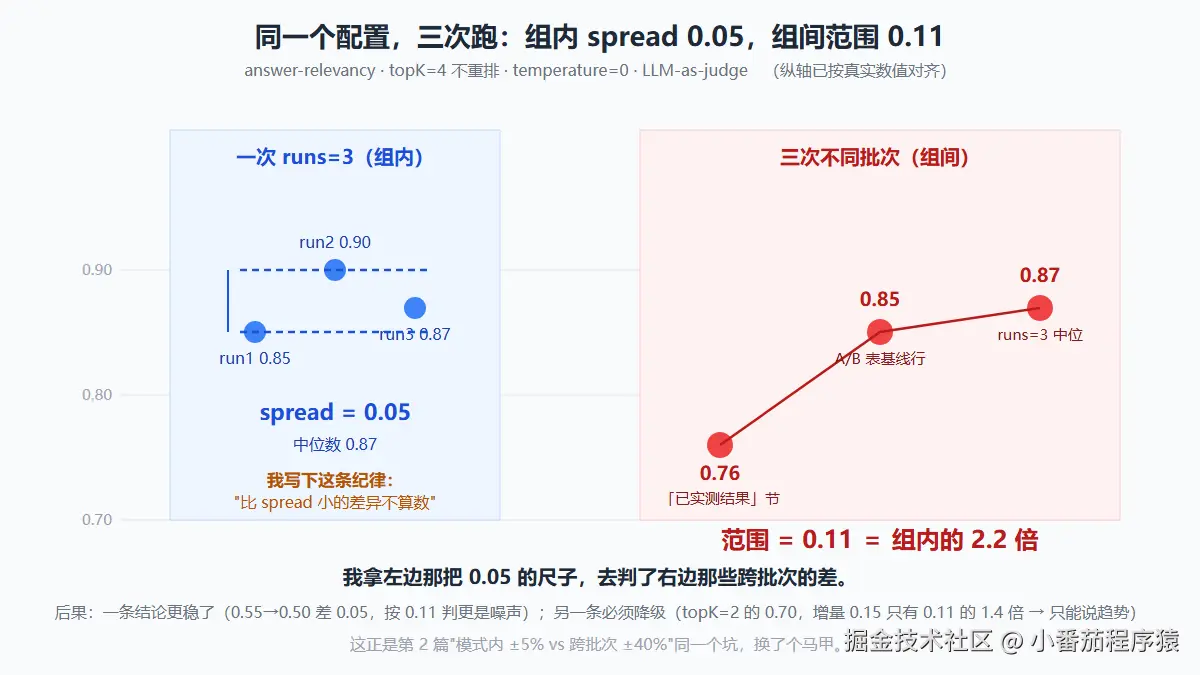
runs=3取中位数,发现 temp=0 仍有 ±0.05 抖动 ,0.05 的差值正好等于噪声 → "rerank 让 precision 下降"这个结论作废,它根本没动。 - 第三次反转(这篇最该看的一段) :我拿"比 spread 小的差异不算数"这条自己定的纪律去判第三组数据时,翻出同一配置三次跑的
answer-relevancy是 0.76 / 0.85 / 0.87 ------跨批次范围 0.11,是我声明的组内 spread 0.05 的 2.2 倍。我用组内方差,去判了组间差异。 而"紧 topK=2 让 precision 升到 0.70"这个我写进结论的东西,增量 0.15 只有组间范围的 1.4 倍------它撑不起"真变化"四个字,只能算趋势。
判断准则(这篇唯一想让你带走的东西):
一个难看的数字,先问"是系统差,还是尺子错"。而判"是不是噪声",要用同一批次的方差------组内 spread 管不了跨批次比较。
全文关键词:RAG 评测、RAGAS、precision@k、MRR、hit@1、rerank、LLM-as-judge、指标噪声、组内方差与组间方差。
一、场景:一个 83% 让我觉得挺不错
先说清楚我做了什么。语料是我自己几份项目文档,按空行粗切成 chunk,塞进内存向量库;用户提问走向量检索,命中的块拼进提示词,模型再作答,答案句末带 (资料N) 引用,接口同时返回来源和相似度。
第一版评测很朴素:手写 6 道只有语料里才有答案的题,看 Top-3 检索结果里有没有含正确那段。
先说清题量,因为后面还会冒出另一个数:这一节的
/eval是 6 题;第二节 RAGAS 四指标的/evalrag是另一套 5 题 gold 集;第六节的 Agent 链路评测又是 6 题。三套题集互不相同,别把它们当一个。
结果 6 题命中 5,召回准确率 83%。 唯一 miss 的那题是"数据风暴怎么修复"------Top-3 里没含到讲"错峰"的那段。
我当时的心态是:83%,还行啊,剩下那 17% 是 chunk 粒度的历史遗留问题,回头再收拾。
然后我去上了 RAGAS 四指标。
二、第一次反转:一个难看的数字,差点让我白花一笔钱
Java 复刻的四个指标(LLM-as-judge,5 题 gold 集,每题各跑一次裁判):
| 指标 | 读数 | 含义 |
|---|---|---|
| faithfulness(答案是否忠于检索到的内容) | 1.0 | 没瞎编 |
| context-recall(该召回的召回全没有) | 1.0 | 覆盖没问题 |
| answer-relevancy(答案切不切题) | 0.85 | 基本切题,有一条啰嗦 |
| context-precision@4(检索到的块里有多少真相关) | 0.55 | 🔴 难看 |
三个 1.0 配一个 0.55,那还说什么,当然是检索精度有问题。
于是按标准药方上 rerank:候选池放大到 10,用 LLM 做 listwise 重排,再截 topK=4。同池子、只变选择方式,A/B:
| 配置 | faithfulness | recall | relevancy | precision@4 |
|---|---|---|---|---|
| topK=4 不重排(基线) | 1.0 | 1.0 | 0.76 | 0.55 |
| topK=4 + rerank | 1.0 | 1.0 | 0.85 | 0.50 |
| topK=2 + rerank | 1.0 | 1.0 | 0.88 | 0.70 |
重排之后 precision 从 0.55 掉到 0.50。 我当时的第一反应是"这个 rerank 模型不行",第二反应是换一个专用的 ------README 里那一行 或换 qwen3.7-text-rerank 专用 API 就是这么写下来的,那是一笔已经准备花出去的钱。
幸好我在花钱之前,先数了一次排名。
我另开了一个 /evalrank 端点,不看模型判断,只看答案块在候选池里的首现排名:
| 指标 | 值 |
|---|---|
hit@1_vector |
1.0 |
mrr_vector |
1.0 |
mrr_rerank |
1.0 |
delta_mrr |
0 |
逐 case vectorFirstRelevantRank |
全为 1 |
纯向量已经把每道题的答案块排在了第 1 位。满分。没有提升空间。
那 0.55 是什么? 它测的根本不是"排得好不好"。我的数据里每道题的答案只落在 1 个块,而我保留了 4 个块 ------precision@k 的分母是"保留了几块",这个结构本身就把它压死了 。其中跨主题的那两道题只有 0.25。
换句话说:0.55 是我数据特性的算术结果,不是系统质量的读数。 rerank 改变的是顺序,不改变"相关块的数量",所以它对 precision@4 几乎无解------它没变差,它压根就没法变好。
我差点花钱买一个工具,去优化一个已经满分的环节。
三、机制:precision@k 和 MRR 到底谁在测排序
这段值得单独讲,因为这是八股里不会写、但一踩就是几周工期的东西。
| precision@k | hit@1 / MRR | |
|---|---|---|
| 分子 | 检索到的块里"相关"的数量 | 第一个相关块的排名 |
| 隐含假设 | 答案分散在多个块里 | 答案至少有一块,越靠前越好 |
| 答案只在 1 块、保留 k 块时 | 天花板被 k 压死 | 满分可得 |
| 我这个场景 | 完全不适用 | 适用 |
所以判断规则不是"哪个指标更权威",而是"我的答案在语料里到底占几块":
- 答案天然分散在多块(长文档问答、跨段综合)→ precision@k / context-recall 有意义,rerank 有活干;
- 答案就是孤零零一块(配置项、事实题、FAQ)→ 看 hit@1 / MRR,别用 precision@k 误伤自己。
四、第二次反转:0.55 到 0.50 到底是不是"变差了"
上面那张 A/B 表我读成了"rerank 反而让 precision 下降 0.05"。这句话现在得撤回。
因为 LLM-as-judge 即使 temperature=0 也不是确定性的。我给评测加了 runs=N,同一批题跑三轮,输出 median{} + spread{min,max} + perRun[]:
| 指标 | 中位数 | spread |
|---|---|---|
| faithfulness | 1.0 | 0.0(稳) |
| context-recall | 1.0 | 0.0(稳) |
| answer-relevancy | 0.87 | 0.05(抖) |
| context-precision | 0.55 | 0.05(抖) |
temp=0 仍有 ±0.05 的抖动。而 0.55 → 0.50 的差值恰好是 0.05。
纪律:比 spread 小的差异不算数。 所以"rerank 让 precision 变差了"这个结论作废------它没变差,它没动。
顺带这条纪律也解释了为什么 faithfulness=1.0 可以当真(spread 0.0),而 relevancy 只能当趋势。
五、第三次反转:我用组内方差,判了组间差异
这一节是这篇真正想写的东西。
写到这里我以为自己已经会正确使用噪声了。然后我去核对 answer-relevancy 这个数,发现 README 里它出现了三次:
| 出处 | relevancy | 是什么 |
|---|---|---|
| 「已实测结果」节 | 0.85 | 首次单跑 |
| 「Rerank A/B」表基线行 | 0.76 | A/B 时另一次单跑 |
| 「多轮中位数」节 | 0.87 | runs=3 的中位数 |
**三个数来自同一个配置(topK=4、不重排)。**但有一个我必须交代的变量:三次跑之间,我把对话模型从 kimi-k2.7-code 换到了 qwen3.7-flash-2026-07-15(前两次是 kimi,第三次是 qwen3.7-flash)。所以这 0.11 里混着批次噪声和模型差异,分不干净------而这只会让「组间波动比组内大」的结论更稳,不会更松。到这一步都还好------真正的问题是我拿它们去比 spread:
- 我声明的 spread = 0.05 ,那是一次 runs=3 内部的极差(组内方差);
- 而这三次跨批次 跑的实际范围 = 0.87 − 0.76 = 0.11,是组内 spread 的 2.2 倍。
我拿组内方差,去判了组间差异。
这就是第 2 篇那个坑换了个马甲 :那篇文章里我写过"模式内波动 ±5%,跨批次曾 ±40%"------我知道组间方差比组内大,然后在自己新写的判据上重犯了一次。
后果分两头,而且两头不一样:
① 有一条结论反而更稳了。 rerank 让 precision 0.55→0.50,差 0.05。按组内 spread 判是噪声,按组间范围 0.11 判更是噪声。 撤回"变差"这个说法,安全。
② 但另一条必须降级。 紧 topK=2 → precision 0.70,相对基线 0.55 的增量是 0.15,只有组间范围 0.11 的 1.4 倍。 我在 README 里把它写成"才是真变化"------这句话撑不住,只能说趋势。(A/B 那节我自己写的"单次有噪声,趋势清晰"其实是对的,是后来回头把它拔高了。)
③ 而核心结论毫发无损。 hit@1=1.0、mrr=1.0、逐 case 首现排名全为 1------这些是数排名算出来的,不经过任何模型裁判,零噪声。 "precision@4=0.55 是指标假象"这个反转,站在确定性数据上。
这条纪律现在被我改成:
判"是不是噪声",要用同一批次的方差;跨批次比较,要用跨批次方差。两者不是一回事,混用的结果是------你会把噪声读成结论,或者把结论误判成噪声。
六、还有两把尺子,也只有它们能抓到"模型在偷懒"
评测这套东西跑到底,给了我一个纯后端视角想不到的结果。
我把评测加到了完整的 Agent 链路上(关键词硬校验 + LLM 裁判 + 调用轨迹 trajectory ),6 道只能从数据库查到答案的事实题,三个维度一起跑:
| 维度 | 收紧提示词前 | 后 | 测什么 |
|---|---|---|---|
| keyword(终答含不含关键事实) | 100% | 100% | 答案对不对 |
| trajectory(有没有调对工具、参数对不对) | 50-67% | 100% | 过程对不对 |
| judge(LLM 裁判分档) | 83-100% | 83% | 主观质量 |
keyword 满分,trajectory 只有 50-67%。 差在哪?模型有几道题根本没调工具,凭常识直接答了------而且答对了。
这跟本文开头是同一个结构:只测最终答案,测不出"它有没有去查"。 这次它蒙对了,下次它就是编。收紧系统提示为"事实题必须先调工具、禁止凭记忆作答"之后,trajectory 复测 100%。
七、最狠的一次:过不了的是裁判,不是系统
中位数门禁稳定报 judge = 83%(6 题里 1 题持续被判"部分正确" ,3 轮,min 到 max 很窄)。按第四节的纪律,spread 小 = 这是真问题。 我准备去修系统。
提醒一下:这个 83% 和第一节
/eval那个 83% 只是数值巧合(一个是 6 题命中 5,一个是 6 题里 5 题被判满分),两套题、两个系统、两回事。
归因之后发现是裁判自己错了:它拿自己的外部先验否定了数据库里的真值,还要求答案包含这个业务域之外的信息。
改的是评测器的评分规则,不是系统:① 数值以系统数据为准,裁判不得用外部知识否定;② 限定在该业务域内,域外信息不扣分;③ 只在真正矛盾或编造时扣分。
重跑 RUNS=3 → keyword / trajectory / judge 全部 100%,门禁通过。
所以"评测过不了"的正确顺序是:先怀疑量具,再怀疑裁判,最后才怀疑系统。 本文三层反转,讲的就是这三步。
八、如果继续做,我会排这几件事
| 方向 | 为什么 |
|---|---|
| 把 precision@k 从主指标里摘掉,只留 hit@1 / MRR | 我的答案就是单块,这把尺子的天花板由数据特性决定 |
| 跨批次比较一律跑 runs≥3,并单独报组间极差 | 第五节那个 2.2 倍不是巧合,是常态 |
| 切分改成语义/递归切分 + overlap | 那两道 0.25 的题是 chunk 粒度问题,不是排序问题 |
| rerank 只在"大语料 + 答案分散多块"的场景再测 | 现在这个池子里它没有活可干 |
| 接 Langfuse 做数据集版本化 + 每次改动自动回归 | 现在 gold 集和指标是我手抄在 README 里的,会漂 |
复现(命令与代码路径)
- 代码:
D:\ai-agent-project\phase2-rag------RagEvalService.java(RAGAS 四指标 + runs 中位数 + rerank 开关)、/evalrank(hit@1 / MRR / precision@k,纯计算不经裁判);护栏与网关见phase4-agent-ops(ToolGateway/Breaker均为手写,缓存用 Caffeine,其余 ChatClient/VectorStore 为 Spring AI 自带)。 - 四指标(runs=3 取中位数):
bash
curl "http://localhost:8082/api/rag/evalrag?topK=4&retrieve=10&rerank=false&runs=3"- 排序质量(向量序 vs rerank 序):
bash
curl "http://localhost:8082/api/rag/evalrank?pool=10&k=4"- 启动、环境变量、中文传参(UTF-8 文件)等前置步骤见
phase2-rag/README.md。文中每个百分比都能在响应 JSON 里逐项对上。
九、局限(照例先说)
- 5 题 gold 集,语料是我自己的项目文档。 这是个小样本上的机制演示,不是可用的评测基准。 换语料、换题量,0.55 这个数没有可比性。
- 我没有重新推导 RAGAS 的 precision@k 加权公式。 文中只说"答案占几块会压低它"这个方向性结论,具体 0.55 是怎么加权出来的我没有逐题复算------所以别拿这篇去解释 RAGAS 的实现细节。
answer-relevancy报的是区间 0.76 至 0.87,不给点值。 因为那三次跑本身就是不同批次的单跑,我没法说哪个"才是真的"。topK=2 → 0.70降级为趋势 (第五节),这条是本文自己推翻的结论之一,保留在文里而不是删掉。- 第六、七节的 trajectory 与裁判校准,来自另一个阶段的项目(完整 Agent 链路),不是本篇的 RAG 系统。 我只借它的结论说明"尺子"这件事在 Agent 上更严重,两组数字不通用。
- 第五节那三次 relevancy 读取跨了一次模型替换(kimi → qwen3.7-flash)。 严格说不是纯批次对比;但方向不变------跨批次的真实波动只会比 0.11 更大,"用组内 spread 判组间"的错更明显。
- 我自己的实验笔记里有一处题量没对齐 :第六节的评测,一份记录写"5 条事实题"、另一处写"6 题中 1 题"。83% 这个数只能由 5/6 得出,所以本文按 6 题 写,并把它标出来而不是悄悄统一------笔记自己前后不一致,也是这篇要批评的那类问题。
- rerank 用的是 LLM listwise 重排,不是专用 rerank 模型。 所以"rerank 无收益"这个结论的适用范围是这种实现 + 这个池子 + 单块答案,不外推到专用 rerank 模型。
写在最后
这篇如果只能留一句话,我希望是这个:
一个难看的数字,先问"是系统差,还是尺子错"。
我这次运气好,在花钱之前先数了一次排名。但更有意思的是后面两层------我纠正了第一次用错尺子,然后立刻在"怎么判断这是不是噪声"上又用错了一次,而且错的那个判据是我自己写下来、还准备拿去用的。
组内方差和组间方差,这俩词谁都背得出来。我是自己踩了一遍才知道它们差 2.2 倍。
八股可以被背,结论只能被跑出来。这是「高并发实测」系列第四篇。
上一篇:《Agent 工程化实测:p95 从 836ms 降到 12ms,而真正的收获是发现瓶颈根本不在 Agent 这层》。 再上一篇:《高并发写入实测:把最重的 MySQL 改回同步,QPS 反而涨了 38%》。 第一篇:《别再死背 44 字节了:Redis String 三种编码压测》。