《扩散模型原理:从起源到发展》 第六章:扩散模型的统一系统化视角
专著参考 :The Principles of Diffusion Models
前序阅读章节:
【扩散模型原理】(一)Deep Generative Modeling
【扩散模型原理】(二)Variational Perspective: From VAEs to DDPMs
【扩散模型原理】(三)Score-Based Perspective: From EBMs to NCSN
【扩散模型原理】(四)Diffusion Models Today: Score SDE Framework(1)
【扩散模型原理】(四)Diffusion Models Today: Score SDE Framework(2)
【扩散模型原理】(五)Flow-Based Perspective : From NFs to Flow Matching(1)
【扩散模型原理】(五)Flow-Based Perspective : From NFs to Flow Matching(2)
【扩散模型原理】(五)Flow-Based Perspective : From NFs to Flow Matching(3)
A Unified and Systematic Lens on Diffusion Models
本章给出一套系统化视角,将变分视角 、得分匹配视角 与流匹配视角 纳入统一的理论框架。尽管各类方法的设计动机与直观理解各不相同,但其背后的核心机制是一致的。基于第 2‑5 章内容,我们可总结出一套通用范式 :定义前向退化过程,刻画边缘分布演化路径;再学习一个时变向量场,沿着该路径将简单先验分布变换为数据分布。
在全部研究视角下,一项关键技术是 6.1 节提出的条件化技巧 。 该技巧将难以求解的边缘目标函数转化为可求解的条件目标函数,以此实现稳定且高效的训练。
6.2 节对训练目标开展系统性分析,明确其核心组成部分,并阐释变分视角、基于分数的视角与基于流的视角下损失函数的构建方式。
6.3 节证明,形如 x t = α t x 0 + σ t ϵ \mathbf{x}_t=\alpha_t \mathbf{x}_0+\sigma_t \mathbf{\epsilon} xt=αtx0+σtϵ 的任意仿射前向加噪过程,均可等价转换为标准线性调度 x t = ( 1 − t ) x 0 + t ϵ \mathbf{x}_t=(1-t)\mathbf{x}_0+t\mathbf{\epsilon} xt=(1−t)x0+tϵ。此外,噪声预测、干净数据预测、分数预测与速度预测等常用参数化形式,在梯度层面具备可互换性。因此,噪声调度器与参数化方案的选取均遵循同一建模准则。
最后,6.4 节整合上述讨论,给出**核心控制方程:福克‑普朗克方程。**无论将其视作变分方案(离散时间去噪)、基于分数的方法(随机微分方程形式),还是基于流的方法(常微分方程形式),上述每一类方法所构建生成器的边缘分布均服从相同的密度演化规律。因此,福克‑普朗克方程是三类视角均需要满足的通用约束,三类方法的差异仅体现在参数化形式与训练目标函数上。
6.1 条件化技巧:扩散模型的核心关键(Conditional Tricks: The Secret Sauce of Diffusion Models)
至此,我们已经从三类看似相互独立的源头研究了扩散模型:变分视角、基于分数的视角以及基于流的视角。三类视角最初的研究动机各不相同,各自对应一套训练目标(固定 t t t ):
- 变分视角 :学习参数化密度 p ϕ ( x t − Δ t ∣ x t ) p_\phi(\mathbf{x}{t-\Delta t}|\mathbf{x}t) pϕ(xt−Δt∣xt),使其逼近真实反向转移分布 p ( x t − Δ t ∣ x t ) p(\mathbf{x}{t-\Delta t}|\mathbf{x}t) p(xt−Δt∣xt),最小化如下目标:
J K L ( ϕ ) : = E p t ( x t ) D K L ( p ( x t − Δ t ∣ x t ) ∥ p ϕ ( x t − Δ t ∣ x t ) ) ; \mathcal{J}\mathrm{KL}(\phi):=\mathbb{E}{p_t(\mathbf{x}_t)}\left\\mathcal{D}_\\mathrm{KL}\\big(p(\\mathbf{x}_{t-\\Delta t}\|\\mathbf{x}_t)\\,\\\|\\,p_\\phi(\\mathbf{x}_{t-\\Delta t}\|\\mathbf{x}_t)\\big)\\right; JKL(ϕ):=Ept(xt)DKL(p(xt−Δt∣xt)∥pϕ(xt−Δt∣xt)); - 基于分数的视角 :训练分数模型 s ϕ ( x t , t ) \mathbf{s}\phi(\mathbf{x}t,t) sϕ(xt,t),拟合边缘分数 ∇ x log p t ( x t ) \nabla\mathbf{x}\log p_t(\mathbf{x}t) ∇xlogpt(xt),优化目标为:
J S M ( ϕ ) : = E p t ( x t ) ∥ s ϕ ( x t , t ) − ∇ x log p t ( x t ) ∥ 2 2 ; \mathcal{J}\mathrm{SM}(\phi):=\mathbb{E}{p_t(\mathbf{x}_t)}\left\\left\\\|\\mathbf{s}_\\phi(\\mathbf{x}_t,t)-\\nabla_\\mathbf{x}\\log p_t(\\mathbf{x}_t)\\right\\\|_2\^2\\right; JSM(ϕ):=Ept(xt)∥sϕ(xt,t)−∇xlogpt(xt)∥22; - 基于流的视角 :学习速度模型 v ϕ ( x t , t ) \mathbf{v}_\phi(\mathbf{x}_t,t) vϕ(xt,t),逼近理论速度 v t ( x t ) \mathbf{v}t(\mathbf{x}t) vt(xt)(例如由式 (5.2.10) 定义),最小化损失:
J F M ( ϕ ) : = E p t ( x t ) ∥ v ϕ ( x t , t ) − v t ( x t ) ∥ 2 2 . \mathcal{J}\mathrm{FM}(\phi):=\mathbb{E}{p_t(\mathbf{x}_t)}\left\\left\\\|\\mathbf{v}_\\phi(\\mathbf{x}_t,t)-\\mathbf{v}_t(\\mathbf{x}_t)\\right\\\|_2\^2\\right. JFM(ϕ):=Ept(xt)∥vϕ(xt,t)−vt(xt)∥22.
初看之下,上述目标函数几乎无法求解,因为它们均需要用到理论真值 ,而这类真值在一般情况下本质上是不可获取的。但这里存在一个巧妙的突破口:各类方法独立地得到了解决该问题的同一套简洁方案 ------以原始数据 x 0 \mathbf{x}_0 x0 作为条件。 该技术能够将每一个难以求解的训练目标转换为可求解形式。
这套精巧的 "条件化技术" 将目标函数改写为关于已知高斯条件分布 p t ( x t ∣ x 0 ) p_t(\mathbf{x}_t|\mathbf{x}_0) pt(xt∣x0) 的期望,得到与原目标梯度等价的闭式回归目标,由此获得可求解的训练目标:
-
变分视角 (式 (2.2.3)):
J K L ( ϕ ) = E x 0 E p t ( x t ∣ x 0 ) D K L ( p ( x t − Δ t ∣ x t , x 0 ) ∥ p ϕ ( x t − Δ t ∣ x t ) ) ⏟ J C K L ( ϕ ) + C ; \mathcal{J}\mathrm{KL}(\phi)=\underbrace{\mathbb{E}{\mathbf{x}0}\mathbb{E}{p_t(\mathbf{x}t|\mathbf{x}0)}\left\\mathcal{D}_\\mathrm{KL}\\big(p(\\mathbf{x}_{t-\\Delta t}\|\\mathbf{x}_t,\\mathbf{x}_0)\\,\\\|\\,p_\\phi(\\mathbf{x}_{t-\\Delta t}\|\\mathbf{x}_t)\\big)\\right}{\mathcal{J}\mathrm{CKL}(\phi)}+C; JKL(ϕ)=JCKL(ϕ) Ex0Ept(xt∣x0)DKL(p(xt−Δt∣xt,x0)∥pϕ(xt−Δt∣xt))+C;
-
基于分数的视角 (式 (3.3.3)):
J S M ( ϕ ) = E x 0 E p t ( x t ∣ x 0 ) ∥ s ϕ ( x t , t ) − ∇ x t log p t ( x t ∣ x 0 ) ∥ 2 2 ⏟ J D S M ( ϕ ) + C ; \mathcal{J}\mathrm{SM}(\phi)=\underbrace{\mathbb{E}{\mathbf{x}0}\mathbb{E}{p_t(\mathbf{x}t|\mathbf{x}0)}\left\\left\\\|\\mathbf{s}_\\phi(\\mathbf{x}_t,t)-\\nabla_{\\mathbf{x}_t}\\log p_t(\\mathbf{x}_t\|\\mathbf{x}_0)\\right\\\|_2\^2\\right}{\mathcal{J}\mathrm{DSM}(\phi)}+C; JSM(ϕ)=JDSM(ϕ) Ex0Ept(xt∣x0)∥sϕ(xt,t)−∇xtlogpt(xt∣x0)∥22+C;
-
基于流的视角 (式 (5.2.9)):
J F M ( ϕ ) = E x 0 E p t ( x t ∣ x 0 ) ∥ v ϕ ( x t , t ) − v t ( x t ∣ x 0 ) ∥ 2 2 ⏟ J C F M ( ϕ ) + C . \mathcal{J}\mathrm{FM}(\phi)=\underbrace{\mathbb{E}{\mathbf{x}0}\mathbb{E}{p_t(\mathbf{x}t|\mathbf{x}0)}\left\\left\\\|\\mathbf{v}_\\phi(\\mathbf{x}_t,t)-\\mathbf{v}_t(\\mathbf{x}_t\|\\mathbf{x}_0)\\right\\\|_2\^2\\right}{\mathcal{J}\mathrm{CFM}(\phi)}+C. JFM(ϕ)=JCFM(ϕ) Ex0Ept(xt∣x0)∥vϕ(xt,t)−vt(xt∣x0)∥22+C.
为建立统一视角,接下来我们系统回顾条件 KL、分数与速度目标函数。关键在于,这些目标函数不仅具备可求解性,而且仅相差一个常数偏移量,与原始目标函数相互等价 。条件化形式 ( J C K L , J D S M , J C F M ) \left(\mathcal{J}\mathrm{CKL},\mathcal{J}\mathrm{DSM},\mathcal{J}\mathrm{CFM}\right) (JCKL,JDSM,JCFM) 与原始形式 ( J K L , J S M , J F M ) \left(\mathcal{J}\mathrm{KL},\mathcal{J}\mathrm{SM},\mathcal{J}\mathrm{FM}\right) (JKL,JSM,JFM) 的差异仅为该常数偏移;常数偏移不会改变梯度,因此优化曲面保持不变 。由此,极小值解与理论真值目标一一对应:各目标均可转化为最小二乘回归问题,其解能够还原对应的条件期望 :
p ∗ ( x t − Δ t ∣ x t ) = E x 0 ∼ p ( ⋅ ∣ x t ) p ( x t − Δ t ∣ x t , x 0 ) = p ( x t − Δ t ∣ x t ) , s ∗ ( x t , t ) = E x 0 ∼ p ( ⋅ ∣ x t ) ∇ x t log p t ( x t ∣ x 0 ) = ∇ x t log p t ( x t ) , v ∗ ( x t , t ) = E x 0 ∼ p ( ⋅ ∣ x t ) v t ( x t ∣ x 0 ) = v t ( x t ) . (6.1.1) \begin{aligned} p^{*}(\boldsymbol{x}_{t-\Delta t}|\boldsymbol{x}t) &= \mathbb{E}{\boldsymbol{x}_0\sim p(\cdot|\boldsymbol{x}t)}\bigp(\\boldsymbol{x}_{t-\\Delta t}\|\\boldsymbol{x}_t,\\boldsymbol{x}_0)\\big &&= p(\boldsymbol{x}{t-\Delta t}|\boldsymbol{x}_t),\\ \mathbf{s}^{*}(\boldsymbol{x}t,t) &= \mathbb{E}{\boldsymbol{x}_0\sim p(\cdot|\boldsymbol{x}t)}\big\\nabla_{\\boldsymbol{x}_t}\\log p_t(\\boldsymbol{x}_t\|\\boldsymbol{x}_0)\\big &&= \nabla{\boldsymbol{x}_t}\log p_t(\boldsymbol{x}_t), \tag{6.1.1}\\ \mathbf{v}^{*}(\boldsymbol{x}t,t) &= \mathbb{E}{\boldsymbol{x}_0\sim p(\cdot|\boldsymbol{x}_t)}\big\\mathbf{v}_t(\\boldsymbol{x}_t\|\\boldsymbol{x}_0)\\big &&= \mathbf{v}_t(\boldsymbol{x}_t). \end{aligned} p∗(xt−Δt∣xt)s∗(xt,t)v∗(xt,t)=Ex0∼p(⋅∣xt)p(xt−Δt∣xt,x0)=Ex0∼p(⋅∣xt)∇xtlogpt(xt∣x0)=Ex0∼p(⋅∣xt)vt(xt∣x0)=p(xt−Δt∣xt),=∇xtlogpt(xt),=vt(xt).(6.1.1)
这并非偶然:条件化形式在令训练可求解的同时,揭示出一种深刻的统一关系。变分扩散、基于分数的随机微分方程(SDE)与流匹配,本质上是同一原理的不同表现形式。三种视角,同一内核 ,彼此形成精巧的关联。
本章后续将进一步探究三者之间的等价关系。
6.2 解析扩散模型训练损失的研究脉络(A Roadmap for Elucidating Training Losses in Diffusion Models)
本节针对扩散模型的训练损失建立一套系统化分析框架。在 6.2.1 节,将原有三类标准目标函数拓展为四类参数化形式,阐释各类形式如何源于不同的建模视角。随后在 6.2.2 节,将上述结论凝练为通用框架,对扩散模型目标函数的结构进行解耦,为 6.3 节的等价性推导奠定基础。
6.2.1 扩散模型中四类常用参数化方式(Four Common Parameterizations in Diffusion Models)
本节中,前向扰动核定义为:
p t ( x t ∣ x 0 ) = N ( x t ; α t x 0 , σ t 2 I ) , p_t(\mathbf{x}_t|\mathbf{x}_0)=\mathcal{N}\left(\mathbf{x}_t;\alpha_t\mathbf{x}_0,\sigma_t^2\mathbf{I}\right), pt(xt∣x0)=N(xt;αtx0,σt2I), 除非额外说明,其中 x 0 ∼ p data \mathbf{x}0 \sim p{\text{data}} x0∼pdata,其定义见式 (4.4.1)。
设 ω : 0 , T → R > 0 \omega:0,T\to\mathbb{R}{>0} ω:0,T→R>0 为正的时间权重函数。为便于后续分析,下面汇总四类标准参数化形式 :噪声 ϵ ϕ \boldsymbol{\epsilon}\phi ϵϕ、干净样本 x ϕ \mathbf{x}\phi xϕ、分数 s ϕ \mathbf{s}\phi sϕ、速度 v ϕ \mathbf{v}_\phi vϕ,以及它们对应的极小化解 ϵ ∗ \boldsymbol{\epsilon}^{*} ϵ∗、 x ∗ \mathbf{x}^{*} x∗、 s ∗ \mathbf{s}^{*} s∗、 v ∗ \mathbf{v}^{*} v∗。
变分视角。该方法基于 DDPM 中的 KL 散度(参见 2.2.4 节与 4.4.3 节),其任务等价于预测生成 x t \mathbf{x}_t xt 所对应的期望噪声 ,或是预测 x t \mathbf{x}_t xt 受扰动前的期望干净信号。
1. ϵ \boldsymbol{\epsilon} ϵ‑预测(噪声预测) (Ho 等人,2020):
ϵ ϕ ( x t , t ) ≈ E ϵ ∣ x t = ϵ ∗ ( x t , t ) (6.2.1) \boldsymbol{\epsilon}_\phi(\mathbf{x}_t,t) \approx \mathbb{E}\\boldsymbol{\\epsilon}\|\\mathbf{x}_t = \boldsymbol{\epsilon}^*(\mathbf{x}_t,t) \tag{6.2.1} ϵϕ(xt,t)≈Eϵ∣xt=ϵ∗(xt,t)(6.2.1) 对应的训练目标为
L noise ( ϕ ) : = E t ω ( t ) E x 0 , ϵ ∥ ϵ ϕ ( x t , t ) − ϵ ∥ 2 2 . \mathcal{L}_{\text{noise}}(\phi):=\mathbb{E}_t\left\\omega(t)\\mathbb{E}_{\\mathbf{x}_0,\\boldsymbol{\\epsilon}}\\left\\\|\\boldsymbol{\\epsilon}_\\phi(\\mathbf{x}_t,t)-\\boldsymbol{\\epsilon}\\right\\\|_2\^2\\right. Lnoise(ϕ):=Etω(t)Ex0,ϵ∥ϵϕ(xt,t)−ϵ∥22. 式中, ϵ ∗ \boldsymbol{\epsilon}^* ϵ∗ 表示为得到给定 x t \mathbf{x}_t xt 而注入的平均噪声。
2. x \mathbf{x} x‑预测(干净样本预测) (Kingma 等人,2021;Karras 等人,2022;Song 等人,2023):
x ϕ ( x t , t ) ≈ E x 0 ∣ x t = x ∗ ( x t , t ) (6.2.2) \mathbf{x}_\phi(\mathbf{x}_t,t) \approx \mathbb{E}\\mathbf{x}_0\|\\mathbf{x}_t = \mathbf{x}^*(\mathbf{x}_t,t) \tag{6.2.2} xϕ(xt,t)≈Ex0∣xt=x∗(xt,t)(6.2.2) 对应的训练目标为
L clean ( ϕ ) : = E t ω ( t ) E x 0 , ϵ ∥ x ϕ ( x t , t ) − x 0 ∥ 2 2 . \mathcal{L}_{\text{clean}}(\phi):=\mathbb{E}_t\left\\omega(t)\\mathbb{E}_{\\mathbf{x}_0,\\boldsymbol{\\epsilon}}\\left\\\|\\mathbf{x}_\\phi(\\mathbf{x}_t,t)-\\mathbf{x}_0\\right\\\|_2\^2\\right. Lclean(ϕ):=Etω(t)Ex0,ϵ∥xϕ(xt,t)−x0∥22. 式中, x ∗ \mathbf{x}^* x∗ 代表在含噪观测 x t \mathbf{x}_t xt 条件下,全部合理干净样本估计的均值。
**基于分数的视角。**该方法预测噪声等级 t t t 下的分数函数,该函数给出平均去噪方向,可将 x t \mathbf{x}_t xt 还原为所有可能生成该含噪样本的干净样本:
3. 分数预测 (Song 与 Ermon,2019;Song 等人,2020c):
s ϕ ( x t , t ) ≈ ∇ x t log p t ( x t ) = E ∇ x t log p t ( x t ∣ x 0 ) ∣ x t = s ∗ ( x t , t ) (6.2.3) \mathbf{s}_\phi(\mathbf{x}t,t) \approx \nabla{\mathbf{x}_t}\log p_t(\mathbf{x}_t) =\mathbb{E}\big\\nabla_{\\mathbf{x}_t}\\log p_t(\\mathbf{x}_t\|\\mathbf{x}_0)\\big\|\\mathbf{x}_t\\big =\mathbf{s}^*(\mathbf{x}_t,t) \tag{6.2.3} sϕ(xt,t)≈∇xtlogpt(xt)=E∇xtlogpt(xt∣x0) xt=s∗(xt,t)(6.2.3) 对应的训练目标为
L score ( ϕ ) : = E t ω ( t ) E x 0 , ϵ ∥ s ϕ ( x t , t ) − ∇ x t log p t ( x t ∣ x 0 ) ∥ 2 2 , \mathcal{L}_{\text{score}}(\phi):=\mathbb{E}t\left\\omega(t)\\mathbb{E}_{\\mathbf{x}_0,\\boldsymbol{\\epsilon}}\\left\\\|\\mathbf{s}_\\phi(\\mathbf{x}_t,t)-\\nabla_{\\mathbf{x}_t}\\log p_t(\\mathbf{x}_t\|\\mathbf{x}_0)\\right\\\|_2\^2\\right, Lscore(ϕ):=Etω(t)Ex0,ϵ∥sϕ(xt,t)−∇xtlogpt(xt∣x0)∥22, 其中条件分数满足 ∇ x t log p t ( x t ∣ x 0 ) = − 1 σ t ϵ . \nabla{\mathbf{x}_t}\log p_t(\mathbf{x}_t|\mathbf{x}_0)=-\frac{1}{\sigma_t}\boldsymbol{\epsilon}. ∇xtlogpt(xt∣x0)=−σt1ϵ.
**基于流的视角。**该方法预测数据演化至 x t \mathbf{x}_t xt 处的瞬时平均速度。
4. v \mathbf{v} v‑预测(速度预测) (Lipman 等人,2022;Liu,2022;Salimans 与 Ho,2021;Albergo 等人,2023):
v ϕ ( x t , t ) ≈ E d x t d t ∣ x t = v ∗ ( x t , t ) (6.2.4) \mathbf{v}_\phi(\mathbf{x}_t,t)\approx\mathbb{E}\left\\left.\\frac{\\mathrm{d}\\mathbf{x}_t}{\\mathrm{d}t}\\right\|\\mathbf{x}_t\\right=\mathbf{v}^*(\mathbf{x}_t,t) \tag{6.2.4} vϕ(xt,t)≈Edtdxt xt=v∗(xt,t)(6.2.4) 对应的训练目标为
L velocity ( ϕ ) : = E t ω ( t ) E x 0 , ϵ ∥ v ϕ ( x t , t ) − v t ( x t ∣ x 0 , ϵ ) ∥ 2 2 , \mathcal{L}_{\text{velocity}}(\phi):=\mathbb{E}_t\left\\omega(t)\\mathbb{E}_{\\mathbf{x}_0,\\boldsymbol{\\epsilon}}\\left\\\|\\mathbf{v}_\\phi(\\mathbf{x}_t,t)-\\mathbf{v}_t(\\mathbf{x}_t\|\\mathbf{x}_0,\\boldsymbol{\\epsilon})\\right\\\|_2\^2\\right, Lvelocity(ϕ):=Etω(t)Ex0,ϵ∥vϕ(xt,t)−vt(xt∣x0,ϵ)∥22, 其中条件速度定义为 v t ( x t ∣ x 0 , ϵ ) = α t ′ x 0 + σ t ′ ϵ . \mathbf{v}_t(\mathbf{x}_t|\mathbf{x}_0,\boldsymbol{\epsilon})=\alpha_t'\mathbf{x}_0+\sigma_t'\boldsymbol{\epsilon}. vt(xt∣x0,ϵ)=αt′x0+σt′ϵ.
式中, v ∗ \mathbf{v}^* v∗ 代表经过观测点 x t \mathbf{x}_t xt 的平均速度向量。
基于式 (6.1.1) 给出的结论,上述四类预测形式的本质均为条件期望逼近 :依据观测样本 x t \mathbf{x}_t xt,分别对平均噪声、干净原始数据、分数函数与速度做近似求解。
6.2.2 解耦扩散模型的训练目标(Disentangling the Training Objective of Diffusion Models)
如 6.2.1 节所述,四类预测方式对应的目标函数具备统一的扩散模型训练模板形式:
L ( ϕ ) : = E x 0 , ϵ E p time ( t ) ω ( t ) ∥ N N ϕ ( x t , t ) − ( A t x 0 + B t ϵ ) ∥ 2 2 . (6.2.5) \mathcal{L}(\phi):=\mathbb{E}{\mathbf{x}0,\boldsymbol{\epsilon}} \mathbb{E}{p{\text{time}}(t)} \left\\omega(t) \\left\\\|\\mathrm{NN}_\\phi\\left(\\mathbf{x}_t,t\\right)-\\left(A_t\\mathbf{x}_0+B_t\\boldsymbol{\\epsilon}\\right)\\right\\\|_2\^2\\right. \tag{6.2.5} L(ϕ):=Ex0,ϵEptime(t)ω(t)∥NNϕ(xt,t)−(Atx0+Btϵ)∥22.(6.2.5) E p time ( t ) \mathbb{E}{p{\text{time}}(t)} Eptime(t) 为时间分布 ; ω ( t ) \omega(t) ω(t) 为时间权重 ; ∥ N N ϕ ( x t , t ) − ( A t x 0 + B t ϵ ) ∥ 2 2 \left\|\mathrm{NN}_\phi\left(\mathbf{x}_t,t\right)-\left(A_t\mathbf{x}_0+B_t\boldsymbol{\epsilon}\right)\right\|_2^2 ∥NNϕ(xt,t)−(Atx0+Btϵ)∥22 为均方误差项。
为提升训练效率、优化扩散模型学习流程,有四项关键设计选择至关重要(Karras 等人,2022;Lu 与 Song,2024):
-
( A ) 通过 α t \alpha_t αt 与 σ t \sigma_t σt 确定 x t \mathbf{x}_t xt 前向过程的噪声调度;
-
( B ) 神经网络 N N ϕ \mathrm{NN}_\phi NNϕ 的预测类型,以及对应的回归目标 ( A t x 0 + B t ϵ ) (A_t\mathbf{x}_0+B_t\boldsymbol{\epsilon}) (Atx0+Btϵ);
-
( C ) 时间权重函数 ω ( ⋅ ) : 0 , T → R ≥ 0 \omega(\cdot):0,T\to\mathbb{R}_{\ge 0} ω(⋅):0,T→R≥0;
-
( D ) 时间分布 p time p_{\text{time}} ptime。
下文将对上述四项组成部分展开详细说明,为后续章节的讨论提供分析框架。
( A ) 噪声调度 α t \boldsymbol{\alpha_t} αt 与 σ t \boldsymbol{\sigma_t} σt。 使用者可根据自身应用场景灵活选取噪声调度方案,常见方案汇总于 表 5.2。重要的是,如式 (6.3.3) 与式 (6.3.5) 将要证明的,所有形如 x t = α t x 0 + σ t ϵ \mathbf{x}_t=\alpha_t\mathbf{x}_0+\sigma_t\boldsymbol{\epsilon} xt=αtx0+σtϵ 的仿射流在数学上彼此等价。具体而言,通过恰当的时间重参数化与空间重缩放 ,任意该类插值形式均可转化为标准线性调度 ( α t = 1 − t , σ t = t ) (\alpha_t=1-t,\ \sigma_t=t) (αt=1−t, σt=t),或三角函数调度 ( α t = cos t , σ t = sin t ) (\alpha_t=\cos t,\ \sigma_t=\sin t) (αt=cost, σt=sint)。
( B ) 参数化形式 N N ϕ \boldsymbol{\mathrm{NN}_\phi} NNϕ 与训练目标 A t x 0 + B t ϵ \boldsymbol{A_t\mathbf{x}_0+B_t\boldsymbol{\epsilon}} Atx0+Btϵ。 使用者可灵活选择模型的预测目标:干净信号、噪声、分数函数或速度 。如 6.2.1 节所述,上述全部预测类型拥有统一形式的回归目标:
Regression Target = A t x 0 + B t ϵ , \text{Regression Target}=A_t\mathbf{x}_0+B_t\boldsymbol{\epsilon}, Regression Target=Atx0+Btϵ,其中系数 A t A_t At、 B t B_t Bt 由所选预测类型与调度 ( α t , σ t ) (\alpha_t,\sigma_t) (αt,σt) 共同决定,该对应关系汇总于 表 6.1。
尽管这四类参数化形式看上去各不相同,后文式 (6.3.1) 将证明,仅通过简单代数变换即可实现不同参数化形式之间的相互转换。此外,式 (6.3.6) 还将说明:式 (6.2.5) 中的 ℓ 2 \ell_2 ℓ2 平方损失项在各类预测模式下具备梯度等价性 ;除 ω ( t ) p time ( t ) \omega(t)p_{\text{time}}(t) ω(t)ptime(t) 之外,不同预测形式之间仅相差一项完全由噪声调度 ( α t , σ t ) (\alpha_t,\sigma_t) (αt,σt) 决定的时间权重因子。
**Table 6.1 | 不同参数化方式之间的关系汇总:**四种参数化形式在数学上完全等价,可通过简单代数变换实现相互转换。
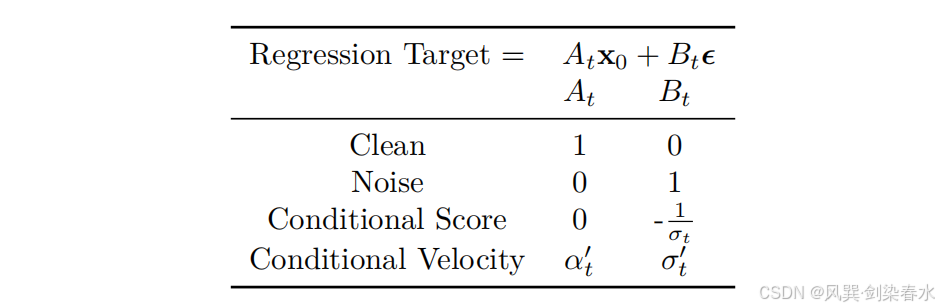
( C ) 时间分布 p time ( t ) \boldsymbol{p_{\text{time}}(t)} ptime(t)。 由于训练损失是关于 t t t 的期望,依据 p time ( t ) p_{\text{time}}(t) ptime(t) 采样时间步,在数学上等价于以 p time ( t ) p_{\text{time}}(t) ptime(t) 对每个时间步的均方误差施加权重;该权重因子可以合并至已有的时间权重项 ω ( t ) \omega(t) ω(t)。但实验证据表明,选取不同的 p time ( t ) p_{\text{time}}(t) ptime(t) 会影响模型性能。因此本文将对时间分布 p time ( t ) p_{\text{time}}(t) ptime(t) 与时间权重函数 ω ( t ) \omega(t) ω(t) 分开进行讨论。
时间分布的常用选择为区间 0 , T 0,T 0,T 上的均匀分布 (Ho 等人,2020;Song 等人,2020c;Lipman 等人,2022;Liu,2022)。其他可选方案包括对数正态分布 (Karras 等人,2022)以及自适应重要性采样方法(Song 等人,2021;Kingma 等人,2021)。
( D ) 时间权重函数 ω ( t ) \boldsymbol{\omega(t)} ω(t)。 权重函数的常用选择为常数权重 ω ≡ 1 \omega \equiv 1 ω≡1(Ho 等人,2020;Karras 等人,2022;Lipman 等人,2022;Liu,2022),同时也已有自适应权重方案 被提出(Karras 等人,2023)。特定形式的 ω ( t ) \omega(t) ω(t) 可将式 (6.2.5) 转化为负对数似然的更紧上界,实质上把优化目标改写为极大似然训练。
ω ( t ) \omega(t) ω(t) 的代表性权重方案包括取 ω ( t ) = g 2 ( t ) \omega(t)=g^2(t) ω(t)=g2(t)(Song 等人,2021),其中 g g g 为式 (4.1.3) 前向随机微分方程中的扩散系数。其余方法还有信噪比(SNR)权重(Kingma 等人,2021),以及单调权重函数(Kingma 与 Gao,2023),后者中 ω ( t ) \omega(t) ω(t) 是关于时间的单调函数。
总体而言,无论选取何种噪声调度器、预测类型或是时间采样分布,上述因素在理论层面最终都会体现为对目标函数时间权重的影响。该时间权重会改变实际训练的损失曲面,进而影响模型性能。
下一章:【扩散模型原理】(六)A Unified and Systematic Lens on Diffusion Models(2)