Embabel学习笔记:把Agent的决策权从LLM手里拿回来(GOAP行动图+双框架同任务实测)
本文是一次完整的框架学习与实战记录:从 Agent 站手搓 ReAct 循环留下的"决策税"问题出发,认识 Spring 之父 Rod Johnson 的新框架 Embabel,理解它用 GOAP 规划算法替换 LLM 决策的核心思路,动手跑通最小 Agent,再把仓储设备诊断任务用类型化行动图重写------与手搓 ReAct 循环同任务双跑对比,用请求数和轨迹说话。配 6 张概念图与两轮真实实测日志。 技术栈:Embabel 1.5.3 + Spring Boot 4.1.1 + DashScope(qwen3.7-plus);对照组为 Agent 站的 Spring AI 1.0.0 GA 手搓显式 ReAct 循环。 完整代码见仓库 embabel-lab 模块。本文承接 Agent 站(显式 ReAct 循环已跑通),只专注一件事:换掉循环里的决策者,会发生什么。
〇、先看全景:循环里的决策税
上一篇 Agent 站的收官实测里,有一个数字值得重新盯一会儿:同一个"WH-AGV-003 报障停机诊断"任务,显式 ReAct 循环跑了 3~5 轮(两次实测轮数不同),每一轮都要向 LLM 发一次请求------问的无非是"信息够了吗?下一步查什么?"。最后一轮生成结论的调用是必要开销,但前面几轮里,LLM 的大头工作其实是决策:决定先查实时状态、再查基础档案、查到故障码后检索知识库。
这就是本文的起点问题:这些决策,真的需要每次都问 LLM 吗?
回头看这个诊断任务的调查顺序------先实时、再档案、后综合------它是一条稳定的方法论 ,换十次任务它也不会变。用 LLM 每轮现想一遍,等于让一位资深专家陪着一个流程早已烂熟于心的实习生,每走一步都要开一次会。会议有三个代价:token 账单随轮数线性膨胀 (每轮请求都带着越滚越大的草稿本)、轨迹不可复现 (同一个任务两次跑 3 轮和 5 轮都是正常收敛,测试只能断言结论不能断言过程)、跳步风险(方法论写在 system prompt 里是软约束,模型心情不好就可能漏查一路证据)。
有没有一种办法,把稳定的调查顺序固化下来,LLM 只在真正需要语言能力的地方(提取、综合)出场?这就是 Embabel 给出的答案------它把 Agent 循环里的决策者从 LLM 换成了一个规划算法。
一、Embabel 是什么:Spring 之父的第二次创业
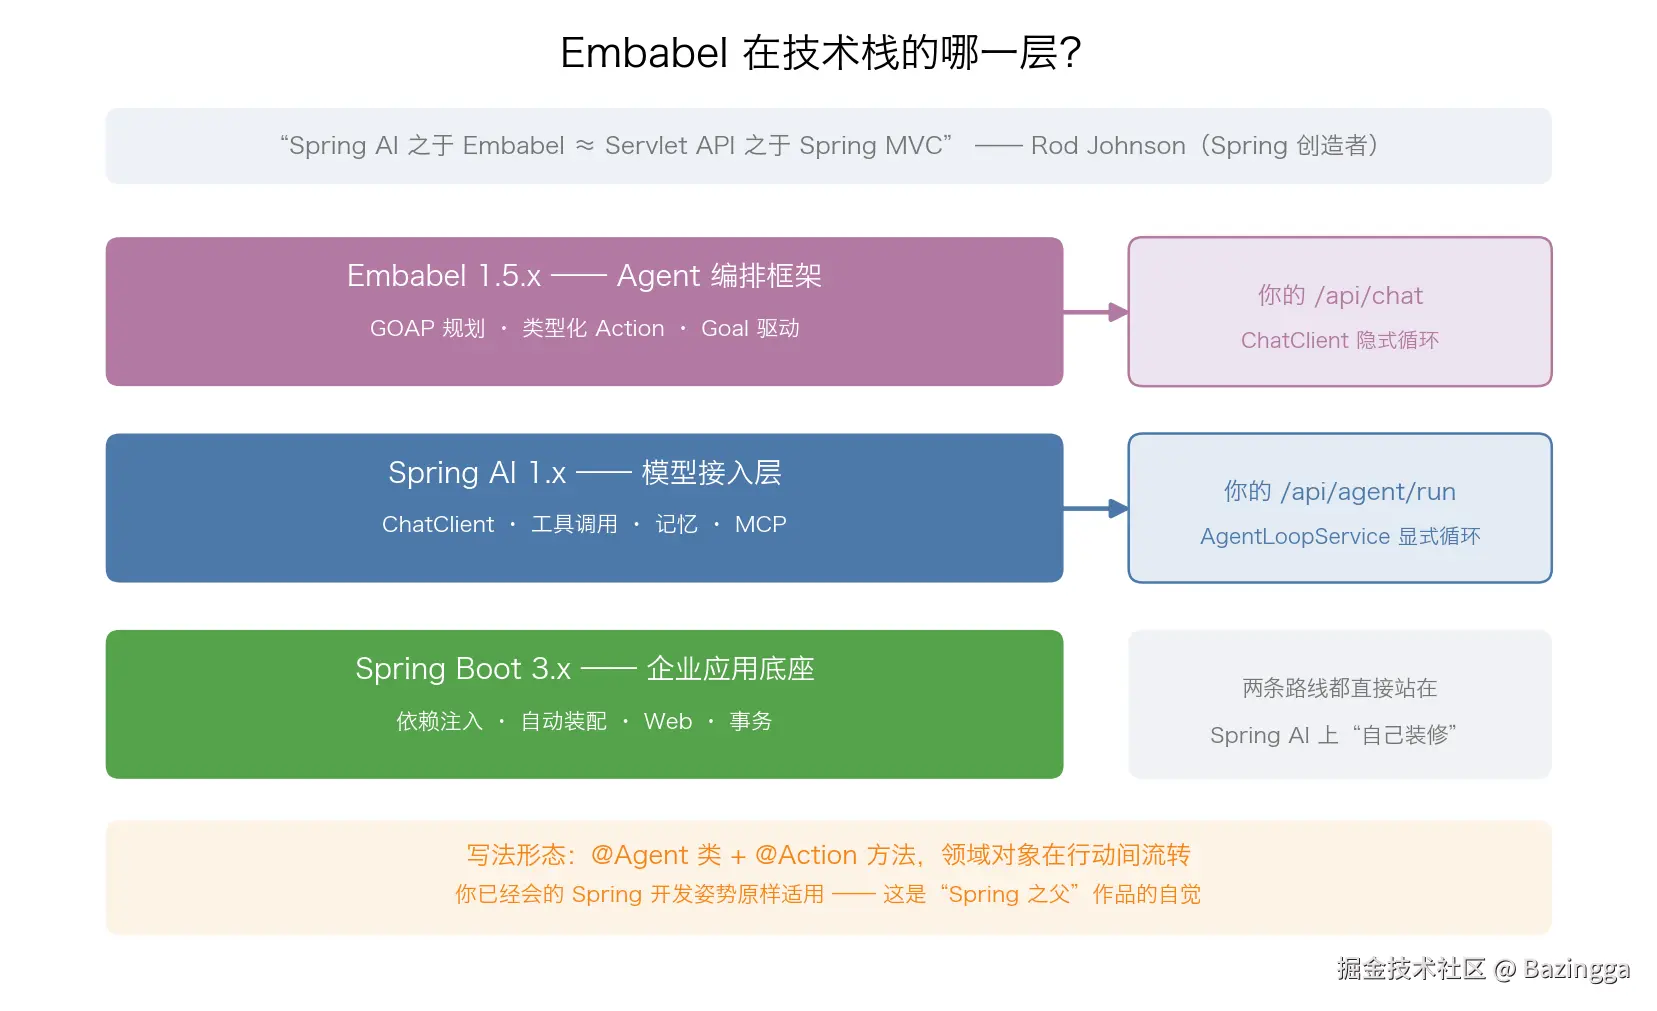
Embabel(发音 Em-BAY-bel)是 JVM 上的 Agent 编排框架,作者 Rod Johnson------对,就是 2002 年写出 Spring 框架的那个人。2025 年他带着这个项目回到大众视野,2026 年 8 月发布 1.0,到本文写作时的最新版本是 1.5.3(2026-10-05 发布)。
理解它的定位,一个类比就够了:Spring AI 之于 Embabel,就像 Servlet API 之于 Spring MVC。Spring AI 是接入层------统一模型调用、工具协议、记忆接口,相当于提供标准水电接口;Embabel 是编排层------在接入层之上解决"多步任务怎么组织",相当于拎包入住的精装方案。Embabel 默认就用 Spring AI 做底层模型接入,两者不是竞争关系,是上下层。
它解决的核心问题只有一个:LLM 驱动的循环(ReAct)里,决策成本和不确定性太高。Embabel 的解法是 GOAP------一个不看 LLM 脸色的规划算法,下一章展开。
动手前的第一个现实问题反而是工程问题:版本矩阵 。Embabel 1.5.3 的自动装配依赖 Spring AI 2.0.1 + Spring Boot 4.1.1;而主工程是 Spring AI 1.0.0 GA + Spring Boot 3.4.1------两条版本线在 Maven 的世界里无法共存于同一个 classpath(依赖仲裁只会在两个大版本里选一个,另一个的类在运行期直接 NoSuchMethodError)。这不是 Embabel 特有的坑,是所有快速迭代的 AI 框架共同的时代病:它们追着最新上游跑,你的存量工程追不上。
所以本文的工程形态是仓库内双模块:主应用留在原版本线(GA 不升级,MCP Server、记忆持久化、评测门禁都不用重验),Embabel 学习工程独立成 embabel-lab 模块,各自挂各自的 Boot parent,互不污染。判断依据写在这里,是因为这个决策模式可复用:引入激进新框架的第一步,是隔离,不是替换。
二、六个词汇:一道类型化的数学题
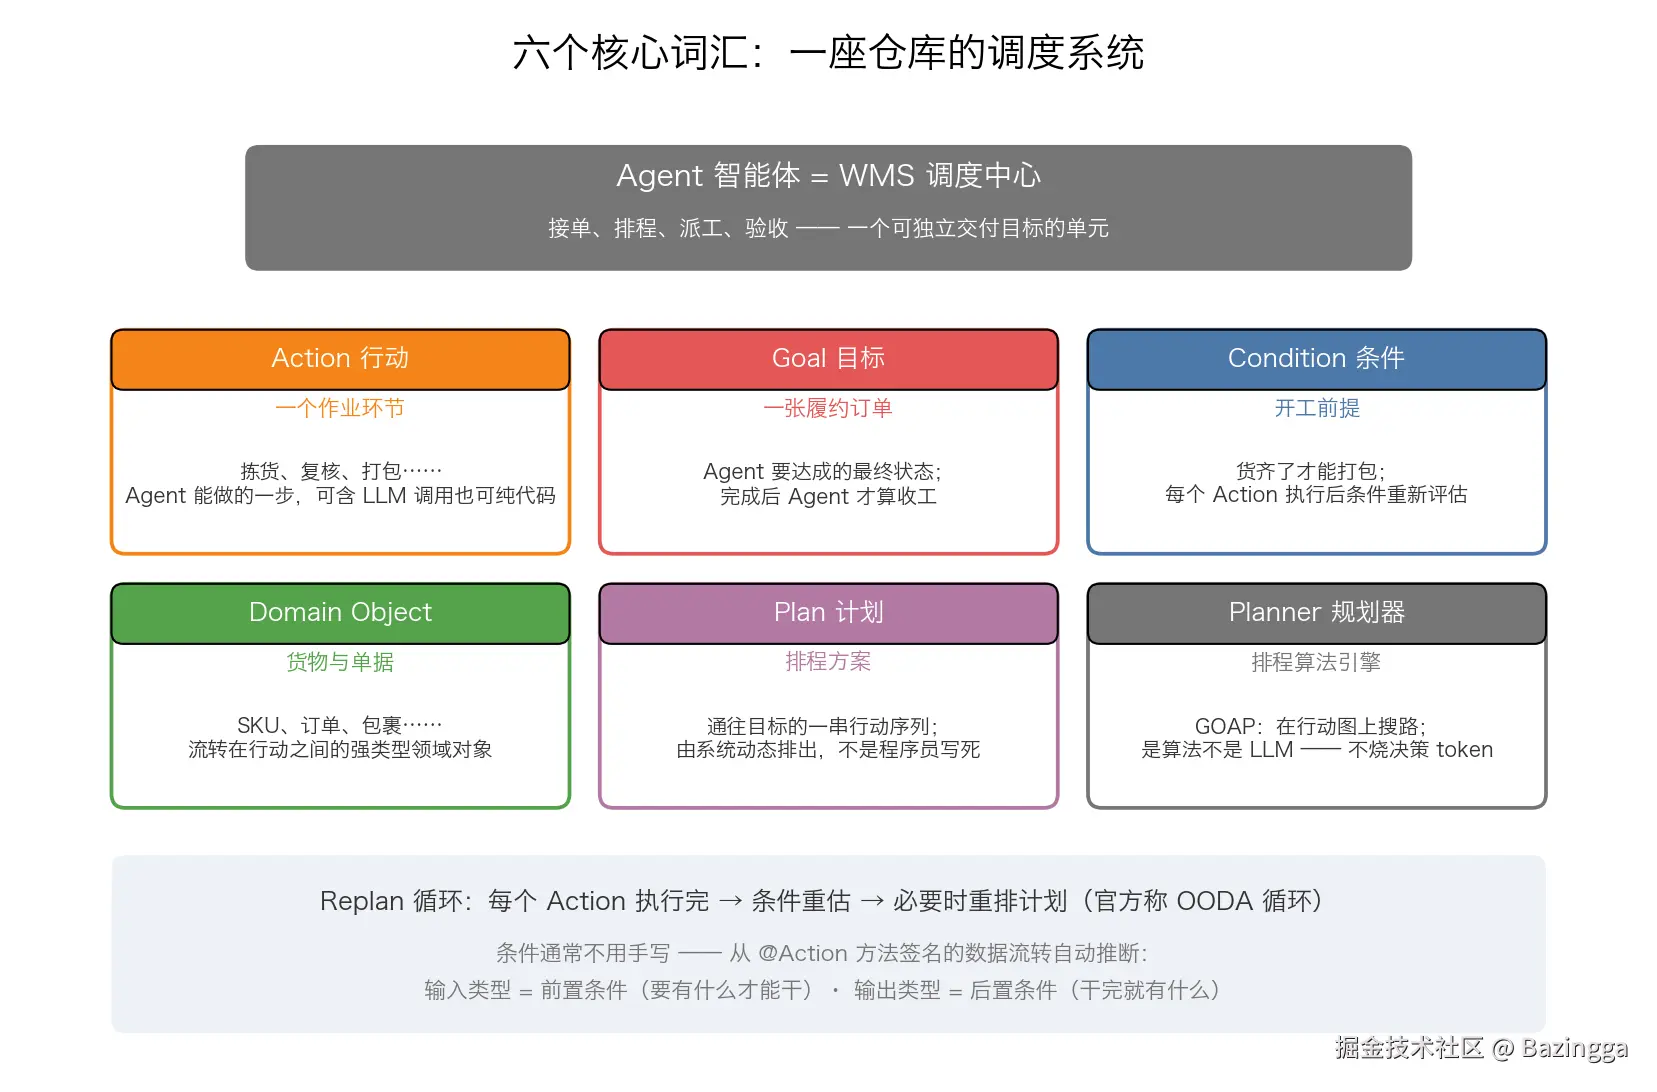
Embabel 的世界观里只有六个词,前五个你在游戏开发领域全都见过:
- Action(行动):一个 Java 方法,可带 LLM 也可纯代码------工位上的作业环节;
- Goal(目标):要达成的最终状态------履约订单;
- Condition(条件):某个事实是否成立(某类型对象是否已产出)------开工前提;
- Domain Object(领域对象):Action 的输入输出类型,推荐用 Java record------流转的物料;
- Plan(计划):规划器排出的 Action 序列------排产结果;
- Planner(规划器):那个不用 LLM 的决策者------排产算法本身。
其中最妙的设计是 Condition 不需要单独声明 ------它直接从 @Action 方法的签名里推断:
java
@Action
DeviceStatus queryRealtimeStatus(DeviceCode deviceCode) { ... }这个签名同时说了三件事:queryRealtimeStatus 这个行动的前置条件 是"世界里有 DeviceCode"、后置条件 是"世界里会有 DeviceStatus"、产出物料是 DeviceStatus 对象。方法签名即声明,行动图即类型依赖图。写 Java 的人第一次意识到:原来类型系统可以当流程引擎用。
三、GOAP:三十年前的游戏 AI,今天来管 Agent
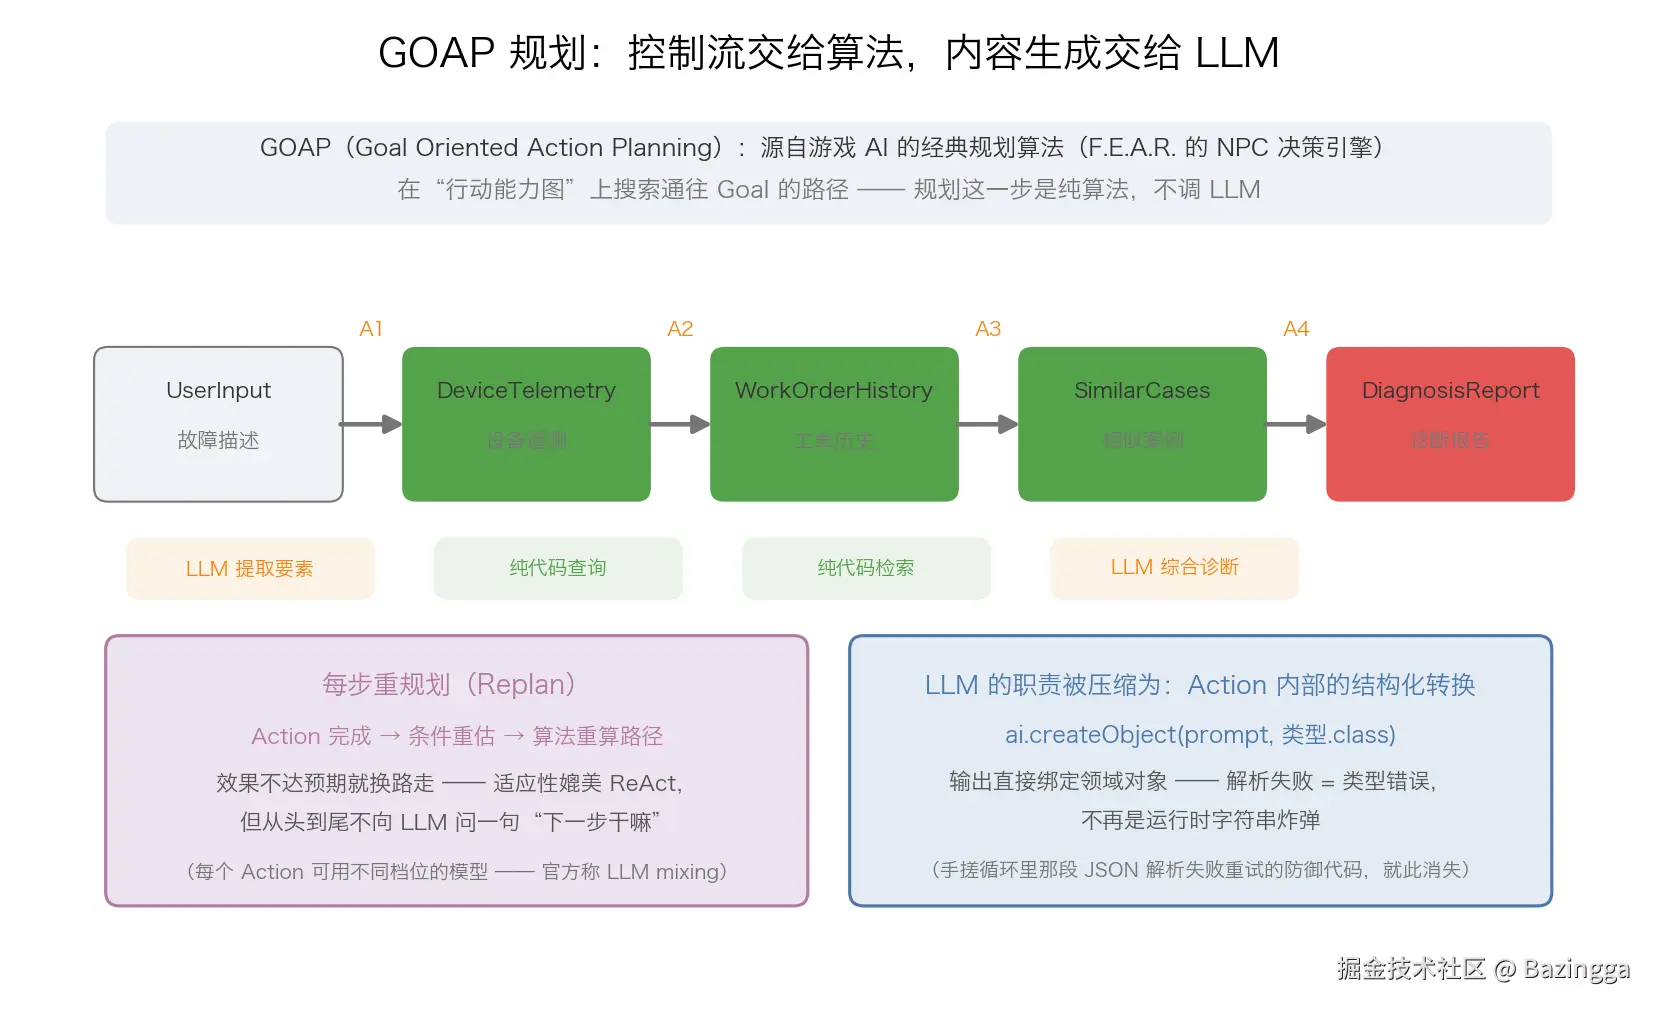
GOAP(Goal-Oriented Action Planning,目标导向行动规划)不是新东西------它的成名作是 2005 年的游戏《F.E.A.R.》,当年用来让游戏 NPC 自己组合出"绕后、换弹、找掩体"的行为序列,让玩家觉得敌人"会动脑子"。它的本质是状态图搜索:把"世界状态"当节点、Action 当边,从当前状态搜出一条能到达目标状态的路径------和地图导航、A* 是一家人。
放到 Agent 领域,翻译过来就是:"先查实时、再查档案、后综合"这个调查顺序,不是 LLM 想出来的,是算法在行动图上搜出来的。搜图不花 token,也不掷骰子------同一个任务每次搜出的路径一致,轨迹可复现。
这里要主动修正一个容易踩的理解偏差(本文写作时官方 README 核实过):GOAP 不是"开头规划一次、照着执行到底"的开环控制。真实行为是每个 Action 执行完,规划器重新评估世界状态、必要时重排计划 ------官方称之为 OODA 循环(Observe-Orient-Decide-Act)。后文的实测日志里,你会看到每执行一步就出现一次 ready to plan,计划随世界状态推进而收缩。 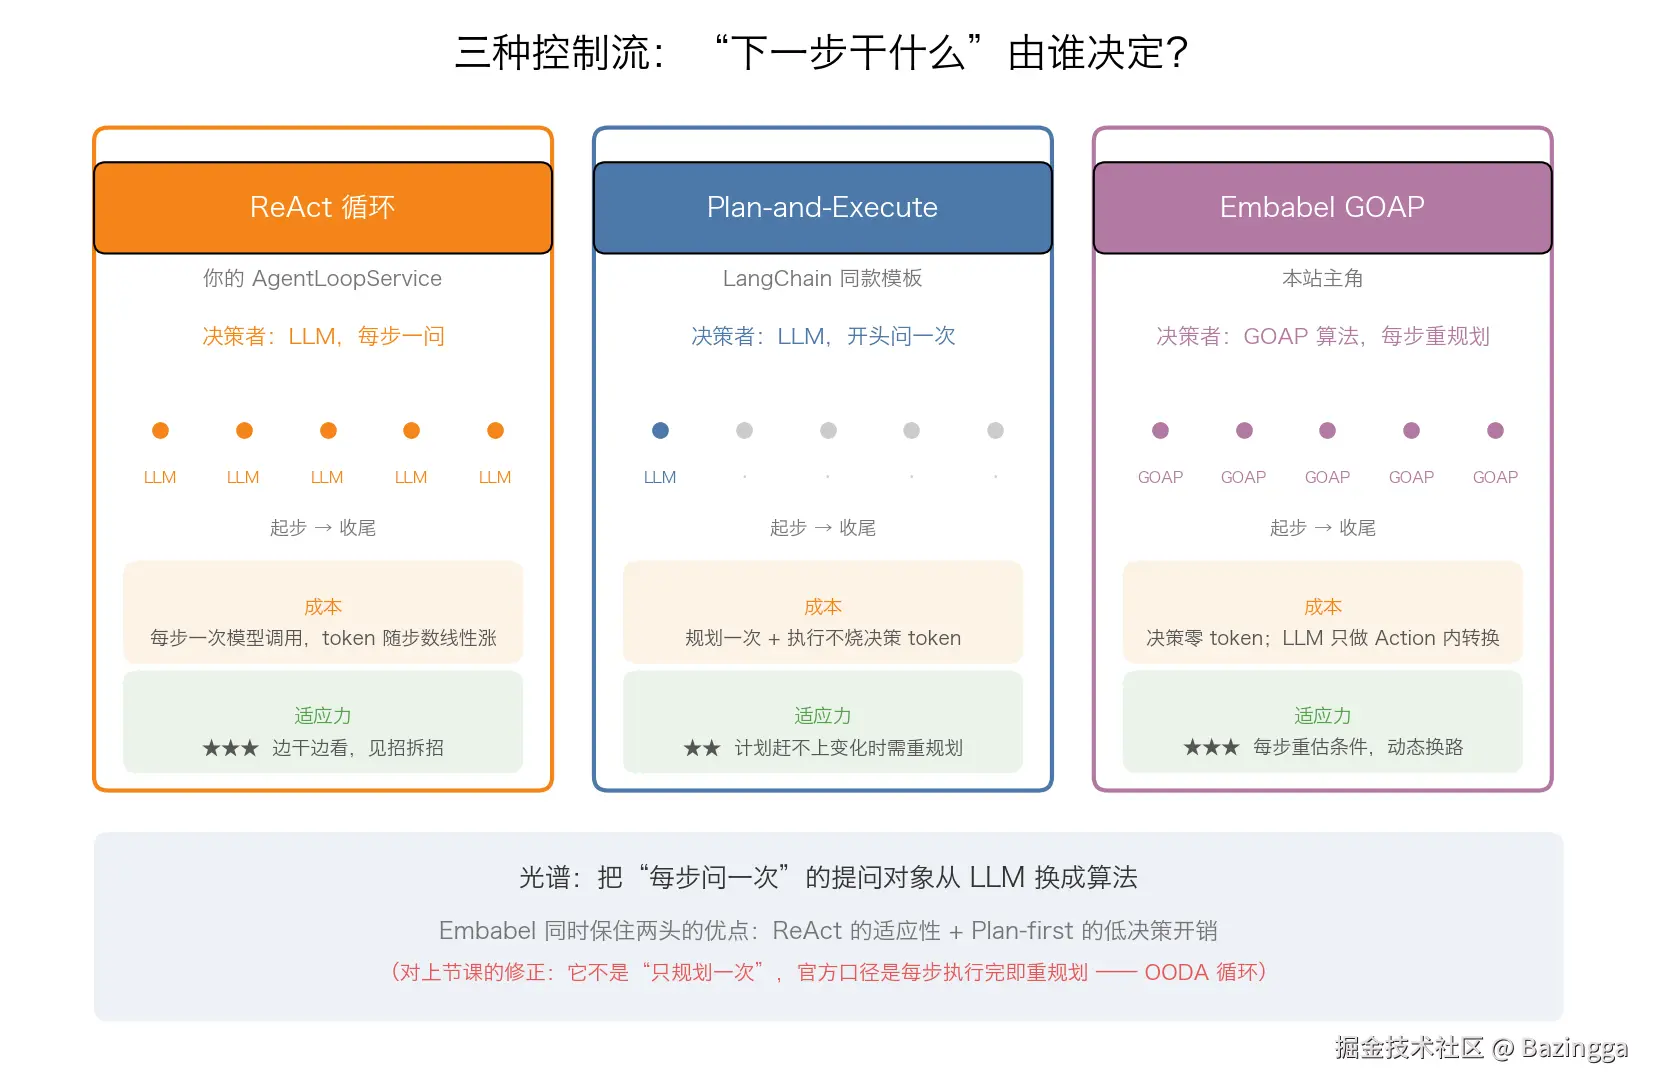
把 Embabel 放进 Agent 控制流的版图里看更清楚。ReAct 循环 = 决策者(LLM)+ 执行者(工具);Embabel 做的事是把决策者换掉------LLM 从"每步指挥交通的交警"降级成"路口间拉货的司机",只在 Action 内部需要语言能力时出场(提取、翻译、综合)。省下的正是决策 token:控制流不再需要向模型请求任何东西。
一个容易混淆的点顺带澄清:GOAP 的规划是状态图搜索,不是算法课上的动态规划(DP)------没有重叠子问题和记忆化填表,只有从现状到目标的路径搜索。"动态地规划"和"动态规划"是两回事。
四、动手一:最小 Agent,三个卖点一次看全
第一个练手任务是工单生成:输入一段设备故障描述,产出结构化维修工单。两个 Action 刻意选择了不同画风:
java
@Agent(description = "从设备故障描述生成结构化维修工单")
public class DeviceWorkOrderAgent {

    @Action
    DeviceIssue extractIssue(UserInput userInput, Ai ai) {
        // LLM 翻译:自然语言 → 结构化(deviceCode / symptom / severity)
        return ai.withDefaultLlm().createObject(prompt, DeviceIssue.class);
    }

    @AchievesGoal(description = "维修工单已生成")
    @Action
    WorkOrder createWorkOrder(DeviceIssue issue) {
        // 纯代码映射:severity HIGH → 优先级 P1 立即派单......零 token
        ...
    }
}
extractIssue 是 LLM 行动(自然语言到结构化的翻译,只有模型干得了);createWorkOrder 是纯代码行动(严重程度到优先级的映射规则,写死的业务逻辑,让模型干纯属浪费钱)。让 LLM 只出现在它不可替代的位置------这是 Embabel 编程的第一直觉。
实测日志(DashScope qwen3.7-plus)三个卖点各对应一段:
csharp
[ready to plan from: {UserInput=TRUE, DeviceIssue=FALSE, ...}]
[formulated plan: extractIssue -> createWorkOrder]        ← 卖点一:GOAP 排程
[executing action extractIssue]
[using LLM qwen3.7-plus, creating DeviceIssue](11.2 秒)
[object bound it:DeviceIssue]                             ← 卖点二:类型绑定
[executed action extractIssue in PT11.2S]
[ready to plan ...](第二次)
[executed action createWorkOrder in PT0S]                 ← 卖点三:LLM 混编
[goal createWorkOrder achieved in PT11.227S]
卖点一:GOAP 排程 。"extractIssue → createWorkOrder"这个顺序没有写在任何 prompt 里,是规划器从两个方法签名的类型依赖推出的。卖点二:类型绑定 ------LLM 返回的 JSON 被 createObject(DeviceIssue.class) 直接绑定成领域对象,喂给下一个 Action,中间零 JSON 解析、零防御代码。卖点三:LLM 混编------11.2 秒的 LLM 行动紧挨着 PT0S 的纯代码行动,天然混在一条流水线上。
日志里还能看到两次 ready to plan------第一次排在两步计划,执行完 extractIssue 后世界状态变了,第二次排出的计划收缩到只剩 createWorkOrder。每步重规划,不是一锤子买卖。
五、动手二:把诊断方法论钉进方法签名
最小 Agent 只是热身。真正的考题是开头那个扎心的问题------把 Agent 站的诊断任务("WH-AGV-003 报障停机,帮我诊断原因并给处理建议")用 Embabel 重写,看看"先实时→再档案→后综合"的方法论能不能从 system prompt 的软约束变成硬约束。
5.1 核心手法:目标行动的多参数签名
答案在一个方法签名里。综合报告这个 Action 故意写成同时吃三路证据:
java
@AchievesGoal(description = "设备诊断报告已生成")
@Action
DiagnosisReport synthesizeReport(DeviceStatus status, ArchiveInfo archive,
KnowledgeHits knowledge, Ai ai) { ... }这个签名在行动图上的含义:要产出 DiagnosisReport,世界里必须先有 DeviceStatus、ArchiveInfo、KnowledgeHits 三个对象。GOAP 规划器搜图时,无论从哪里出发,都必须先排出能产出这三者的行动序列,才能走到目标------跳过任何一路证据,图上根本不连通。
完整的 Agent 五个 Action,方法论顺序由类型依赖自然涌现:
| Action | 角色 | 耗时(实测) |
|---|---|---|
extractTask:任务描述 → 设备编码 |
LLM 翻译 | ~6 秒 |
queryRealtimeStatus:编码 → 实时状态(含故障码) |
纯代码(模拟 IoT) | PT0S |
queryArchive:编码 → 基础档案(含编码体系差异) |
纯代码(模拟主档) | PT0S |
searchKnowledge:故障码 → 知识库命中 |
纯代码(模拟 RAG) | PT0S |
synthesizeReport:三路证据 → 诊断报告 |
LLM 综合 | 46.8 秒 |
注意一个细节:searchKnowledge 的前置条件是 DeviceStatus 而不是 DeviceCode------知识库的检索词是故障码,而故障码只有查完实时状态才有。"先实时后知识库"这条顺序,同样是被签名钉死的。
数据源在这里是模拟版(故障码 E0401、主档查无该编码、编码体系差异 WH-AGV-00x vs AGV-12xxxxx,全部照搬 Agent 站实测轨迹里的真实观察)------学习的焦点是编排结构,不是数据源本身。
5.2 实测:首排即正解,LLM 恰好两次
实测日志比任何论述都有说服力。GOAP 第一次规划就排出完整五步:
csharp
[formulated plan: extractTask -> queryRealtimeStatus -> queryArchive
                  -> searchKnowledge -> synthesizeReport]
[executed action extractTask in PT6.2S]          ← LLM 第 1 次(提取)
[executed action queryRealtimeStatus in PT0S]
[executed action queryArchive in PT0S]
[executed action searchKnowledge in PT0S]        ← 三连 PT0S:零决策请求
[using LLM qwen3.7-plus, creating DiagnosisReport](46.8 秒)
[goal synthesizeReport achieved in PT52.9S]      ← LLM 第 2 次(综合)
整个任务 LLM 恰好出场两次:开头一次翻译(任务→编码),结尾一次综合(证据→报告)。中间三步调查全程零请求、零 token------在 ReAct 版本里,这三步的调查顺序正是靠每轮一次的 LLM 决策请求买来的。
产出的诊断报告质量也值得看一眼:四条原因分析逐条标注知识库引用编号(123)、五条处理建议按处置顺序排列(先回充→查线缆→清洁镜面→换件→补档案)、主档编码体系差异如实说明、超出知识库的建议明确标注"通用经验"。结构化程度比 ReAct 版本更规整------因为在 prompt 里,三路证据是以带标签的证据块形式喂给 LLM 的,它只需要做翻译,不需要一边调查一边记笔记。
5.3 双跑对比:同一任务,两种范式
现在把两个版本并排放好(同任务、同三路证据来源):
| 维度 | 手搓 ReAct(Spring AI) | 类型化 GOAP(Embabel) |
|---|---|---|
| 调查顺序由谁决定 | LLM 每轮现想(prompt 软约束) | 规划器从方法签名搜出(硬依赖) |
| LLM 请求次数 | 3~5 次(每轮决策+生成,轮数随运气波动) | 恰好 2 次(提取 + 综合) |
| 轨迹形态 | 非唯一(同任务两次跑 3 轮/5 轮) | 确定性(行动图上只有一条通路) |
| 方法论跳步风险 | 存在(软约束靠模型自觉) | 不存在(签名不满足,图不连通) |
| 决策 token | 每轮草稿本越滚越大 | 零(控制流不请求模型) |
| 总耗时 | ~28 秒(5 轮版) | ~53 秒(大头是报告生成本身) |
耗时一行要诚实标注口径:两次跑用的模型不同(qwen3.8-omni-flash vs qwen3.7-plus)、报告生成长度不同,请求次数才是可比的硬指标------类型化版本 46.8 秒的大头花在"写报告"上,ReAct 版本最后一轮同样要付这笔钱,省不掉;真正省掉的是前面几轮的决策开销。
5.4 代价:天下没有免费的确定性
只晒优点就是软文了。类型化有个结构性的代价:策略固化在代码里,适应性就交出去了。
ReAct 版本里有一个很精彩的瞬间:模型拿 WH-AGV-003 去查主档,查无此实体------它自己换了检索词,按类型搜了一遍 AGV 清单,探明了两套编码体系的差异。这个"查无→换路"的策略调整,是模型在运行时现场想出来的,没写进任何 prompt。类型化版本里,同样的策略(精确查无后自动展开类型清单)被固化在 queryArchive 的代码里------编码体系哪天变了,改的是 Java 代码而不是 prompt。
一句话总结这个 trade-off:ReAct 用 token 买适应性,GOAP 用代码买确定性。任务方法论越稳定,类型化越划算;任务路径越是"走着瞧",越该把决策留给模型。
六、生产站位:它值得进你的技术栈吗
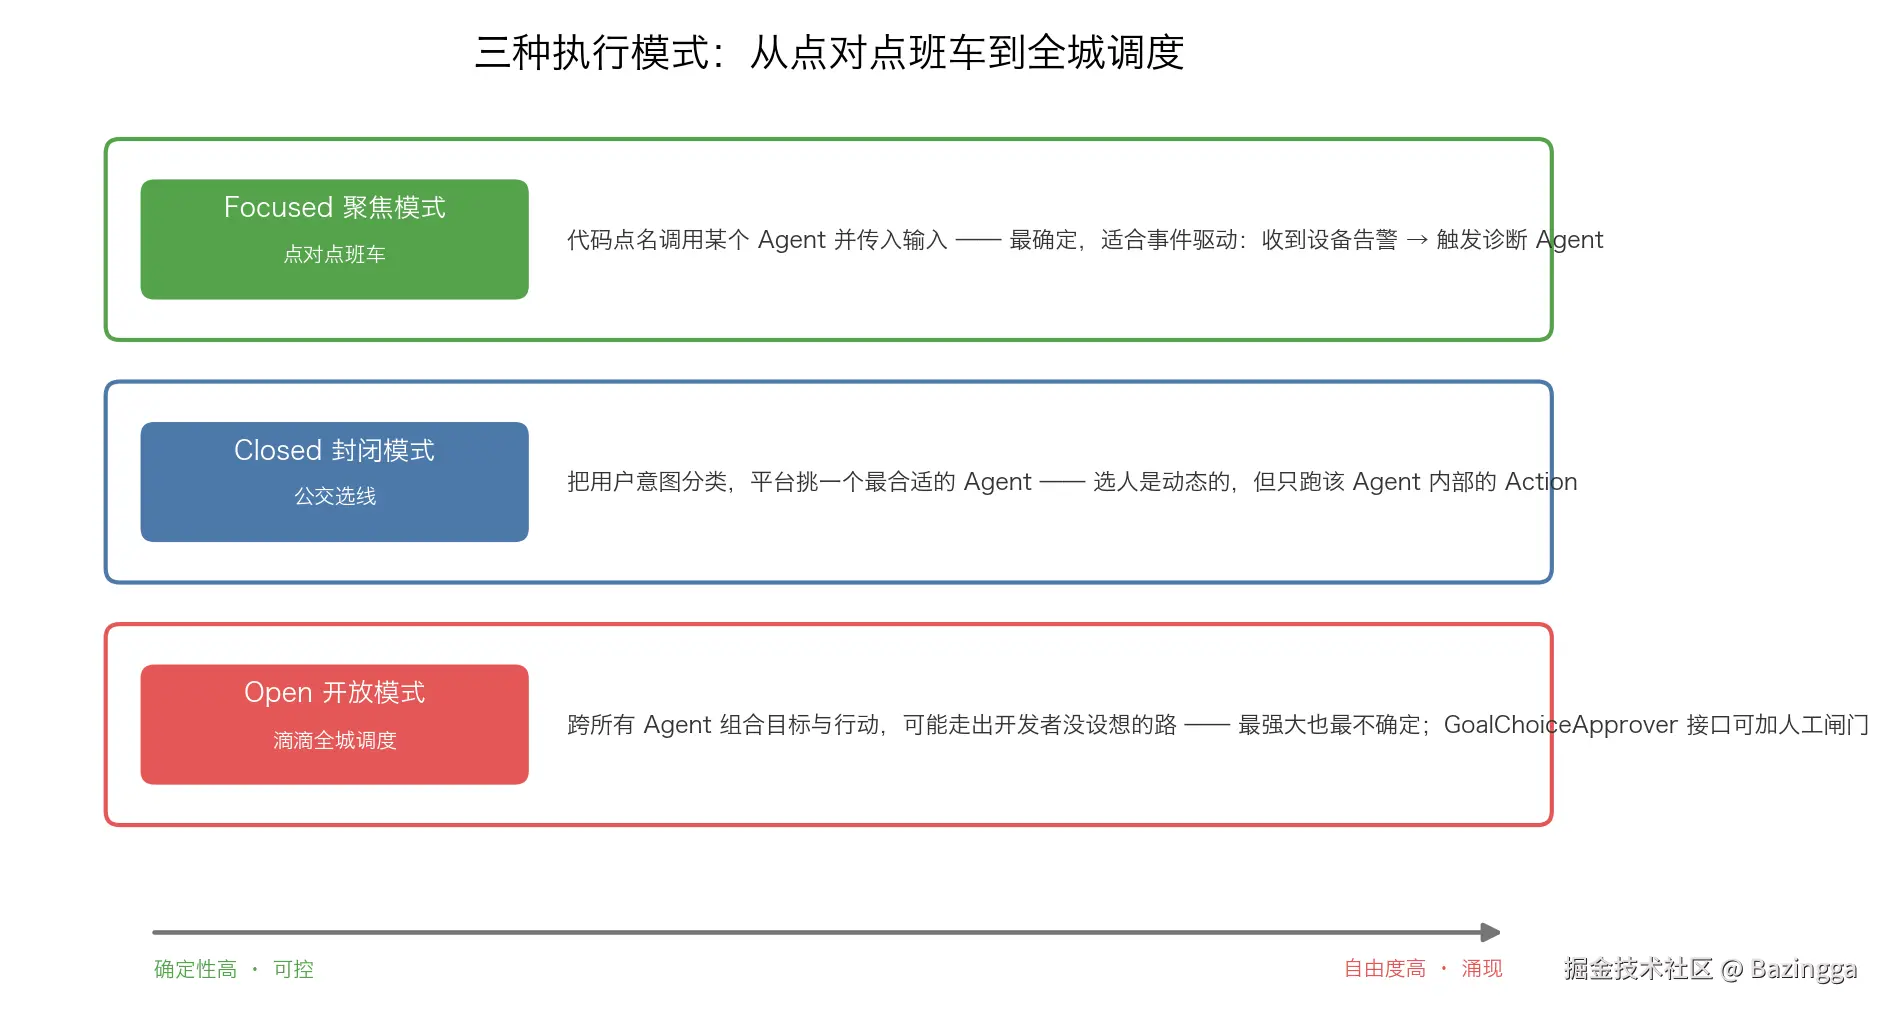
动手之外,还有两个认知拼图。第一个是 Embabel 的三种执行模式:Focused (代码点名调用指定 Agent------本文两个动手任务都是这种,适合事件驱动的确定链路)、Closed (平台做意图分类、从注册的 Agent 里挑一个------像公交选线)、Open(平台在所有已注册目标里现场组合出定制 Agent------像滴滴全城调度,最强也最不确定,生产上要配人工审批闸门)。从 Focused 到 Open,自主性递增、确定性递减------这个谱系和 Anthropic 的"Workflow 到 Agent"阶梯严丝合缝地接上了。
第二个拼图更大:把 Embabel 放进 2026 年的 Java Agent 框架版图里看。
| 框架 | 决策者 | 成熟度 | 杀手锏 | 短板 |
|---|---|---|---|---|
| Spring AI | LLM(ReAct) | GA,主流 | Advisors 链、Spring 原生 | 小版本间 API 变动 |
| LangChain4j | LLM(ReAct) | GA,最广 | Guardrails、20+ 供应商 | 新特性滞后数周 |
| Embabel | GOAP 算法 | 1.x,早期 | 决策零 token、类型化可测试 | 太新,checkpointing 还在路上 |
| Koog(JetBrains) | 显式图 | Beta | 长任务断点续跑 | Java API 是二等公民 |
| Google ADK | 层级 Agent | Pre-GA | A2A 协议原生 | 无 SLA、Gemini 绑定 |
| Semantic Kernel | LLM | GA | Azure 系无缝 | C# 移植感重 |
先回答最实际的问题:Embabel 生产用得多吗? 诚实地说------还不多。1.0 发布于 2026 年 8 月,距今两个月;公开的可参考企业案例还没有形成名单。生产采用度的现状是 LangChain4j 与 Spring AI 双雄领跑、手搓编排沉默地占大头、Embabel/Koog/ADK 都在早期采用者阶段。它的势头是真的(Rod Johnson 光环 + 社区讨论热度 + 迭代速度),但"势头好"和"敢押生产"之间还隔着一年。
更要紧的认知是这个:2026 年大多数生产系统根本不用全自主 Agent 循环。真实主流形态是"确定性代码编排 + LLM 塞在节点里干活"------本文工程的 RAG 链路(摄入→检索→精排→生成)就是这个形态,步骤写死,LLM 只在生成节点出场。Anthropic《Building Effective Agents》的论断在这里依然成立:能用 workflow 就别上 autonomous agent,可预测性、可测试性、成本三样都是 workflow 赢。
那 Embabel 的 GOAP 路线占哪个位置?workflow 与 autonomous agent 之间的过渡地带 :任务的步骤之间有依赖逻辑、组合方式多变,但方法论本身稳定------比如本文的诊断任务(三路证据缺一不可,但每路怎么查是确定的)。对这类任务,GOAP 比死工作流灵活(失败重排、按条件选路),比全自主 Agent 可控(顺序由签名保证)。选型判断一句话:步骤全已知→纯代码编排;方法论稳定、多步要证据→GOAP 类型化;路径不可预知→ReAct 交给模型。
收束:值得带走的三件事
一路学下来,值得写进笔记本的是三件,恰好对应三个层次:
机制层------Agent 循环里的"决策者"是个可替换的零件。本文用同任务双跑证明了:把决策者从 LLM 换成 GOAP 规划算法,决策类请求从 3~5 次降到 0 次,方法论从 prompt 措辞变成类型签名,轨迹从随机波动变成图上唯一通路。这个视角比"XX 框架好不好用"值钱得多------任何框架(Embabel、Koog 的图、LangGraph 的节点)都是这个零件的某种实现。
工程层 ------类型系统可以当流程引擎用。synthesizeReport(DeviceStatus, ArchiveInfo, KnowledgeHits) 这个签名同时是编译期契约、行动图边集、方法论文档------三样东西合成了一个,改流程就是改签名,编译器会告诉你哪里漏了。写 Java 多年的人对这个手感不会陌生:这就是当年 Spring 用接口和注解驯服 XML 配置的那套哲学,换了个领域重演。
判断层------确定性是有价格的。GOAP 用代码买确定性,代价是"查无→换检索词"这类临场应变能力被固化进了 Java 方法;ReAct 用 token 买适应性,代价是轮数波动和跳步风险。没有免费的午餐,只有匹配任务形态的选型:本文的诊断任务方法论稳定,类型化赢得干净利落;但如果明天任务变成"探索这片新仓库里有哪些未知故障模式",该把方向盘还给模型。
Embabel 自己还很年轻,生产检验才刚开始,本文的结论都应该在这个前提下打折使用。但它押注的方向------把工程学的确定性重新带回 Agent 世界------是每一个要把 Agent 从 demo 推向生产的团队都绕不开的命题。从这个角度看,学它的最佳姿势不是立刻押注,而是把它当成一面镜子:照一照你手头那些 ReAct 循环里,有多少轮请求其实是在为"本可以写死的东西"付费。