LingBot-VA 2.0 深度解析:为什么要同时预测未来世界与机器人动作
LingBot-VA 2.0 是一套面向机器人控制的 Video-Action Foundation Model。它不是 LingBot-VLA 2.0 的改名版本,也不是一个把视频生成模型接上动作头的简单组合。
VLA 的典型目标是:
a_t \\sim \\pi_\\theta(a_t\\mid o_{\\le t},l)
即根据观测和语言直接输出动作。
VA 的目标更接近:
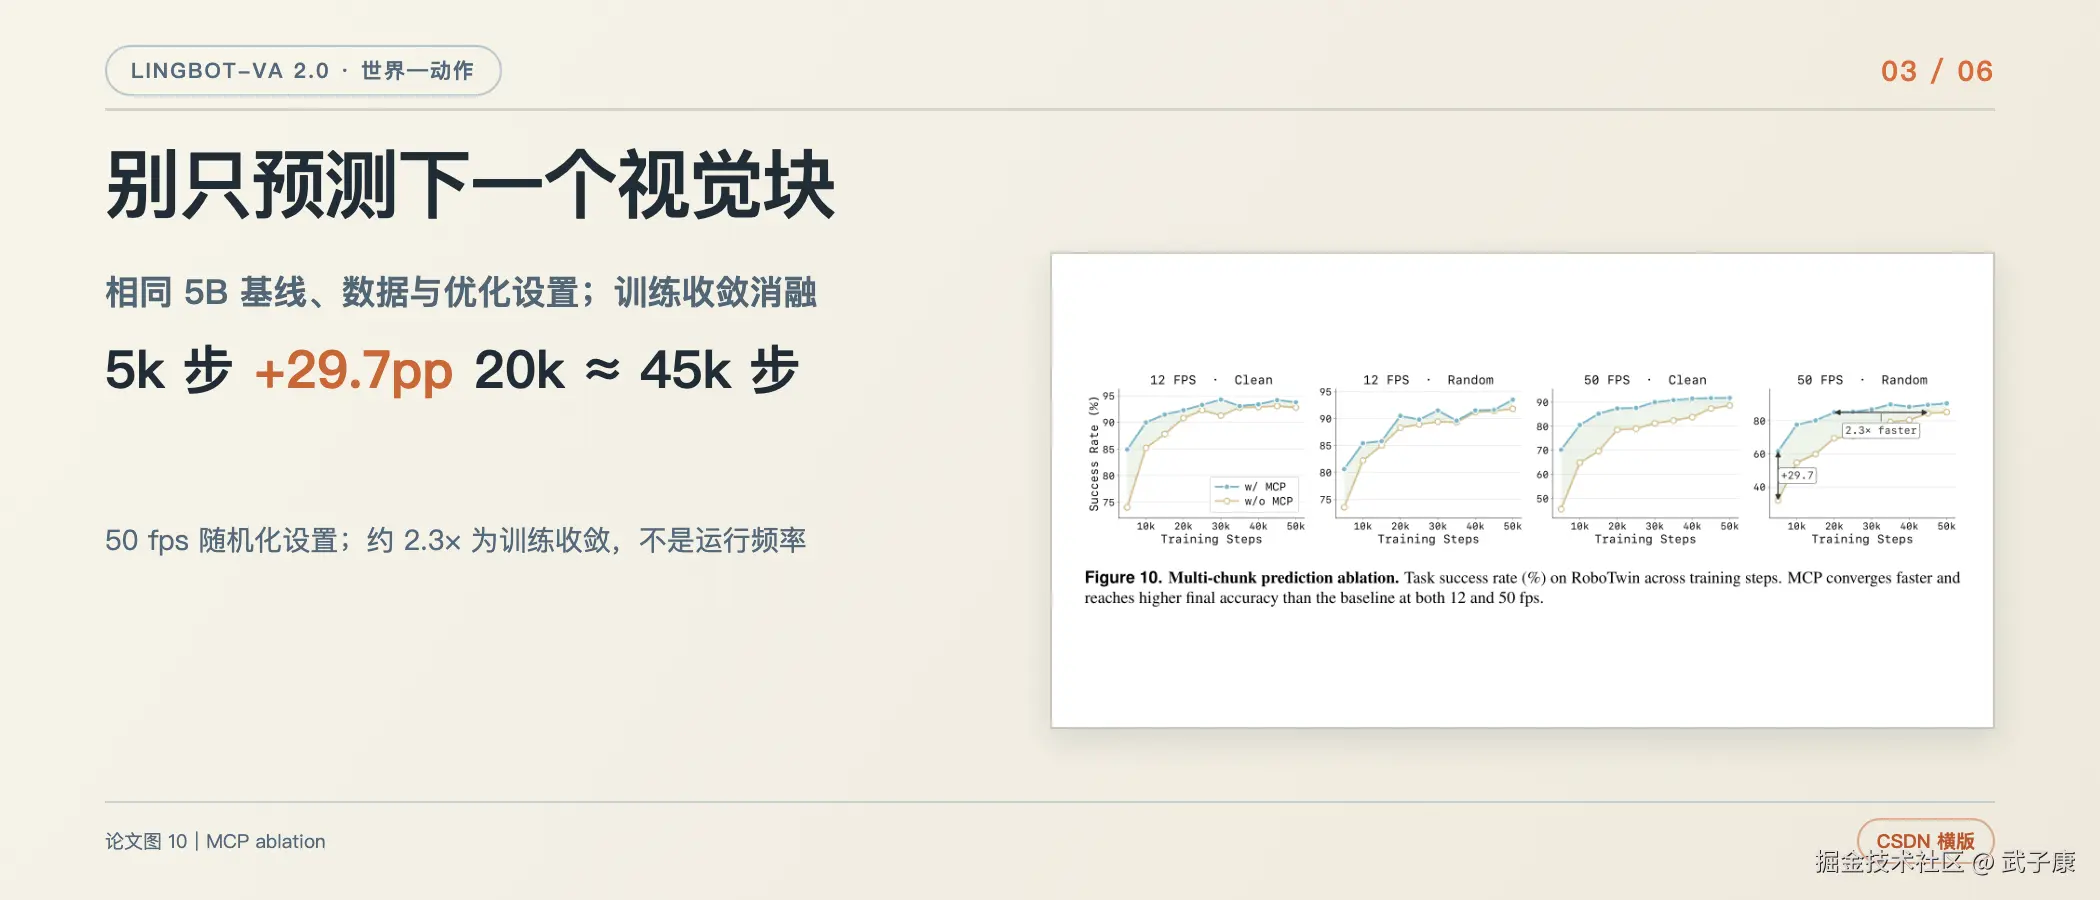
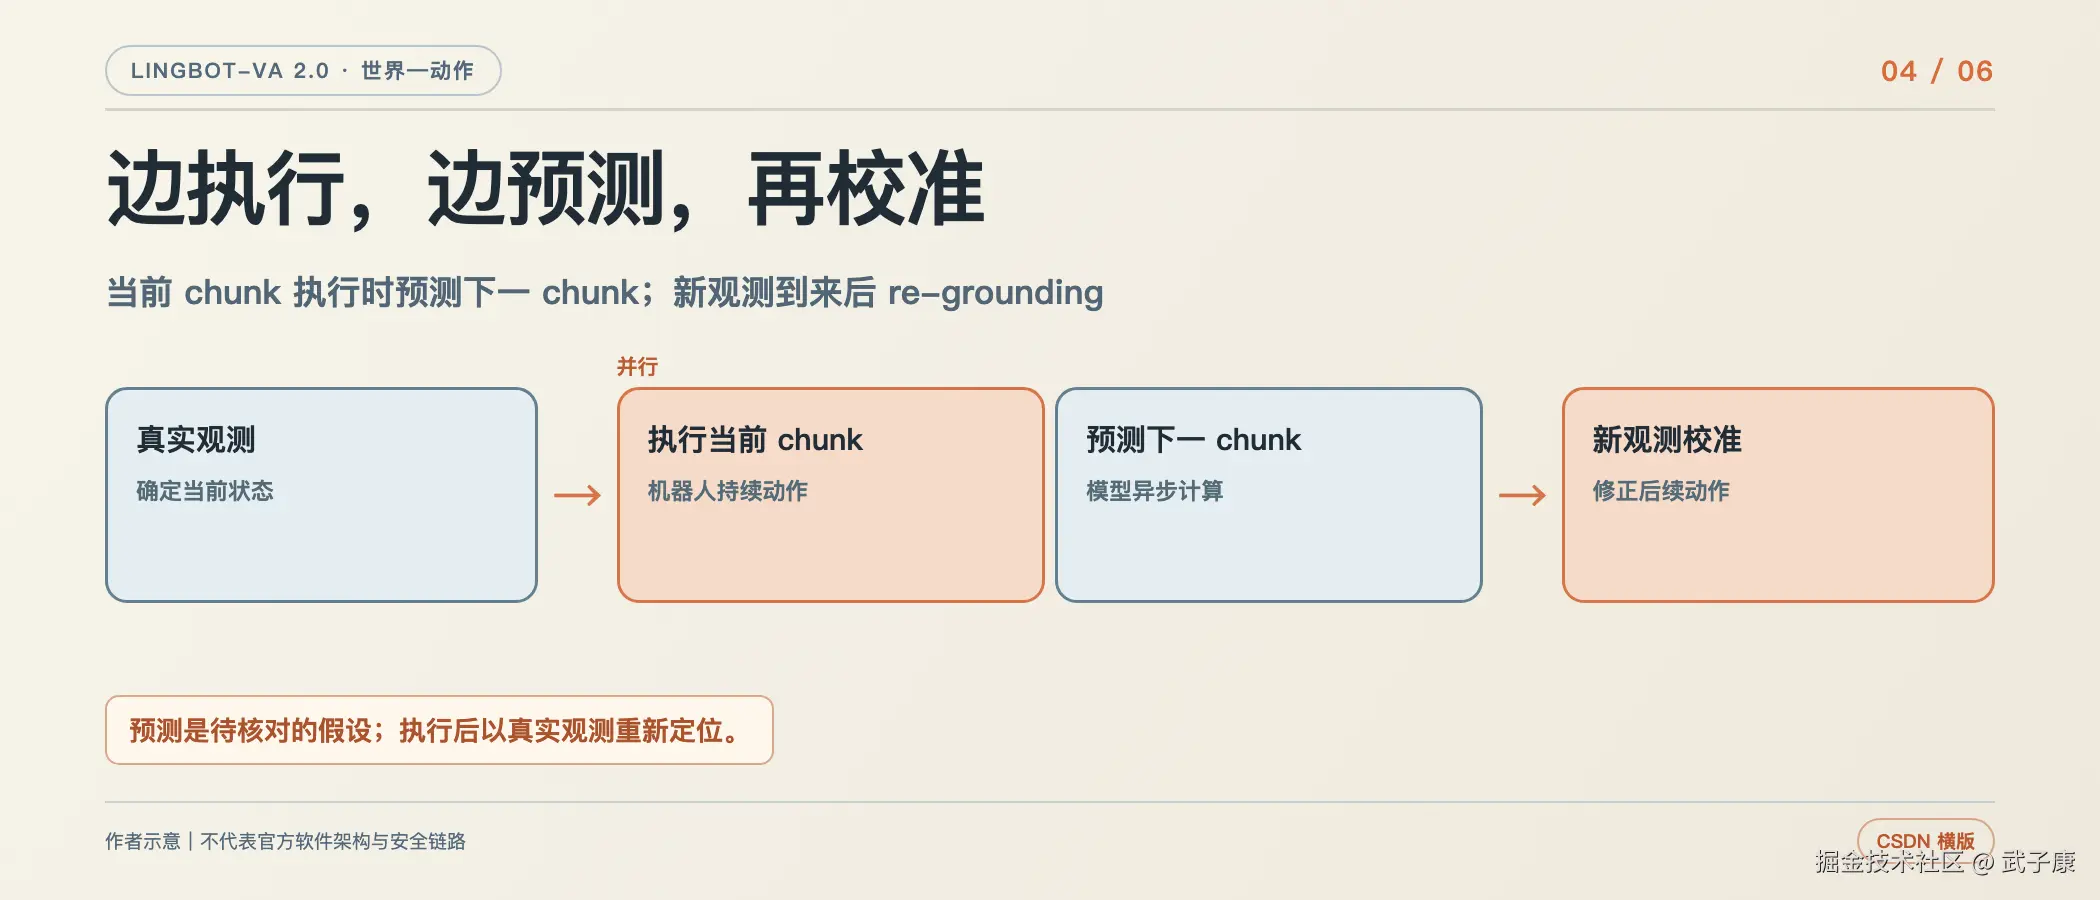
(z_{t+1},a_t) \\sim p_\\theta(z_{t+1},a_t\\mid z_{\\le t},a_{\ 其中 (z) 是视觉状态的 latent。模型同时回答两个问题: 这种建模方式把动作放在世界变化中理解。动作不是一个孤立控制量,而是当前状态到未来状态之间的因果桥梁。 反应式策略可以在许多任务上工作,但存在结构性限制。 模型看到"夹爪靠近杯子"就输出闭合动作,却未必理解闭合后杯子是否真的会被抓住。 若两个动作在当前时刻都合理,预测未来状态有助于分析动作后果;这只是建模动机,不代表 VA 2.0 已公开候选动作反事实搜索接口。 整理桌面、开冰箱、移动物体、清洁炉灶都包含多个子步骤。仅根据当前帧反应,容易重复已经完成的动作,或者在中间失败后无法恢复。 互联网视频和人类第一视角视频没有机器人关节动作。若模型只监督机器人动作,这些视频很难直接使用。VA 通过视觉转移和 latent action,可以从无标签视频中学习"状态如何变化"。 因此,VA 的核心主张是:先学习世界状态和动作之间的因果结构,再把这种结构用于控制。 LingBot-VA 1.0 于 2026 年 1 月公开。它采用自回归扩散框架,在同一个因果序列中交错建模视频与动作,并使用双流 Mixture-of-Transformers、异步执行和 KV Cache。 其信息流可以概括为: 历史视频 latent、历史动作和语言指令经共享因果注意力进入视频专家与动作专家,分别形成未来视觉 latent 与机器人动作。 VA 1.0 的公开仓库直接提供 Image-to-Video-Action 生成入口。因此,它确实能够输出或解码未来视觉序列,但用途是预测机器人动作后果,不是生成商业视频内容。 VA 1.0 的限制在于:其视频表征和骨干仍带有通用视频生成模型的继承路径。通用视频模型通常强调视觉重建和双向建模,而机器人闭环控制严格按时间向前推进。把一个为数字内容生成而训练的模型改造成因果控制器,可能产生表示目标和部署结构之间的不匹配。 LingBot-VA 2.0 的论文标题是 Native Video-Action Pretraining for Generalizable Robot Control。关键词是 Native:从表示、预训练目标到部署方式,全部围绕机器人控制构建。 它的完整逻辑可以概括为: 传统视频 VAE 的目标通常是把像素压缩后再重建。它会保留颜色、纹理和局部细节,但不保证 latent 最适合机器人控制。 例如,对于拿杯子任务,控制真正需要的信息可能是: 而像素重建可能把大量容量用于背景纹理、光照细节和无关物体。 VA 2.0 的 Tokenizer 增加两个方向: 相邻视频帧进入语义视觉---动作 Tokenizer;冻结视觉基础模型提供语义对齐,输出前后视觉状态 latent 与连接变化的 latent action。 这样,即使视频没有机器人关节标注,模型也可以从状态变化中学习动作结构。 论文表 2 给出了 tokenizer 的受控对比:在相同 token 数、相同下游架构和后训练设置下,分别用 WAN2.2 VAE 与作者 tokenizer 从头训练 1.3B Video-Action 模型。RoboTwin 50 任务平均成功率从 Easy/Hard 78.0%/76.0% 升至 86.6%/83.1% ;预测跨度为 3 个 chunk 时,从 67.2%/68.0% 升至 92.0%/85.4% 。这支持语义 tokenizer 在该基准和固定条件下更有利于控制;它不能单独证明跨本体真机收益,也不是本文本地复现。论文表 2 VA 2.0 不把世界状态和动作看成完全分离的模态,而是尝试把二者放在一个语义一致的空间中。 可以把动作理解为: u_t \\approx f(z_t,z_{t+1}) 也就是"从当前状态走向下一状态所需要的变化"。 对于有机器人动作标注的数据,latent action 可以和真实关节动作对齐;对于无标注人类视频,latent action 提供弱监督。这样,互联网视频、人类演示和机器人轨迹可以在统一框架中贡献训练信号。 这不意味着人类动作会自动无损映射到任意机器人。跨本体仍然需要动作头、后训练和机器人适配。它解决的是预训练阶段的动作语义利用问题,不是直接消除本体差异。 闭环控制的时间结构是单向的: 部署时不可能看到未来真实帧。因此,若预训练使用双向注意力,模型在训练中可能依赖部署时不可用的信息。 VA 2.0 从头训练因果 Diffusion Transformer,预测未来视觉 latent 与连接状态转移的动作。语言指令通过交叉注意力提供条件。 因果 DiT 使每个视觉位置只读取历史视觉与历史动作,语言指令作为条件进入各时间位置;训练时不得偷看部署时才会出现的未来真实帧。 每个时间位置只能使用历史信息。这样可以缩小预训练和部署之间的结构差异。 视频动态和机器人控制同时需要: 单一 Dense 网络扩大容量会直接增加每步计算量,而控制系统要求低延迟。VA 2.0 使用稀疏 MoE,在扩大总参数容量时,每个 token 只激活部分专家。 MoE 的收益是容量与活跃计算解耦;代价是路由、专家装载、通信和量化部署更复杂。论文中的高频控制并不是仅靠 MoE 达成,还依赖少步一致性蒸馏、量化执行和系统级开销优化。 相邻视频块通常变化很小。只预测下一个 chunk 时,模型可能通过复制外观得到较低损失,却没有学到真正的长程轨迹。 Multi-Chunk Prediction 的辅助头仅对视觉流的多个未来 latent 块施加监督;动作解码通过共享注意力与逆动力学路径间接受益。它不在训练时直接监督多个未来动作块: \\mathcal{L}*{MCP}=\\sum*{h=1}\^{K}\\lambda_h\\mathcal{L}\\left(\\hat z_{t+h},z_{t+h}\\right) 这样模型必须表示更长期的动态,而不是只维持下一瞬间的视觉连续性。 例如"伸手---抓住---抬起---移动---放下"任务中,下一个块可能只看到手臂略微移动;多个未来块会迫使模型理解完整操作趋势。 论文图 10 在相同 5B Video-Action 基线、数据和优化条件下比较有无 MCP 的后训练。50 fps 随机化设置训练到 5k 步时,MCP 组成功率高 29.7 个百分点 ;MCP 组在 20k 步达到基线 45k 步的准确度,作者称约 2.3 倍训练加速 。这个消融支持 MCP 改善该设置的收敛效率,不能由此推断任意任务的最终成功率、真机控制频率或各组件联用的独立贡献。论文图 10 与消融说明 人类第一视角视频具有场景和任务多样性,但缺少机器人动作标签。机器人数据有精确动作,却规模小、采集昂贵。 VA 2.0 通过语义状态 latent 和 latent action 同时使用两类数据: 这条路线的价值在于把"动作知识"的来源从机器人示范扩展到大规模视频。风险在于人类手部运动、视角、速度、接触方式与机器人存在明显 domain gap。联合训练能否稳定转移,仍需在更多本体和任务上独立验证。 论文展示了一种视觉上下文学习方式:给模型一段人类参考视频,再给当前机器人观测,模型根据视频中的程序执行新任务,不进行参数更新。 人类参考视频提供任务程序上下文,机器人当前观测提供即时状态;模型据此预测未来视觉状态与可执行动作,不通过参数更新记忆新任务。 论文中的独立 ICL 演示先在四个任务上训练,每个任务 15 个示范,然后在未见过的任务组合上用参考视频作为上下文执行。 这说明"10--15 个示范"和"零样本"不能被泛化成所有任务只需要十几个样本。论文中的少样本和零样本结果存在具体任务、对象、场景和预训练条件,不能直接当作任意机器人部署保证。 世界模型通常比纯动作策略慢。若机器人必须等待未来视频预测完成再执行,模型延迟会直接变成控制延迟。 VA 2.0 的 Foresight Reasoning 采用异步执行: 问题是模型预测可能基于旧的想象状态。如果真实机器人因为摩擦、遮挡或抓取失败偏离预测,继续使用旧 latent 会造成误差积累。 VA 2.0 在每轮使用最新真实观测重新落地: VA 2.0 先给出当前动作块;机器人执行时,模型并行推演后续视觉状态与动作。摄像头送来新观测后,模型重新校准预测,再输出修正的下一动作块。 这套机制的关键不是"预测永远正确",而是预测和执行并行,并允许真实观测不断纠偏。 论文表 3 报告,通过少步一致性蒸馏、低精度编译、长序列注意力和运行时开销优化,推理时间从 927 ms/chunk 降至 142 ms/chunk,峰值异步等效频率从 35 Hz 提升到 225 Hz。表中的计算口径固定每个 chunk 含 32 个低层控制步,即 这两个数字不矛盾。142 ms 是一次 chunk 预测的时长;225 Hz 是论文按固定 chunk 步数折算的峰值异步频率。机器人可以在模型生成下一 chunk 时继续消费当前 chunk。 因此,225 Hz 不表示模型每秒完整生成 225 段未来视频,也不表示所有硬件都能达到该频率。它依赖: 在本轮核对的官方入口未见 VA 2.0 可运行代码和权重,因此本文未在本地验证这个数字。论文表 3给出的是作者实验条件下的结果。 长时序任务需要高层规划和低层控制分工。论文加入分层 VLM Planner,把目标分解为结构化子任务,再由低层 VA 策略执行。 这使世界模型不必在每个低层控制步重新推理完整长任务。不过 Planner 的错误会向下传播,低层策略也需要能识别子任务已完成或无法完成。 答案是:能预测并生成未来视觉序列,但目的不是内容创作。 需要区分三个层级: VA 1.0 已有公开 Image-to-Video-Action 脚本,可以直接看到未来画面与动作。VA 2.0 论文中的核心也是预测未来视觉 latent 和动作;截至 2026 年 9 月 26 日,在本文核对的官方项目页与仓库中未见 VA 2.0 可运行权重,无法给出对应的官方视频导出命令。 它的视觉输出更关心: 它不以电影级美学、人物表演、镜头语言或长篇叙事为主要目标。 论文在 RoboTwin 2.0 的 50 个双臂任务上报告: 论文还报告: 这些都是作者报告结果。在本文截至 2026 年 9 月 26 日核对的官方入口中,未见 VA 2.0 可运行代码与权重供社区独立复现,因此不能把论文表格等同于已验证的通用性能。 这是 VA 2.0 与 VLA 2.0 最大的工程差异。 截至 2026 年 9 月 26 日,对本文所列官方入口的核查结果: VA 1.0 仓库中已经放入 VA 2.0 论文 PDF,但仓库代码、模型下载表和运行说明仍对应 VA 1.0。论文文件出现在仓库中,不代表 VA 2.0 权重和实现已经发布。 论文 v2 已报告约 15.3B 训练总参数、推理时每 token 约 2.5B 激活参数,其中视频骨干约 13.0B 总量/1.9B 激活,动作专家约 0.6B,MCP 训练头约 1.7B。论文参数规模段可直接核对这些数值;MCP 头用于训练监督,标准推理仅运行骨干。激活参数量不能当作完整模型驻留量;权重格式、Tokenizer、KV Cache、offload 和执行配置仍缺少公开的 VA 2.0 可复现运行契约。因此,本文不能给出 VA 2.0 的可信显存要求或 A6000 运行保证。 VA 1.0 的官方配置明确: 官方软件要求: Attention 配置必须手动区分: 使用错误模式会导致训练或评估失败。 48GB 是 A6000 的名义显存容量,高于官方带 VAE、Text Encoder CPU Offload 条件下的 18/24GB 说明;这不能证明 A6000 实机运行、关闭 offload 后的占用或 8 卡训练吞吐。VA 1.0 的硬件适配仍需按具体版本、配置和设备实测,与 VA 2.0 的显存问题分开记录。官方 VA 1.0 README列明了上述 offload 条件。 LingBot-VLA 2.0 的主输出是动作,LingBot-VA 2.0 同时建模未来视觉状态与动作;两者不能仅凭论文基准互换。需要动手复现 Video-Action 路径时,当前可从有公开代码和权重的 VA 1.0 开始;要验证 VA 2.0 的原生 tokenizer、MCP 与 Foresight 整体收益,则仍需等待对应实现与权重,并在同一任务和设备上比较。本文重点是这条世界---动作因果链及其证据,不提供 VLA/Video 的重复选型清单。 模型可能生成看起来合理的未来画面,但动作精度没有提升。论文已有 tokenizer 的 RoboTwin 消融与 MCP 的训练收敛消融;仍需在其他本体和真实机器人任务上,固定数据与控制链路,比较有无视觉预测、不同预测跨度及实际动作精度。 预测失误可能让机器人提前执行错误动作。Foresight re-grounding 能纠偏,但纠偏速度和失败边界需要真机测试。 语义表示有利于任务理解,但精细抓取需要毫米级位姿和接触状态。语义与几何之间存在取舍。 高频输出不等于低延迟闭环。必须测量动作缓存深度、观测陈旧度、网络抖动和紧急中断响应。 程序性知识可能迁移,但人类手部动作、视角和物理能力与机器人不同。需要按任务和本体报告收益,而不是只给总平均值。 LingBot-VA 2.0 的核心思想是:机器人不应只根据当前画面反应,而应在行动时持续预测世界如何变化,并用最新真实观测修正预测。 它通过五个关键设计实现这条路线: 它能生成未来视觉状态,但视觉生成是控制推演的一部分,不是内容产品。截至 2026 年 9 月 26 日,在本文核对的官方项目页与仓库中未见 VA 2.0 可运行权重与完整实现,因此无法给出可信的本地部署配置。现阶段可运行的开源参照是 LingBot-VA 1.0。
世界接下来会变成什么状态?
机器人应该执行什么动作?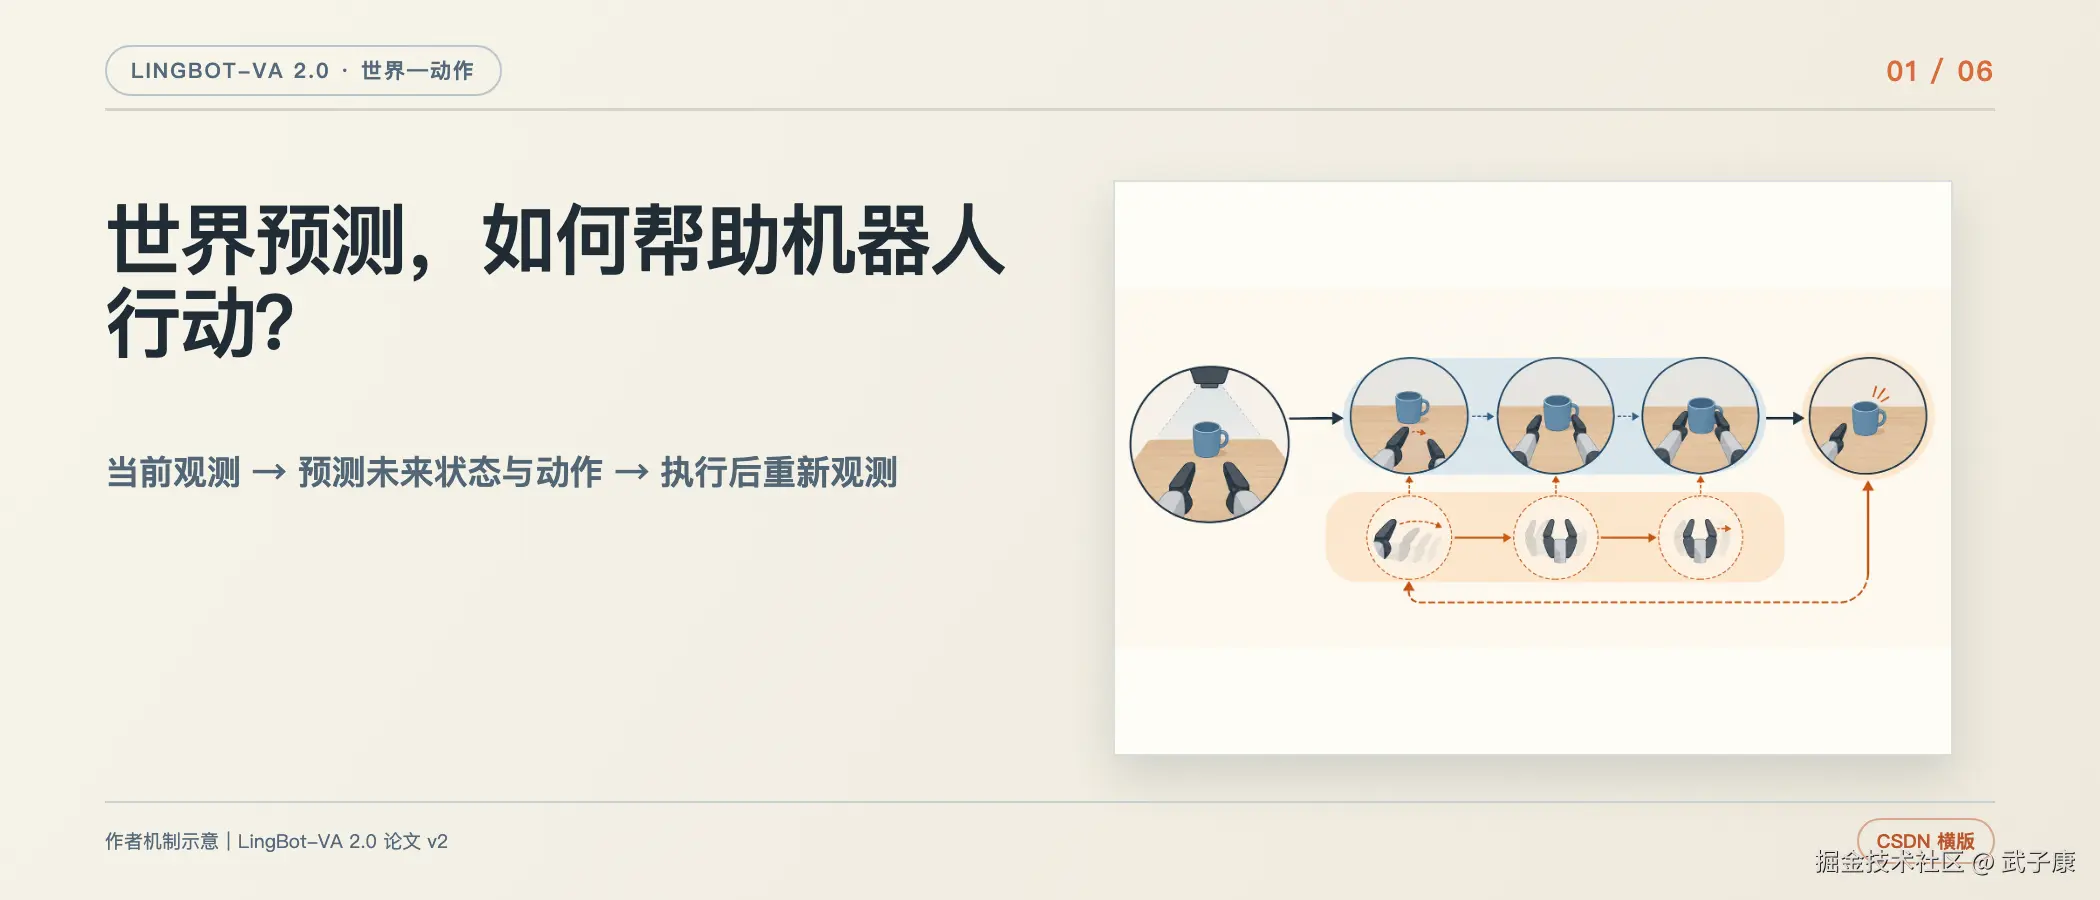
VA 为什么可能比纯反应式 VLA 更适合长时序控制
它可能只学到视觉捷径
它难以表示动作后果
它容易在长任务中丢失任务进度
它难以利用无动作标注视频
LingBot-VA 1.0 已经做了什么
VA 2.0 的核心变化:从头按控制需求设计
语义视觉---动作 Tokenizer
        ↓
共享世界状态与 latent action 空间
        ↓
从头训练严格因果的 Video-Action DiT
        ↓
Sparse MoE 扩大容量
        ↓
Multi-Chunk Prediction 学习长轨迹动态
        ↓
人类视频 + 机器人数据联合训练
        ↓
Foresight Reasoning 异步预测与执行
        ↓
最新真实观测重新落地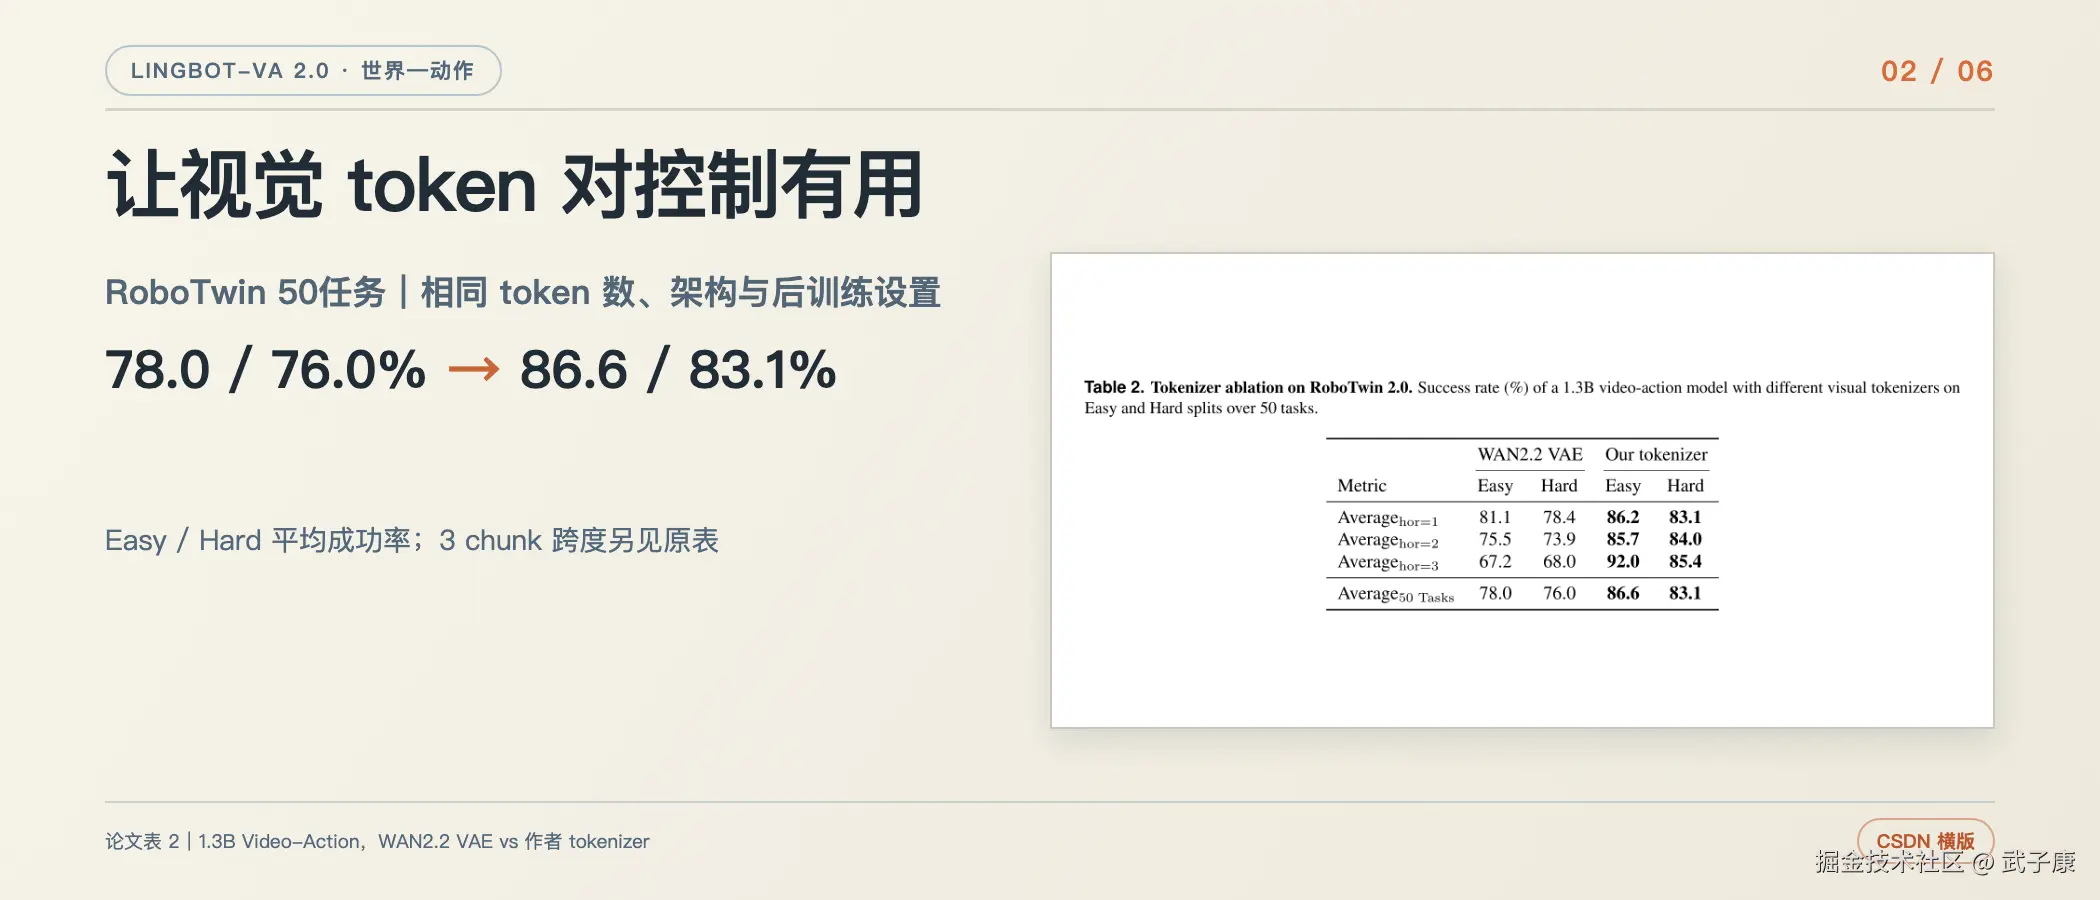
语义视觉---动作 Tokenizer
共享状态与动作 latent 空间
严格因果的 DiT
过去观测 → 当前动作 → 未来结果Sparse MoE 为什么出现在机器人控制模型中
Multi-Chunk Prediction 解决什么问题
人类---机器人联合训练
互联网/人类视频:提供视觉世界动态和程序性操作知识
机器人轨迹:提供可执行动作和本体映射In-Context Learning:用示范视频代替文字指令
Foresight Reasoning:边行动边预测
机器人执行当前动作块
          ║ 同时
模型预测后续视觉状态与动作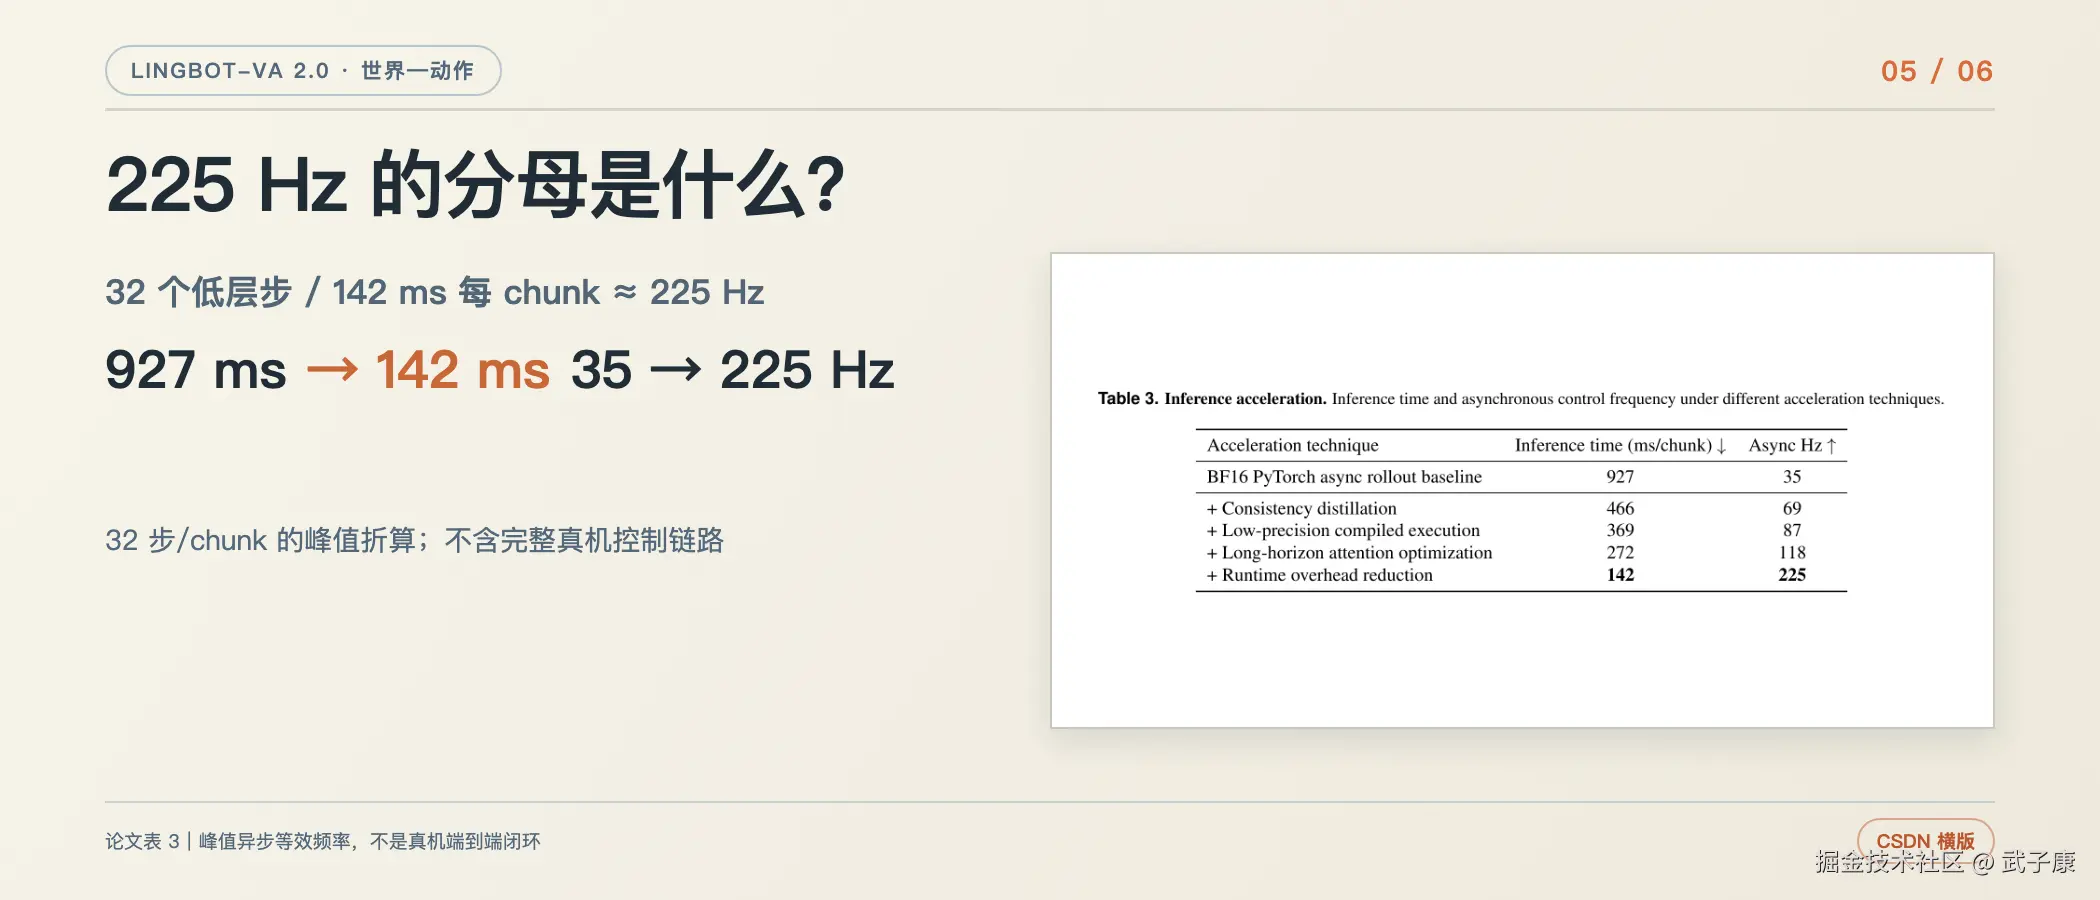
225 Hz 应该怎样理解
1000 / 142 × 32 ≈ 225 Hz;这不是端到端闭环实测控制率。
分层 VLM Planner
高层目标:整理桌面并把杯子放入托盘
        ↓
1. 定位杯子
2. 清除抓取路径
3. 抓取杯子
4. 移动到托盘
5. 放下并确认
        ↓
每个子任务交给 Video-Action 低层策略它能不能生成视频
模型
视觉输出
主要目的
LingBot-Video
完整可观看视频
内容与具身视频生成
LingBot-World
连续、可控制的视频世界
交互式环境模拟
LingBot-VA
未来视觉 latent 或解码帧
预测动作后果和控制机器人
论文报告的结果
方法
Clean
Randomized
平均
LingBot-VA 1.0
92.9
91.6
92.2
LingBot-VA 2.0
93.8
93.4
93.6
当前开源状态
内容
VA 1.0
VA 2.0
论文
已公开
已公开
项目页
已公开
已公开
官方代码
已公开
未发现独立公开实现
基础权重
已公开
未发现
RoboTwin 权重
已公开
未发现
后训练代码
已公开
未发现
本地推理命令
已公开
未发现
许可证
Apache 2.0
无独立代码仓库可核实
当前可以运行的是 VA 1.0
场景
官方显存说明
Image-to-Video-Action 单卡推理
约 18 GB,VAE 和 Text Encoder CPU Offload
RoboTwin 单卡评估
约 24 GB,VAE 和 Text Encoder CPU Offload
后训练
FSDP 分布式训练
Python 3.10.16
PyTorch 2.9.0
CUDA 12.6
Diffusers 0.36.0
Transformers 4.55.2
FlashAttention
训练:attn_mode = "flex"
推理:attn_mode = "torch" 或 "flashattn"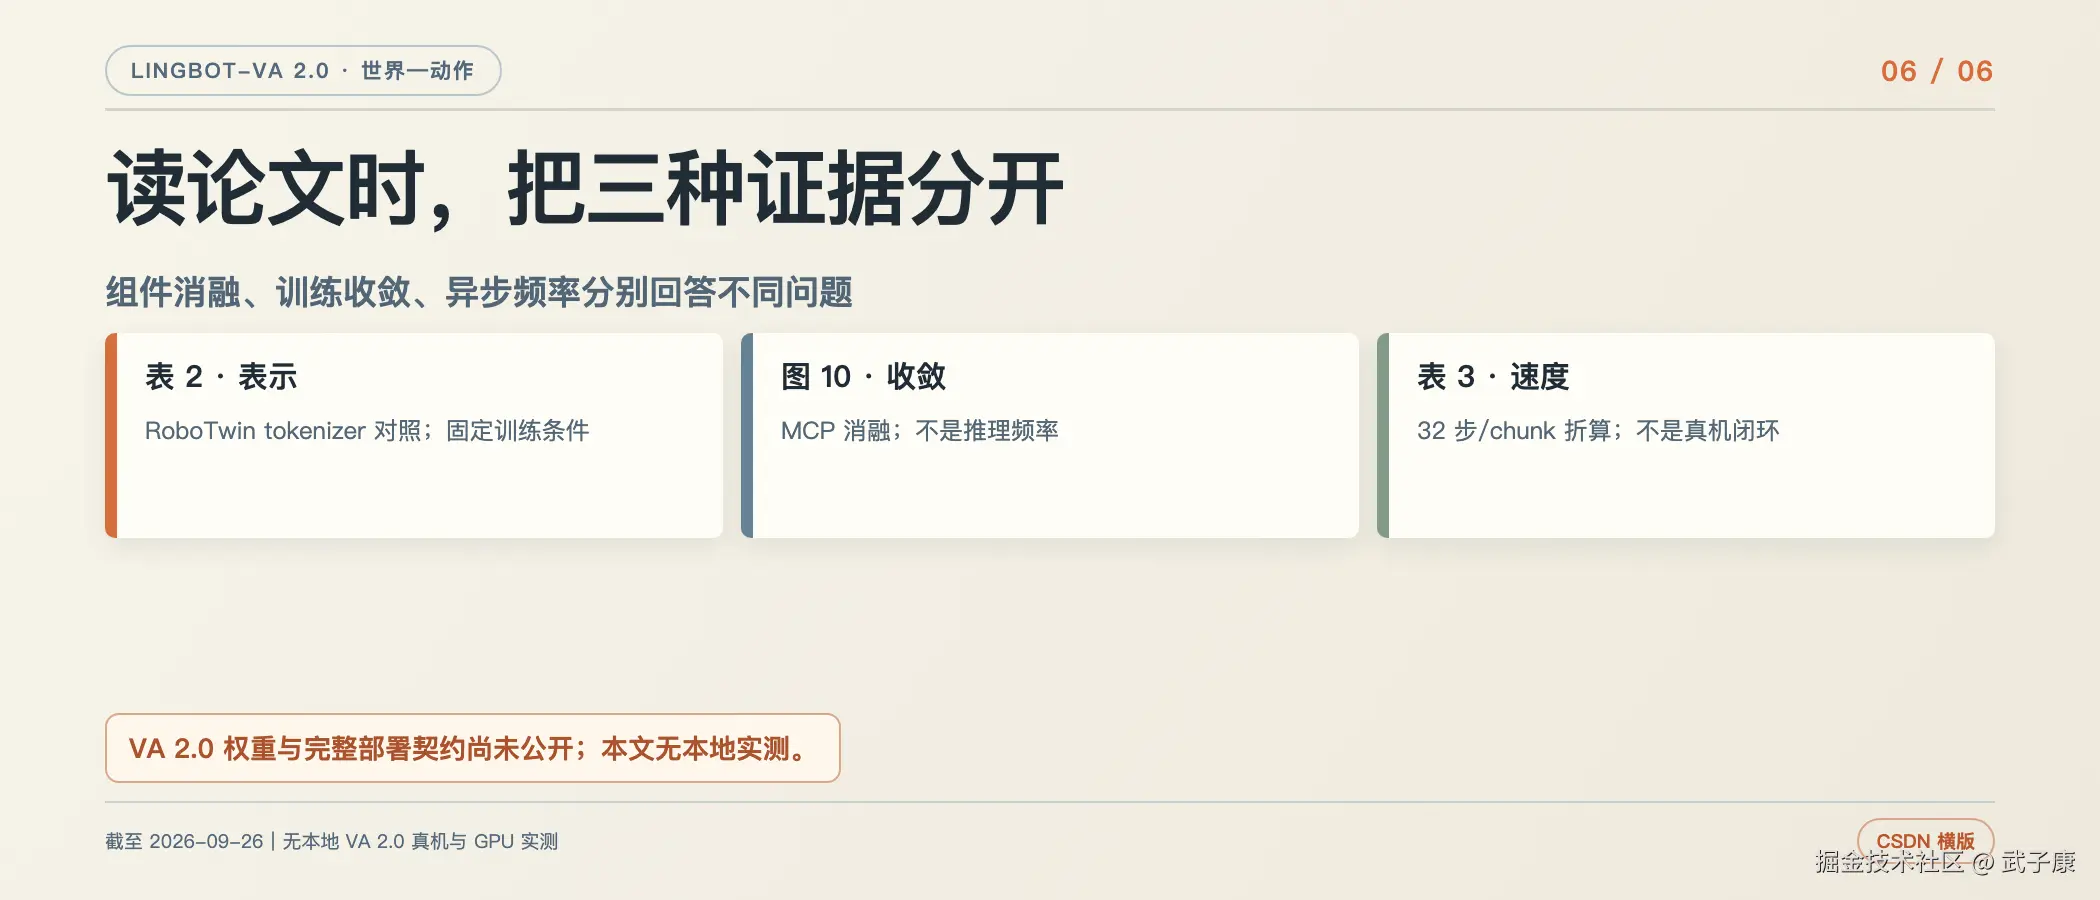
与现有开源路径的边界
VA 路线真正需要验证的几个问题
视觉预测是否真正改善动作
世界模型错误是否会误导控制
视频 latent 是否保留精细几何
异步控制是否稳定
人类视频能否跨本体迁移
结论
语义视觉---动作 Tokenizer
严格因果的 Video-Action DiT
Sparse MoE
Multi-Chunk Prediction
Foresight Reasoning + 真实观测 re-grounding参考资料