前面几篇把 Flink 窗口的各种类型(滚动、滑动、会话、计数、全局)和聚合函数都讲透了。但有一个根本性的问题还没深入:窗口按什么时间触发?是按数据到达的时间,还是按数据本身携带的时间?这就是 Flink 的时间语义(Time Semantic)。
时间语义是 Flink 流处理的核心概念之一,也是最容易踩坑的地方。用错时间语义,统计结果可能完全错误------比如计费系统按数据到达时间统计,而不是按订单发生时间,导致对账失败。
Flink 支持三种时间语义:处理时间(Processing Time)、事件时间(Event Time)、摄入时间(Ingestion Time)。生产环境 90% 的场景用事件时间,但事件时间需要配合 Watermark 机制来处理乱序和迟到数据。
这篇从三种时间语义的区别、事件时间的核心问题(乱序与迟到)、Watermark 机制(生成、传递、窗口触发)、完整代码实现、到生产选型和常见坑,把时间语义一次性讲透。
一、为什么需要时间语义:一个乱序数据的真实场景
先看一个真实场景。你负责一个实时计费系统,从 Kafka 消费订单数据,每小时统计每个用户的消费金额,用于计费和对账。
订单数据的产生顺序是:
- 订单 A:10:00:01 创建,金额 100 元
- 订单 B:10:00:02 创建,金额 200 元
但由于网络延迟、消息队列重试、跨地域传输等原因,数据到达 Flink 的顺序是:
- 订单 B 先到达:10:00:05
- 订单 A 后到达:10:00:10(延迟了 5 秒)
如果用处理时间(按数据到达时间处理),窗口 [10:00:00, 10:05:00) 会先处理 B 再处理 A,统计结果是 300 元------这个结果碰巧是对的,但如果 A 延迟到 10:05:01 才到达,就会被分到下一个窗口,当前窗口只统计 B 的 200 元,结果错误。
更严重的是,处理时间的结果不确定------同一批数据,第一次运行和第二次运行的结果可能不同(因为网络延迟不同),无法对账。
如果用事件时间(按数据本身的时间戳处理),不管数据什么时候到达,都按订单创建时间统计。订单 A 和 B 都在 [10:00:00, 10:05:00) 窗口内,统计结果一定是 300 元,结果确定可重现。
但事件时间有一个核心问题:什么时候认为窗口内的数据都到齐了? 订单 A 延迟了 5 秒,如果窗口在 10:05:00 就触发,A 还没到,结果就少了 A。解决方案是 Watermark------告诉 Flink "某个时间点之前的数据都到齐了",Watermark 超过窗口结束时间时才触发。
二、三种时间语义全景
Flink 支持三种时间语义,各有适用场景:
| 时间语义 | 定义 | 时间来源 | 需要 Watermark | 结果确定性 | 适用场景 |
|---|---|---|---|---|---|
| 处理时间 Processing Time | 数据到达算子时,算子所在机器的系统时间 | TaskManager 机器时钟 | 不需要 | 不确定 | 实时监控、大屏 |
| 事件时间 Event Time | 数据本身携带的时间戳(事件发生时间) | 数据中的时间字段 | 必须设置 | 确定 | 业务统计、风控、计费(首选) |
| 摄入时间 Ingestion Time | 数据进入 Flink Source 时,Source 所在机器的系统时间 | Source 机器时钟 | 自动生成 | 较确定 | 无事件时间字段的折中 |
下面这张图把三种时间语义、数据流转中的时间节点、八维度对比放在一起展示。
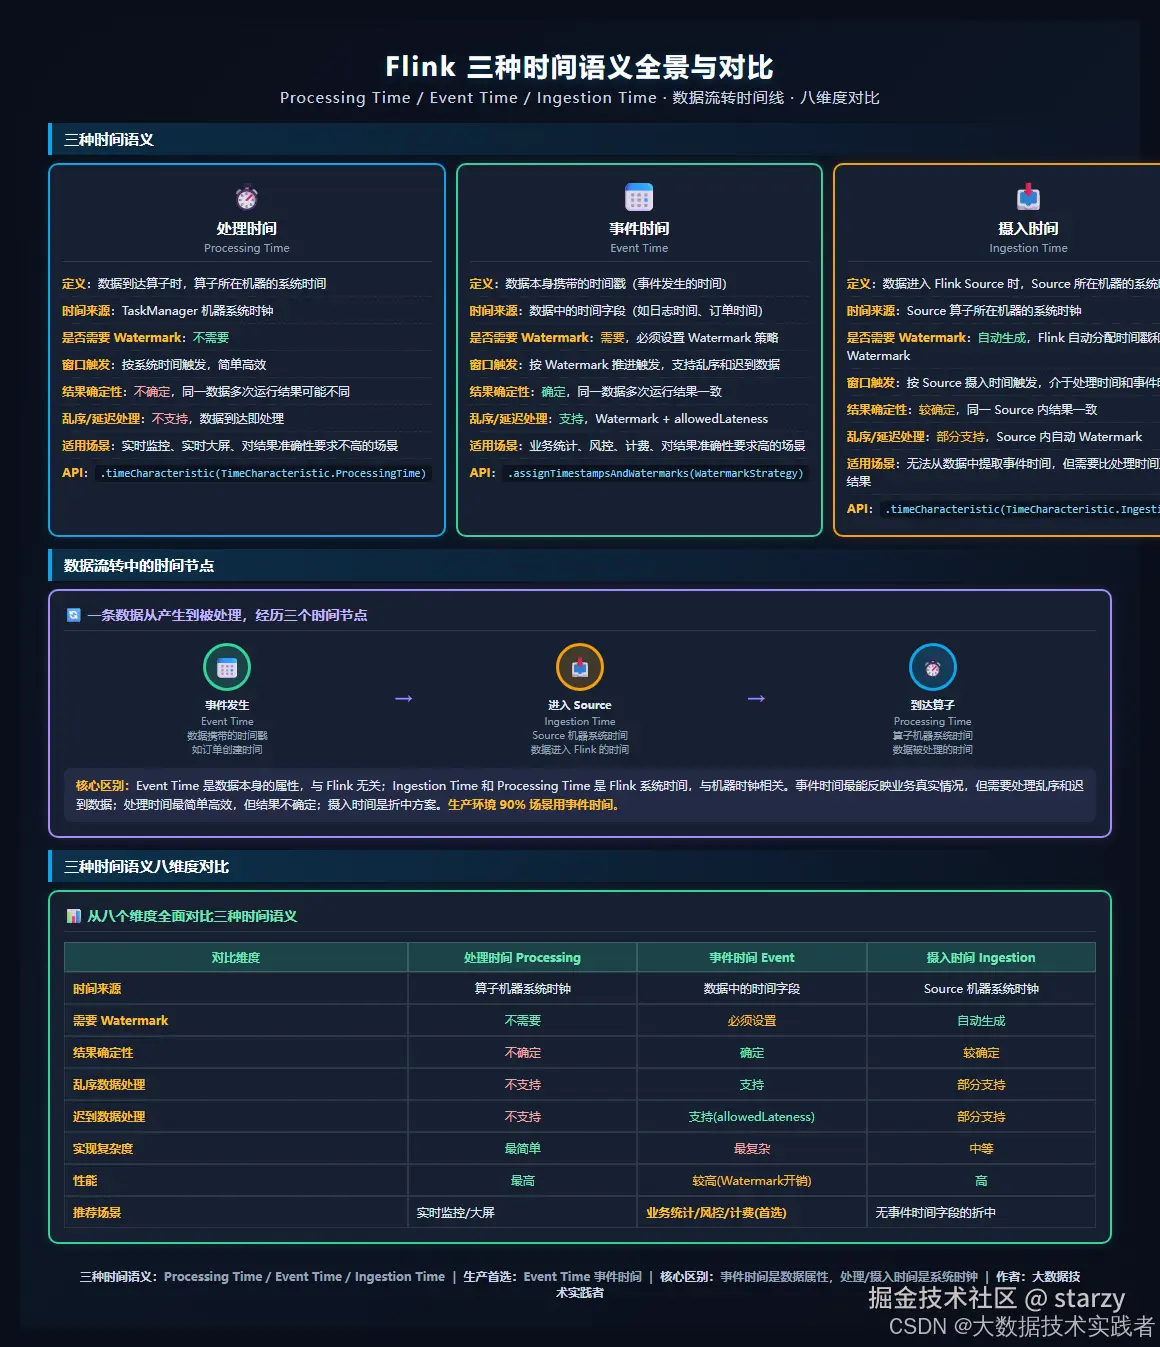
从图里可以看到几个关键点:
第一,三种时间语义的本质区别是时间来源不同:处理时间和摄入时间是 Flink 系统时钟(机器时间),事件时间是数据本身的属性(业务时间)。事件时间最能反映业务真实情况,处理时间最简单高效,摄入时间是折中。
第二,一条数据从产生到被处理,经历三个时间节点:事件发生(Event Time)→ 进入 Source(Ingestion Time)→ 到达算子(Processing Time)。三个时间可能完全不同,取决于网络延迟和系统时钟。
第三,事件时间需要 Watermark,处理时间不需要,摄入时间自动生成。Watermark 是事件时间的核心机制,用于判断"窗口内的数据是否都到齐了"。
第四,结果确定性:事件时间确定(同一数据多次运行结果一致),处理时间不确定(受网络延迟影响),摄入时间较确定(Source 内一致)。业务统计和计费必须用事件时间,保证结果可对账。
三、处理时间(Processing Time):最简单的时间语义
处理时间是最简单的时间语义------按数据到达算子时,算子所在机器的系统时间处理。不需要 Watermark,窗口按系统时间触发,性能最高,延迟最低。
3.1 处理时间完整代码
java
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.windowing.assigners.TumblingProcessingTimeWindows;
import org.apache.flink.streaming.api.windowing.time.Time;

public class ProcessingTimeExample {

    // 订单事件
    public static class Order {
        public String userId;
        public double amount;
        public long timestamp;

        public Order() {}
        public Order(String userId, double amount, long timestamp) {
            this.userId = userId;
            this.amount = amount;
            this.timestamp = timestamp;
        }
    }

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
            StreamExecutionEnvironment.getExecutionEnvironment();

        // 模拟数据源
        DataStream<Order> source = env.addSource(new OrderSource());

        // 处理时间:5分钟滚动窗口,按系统时间触发
        DataStream<Double> result = source
            .keyBy(order -> order.userId)
            .window(TumblingProcessingTimeWindows.of(Time.minutes(5)))
            .sum("amount");  // 求和

        result.print();

        env.execute("Processing Time Example");
    }
}
处理时间的关键点:
第一,用 TumblingProcessingTimeWindows(处理时间窗口分配器),不需要设置 Watermark,不需要从数据中提取时间戳。
第二,窗口按 TaskManager 机器的系统时间触发。比如 10:00:00 到 10:05:00 的窗口,在系统时间到达 10:05:00 时立即触发。
第三,结果不确定------同一批数据,第一次运行和第二次运行的结果可能不同(因为网络延迟不同,数据到达时间不同)。
第四,处理时间适合实时监控、实时大屏等对结果准确性要求不高、追求低延迟的场景。不适合业务统计、计费、对账等需要结果确定的场景。
四、事件时间(Event Time):生产环境首选
事件时间是生产环境最常用的时间语义------按数据本身携带的时间戳(事件发生时间)处理,而不是按到达时间。结果确定可重现,支持乱序和迟到数据。
但事件时间需要解决两个核心问题:
- 什么时候认为窗口内的数据都到齐了? → Watermark
- 迟到的数据怎么处理? → allowedLateness + sideOutputLateData
4.1 事件时间的核心问题:乱序与迟到数据
分布式系统中,数据到达顺序和事件发生顺序往往不一致。原因包括:
- 网络延迟(跨地域传输、网络拥塞)
- 消息队列重试(Kafka 重试导致后发先至)
- 多分区并行消费(不同分区的消费速度不同)
- 数据回放(历史数据重新消费)
乱序数据是常态,不是异常。事件时间必须能够处理乱序数据,保证统计结果正确。
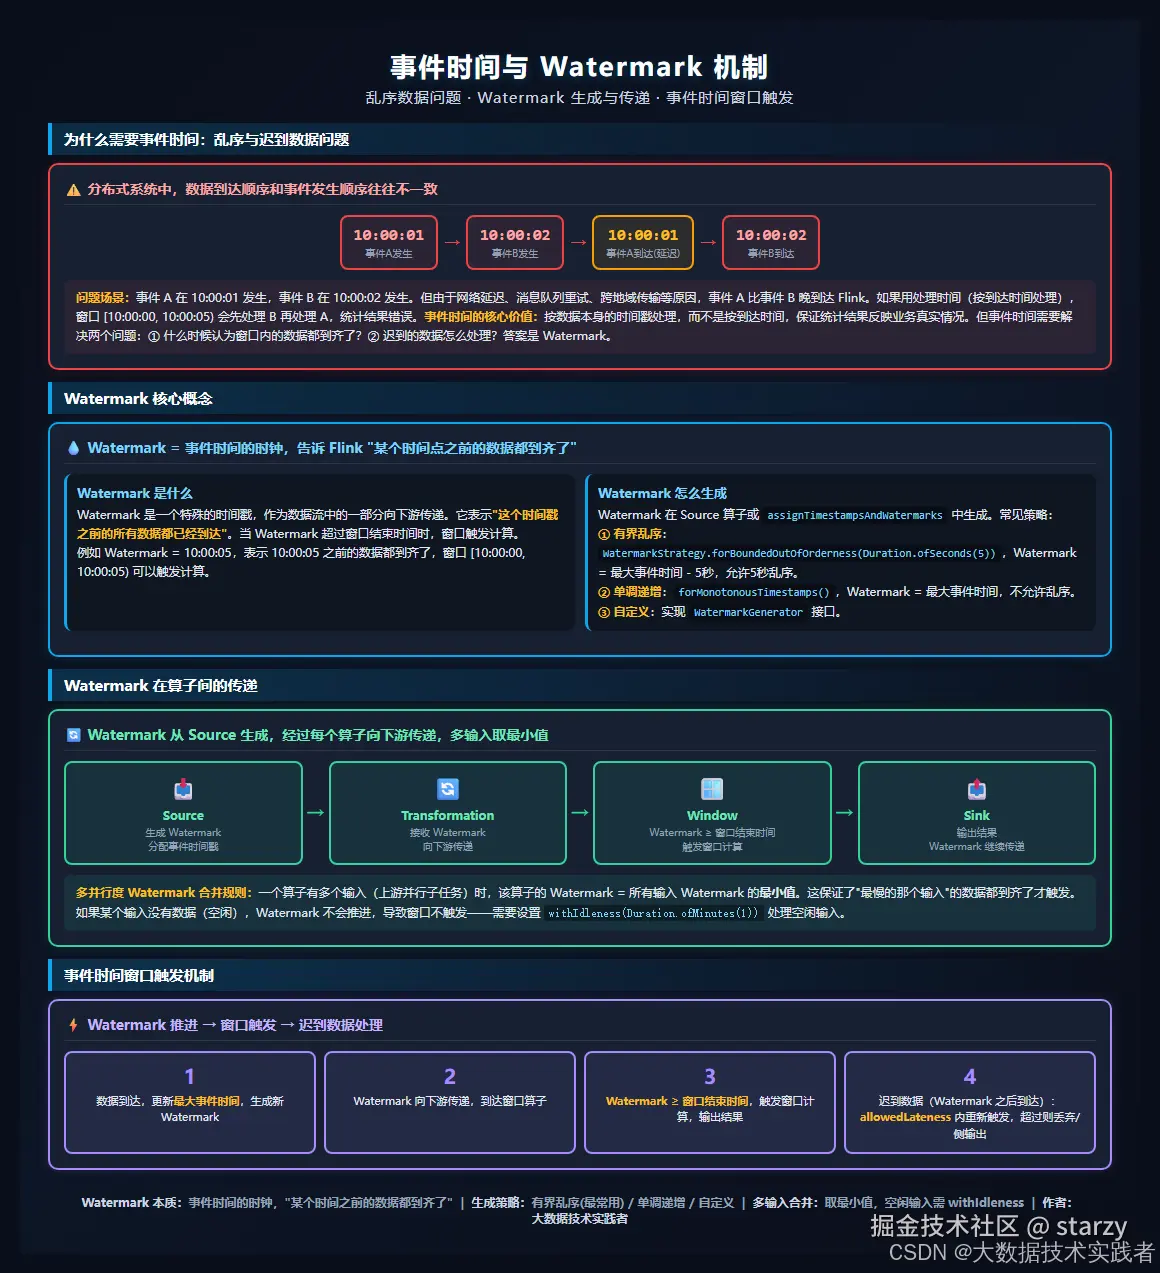
下面这张图展示了乱序数据问题、Watermark 机制、Watermark 传递和事件时间窗口触发。
4.2 Watermark 是什么
Watermark 是一个特殊的时间戳,作为数据流中的一部分向下游传递。它表示**"这个时间戳之前的所有数据都已经到达"**。
例如 Watermark = 10:00:05,表示 10:00:05 之前的数据都到齐了,窗口 [10:00:00, 10:00:05) 可以触发计算。
Watermark 的核心作用:驱动事件时间窗口触发。当 Watermark 超过窗口结束时间时,窗口触发计算。
4.3 Watermark 生成策略
Flink 提供了三种常用的 Watermark 生成策略:
1. 有界乱序(BoundedOutOfOrderness)------ 最常用
Watermark = 当前最大事件时间 - 乱序容忍时间。允许一定程度的乱序,乱序容忍时间内的数据都会被窗口包含。
java
WatermarkStrategy.<Order>forBoundedOutOfOrderness(Duration.ofSeconds(5))
    .withTimestampAssigner((event, timestamp) -> event.timestamp)
表示允许 5 秒的乱序。如果最大事件时间是 10:00:10,Watermark = 10:00:05,表示 10:00:05 之前的数据都到齐了。10:00:01 到 10:00:05 之间的数据即使延迟到达,也会被正确处理。
2. 单调递增(MonotonousTimestamps)
Watermark = 当前最大事件时间。不允许乱序,数据必须按时间戳递增到达。如果有乱序数据,会被当作迟到数据处理。
java
WatermarkStrategy.<Order>forMonotonousTimestamps()
    .withTimestampAssigner((event, timestamp) -> event.timestamp)
适用于数据已经按时间排序的场景(如某些数据库的 binlog)。
3. 自定义(WatermarkGenerator)
实现 WatermarkGenerator 接口,完全自定义 Watermark 生成逻辑。适用于特殊场景(如按数据中的特定字段生成 Watermark、周期性生成等)。
4.4 事件时间完整代码(有界乱序 Watermark)
java
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;
import org.apache.flink.streaming.api.windowing.time.Time;

import java.time.Duration;

public class EventTimeExample {

    // 订单事件
    public static class Order {
        public String userId;
        public double amount;
        public long timestamp;  // 事件时间:订单创建时间

        public Order() {}
        public Order(String userId, double amount, long timestamp) {
            this.userId = userId;
            this.amount = amount;
            this.timestamp = timestamp;
        }
    }

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
            StreamExecutionEnvironment.getExecutionEnvironment();

        // 模拟数据源
        DataStream<Order> source = env.addSource(new OrderSource());

        // 事件时间:设置 Watermark 策略(有界乱序 5 秒)
        WatermarkStrategy<Order> watermarkStrategy = WatermarkStrategy
            .<Order>forBoundedOutOfOrderness(Duration.ofSeconds(5))
            .withTimestampAssigner((event, timestamp) -> event.timestamp);

        DataStream<Double> result = source
            .assignTimestampsAndWatermarks(watermarkStrategy)  // 分配时间戳和 Watermark
            .keyBy(order -> order.userId)
            .window(TumblingEventTimeWindows.of(Time.minutes(5)))  // 事件时间滚动窗口
            .sum("amount");

        result.print();

        env.execute("Event Time Example");
    }
}
事件时间代码的关键点:
第一,必须调用 assignTimestampsAndWatermarks(WatermarkStrategy) 设置 Watermark 策略,并从数据中提取时间戳(withTimestampAssigner)。忘记设置 Watermark 会导致窗口永远不触发(Watermark 永远是 Long.MIN_VALUE)。
第二,用 TumblingEventTimeWindows(事件时间窗口分配器),窗口按事件时间划分,按 Watermark 推进触发。
第三,有界乱序时间 Duration.ofSeconds(5) 表示允许 5 秒的乱序。这个值需要根据实际数据乱序情况合理设置------设置过小会导致迟到数据被丢弃,设置过大会导致窗口触发延迟增加。
第四,事件时间的结果确定------同一批数据,不管什么时候运行、不管网络延迟如何,结果都一样(因为按数据本身的时间戳统计)。
五、Watermark 在算子间的传递
Watermark 不是只在 Source 生成后就结束了,它会随着数据流在每个算子间向下游传递。理解 Watermark 的传递机制,对于排查窗口不触发等问题非常重要。
5.1 Watermark 传递流程
Watermark 的传递流程:
- Source 算子:生成 Watermark(根据 WatermarkStrategy)
- Transformation 算子(map/filter/keyBy 等):接收上游 Watermark,向下游传递
- Window 算子:Watermark 到达后,检查是否有窗口的结束时间 ≤ Watermark,如果有则触发这些窗口
- Sink 算子:接收 Watermark,继续向下游传递(如果有下游)
5.2 多并行度 Watermark 合并规则
一个算子通常有多个输入(上游多个并行子任务)。Watermark 的合并规则是:该算子的 Watermark = 所有输入 Watermark 的最小值。
为什么取最小值?因为 Watermark 表示"这个时间之前的数据都到齐了",只有所有输入的这个时间之前的数据都到齐了,才能认为整体都到齐了。取最小值保证了"最慢的那个输入"的数据都到齐了才触发。
5.3 空闲输入问题
如果某个上游并行子任务没有数据(空闲),它的 Watermark 不会更新(停留在旧值)。由于下游取所有输入的最小值,这个空闲输入会导致整体 Watermark 不推进,窗口永远不触发。
解决方案:设置 withIdleness(Duration.ofMinutes(1)),当某个输入空闲超过指定时间后,暂时忽略该输入的 Watermark(不参与最小值计算),直到该输入有新数据到达。
java
WatermarkStrategy.<Order>forBoundedOutOfOrderness(Duration.ofSeconds(5))
    .withIdleness(Duration.ofMinutes(1))  // 空闲 1 分钟后忽略该输入
    .withTimestampAssigner((event, timestamp) -> event.timestamp)
空闲输入是生产环境中窗口不触发的最常见原因之一,一定要设置 withIdleness。
六、迟到数据处理:allowedLateness 与侧输出
Watermark 超过窗口结束时间后,窗口触发计算。但之后可能还有迟到的数据到达(时间戳在窗口范围内,但到达时间晚于 Watermark)。这些迟到数据怎么处理?
Flink 提供了两种处理方式:
6.1 allowedLateness:允许迟到数据重新触发窗口
设置 allowedLateness(Time),允许在窗口触发后,迟到数据在指定时间内到达时重新触发窗口计算。
java
DataStream<Double> result = source
    .assignTimestampsAndWatermarks(watermarkStrategy)
    .keyBy(order -> order.userId)
    .window(TumblingEventTimeWindows.of(Time.minutes(5)))
    .allowedLateness(Time.hours(1))  // 允许 1 小时的迟到数据
    .sum("amount");
表示窗口触发后,1 小时内到达的迟到数据会重新触发窗口计算(包含迟到数据)。超过 1 小时的迟到数据会被丢弃(或侧输出)。
注意:allowedLateness 会导致窗口状态保留更长时间(窗口触发后不立即清理,而是保留到 allowedLateness 超时),增加状态大小。需要根据业务需求合理设置。
6.2 sideOutputLateData:迟到数据侧输出
如果不想让迟到数据重新触发窗口(避免结果频繁更新),可以把迟到数据侧输出到单独的流,单独处理。
java
import org.apache.flink.streaming.api.functions.windowing.ProcessWindowFunction;
import org.apache.flink.streaming.api.windowing.windows.TimeWindow;
import org.apache.flink.util.Collector;
import org.apache.flink.util.OutputTag;

// 定义迟到数据的侧输出标签
OutputTag<Order> lateOutputTag = new OutputTag<Order>("late-data") {};

DataStream<Double> result = source
    .assignTimestampsAndWatermarks(watermarkStrategy)
    .keyBy(order -> order.userId)
    .window(TumblingEventTimeWindows.of(Time.minutes(5)))
    .sideOutputLateData(lateOutputTag)  // 迟到数据侧输出
    .sum("amount");

// 获取迟到数据流
DataStream<Order> lateStream = result.getSideOutput(lateOutputTag);
lateStream.print("迟到数据");  // 单独处理迟到数据
侧输出的迟到数据可以单独处理(如写入补数表、告警、人工审核等),不影响主流的统计结果。
6.3 迟到数据处理策略选择
| 策略 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| 默认丢弃 | 对准确性要求不高,迟到数据影响小 | 实现简单,状态小 | 可能丢失数据,结果偏小 |
| allowedLateness | 业务需要包含迟到数据,允许结果更新 | 结果准确,包含迟到数据 | 状态大,结果可能频繁更新 |
| sideOutputLateData | 迟到数据需要单独处理,不影响主流 | 主流结果稳定,迟到数据可追溯 | 需要额外处理迟到数据流 |
生产环境常用组合:allowedLateness(较短时间,如 1 分钟)+ sideOutputLateData(超过 allowedLateness 的迟到数据侧输出)。既保证大部分迟到数据被包含,又避免状态过大和结果频繁更新。
七、摄入时间(Ingestion Time):折中方案
摄入时间是介于处理时间和事件时间之间的折中方案------按数据进入 Flink Source 时,Source 所在机器的系统时间处理。Flink 自动分配时间戳和生成 Watermark,不需要手动设置。
摄入时间的特点:
- 比处理时间结果更稳定(Source 内时间一致,不受后续算子网络延迟影响)
- 不需要手动设置 Watermark(Flink 自动生成)
- 结果较确定(同一 Source 内结果一致)
- 但仍然是系统时间,不是数据本身的业务时间
摄入时间适用于:数据中没有明确的事件时间字段,但需要比处理时间更稳定的结果的场景。实际生产中使用较少,大多数场景要么用处理时间(实时监控),要么用事件时间(业务统计)。
注意:Flink 1.12+ 已废弃 setStreamTimeCharacteristic(TimeCharacteristic.IngestionTime) 的方式,统一用 WatermarkStrategy。摄入时间可以通过在 Source 中自动分配时间戳来实现。
八、实战案例与选型
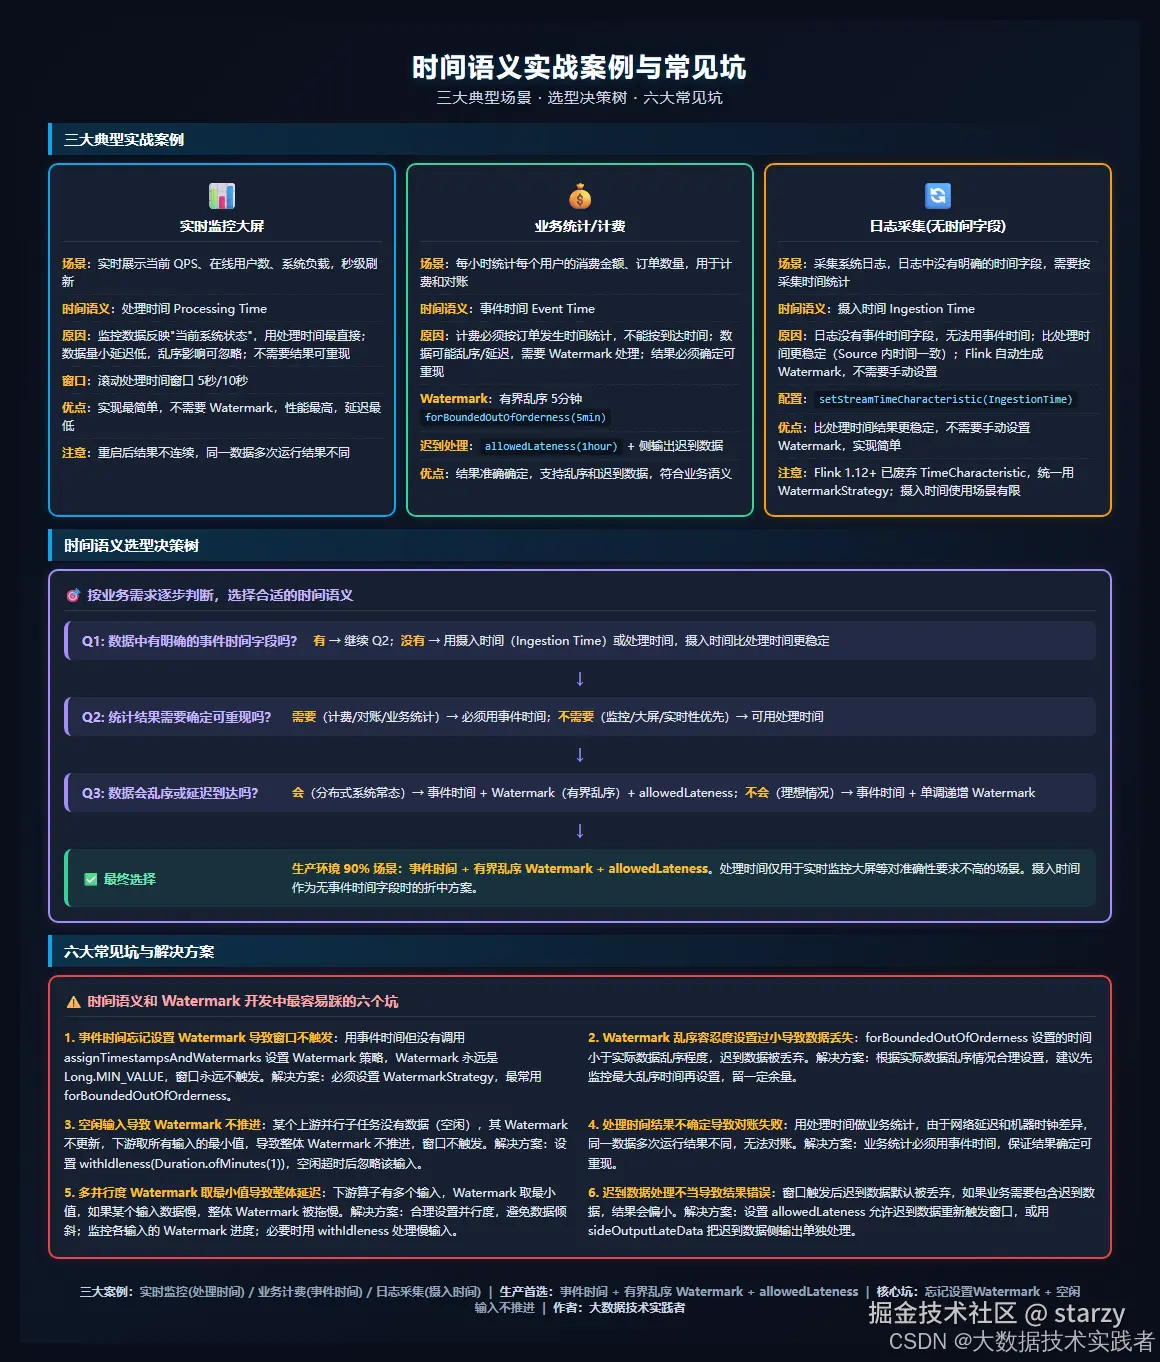
下面这张图总结了三大实战案例、时间语义选型决策树和六大常见坑。
8.1 三大典型场景
场景一:实时监控大屏 → 处理时间
实时展示当前 QPS、在线用户数、系统负载,秒级刷新。监控数据反映"当前系统状态",用处理时间最直接;数据量小延迟低,乱序影响可忽略;不需要结果可重现。
场景二:业务统计/计费 → 事件时间(首选)
每小时统计每个用户的消费金额、订单数量,用于计费和对账。计费必须按订单发生时间统计,不能按到达时间;数据可能乱序/延迟,需要 Watermark 处理;结果必须确定可重现。
场景三:日志采集(无时间字段)→ 摄入时间
采集系统日志,日志中没有明确的时间字段,需要按采集时间统计。比处理时间更稳定,Flink 自动生成 Watermark,不需要手动设置。
8.2 选型决策树
按业务需求逐步判断:
-
数据中有明确的事件时间字段吗?
- 有 → 继续判断
- 没有 → 用摄入时间或处理时间(摄入时间更稳定)
-
统计结果需要确定可重现吗?
- 需要(计费/对账/业务统计)→ 必须用事件时间
- 不需要(监控/大屏/实时性优先)→ 可用处理时间
-
数据会乱序或延迟到达吗?
- 会(分布式系统常态)→ 事件时间 + 有界乱序 Watermark + allowedLateness
- 不会(理想情况)→ 事件时间 + 单调递增 Watermark
最终结论:生产环境 90% 场景用事件时间 + 有界乱序 Watermark + allowedLateness。 处理时间仅用于实时监控大屏等对准确性要求不高的场景。摄入时间作为无事件时间字段时的折中方案。
九、六大常见坑与解决方案
9.1 坑一:事件时间忘记设置 Watermark 导致窗口不触发
现象:用事件时间但没有调用 assignTimestampsAndWatermarks 设置 Watermark 策略,窗口永远不触发,没有任何输出。
原因:Watermark 默认是 Long.MIN_VALUE,永远不会超过窗口结束时间,窗口永远不触发。
解决方案:必须设置 WatermarkStrategy,最常用 forBoundedOutOfOrderness,并通过 withTimestampAssigner 从数据中提取时间戳。
9.2 坑二:Watermark 乱序容忍度设置过小导致数据丢失
现象:forBoundedOutOfOrderness(Duration.ofSeconds(2)) 设置的乱序容忍时间小于实际数据乱序程度(实际乱序 10 秒),迟到数据被丢弃,统计结果偏小。
原因:Watermark = 最大事件时间 - 乱序容忍时间。如果乱序容忍时间过小,Watermark 推进过快,迟到数据被当作过期数据丢弃。
解决方案:根据实际数据乱序情况合理设置。建议先监控最大乱序时间(数据到达时间 - 事件时间),再设置乱序容忍时间,留一定余量(如最大乱序的 1.5 倍)。
9.3 坑三:空闲输入导致 Watermark 不推进
现象:某个上游并行子任务没有数据(空闲),下游 Watermark 不推进,窗口不触发。其他输入都有数据,但整体不触发。
原因:下游 Watermark = 所有输入 Watermark 的最小值。空闲输入的 Watermark 停留在旧值,拖慢整体 Watermark。
解决方案:设置 withIdleness(Duration.ofMinutes(1)),空闲超时后暂时忽略该输入。这是生产环境中窗口不触发的最常见原因,一定要设置。
9.4 坑四:处理时间结果不确定导致对账失败
现象:用处理时间做业务统计,由于网络延迟和机器时钟差异,同一数据多次运行结果不同,无法对账。
原因:处理时间按数据到达时间统计,到达时间受网络延迟影响,结果不确定。
解决方案:业务统计必须用事件时间,保证结果确定可重现。处理时间仅用于实时监控等不需要对账的场景。
9.5 坑五:多并行度 Watermark 取最小值导致整体延迟
现象:下游算子有多个输入,某个输入数据慢(数据倾斜或消费延迟),整体 Watermark 被拖慢,窗口触发延迟增加。
原因:下游 Watermark 取所有输入的最小值,慢输入的 Watermark 小,拖慢整体。
解决方案:合理设置并行度,避免数据倾斜;监控各输入的 Watermark 进度(Flink Web UI 可以查看);必要时用 withIdleness 处理慢输入;或调整数据分区策略让各输入数据量均衡。
9.6 坑六:迟到数据处理不当导致结果错误
现象:窗口触发后迟到数据默认被丢弃,如果业务需要包含迟到数据,结果会偏小;或者 allowedLateness 设置过长,导致状态过大和结果频繁更新。
原因:迟到数据处理策略选择不当,没有根据业务需求设置合适的 allowedLateness 和侧输出。
解决方案:根据业务需求选择策略------对准确性要求不高用默认丢弃;需要包含迟到数据用 allowedLateness(合理设置时间,避免过长);需要单独处理用 sideOutputLateData。生产环境常用组合:短 allowedLateness + 侧输出。
十、总结与下一篇预告
时间语义是 Flink 流处理的核心概念,要点回顾:
第一,三种时间语义:处理时间(Processing Time,算子机器系统时钟,最简单,结果不确定)、事件时间(Event Time,数据携带的时间戳,生产首选,结果确定)、摄入时间(Ingestion Time,Source 机器系统时钟,折中方案)。
第二,事件时间是生产环境首选,因为结果确定可重现,支持乱序和迟到数据。但事件时间需要 Watermark 机制来判断"窗口内的数据是否都到齐了"。
第三,Watermark 是事件时间的时钟,表示"某个时间之前的数据都到齐了"。常用生成策略:有界乱序(最常用)、单调递增、自定义。Watermark 在算子间传递,多输入取最小值,空闲输入需 withIdleness。
第四,迟到数据处理:默认丢弃、allowedLateness(允许重新触发)、sideOutputLateData(侧输出单独处理)。生产环境常用短 allowedLateness + 侧输出组合。
第五,生产选型:90% 场景用事件时间 + 有界乱序 Watermark + allowedLateness。处理时间仅用于实时监控大屏。摄入时间作为无事件时间字段时的折中。
第六,常见坑:忘记设置 Watermark(窗口不触发)、乱序容忍度过小(数据丢失)、空闲输入(Watermark 不推进)、处理时间结果不确定(对账失败)、多并行度取最小值(整体延迟)、迟到数据处理不当(结果错误)。