一文讲透推理引擎性能指标:TTFT、TPOT、KV命中率、并发,到底对应 vLLM / SGLang 的哪个参数?
作 者:吴佳浩Alben
撰稿时间:2026.10.1
更新时间:2026.10.7
引言
很多人在做推理压测时都会遇到一个尴尬:
同一个模型、同一张卡,为什么我测出来的 TTFT 比同事慢一倍?
vLLM 的
--max-num-seqs和 SGLang 的--max-running-requests,到底是不是一个东西?为什么我在
/metrics里翻了半天,就是找不到 GPU 利用率、SM 占用、Tensor Core 利用率?
指标是测出来了,报告也交了,但被问一句"你那个 TTFT 是哪个参数决定的",就答不上来了。
其实这里面藏着三层容易被混淆的东西:指标类型 (哪些有旋钮、哪些只能测、哪些引擎根本不管)、参数命名 (同一个概念两个引擎各叫各的)、测量口径(定并发还是定速率、稠密还是稀疏------对,推理侧也有类似的口径陷阱)。搞懂这三层,你就能把任何一份压测报告翻译成一份调优清单,也能识破 benchmark 里的"数字游戏"。本篇内容稍微有点干,各位可以跳着看,重点看自己感兴趣的部分。
一、先理解三层映射框架
推理引擎的指标,按"能不能被参数调"分成三类,这是本文所有内容的骨架。
| 类型 | 含义 | 对应什么 | 典型指标 |
|---|---|---|---|
| A 类:有旋钮 | 启动参数能直接调节 | vllm serve / sglang.launch_server 参数 |
并发数、KV 显存占比、chunk 大小、调度策略 |
| B 类:只能测 | 引擎暴露指标,但不由单个参数决定 | /metrics 的 Prometheus 指标名 + 压测脚本参数 |
TTFT、TPOT、命中率、排队时延、P99 |
| C 类:引擎外 | 引擎根本不产出 | nvidia-smi / DCGM / ncu / nccl-tests / fio | SM 占用、Tensor Core 利用率、显存带宽、NCCL、模型质量分 |
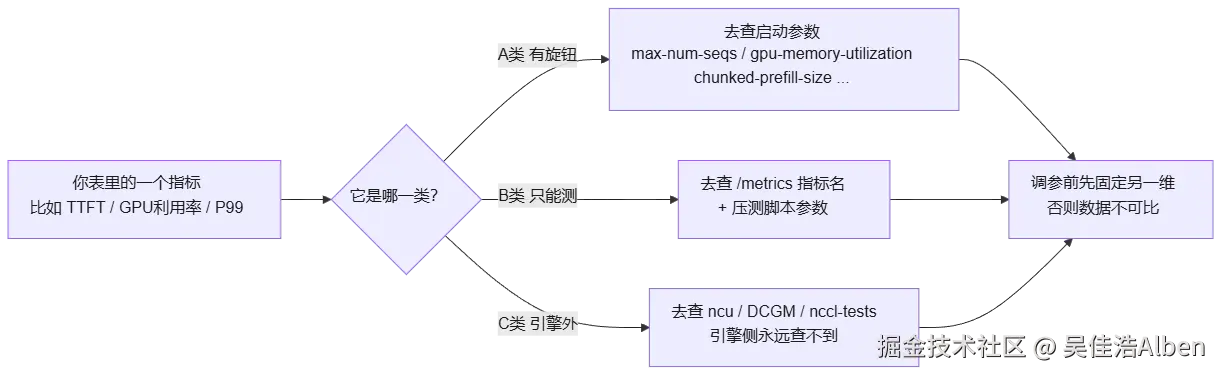
先把一个最常见的误解纠正掉:GPU 利用率、SM Occupancy、Tensor Core 利用率这三兄弟,vLLM 和 SGLang 都不往 /metrics 里吐。 你在 /metrics 里翻多久都找不到,因为它们的采集层级在驱动和硬件计数器,不在引擎。
唯一的例外是 SGLang 新加的 --enable-mfu-metrics,能直接导出估算 MFU------这是目前极少数"引擎内"就能拿到的算力效率指标。
这也是我见过最普遍的时间黑洞:把 C 类指标当成 A 类去查参数,查一天也查不出结果。
二、以 TTFT 为例:一个指标为什么对应五六个参数
核心问题: 什么决定用户按下回车后,多久看到第一个字?
答案: prefill 阶段的 token 预算、chunk 切分粒度、前缀缓存命中率,三者共同决定。
| 项目 | vLLM | SGLang |
|---|---|---|
| 单步 token 预算 | --max-num-batched-tokens |
--max-prefill-tokens(默认 16384) |
| chunk 切分 | V1 默认开;--no-enable-chunked-prefill 可关 |
--chunked-prefill-size(默认 8192,-1 关闭) |
| 长请求优先 | --long-prefill-token-threshold(默认 0,实际取上下文 4%) |
--schedule-policy lpm |
| 前缀复用 | --enable-prefix-caching(要显式开) |
Radix Cache 默认开 ,--disable-radix-cache 关 |
| 观测 | vllm:time_to_first_token_seconds |
sglang:time_to_first_token_seconds |
所以 TTFT 从来不是"一个参数",它是一个结果 。你能调 的是 token 预算和 chunk 粒度,能观测的是命中率,剩下的交给调度器。
这里有个 SGLang 上特别容易混的点:--chunked-prefill-size 和 --max-prefill-tokens 是两个不同的东西。前者是"一次切多大块",后者是"一批总共允许多少 token"。SGLang 官方 FAQ 里,prefill 阶段 OOM 让你调的是前者(降到 4096 或 2048),不是后者。
配图建议:一张 TTFT 组成拆解图,横轴标出 排队 → prefill → 首token,在 prefill 段标注受哪几个参数影响
三、吞吐类指标:Prefill 和 Decode 是一对反方向的旋钮
核心问题: 为什么我把 token 预算调大,吞吐涨了,但同事说延迟变差了?
答案: 因为 prefill 吞吐和 TTFT 抖动是同一批参数的两个方向。
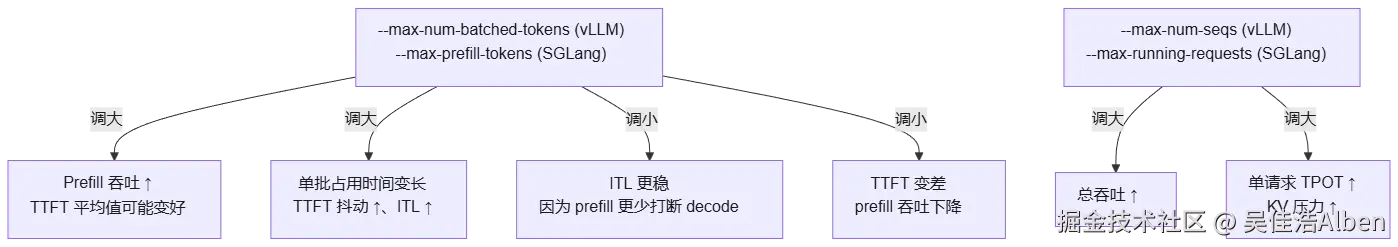
把这张图记住,你就能理解为什么调参一次只能动一维:
不固定另一维的对比数据,全是废数据。
我见过太多"我调优后吞吐提升了 30%"的结论,细问之下是把并发也从 32 改到了 128------那不是调优,那是换了个测试条件。
| 指标 | vLLM 观测 | SGLang 观测 |
|---|---|---|
| Prefill 吞吐 | vllm:prompt_tokens_total、日志 Avg prompt throughput |
sglang:prompt_tokens_total |
| Decode 吞吐 | vllm:generation_tokens_total、日志 Avg generation throughput |
sglang:gen_throughput、sglang:generation_tokens_total |
四、延迟类指标:TPOT / ITL / E2E 都是"结果",没有旋钮
这是我特别想强调的一点:这三个指标在参数表里找不到对应的旋钮。
| 指标 | 含义 | vLLM 观测 | SGLang 观测 |
|---|---|---|---|
| TPOT | Time Per Output Token | vllm:time_per_output_token_seconds |
压测侧统计 |
| ITL | Inter-Token Latency | vllm:inter_token_latency_seconds |
sglang:inter_token_latency_seconds |
| E2E | 总响应时间 | vllm:e2e_request_latency_seconds |
sglang:e2e_request_latency_seconds |
它们是并发、批预算、KV 压力共同作用的结果。想优化 TPOT,你要动的是这样几个东西:
--max-num-seqs/--max-running-requests(并发越高,TPOT 越高)- CUDA Graph(vLLM 默认开,
--enforce-eager是关掉它;SGLang 用--disable-cuda-graph) - 编译优化(vLLM
-O3/--compilation-config,SGLang--enable-torch-compile) - 投机解码(两边都有,参数名差得比较远)
- KV 精度(
--kv-cache-dtype两边同名)
这就是"结果指标"和"参数指标"的区别------你优化不了 TPOT,你只能优化影响 TPOT 的那几个旋钮,然后重新测 TPOT。
五、分位数:P99 不是参数,是分布
很多人第一次跑 vLLM 的 bench,看到输出里只有 Mean 和一个 P99,就以为"分位数是自动的"。
不是。 --metric-percentiles 的默认值是 99------你不显式写,它就只给你一个 P99。
bash
# 正确姿势:把 P50/P90/P95/P99 都要出来
--percentile-metrics ttft,tpot,itl,e2el \
--metric-percentiles 50,90,95,99
⚠️ 两个坑,我都踩过:
- 指标名是
e2el,不是e2e。 写e2e会报错。可选值包括ttft,tpot,itl,ttfc,tpoc,icl,tpop,e2el等。 - SGLang 的
bench_serving没有这么细的分位数开关。 它的做法是用--output-details把逐请求明细(ttfts、itls、input/output lens)导出成 JSONL,自己算分位数------这反而更灵活,但很多人不知道有这个参数。
bash
python -m sglang.bench_serving --backend sglang --host 127.0.0.1 --port 30000 \
  --dataset-name random --random-input-len 4096 --random-output-len 512 \
  --num-prompts 1000 --max-concurrency 128 \
  --output-file ./results/sglang.jsonl --output-details
补一个反直觉的发现:分位数背后其实藏着一个参数。 翻 SGLang 的 --help 会看到一个 --bucket-time-to-first-token------TTFT 直方图的分桶边界。
也就是说:"P99 是分布不是参数"这句只说对了一半。 压测报告里的分位数确实没有旋钮,但你从 /metrics 里用 histogram_quantile() 算出来的分位数,精度完全由直方图分桶决定:
- 桶边界太粗 → 相邻桶之间被线性插值抹平,P99 会偏乐观
- 桶边界没覆盖真实长尾 → 数据全落进
+Inf桶,P99 直接失真
所以从 Prometheus 拿分位数之前,先去看一眼 *_bucket 的实际边界 (curl /metrics | grep _bucket 就行)。vLLM 侧的分桶是内部默认值,同样建议先确认覆盖面,再决定要不要换 Prometheus 侧的 histogram_quantile 参数。
六、并发与 KV:一对必须一起看的孪生指标
核心问题: 我把并发调到 512,为什么吞吐没涨,TPOT 反而抖得厉害?
答案: 因为并发和 KV 是耦合的,KV 不够就会触发抢占(preemption)或回收(retract),请求被反复打断重算。
| 概念 | vLLM | SGLang | |
|---|---|---|---|
| 最大并发 | --max-num-seqs |
--max-running-requests |
|
| 并发观测 | vllm:num_requests_running |
sglang:num_running_reqs |
|
| 排队观测 | vllm:num_requests_waiting、`vllm:num_requests_waiting_by_reason{reason="capacity" |
"deferred"}` | sglang:num_queue_reqs、/get_load |
| 被抢占 | vllm:num_preemptions_total |
retract 计数(sglang:num_retracted_reqs*) |
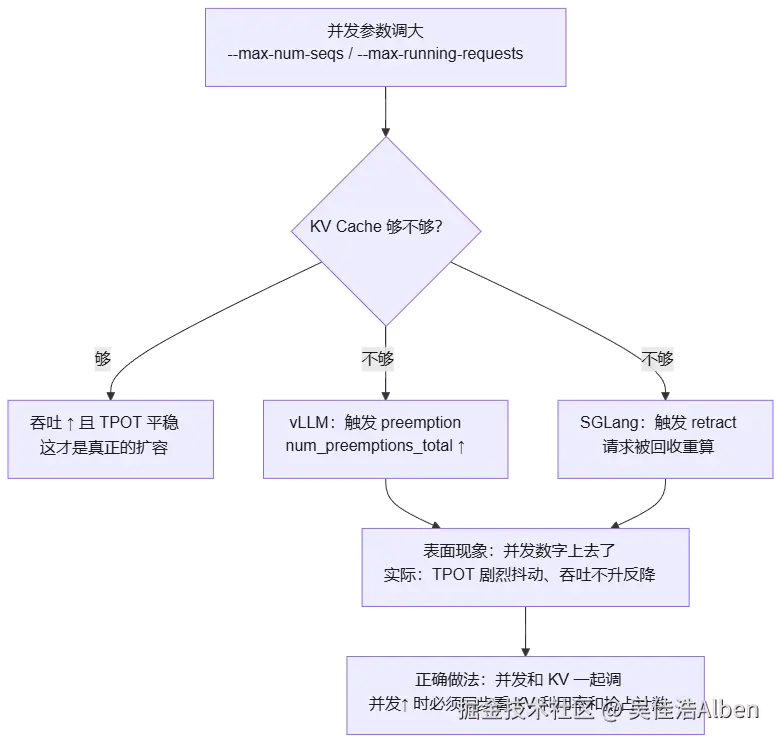
这是我最想让人记住的一条:并发指标永远要和 KV 淘汰一起看。 只看 Running: 512 reqs 就宣布"扩容成功",是很危险的。
vLLM 的日志行其实把这两件事并排印出来了,只是很多人没注意:
yaml
Running: 512 reqs, Waiting: 87 reqs, GPU KV cache usage: 99.2%, Prefix cache hit rate: 61.3%看到 Waiting 不为 0、KV 到 99%,就该知道现在不是"在扩容",而是"在排队+抢占"。
七、KV Cache 命中率:唯一"默认开着"的优化
| 项目 | vLLM | SGLang |
|---|---|---|
| 开关 | --enable-prefix-caching(要显式开) |
Radix Cache 默认开 ,--disable-radix-cache 关 |
| 淘汰策略 | --prefix-caching-hash-algo |
--radix-eviction-policy lru/lfu(默认 lru) |
| 观测 | vllm:prefix_cache_hits_total / vllm:prefix_cache_queries_total |
sglang:cache_hit_rate |
| 按请求统计 | --- | --enable-cache-report |
这里有一个我一开始理解错的参数,值得单独说:--enable-cache-report。
我最初以为它是"让服务端输出缓存报告"。实际上它的作用是:把缓存的 token 数塞进 OpenAI 响应体的 usage.prompt_tokens_details.cached_tokens 字段里 ,供客户端或压测工具按请求统计命中率。默认 False,要统计就得显式开。
另外一个坑:SGLang 当前文档里 --schedule-policy 的默认值是 fcfs,不是很多人印象中的 lpm。 想要"最长前缀优先"以提高命中率,必须显式写 --schedule-policy lpm。这一条建议你 --help 复核一下自己装的版本。
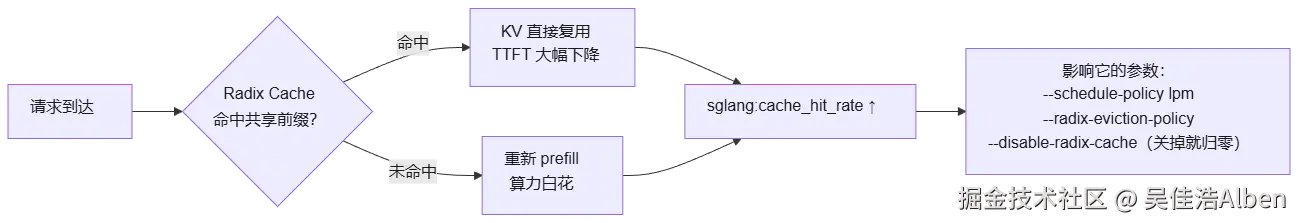
Agent 类应用的命中率普遍很高 (系统提示词、工具 schema、多轮历史都是共享前缀),这也是 SGLang 在这类场景口碑好的原因。所以压测时如果只发随机 prompt,你测出来的命中率天然偏低------这不是引擎的问题,是你的数据集不真实。
八、显存类指标:为什么"峰值显存≈设定值"不是浪费
| 项目 | vLLM | SGLang |
|---|---|---|
| 总量占比 | --gpu-memory-utilization(默认 0.9) |
--mem-fraction-static(实际默认 0.9) |
| KV 池硬上限 | --num-gpu-blocks-override、--kv-cache-memory-bytes |
--max-total-tokens |
| 块/页大小 | --block-size(16/32/64) |
--page-size(默认 1) |
| KV 精度 | --kv-cache-dtype |
--kv-cache-dtype |
| 观测 | 启动日志 GPU KV cache size: N tokens |
启动日志 max_total_num_tokens |
一个反直觉但正确的事实: vLLM 会把 --gpu-memory-utilization 给的额度预先吃满 留给 KV pool,SGLang 的 --mem-fraction-static 同理。所以"峰值显存 ≈ 设定值"是设计行为,不是浪费。你看到 "81559MiB 里用了 71303MiB" 就以为漏显存了,其实那是它主动留给 KV 的。
想测真实权重占用,得单独用小 fraction 跑一次,或者从启动日志里把那两行拆出来看。
还有两个参数值得单独记住:
--num-gpu-blocks-override:官方说明写得很直白------"If specified, ignore GPU profiling result and use this number of GPU blocks. Used for testing preemption. " 也就是说,这是引擎作者提供给你专门用来构造 KV 压力、复现抢占的开关。想测 KV 淘汰行为,就用它。--page-size 64:SGLang 官方 HiCache 最佳实践里给的配置。注意分层缓存的场景要放大页大小,这和纯 GPU 场景(默认 1)是很不一样的思路。
SGLang 官方 HiCache 文档给的一组真实参数,可以直接抄:
bash
python3 -m sglang.launch_server --model-path /DeepSeek-R1/ --tp 8 --page-size 64 \
  --context-length 65536 --chunked-prefill-size 6144 --mem-fraction-static 0.85 \
  --enable-hierarchical-cache --hicache-ratio 2 --hicache-io-backend kernel
九、引擎测不到的指标:SM、Tensor Core、带宽、NCCL
前面说过这批是 C 类。这里给一张"查什么用什么"的对照表,建议直接收藏:
| 指标 | 工具与字段 |
|---|---|
| SM 占用 / Tensor Core / 显存带宽 | ncu --metrics sm__throughput.avg.pct_of_peak_sustained_elapsed,sm__pipe_tensor_op_hmma_cycles_active.avg.pct_of_peak_sustained_active,dram__throughput.avg.pct_of_peak_sustained_elapsed |
| GPU 利用率 / 功耗 / NVLink / PCIe | DCGM:DCGM_FI_PROF_SM_OCCUPANCY、DCGM_FI_PROF_PIPE_TENSOR_ACTIVE、DCGM_FI_PROF_DRAM_ACTIVE、DCGM_FI_DEV_POWER_USAGE、DCGM_FI_PROF_NVLINK_TX_BYTES、DCGM_FI_PROF_PCIE_TX_BYTES |
| 峰值显存 | nvidia-smi --query-gpu=memory.used --format=csv -l 1 |
| 显存碎片率 | torch.cuda.memory_stats(),看 reserved vs allocated |
| SSD IOPS / 带宽 | fio、iostat -x 1 |
| NCCL / AllReduce 延迟 | nccl-tests:./build/all_reduce_perf -b 8 -e 8G -f 2 -g 8 |
| 模型质量(MMLU/SWE-bench/...) | lm-eval-harness、evalplus、swebench harness、lmms-eval |
| Token/$、W/token | 外部换算:token 数来自引擎指标,功耗来自 DCGM / nvidia-smi |
关于显存碎片率,补一句实战经验: 引擎参数里没有"降低碎片"的旋钮,但环境变量 PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True 通常能明显缓解。这个不是引擎的功能,是 PyTorch 分配器的功能。
⚠️ 但有一条例外,必须单独说:MFU 其实有引擎内参数。
上面把 MFU 归进 C 类,是因为精确 的 SM / Tensor Core 占用只有 ncu 和 DCGM 能给。但 SGLang 提供了 --enable-mfu-metrics:打开之后 /metrics 里会多出估算的 MFU 指标,不装 DCGM 也能看个大概趋势。(vLLM 侧没有对应开关。)
这正好是"三层框架"的一个好例子:同一个指标在不同引擎里的可得性可能完全不同 。所以拿到一个新引擎,第一件事应该是把 --help 和 /metrics 都完整翻一遍,而不是套用上一个引擎的经验------这次翻 SGLang 的 --help,我就额外翻出来 --enable-mfu-metrics、--enable-metrics-for-all-schedulers(多 TP rank 时让每个 rank 单独记指标)、--extra-metric-labels(给指标打自定义标签)、--export-metrics-to-file(把逐请求指标落盘)这几个文档里几乎不提、但排查问题时很好用的开关。
关于质量指标,必须强调: 引擎参数里没有"提升 MMLU"的旋钮,只有损害 它的旋钮--------quantization、--kv-cache-dtype fp8、--attention-backend 换实现。所以量化上线前质量分必须重测,这不是可选项。
十、实测:怎么跑一次"可比"的压测
理论讲完,换个角度:你手头这两个引擎,到底能不能公平地比一次?
这里有一个很多人不知道的技巧:vLLM 的 bench 支持 --backend sglang。
也就是说,你可以用同一个客户端、同一份输入分布 去打两个引擎,这才是真正可比的对比方式。比"vLLM 用自己的脚本、SGLang 用 bench_serving"这种各跑各的搞法靠谱得多------两个不同的客户端,连分位数算法都可能不一样,比出来的结论没有意义。
bash
# 打 vLLM
vllm bench serve --backend vllm --model Qwen/Qwen2.5-7B-Instruct \
  --base-url http://127.0.0.1:8000 \
  --dataset-name random --random-input-len 4096 --random-output-len 512 \
  --num-prompts 1000 --request-rate inf --max-concurrency 128 --ignore-eos \
  --percentile-metrics ttft,tpot,itl,e2el --metric-percentiles 50,90,95,99 \
  --save-result --result-dir ./results

# 同一个客户端打 SGLang(保证可比)
vllm bench serve --backend sglang --model Qwen/Qwen2.5-7B-Instruct \
  --base-url http://127.0.0.1:30000 \
  --dataset-name random --random-input-len 4096 --random-output-len 512 \
  --num-prompts 1000 --request-rate inf --max-concurrency 128 --ignore-eos \
  --percentile-metrics ttft,tpot,itl,e2el --metric-percentiles 50,90,95,99 \
  --save-result --result-dir ./results-sglang
但这两个客户端不是一回事 --------backend vllm 走 /v1/completions,--backend sglang 走 SGLang 原生的 /generate,流式解析和 token 计数的代码路径完全不同。真正逐字节一致的写法在下面 10.3 节。
10.1 本次实测环境(实跑取证,不是抄文档)
下面所有数字都出自这套环境,你可以照着复现:
| 项目 | 实测值 | 取证方式 |
|---|---|---|
| GPU | RTX 5090,32607 MiB,计算能力 sm_120(Blackwell) | nvidia-smi + torch.cuda.get_device_capability() |
| 驱动 | 617.14 | nvidia-smi |
| 容器环境 | Docker Desktop 4.47.0 / Engine 28.4.0,含 nvidia runtime |
docker info |
| 模型 | Qwen2.5-7B-Instruct,bf16,4 个分片共 15.2 GB | 目录实测 |
| 模型结构 | 28 层 / 28 头 / 4 个 KV 头(GQA) / 原生 32768 上下文 | config.json |
| vLLM | vllm/vllm-openai:v0.28.0-cu129 |
镜像 digest 见文末 |
| SGLang | lmsysorg/sglang:latest,容器内实际是 v0.5.21 |
sglang.__version__ |
⚠️ sm_120 是 50 系显卡用户共同的坑:
RTX 50 系的计算能力是 sm_120 ,而社区里大量 vLLM 镜像(包括 v0.9.0 前后的官方镜像)是 CUDA 12.4 及更早版本构建的,PyTorch 里不含 sm_120 的 kernel 镜像,一启动就报:
vbnet
RuntimeError: CUDA error: no kernel image is available for execution on the device所以镜像标签必须挑 CUDA 12.9(cu129)或更高。 本次用 v0.28.0-cu129;SGLang 用官方 latest(要求 CUDA 13 兼容驱动,617.14 满足)。
顺便记一个显存账,后面全靠它:
scss
每 token 的 KV 开销 = 2(K+V) × 28层 × 4个KV头 × 128(head_dim) × 2字节(bf16)
                    = 57,344 字节 ≈ 56 KB/token
10.2 第一个反直觉结论:两个引擎必须串行跑
我原本的设计是"两个容器都起来、同一个客户端轮流打",算一下显存就知道不可能:
ini
7B bf16 权重 ≈ 14.2 GB
两个服务各占一份  →  14.2 × 2 = 28.4 GB
还没算 KV Cache,32 GB 的 5090 就已经不够了
单卡 32 GB 装不下两个各配 --gpu-memory-utilization 0.85 的 7B 服务。 正确顺序只能是:
起 vLLM → 压测 → 停容器释放显存 → 起 SGLang → 压测两个配套细节,都很容易踩:
- 压测客户端必须抽成独立容器(不挂 GPU)。否则你一停 vLLM,客户端跟着就没了,第二段没法接着打。
- 压测期间机器不能被别的活占着。 我一开始边拉镜像边压测,TTFT 的分位数立刻被打脏------下载解压抢 CPU 和磁盘,长尾直接飙起来。所以流程里必须加"等所有镜像就绪 + 静置 30 秒"。
10.3 对齐项声明:这张表比结论更重要
对比测试最容易犯的错是无意中动了两个变量。凡是有对应关系的旋钮,两边都显式设成同一个值:
| 维度 | vLLM 参数 | SGLang 参数 | 取值 |
|---|---|---|---|
| 上下文长度 | --max-model-len |
--context-length |
32768 |
| 显存占用比例 | --gpu-memory-utilization |
--mem-fraction-static |
0.85 |
| 最大并发 | --max-num-seqs |
--max-running-requests |
128 |
| 单步 token 预算 | --max-num-batched-tokens |
--max-prefill-tokens |
8192 |
| chunk 切分 | (V1 默认开) | --chunked-prefill-size |
8192 |
| 前缀缓存 | --enable-prefix-caching |
(Radix 默认开) | 开 |
| CUDA Graph | 默认开 | 默认开 | 开 |
两个必须知道的默认值差异:
- vLLM 侧没有
--chunked-prefill-size这个参数,V1 引擎里 chunked prefill 默认开,由--max-num-batched-tokens统一控制 - SGLang 的
--max-running-requests默认是 4096 (实测启动日志里明明白白写着max_running_requests=4096)。不显式设成 128,两边的并发上限根本不在一个量级,比出来的吞吐毫无意义
10.4 更公平的做法:两边都用 openai 后端
bash
# 1) 常驻压测客户端(不占 GPU,只负责发包)
docker run -d --name bench-client --network llmbench \
  -v D:/models/Qwen2.5-7B-Instruct:/models/qwen:ro \
  -e HF_HUB_OFFLINE=1 --entrypoint sleep \
  vllm/vllm-openai:v0.28.0-cu129 infinity

# 2) 打 vLLM
docker exec bench-client vllm bench serve \
  --backend openai --endpoint /v1/completions \
  --base-url http://vllm-qwen:8000 \
  --model qwen2.5-7b --tokenizer /models/qwen \
  --dataset-name random --random-input-len 4096 --random-output-len 512 \
  --num-prompts 256 --request-rate inf --max-concurrency 128 --ignore-eos \
  --percentile-metrics ttft,tpot,itl,e2el --metric-percentiles 50,90,95,99

# 3) 打 SGLang:同一个容器、同一份数据集,只换 base-url
docker exec bench-client vllm bench serve \
  --backend openai --endpoint /v1/completions \
  --base-url http://sglang-qwen:30000 \
  --model qwen2.5-7b --tokenizer /models/qwen \
  --dataset-name random --random-input-len 4096 --random-output-len 512 \
  --num-prompts 256 --request-rate inf --max-concurrency 128 --ignore-eos \
  --percentile-metrics ttft,tpot,itl,e2el --metric-percentiles 50,90,95,99
两边都走 OpenAI 兼容接口,客户端代码逐字节一致,唯一的差别只剩服务端------这才叫可比。
并发按 1 / 16 / 64 / 128 扫,请求数随并发放大(1→20、16→32、64→128、128→256)。低并发点样本太少的话,分位数根本不稳定。
跑完你会看到真实的报告长这样。下面两份都是我这台机器上的原始输出,不是示意 ------ 先看健康的低并发(并发 1):
java
============ Serving Benchmark Result ============
Successful requests:                     20
Failed requests:                         0
Maximum request concurrency:             1
Benchmark duration (s):                  122.45
Total input tokens:                      81920
Total generated tokens:                  10240
Output token throughput (tok/s):         83.63
Total token throughput (tok/s):          752.64
---------------Time to First Token----------------
Mean TTFT (ms):                          327.54
P50 TTFT (ms):                           326.75
P99 TTFT (ms):                           343.80
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          11.34
P99 TPOT (ms):                           11.42
---------------Inter-token Latency----------------
Mean ITL (ms):                           11.34
P99 ITL (ms):                            12.76
----------------End-to-end Latency----------------
Mean E2EL (ms):                          6122.32
P99 E2EL (ms):                           6175.16
==================================================
再把同一台机器、同一个模型、同一个客户端的并发从 1 提到 128:
java
============ Serving Benchmark Result ============
Successful requests:                     256
Failed requests:                         0
Maximum request concurrency:             128
Benchmark duration (s):                  160.63
Total input tokens:                      1048576
Total generated tokens:                  131072
Output token throughput (tok/s):         815.96
Total token throughput (tok/s):          7343.66
---------------Time to First Token----------------
Mean TTFT (ms):                          43765.43
P50 TTFT (ms):                           54943.65
P90 TTFT (ms):                           61122.51
P99 TTFT (ms):                           68232.12
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          48.37
P99 TPOT (ms):                           74.76
---------------Inter-token Latency----------------
Mean ITL (ms):                           48.37
P50 ITL (ms):                            25.31
P99 ITL (ms):                            625.08
----------------End-to-end Latency----------------
Mean E2EL (ms):                          68483.79
P50 E2EL (ms):                           73663.00
P99 E2EL (ms):                           93561.58
==================================================
这两份报告放在一起,能读出四个只看吞吐数字绝对发现不了的信息:
- P50 TTFT(54.9 秒)居然比 Mean TTFT(43.8 秒)还大。 说明分布是左偏的:大多数请求排满了整个队伍,少数早早被服务的请求把均值拉低了。这种时候报均值就是自我安慰,该报 P50 和 P90。
- Mean ITL 48 ms,但 P99 ITL 是 625 ms ------ 13 倍。 这是抢占/重算的指纹:KV 池装不下这么多并发,部分请求被换出,再回来时 prefix 得重算一遍,于是那一步的 token 间隔暴涨到几百毫秒。只看均值你永远发现不了这件事。
- TTFT 从 0.33 秒变成 44 秒,但总吞吐只从 753 涨到 7,344。 并发翻了 128 倍,吞吐只翻了 9.8 倍,代价是首字延迟翻了 134 倍。
- 两份报告的
Failed requests都是 0。 服务"全成功"和"服务可用"完全是两件事------这就是为什么必须把分位数和 KV/抢占指标一起看。
10.5 实测结果
10 组压测全部 0 失败请求 。随机数据集、输入 4096 / 输出 512、--request-rate inf 定并发压满:
| 并发 | 引擎 | 总吞吐 (tok/s) | 输出吞吐 (tok/s) | TTFT 均值 (ms) | TTFT P99 (ms) | TPOT 均值 (ms) | E2EL 均值 (ms) |
|---|---|---|---|---|---|---|---|
| 1 | vLLM | 752.64 | 83.63 | 327.54 | 343.80 | 11.34 | 6,122 |
| 1 | SGLang | 791.06 | 87.90 | 523.85 | 3,796.43 | 10.37 | 5,825 |
| 16 | vLLM | 7,258.76 | 806.53 | 768.17 | 2,356.15 | 18.31 | 10,125 |
| 16 | SGLang | 7,941.96 | 882.44 | 984.13 | 3,676.66 | 16.22 | 9,275 |
| 64 | vLLM | 8,299.22 | 922.14 | 9,874.74 | 24,925.68 | 43.97 | 32,342 |
| 64 | SGLang | 10,044.54 | 1,116.06 | 9,897.82 | 28,144.28 | 29.97 | 25,210 |
| 128 | vLLM | 7,343.66 | 815.96 | 43,765.43 | 68,232.12 | 48.37 | 68,484 |
| 128 | SGLang | 8,598.27 | 955.36 | 38,741.12 | 58,411.00 | 33.76 | 55,992 |
结论一:吞吐在并发 64 就到顶了,再加并发只是把 TTFT 顶到 43 秒。
| 并发 | vLLM 总吞吐 | 环比 | TTFT 均值 |
|---|---|---|---|
| 1 | 753 | --- | 0.33 s |
| 16 | 7,259 | +864% | 0.77 s |
| 64 | 8,299 | +14% | 9.87 s |
| 128 | 7,344 | −12% | 43.77 s |
SGLang 的形状一模一样(16→64 涨 26%,64→128 跌 14%)。这就是"扩容成功的假象" :你把 --max-num-seqs 从 64 调到 128,吞吐不升反降,而 TTFT 涨了 4.4 倍。单看吞吐你会说"差不多",看 TTFT 才知道服务已经塌了。
结论二:--max-num-seqs 128 只是纸面上限,真正能同时跑几个由 KV 池决定。
ini
vLLM   启动日志:  GPU KV cache size: 194,896 tokens
SGLang 启动指标:  max_total_num_tokens = 210,714

单个请求占用 = 输入 4096 + 输出 512 = 4,608 token
vLLM   实际可并发 = 194,896 ÷ 4,608 ≈ 42 个
SGLang 实际可并发 = 210,714 ÷ 4,608 ≈ 46 个
设的是 128,实际只能同时跑 42 个 ,剩下 86 个全在排队。43 秒的 TTFT 里绝大部分是排队时间------实测抢占只有 35 次(SGLang 侧 retract 10 次),不是抢占主导,是准入排队主导。这也解释了为什么两者高并发吞吐差得不多:瓶颈都在同一块显存带宽上。
结论三:两个引擎的强项不一样,别指望一个"全面更好"。
| 维度 | 赢家 | 差距 |
|---|---|---|
| 低并发 TTFT | vLLM | 328 vs 524 ms(快 60%) |
| 高并发总吞吐 | SGLang | c64 高 21%、c128 高 17% |
| 高并发 TPOT | SGLang | c128: 33.76 vs 48.37 ms |
| 前缀缓存命中率 | SGLang | 94.1% vs 78.4% |
| 启动到就绪 | vLLM | 4 分 13 秒 vs 5 分 59 秒 |
结论四:前缀缓存的收益是断崖式的,命中率也是可以直接测出来的。
用 --prefix-repetition-* 造一组共享前缀的负载(2048 前缀 + 128 后缀,输出 128,并发 32):
| 指标 | vLLM | SGLang |
|---|---|---|
| 总吞吐 (tok/s) | 24,503 | 22,007 |
| TTFT 均值 | 916 ms | 1,269 ms |
| TTFT P99 | 1,783 ms | 2,755 ms |
| 后缀命中率 | 78.4% | 94.1% |
命中率的算法,两个引擎路子不同:
- vLLM 靠两个计数器自己算 :
prefix_cache_hits_total ÷ prefix_cache_queries_total。本次增量是 102,384 ÷ 130,561 = 78.4% (顺手验证一件事:全程prefix_cache_queries_total= 1,785,856,和各并发组输入 token 总和一字不差,说明这个计数器可信) - SGLang 直接给你一个 gauge :
sglang:cache_hit_rate= 0.9412,不用自己算
⚠️ 注意这组的输入 shape(2048+128)和上表的 4096/512 不同,吞吐数字不能直接跨表比倍数,但命中率和 TTFT 的对比是干净的。
一个必须知道的测试缺陷:这次没做预热。
看 SGLang 并发 1 那组:均值 523.85 ms ,但 P50 只有 310.47 ms 、P99 高达 3,796.43 ms。20 个请求里有一个吃了冷启动的大亏,直接把均值和 P99 一起带偏。
原因在 vllm bench serve 的 --num-warmups 默认是 0 ;而 vLLM 自己在启动阶段就做了预热(日志里的 init engine (profile, create kv cache, warmup model)),SGLang 没有,所以首个真实请求的代价落进了报告。
下次压测一律加 --num-warmups 8,否则你看到的"长尾抖动"其实是冷启动。这是我这次跑完才补上的一课。
10.6 只有实跑才会踩到的坑(附实测数字)
⚠️ 最大的一个坑:WSL2 上用 vLLM 0.28,必须手动开 pinned memory,否则引擎起不来。
我第一次启动 vLLM 直接崩了:
arduino
RuntimeError: UVA is not available
  File "vllm/v1/worker/gpu/buffer_utils.py", line 47, in __init__
    raise RuntimeError("UVA is not available")
翻源码才明白链路:V1 的新 GPU runner 需要 UVA(统一虚拟寻址) → UVA 需要 pinned memory → 而 vLLM 在 WSL2 上默认把 pinned memory 关掉了 。关键代码在 vllm/platforms/cuda.py:
python
if in_wsl():
    version = _get_wsl_kernel_version()
    if version is None or version < (4, 19, 121):
        return False                      # 内核太老,确实不支持
    # On compatible WSL2 kernels, pinned memory is supported but
    # disabled by default. Enable it via VLLM_WSL2_ENABLE_PIN_MEMORY=1.
    return envs.VLLM_WSL2_ENABLE_PIN_MEMORY   # ← 默认 False,就崩在这
我的容器内核实测 6.18.33.2-microsoft-standard-WSL2,远高于 4.19.121,能力是有的,只是默认关着。加一个环境变量就好了:
bash
docker run ... -e VLLM_WSL2_ENABLE_PIN_MEMORY=1 vllm/vllm-openai:v0.28.0-cu129 ...⚠️ 第二个坑:RTX 50 系(sm_120)必须用 CUDA 12.9+ 的镜像 ,否则 no kernel image is available for execution on the device。实测容器里 torch.cuda.get_device_capability() = (12, 0)。
启动耗时(实测,从 docker run 到 /health 返回 200):
| 阶段 | vLLM 0.28.0 | SGLang 0.5.21 |
|---|---|---|
| 加载权重 | 136.57 s | 85.68 s |
| 编译 / CUDA Graph 捕获 | torch.compile 12.42 s + 捕获 67 s | 启动阶段已含 |
| KV 分配 | --- | 0.88 s |
| 引擎初始化合计 | 122.78 s(含预热) | scheduler_e2e 292.88 s |
| 容器起到就绪 | 4 分 13 秒 | 5 分 59 秒 |
KV 池实测容量(两边都是 0.85 显存比例 / 32K 上下文):
| 引擎 | KV token 数 | KV 显存 |
|---|---|---|
| vLLM | 194,896 | 10.41 GiB |
| SGLang | 210,714 | 11.25 GB |
模型权重在 Windows 绑定挂载上的读取速度实测 134 MB/s (NVMe 被 virtiofs 拖累),15.2 GB 权重光读就要一百多秒------反复重启调参的场景,强烈建议把模型一次性 docker cp 进卷里。
几个环境侧的坑,一并记下:
| 现象 | 实测 | 教训 |
|---|---|---|
| 并行拉两个大镜像 | 大层卡在 Retrying in 5 seconds 死循环 |
两条拉取抢一条带宽,大层一重试就得从零重来;改串行后 0 次重试 |
| 拉取中途中断 | 已下载的层保不住 | 那些层没有镜像引用,属于悬空层会被回收,下次还得重下 |
| SGLang 的 Radix 缓存实现 | UnifiedRadixCache + RustUnifiedTreeCore |
启动日志里写的就是这个名字,比文档和博客里的旧名字准 |
SGLang 默认 max_running_requests |
4096 |
不显式设成 128,两边的并发上限根本不在一个量级 |
10.7 想再往深挖,这几个测试条件必须注意
--request-rate inf+--max-concurrency是"定并发压满",--request-rate N才是"定速率"。 测排队时延和 P99 要用后者,前者会把排队问题藏起来。- SGLang 的
--disable-ignore-eos:用真实 prompt 压测时加上,避免强行 decode 到固定长度把输出分布压成乱码。加上之后报告会多出 steady-state 列。 - 固定 shape 微基准 (去调度噪声,看纯 kernel 性能):vLLM 用
vllm bench latency --batch-size --input-len --output-len;SGLang 用python -m sglang.bench_one_batch --batch-size --input-len --output-len。 - 长上下文衰减 :input len 扫 8K/32K/64K/128K/256K,同时把
--max-model-len(vLLM) /--context-length(SGLang) 提到对应值,画 TTFT 和 output throughput 两条曲线。
配图建议:一张双引擎对比折线图,横轴为并发(1→256),两条线分别为 TTFT P99,标注拐点位置
十一、快速换算与避坑速查表
参数等价对照(记住这张表,两个引擎随便切):
| 概念 | vLLM | SGLang |
|---|---|---|
| 单步 token 预算 | --max-num-batched-tokens(默认 2048) |
--max-prefill-tokens(默认 16384) |
| chunked prefill | V1 默认开,--no-enable-chunked-prefill 关 |
--chunked-prefill-size(默认 8192,-1 关) |
| 最大并发序列 | --max-num-seqs |
--max-running-requests |
| KV 显存占比 | --gpu-memory-utilization |
--mem-fraction-static |
| KV 池硬上限 | --num-gpu-blocks-override、--kv-cache-memory-bytes |
--max-total-tokens |
| KV 块/页大小 | --block-size |
--page-size |
| KV 精度 | --kv-cache-dtype |
--kv-cache-dtype |
| 前缀缓存 | --enable-prefix-caching |
默认开,--disable-radix-cache |
| 调度策略 | --scheduling-policy fcfs/priority |
--schedule-policy(默认 fcfs) |
| 最大长度 | --max-model-len |
--context-length |
| CUDA Graph | 默认开,--enforce-eager 关 |
默认开,--disable-cuda-graph |
| torch.compile | -O3 |
--enable-torch-compile |
| attention backend | VLLM_ATTENTION_BACKEND 环境变量 |
--attention-backend |
| 并行 | -tp/-pp/-dp、--enable-expert-parallel |
--tp-size/--pp-size/--dp-size/--ep-size |
| PD 分离 | --kv-transfer-config |
--disaggregation-mode prefill/decode |
| 指标端点 | /metrics 默认可用 |
--enable-metrics(默认 False,必须显式开) |
实跑补充:SGLang 侧几个只在 server_args 里才看得到的默认值
(来源:启动日志里打印的有效参数,比查文档和博客都可靠------文档会滞后,博客会抄错)
| 参数 | 实测默认值 | 影响什么 |
|---|---|---|
schedule_policy |
fcfs |
调度顺序。网上不少地方写 lpm,那是历史版本 |
radix_eviction_policy |
lru |
前缀缓存的淘汰顺序,直接决定命中率 |
retraction_policy |
length |
显存不够时抢占谁------这就是 retract 类指标的来源 |
max_prefill_tokens |
16384 | 单步 prefill 预算,和 vLLM 的 --max-num-batched-tokens 对应 |
disable_radix_cache |
False |
前缀缓存默认就是开的 |
disable_overlap_schedule |
False |
overlap 调度默认开 |
page_size |
1 |
KV 页粒度(vLLM 里叫 --block-size) |
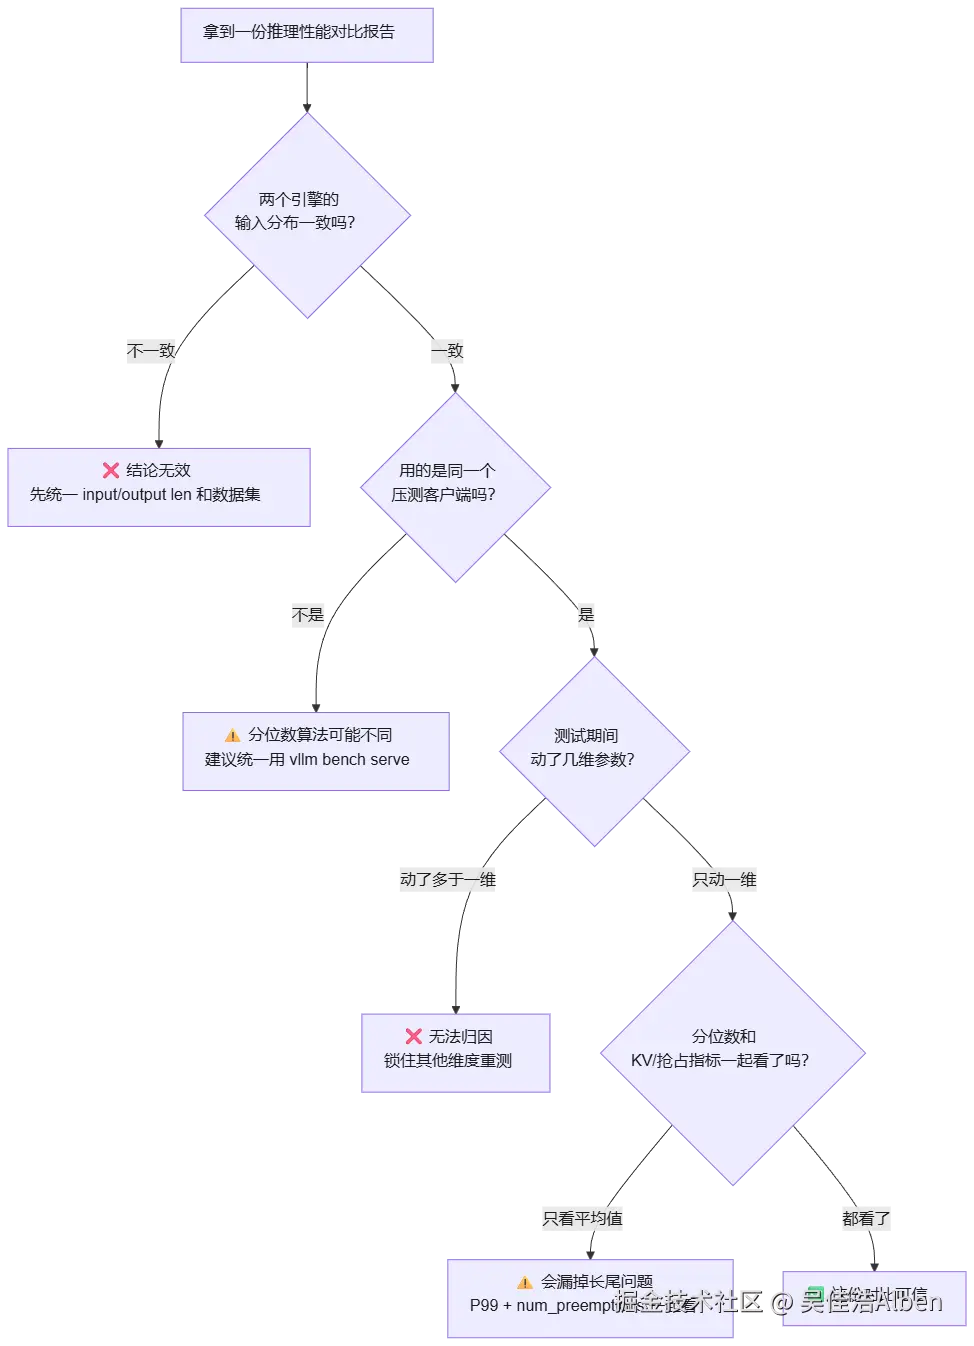
避坑清单(拿到一份压测报告时,先问自己这几个问题):
- 这个指标是 A 类、B 类还是 C 类? ------ C 类的指标别去查参数,查不到
- 两个引擎的输入分布完全一致吗?(input/output len、是否 ignore_eos、数据集有没有共享前缀)------ 不一致的对比毫无意义
- 分位数是显式打开的吗? ------
--metric-percentiles默认只有 99,不写就没有 P50/P90/P95 - 这次测试动了几维参数? ------ 一次只动一维,另一维锁死,否则数据不可比
- GPU 利用率是从哪来的? ------ 引擎
/metrics里没有,别拿nvidia-smi的 GPU-Util 当算力利用率用 - 做预热了吗? ------
vllm bench serve的--num-warmups默认是 0,首个请求的冷启动会直接污染 P99。我这次就中招了:SGLang 并发 1 那组均值 524 ms 而 P50 只有 310 ms,差的 200 多毫秒全来自那一个冷启动请求
十二、一句话总结
推理引擎的性能指标分三层:A 类有旋钮(并发、KV 显存占比、chunk 大小、调度策略),B 类只能测(TTFT、TPOT、ITL、命中率、P99),C 类引擎根本不管(SM 占用、Tensor Core、显存带宽、NCCL),把 C 类当 A 类查参数是最常见的时间黑洞;同一个概念在 vLLM 和 SGLang 里叫法不同(max-num-seqs ↔ max-running-requests、gpu-memory-utilization ↔ mem-fraction-static、max-num-batched-tokens ↔ max-prefill-tokens),记住概念别记名字;调参的方向是反对称的,token 预算调大换来 prefill 吞吐但牺牲 TTFT 抖动和 ITL,并发调大换来总吞吐但抬高 TPOT,所以一次只能动一维、另一维锁死;并发和 KV 必须一起看,否则你看到的"扩容成功"很可能只是排在队伍里被反复抢占;最后,所有参数都以你机器上
--help的输出为准,不要信博客------包括我这篇。
个人声明:
本文所有参数名、默认值和指标名均核对自 vLLM / SGLang 官方文档与 GitHub 源码,并且第十节的全部数据都来自本机实跑 :RTX 5090 32GB、Qwen2.5-7B-Instruct bf16、vLLM 0.28.0(cu129 镜像)、SGLang 0.5.21,同一个压测客户端、同一份数据集、逐项对齐配置,10 组压测 0 失败请求。两处原先存疑的地方也已用实测解决:--schedule-policy 的默认值确为 fcfs(从启动日志的 server_args 打印取证,网上流传的 lpm 是历史版本),前缀缓存计数器确认是 vllm:prefix_cache_hits_total (带 _total 后缀,不是 prefix_cache_hits)。
但这份数据的边界必须说清楚:单卡、单模型、每个并发点只跑了一轮、没有做预热 (--num-warmups 默认 0,所以 SGLang 并发 1 那组的 P99 里混着冷启动),而且用的是 --request-rate inf 定并发压满,不是定速率。换模型、换卡、换 QPS 模型,结论都可能变,请以你自己机器上的实跑为准。
如果这篇帮你少踩一个坑(尤其是 WSL2 那个 UVA is not available,真的很坑),那就没白写。有疑议不要喷俺,可以留言!!!