前言
学 Docker,说实话是被我自己的项目「逼」的。
那段时间我一直在做一个AI私人书房 BookSoul(React + NestJS + LangGraph + Milvus,代码已开源在 GitHub,感兴趣的朋友可以去看看、顺手点个 Star)。功能一点点磨到差不多,终于走到要上线这一步 ------ 兴奋是真的,头大也是真的。
我的开发环境是 Windows,服务器却是一台干净的 Linux。要把项目跑起来,得先在服务器上装 Node、PostgreSQL、Nginx,还要连通云端的 Milvus 和模型服务。我硬着头皮手动装过一遍,心里完全没底:版本和本地对不上怎么办?哪一步漏配了怎么办?更关键的是,上线之后总免不了更新和回滚,难道每次都靠手敲命令、靠记忆去赌?
折腾一轮我才意识到,这些焦虑的根源是同一个问题:环境不一致、流程不可重复。本地跑得好好的程序,换个操作系统、换个依赖版本,表现就可能完全不同;而纯手工部署既没法保证每次一模一样,出了问题也很难干净地退回去。
Docker 给出的答案非常干脆:把程序和它运行所需的一切一起打包进镜像,让同一份镜像在任何机器上都有一致的表现;再用 Compose 把整个部署流程固化下来,一条命令拉起、一条命令回滚。
一、Docker 是什么,容器到底轻量在哪
Docker 是一个用 Go 实现的开源项目,它把程序、运行时、系统库和配置一起打包进镜像(Image) ,镜像运行起来就是容器(Container)。
一句话:只要我能跑起来,你拿到这个镜像也一定能跑起来,和操作系统无关。
容器经常被拿来和虚拟机对比,二者的结构差异如下图:
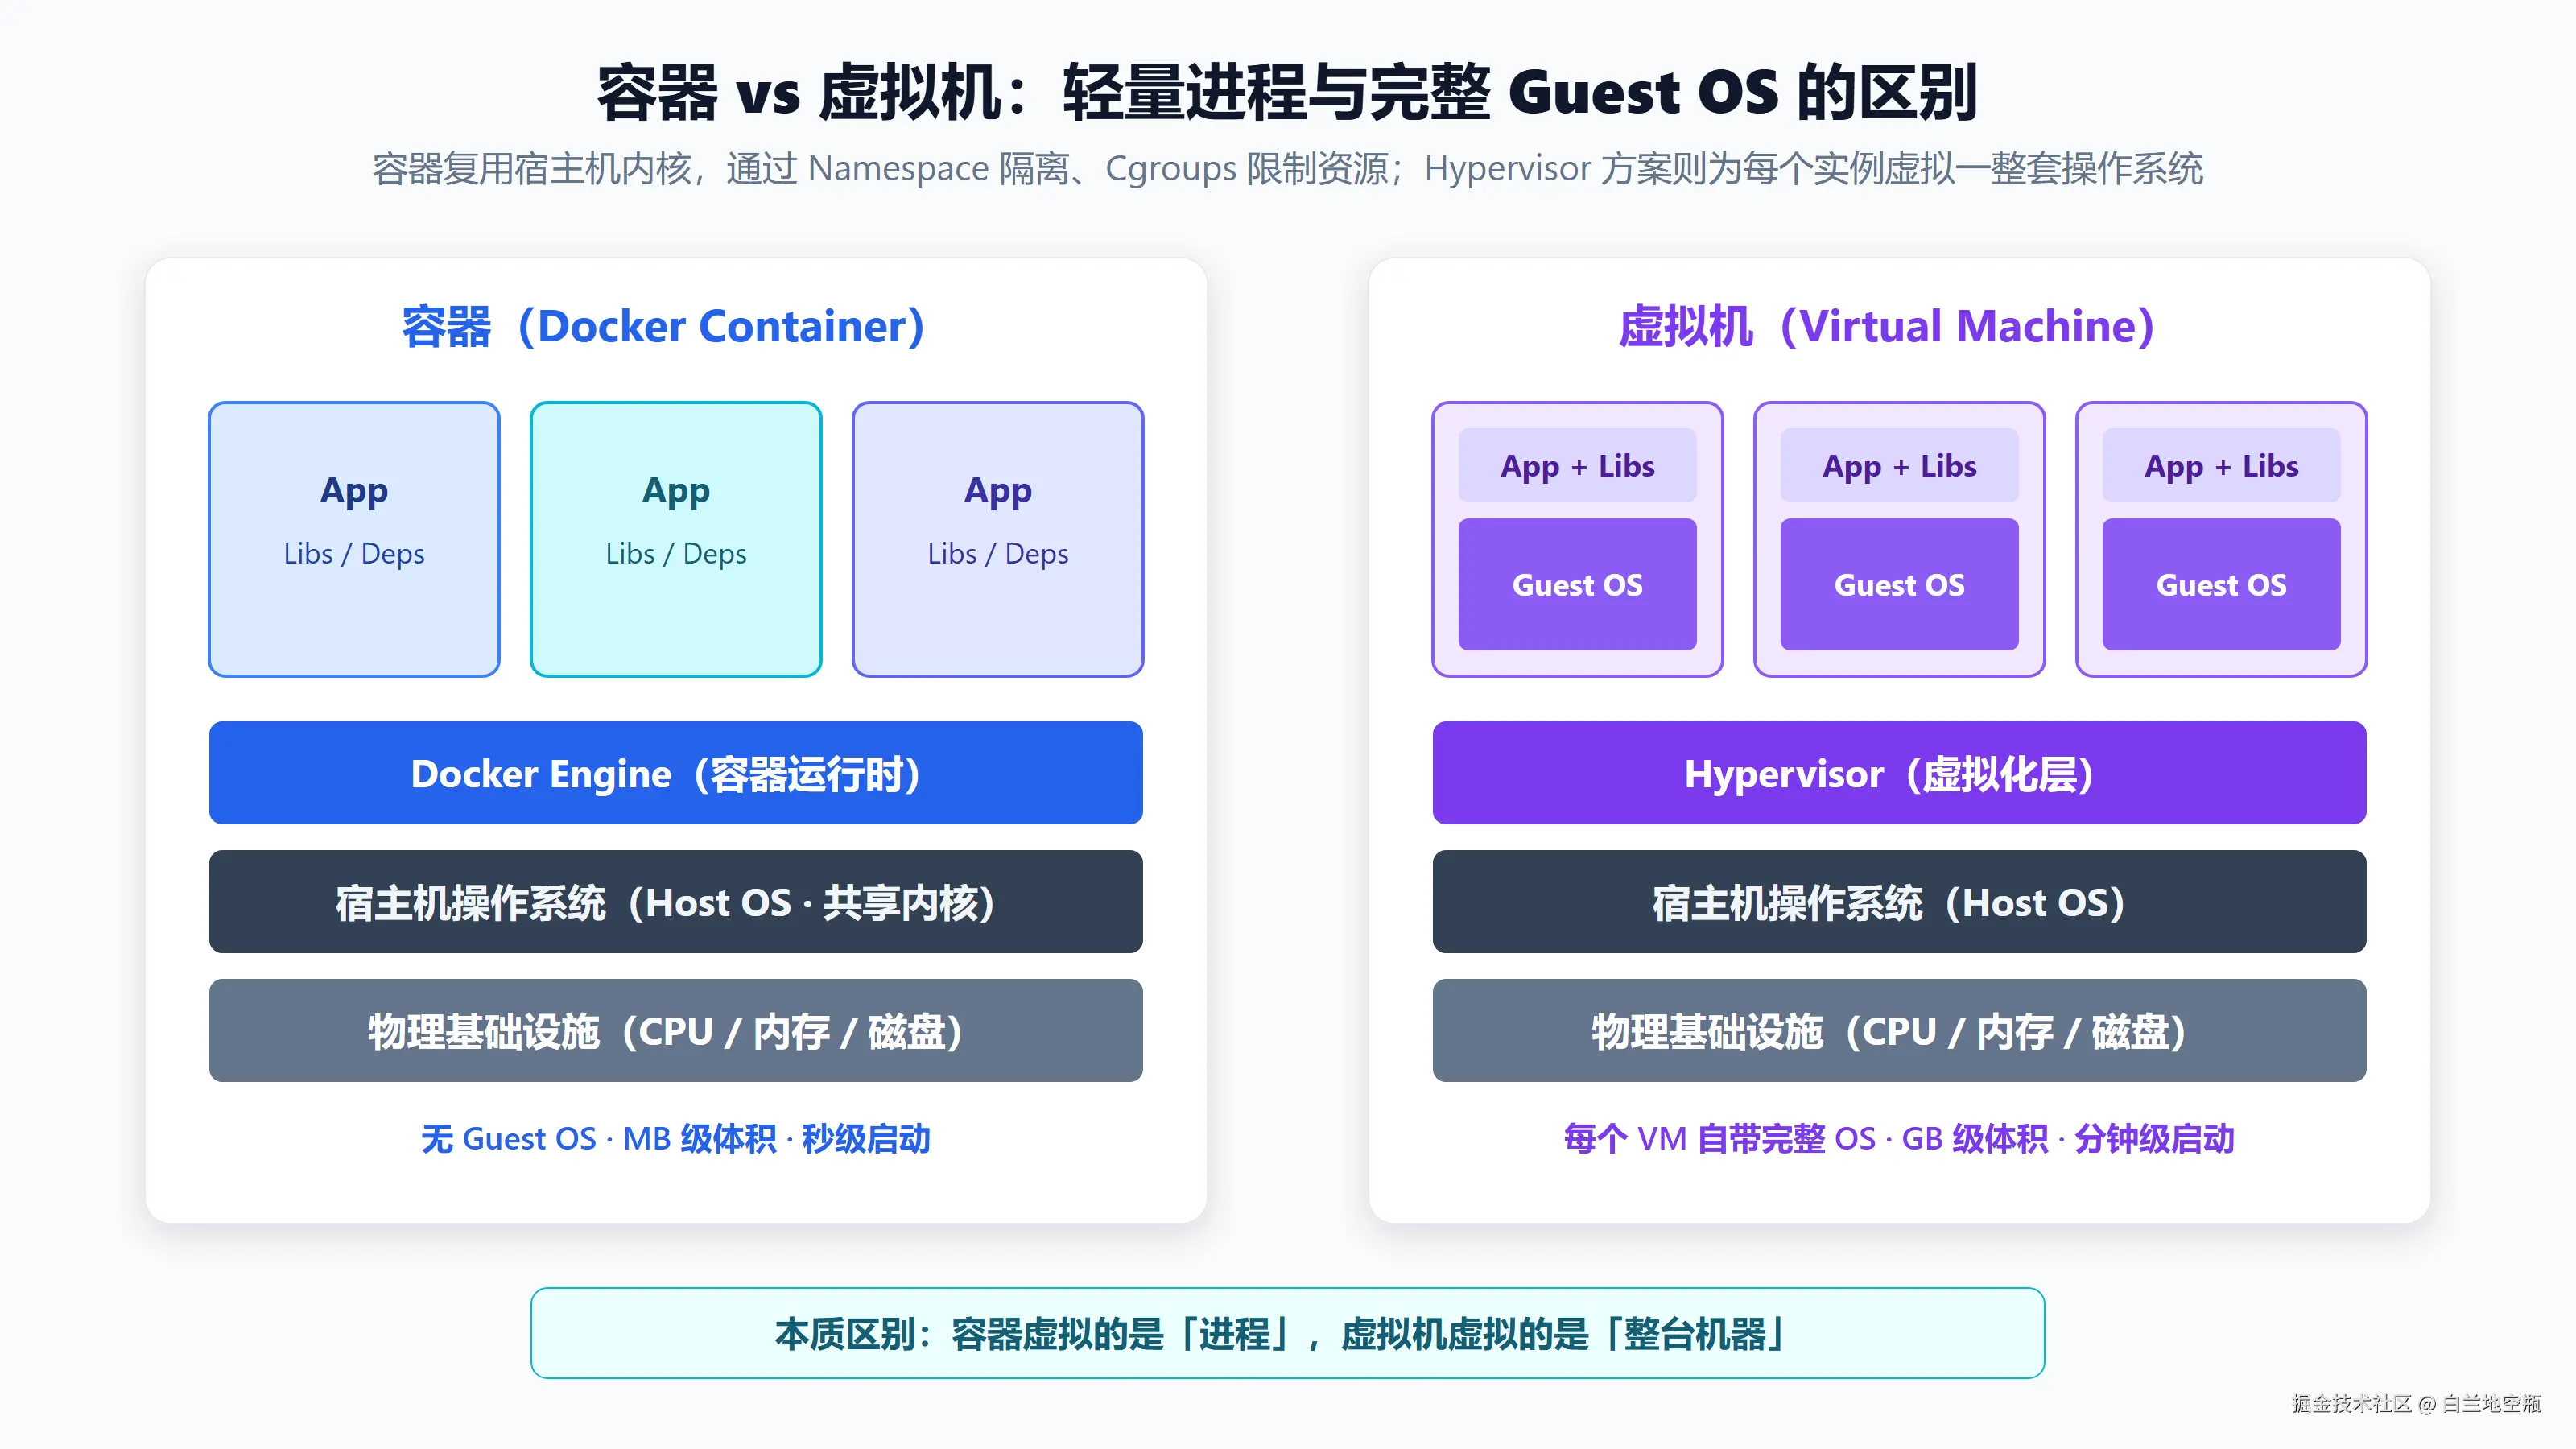
可以看到,Hypervisor 方案要为每个虚拟机虚拟一整套 Guest OS;而容器复用宿主机内核,容器内没有、也不需要 Guest OS。它的底层主要依赖三项 Linux 技术:
-
Namespaces(命名空间):实现资源隔离。PID、网络、挂载点、UTS、IPC、User 等命名空间,让容器内的进程「看到」的是一个独立的世界;
-
Cgroups(控制组):实现资源限制。限制容器能用多少 CPU、内存、IO,防止某个容器吃光宿主机资源;
-
Union File System(联合文件系统):实现镜像分层,下一节细讲。
所以容器的本质,是一个被隔离、被限制资源、拥有独立根文件系统的普通进程------ 它虚拟的是「进程」,而虚拟机虚拟的是「整台机器」。这也是容器 MB 级体积、秒级启动的根本原因。
二、镜像、容器、仓库与 C/S 架构
Docker 有三个绕不开的核心概念:
-
镜像(Image) :只读模板,比如官方的
mysql:5.7、nginx:alpine; -
容器(Container) :镜像运行起来的实例。用 OOP 类比,镜像是类,容器是实例,同一个镜像可以同时跑出多个容器;
-
仓库(Registry):集中存放和分发镜像的地方,比如 Docker Hub,以及生产中常用的私有仓库(如阿里云 ACR)。
Docker 采用 Client / Server 架构,我们敲的 docker 命令只是客户端,真正干活的是后台常驻的守护进程:
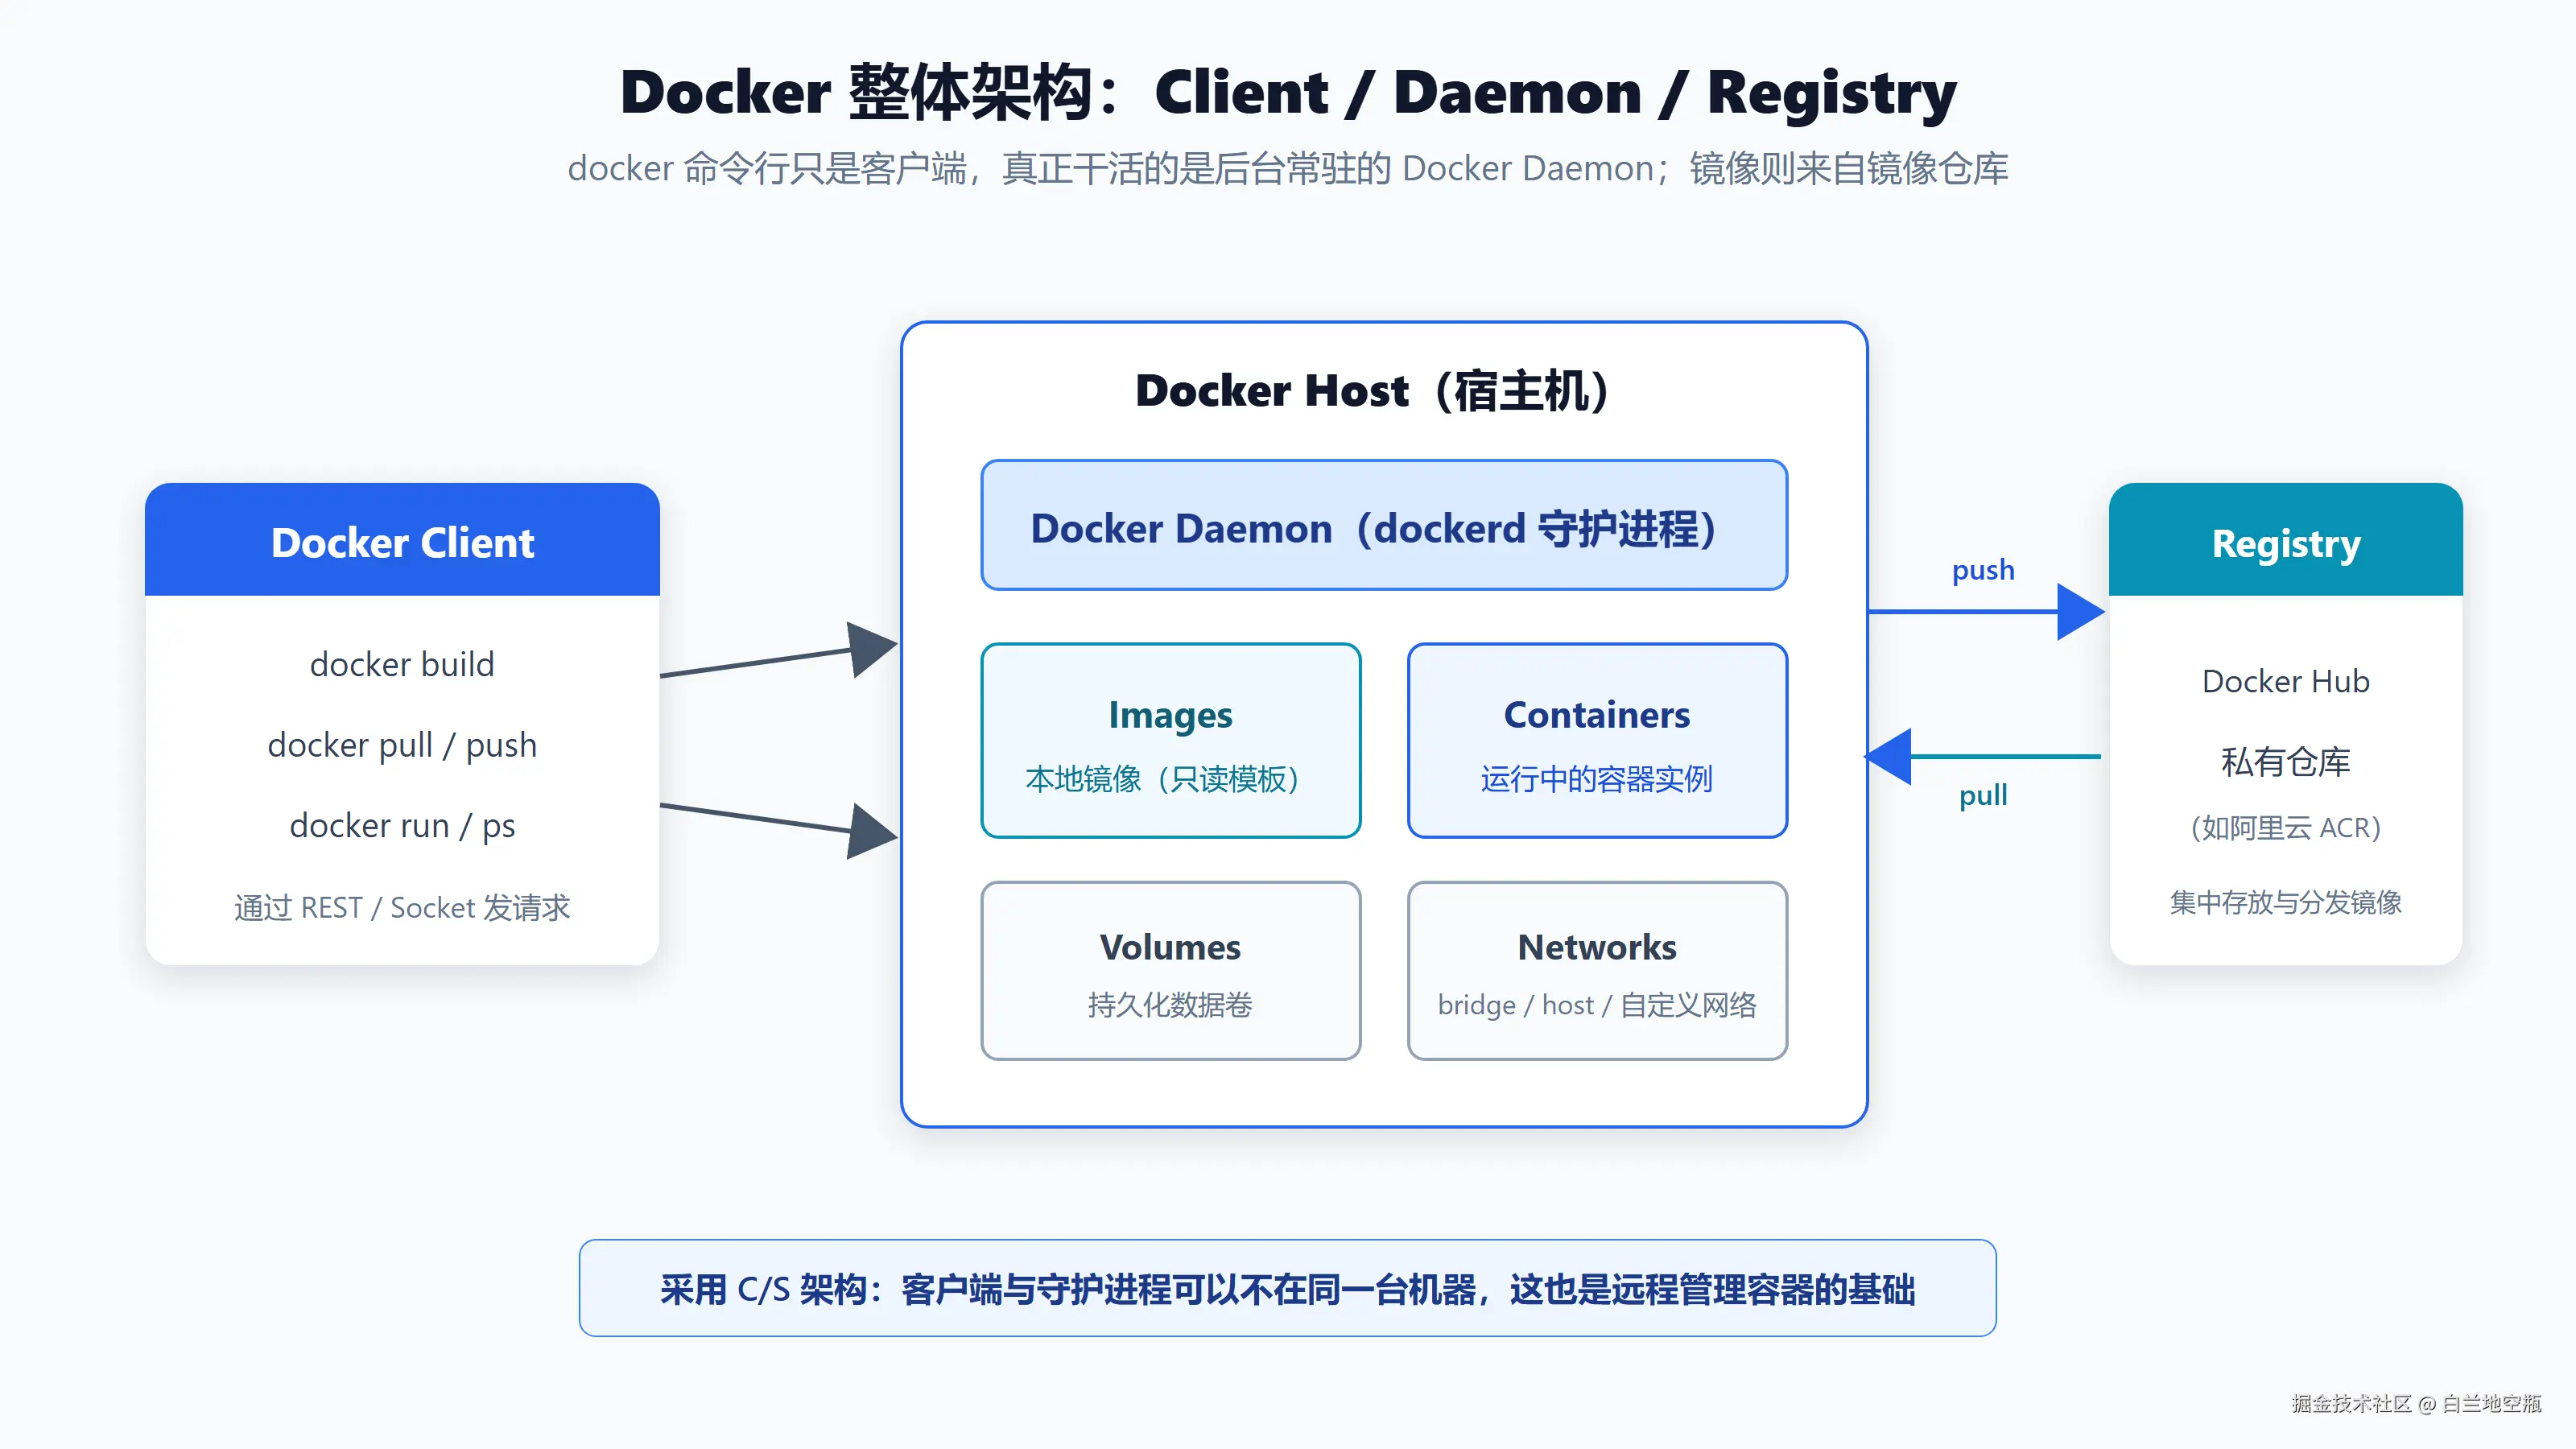
客户端把命令(构建、拉取、运行)通过 Socket 或 REST 发给 Docker Daemon,由 Daemon 操作镜像和容器;拉取和推送镜像时,Daemon 再与 Registry 通信。客户端和守护进程甚至可以不在同一台机器上。
日常高频命令其实就这些:
bash
docker pull 镜像名:tag       # 拉取镜像,不写 tag 默认 latest

docker images               # 查看本地镜像

docker run \[选项] 镜像名      # 由镜像启动容器

docker ps                   # 查看运行中的容器,-a 查看全部

docker logs -f 容器名        # 跟踪日志,排查问题的第一步

docker exec -it 容器名 bash  # 进入运行中的容器调试

docker stop / start / rm     # 停止 / 启动 / 删除容器
容器启动就报错时,我的固定排查路径是:先 docker logs 看错误输出;日志看不出问题,就用 docker run -it 镜像 sh 起一个终端,进去手动执行启动命令,问题基本藏不住。
三、镜像为什么要分层:UnionFS 与构建缓存
Dockerfile 里的每条指令,都会生成一个只读层(Layer) ,这些层通过联合文件系统自下而上叠加,最终组成镜像;容器启动时,Docker 会在最顶部再加一个可写层:
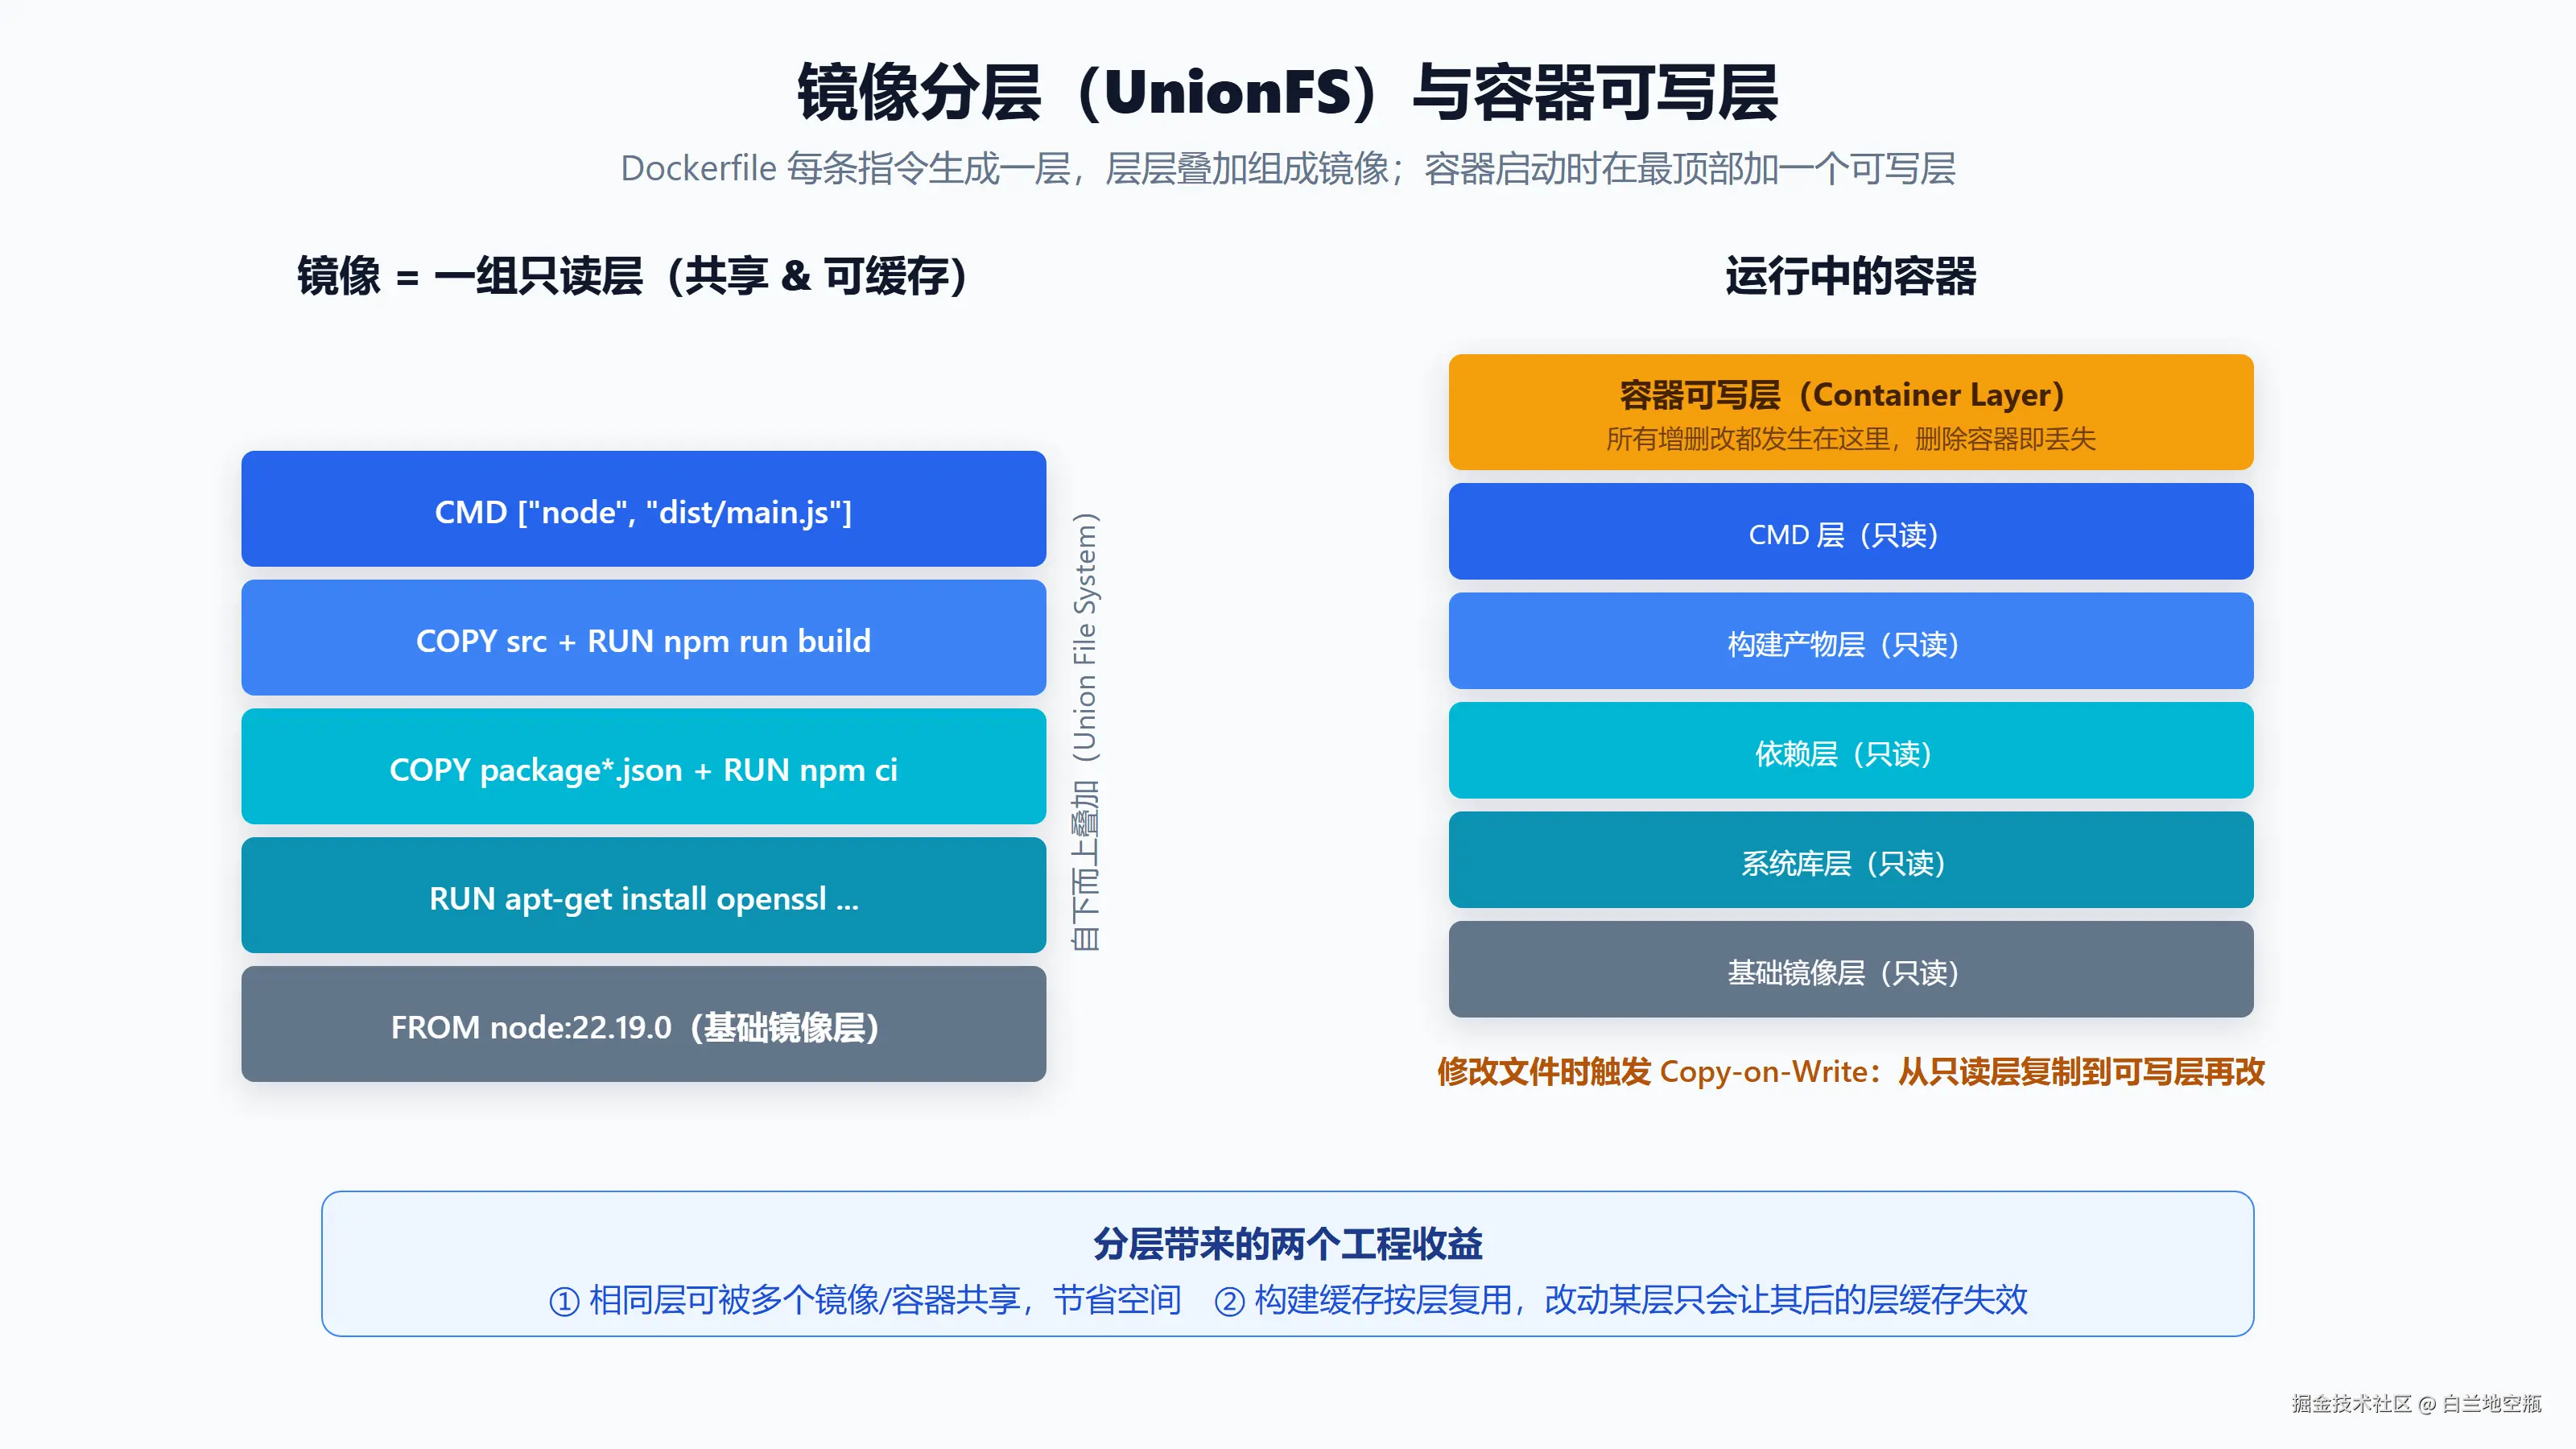
这个设计有两个非常实际的工程收益:
-
层可以共享 :多个镜像如果底层相同(比如都基于
node:22),磁盘上只存一份,容器之间也共享这些只读层; -
构建可以缓存 :构建镜像时,某一层及其指令没有变化,就直接复用缓存。一旦某一层失效,它之后的所有层都会重新构建。
理解了缓存机制,自然就能理解 Dockerfile 的一条优化原则:把不常变化的层放前面,把频繁变化的层放后面。 比如先 COPY package*.json 再 npm ci,最后才 COPY 源码------ 这样改业务代码时,昂贵的依赖安装层依然命中缓存。
容器对文件的修改则遵循 Copy-on-Write(写时复制) :要修改只读层里的文件时,先把该文件复制到顶部的可写层再改。也正因如此,容器删除后,可写层里的数据会一并消失------ 重要数据必须通过挂载持久化。
四、容器网络与端口映射
容器拥有独立的网络命名空间,容器内服务监听的端口,默认只能在容器内部访问。我们用 -p 宿主机端口:容器端口 做端口映射,它背后其实涉及网桥、虚拟网卡对和 iptables 规则:
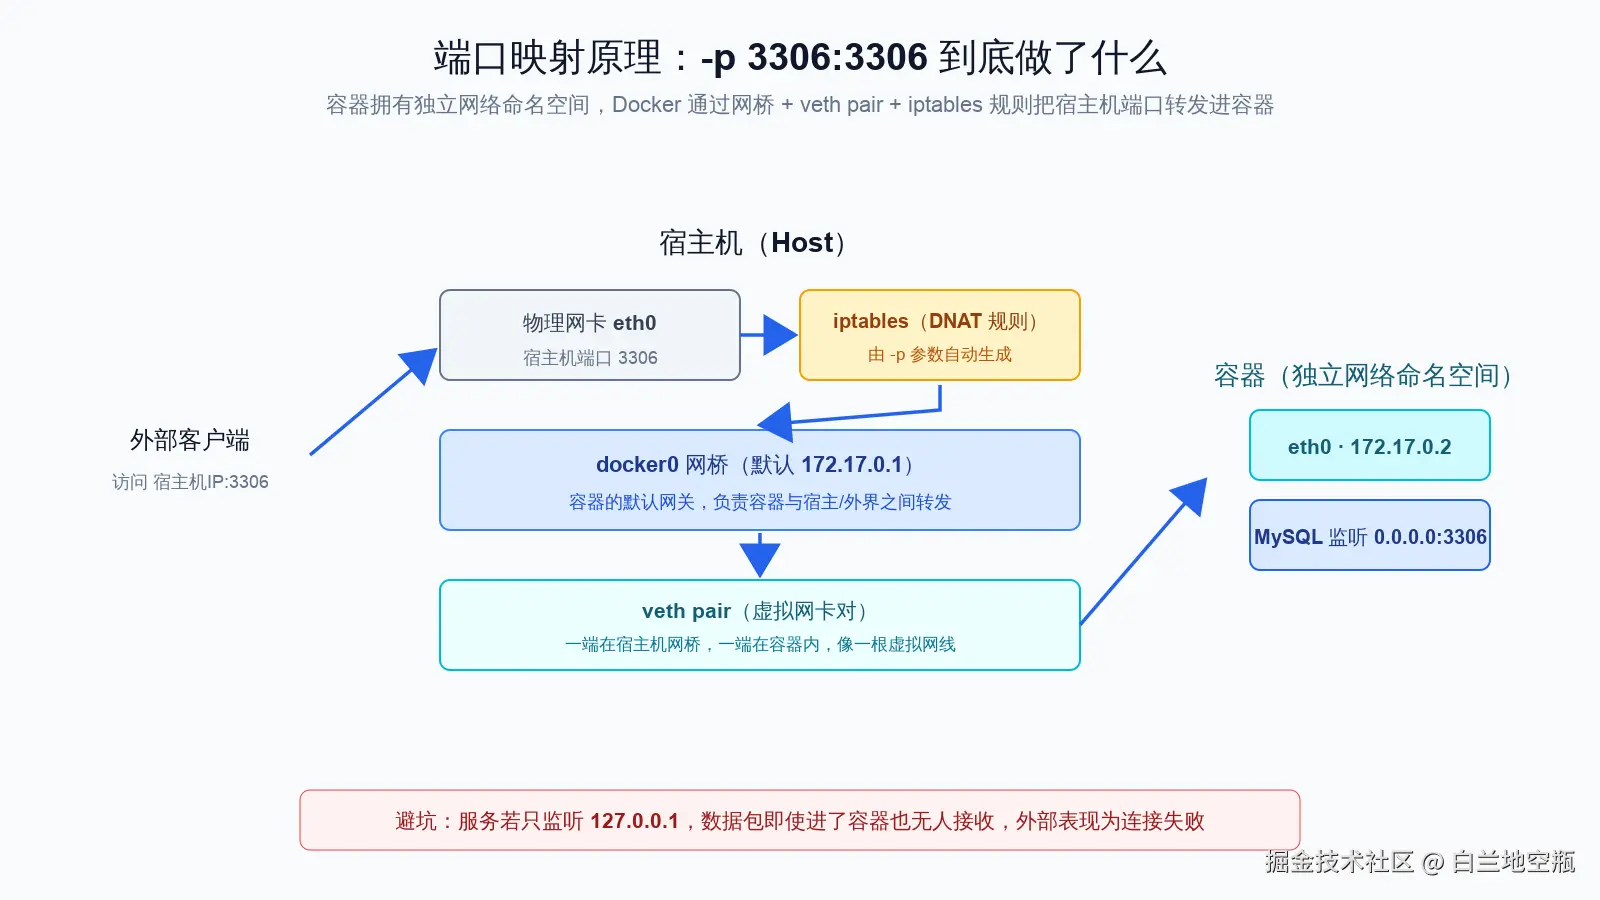
数据包的完整旅程是:
-
外部请求到达宿主机网卡
eth0的对应端口; -
Docker 在启动容器时通过
-p自动生成 iptables DNAT 规则 ,把流量导向docker0网桥; -
docker0(容器默认网关,通常是172.17.0.1)通过 veth pair------ 一对虚拟网卡,一端在宿主机、一端在容器,像一根虚拟网线 ------ 把数据包送进容器; -
容器内的服务收到请求并响应。
这里有一个必须记住的避坑点:**容器内服务要监听 0.0.0.0 ,而不是 **127.0.0.1,否则数据包进了容器也无人接收,外部表现为连接失败。
go
// 错误:只在容器内回环地址监听,外部访问不到

http.ListenAndServe("127.0.0.1:8080", nil)

// 正确:等价于 0.0.0.0:8080,外部可通过端口映射访问

http.ListenAndServe(":8080", nil)
此外,默认的 bridge 网络不支持容器名解析 ,容器间只能靠 IP 通信。生产中我会创建自定义 bridge 网络,它支持用容器名(服务名)直接互相访问,并且不同网络之间天然隔离。这也是后面 Compose 网络的基础。
五、数据持久化:Bind Mount 与 Volume
既然容器可写层不可靠,重要数据就要靠挂载(-v)持久化。Docker 提供两种方式:
| 方式 | 位置与管理 | 适用场景 |
|---|---|---|
| Bind Mount(绑定挂载) | 宿主机上的任意路径,由用户自己管理 | 配置文件、日志目录,需要宿主机直接查看 / 修改 |
| Volume(数据卷) | Docker 统一管理(/var/lib/docker/volumes/) |
数据库等重要数据,跨平台、可备份、可共享 |
bash
\# Bind Mount:宿主机 ./conf 挂载到容器内,配置改动实时生效

docker run -d -v ./nginx.conf:/etc/nginx/nginx.conf:ro nginx

\# Volume:数据库数据交给 Docker 数据卷管理

docker volume create mysql\_data

docker run -d -v mysql\_data:/var/lib/mysql -e MYSQL\_ROOT\_PASSWORD=123456 mysql:5.7
:ro 表示只读,容器只能读取、不能修改宿主机文件,适合证书、配置这类内容。
六、Dockerfile 实战:把 BookSoul 后端做成镜像
只会拉现成镜像大概能覆盖一半场景;部署自己的项目,就要写 Dockerfile。以 BookSoul 后端(NestJS + Prisma)为例,我采用了多阶段构建:
bash
\# 基础镜像锁定 digest,保证每次构建的底座完全一致

FROM node:22.19.0-bookworm-slim@sha256:4a48... AS base

RUN apt-get update && apt-get install -y --no-install-recommends openssl ca-certificates \\

    && rm -rf /var/lib/apt/lists/\*

WORKDIR /app/server

\# 构建阶段:装依赖、生成 Prisma Client、编译

FROM base AS build

COPY server/package\*.json ./

COPY server/prisma ./prisma

RUN npm ci --no-audit --no-fund

\# 构建期不连真实数据库,给一个格式合法的占位连接串即可

RUN DATABASE\_URL=postgresql://unused@127.0.0.1/build npm run prisma:generate

COPY server/src ./src

RUN npm run build

\# 裁剪出生产依赖

FROM build AS production-dependencies

RUN npm prune --omit=dev

\# 运行阶段:只含生产产物,且以非 root 用户运行

FROM base AS runtime

ENV NODE\_ENV=production PORT=3000 BOOK\_UPLOAD\_DIR=/data/books

COPY --from=production-dependencies --chown=node:node /app/server/node\_modules ./node\_modules

COPY --from=build --chown=node:node /app/server/dist ./dist

USER node

EXPOSE 3000

CMD \["node", "dist/main.js"]
这里的每一个选择都对应一个具体的考量:
-
基础镜像锁定 digest(
@sha256:...):而不是只写标签,避免「昨天还能构建、今天底座悄悄变了」; -
多阶段构建:编译工具链和 dev 依赖全部留在 build 阶段,最终镜像只包含生产产物,体积小、攻击面小;
-
非 root 运行(
USER node):即使容器被攻破,拿到的也只是普通用户权限; -
构建期不连数据库:Prisma 生成客户端只需要一个占位连接串,让构建过程无外部依赖、可重复。
我还基于同一个文件做了一个独立的 migration 镜像 target ,它的默认命令仅仅是 prisma --version:
sql
FROM base AS migration

COPY --from=build /app/server/node\_modules ./node\_modules

COPY server/prisma ./prisma

USER node

CMD \["./node\_modules/.bin/prisma", "--version"]
为什么不让容器启动时自动跑迁移? 因为数据库迁移往往涉及停机和数据风险,它可能在扩容、重启、崩溃恢复时被意外触发。我希望迁移永远是一次由人显式发起、先核对再执行的独立操作。
前端则是「构建 + Nginx」两段式:一个阶段用 Vite 打包静态资源,最终阶段放进锁定版本的 Nginx 镜像:
sql
FROM nginx:1.28.3-alpine@sha256:a8b3...

COPY deploy/nginx.conf /etc/nginx/nginx.conf

COPY --from=build /app/client/dist /usr/share/nginx/html

EXPOSE 80 443
七、Docker Compose:多服务一键编排
当应用同时包含 Web、API、数据库时,手动维护一长串 docker run、网络和启动顺序是灾难。Compose 用一个 YAML 文件声明整个应用,一条命令拉起所有服务。BookSoul 的部署拓扑如下:
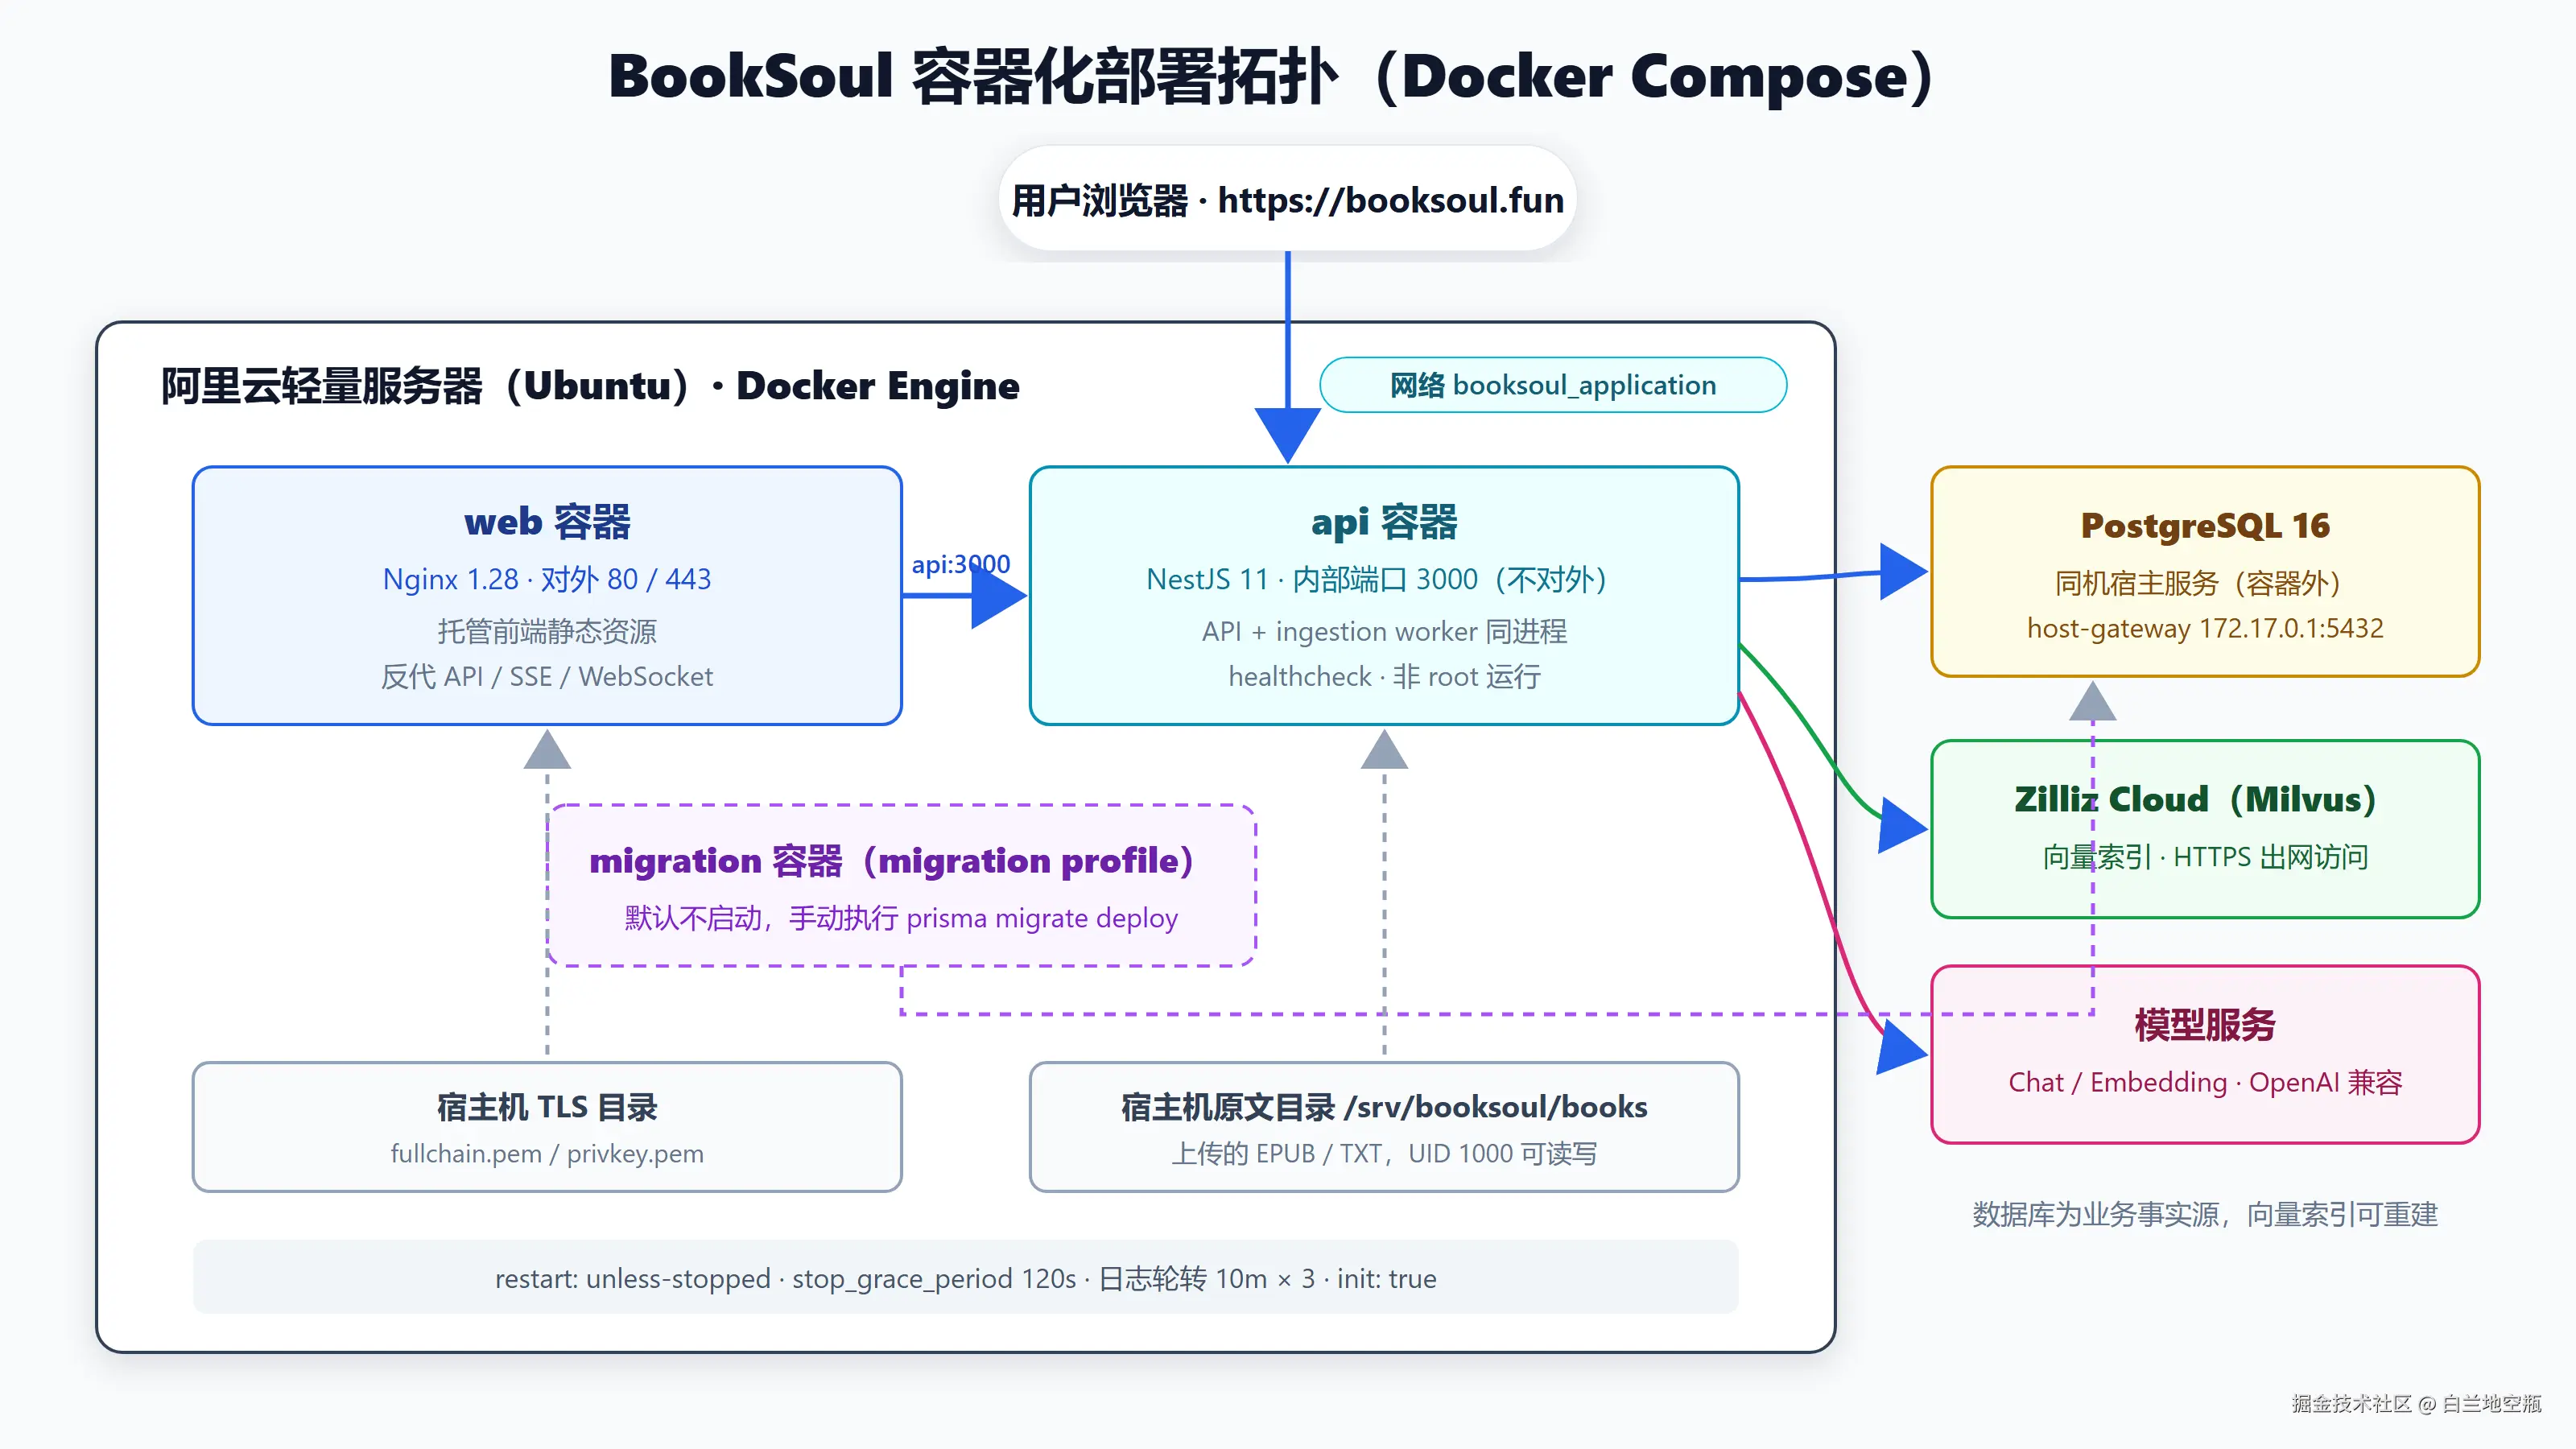
对应的 compose 配置(节选):
less
services:

  api:

    image: \${API\_IMAGE}

    init: true

    restart: unless-stopped

    stop\_grace\_period: 120s        # 给正在进行的索引、SSE 响应留足优雅停机时间

    env\_file:

      - path: \${APP\_ENV\_FILE}

        format: raw

    volumes:

      - \${UPLOAD\_HOST\_DIR}:/data/books   # 小说原文持久化到宿主机

    healthcheck:

      test: \["CMD", "node", "-e", "fetch('http://127.0.0.1:3000/')..."]

      interval: 30s

    networks: \[application]

    # 注意:api 没有 ports,不对宿主机暴露,只能在内部网络访问

  web:

    image: \${WEB\_IMAGE}

    depends\_on:

      api:

        condition: service\_healthy   # 等 API 真正健康后再启动

    ports:

      - "80:80"

      - "443:443"

    volumes:

      - \${TLS\_HOST\_DIR}:/etc/nginx/tls:ro   # 证书只读挂载

networks:

  application:

    name: booksoul\_application

    external: true      # 预先创建的网络,用于连通宿主机上的 PostgreSQL
这里有几个我认为很关键的工程细节:
-
API 不直接暴露端口 :只有 Nginx 对外开 80/443,外部流量统一从 Nginx 反代到内部的
api:3000,缩小攻击面; -
depends_on: condition: service_healthy:不是简单等容器「启动」,而是等健康检查通过,避免 Nginx 在后端还没就绪时就接入流量; -
init: true** + **stop_grace_period: 120s:前者注入 init 进程正确回收僵尸进程,后者给正在进行的上传索引、流式回答留出优雅退出的时间; -
日志轮转 :限制
max-size: 10m、保留 3 个文件,否则长跑服务能把磁盘写满。
Nginx 配置本身也有讲究。因为 BookSoul 同时用到 SSE 流式输出和 WebSocket,反代时必须关闭缓冲并正确处理协议升级:
bash
upstream booksoul\_api {

    resolver 127.0.0.11 valid=10s;   # 使用 Docker 内置 DNS

    server api:3000 resolve;         # 直接用服务名,并动态解析

}

location /api/ {

    proxy\_pass http://booksoul\_api;

    proxy\_set\_header Upgrade \$http\_upgrade;      # WebSocket 升级

    proxy\_set\_header Connection \$connection\_upgrade;

    proxy\_buffering off;   # SSE 必须关闭缓冲,否则回答会被攒成一坨

    proxy\_read\_timeout 300s;

}
其中 resolver 127.0.0.11 是 Docker 内置 DNS,配合 resolve 可以在后端容器重建、IP 变化后自动重新解析,避免 Nginx 启动时写死 IP。
八、发布、回滚与不可变镜像
容器化之后,发布流程也变得清晰可控:
-
镜像打上
时间戳 + Git SHA的标签(如r20261009T120000Z-c9996337),推到私有仓库,镜像一旦发布就不可变; -
部署分两步:
prepare只拉取并校验镜像、不切换流量;activate重建容器并接入流量,并用文件锁(flock)拒绝并发部署; -
任何一步失败,当前运行版本都不受影响。
回滚因此极其简单 :把旧版本的 digest 再执行一次 activate 即可。这也是我坚持用 digest 而不是模糊的 latest 的原因 ------ 回滚时回到的,必须是「当时那一版」,而不是一个内容可能已经变化的标签。
九、Docker 过时了吗?怎么看 K8s 和 Podman
学习过程中,网上总有各种声音:Docker 不行了、现在都用 K8s 了、Podman 要取代 Docker 了......
我自己的态度很简单:该学学,该用用,真淘汰了就拥抱新变化。
而且从知识结构上说,K8s 编排的最小单位 Pod,本质依然是容器;理解了镜像、容器、网络、挂载、分层这些由 Docker 建立起来的心智模型,再去学上层编排是顺水推舟的事。反过来,连容器都没跑明白就直接冲 K8s,只会被一层又一层的概念劝退。Podman 也类似,它兼容 Docker 的命令习惯和 OCI 镜像标准,基础概念是相通的。
工具会迭代,但「把环境一起交付」的思想不会过时。
写在最后
回顾整个学习过程,Docker 对我而言不只是一个部署工具,更是一种确定性的工程思维:
-
它消灭了「在我电脑上明明能跑」的玄学;
-
让中间件安装从几小时的手工活变成一条命令;
-
让构建、发布、回滚都成为可重复、可审计的确定流程;
-
也让我在设计 Dockerfile 和 Compose 时,被迫认真思考安全边界、数据持久化和失败恢复。
如果你也在被环境配置反复折磨,不如就从 docker run 一条 MySQL 命令开始,亲手把一个项目跑起来。容器化这件事,动手一次胜过看十篇文章。