今天聊聊我最近研究异构数据同步的时候接触到的金仓 Kingbase FlySync(下文简称 KFS)------一款对标 OGG 的异构数据同步软件。内容偏产品力拆解,后半段带一个自己动手规划同步链路的实操记录。
@toc
从一个再普通不过的需求说起
先说个场景吧,做过企业信息化的朋友应该都不陌生。
业务系统跑在 Oracle 上,然后领导某天提了个需求:能不能把交易数据实时同步到分析库,让报表部门每天早上看到的是昨天的最新数据,而不是前天的?再过一阵,国产化改造提上日程,公司新采购了一批国产数据库,领导又问:能不能让老库和新库双轨并行跑一段时间,随时可以回退?
这两个需求看着不相干,其实说白了是同一件事:让数据在两个不同的数据库之间,实时、完整、可监控地流动。
我刚入行那会儿,团队的做法是自己写脚本:定时任务半夜跑一遍,把增量数据从 A 库抽出来灌到 B 库。这种脚本我是真的维护过,里面的痛苦我太清楚了------时间戳边界处理不干净会丢数据,业务跑批把抽取窗口撑爆了会丢数据,中途网络抖一下,还是丢数据。更难受的地方在哪呢?出了问题你还不知道,往往仅仅只是等业务方拿着对不上的报表来找你,才发现同步早就错了。
后来接触了 KFS 这类基于数据库日志解析的数据同步软件,我才发现自己当年干的活,其实是在手搓一个性能差、不可靠、还没有监控的同步工具。而这件事,人家早就有了工业层级里的解法。
KFS 是什么,凭什么说它"扎实"
KFS 是电科金仓推出的异构数据同步软件,官方的定位是面向同城/异地灾备、数据库平滑迁移升级、数据集中共享与分发、应用上云迁移、数据库负载均衡这些场景的实时数据同步产品。 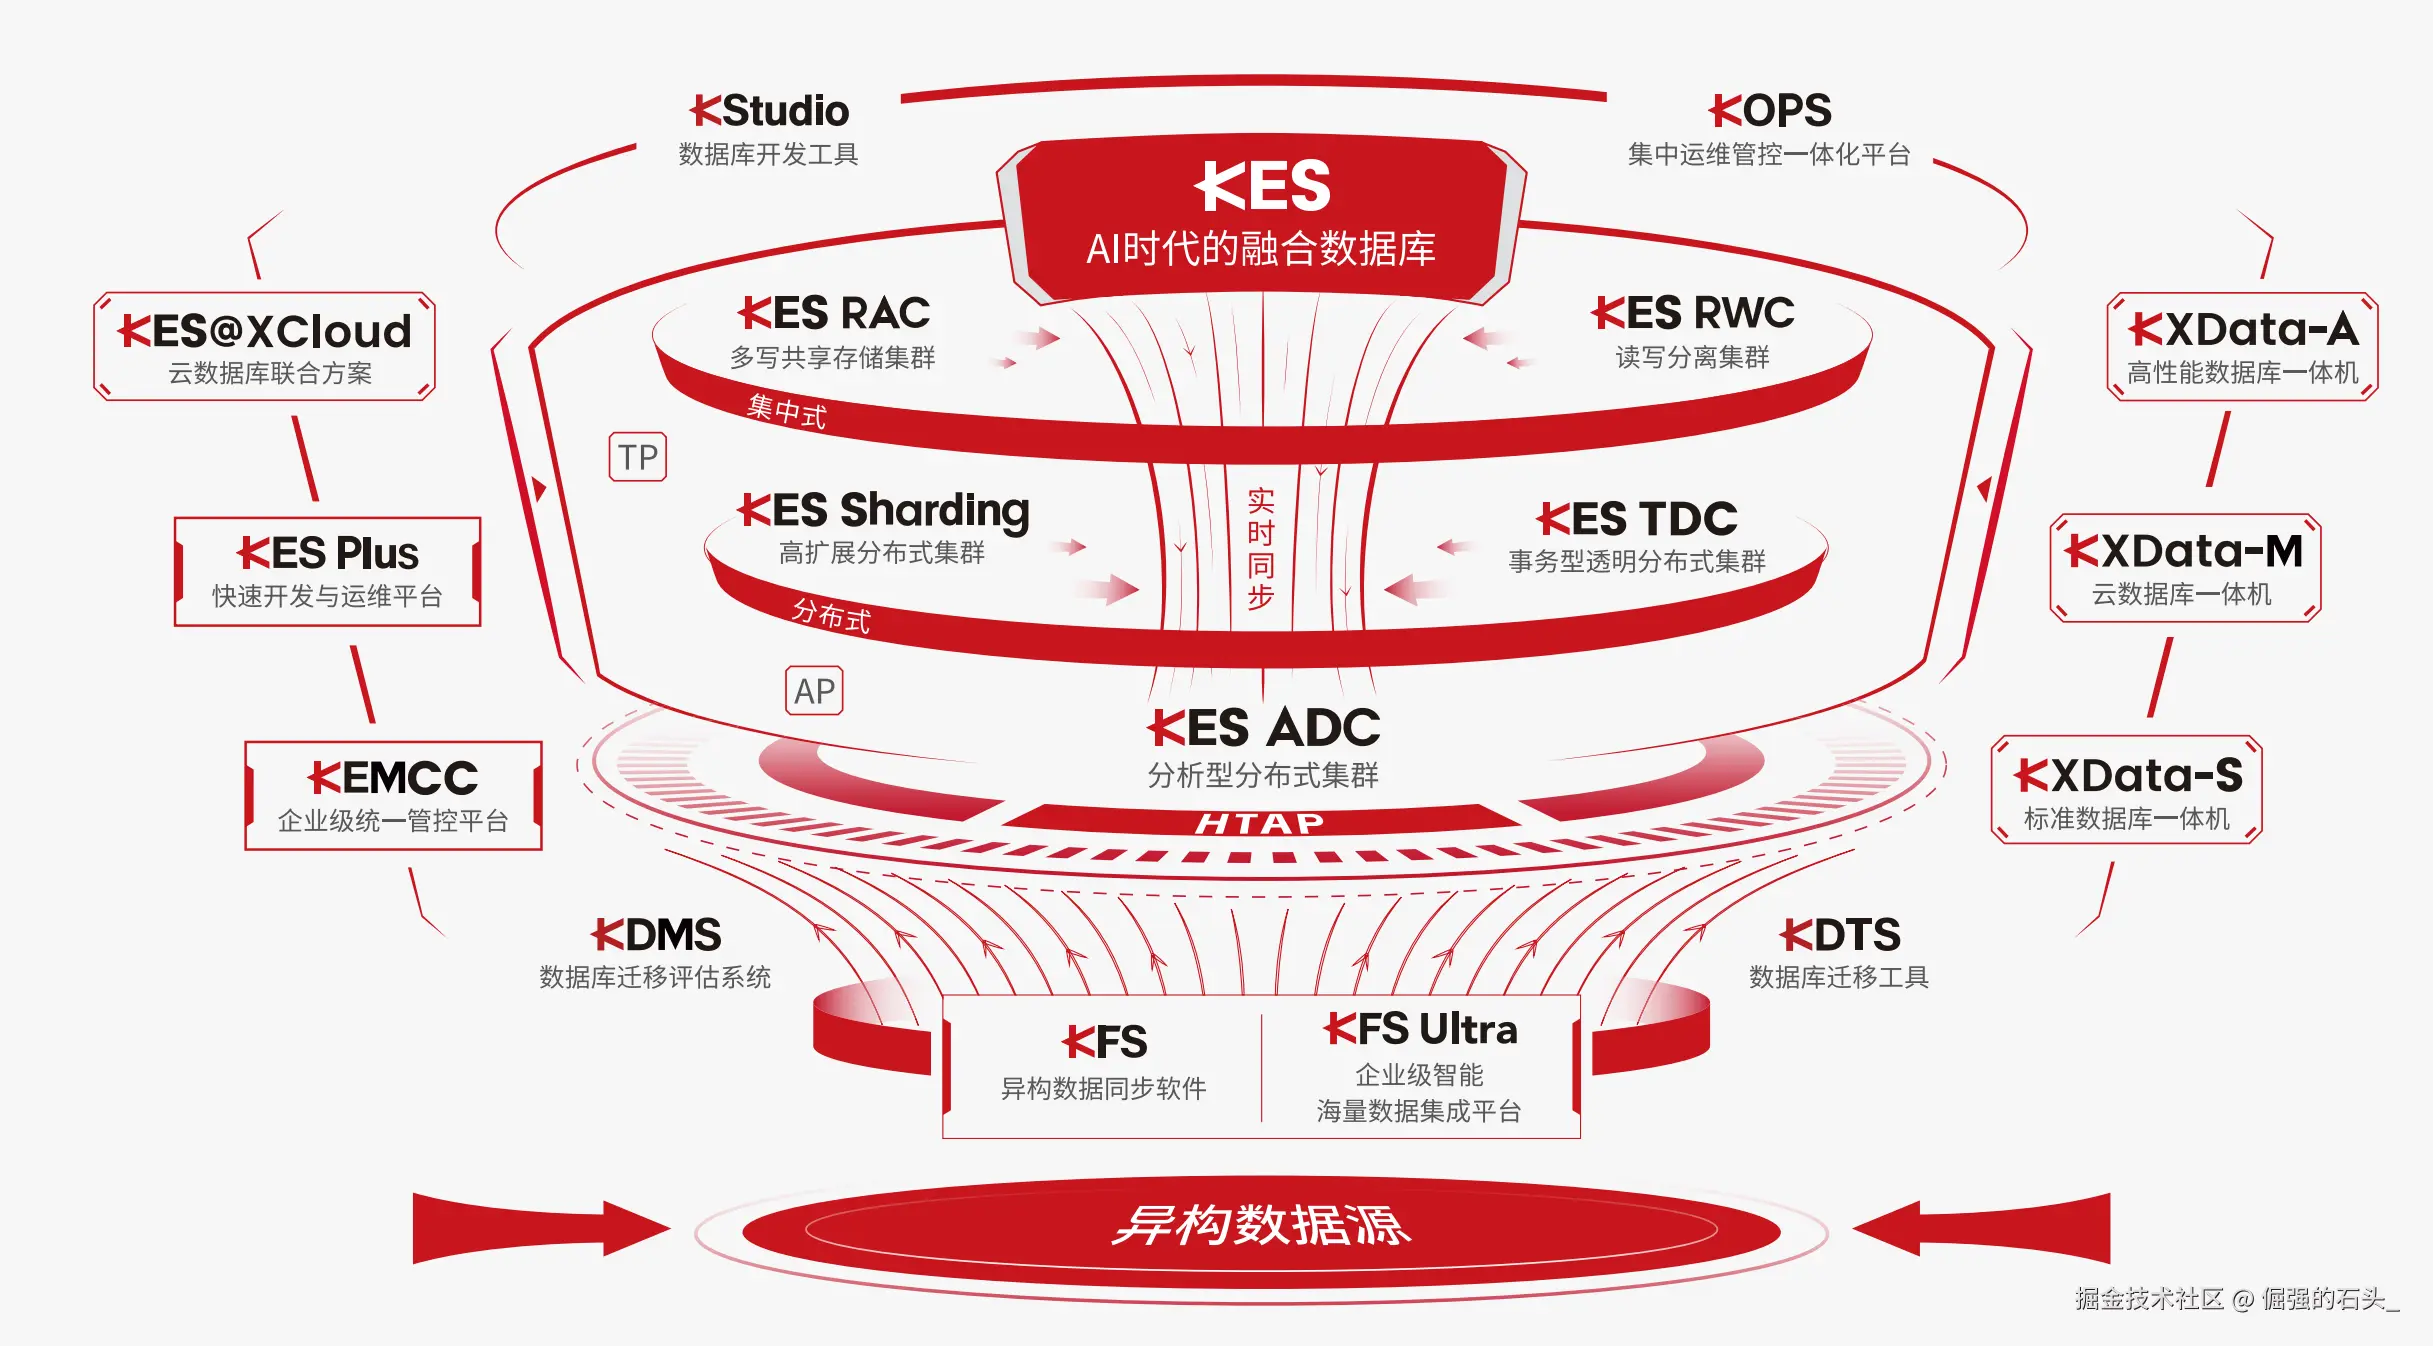
如果你了解 Oracle 生态,那其实一句话就能对上号:KFS 的对标产品是 OGG(Oracle GoldenGate)。而熟悉国产化替代的朋友都知道,OGG 这类国外同步软件恰恰是替代清单上的常客------数据库换国产了,那么配套的同步工具也得跟上,不然的话整条数据链路依然是"半国产"的状态。
说它扎实,是我研究完它的技术文档之后,从几个硬指标里得出来的判断。这些数字后面我会一一展开:同步时延亚秒级、支持 30 余种异构数据源、1C2G 的最小环境能做到每天 50GB 的同步吞吐、校验速率 100MB/s 而且全程不中断业务、代码自主率 100%。另外还有一点很打动我:它已经规模化了交付 5000 余套,服务过 500 多家客户,人民银行征信中心、解放军总医院、国家电网、中石化这些对数据一致性近乎苛刻的单位都在名单里。产品好不好,销售话术说了不算,金融核心系统的验收报告才算数。
原理拆解:采集、KUFL、加载三段式
KFS 的核心技术和所有基于 CDC(变更数据捕获)思路的同步软件是一脉相承的:不碰业务表,直接去解析数据库的事务日志。整个链路分三段,我先用一张图建立整体印象:
第一段是采集 采集模块部署在源端,通过直接访问数据库事务(REDO)日志做实时解析,读出插入、更新、删除这些操作的结果。这里有个细节我很欣赏:它只解析已提交的事务,中间活动和回滚操作会自动忽略掉。也就是说,负载再高的生产库,也不会把未提交的脏数据传到下游,架构层面的负载天然就小。
第二段是 KUFL 文件 KUFL(Kingbase Unified Format Log)是 KFS 自己定义的一种中间文件格式,把从不同数据库里抽取出来的变更数据,统一成一种加密格式来存储。这个设计解决了两个问题。一个是异构适配------不管上游是 Oracle 还是 MySQL,中间格式是统一的,下游加载模块不用去关心源端是谁;另一个是可靠性------数据一旦落成 KUFL 文件,源端或目标端任何一边中断了,恢复之后从文件位置继续加载就行,这就是断点续传的物理基础。
第三段是加载 加载模块从 KUFL 文件读取变更数据,转换成目标端数据库的原生 SQL 应用上去。因为它是按事务在源端的提交顺序和事务环境加载的,所以目标端能保持事务一致性和引用完整性。
这个三段式架构带来一个我很看重的特性:对生产系统低干扰 。KFS 不需要在数据库引擎内部做任何改造,靠 Agent 监控日志就能干活,还支持分离部署------解析、转换这些计算动作可以挪到专门的 KFS 节点上做,生产库只多付一点点读日志的 I/O。官方给的实测数据是某医院场景下,64 核 96GB 的服务器上跑 Oracle 11g 生产库,KFS 进程单核 CPU 占用不到 70%、内存占用不到 2GB。对生产库来说,这基本就是"无感"级别的存在了。 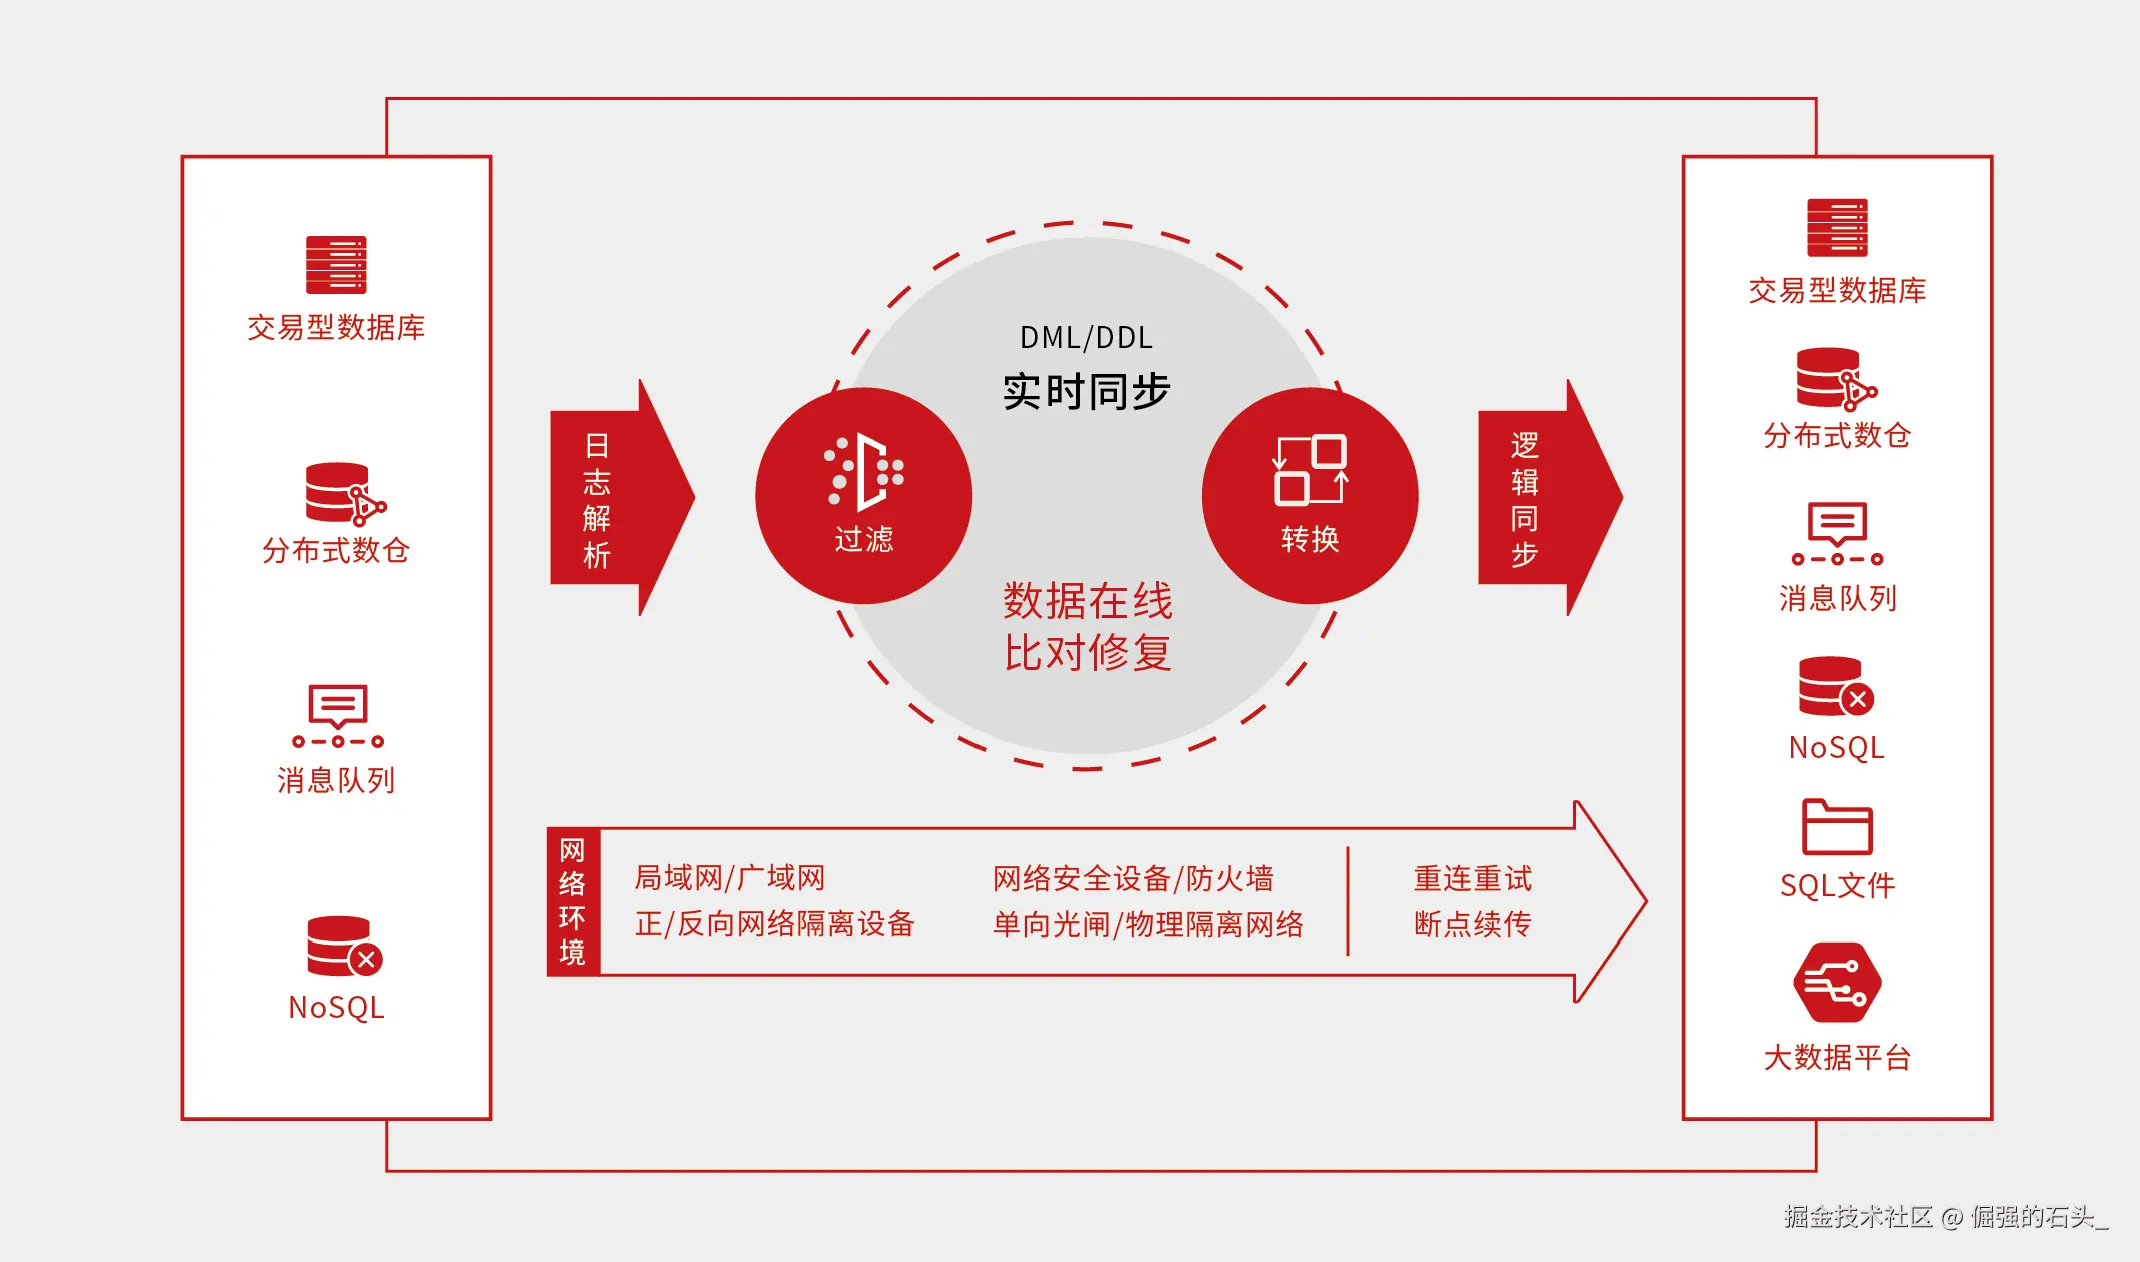
产品力五连:这份配置单在同级别里什么水平
一、数据源覆盖:30 余种,国产库是强项
同步软件最怕的就是"数据源不支持"这种情况。KFS 的支持清单我完整看了一遍,按类别整理如下:
| 类别 | 代表数据源 | 方向 |
|---|---|---|
| 国外交易型数据库 | Oracle、SQL Server、MySQL/MariaDB、PostgreSQL、DB2、Informix 等 | 源端 + 目标端 |
| 国产交易型数据库 | KingbaseES、达梦、OceanBase、PolarDB、openGauss、Vastbase、AntDB、TDSQL 等 | 源端 + 目标端 |
| 分析型/分布式数仓 | Greenplum、ClickHouse、华为 DWS、Gbase8a 等 | 目标端 |
| 消息队列 | Kafka、RabbitMQ、RocketMQ、华为 ROMA | 源端 + 目标端 |
| 大数据/NoSQL | Hadoop、Hive、MongoDB、ElasticSearch、FlinkCDC 等 | 目标端 |
| 其他 | SQLite、SQL 文件、ETL 工具 | 双向 |
下图摘录自官方文档 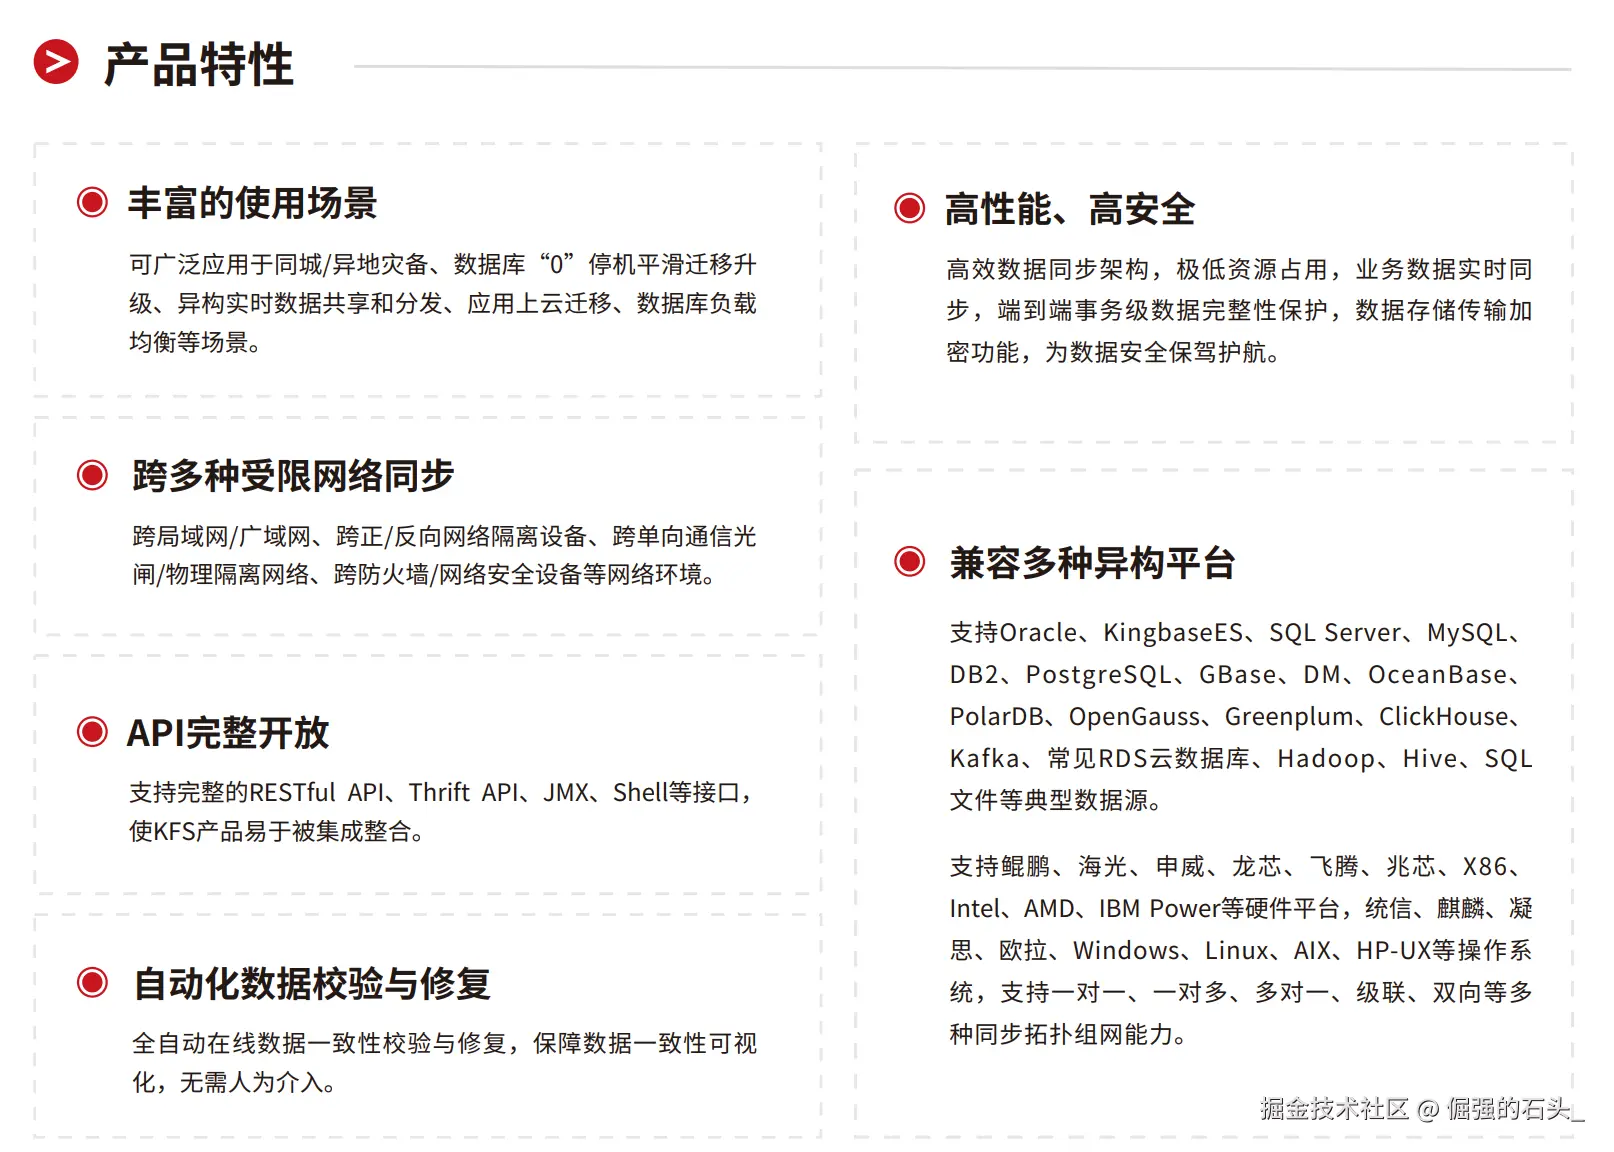
这个清单里有意思的一点是国产数据库的支持广度------达梦、OceanBase、openGauss 这些友商的产品,KFS 既支持作为源端,也支持作为目标端。这在异构迁移项目里其实非常实用,因为客户的存量系统往往不止一种数据库。当然,个别数据源只支持单向(比如 Informix、TDSQL 目前仅作源端,华为 ROMA 仅作目标端),这个以官方支持清单为准。
二、性能:时延亚秒级,跑批场景也有解
普通业务场景下,KFS 的同步时延在亚秒级,源端的任何变更目标端实时可见。几组实测数字摆一下:Oracle 源端解析速率 118MB/s,KES 源端解析 101MB/s,目标端加载 240MB/s 以上;标准 TPCC 模型下同步性能比业界同类产品高 30%。
更难得的是跑批场景的处理。金融、政企客户每天凌晨都有大批量的跑批作业,单个事务动辄千万行,这是所有同步软件的噩梦。那 KFS 怎么解的呢?三个专利技术的组合:大事务分片(把超大事务"化整为零")、日志解析前的智能过滤(不需要同步的数据在解析动作启动前就被过滤掉,省掉无谓的资源消耗)、基于分区索引的多通道并行入库。某客户 350GB 的凌晨跑批,7 点结束,7:05 之前数据就追平了,同步延迟控制在 5 分钟以内。
三、数据完整性:多维检查 + 自动修复
数据同步最核心的指标不是快,而是"不丢不改"。KFS 在传输过程中做了多维度的检查:事务同步顺序检查(源端执行顺序即目标端加载顺序)、日志连续性检查(序号断档立即告警)、I/O 顺序检查(严格控制持久化顺序),再加上数据比对修复来兜底。官方的原话是保证数据 100% 完整性与一致性,从机制上看,这几道关卡确实把数据损坏的主要路径都覆盖了。
四、不停机校验修复:我认为是最有竞争力的单点
市面上不少同步产品也带校验功能,但普遍的要求是停业务或者低峰期执行。KFS 的在线校验用的是快照技术:利用数据库快照机制获取某一时刻的静态数据视图来做比对,存量、增量数据的校验全程不需要中断业务,平均在线校验速率 100MB/s,100GB 数据分钟级就能校验完。
两个落地案例的数字很能说明问题。某医院项目存量 5TB、日增 300GB,校验速率实测 98MB/s,业务机 CPU 负载增加不到 3%;人行融资平台项目存量 4TB,原来全量校验一次要 6 个小时以上,改成增量校验之后缩短到 10 分钟以内。发现差异后可以自动修复,也可以手动选择记录级修正,再配合邮件、短信、微信/钉钉告警,真正做到无人值守。
五、高可用与安全:把"同步程序自己挂了怎么办"想清楚了
同步链路本身也是生产系统,它也会挂。KFS 的容错设计覆盖了四类故障:服务器故障、数据库故障、网络中断、同步程序自身故障。对应的能力是自动重启、自动重连、断点续传、多实例 HA 热备------主同步节点故障后,备节点秒级接管(实测通常 10 秒内完成切换),全过程不需要人工干预。安全层面,内部数据存储和传输支持端到端国密算法加密,产品代码自主率 100%,这在有合规要求的行业里是硬通货。
实操记录:规划一条 Oracle 到 KES 的同步链路
光看参数不过瘾,我按官方文档的思路,自己推演了一遍在测试环境搭一条 Oracle → KingbaseES 同步链路的完整过程。假设我们要把某业务库同步到国产分析库做报表。
第一步,评估。 KFS 在正式部署前有管家式的业务分析评估,覆盖硬件环境、软件环境、网络环境、数据源和风险评估五个维度,输出分析报告和整改建议。这个环节我个人觉得非常值------同步项目的坑大多在评估阶段就该暴露,比如:哪些表没有主键(无主键表同步要特殊处理)、哪些表包含大对象(BLOB/CLOB)、日志归档模式有没有打开、日增数据量多大、网络带宽够不够。
第二步,部署。 KFS 有三个组件:源端、目标端、还有图形化管理平台 KFSMC。通过 KFSMC 的 Web 界面可以完成图形化安装部署,向导式配置源端连接、目标端连接、同步对象,一条链路几分钟就能建起来。如果客户有自己的运维平台,KFS 也开放了完整的 RESTful API、Thrift API、JMX 和 Shell 接口,方便被集成。
第三步,初始搬迁 + 增量同步。 KFS 支持一站式完成存量搬迁和增量同步:先对源库数据做快照全量传输,搬迁期间源库产生的增量变更被持续捕获缓存在 KUFL 文件里,全量完成之后自动接续增量加载,全程业务不用停。
第四步,验证。 数据到位后必须验证,我的习惯是用三层验证:
sql
-- 1. 行数级校验:确认两端表的总行数一致
-- 源端(Oracle)
SELECT COUNT(*) FROM biz_order;
-- 目标端(KingbaseES)
SELECT COUNT(*) FROM biz_order;

-- 2. 抽样级校验:按主键抽取若干行,比对关键字段
SELECT * FROM biz_order WHERE order_id = 10086;

-- 3. 实时性校验:源端插入一条带时间戳的数据,观察目标端出现的时间差
-- 源端
INSERT INTO biz_order(order_id, amount, created_at)
VALUES (99999, 100.00, SYSDATE);
COMMIT;
-- 目标端立即查询,验证亚秒级同步是否达成
SELECT order_id, amount, created_at FROM biz_order WHERE order_id = 99999;
日常运维则交给 KFSMC:按链路查看同步数据量、同步延迟、同步速率,每条链路的每个同步操作都有耗时分析,出问题的时候能快速定位到底是解析慢、传输慢还是加载慢。配置了告警规则之后,异常和数据不一致会第一时间推送到邮件、短信或企业微信/钉钉。
什么样的团队适合它
最后给我的选型建议。如果你属于以下几种情况,那 KFS 值得认真评估一下:
- 在做国产化替代,需要老库(尤其是 Oracle)和新库双轨并行、随时可回退的方案。这是 KFS 最成熟的场景,正反向同步 + 自动比对,切换风险被压到最低;
- 有实时数据集成需求,多个业务库要汇聚到数仓或通过 Kafka 供给下游,受不了传统 ETL 的天级延迟;
- 在做容灾建设,同城/异地、双活/多活架构,要求 RPO 尽可能小的异构容灾;
- 正在被 OGG、Qlik 等国外同步软件的 license 和服务困扰,需要一个能力对等、支持国产数据源更全面的替代品。
一句话总结:数据同步软件这个品类,拼到最后拼的不是"能不能同步",而是"同步得多快、多稳、多省心"。KFS 在这三点上都交出了有真实客户案例背书的答卷,加上金仓数据库本身在国产数据库领域的积累,KES + KFS 这套组合在国产化数据链路里确实是当前值得重点考虑的选择。