单表涨到几千万行以后,查询变慢、VACUUM 变久、备份恢复变长。分区表是 PostgreSQL 应对大表的标配手段,但分错了方向,比不分会更糟。 」
一、六步落地核心链路
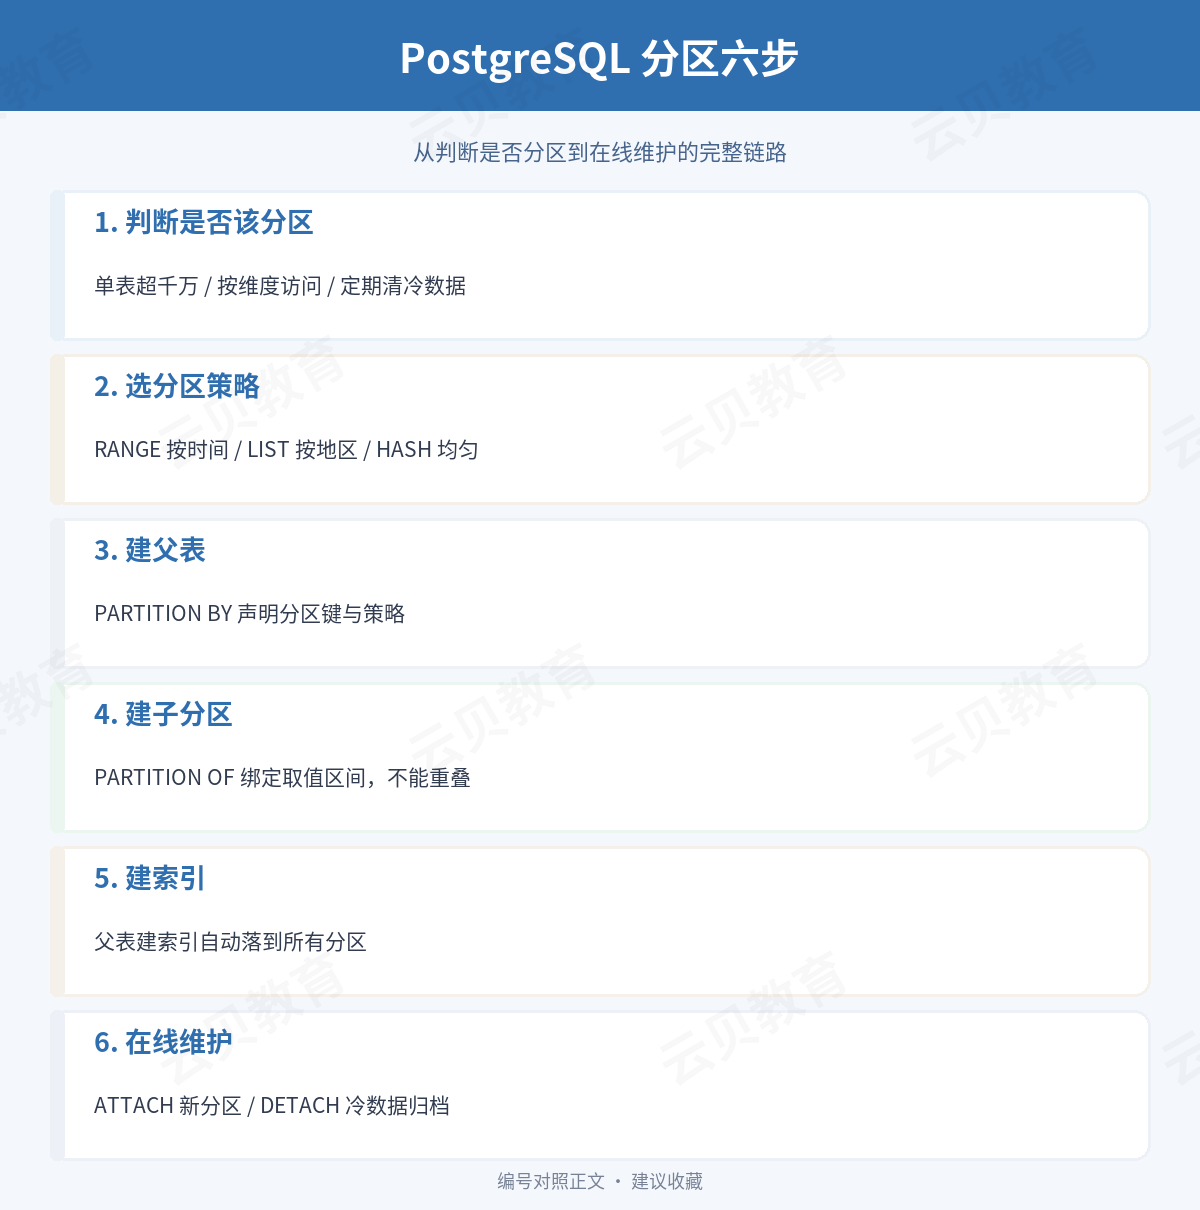
▲ 六步链路图(对照正文)
-
- 判断是否该分区:单表行数超过千万、访问明显按时间或业务维度集中、需要定期清理冷数据,这三类场景最适合分区。
-
- 选分区策略:RANGE(按时间最常用)、LIST(按地区或类型)、HASH(均匀分布),策略跟着查询模式走。
-
- 建父表 :用 PARTITION BY 声明分区键与策略,父表本身不存数据。
-
- 建子分区 :每个子分区用 PARTITION OF 绑定一段取值区间,区间不能重叠。
-
- 建索引:在父表建索引会自动落到所有分区;主键和唯一约束必须包含分区键。
-
- 在线维护 :新周期到了 ATTACH 新分区,冷数据 DETACH 归档,必要时重建索引和统计信息。
二、对照:反例 vs 推荐
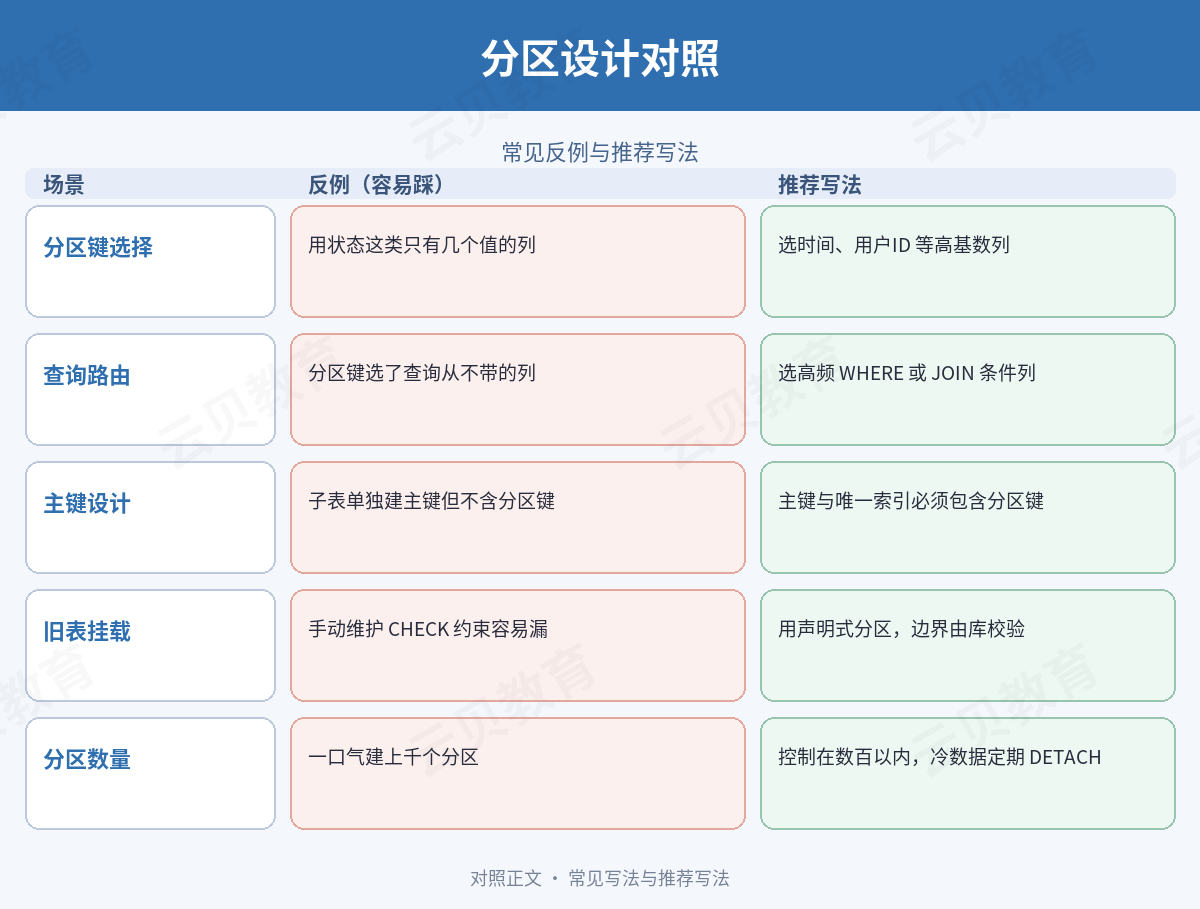
▲ 对照图(对照正文)
|--------|------------------|----------------------|
| 场景 | 反例(容易踩) | 推荐写法 |
| 分区键选择 | 用状态这类只有几个值的列做分区键 | 选时间、用户ID 等高基数列 |
| 查询路由 | 分区键选了查询从不带的列 | 选高频 WHERE 或 JOIN 条件列 |
| 主键设计 | 子表单独建主键但不含分区键 | 主键与唯一索引必须包含分区键 |
| 旧表挂载 | 手动维护 CHECK 约束容易漏 | 用声明式分区,边界由数据库校验 |
| 分区数量 | 一口气建上千个分区 | 控制在数百以内,冷数据定期 DETACH |
三、常见故障速查命令
|-----------|----------------|--------------------------------------------------------------------------------------------|
| 场景 | 注意点 | 命令 |
| 看分区裁剪是否生效 | 默认开启,带分区键条件才触发 | EXPLAIN SELECT * FROM orders WHERE created_at > '2026-01-01' |
| 在线加新分区 | 区间不能和已有分区重叠 | CREATE TABLE p2026 PARTITION OF orders FOR VALUES FROM ('2026-01-01') TO ('2026-02-01') |
| 挂载已有表 | 数据须全部落在该区间 | ALTER TABLE orders ATTACH PARTITION p2026 FOR VALUES FROM ('2026-01-01') TO ('2026-02-01') |
| 卸载冷数据 | 卸载后可独立备份 | ALTER TABLE orders DETACH PARTITION p2026 |
| 批量建索引 | 自动传播到所有分区 | CREATE INDEX ON orders (user_id) |
| 刷新统计信息 | 大表分区后仍需定期做 | ANALYZE orders |
下面是一段完整建表示例:
CREATE TABLE orders (
id bigserial,
user_id bigint,
amount numeric(12,2),
created_at date
) PARTITION BY RANGE (created_at);
CREATE TABLE orders_2026q1 PARTITION OF orders
FOR VALUES FROM ('2026-01-01') TO ('2026-04-01');
CREATE INDEX ON orders (user_id);
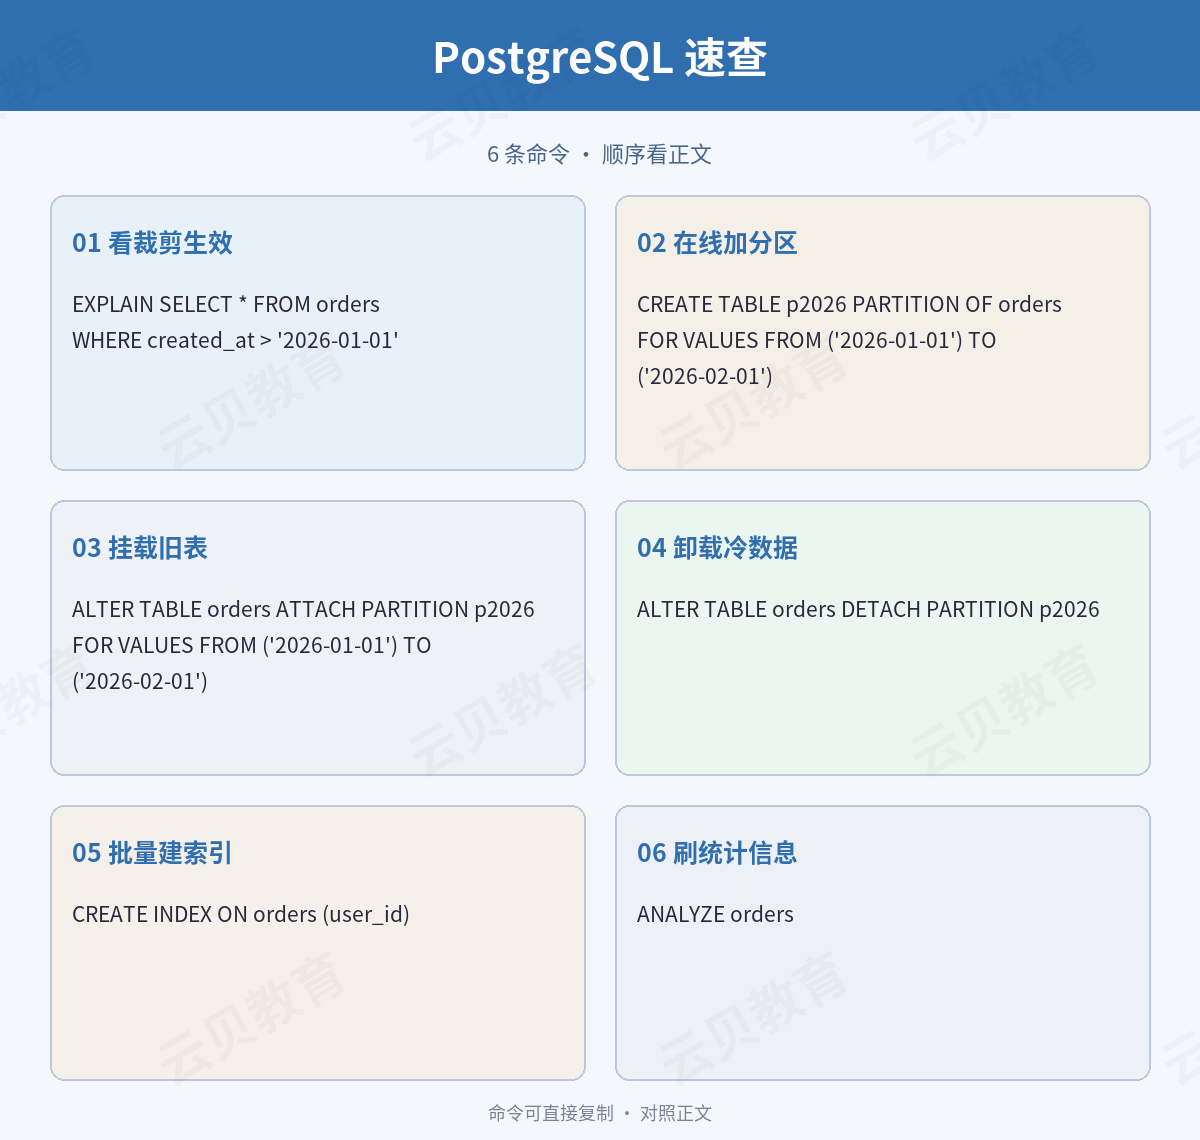
▲ 一图速查:核心命令汇总(建议收藏)
小结
分区裁剪默认开启,查询带分区键条件才会触发;主键和唯一约束必须包含分区键,否则建表直接报错;冷数据用 DETACH 迁走,单表分区数控制在数百以内,规划开销才不会反噬性能。想系统深入 PostgreSQL,可以关注官方 PGCE 认证路线,把分区、执行计划、备份恢复串成体系。
------ 本文由 云贝教育 整理分享