导读:系列(九)讲完6层安全,MCP Server已能挡人;但双11预热凌晨两点一次真实事故告诉我,能挡人不代表能扛事------单实例被流量打满、下游慢调用拖垮全场。本文基于那次脱敏复盘加本机Docker实测,讲清无状态MCP Server如何做到"挂一个不影响整体":状态全外置才能扩容,Nginx加权轮询加健康检查摘死实例,下游挂了靠Resilience4j熔断兜底、工具分级降级,再kill实例与Redis断网演练验证。做企业MCP生产部署、大促扩容、第三方接口熔断或防Redis与DB单点的团队,这套分层打法可作为同类场景的参考。性能数字只来自那次事故,本机mock仅验证机制不验证量级。
一、那个凌晨两点的告警
双11预热第一天。我们的MCP Server上线两周,一切正常。
凌晨2:17,告警群炸了。
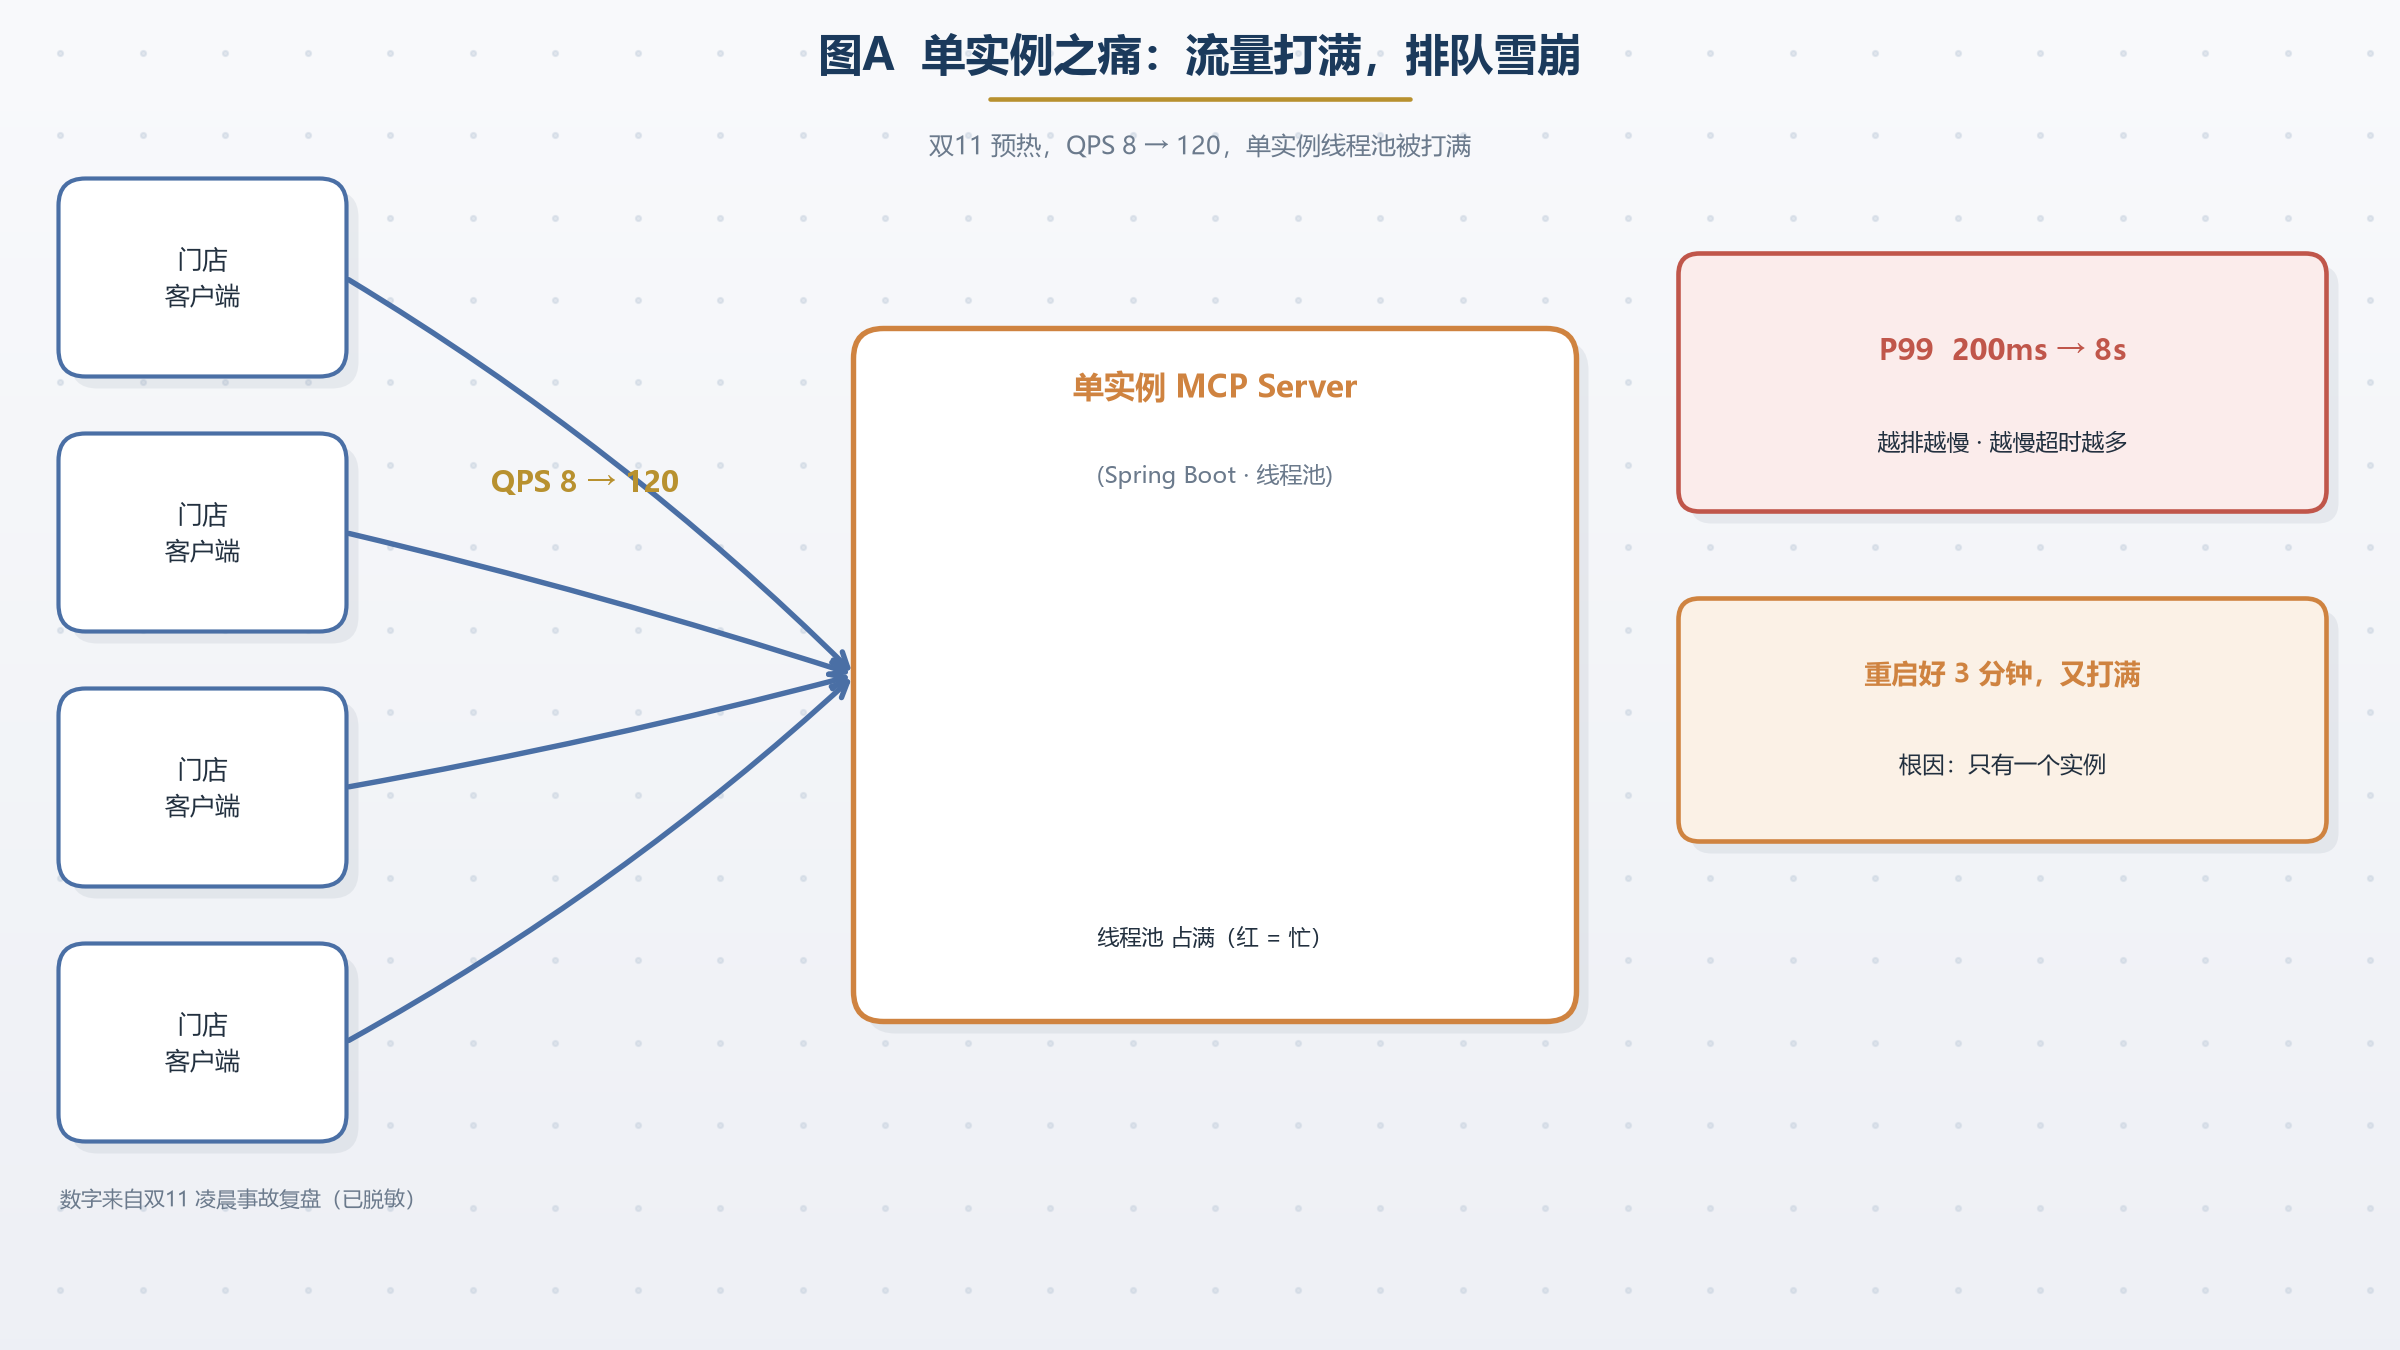
门店查询接口P99延迟从200ms飙到8s。客服群里店长开始吐槽,说查个库存转半天圈。我远程登上去一看,CPU打满,QPS从平时的8涨到120。
问题不在代码。代码没变。问题在于我们只部署了一个实例。
大促期间,总部营销中心推了一条活动到全部门店。店长们一拥而上查库存、查价格、查活动配置。单实例Spring Boot的线程池被打满,后面的请求排队,越排越慢,越慢超时越多。
我做的第一件事是重启。重启后好了3分钟,又打满了。
第二件事是加机器。但加机器不是复制一个jar包那么简单。你得解决三个问题:新实例怎么加入、旧实例挂了怎么自动切、下游依赖挂了怎么办。
这篇就讲这三件事。不是概念,是我凌晨两点踩完坑之后、在我们这个场景里的标准答案。
不过本文有两套证据来源,先划清楚,免得你拿数字去较真:
| 来源 | 覆盖哪些数字 | 怎么复核 |
|---|---|---|
| 生产复盘(当时监控,已脱敏) | QPS 8→120、P99 200ms→8s、Nginx 8秒摘除、熔断3秒触发、约5%请求502 | 无法复现,是那一次事故的个案 |
| 本机实测(Docker + mock 数据,这次写作时跑的) | 跨实例读写上下文、熔断按样本数触发、哨兵7秒切换、Host头400、连接池对照实验 |
git checkout v10 即可复现,脚本与原始输出在仓库 10-store-ha/verify/实测记录.md |
本机这套是单机容器加mock数据,没有真实流量和真实数据库------机制可以照搬,性能数字别照抄。
二、全文导览
完整可运行代码在文末,国内直接访问:https://gitee.com/ethanliang2016/mcp-in-action(tag:
v10)
三、多实例部署:无状态是前提
系列(三)我们把MCP Server改成了无状态。这件事的真正价值今天才体现出来。
有状态的MCP Server不能随便加机器。用户A的会话存在实例1的内存里,你把请求打到实例2,它不认识用户A,直接报错。
无状态之后,每个请求都自带身份和上下文。实例1处理完不需要记住你,下一个请求来实例3处理也完全OK。
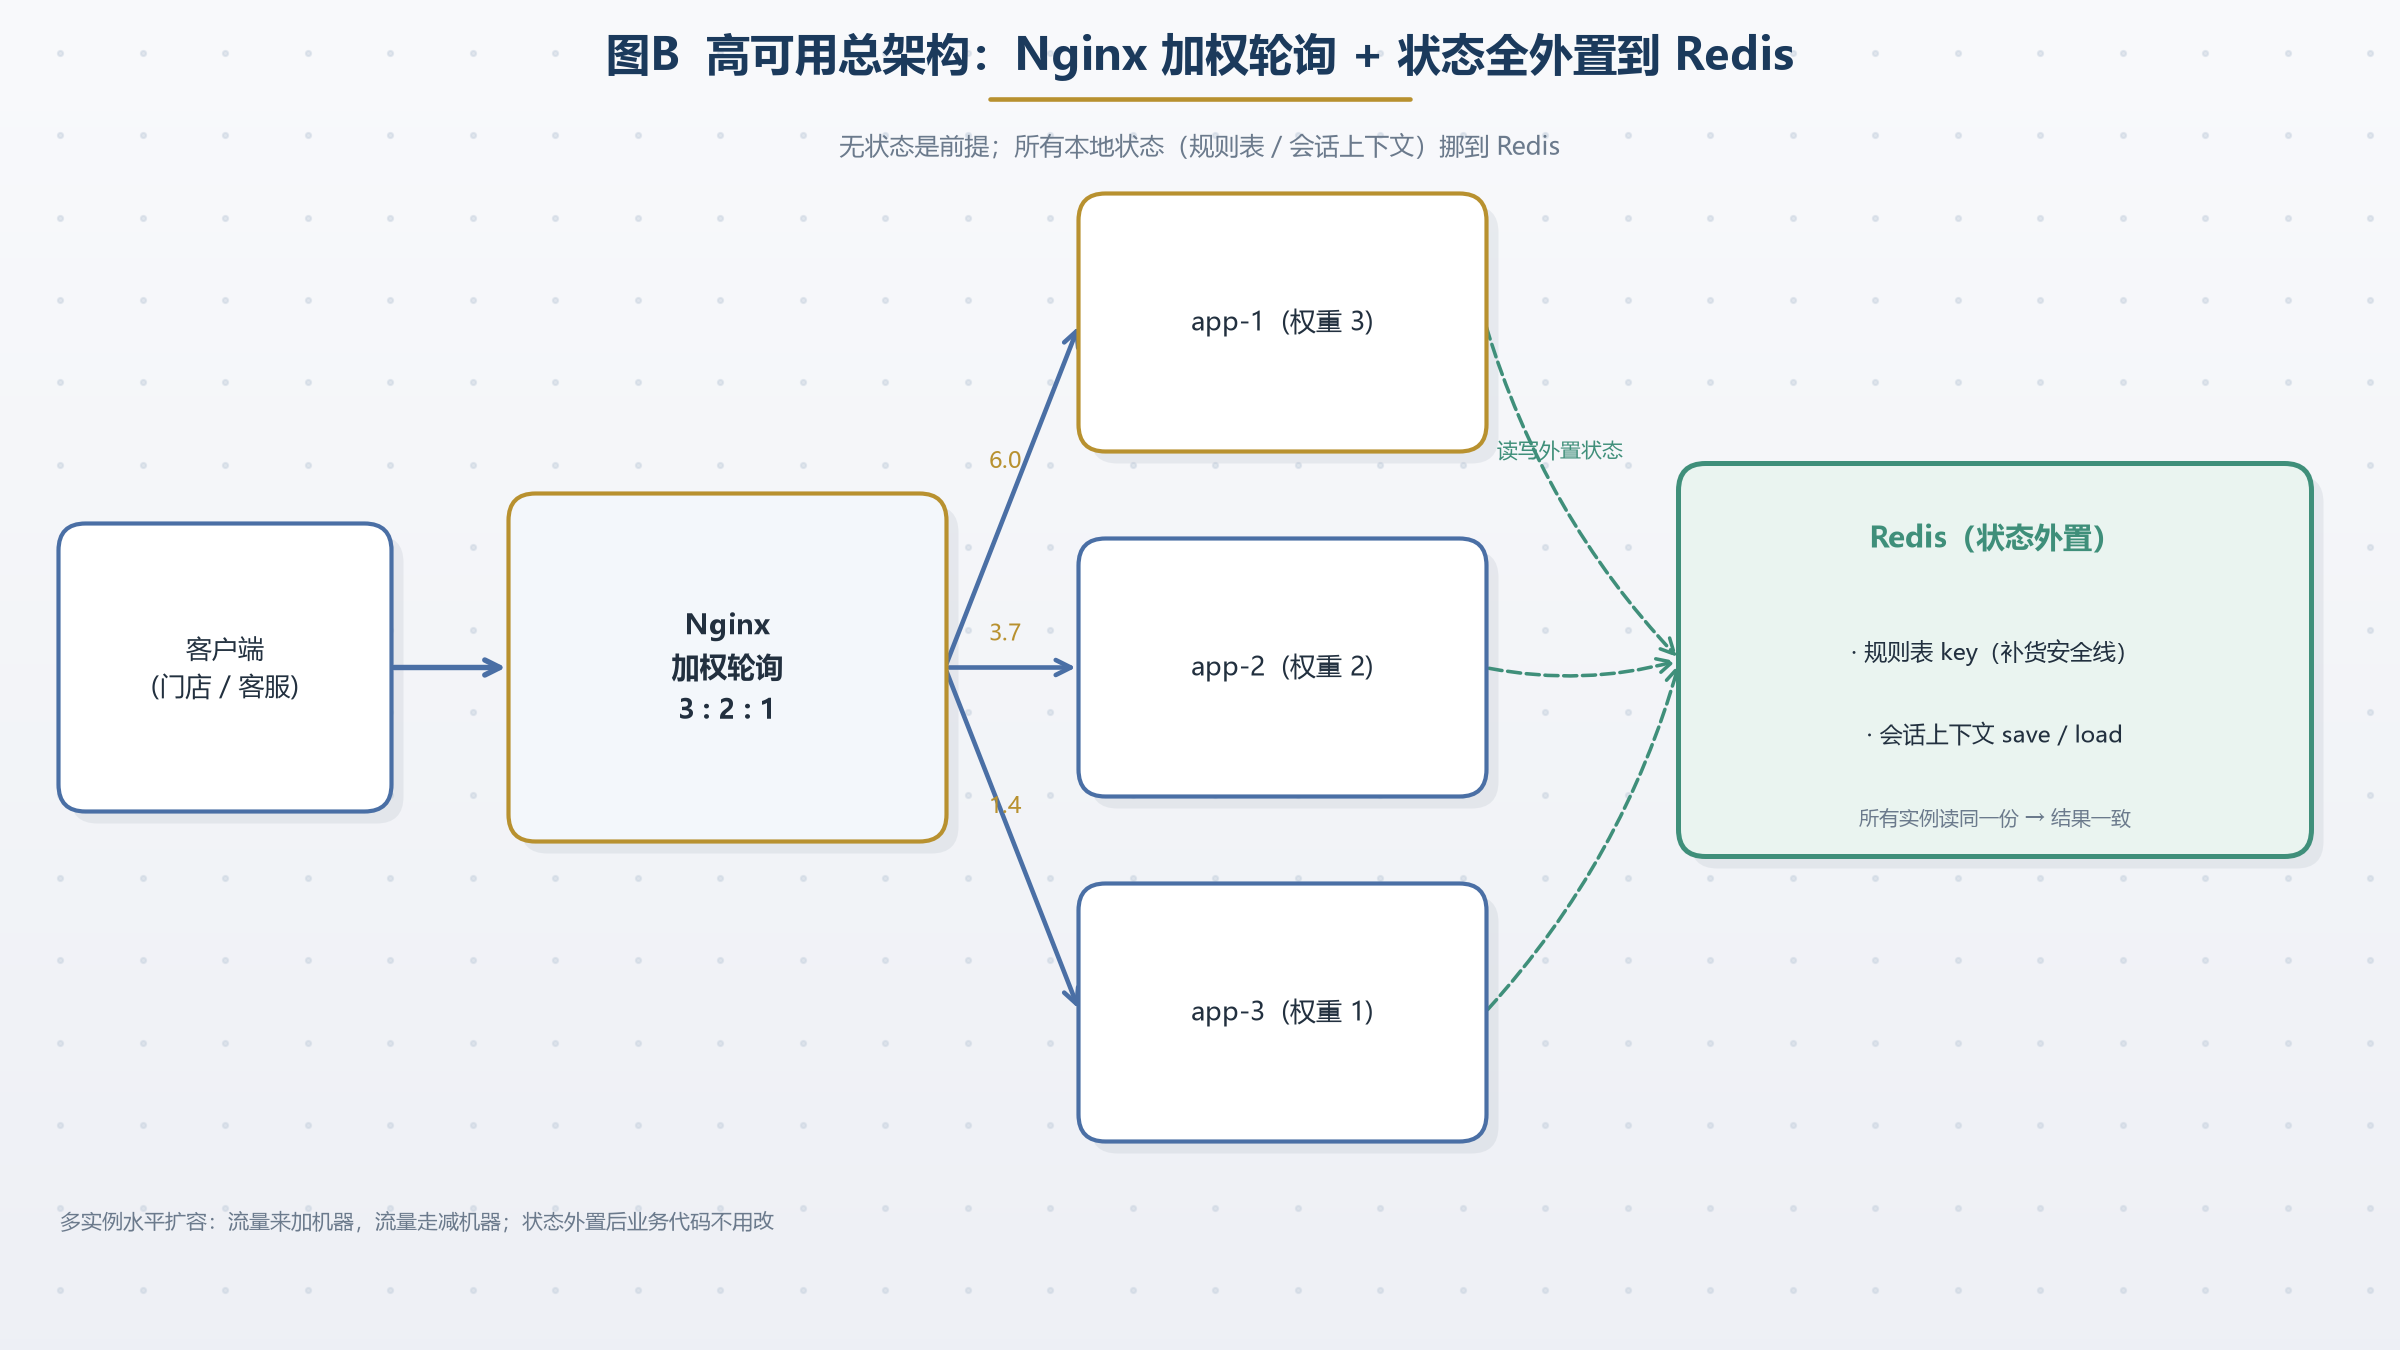
这意味着什么?意味着你可以水平扩容。流量来了加机器,流量走了减机器。业务代码不用改,但负载均衡配置得同步更新(或接入Consul / K8s这类服务发现),加机器不是零成本的。
但有一个前提你可能忽略了。
无状态不是"把session关掉"就完了。你得确认所有工具调用都不依赖本地状态。我逐个检查了工具里有没有本地状态。配套示例里的6个工具是下面这张表(生产环境当时还有一个调LLM的工具,第7节会提到):
| 工具 | 是否依赖本地状态 | 风险 |
|---|---|---|
| 查门店销售(get_store_sales) | 否,查库 + Redis缓存 | 无 |
| 查商品库存(get_inventory) | 否,查库 | 无 |
| 查设备状态(get_device_status) | 否,调用第三方接口 | 无 |
| 生成补货建议(suggest_restock) | 是,本地缓存了一份规则表 | 有 |
| 保存上下文(save_context) | 是,写在本实例内存 | 有 |
| 读取上下文(load_context) | 是,从本实例内存读 | 有 |
两类状态都得挪走。
第一类:规则表。suggest_restock 依赖本地缓存的一份安全线倍数。单实例时没问题,多实例之后实例A和B可能算出不同的补货建议。搬到Redis之后大家读同一个key,同一家门店在任何实例上算出来的都一样。
第二类:会话上下文。这条最容易漏------你已经把session关掉了,但只要工具还往本实例内存里写东西,多实例照样翻车:写在实例A,下一次请求落到实例B,读出来是空。同样搬到Redis。
配套示例里我把这两类都挪走之后,实测验证是这样的:
k0 → 上一轮由 app-1 写入,这轮请求落到 app-2,读到了:k0=v0
k5 → 上一轮由 app-2 写入,这轮请求落到 app-3,读到了:k5=v5
写和读落在不同实例上,数据照样读得到。这段输入输出就是"状态真的外置了"最硬的证据,你自己改完也建议这么验一遍。
这个问题不致命,但你不知道它存在,上线后就会变成线上事故。
还有一件连带的:多实例加上客户端重试,同一个请求可能被处理两次。读操作天然幂等,写操作不是。做法是给写操作带幂等键(request_id或业务唯一标识),服务端用Redis或数据库唯一约束去重------配套示例没覆盖这块,生产上得自己补。
四、Nginx负载均衡:三种策略的取舍
多实例跑起来之后,前面加Nginx做分发。
upstream mcp_backend {
    server 10.0.0.11:8088 weight=3;
    server 10.0.0.12:8088 weight=2;
    server 10.0.0.13:8088 weight=1;
}
三种策略,我实测后的选择:
轮询(默认)。每个请求按顺序分。适合所有实例配置一样的场景。我们10.0.0.11是8核16G,12和13是4核8G,直接轮询会让小机器先挂。
加权轮询。按机器性能分配权重。我们三台按性能给权重3:2:1(8核机3,两台4核机分别2和1),大机器扛最多流量。这是我们现在用的。
IP哈希。同一个客户端固定打到同一个实例。听起来不错,但我们是无状态MCP,不需要会话粘滞。而且IP哈希有个坑:某个实例挂了,这个IP的所有请求重新分配,可能造成请求抖动。
我的建议:在无状态、无需会话粘滞的前提下,MCP直接用加权轮询,不要用IP哈希。
还有一点反直觉。很多人觉得负载均衡就是"把请求分出去"。但真正的问题是分出去之后,你怎么知道哪个实例还活着。这就是健康检查。
五、健康检查:挂了要自动摘
Spring Boot Actuator暴露健康端点:
management:
  endpoints:
    web:
      exposure:
        include: health,info
  endpoint:
    health:
      show-details: always
访问 /actuator/health 返回的是这个形态(配套示例里开了 show-details: always):
{"components":{
  "diskSpace":{"status":"UP"},
  "livenessState":{"status":"UP"},
  "ping":{"status":"UP"},
  "readinessState":{"status":"UP"},
  "redis":{"details":{"version":"7.4.11"},"status":"UP"},
  "ssl":{"status":"UP"}},
 "groups":["liveness","readiness"],"status":"UP"}
重点看最后那个 redis。健康检查不只是汇报"我活着",它把关键依赖一起带出来了------Redis一旦连不上,这里会变 DOWN,负载均衡就能据此把这个实例摘掉。所以别让health端点只返回一个 {"status":"UP"},那等于把依赖问题藏起来。
不过详情开出来是有安全代价的:show-details: always 会把组件细节全吐出去------Redis精确版本号、磁盘余量、SSL证书状态、连接池情况。拿到精确版本号能直接对CVE,看出有哪些依赖就能画攻击面。
**所以详情只给内网,别给公网。**三道防线里至少做两道:
- 默认
show-details: never,对外只返回{"status":"UP"} - 用health group单独开一个内部端点给Nginx和监控用,
include只放你真要看的那几个组件 - 网络层隔离:actuator只监听内网地址,或防火墙只放行Nginx
yaml
management:
  endpoint:
    health:
      show-details: never          # 对外精简
      group:
        internal:                  # 内部专用:/actuator/health/internal
          show-details: always
          include:
            - redis
            - db
            - ping
配套示例是本机Docker演示,直接开的 always------你上生产前记得收回去。
Nginx这边要把权重和健康检查写在同一个upstream,再补上代理头------这才是能用的终态配置,别拆成两个片段用:
upstream mcp_backend {
    server 10.0.0.11:8088 weight=3 max_fails=2 fail_timeout=10s;
    server 10.0.0.12:8088 weight=2 max_fails=2 fail_timeout=10s;
    server 10.0.0.13:8088 weight=1 max_fails=2 fail_timeout=10s;
}

server {
    listen 80;
    location / {
        proxy_pass http://mcp_backend;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_set_header Host $host;          # 这条不能省,原因见下
        proxy_set_header X-Real-IP $remote_addr;
    }
}
max_fails=2 是连续2次转发失败就把这个实例摘下来,fail_timeout=10s 是10秒后再试,活了加回来。注意这里的"失败"是真实请求失败,不是Nginx主动ping出来的------下面那条边界说明专门讲这点。
**
proxy_set_header Host $host这句最不起眼,漏了整站400。**Nginx不配这条时,转发给后端的Host默认是upstream的名字,也就是mcp_backend------里面带下划线,Tomcat直接判非法主机名。同一套服务的实测:
Host: localhost:8080   → 200
Host: mcp_backend      → 400 Bad Request(Tomcat)
这个坑阴在日志干净:Nginx不报错,后端也不报错,只有客户端拿到400。
当时的记录是这样的:kill掉实例12的Java进程,Nginx在大约8秒后把它从轮询列表移除。期间正在处理的请求会收到502,但新请求自动分到11和13。
8秒。这个数字你要知道。不是秒切,是有一个窗口期的。在这个窗口期里,部分用户会看到错误。如果你要求零错误,需要在客户端加重试。
边界:开源Nginx这套
max_fails / fail_timeout是被动健康检查------靠真实业务请求失败来计数,不会主动ping后端。如果某实例长时间没流量,它挂了Nginx也发现不了。
这个盲区有个很阴的失效模式:低峰潜伏,高峰爆发 。凌晨实例挂了,因为没流量,Nginx毫无察觉;早高峰流量一来,一波请求全撞在那个死实例上,等 max_fails 攒够又要几秒。运维刚上班就接到报警,还以为是流量问题。
补主动探活有四条路:Nginx Plus(最省事但商业付费)、nginx_upstream_check_module(要重新编译Nginx)、接入服务发现(Consul / Nacos,实例自注册自注销)、以及脚本加定时任务(定时curl各实例的health端点,连续失败就在upstream里标 down 再reload)。大多数团队用不起Plus也不想重编译Nginx,脚本方案最实际------不优雅,但成本低见效快。四种方案的成本对比和一个能直接用的脚本单独写一篇(见文末延伸阅读)。
另一半:主动下线要优雅停机
上面讲的都是"实例意外挂了怎么摘"。但生产里绝大多数实例下线是你自己发起的------发版重启。这部分没做,每次发布都会甩给用户一批502。
做法是开 server.shutdown: graceful,再配一个 timeout-per-shutdown-phase,让Tomcat停止接收新连接、把在途请求处理完再退出;Nginx侧配合走「摘流量 → 等排空 → 停进程 → 部署 → 健康检查 → 加回」,多实例滚动着来,一次只动一个。
这里有个约束容易踩:停机等待必须大于最长的工具超时,否则等待到期直接强杀,优雅停机等于没开。完整配置、发布步骤和我踩的坑单独写了一篇(见文末延伸阅读),这里不展开。
六、下游熔断:第三方挂了不能拖垮你
MCP Server自己活着不够。它调用的第三方服务(库存系统、设备状态接口)可能挂。
我凌晨遇到的第二个问题:设备状态接口超时了。我们的查设备状态工具调用这个接口,最初超时设了30秒。问题就出在这------下游是"慢"不是"挂":延迟涨到5秒但不报错,这30秒里请求一直占着Tomcat线程不放。50个这样的请求打进来,线程池直接满,所有工具都不能用了。
这就是典型的级联故障。一个下游挂了,拖垮整个系统。
Resilience4j加熔断:
@CircuitBreaker(name = "deviceStatus", fallbackMethod = "fallback")
public DeviceStatus queryDevice(String deviceId) {
    return deviceApiClient.getStatus(deviceId);
}

public DeviceStatus fallback(String deviceId, Throwable t) {
    return DeviceStatus.unknown("设备状态暂不可用");
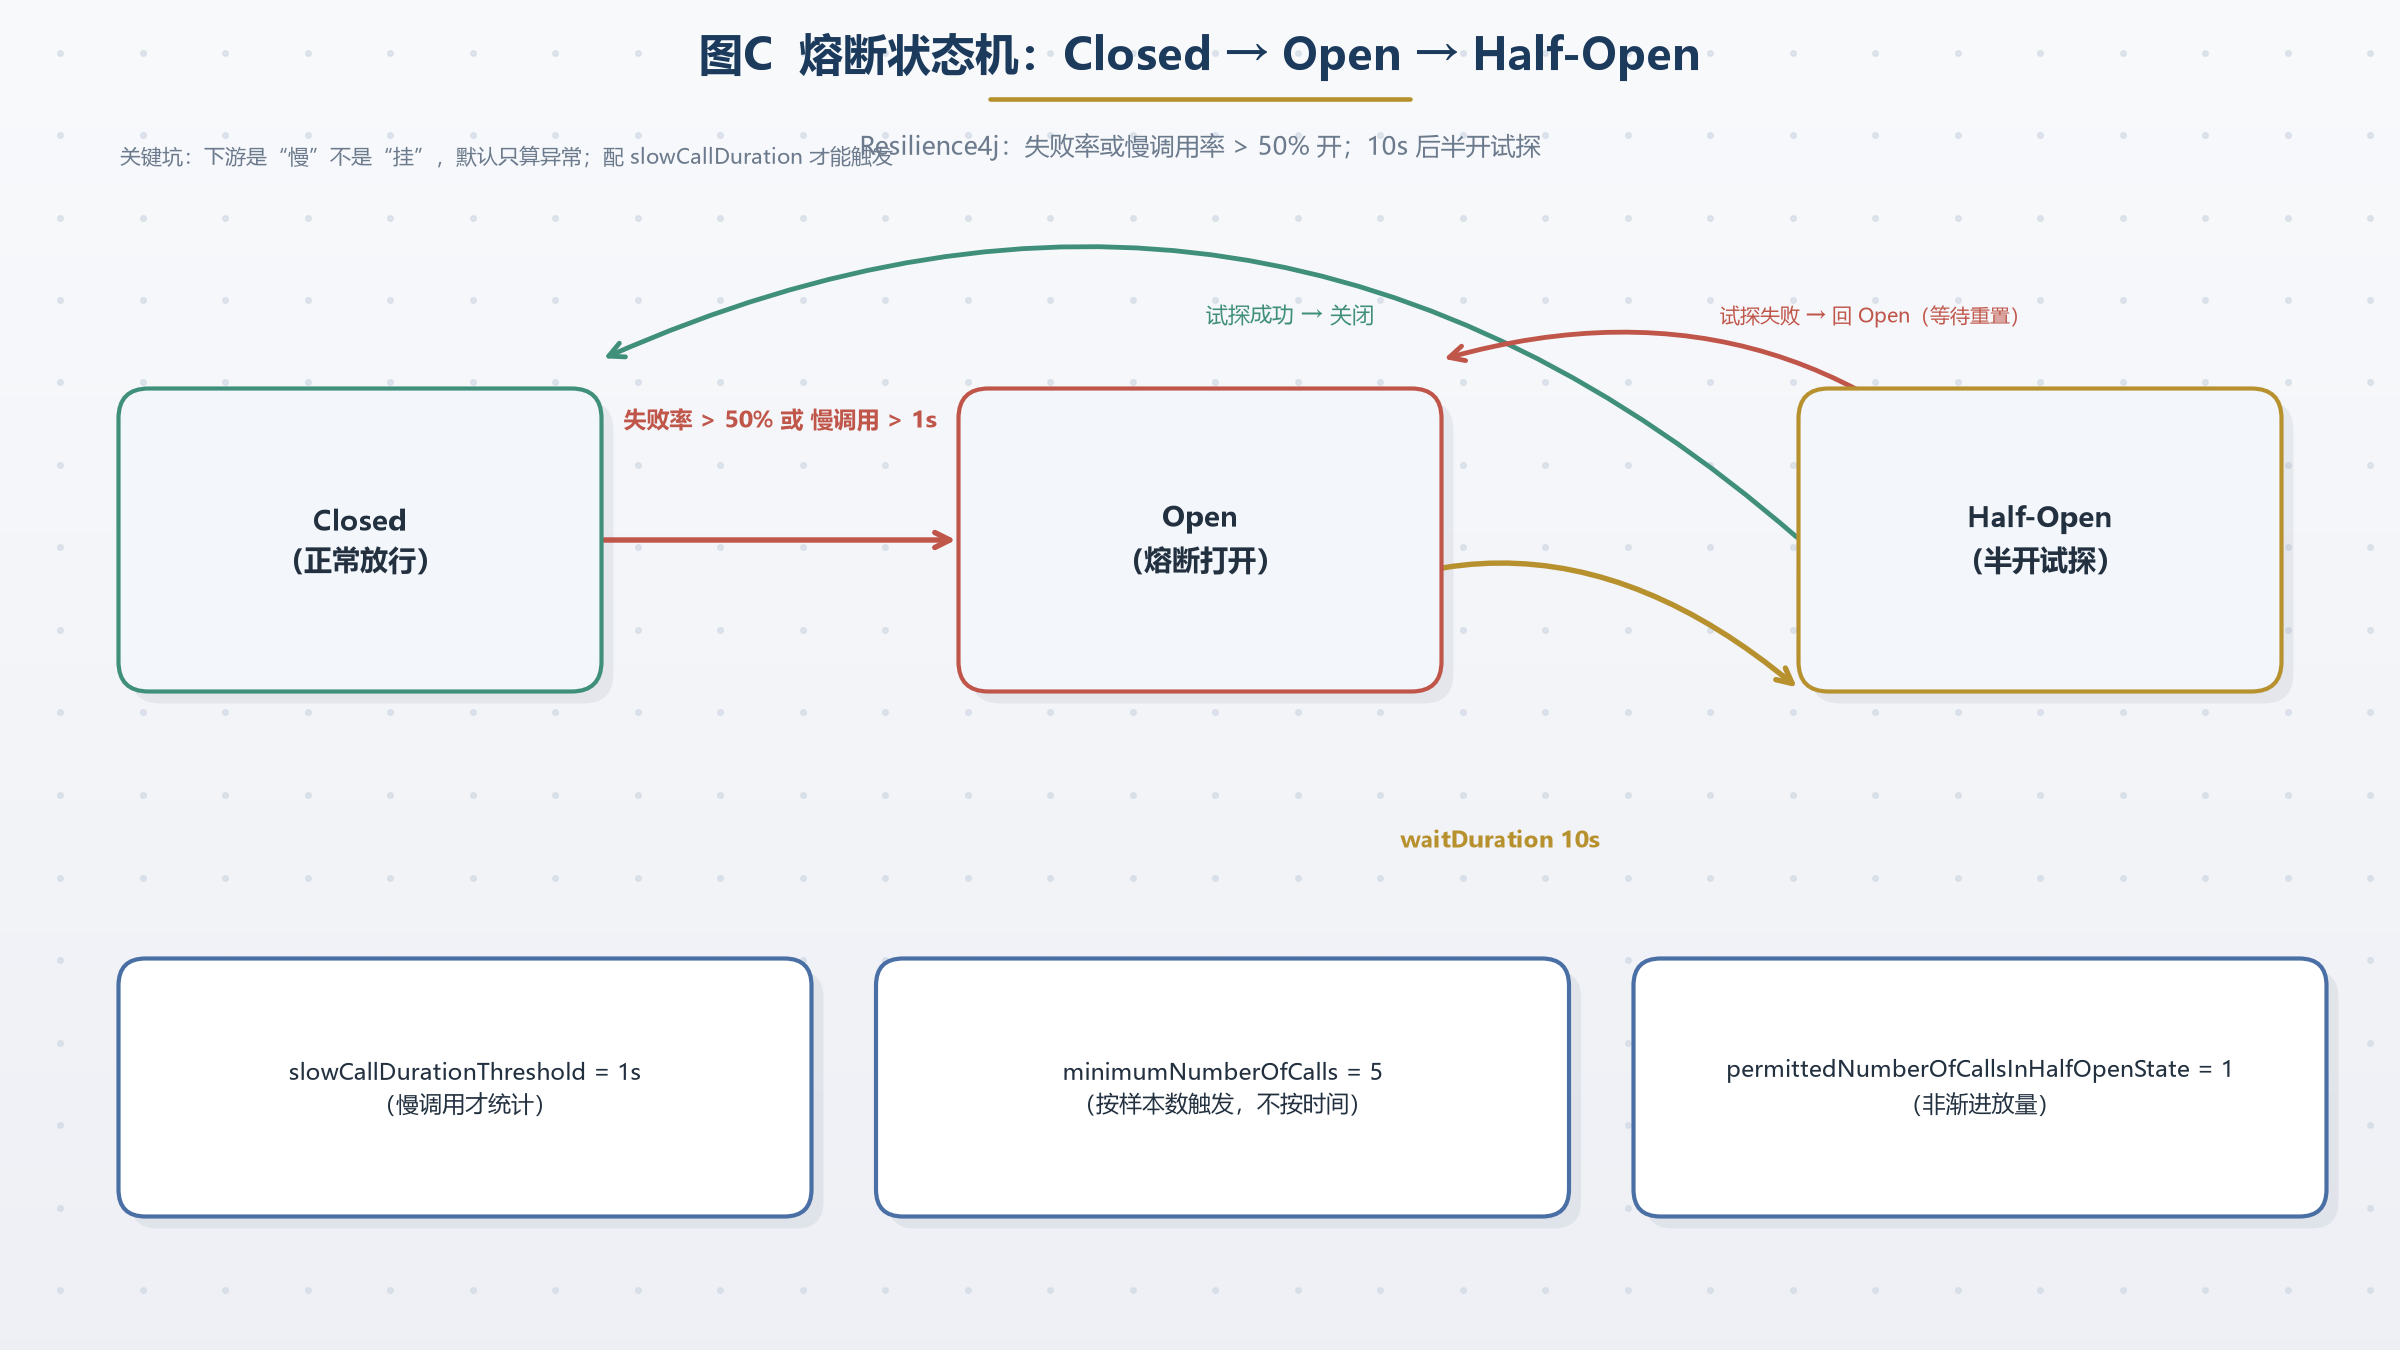
}熔断的逻辑:失败率或慢调用率 超过50%,熔断器打开。接下来10秒请求直接走fallback,不再调下游;10秒后半开,放一个请求试探,好了就关,没好继续开。注意一个坑------下游是"慢"不是"挂",默认只有抛异常才算失败,慢调用不会被计入。所以我们额外配了 slowCallDurationThreshold=1s:单次调用超过1秒就算慢调用,5秒延迟就被统计进去,熔断照样能触发。
还有一个参数决定了"多久打开"这个问题其实没有固定答案:minimumNumberOfCalls。Resilience4j默认要攒够5次调用 才开始算失败率------按样本数触发,不按时间触发。所以几秒打开取决于你的QPS:并发高时5个请求眨眼就到,请求稀的时候可能攒很久才开门。所以在压测环境看到的数字,换个环境就对不上。
而且它是每个实例各自计数的。加了负载均衡之后请求按权重摊到多个实例,每个实例都要各自攒够样本。我在配套示例里单客户端串行调用时就是这个效果:慢调用照旧发生,但一直返回正常结果,跑到第12次才出现降级------不是熔断没生效,是分摊之后每个实例都没攒够样本。
打开配套代码可能会一愣 :上面给的是注解写法,仓库里却是Resilience4j纯库API手动构建的。原因是注解写法要走Spring Boot的自动配置,而这套示例不想依赖自动配置(也让它在Boot 4下能直接跑起来),所以用了纯库写法------两者语义完全等价。
语义 注解写法 纯库写法(配套示例) 给方法接上熔断 @CircuitBreaker(name="deviceStatus", fallbackMethod="fallback")CircuitBreaker.decorateSupplier(deviceCb, supplier)降级逻辑 fallback(...)方法catch CallNotPermittedException后返回降级结果失败率阈值 failureRateThreshold=50.failureRateThreshold(50)慢调用判定 slowCallDurationThreshold=1s.slowCallDurationThreshold(Duration.ofSeconds(1))慢调用率阈值 slowCallRateThreshold=50.slowCallRateThreshold(50)打开后等待 waitDurationInOpenState=10s.waitDurationInOpenState(Duration.ofSeconds(10))统计窗口 slidingWindowSize=10.slidingWindowSize(10)最小样本数 minimumNumberOfCalls=5.minimumNumberOfCalls(5)参数一个对一个。也就是说,从配套示例迁到你自己的项目里,或者反过来,阈值一行都不用改,只是换写法。
熔断管的是"别被下游拖垮",反方向还有别被上游冲垮 ------这就是限流,我在系列(九)里用Bucket4j做过,本篇不重复。关键是两者的配合:限流是第一道闸,熔断是第二道闸,限流没生效时熔断会开得特别频繁,因为你塞给下游的量本来就超了。看到熔断反复开,先查限流。
半开状态有三个细节容易踩
- 半开的试探请求本身很慢,算失败吗?算。半开请求的结果照样统计,慢调用也计入失败率------下游正在恢复、响应5秒时,试探请求会直接把熔断器推回打开状态。
- **半开失败后,等待时间重置吗?**重置。放进去一个请求失败了,会从头再等一个
waitDurationInOpenState(10秒),不是立刻再试。 - **半开成功后,流量就立刻全放吗?**默认是。成功即关闭熔断器、全量放行------这正是"刚恢复就被流量打挂"的经典成因。Resilience4j的
permittedNumberOfCallsInHalfOpenState只能决定半开期放几个请求(本文配的是1),它不是渐进放量。真要渐进恢复,得在网关或限流层自己做:先放10%,稳住再放30%,逐步到全量。
最后一句运维经验:这些阈值上线后多半要调。熔断阈值、限流阈值、超时时间最好接配置中心(Nacos / Apollo之类)支持热更新,不然每调一次参就要重启一轮实例------对一篇讲高可用的文章来说,自己把重启当儿戏就有点讽刺了。
当时压测的结果:设备接口延迟从200ms涨到5s后,熔断在3秒内触发。触发后MCP Server的P99延迟从5s降回200ms。代价是查设备状态返回"暂不可用",但其他4个工具完全不受影响。
超时是一套体系,不是一个数字
本文到这儿出现了好几个超时:慢调用阈值1秒、设备接口超时30秒、熔断打开后等10秒、优雅停机等30秒。它们是互相约束的------总超时要大于各下游超时之和、越往下层越短、慢调用阈值必须小于工具超时、停机等待必须大于最长工具超时。单看哪个都合理,凑一起就可能打架。
拿本文这套数举例:慢调用1秒小于接口超时,这条没问题;但优雅停机等30秒和接口超时30秒刚好相等就不行------真有请求卡满30秒时,停机等待同时到期,照样强杀。要么把接口超时压下去,要么把停机等待加长,两者不能相等。
五条约束的完整说明、层级关系和重试策略单独写了一篇(见文末延伸阅读),这里只留结论。
熔断兜底,其余四个工具照常跑------这其实就是优雅降级:不是所有工具都必须100% 可用,一个挂了不能拖垮全部。
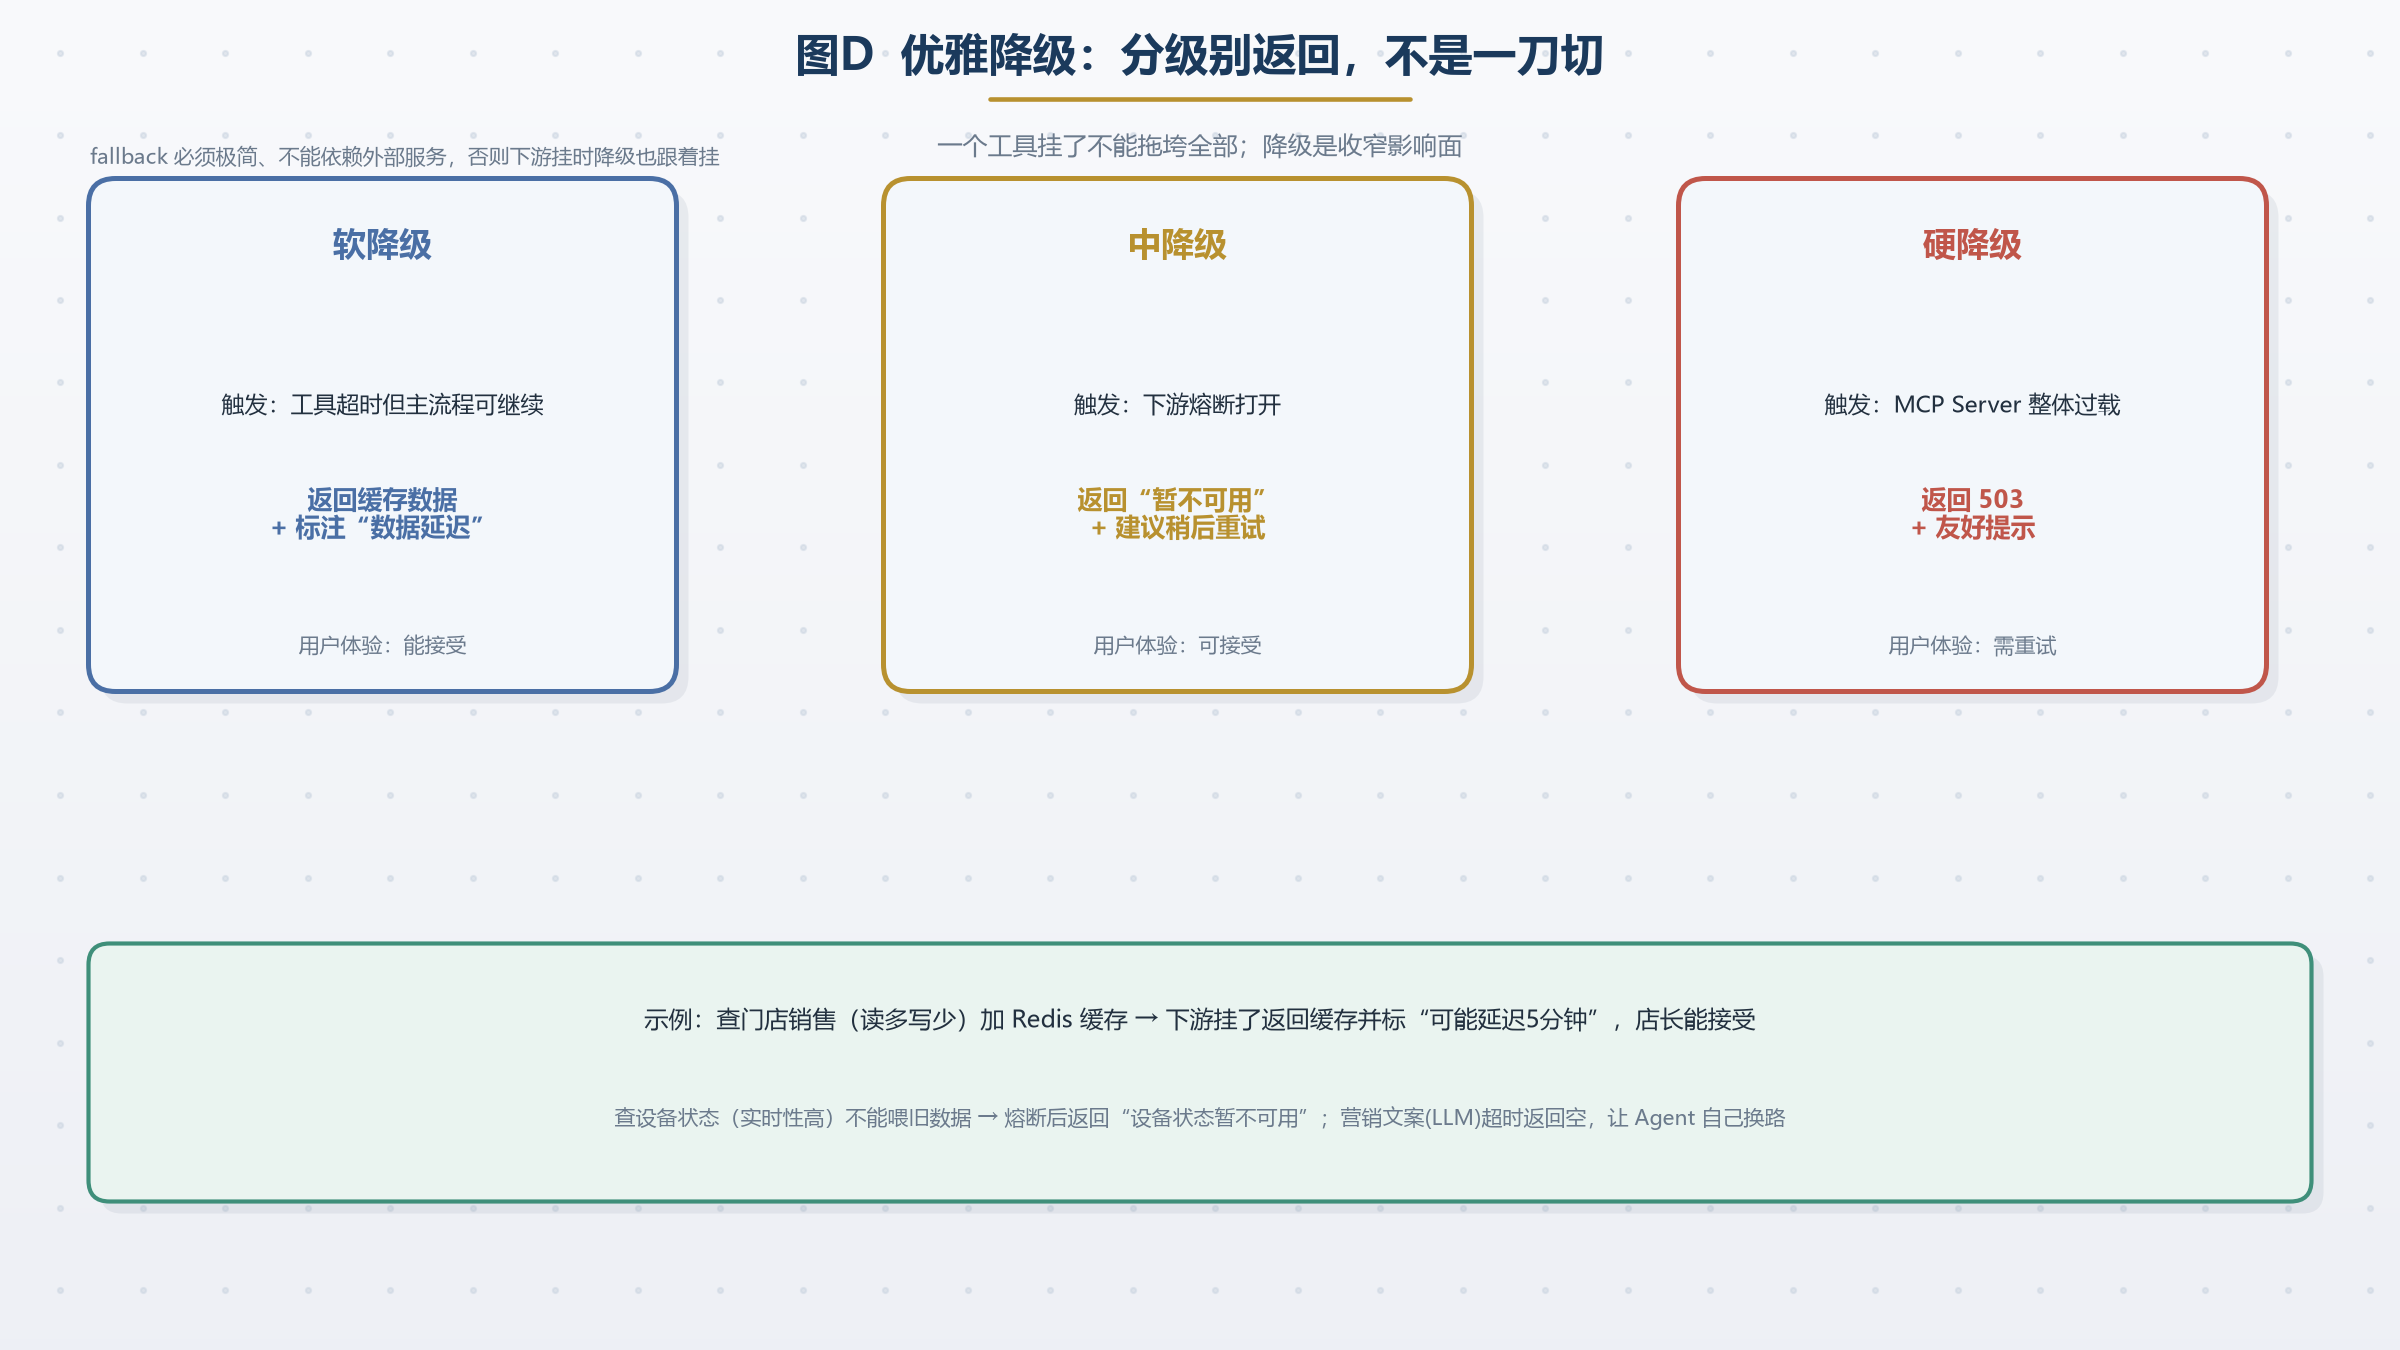
七、优雅降级:超时了返回什么
降级要分程度,差别在返回什么:
| 降级级别 | 触发条件 | 返回什么 | 用户体验 |
|---|---|---|---|
| 软降级 | 工具超时但主流程可继续 | 返回缓存数据 + 标注"数据延迟" | 能接受 |
| 中降级 | 下游熔断打开 | 返回"暂不可用"+ 建议稍后重试 | 可接受 |
| 硬降级 | MCP Server整体过载 | 返回503 + 友好提示 | 需重试 |
我们的做法:
查门店销售这种读多写少的,加Redis缓存。下游挂了直接返回缓存数据,标注"数据可能延迟5分钟"。店长能接受。
顺带提一句:缓存的三个经典问题------穿透(查不存在的数据,每次打到DB)、击穿(热点key过期的瞬间,并发全涌进来)、雪崩(大批key同时过期或Redis整个挂掉)------成因和解法完全不同,别混着用。本文演练的是第三种里"Redis整体挂了"这一支。但现实里击穿更常见------很多团队Redis好好的,却因为一个热点key过期把DB打挂了。三者的区分和各自解法单独写了一篇(见文末延伸阅读)。
查设备状态这种实时性要求高的,不能用旧数据。熔断后返回"设备状态查询暂时不可用"。
营销文案生成这类LLM调用(生产环境才有,配套示例里没有这个工具),加超时30秒。超时了返回空结果,让Agent知道这个工具现在不能用,它会自己决定要不要换个方式回答。
另外HTTP层的502/503/429是一回事,MCP协议层还有一层:工具调用失败要按JSON-RPC错误对象返回(负的code加一句人能读的message),别把异常栈直接塞回去。客户端拿到错误后的行为由它自己决定------大多数Agent会自行重试或换别的工具,所以message写"现在不可用,稍后再试"比写"内部错误"有用得多。
八、故障演练:别等大促才发现
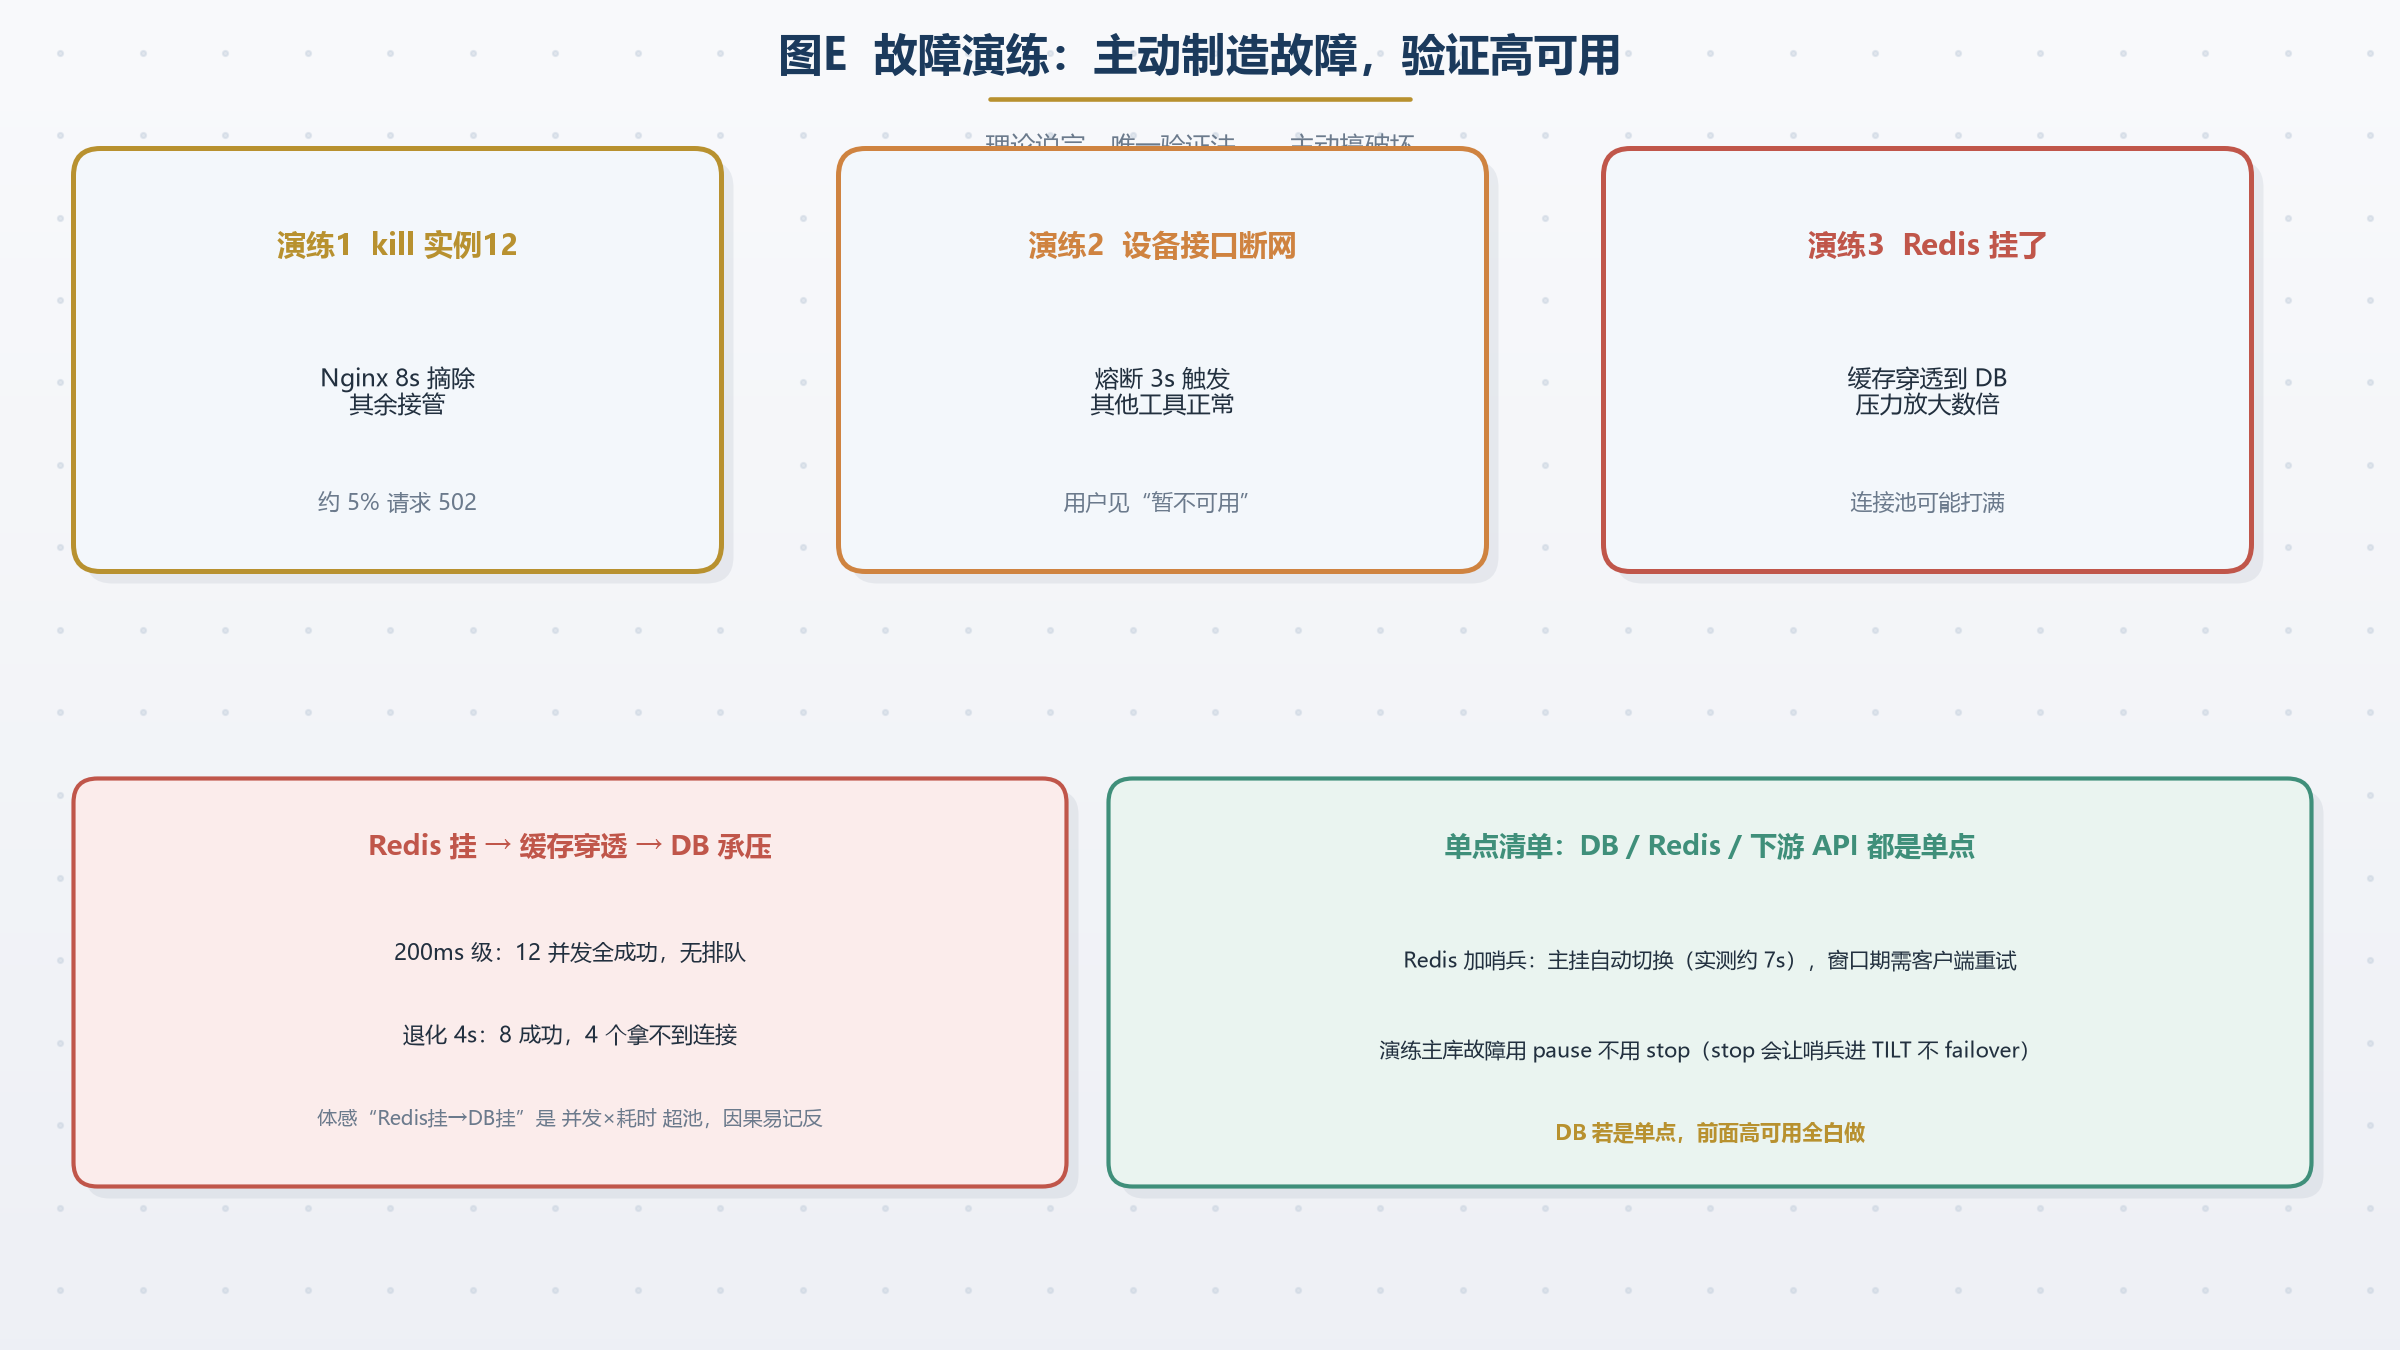
理论说完了。真正验证高可用的方法只有一个:主动制造故障。
我做了三次演练:
演练1:kill掉实例12。Nginx 8秒摘除,其他实例接管。期间约5% 请求收到502。
演练2:设备接口断网。熔断3秒触发,其他工具正常。用户看到"设备状态暂不可用"。
演练3:Redis挂了。这是我没想到的。缓存没了之后,查门店销售全部穿透到DB------我用5次同样的请求量了一下缓存前后的差别:缓存正常时只有第1次打到数据库(后面几次全命中缓存,数据库压力基本为零),缓存一挂,5次请求全部直连数据库,数据库承接的查询量立刻放大好几倍。
但这里有个前提我后来才想明白,而且它非常容易被说反:Redis挂了并不自动等于连接池打满。真正决定的是"并发数 × 单次查询耗时"有没有超过连接池的容量。我拿同样的池(上限8)跑了两组对照,12个并发客户端抢连接:
| 单次查询耗时 | 12并发打上进8连接的池 | 结果 |
|---|---|---|
| 200ms级(正常) | 全部正常返回 | 12个全成功,没有发生排队------连接用完就还了 |
| 退化到4秒 | 8个成功 | 剩下4个直接拿不到连接(Too many connections) |
所以准确的说法是:缓存是个节流阀。阀一没,DB承受的压力立刻按倍数放大。至于会不会打满连接池,要看那时候查询本身有没有变慢。而现实里这两件事常常一起发生------热点key集体过期,或者DB本来就在报警。于是体感上就成了"Redis挂 → DB跟着挂"的连锁反应,容易把因果记反。
配套示例是全mock数据、不带真实数据库,上面这两组对照是我在本地另外起的一套MySQL + Redis上跑出来的,我把触发条件、实验脚本和原始输出都留在仓库的 10-store-ha/verify/实测记录.md 里了,你可以照着自己复现一遍。
Redis挂了这个case教会我一件事:你的MCP Server依赖的每一个外部组件(DB、Redis、下游API)都是单点。你得知道每个单点挂了会发生什么。
缓存这边我用哨兵解决了自动切换;数据库是另一个单点,主从复制、读写分离或直接用云RDS都行。DB要是单点,前面这些高可用做再多也白搭。
后来我给Redis加了哨兵(Sentinel),三个节点形成多数派,主节点挂了自动切换。实测一遍大约7秒完成:
15:59:47 # +sdown master mymaster redis-master 6379
15:59:48 # +odown master mymaster redis-master 6379 #quorum 3/2
15:59:49 # +switch-master mymaster redis-master 6379 172.19.0.5 6379
切换完成后读写恢复正常,切换前已经写进去的数据也没丢------新主库是从副本提上来的,数据早就同步过去了。原主库回来之后会被哨兵降级成副本,不会形成双主。
**但别理解成"切换期间零失败"。**主从切换有一个窗口期(我这次实测约7秒),这段时间主库不可写,撞上去的写请求是会失败的。我的验证是在切换完成之后才发起的,所以看到的是"一切正常";窗口期内那几个请求报的错,我这边没采到。要兜住这段,靠的是客户端重试(Lettuce会自己重连,重要写操作建议业务层再补一次重试),不是靠哨兵。
另外哨兵只解决一件事:主节点故障自动切换。它不解决水平扩展(读压力大要做读写分离),也不解决数据分片(数据量上去了要Redis Cluster)。选型时别把它当万能药。
这里有个坑值得单独拎出来,因为按直觉操作会得出"哨兵没用"的错误结论:演练主库故障要用 pause,不要用 stop。
容器一 stop,Docker网络里的DNS别名就注销了,而哨兵配置里开着 resolve-hostnames,解析失败会让它进入TILT模式------一种自我保护状态,期间不发起failover。我第一次就是这么试的,主库明明已经不可用,哨兵却迟迟不动:
15:55:12 # Failed to resolve hostname 'redis-master'
15:55:12 # +tilt                   ← 自我保护,不发起 failover
15:55:42 # +sdown master mymaster  ← 本该 5 秒就标记
15:55:45 # +tilt
换成 pause(冻结进程,但别名和IP都保留)之后一切正常:5秒sdown、7秒完成switch-master。
日常监护:没有监控的高可用是盲飞
演练是定期体检,但平时你得知道系统现在什么状态。这里只讲跟高可用直接相关的那几个指标------全链路追踪和可观测性体系放在系列(十四),不在这儿展开。
至少要看这6个:
- 各实例的QPS / 错误率 / P99
- 健康实例数(Nginx认为还活着几个)
- 熔断状态:哪些下游的熔断器是打开的、开了多久
- 降级次数:三个级别各触发了多少次
- 线程池 / 连接池使用率
- 依赖可用性:DB、Redis、下游接口
告警阈值我用的经验值:错误率>5%、P99>1s、实例不健康、熔断打开超过30秒、线程池使用率>80%(这条是预警不是告警)。
池子该设多大是另一个话题------线程池不是越大越好、数据库连接数有公式、拍脑袋定的数基本都不准得靠实际使用率回调,这些单独写了一篇(见文末延伸阅读)。这里只强调一个结论:容量不是静态数字,它是"并发 × 单次耗时"的函数。你按今天的耗时配的容量,明天下游慢一倍就不够用了------上面那组对照实验已经证明过这一点。
熔断这里有个原则值得单独说:**fallback必须极简,不能再依赖外部服务。**否则下游挂了、fallback也跟着挂,那就真没有退路了------降级是为了收窄影响面,不是换个地方继续失败。另外熔断打开这件事本身要留一条审计日志(什么时候开的、开了多久、失败多少次),不然事后复盘只能靠猜:到底是下游真的挂了,还是我阈值配得太敏感。
九、你以为vs实际
| 你以为 | 实际 |
|---|---|
| 加机器就能扛住流量 | 加机器前先确认无状态,否则会话错乱 |
| Nginx负载均衡自动搞定一切 | Nginx不会主动发现实例挂了,要配健康检查 |
| 下游挂了等它自己恢复 | 不熔断的话一个下游挂拖垮整个MCP |
| 降级就是返回错误页 | 降级是分级别,有的返回缓存,有的返回友好提示 |
| 高可用 = 多活 | 高可用是"一个挂了系统还能用",不是"所有都活着" |
| 加了健康检查就零故障了 | 健康检查有窗口期,窗口期内照样有错误,要零错误得客户端重试 |
| 熔断越快越好 | 太快误伤、太慢保护不住,而且它是按样本数触发的,不是按时间 |
| 多实例就等于高可用 | 多实例却共用一个DB或Redis,那依赖还是单点 |
十、决策树:你需要做到哪一层
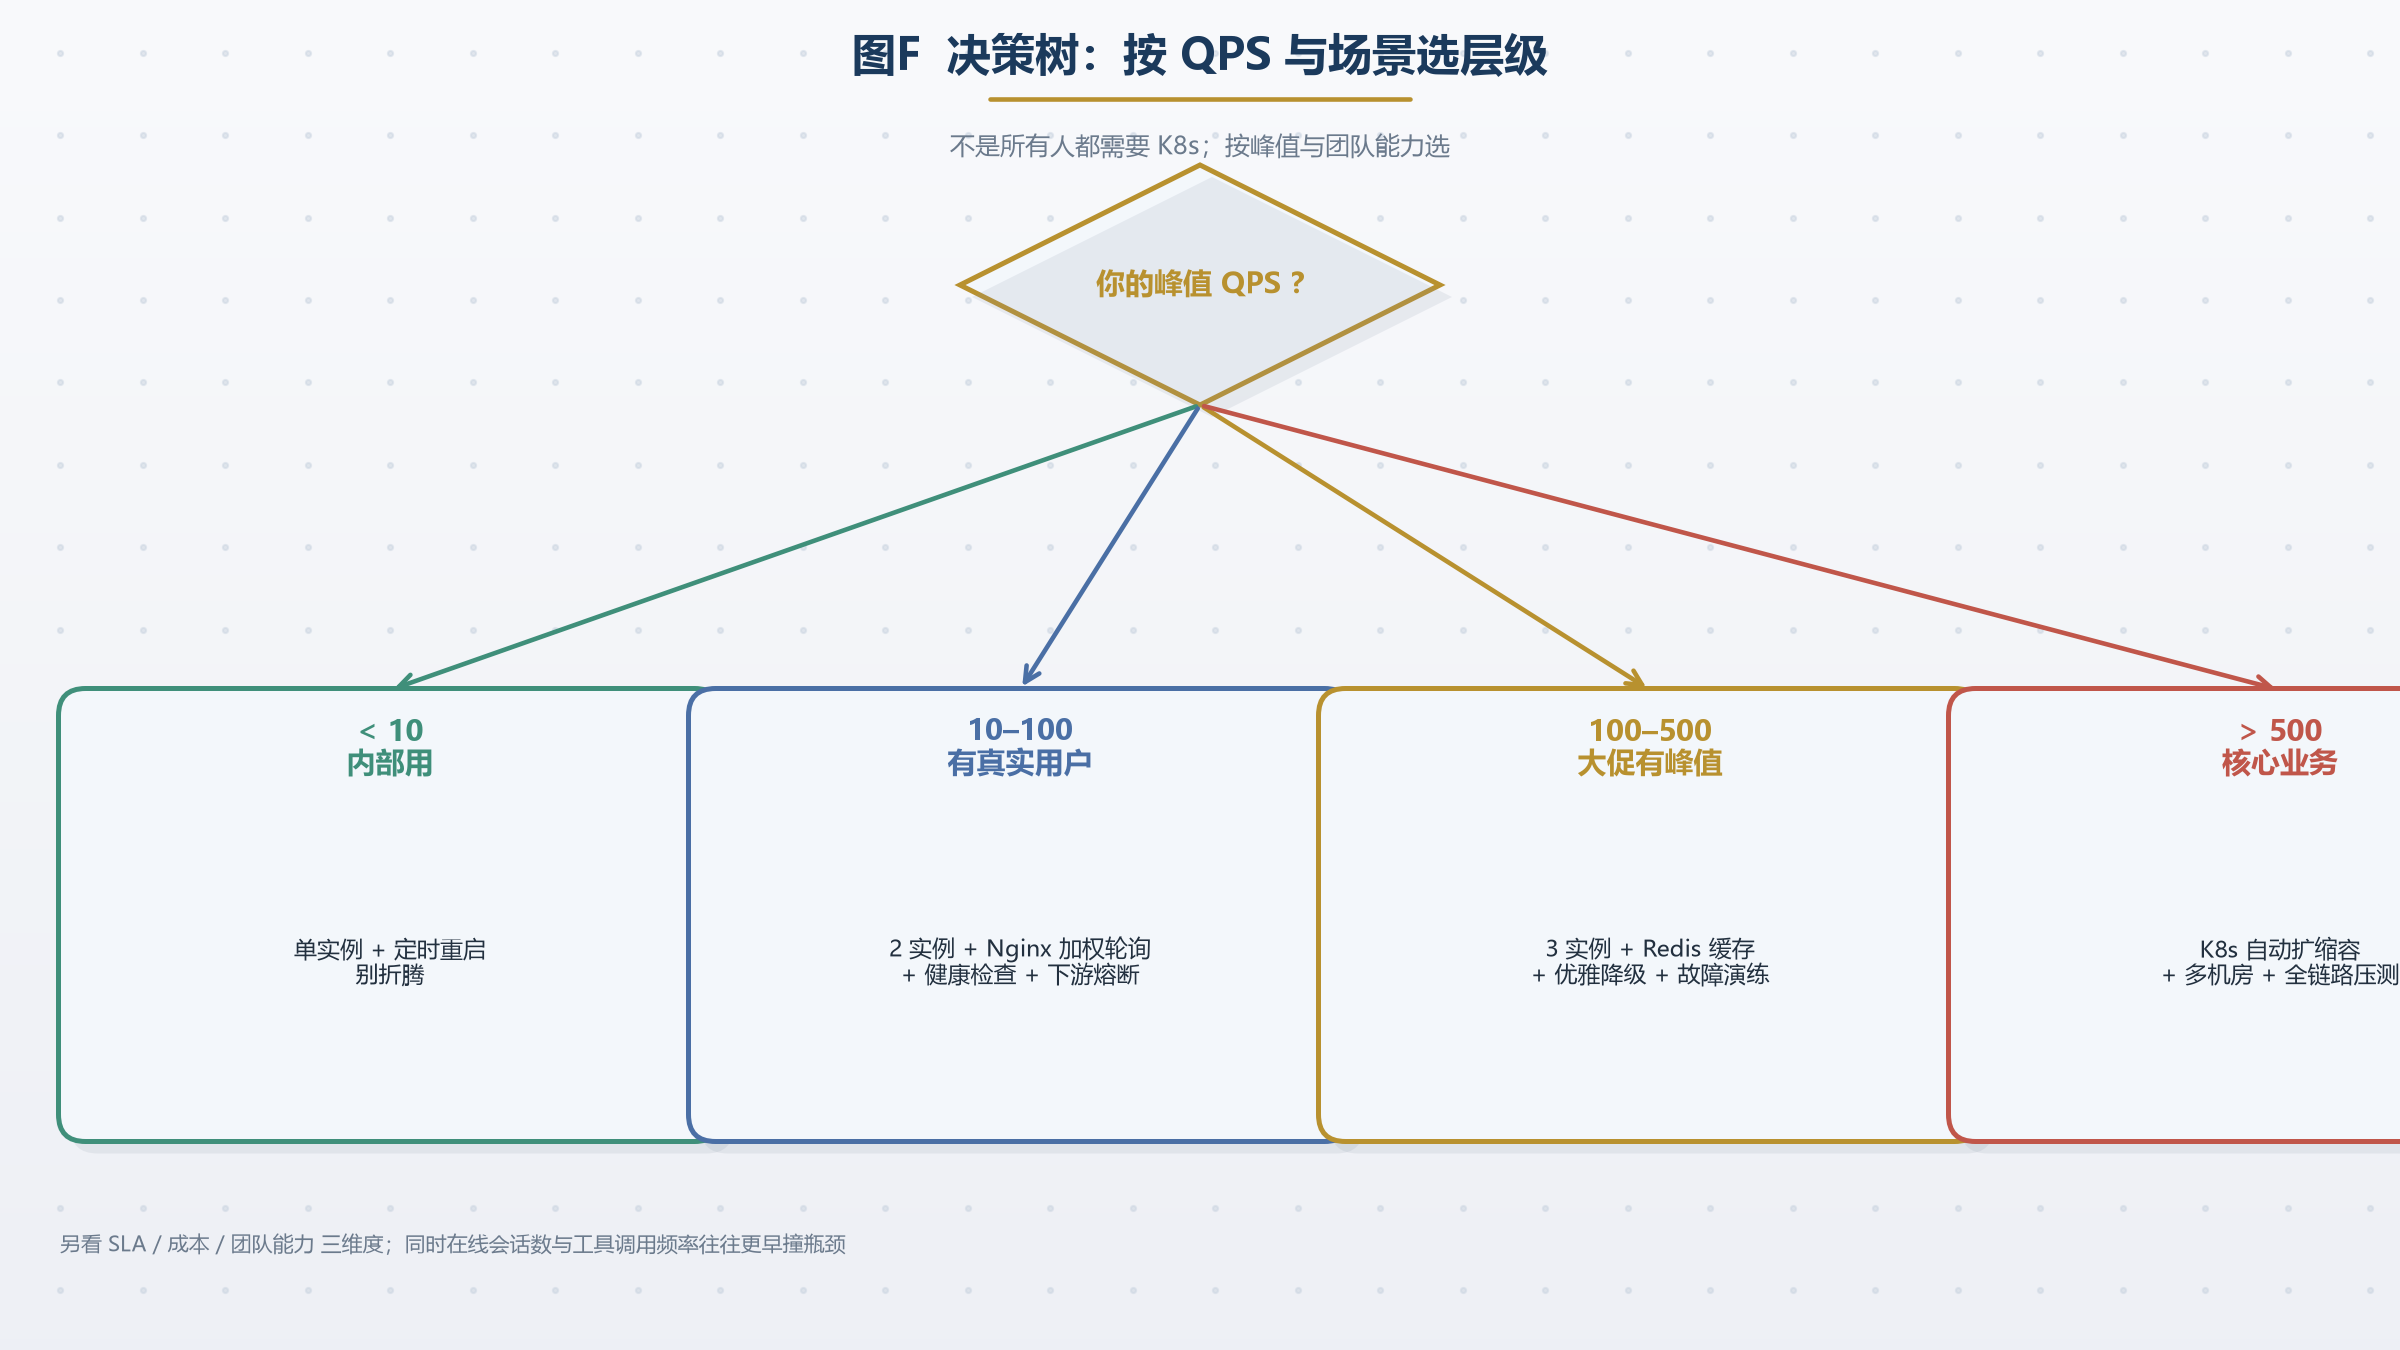
不是所有人都需要上K8s。按你的场景选:
你的MCP Server有多少QPS?
├─ <10 QPS,内部用
│   └─ 单实例+定时重启就够了,别折腾
├─ 10-100 QPS,有真实用户
│   └─ 2实例+Nginx加权轮询+健康检查+下游熔断
├─ 100-500 QPS,大促有峰值
│   └─ 3实例+Redis缓存+优雅降级+故障演练
└─ >500 QPS,核心业务
    └─ K8s自动扩缩容+多机房+全链路压测
不过QPS只是其中一个维度。真正在这几档之间做选择的,通常是另外三件事:
| 维度 | 怎么影响选择 |
|---|---|
| SLA | 99.5%和99.99%不是一个量级的投入------后者基本意味着多机房,光这一项就够吃掉预算 |
| 成本 | 2实例加Nginx是几百块一个月的事;K8s加多机房是好几倍,还得算上运维人力 |
| 团队能力 | K8s不是搭起来就完事,得有人能扛半夜的Pod异常。没人维护的话,3实例加Nginx远比一个没人看懂的K8s集群可靠 |
另外MCP有个容易被忽略的点:QPS不是唯一衡量维度,同时在线的会话数和工具调用频率往往更早撞到瓶颈------一个会话里Agent可能连着调七八个工具。
还有一个前置问题:你怎么知道该上几台?估峰值QPS(历史峰值 × 1.5~3倍增长系数)→ 单机压测找到瓶颈 → 按峰值 ÷ 单机容量 × 冗余系数算实例数。冗余至少30%,大促给50%~100%;压测别只压匀速流量,指标看P99不看平均值。
至于决策树最后一档的"多机房"------那是另一个量级的话题,本文不覆盖:数据同步、流量调度、机房级切换,以及成本。它通常需要单独立项。
我们现在在第三档。双11期间从2实例扩到3实例,扛住了120 QPS的峰值。没有用户投诉。
十一、下一篇
高可用解决了"挂了怎么办"。但店长们在飞书群里 @机器人查库存这个场景,我们还没接。
下一篇讲怎么把MCP接到飞书,让店长在群里直接 @机器人查数据。
十二、本次实测核心踩坑与风险
- 环境坑 :Nginx漏配
proxy_set_header Host $host时,转发Host默认成upstream名(含下划线),Tomcat判非法主机名导致整站400,且Nginx与后端都不报错、只有客户端拿到400,日志干净极难查;actuatorshow-details: always会把Redis精确版本、磁盘余量、SSL状态全吐出去,等于给攻击者画攻击面,只能放内网。 - 安全坑:健康详情开公网泄露版本号与依赖即暴露CVE攻击面;fallback若再依赖外部服务,下游挂时降级也跟着挂,等于没退路;熔断何时打开、开了多久、失败几次若不记审计日志,事后复盘只能靠猜。
- 生产坑:被动健康检查靠真实请求失败计数,低峰实例挂了Nginx毫无察觉、早高峰才爆发;优雅停机等待必须大于最长工具超时,否则等待到期强杀、优雅停机形同虚设;熔断各实例各自计数,负载均衡把请求摊薄后单实例凑不够样本,看起来"没生效"其实是没攒够次数。
- 边界坑:本机mock无真实流量与数据库,性能数字别照抄;Redis哨兵只解决主节点自动切换,不解决水平扩展与数据分片;多实例若共用单点DB或Redis,前面高可用全白做;熔断半开成功后默认全量放行,"刚恢复就被流量打挂"是经典成因。
延伸阅读:这个专题的另外 5 篇
讲高可用时我拆出去单独写了 5 个知识点,跟本文配套:
| 篇 | 标题 | 链接 |
|---|---|---|
| 01 | Nginx开源版没有主动探活:四种补救方案和一个能用的脚本 | 待补 |
| 02 | 发版就掉请求?Spring Boot优雅停机的四步 | 待补 |
| 03 | 超时不是一个数字,是一套体系:MCP Server的五条约束 | 待补 |
| 04 | 高可用配完之后:该看哪几个指标,池子该设多大 | 待补 |
| 05 | 缓存穿透、击穿、雪崩:三个概念,三种解法 | 待补 |
本文完整可运行代码 (tag: v10)
- 国内访问 / 点star :https://gitee.com/ethanliang2016/mcp-in-action
- GitHub(需代理):https://github.com/ethanliang2016/mcp-in-action
- 克隆:
git clone https://gitee.com/ethanliang2016/mcp-in-action.git
clone下来 git checkout v10 就能还原本文状态,全mock数据,不依赖任何真实系统。
跑通了的话点个star------这是我继续写下去最直接的反馈。
跑不通直接来提issue,我看到就回。