一、一页详情,四个接口,三种返回形状
一条审批单点开后,用户看到的是一页:上面是流程图(走过的线是绿的,当前那格是橙的),中间是表单,下面是一条时间线,右上角一行"当前处理人:张三、李四"。
看起来是一个页面的东西,在 jeeflow 里是四个接口拼出来的:
| 页面上的一块 | 接口 | data 形状 · 要不要登录人 |
|---|---|---|
| 表单与流程定义 | detail |
对象 · 不要 |
| 流程图着色 | highLight |
对象四键 · 不要 |
| 审批时间线 | approvalRecord |
裸数组 · 不要 |
| 当前处理人 | getAssigneeTextData |
裸数组 · 不要 |
| 抄送我的(列表页,顺带) | ccList |
分页壳 · 要,且还要权限码 |
(表里四个 action 的全称都带 processInstance/ 前缀。)前四个都只吃一个 id,第五个要认"我是谁"。这张表里三件事值得单独说:着色名单里装的是 id 不是名字 、时间线包含进行中的任务 、四个接口里只有一个需要登录人。
二、画布和着色是两个接口,不是一件事
流程图要画出来需要两份数据:图本身 (节点、连线、坐标)和这份实例走到哪了 。前者来自 detail:
java
data.put("jsonObject",
    def0 != null ? parseGraph(def0.getContent()) : null);
后者来自 highLight,它返回四个键(逐行摘自 JeeflowFacade.highLight):
java
data.put("activeNodeNames", activeNodeNames);
data.put("historyNodeNames", historyNodeNames);
data.put("historyEdgeNames", historyEdgeNames);
data.put("nodeProgress", nodeProgress);
前端只是把两份东西交给同一个设计器组件,一次传图、一次传着色数据:
ts
// views/wf/process-instance/detail.vue
jsonObject.value = data.jsonObject || {};          // 来自 detail
// ...
processInstanceHighLight({ id: record.value?.id }).then((data) => {
  highLight.value = data;                          // 来自 highLight
});
// 模板里两枚一起喂给设计器
//   :high-light="highLight"   :assignee-text-data="assigneeTextData"
为什么要拆开? 因为两者变化节奏不同:图在流程定义不变时永远不变,着色每办理一次就变一次。合成一个接口意味着每次刷新状态都要把整张图的 JSON 再传一遍------复杂流程的 content 是几十 KB 的 LogicFlow JSON,而这个页面往往一次会话里要重开好几张单。
三、"节点名"里装的是 id,这是这一页最容易踩的坑
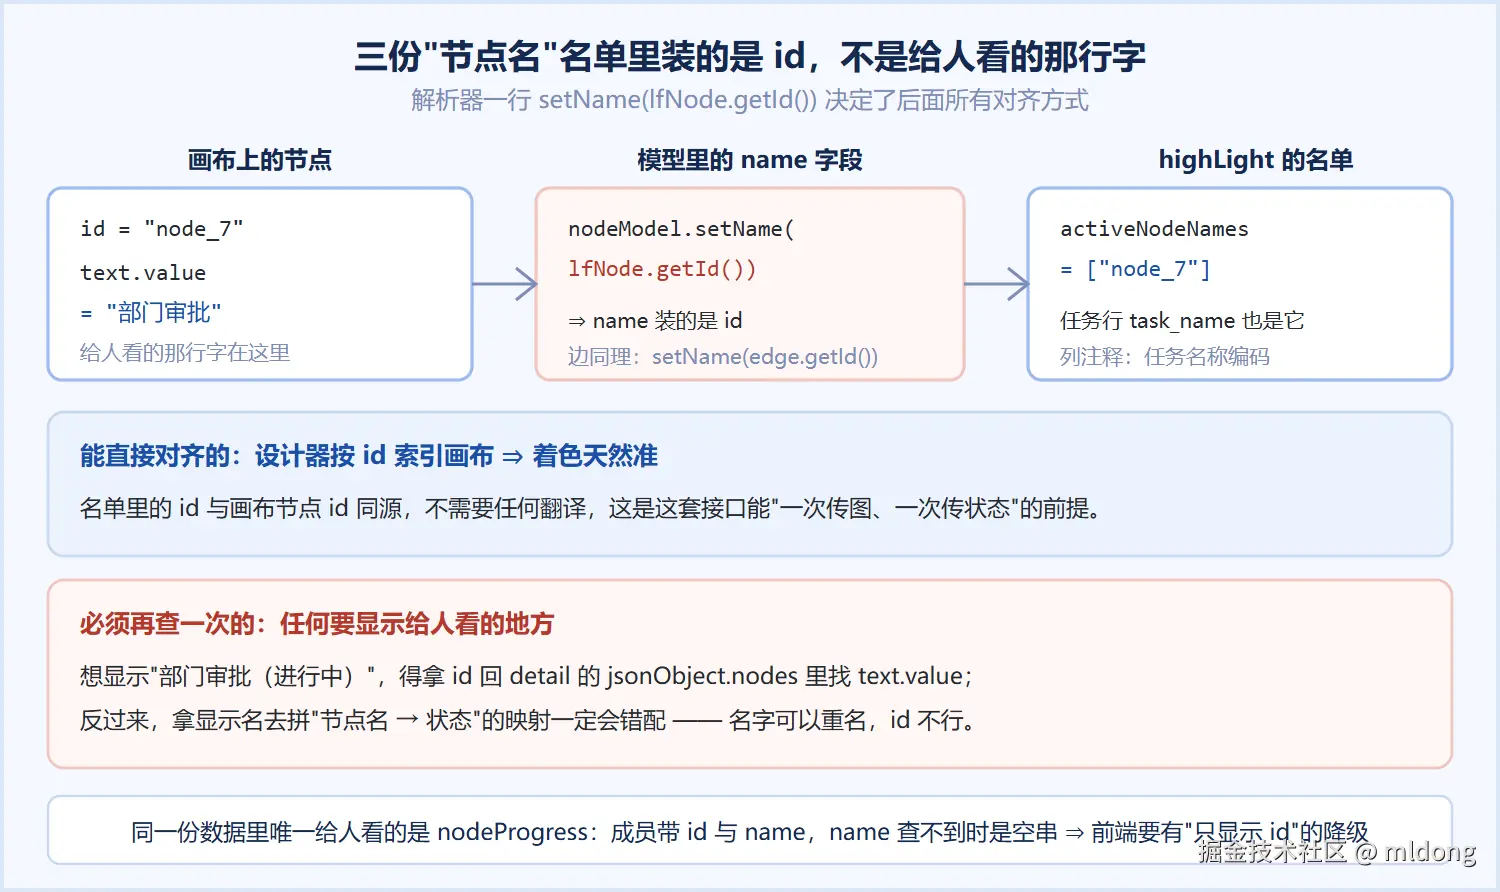
activeNodeNames、historyNodeNames、historyEdgeNames 三个键名都带 Names,直觉上里面该是"部门审批""总经理审批"这类中文节点名。
不是。 解析器在建模型时把 LogicFlow 的节点 id 写进了 name 字段:
java
// AbstractNodeParser.java
nodeModel.setName(lfNode.getId());  // 节点 name = 画布节点 id
tm.setName(edge.getId());           // 边同理
而引擎建任务行时用的就是这个 name:
sql
task_name VARCHAR(100) NOT NULL COMMENT '任务名称编码',所以这三份名单是给机器对齐图用的 id 集合 ,不是给人看的文案。设计器能直接着色,是因为它本来就按 id 索引画布上的节点;但要在页面上显示"部门审批(进行中)"这种文字,你得再拿 id 去图上反查显示名。
这条对做详情页的人有三个实际后果:
- 别拿这三份名单当文案渲染 。要显示节点名,去
detail的jsonObject.nodes里按 id 找text.value。 - 别自己拼"节点名 → 状态"的映射 。名单里是 id,任务行里的
task_name也是 id,两边天然对齐;一旦中间掺进显示名就会错配(显示名可以重名,id 不行)。 - 数据库里那一列叫
task_name,注释写着"任务名称编码"------"编码"两个字就是这个意思:它是标识,不是标题。
至于 nodeProgress,它是这一页里唯一"给人看"的那份:按节点聚合,每个节点带成员列表,成员是 {id, name, done?, active?},done/active 只在命中时才出键,会签节点额外带 type(PARALLEL / SEQUENTIAL)。姓名走 IUserProvider SPI 解析,查不到时给空串------所以前端必须准备"只有 id"的降级显示 ,不能假设 name 一定有值。
四、审批记录是任务历史,不是"已办结清单"
时间线那块吃 approvalRecord,它只有一句话的实现:
java
List<ProcessTask> history = repository.findHistoryTasks(instanceId);而那条 SQL 里没有任何状态条件:
sql
SELECT * FROM wf_process_task
WHERE process_instance_id = ?
ORDER BY create_time ASC
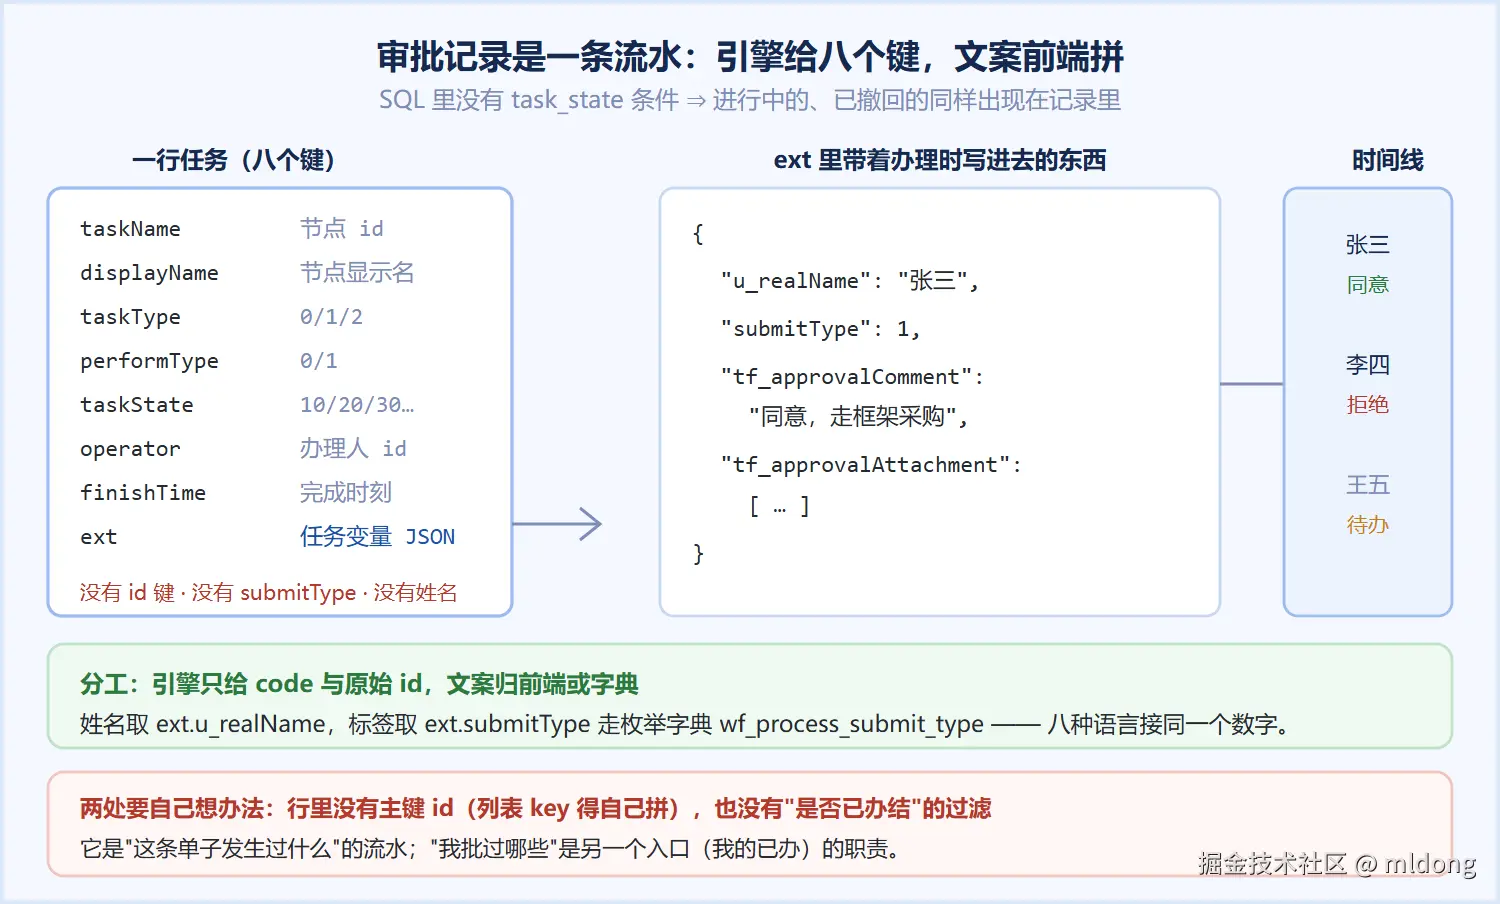
⇒ 进行中的任务、已撤回的任务都在这份记录里 。这不是遗漏,是这一格的定义:它是"这条单子身上发生过什么"的流水,不是"我批过什么"的清单(后者是上一篇里"我的已办"那格的职责,那边要的是 task_state <> 10)。
出口是裸数组 (data 直接就是行列表,不套分页壳),每行八个键:
java
vo.put("taskName", t.getTaskName());
vo.put("displayName", t.getDisplayName());
vo.put("taskType", ... .getCode());
vo.put("performType", ... .getCode());
vo.put("taskState", t.getTaskState());
vo.put("operator", t.getActorId());
vo.put("finishTime", fmtTime(t.getFinishTime()));
vo.put("ext", t.getVariables() != null
? t.getVariables() : new LinkedHashMap<>());请注意这份清单里没有的两样东西:
- 没有
id。八键里没有任务主键。所以前端做时间线时不能拿item.id当列表 key(得自己用taskName+ 序号拼一个)。 - 没有
submitType,也没有姓名。"他点了同意还是拒绝"、"这个人叫什么",引擎都不给。
这两样在前端从 ext 里取------ext 就是这一行任务的变量 JSON,办理时写进去的东西都在这儿:
ts
// views/wf/process-instance/approval-record.vue
<span>{{ item.ext?.u_realName }}</span>
<ApiDict :value="item.ext?.submitType"
         code="wf_process_submit_type" />
姓名是引擎在执行任务时顺手写进变量的 u_realName,提交类型是 submitType;标签文案走后端枚举字典 wf_process_submit_type,不是前端硬编码的一份映射。
为什么把渲染留在前端? 因为"同意/拒绝"这套文案是要跟着语言和项目改的(我们另一套前端里就是硬编码 map),而引擎侧给 code 才能保证八种语言、十三套框架接同一个数字。ext 这个出口是任务变量的唯一对外通道 ,所以业务想往时间线上加"金额""紧急程度"这类字段,不需要动引擎------办理时带进 tf_* 参数,它就出现在 ext 里。
五、"当前处理人"是另一种人,一人一行
getAssigneeTextData 负责右上角那一行。它的实现说明了两件事:
java
boolean includeNodeName =
        !Boolean.FALSE.equals(args.get("includeNodeName"));
List<ProcessTask> doing = repository.findDoingTasks(instanceId, null);
for (ProcessTask t : doing) {
    List<String> actors = repository.findTaskActors(t.getTaskId());
    for (String actor : actors) {
        item.put("value", actor);
        item.put("label", includeNodeName
                ? t.getDisplayName() + ":" + actor : actor);
    }
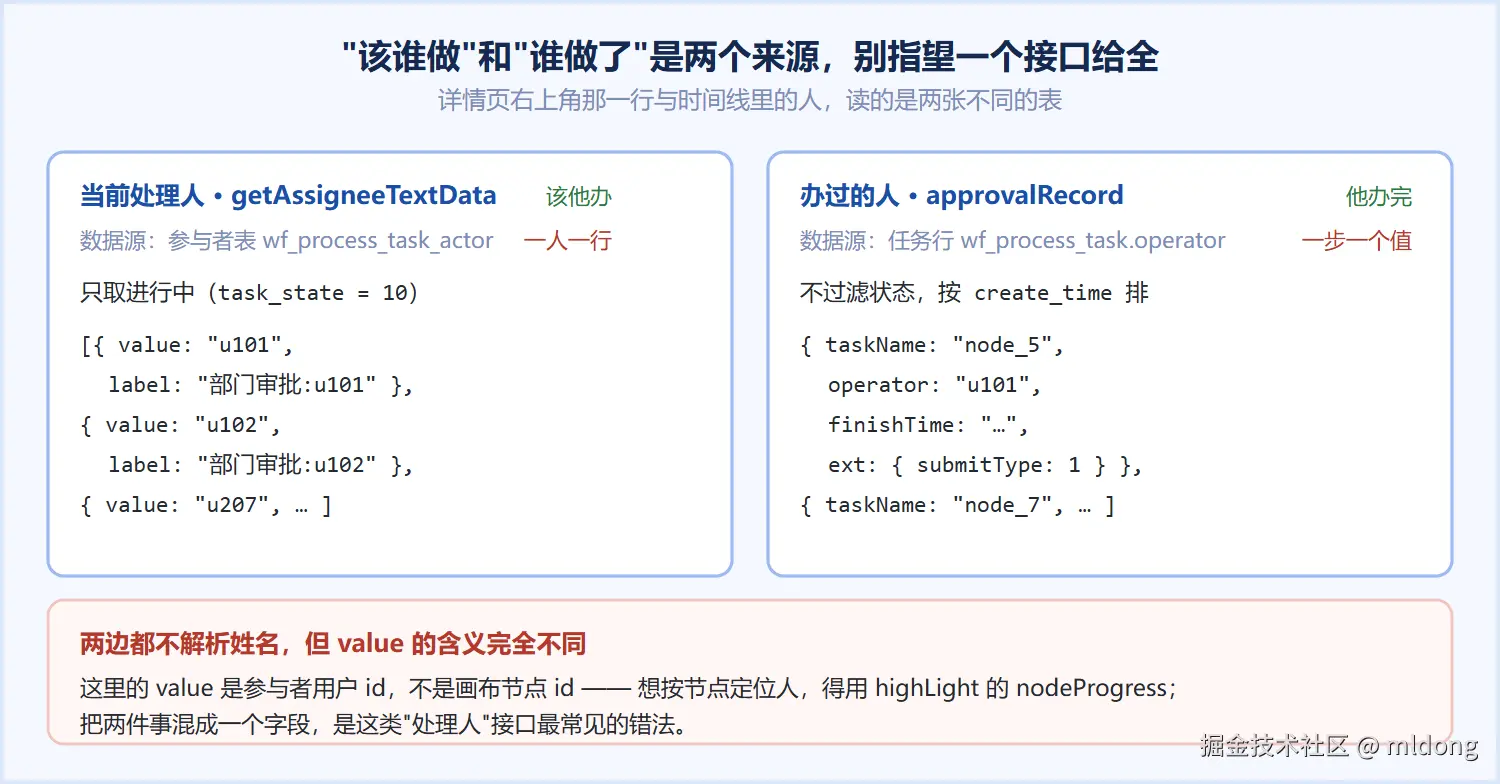
}- 只取进行中的任务 (
findDoingTasks⇒task_state = 10),所以它天然是"现在卡在谁手上",不掺历史。 - 一个参与人一行,不按节点合并 。三人会签就是三行,前端要合并成一行自己
join。 value是参与者用户 id,label是"节点显示名:用户id" 。includeNodeName默认开,只有显式传布尔false才关。
这一格和上一格的区别,正好是那对老问题------"该谁做"和"谁做了"是两个问题:
- 该他办 :
getAssigneeTextData读参与者表wf_process_task_actor,只取进行中的任务,一人一行; - 他办完 :
approvalRecord的operator读任务表自己那一列,一步一个值。
所以详情页上"当前处理人"和"审批记录里的人"是两个来源,别指望一个接口给全。
六、四个接口里只有一个要登录人,这不是疏忽
highLight / approvalRecord / getAssigneeTextData 都只吃 id,而且引擎内置的权限映射把它们列在放行清单里:
java
NO_PERM_ACTIONS.addAll(Arrays.asList(
    "processInstance/detail", "processInstance/highLight",
    "processInstance/approvalRecord",
    "processInstance/getAssigneeTextData", "processInstance/bizData",
    "processTask/detail", "processTask/addCandidate",
    "processTask/latest",
    "processInstance/stats/overview", "processInstance/stats/trend",
    "processInstance/stats/group"));
引擎不依赖任何鉴权框架,只通过 SPI 提供"action → 权限码"的映射元数据,校验发生在集成层 (框架壳里那句 StpUtil.checkPermissionOr(codes),超管直接放行)。放行不等于没边界------它意味着边界换了一层:
- 这三个接口是实例级只读 :拿到
id就能看这条单子的图和记录,谁登录都一样。 - 于是"谁能拿到这个 id"就成了真正的关口,而那一关在列表侧------待办、已办、我发起的、抄送我的四类入口的归属过滤(那是另一篇的四个"我的"菜单各查哪张表的事)。
ccList 是这批里唯一的例外:它要权限码 wf:processInstance:ccList,并且必须带 operator,因为它按"我"来过滤:
java
query.add("cc.actor_id", "EQ", userId);它的行源是流程实例表 ,抄送表只出条件不出字段(cc.state 在筛选白名单里,可以拿 m_cc_EQ_state = 0 筛未读,但不在出口字段里)。所以出口里那个 operator 是发起人 ,不是"抄送给我的人"------这一格我们踩过一次,规则后来钉成三要件:行源必须是实例、operator 必须是发起人、主键键名必须是 id;想知道"这条是谁发给我的",取 cc 行的 create_user,不许占用 operator 这个键名。
一句话收这段:做详情页接口时,先决定它是"实例级只读"还是"我的"。前者只要 id、可以放行;后者必须显式带登录人,且缺人时返回空而不是返回全部。
七、四块内容各自重取,别把它们焊死
前端的接线方式也值得说,因为它决定了"办理完一次,页面要不要整页刷新"。
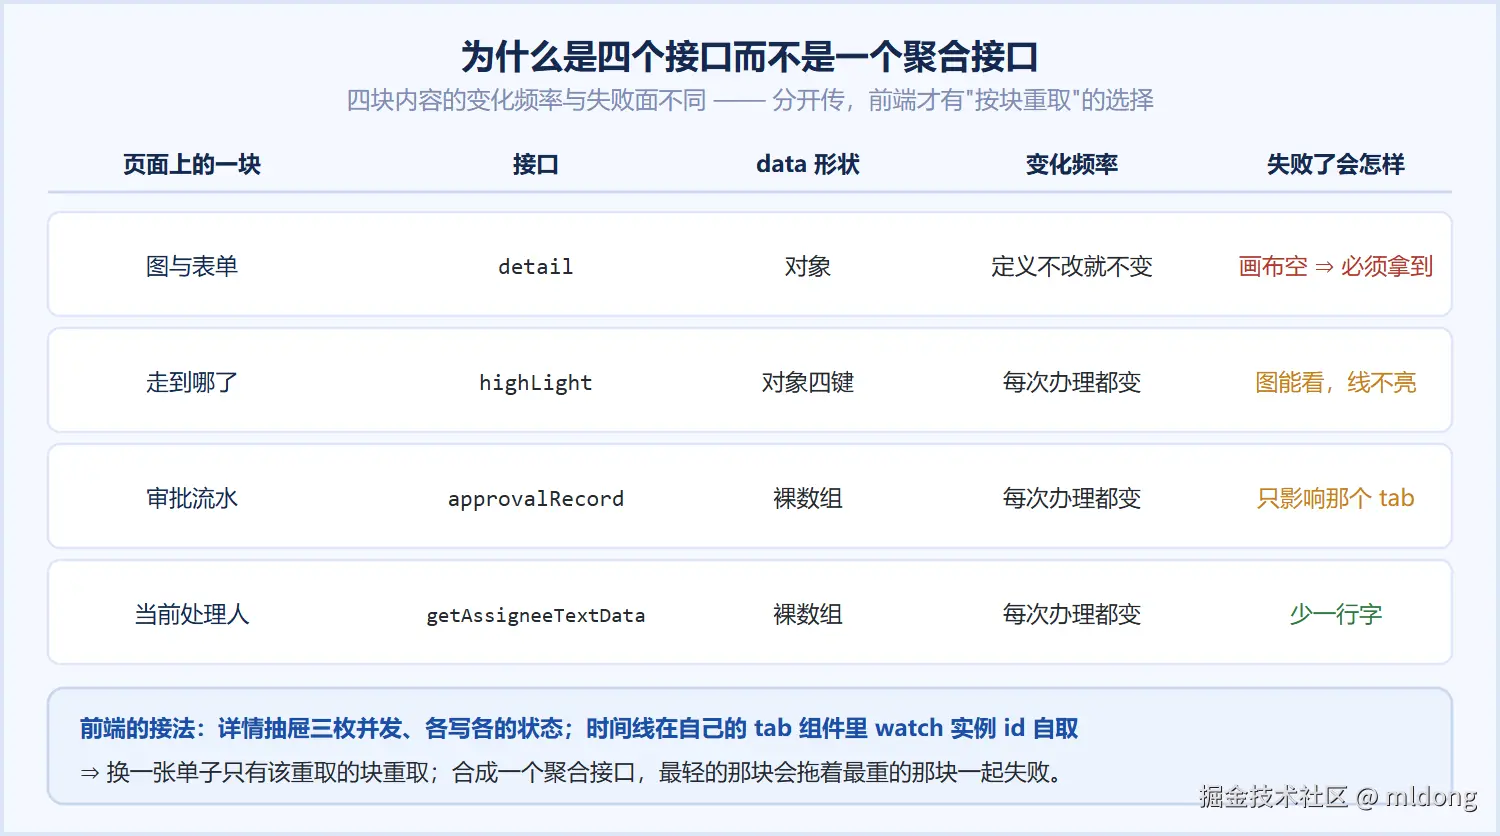
vben5-wf 里这四块不是一次批量取回:详情抽屉打开时三枚并发发出、互不依赖(detail / highLight / getAssigneeTextData),而审批记录根本不在详情抽屉里发------它在自己的 tab 组件里:
ts
// views/wf/process-instance/approval-record.vue
const requestData = () => {
  if (!props.data?.id) return;
  approvalRecord({ id: props.data.id })
    .then((res) => { dataSource.value = res; });
};
onMounted(() => { requestData(); });
watch(() => props.data.id, requestData);
watch 那一行是关键:换一张单子,时间线自己重取,画布不用重画 。同理,办理完只想刷新着色,就只重打 highLight 那一枚。
这不是"前端偷懒没合并接口",而是四类数据的变化频率与失败面天然不同(按上面那四块顺序对):
| 块 | 变化频率 | 失败了会怎样 |
|---|---|---|
| 图与表单 | 定义不改就不变 | 画布空,页面没意义 ⇒ 必须拿到 |
| 着色 | 每次办理 | 图能看,线不亮 ⇒ 可容忍 |
| 审批流水 | 每次办理 | 只影响那个 tab |
| 当前处理人 | 每次办理 | 少一行字 |
接口分开,前端才有"按块降级"的选择;合成一个聚合接口,最轻的那块会拖着最重的那块一起失败。
八、拿去自查:做审批详情页该问的六个问题
- 图和状态是两份数据还是一个接口? 定义几乎不变、状态每办一次都变------分开传,别让每次刷新都重传整张图。
- 那份"节点名单"里装的是 id 还是名字? 如果是 id,画布能直接着色,但任何要显示给人看的地方都得反查一次;如果混着两种,重名节点必然错配。
- "审批记录"要不要包含进行中和已撤回的? 先定义清楚它是"流水"还是"办结清单",再决定要不要状态过滤------这两句话在需求评审时经常被当成同一件事。
- 姓名和"同意/拒绝"标签在哪一侧渲染? 引擎给 code 和原始 id,文案在前端或字典。定了就别两头做,否则换一套前端就对不上。
- 这一页里哪些接口是"我的"语义? 只吃
id的是实例级只读,边界在入口列表;带operator的必须缺人即空页,不能退化成"这条条件不加"。 - 换一张单子时,哪几块要重取? 用
watch挂实例 id 让每块自己重取,比整页 reload 省一次画布重建,也比手工在提交回调里逐个刷新少漏一处。
结语
这一页看上去是"一个详情接口"的事,拆开是四份数据、三种返回形状、两类归属语义,加上一堆"引擎只给 code,文案在前端"的分工。这种分工的代价是每个前端都要多写几行取值逻辑,好处是同一份后端能同时喂两套完全不同的前端、八种语言的引擎实现给出同一批键名。
如果你的系统里也有这么一页,值得先画那张"哪块内容吃哪个接口"的表------它顺手就把变更频率、失败面和权限语义一起定了。
参考资料
- jeeflow 工作流引擎文档站:jeeflow-doc.mldong.com
- 动作与参数契约(规范 06 · 门面):jeeflow-doc.mldong.com/spec/06-fac...
- SPI 与扩展点(规范 05):jeeflow-doc.mldong.com/spec/05-spi
- GitHub(Java 参考实现):github.com/mldong/jeef...
- mldong 快速开发框架:github.com/mldong/mldo...