各位 Rust 爱好者们,大家好。
对于任何编程语言而言,如果我们需要让多个线程访问同一份数据,互斥锁 Mutex 往往是我们的第一选择。
Rust 也不例外。
Mutex 提供了一个简单的保证:同一时间,只有一个线程可以持有这把锁,访问它保护的数据。
不过,这个保证也有代价。
如果大多数线程都只是在读取,会怎样?
这篇文章想聊聊独占锁的隐藏成本:为什么 Mutex 可能成为读多写少场景中的瓶颈,以及在 Rust 中换一种同步方式,如何让更多工作有机会并行执行,提高吞吐量。
先从问题说起。
一视同仁
Mutex 提供的保证很简单:
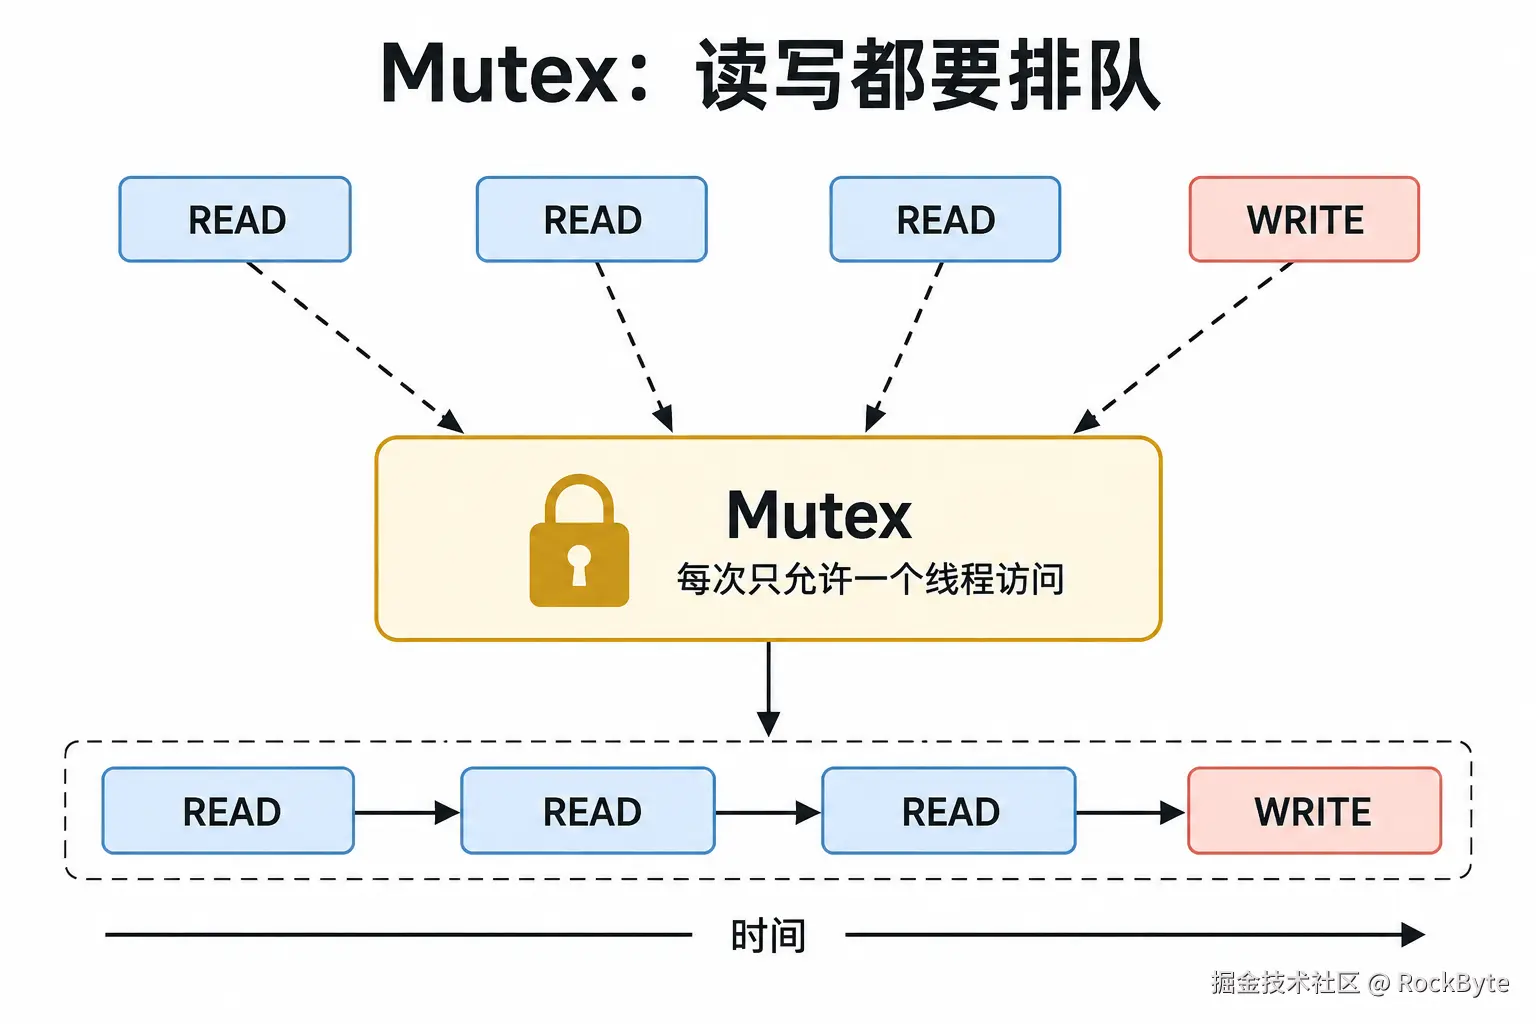
同一时间,只有一个线程能访问它保护的数据,至于这个线程是在读还是在写,Mutex 并不区分。
比如,有一份共享配置,多个线程都需要读取:
rust
use std::sync::Mutex;
let config = Mutex::new(Config::new());
// Thread 1 的线程体(示意)
{
    let guard = config.lock().unwrap();
    read_config(&guard);
}
// Thread 2 的线程体(示意)
{
    let guard = config.lock().unwrap();
    read_config(&guard);
}
// 其他线程类似
这两个线程都只是在读取数据。但因为数据由 Mutex 保护,第二个线程必须等第一个线程释放锁后,才能继续。
该示例省略了跨线程共享锁的准备工作:在 Rust 中,要真正让多个线程共享一把锁,通常需要用
Arc包装它,也可以使用作用域线程或static。这里有意省略了这些准备代码,把重点放在锁的行为上。
举个例子,假设我有多个读线程。
假设读线程 1 先获取锁,它释放锁后,其他读线程才能继续获取锁。读线程仍需逐个进入临界区,但具体顺序不一定按线程编号排列。
数据没有变化,也没有写操作与读取冲突。但 Mutex 还是把原本可能并行执行的工作变成了串行执行------这就是它的隐藏成本。
这种场景的主要问题不在于 Mutex 本身很慢,而在于独占访问会阻止多个线程同时推进工作。
在读多写少的场景中,这一点尤其明显:
想想配置、路由表、缓存、功能开关,以及其他经常读取、偶尔修改的共享状态。
如果几十个线程都在尝试读取同一份数据,却非得依次获取独占锁,就可能产生不必要的锁竞争,让线程花更多时间等待,而不是执行工作。
于是,问题来了:
读线程真的需要等待其他读线程吗?
让读线程一起读取
如果多个线程都只是在读取共享数据,它们未必需要独占访问。
这时候就可以考虑读写锁。
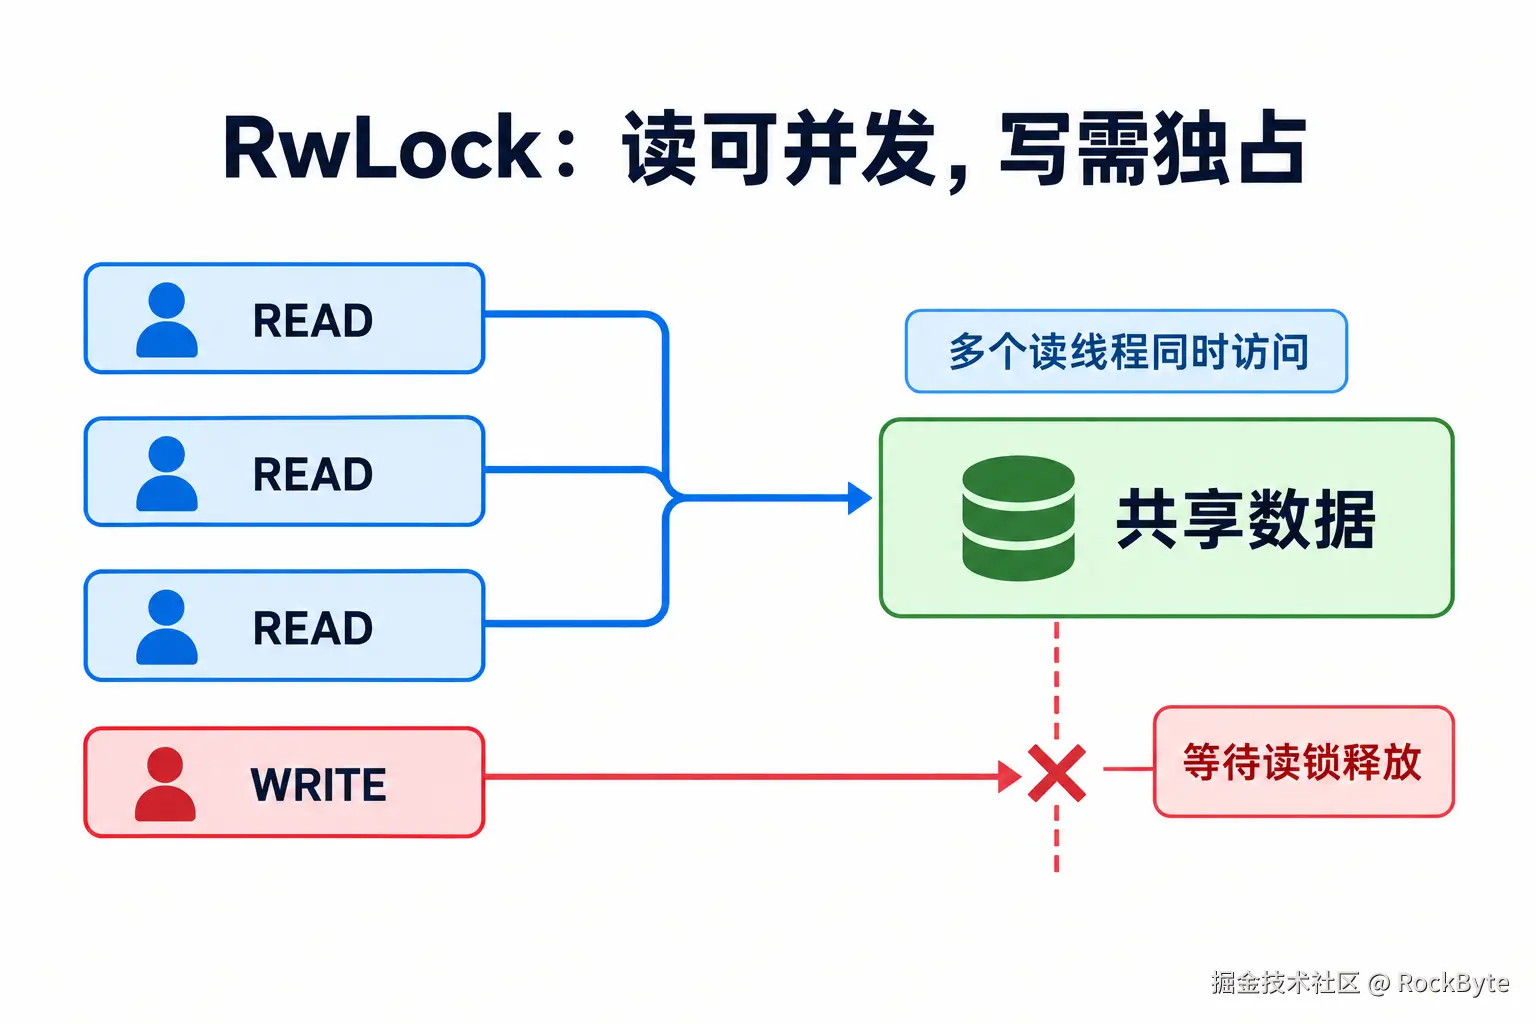
Rust 提供的 RwLock 正是用来处理这类访问模式的。它允许多个线程同时持有读锁,而写锁仍然是独占的。
这里先限定一下范围:本文讨论的是 std::sync::RwLock 和操作系统线程。如果你写的是异步代码,对应的锁通常由运行时提供,比如 tokio::sync::RwLock,它的取舍会有些不同。
read() 和 write() 返回 Result,也是因为需要报告锁中毒的情况,示例因此调用了 .unwrap():如果线程在持有写锁时发生 panic,锁可能进入"中毒"(poisoned)状态,后续调用会报告这一情况。
rust
use std::sync::RwLock;
let config = RwLock::new(Config::new());
// Multiple threads can read concurrently
let guard = config.read().unwrap();
read_config(&guard);
原本,读线程只能一个接一个地执行:
text
READ → READ → READ → READ现在,它们可以同时推进工作:
区别很简单:
Mutex 对每次操作都提供独占访问,而 RwLock 区分了读访问和写访问。
注意!这并不意味着 RwLock 一定更快。
它去掉的是读多写少场景中一个不必要的限制:多个读线程可以同时持有读锁,潜在的性能提升就来自这里。不过,锁的优先级策略取决于操作系统实现;等待中的写线程也可能阻止新的读线程获取锁。
那在实际使用中,差别到底能有多大?
提醒一下:RwLock 同一时间只允许一个写线程,或者多个读线程持有锁。
提速从哪里来
可能的提速,并不是因为 RwLock 是一把神奇的、更快的锁,而是因为原本可以并行的工作,终于能并行执行了。
假设一个读多写少的工作负载有 8 个线程:
text
Mutex

Reader 1 ────────┐
Reader 2 ── wait ┤
Reader 3 ── wait ┤
Reader 4 ── wait ┤
Reader 5 ── wait ┤
Reader 6 ── wait ┤
Reader 7 ── wait ┤
Reader 8 ── wait ┘
尽管这 8 个线程都只需要读取同一份数据,Mutex 仍然只允许其中一个线程进入临界区。
换成 RwLock:
text
Reader 1 ─────────────
Reader 2 ─────────────
Reader 3 ─────────────
Reader 4 ─────────────
Reader 5 ─────────────
Reader 6 ─────────────
Reader 7 ─────────────
Reader 8 ─────────────
         │
       RwLock
         │
    Shared Data
多个读线程就可以同时推进工作。
也就是说,原本是:
text
R → R → R → R现在可以是:
text
R
R   } running concurrently
R
R
随着并发增加,这个区别就变得重要了。
使用 Mutex 时,读线程越多,锁竞争可能越严重,因为每个线程都得等待独占访问。使用 RwLock 时,读线程可以并发执行,这对读多写少的工作负载可能很有帮助。
不过,并发也有代价,并发更多,不代表性能一定更好。
RwLock 自身也有同步开销。如果写操作频繁,或者临界区非常短,它的优势就可能消失。
部分原因是:以标准库基于 futex 的实现为例,读线程虽然不会修改共享数据,但获取读锁时,仍然需要更新锁内部用于记录当前持锁读线程数量的计数。这个计数保存在锁的共享状态中,每个读线程获取和释放锁时都会更新它。多个核心同时做这件事,就需要付出同步这个计数器的成本。如果读取操作非常短,这种协调的开销最终可能比读取本身还大。
所以,目标不是把每个 Mutex 都换成 RwLock。
我们需要弄清楚:什么时候,并发读取带来的收益值得付出这些代价?
接下来就有意思了:有些情况下,选择 RwLock 反而不合适。
什么时候不该用 RwLock
大多数介绍 RwLock 的文章,都在说什么时候应该用它。
我们看看另一面:什么时候应该继续用 Mutex?
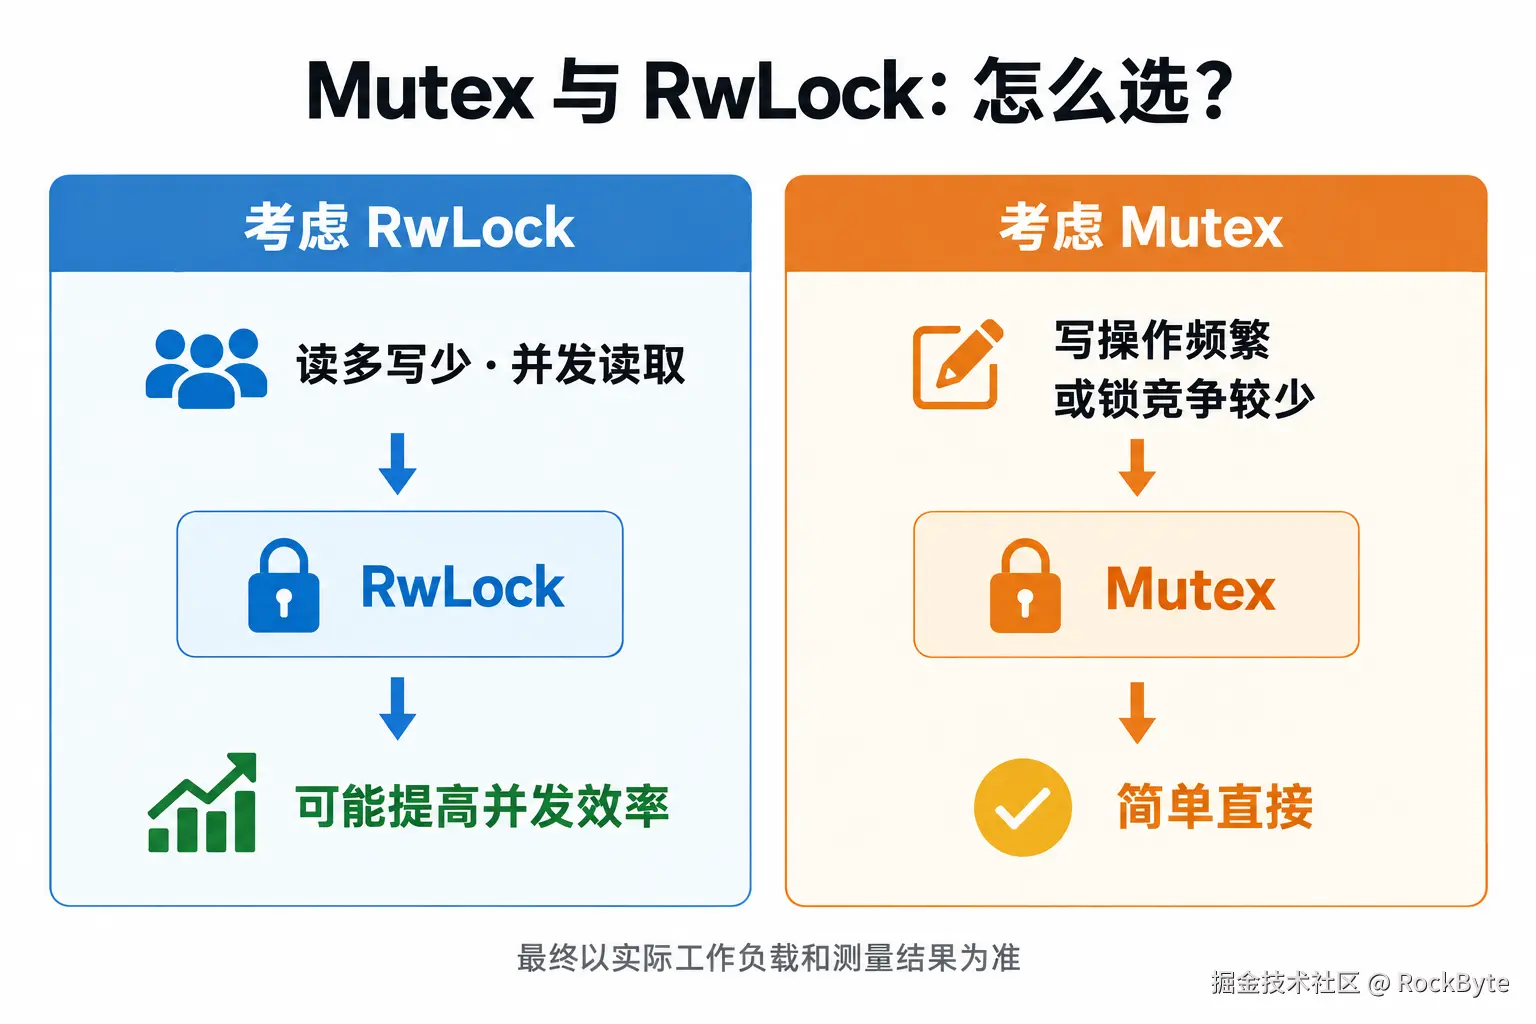
当读取次数远多于写入次数时,RwLock 更容易发挥优势。但离开这个适用范围,它的优势可能很快就消失了。
写操作频繁
如果共享数据经常被修改,读线程和写线程就会不断争夺访问权。
text
READ → WRITE → READ → WRITE → READ → WRITE这种情况下,允许多个读线程同时访问,并不能带来多少收益。Mutex 更简单,也可能更高效。
临界区非常短
如果被保护的操作很短,线程几乎不花什么时间持有锁,RwLock 就没那么有吸引力了。
比如,线程只做一次很小的读取,马上就释放锁,那么多个读线程并发执行,可能也很难带来明显收益。
此时,更简单的 Mutex 可能是更好的选择,尤其是在锁竞争本来就不严重的情况下。
临界区越短、锁竞争越少,RwLock 能优化的空间就越小。
锁竞争很少
如果只有少数线程偶尔访问数据,可能根本没有值得解决的锁竞争。
此时使用 RwLock,可能只是增加了复杂度,却没有带来可测量的收益。
提醒一下:选择这两种锁之前,可以先考虑能否重新设计共享状态,减少锁竞争,甚至避开锁。例如,使用原子操作、分片、不可变数据或消息传递。
这里不是想说 Mutex 比 RwLock 好,也不是说 RwLock 比 Mutex 好。选哪个,取决于你的工作负载。
一点想法
Mutex 并不差。可能对于大多数开发者来讲,很多时候它就是你需要的工具。
问题在于:有些工作负载并不需要独占访问,我们却仍然让它们独占访问。
如果多个线程一直在读取共享数据,却让每个读线程都等待其他读线程,就可能无谓地限制并发。
这时,RwLock 能帮上忙:多个读线程可以同时推进工作,而写操作仍然保持独占。
但 RwLock 并不是 Mutex 的通用替代品。
还是要看看你的工作负载:
这篇文章,并不是告诉你"用 RwLock 替代 Mutex"。
而是:
根据数据实际的访问方式,选择同步方式。
有时候,最大的性能提升,并不来自让锁本身变快。而是来自发现:这些工作原本就不需要串行执行。
哦,对了,如果能避开共享状态和锁竞争,还有可能更快,不过那就需要重新考虑数据的组织方式了。