保单识别在工程上比发票难,主要难在输入不收敛。同一类业务单证,你会同时收到三种东西:
- 原生PDF------有文本层,但字段排版是"视觉排版",不是结构化的;
- 扫描版PDF------整页是一张图,必须走图像通道;
- 纸质拍照------透视畸变、反光、印章压字、局部褶皱。
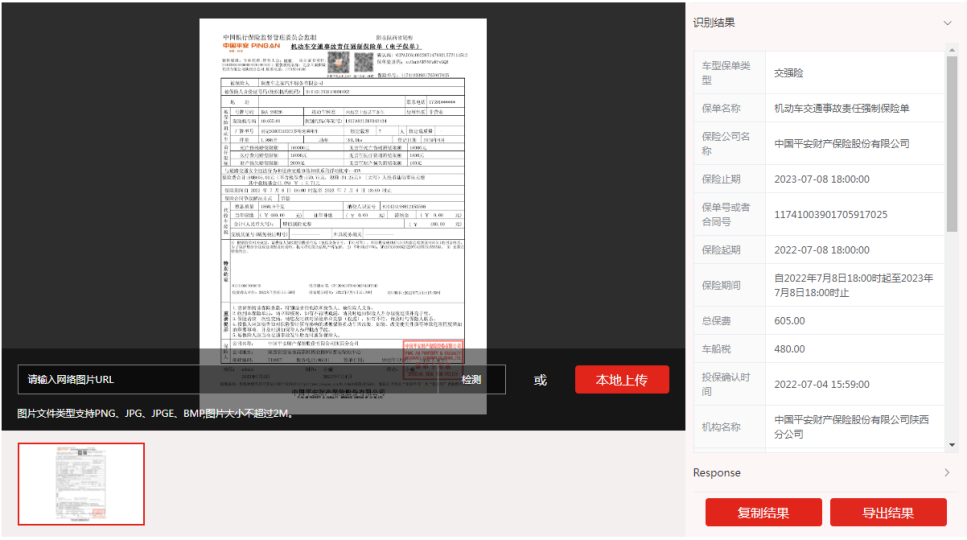
一、输 标题入分流
第一步不是识别,是判型 。原生PDF直接解析文本层,效率高、无误差;扫描版PDF按图像模式处理;拍照件先做清晰度检测,不合格的直接返回重拍提示,避免把脏数据送进流水线。据快瞳科技官方说明,其保单OCR针对电子PDF做了专项适配,区分原生PDF与扫描版PDF两条通道,以保证字段提取完整性。
判型的价值在于成本控制:文本层解析的成本远低于图像推理,能走文本通道的绝不送去跑模型。工程上一条常见的经验是,把清晰度不足的拍照件在入口就拦掉,比让它跑完全流程再失败要划算得多。
二、字段结构化输出
保单的输出不是平铺字段,而是有层级的 :保单基础信息(保司、保单号、交费方式、总保费、生效日期、币种)→ 投保人组(姓名、性别、出生日期、证件号)→ 被保人组 → 受益人组(顺位、生存/身故受益人)→ 险种组(险种名称、基本保额、期交保费、交费期间、保障期间)。险种是数组结构,一张保单可能挂4--5个险种,这是建模时最容易踩坑的地方。
另一个容易被忽略的点是多单合并:同一投保人在同一批次里可能提交多张保单(比如车险与驾意险一起投保),输出时需要保留单据间关联,而不是当成互不相干的记录。
三、语义校验(真正的工程量所在)
识别准确率再高,业务也不敢直接放行,因为字段之间有约束关系:
- 金额类:大小写金额一致性、期交保费与保额的比例合理性;
- 时间类:交费期间起止日与保障期间的先后关系、保单生效日不能晚于当前日期;
- 结构类:受益人为法定继承人时,顺位字段的处理规则。
参考快瞳科技的做法是内置保险业务语义与规则校验,自动标记金额合计不符、日期冲突等矛盾项,再配合置信度评分做分流------高于阈值进业务系统,低于阈值转人工复核。
四、性能与并发
单张保单识别<1 秒,支持批量上传与异步队列处理。常规清晰样本关键字段识别率≥99.5%,光照不均/倾斜/模糊等异常样本≥95%(官方披露)。这个95%才是工程上真正要面对的分布,因为生产环境的照片大部分不清晰。
批量场景下更需要注意的是队列背压:月底出单高峰的单量可能是平峰的几倍,异步队列要能按优先级调度,并对外提供任务进度查询,否则业务侧无法判断"到底还要等多久"。
五、接入形态怎么选
| 形态 | 适用场景 | 注意点 |
|---|---|---|
| 公有云API | 业务系统在线、单证实时流转 | 需处理网络抖动与重试 |
| 离线SDK(Android / iOS) | 移动端采集、弱网环境 | 包体积与芯片适配 |
| 私有化部署 | 数据不出内网、金融合规要求 | 需评估服务器资源 |
| 软硬一体(CPU / GPU) | 信创环境、开箱即用 | 按吞吐量选配置 |
六、上线后常见的三类问题
线上跑起来之后,问题往往不来自模型本身。第一类是新保司版式,市面上总会出现没见过的保单版式,需要保留兜底策略与人工复核通道;第二类是图像质量突变,比如换了新的一批扫描设备,采集质量分布整体下移,此时95%那条线会被击穿,需要监控告警;第三类是业务规则变更,险种或字段口径调整后,校验规则要跟着更新,否则会出现"识别对了但校验误杀"。
一句话总结:保单OCR的工程量,20%在识别,80%在"识别错了怎么办"。