接着上一篇的聊天模型,这里继续完成聊天模型调用工具的讲解说明。
工具调用根本作用是让大语言模型(LLM)具备与外部世界交互的能力。
LLM 本身是一个封闭的知识系统,其能力受限于其训练数据(存在滞后性)和内在的文本生成逻辑。它无法执行直接计算、查询实时信息、操作数据库或调用任何外部 API。工具调用打破了这层壁垒,其作用具体体现在:
- 扩展能力边界:模型可以借助工具完成它自身无法完成的任务,如执行数学计算、搜索网络、查询数据库等。
- 保证信息实时性:通过调用搜索工具或数据库查询工具,LLM 可以获取最新的、训练数据中不存在的信息,避免回答过时或 "一本正经地胡说八道"。
- 处理复杂任务:将一个复杂的用户请求(如 "分析我上个月的消费趋势")分解成多个步骤,并依次调用不同的工具(如 "从数据库获取数据" -> "用 Python 进行数据分析" -> "生成图表")来协同完成。协调这件事这更体现在 Agent 智能体上。
- 连接现有系统:可以将企业内部已有的系统、API 和数据库封装成工具,让 LLM 成为一个用自然语言驱动的统一接口,极大地提升了自动化和集成能力。
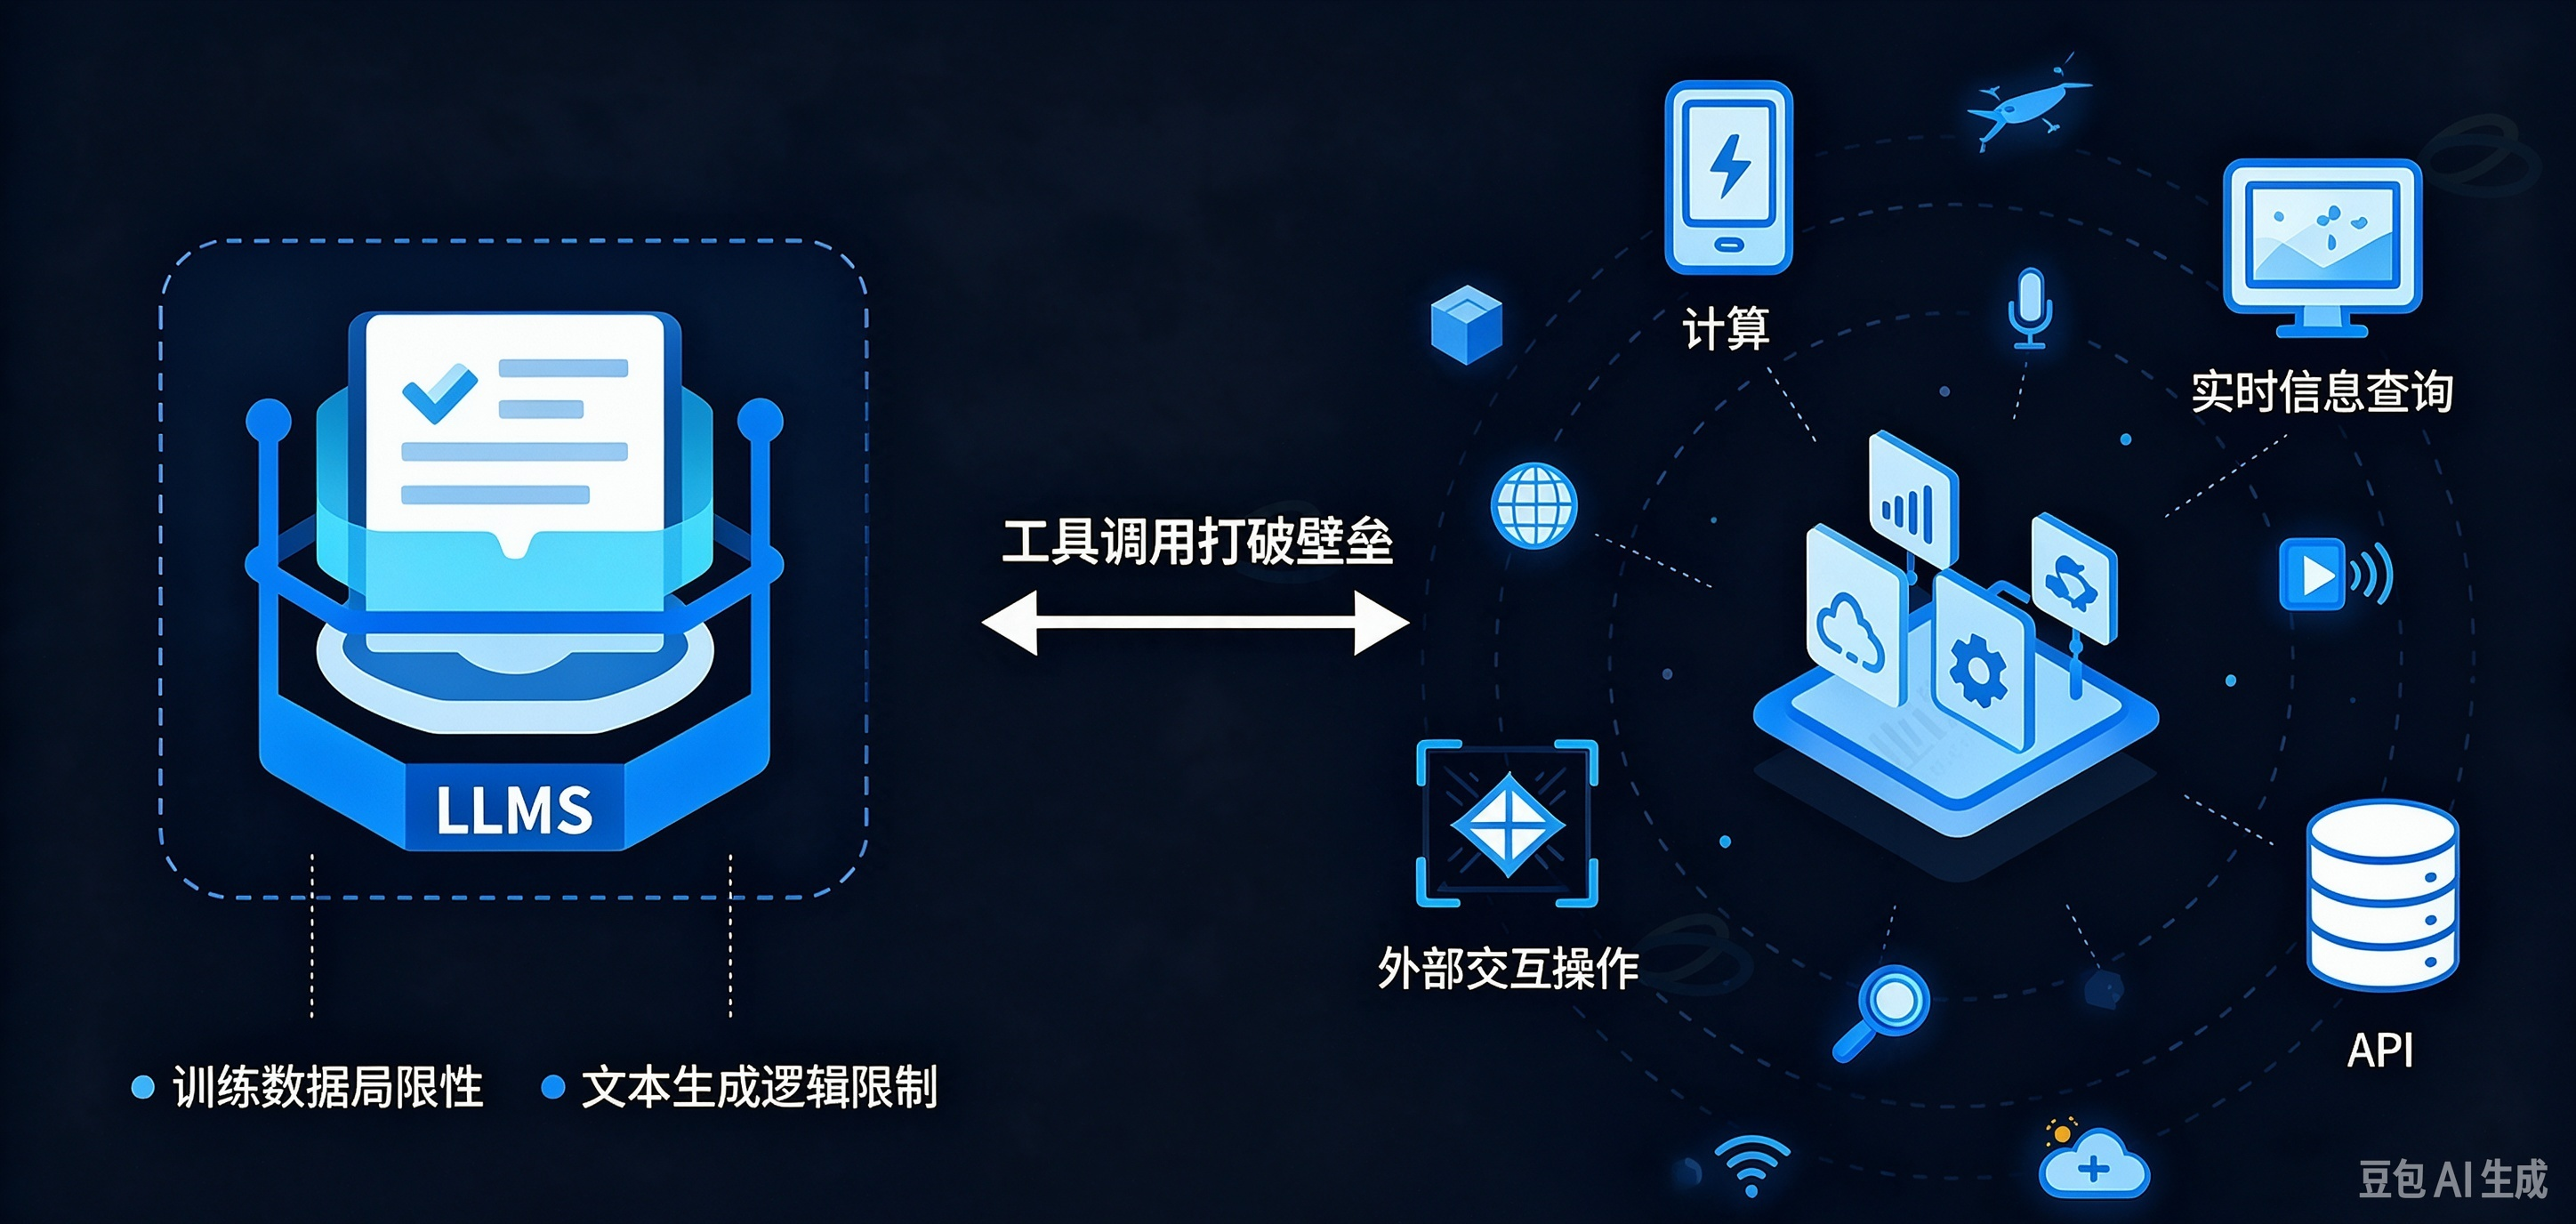
在 LangChain 中,聊天模型提供了额外的功能:工具调用。它能使 LLM 与外部服务、API 和数据库进行交互。工具调用还可用于从非结构化数据中提取结构化信息并执行各种其他任务。
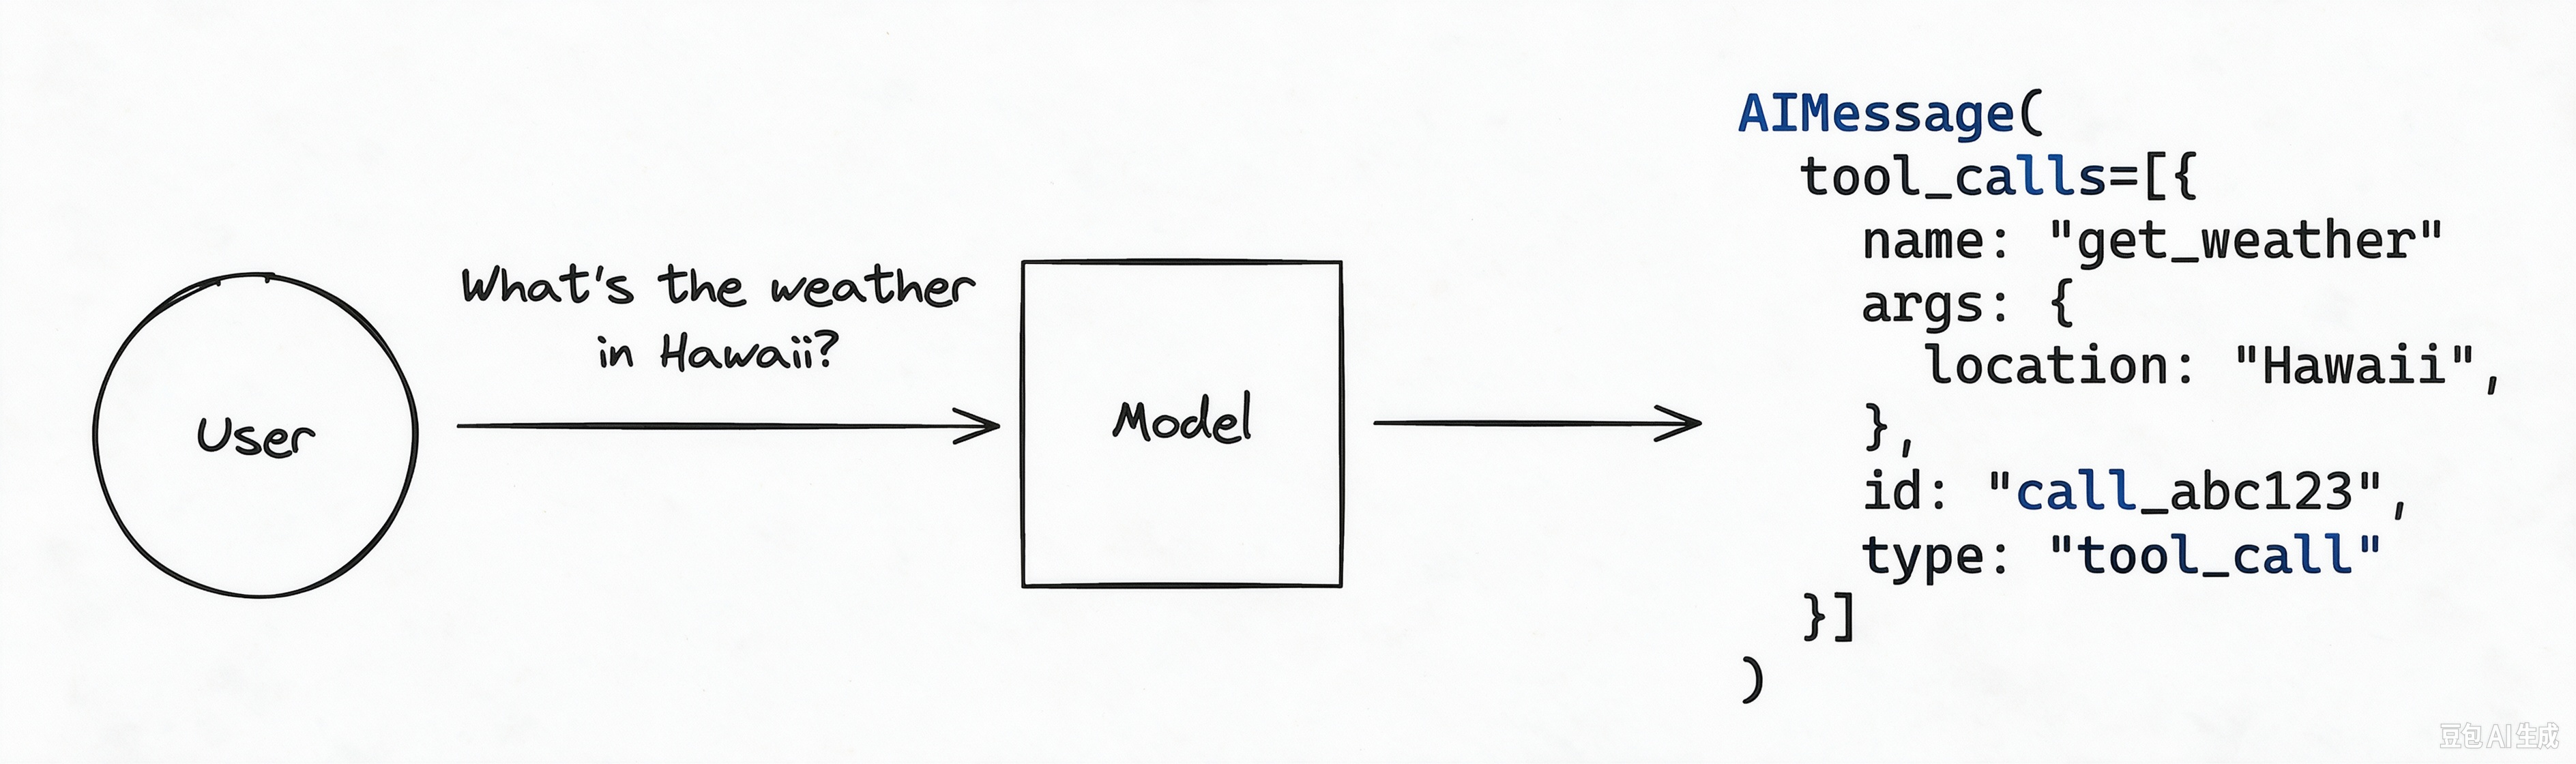
例如,当我们希望获取当前天气情况时,由于 LLM 无法获取实时信息,此时我们就可以借助工具,通过外部服务进行搜索完成查询;
再例如,当我们希望获取数据库表中的数据时,由于 LLM 无法直接获取表数据,此时我们就可以借助工具,通过与数据库交互完成查询。
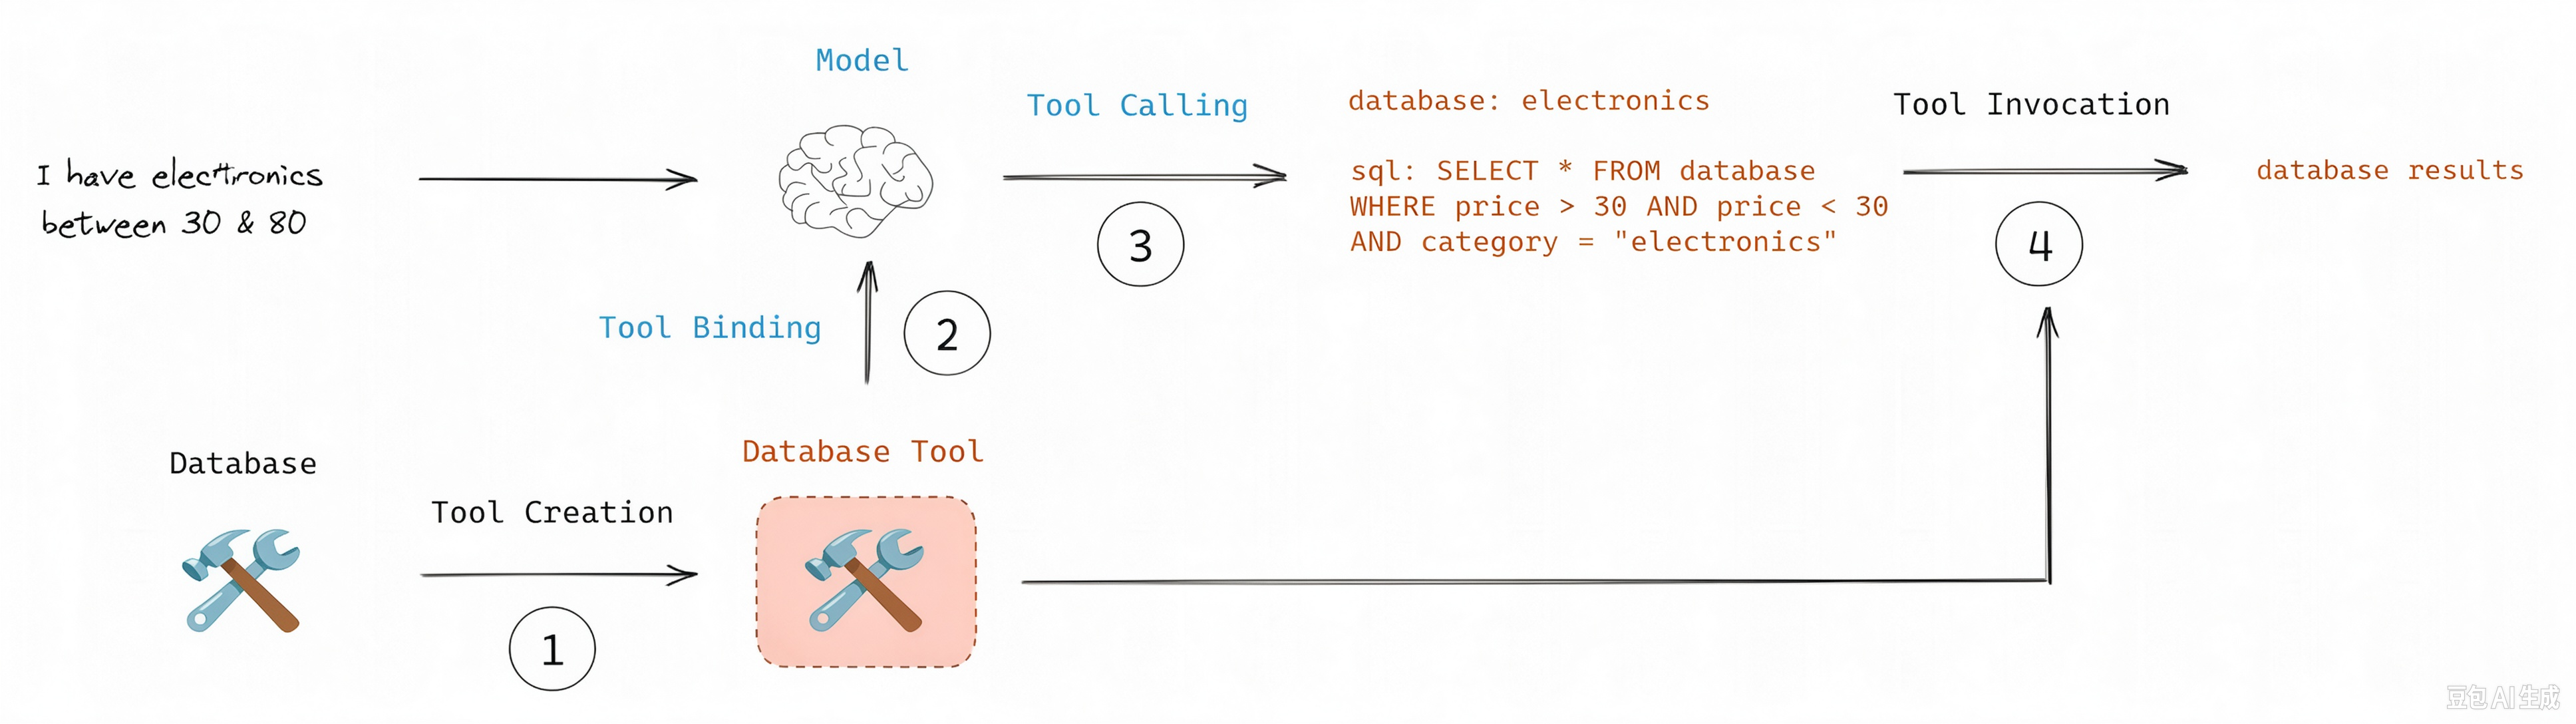
1. 创建工具
1.1 使用 @tool 装饰器创建工具
在 LangChain 中,实现了一个 @tool 装饰器来创建工具,@tool 装饰器是自定义工具的最简单方法。如下所示:
python
from langchain_core.tools import tool
@tool
def multiply(a: int, b: int) -> int:
    """Multiply two integers.
    Args:
        a: First integer
        b: Second integer
    """
return a * b

print(multiply.invoke({"a": 2, "b": 3})) # 输出:6
print(multiply.name) # 输出:multiply
print(multiply.description) # 输出:Multiply two ...省略...b: Second integer
print(multiply.args) # 输出:{'a': {'title': 'A', 'type': 'integer'}, 'b': {'title': 'B', 'type': 'integer'}}
可以看出,工具通过 @tool 加 Python 函数 实现,其中:
- 该装饰器默认使用函数名称作为工具名称。
- 该装饰器将使用函数的文档字符串作为工具的描述。
因此,函数名、类型提示和文档字符串都是传递给工具 Schema 的一部分,不可缺失。定义好的描述是使模型良好运行的重要部分。
什么是 Schema?
答:想象以不同的方式,在 JSON 中表示有关一个人的信息:
示例 1:
python
{
    "name": "张小红",
    "birthday": "1732年2月22日",
    "address": "陕西省西安市雁塔区"
}
示例 2:
python
{
    "surname": "王",
    "given_name": "刚",
    "birthday": "1732-02-22",
    "address": {
        "district": "萧山区",
        "city": "杭州市",
        "province": "浙江省",
        "country": "中国"
    }
}
这两种表述同样有效,尽管示例 2 显然比示例 1 更正式。记录的设计在很大程度上取决于其在应用程序中的预期用途,因此这里没有正确或错误的答案。
但是,当应用程序说 "给我一个人的 JSON 记录" 时,重要的是要确切地知道该如何组织记录。例如,我们需要知道需要哪些字段,以及如何表示这些值。这就是 JSON Schema 的用武之地。
你可能见过这种可视化配置方式,实际上是在构造 JSON Schema:
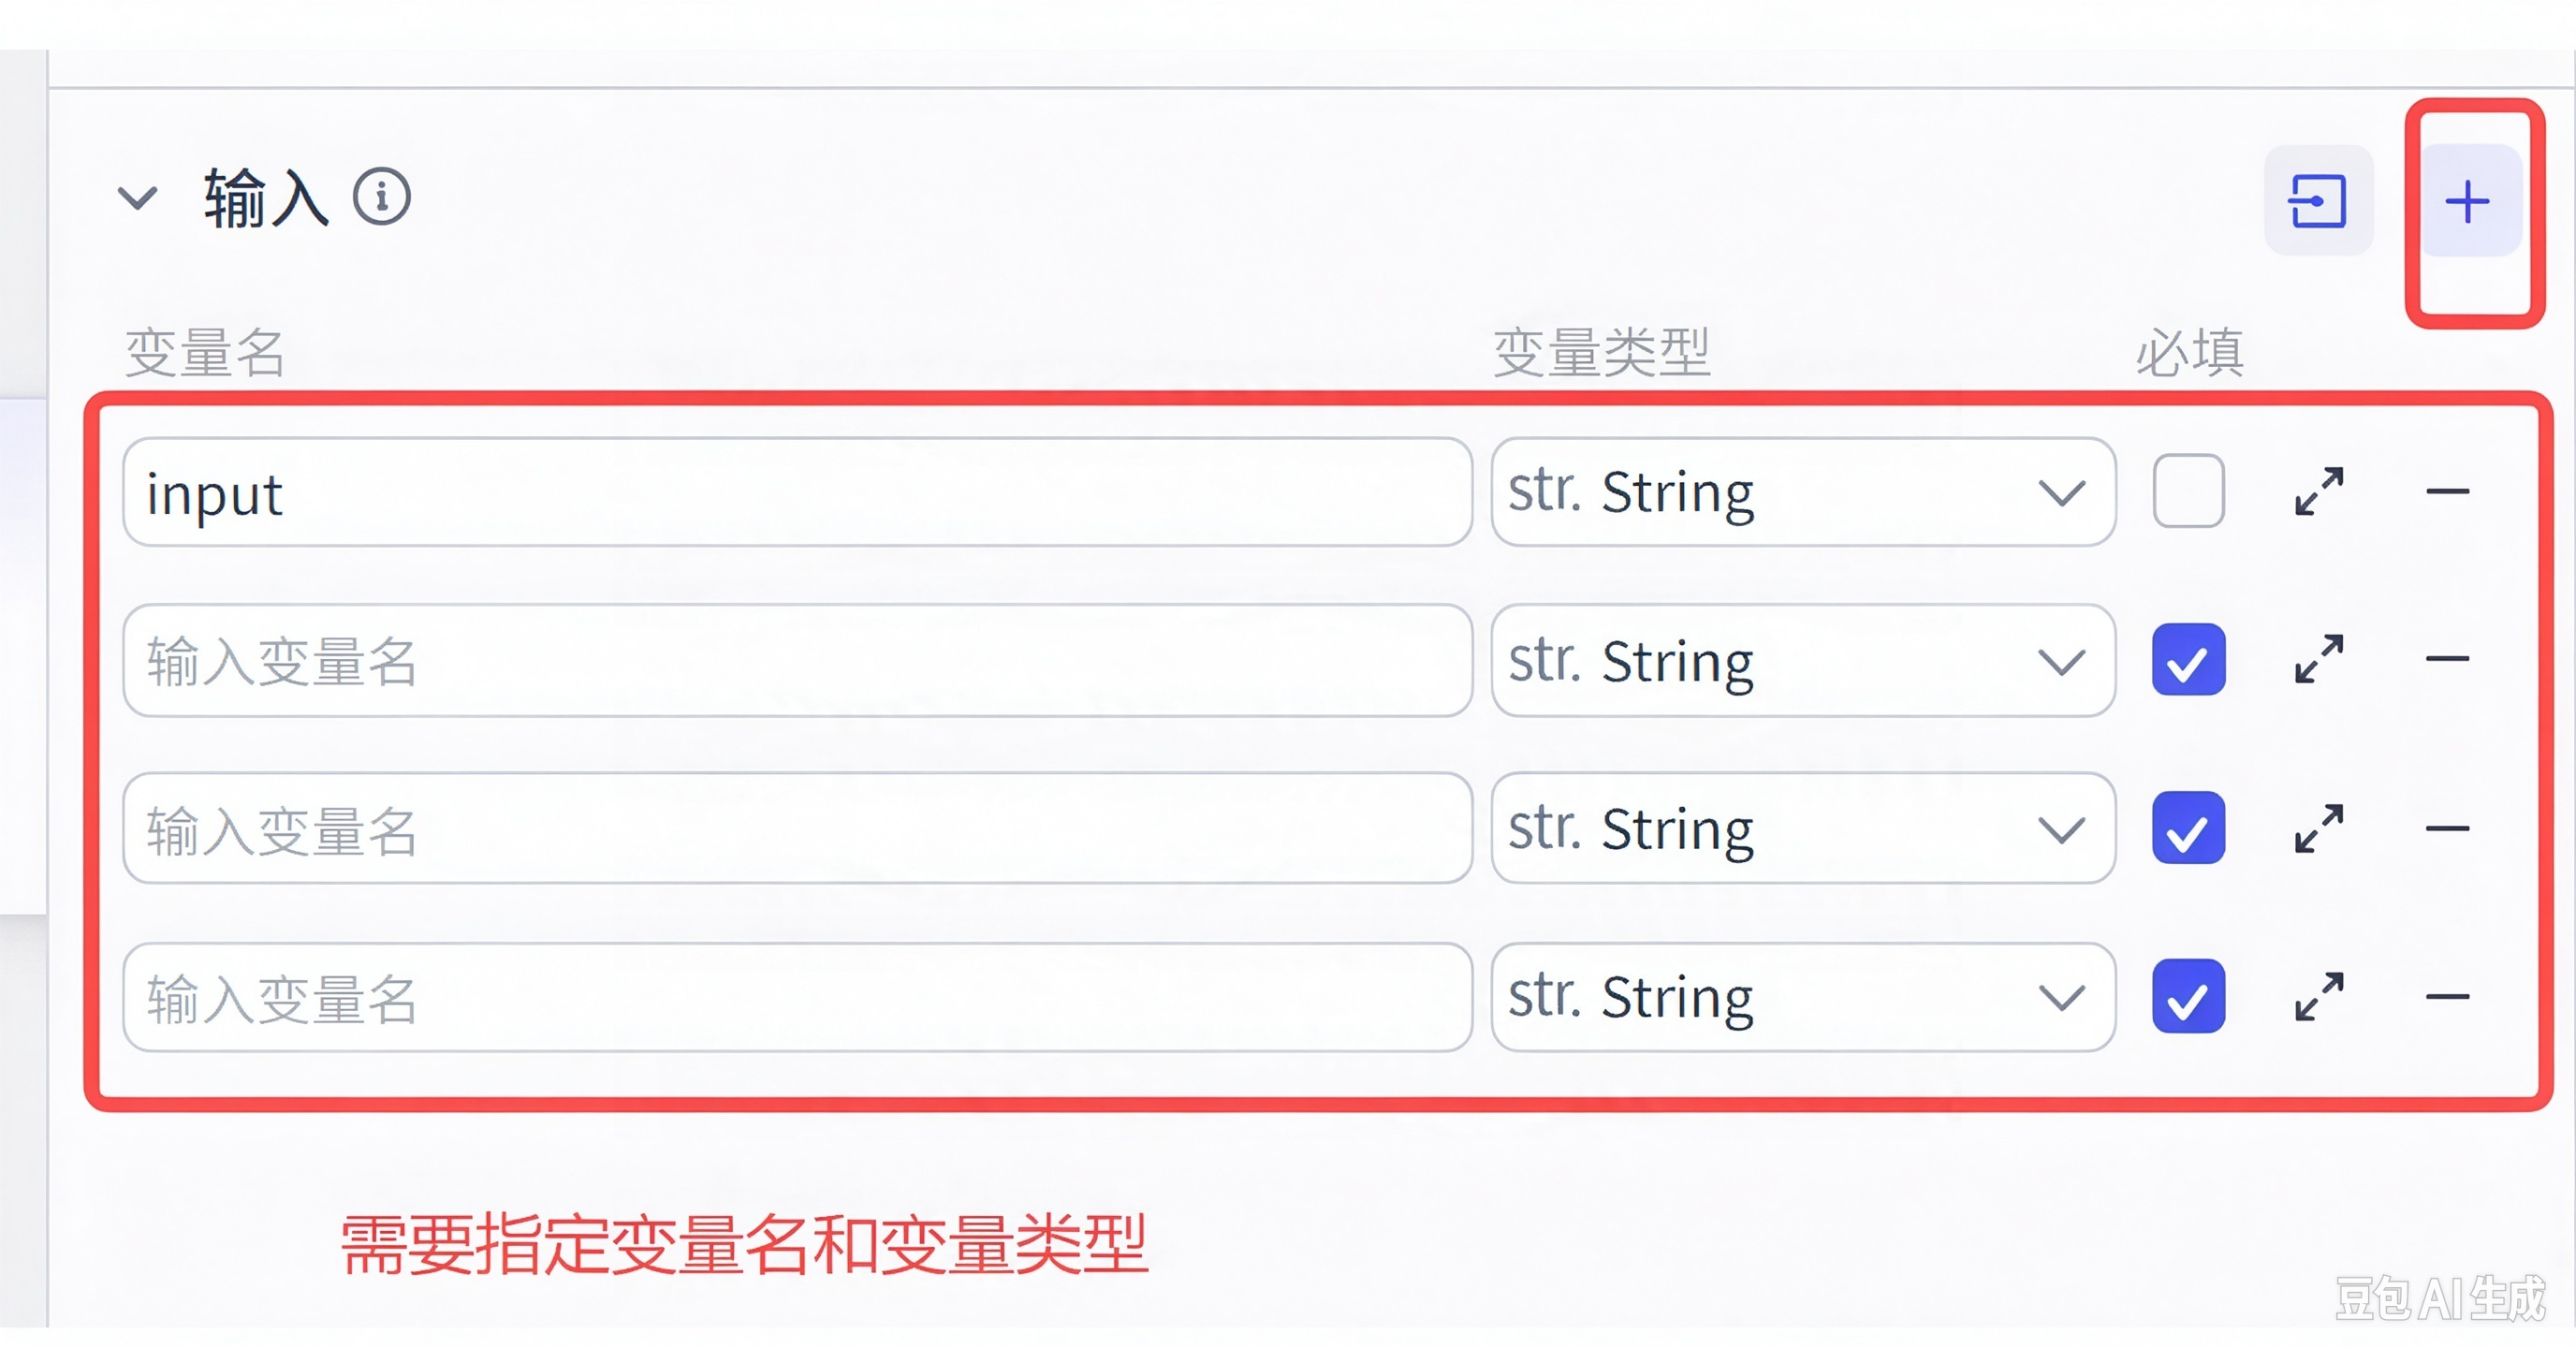
转换成编码方式,则为以下内容(此 JSON Schema 片段描述了上述第二个示例的结构):
python
{
    "type": "object",
    "properties": {
        "surname": { "type": "string" },
        "given_name": { "type": "string" },
        "birthday": { "type": "string", "format": "date" },
        "address": {
            "type": "object",
            "properties": {
                "district": { "type": "string" },
                "city": { "type": "string" },
                "province": { "type": "string" },
                "country": { "type" : "string" }
            }
        }
    }
}
若用此 JSON Schema "验证" 示例 1,那么示例 1 是不符合当前 JSON Schema 的,但是示例 2 可以 "验证" 通过。
注意,JSON Schema 是数据本身,而不是计算机程序,它只是一种 "描述其他数据结构" 的声明格式。简明扼要地描述数据的表面结构,并根据数据自动验证数据很容易。但是,由于 JSON Schema 不能包含任意代码,因此无法表达数据元素之间的关系存在某些约束。
因此,对于足够复杂的数据格式,任何 "验证工具" 都可能有两个验证阶段:一个在 schema(或结构)级别,一个在语义级别。后一种检查可能需要使用更通用的编程语言来实现。
最后回答一下问题,Schema 就是描述其他数据结构的声明格式,用于自动验证数据而存在。
有了以上概念铺垫,对于工具 schema,它将从函数名、类型提示 和文档字符串 中获取相关属性,以此来声明一个工具,包括其名称、描述、输入参数、输出类型等等。这里需要说明的是,若是简单定义工具,如上述示例,工具 schema 需要解析 Google 风格的文档字符串去获取【参数描述】。
什么是 Google 风格的文档字符串?Google 风格是 Python 文档字符串的一种写作规范。它并非 Python 语言官方强制要求,而是由 Google 为其内部 Python 项目制定的规范,后来因为其极高的可读性和简洁性而在整个 Python 社区中变得非常流行。它使用 Args: , Returns: 等关键字,参数描述简洁明了,如下所示:
python
def fetch_data(url, retries=3):
    """从给定的URL获取数据。
    Args:
        url (str): 要从中获取数据的URL。
        retries (int, optional): 失败时重试的次数。默认为3。
    Returns:
        dict: 从URL解析的JSON响应。
    """
# ... 函数实现 ...
除了这种方式,还有其他方式可以让工具 schema,获取相关工具声明需要的内容。下面再展示其他常用的工具定义模式:
1.1.1 模式 1:依赖 Pydantic 类
若使用 @tool 定义工具时,没有提供文档字符串,则会报错:
python
from langchain_core.tools import tool
@tool
def add(a: int, b: int) -> int:
    return a + b
@tool
def multiply(a: int, b: int) -> int:
    return a * b
点击运行,报错: ValueError: Function must have a docstring if description not provided.
此时,在 LangChain 中,可以使用 Pydantic 类,提供运行时数据验证和类型检查。通过 Field(description="...") 添加字段描述,LangChain 会自动提取。 注意,除非提供默认值,否则所有字段都是 required。如下所示:
python
from pydantic import BaseModel, Field
class AddInput(BaseModel):
    """Add two integers."""
    a: int = Field(..., description="First integer")
    b: int = Field(..., description="Second integer")

class MultiplyInput(BaseModel):
    """Multiply two integers."""
    a: int = Field(..., description="First integer")
    b: int = Field(..., description="Second integer")
完整代码如下:
python
# pydantic 数据验证
from pydantic import BaseModel, Field
class AddInput(BaseModel):
    """Add two integers."""
    a: int = Field(..., description="First integer")
    b: int = Field(..., description="Second integer")

class MultiplyInput(BaseModel):
    """Multiply two integers."""
    a: int = Field(..., description="First integer")
    b: int = Field(..., description="Second integer")

# 定义工具
from langchain_core.tools import tool
@tool(args_schema=AddInput)
def add(a: int, b: int) -> int:
    # 未提供描述
    return a + b

@tool(args_schema=MultiplyInput)
def multiply(a: int, b: int) -> int:
    # 未提供描述
    return a * b
注意是代码中 @tool 的 args_schema 参数,它表示工具函数在未提供描述、文档字符串等需要传递给工具 Schema 的内容时,依赖 Pydantic 类使用 args_schema 参数,定义并提供工具输入参数的 schema。默认为 None。
点击运行,不会报错,且将来运行时会进行数据验证。因此,我们再次印证了函数名、类型提示和文档字符串都是传递给工具 Schema 的一部分,不可缺失。
1.1.2 模式 2:依赖 Annotated
在 LangChain 中,可以依赖 Annotated 和文档字符串传递给工具 Schema 。如下所示:
python
from langchain_core.tools import tool
from typing_extensions import Annotated

@tool
def add(
    a: Annotated[int, ..., "First integer"],
    b: Annotated[int, ..., "Second integer"]
) -> int:
    """Add two integers."""
    return a + b

@tool
def multiply(
    a: Annotated[int, ..., "First integer"],
    b: Annotated[int, ..., "Second integer"]
) -> int:
    """Multiply two integers."""
    return a * b
1.2 使用 StructuredTool 类提供的函数创建工具
class langchain_core.tools.structured.StructuredTool 类用来初始化工具,其中 from_function 类方法通过给定的函数来创建并返回一个工具。 from_function 类方法定义如下:
python
classmethod from_function(
    func: Callable | None = None,
    coroutine: Callable[[...], Awaitable[Any]] | None = None,
    name: str | None = None,
    description: str | None = None,
    return_direct: bool = False,
    args_schema: type[BaseModel] | dict[str, Any] | None = None,
    infer_schema: bool = True,
    *,
    response_format: Literal['content', 'content_and_artifact'] = 'content',
    parse_docstring: bool = False,
    error_on_invalid_docstring: bool = False,
    **kwargs: Any,
) → StructuredTool
关键参数说明:
func:要设置的工具函数coroutine:协程函数,要设置的异步工具函数name:工具名称。默认为函数名称。description:工具描述。默认为函数文档字符串。args_schema:工具输入参数的 schema。默认为 None。response_format:工具响应格式。默认为 "content"。- 如果配置为 "content" ,则工具的输出为 ToolMessage 的 content 属性。
- 对于 HumanMessage 、 AIMessage 已经见过,分别表示 用户消息 和 AI 消息响应 ,对于 ToolMessage ,它表示对应工具角色所发出的消息。
- 如果配置为 "content_and_artifact" ,则输出应是与 ToolMessage 的 content 属性与 artifact 属性相对应的二元组。(用法见下面的示例 3 )
- 如果配置为 "content" ,则工具的输出为 ToolMessage 的 content 属性。
1.2.1 示例 1:常规用法
对于用该类方法创建的工具,同样函数名、类型提示 和文档字符串 也都是传递给工具 Schema 的一部分,不可缺失。
python
from langchain_core.tools import StructuredTool
def multiply(a: int, b: int) -> int:
    """Multiply two numbers."""
    return a * b
calculator_tool = StructuredTool.from_function(func=multiply)
print(calculator_tool.invoke({"a": 2, "b": 3})) # 输出:6
1.2.2 示例 2:加入配置,依赖 Pydantic 类
同样的,让工具函数不提供描述、文档字符串等需要传递给工具 Schema 的内容,如下所示:
python
def multiply(a: int, b: int) -> int:
    return a * b
此时可以:
- 使用 args_schema 参数,依赖 Pydantic 类定义并提供工具输入参数的 schema 属性。
- 使用 description 参数,替代文档字符串中对于工具描述的 schema 属性。
python
from langchain_core.tools import StructuredTool
from pydantic import BaseModel, Field
class CalculatorInput(BaseModel):
    a: int = Field(description="first number")
    b: int = Field(description="second number")

def multiply(a: int, b: int) -> int:
    return a * b

calculator_tool = StructuredTool.from_function(
    func=multiply,
    name="Calculator",
    description="两数相乘",
    args_schema=CalculatorInput,
)
print(calculator_tool.invoke({"a": 2, "b": 3}))         # 输出:6
print(calculator_tool.name)                             # 输出:Calculator
print(calculator_tool.description)                      # 输出:两数相乘
print(calculator_tool.args)                             # 输出:{'a': {'description': 'first number', 'title': 'A', 'type': 'integer'}, 'b': {'description': 'second number', 'title': 'B', 'type': 'integer'}}
1.2.3 示例 3:加入 response_format 配置
如果希望我们的工具区分消息内容(content)和其他工件(artifact),让大模型读取 content,而一些用来构造 content 的原始数据保存下来,若后续有一些记录、分析的步骤,就可以派上用场了,这就是 artifact。artifact 通常需要使用字典 Dict 或列表 List 保存。
接下来举个例子再来理解下。例如我们定义了一个搜索天气的 tool,若使用搜索引擎工具询问 "今天的天气如何?" 时:
- content 可能是: "根据最新搜索结果,今天北京晴,气温在 25°C 到 32°C 之间。建议穿短袖衣物。"
- artifact 可能是某搜索引擎 API 返回的完整 JSON 响应,其中包含多个搜索结果条目、每个条目的标题、链接、摘要、排名等元数据。如下所示:
python
# Artifact 的示例结构
{
    'results': [
    {
        'title': '北京天气预报 - 中国天气网',
        'link': 'https://weather.com.cn/...',
        'snippet': '北京今天白天晴,最高气温32°C,夜间晴,最低气温25°C...'
    },
    {
        'title': '北京实时天气 - Weather.com',
        'link': 'https://www.weather.com/...',
        'snippet': 'Bejing, China Weather. Mostly sunny. High 32C...'
    }
    # ... 更多结果
    ],
    'search_parameters': { ... },
    'search_information': { ... }
}
则对于以上原生数据,无论我们今后做日志记录、分析,或自定义后续的处理都很方便。例如存在以下场景:
- 我们不仅仅想要一个总结性的答案,还想要具体的链接、来源或多个备选答案。
- 工具的 content 输出不符合你的预期,我们想查看原始数据来理解问题出在哪里(是工具解析的问题,还是 API 本身返回的问题)。
- 需要记录每次工具调用的完整原始响应,以满足数据分析的要求。
- ......
从这里就可以对比出只返回 content 无法做到这些事情。
如何做到?
我们需要在定义工具时指定 response_format="content_and_artifact" 参数,并确保我们返回一个元组 (content, artifact),代码如下:
python
from langchain_core.tools import StructuredTool
from pydantic import BaseModel, Field
from typing import List, Tuple

class CalculatorInput(BaseModel):
    a: int = Field(description="first number")
    b: int = Field(description="second number")

def multiply(a: int, b: int) -> Tuple[str, List[int]]:
    nums = [a, b]
    content = f"{nums}相乘的结果是{a * b}"
    return content, nums

calculator_tool = StructuredTool.from_function(
    func=multiply,
    name="Calculator",
    description="两数相乘",
    args_schema=CalculatorInput,
    response_format="content_and_artifact"
)上面的代码中,我们将需要相乘的数据当作原始数据,作为样例。(说明:@tool 也支持 response_format 参数)
如果我们直接使用工具参数调用工具,将只返回输出的 content 部分:
python
print(calculator_tool.invoke({"a": 2, "b": 3})) # 输出:[2, 3]相乘的结果是6若想要看到工具返回的元组,我们需要模拟大模型调用工具的姿势,如下所示。这将返回一个 ToolMessage:
python
print(calculator_tool.invoke(
    {
        "name": "Calculator",
        "args": {"a": 2, "b": 3},
        "id": "123", # 必须,与工具调用关联的标识符,将工具调用请求与工具调用结果相关联。
        "type": "tool_call", # 必须
    }
))
结果如下:
python
# ToolMessage
content='[2, 3]相乘的结果是6' name='Calculator' tool_call_id='123' artifact=[2,3]
小结一下,由于 LLM 大多理解文本,所以工具的主要输出 content 必须是结构良好、简洁的文本,以便模型能够轻松理解和基于它进行推理、生成下一步的指令。
在链(Chain)中,工具调用之后的其他组件或函数,可能需要工具的原始且结构化数据(即 artifact )来执行特定操作。这些数据可能是庞大的、且非文本的。这些数据不适合直接塞给模型。因此, artifact 其实是为了给链中后续的组件或函数使用的,不被大模型所直接使用!!
2. 绑定工具
为了实际将这些工具绑定到聊天模型,可以使用聊天模型的 .bind_tools() 方法。如下所示:
python
from langchain_openai import ChatOpenAI
# 定义大模型
model = ChatOpenAI(model="gpt-4o-mini")
...
# 绑定工具,返回一个 Runnable 实例
tools = [add, multiply]
model_with_tools = model.bind_tools(tools)
bind_tools () 方法定义
python
bind_tools(
    tools: Sequence[dict[str, Any] | type | Callable | BaseTool],
    *,
    tool_choice: dict | str | Literal['auto', 'none', 'required', 'any'] | bool | None = None,
    strict: bool | None = None,
    parallel_tool_calls: bool | None = None,
    **kwargs: Any,
) → Runnable[PromptValue | str | Sequence[BaseMessage | list[str] | tuple[str, str] | str | dict[str, Any]], BaseMessage]
请求参数:
tools:绑定到此聊天模型的工具定义列表。支持的类型为:字典、pydantic.BaseModel 类、Python 函数和 BaseTool(如 @tool 装饰器创建的类)。tool_choice(默认空):要求模型调用哪个工具。可以设置为:- 形式为
'<<tool_name>>'的 str:调用<tool_name>工具。 'auto':自动选择工具(包括无工具)。'none':不调用工具。'any'或'required'或True:强制调用至少一个工具。False或None:无效果,默认 OpenAI 的行为。
- 形式为
strict(默认空):- 如果为
True,则保证模型输出与工具定义中提供的 JSON Schema 完全匹配。输入也将根据提供的 Schema 进行验证。 - 如果为
False,则不会验证输入,也不会验证模型输出。 - 如果为
None,则不会将 strict 参数传递给模型。
- 如果为
parallel_tool_calls:默认为None,允许并行工具使用。设置为False以禁用并行工具。kwargs(Any):任何附加参数都直接传递给bind()。
返回值:
- 返回一个 Runnable 实例。
- 该实例支持多种格式输入:
- 原始提示 PromptValue
- 字符串:
"上海天气如何?" - 消息或消息列表:
[HumanMessage(content="...")]
- 该实例的输出:
- 包含工具调用信息的 AIMessage
- 该实例支持多种格式输入:
3. 工具调用
通过 .bind_tools() 方法我们可知,它返回了一个 Runnable 实例,因此我们可以使用该 Runnable 实例,调用 .invoke() 方法,完成工具调用。示例如下:
python
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage
from langchain_core.tools import tool
from typing_extensions import Annotated

# 定义大模型
model = ChatOpenAI(model="gpt-4o-mini")

@tool
def add(
    a: Annotated[int, ..., "First integer"],
    b: Annotated[int, ..., "Second integer"]
) -> int:
    """Add two integers."""
    return a + b

@tool
def multiply(
    a: Annotated[int, ..., "First integer"],
    b: Annotated[int, ..., "Second integer"]
) -> int:
    """Multiply two integers."""
    return a * b

# 绑定工具
tools = [add, multiply]
model_with_tools = model.bind_tools(tools)

# 调用工具
result = model_with_tools.invoke("9乘6等于多少?")
print(result)
输出结果(AIMessage):
python
content='' additional_kwargs={'tool_calls': [{'id':
'call_mBnxNMY7vfAOrExEETcdEC6l', 'function': {'arguments': '{"a":9,"b":6}',
'name': 'multiply'}, 'type': 'function'}], 'refusal': None} response_metadata=
{'token_usage': {'completion_tokens': 17, 'prompt_tokens': 86, 'total_tokens':
103, 'completion_tokens_details': {'accepted_prediction_tokens': 0,
'audio_tokens': 0, 'reasoning_tokens': 0, 'rejected_prediction_tokens': 0},
'prompt_tokens_details': {'audio_tokens': 0, 'cached_tokens': 0}},
'model_name': 'gpt-4o-mini-2024-07-18', 'system_fingerprint': 'fp_560af6e559',
'id': 'chatcmpl-C6DSvbskJtwUl6YTkPILUaiDdDuEN', 'service_tier': 'default',
'finish_reason': 'tool_calls', 'logprobs': None} id='run--1f43e942-d56b-4d6d-
8d3f-145b7e5d0036-0' tool_calls=[{'name': 'multiply', 'args': {'a': 9, 'b':
6}, 'id': 'call_mBnxNMY7vfAOrExEETcdEC6l', 'type': 'tool_call'}]
usage_metadata={'input_tokens': 86, 'output_tokens': 17, 'total_tokens': 103,
'input_token_details': {'audio': 0, 'cache_read': 0}, 'output_token_details':
{'audio': 0, 'reasoning': 0}}
输出说明:
- AIMessage :来自 AI 的消息。从聊天模型返回,作为对提示(输入)的响应。
- content :消息的内容。
- additional_kwargs :与消息关联的其他有效负载数据。对于来自 AI 的消息,可能包括模型提供程序编码的工具调用。
- response_metadata :响应元数据。例如:响应标头、logprobs、令牌计数、模型名称。
从输出结果看来,AI 给出的响应是进行工具的调用!!
工具调用的一个关键原则是,模型根据输入的相关性决定何时使用工具。模型并不总是需要调用工具。例如,给定一个不相关的输入,模型不会调用该工具:
python
result = model_with_tools.invoke("hello world!")
print(result)
输出结果(AIMessage):
content='Hello! How can I assist you today?' additional_kwargs={'refusal':
None} response_metadata={'token_usage': {'completion_tokens': 10,
'prompt_tokens': 82, 'total_tokens': 92, 'completion_tokens_details':
{'accepted_prediction_tokens': 0, 'audio_tokens': 0, 'reasoning_tokens': 0,
'rejected_prediction_tokens': 0}, 'prompt_tokens_details': {'audio_tokens': 0,
'cached_tokens': 0}}, 'model_name': 'gpt-4o-mini-2024-07-18',
'system_fingerprint': 'fp_560af6e559', 'id': 'chatcmpl-C6AoyFpeJNR27mQjDisMfL6pgIspv', 'service_tier': 'default',
'finish_reason': 'stop', 'logprobs': None} id='run--04776002-b77c-4da1-9f35-966e6b39514e-0'
usage_metadata={'input_tokens': 82, 'output_tokens': 10, 'total_tokens': 92,
'input_token_details': {'audio': 0, 'cache_read': 0}, 'output_token_details':
{'audio': 0, 'reasoning': 0}}
4. 强制模型调用工具
当然我们也可以让模型强制调用工具,那就需要在绑定工具时,设置 tool_choice="any" ,表示强制调用至少一个工具。示例如下:
python
model_with_tools = model.bind_tools(tools, tool_choice="any")
result = model_with_tools.invoke("hello world!")
print(result)
输出结果(AIMessage):
content='' additional_kwargs={'tool_calls': [{'id':
'call_zM7F5zPKzzMbTs2C2VtJdAot', 'function': {'arguments': '{"a":1,"b":2}',
'name': 'add'}, 'type': 'function'}], 'refusal': None} response_metadata=
{'token_usage': {'completion_tokens': 17, 'prompt_tokens': 82, 'total_tokens':
99, 'completion_tokens_details': {'accepted_prediction_tokens': 0,
'audio_tokens': 0, 'reasoning_tokens': 0, 'rejected_prediction_tokens': 0},
'prompt_tokens_details': {'audio_tokens': 0, 'cached_tokens': 0}},
'model_name': 'gpt-4o-mini-2024-07-18', 'system_fingerprint': 'fp_560af6e559',
'id': 'chatcmpl-C6AspZtf11Dhz9EEz9WIkTZcVt1dB', 'service_tier': 'default',
'finish_reason': 'tool_calls', 'logprobs': None} id='run--a3c12acf-dcff-4fc0-
865f-6f5c9c269673-0' tool_calls=[{'name': 'add', 'args': {'a': 1, 'b': 2},
'id': 'call_zM7F5zPKzzMbTs2C2VtJdAot', 'type': 'tool_call'}] usage_metadata=
{'input_tokens': 82, 'output_tokens': 17, 'total_tokens': 99,
'input_token_details': {'audio': 0, 'cache_read': 0}, 'output_token_details':
{'audio': 0, 'reasoning': 0}}
5. 工具属性
现在我们知道,输出结果是一个 AIMessage 。但是,如果调用了工具,则 result 将具有一个 tool_calls 属性。此属性包括执行该工具所需的一切,包括工具名称和输入参数,示例如下:
python
model_with_tools = model.bind_tools(tools, tool_choice="any")
result = model_with_tools.invoke("9乘6等于多少?")
print(result.tool_calls)
输出结果:
[{'name': 'multiply', 'args': {'a': 9, 'b': 6}, 'id':
'call_csFbMmYD4Dmz8yMja3ZWK1QW', 'type': 'tool_call'}]
6. 将工具输出传递给聊天模型
到这里可以发现,我们仅仅只是成功调用了工具,但是聊天模型并没有给我们返回我们真正需要的答案。此时就需要:
- 将工具输出传递给聊天模型,包括 HumanMessage 、 AIMessage (工具调用)、ToolMessage
- 聊天模型根据以上消息输入,将最终结果 AIMessage 返回。
为什么要发 ToolMessage 呢?
之前我们讲过,聊天模型通常不是接受单个字符串作为输入,而是接受 聊天消息(XxxMessage)列表,因此在这里我们需要将工具的返回,构造成 ToolMessage ,再传输给聊天模型!!!
方便的是,如果我们使用 @tool 装饰器创建的工具,使用 tool.invoke(tool_calls) ,将自动返回一个 ToolMessage 。完整示例如下:
python
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage
from langchain_core.tools import tool
from typing_extensions import Annotated

# 定义大模型
model = ChatOpenAI(model="gpt-4o-mini")

# 定义工具
@tool
def add(
    a: Annotated[int, ..., "First integer"],
    b: Annotated[int, ..., "Second integer"]
) -> int:
    """Add two integers."""
    return a + b

@tool
def multiply(
    a: Annotated[int, ..., "First integer"],
    b: Annotated[int, ..., "Second integer"]
) -> int:
    """Multiply two integers."""
    return a * b

# 绑定工具
tools = [add, multiply]
model_with_tools = model.bind_tools(tools)

# 添加AIMessage到消息中去
messages = [
    HumanMessage("9乘6等于多少?5加3等于多少?")
]
ai_msg = model_with_tools.invoke(messages)
messages.append(ai_msg)

for tool_call in ai_msg.tool_calls:
    # 根据工具名选择对应工具函数(不区分大小写)
    selected_tool = {"add": add, "multiply": multiply}[tool_call["name"].lower()]
    # 执行工具调用,返回 ToolMessage
    tool_msg = selected_tool.invoke(tool_call)
    # 将 ToolMessage 加入消息
    messages.append(tool_msg)

print(messages)
result = model.invoke(messages)
print(result)
打印结果如下:
[HumanMessage(content='9乘6等于多少?5加3等于多少?', additional_kwargs={},
response_metadata={}), AIMessage(content='', additional_kwargs={'tool_calls':
[{'id': 'call_tZhIzjEQrLk0GquaKXb6JZMy', 'function': {'arguments': '{"a": 9,
"b": 6}', 'name': 'multiply'}, 'type': 'function'}, {'id':
'call_fesQTvJGD7AiuRi1hnBJ67el', 'function': {'arguments': '{"a": 5, "b": 3}',
'name': 'add'}, 'type': 'function'}], 'refusal': None}, response_metadata=
{'token_usage': {'completion_tokens': 50, 'prompt_tokens': 93, 'total_tokens':
143, 'completion_tokens_details': {'accepted_prediction_tokens': 0,
'audio_tokens': 0, 'reasoning_tokens': 0, 'rejected_prediction_tokens':
0},'prompt_tokens_details': {'audio_tokens': 0, 'cached_tokens': 0}},
'model_name': 'gpt-4o-mini-2024-07-18', 'system_fingerprint': 'fp_560af6e559',
'id': 'chatcmpl-C6DVwdK6M9L2AbqB34ICzL9TY9ECE', 'service_tier': 'default',
'finish_reason': 'tool_calls', 'logprobs': None}, id='run--e8e2e70d-1a74-4023-
b0de-a7df05afe5fe-0', tool_calls=[{'name': 'multiply', 'args': {'a': 9, 'b':
6}, 'id': 'call_tZhIzjEQrLk0GquaKXb6JZMy', 'type': 'tool_call'}, {'name':
'add', 'args': {'a': 5, 'b': 3}, 'id': 'call_fesQTvJGD7AiuRi1hnBJ67el',
'type': 'tool_call'}], usage_metadata={'input_tokens': 93, 'output_tokens':
50, 'total_tokens': 143, 'input_token_details': {'audio': 0, 'cache_read':
0}, 'output_token_details': {'audio': 0, 'reasoning': 0}}),
ToolMessage(content='54', name='multiply',
tool_call_id='call_tZhIzjEQrLk0GquaKXb6JZMy'), ToolMessage(content='8',
name='add', tool_call_id='call_fesQTvJGD7AiuRi1hnBJ67el')]
content='9乘6等于54,5加3等于8。' additional_kwargs={'refusal': None}
response_metadata={'token_usage': {'completion_tokens': 15, 'prompt_tokens':
159, 'total_tokens': 174, 'completion_tokens_details':
{'accepted_prediction_tokens': 0, 'audio_tokens': 0, 'reasoning_tokens': 0,
'rejected_prediction_tokens': 0}, 'prompt_tokens_details': {'audio_tokens': 0,
'cached_tokens': 0}}, 'model_name': 'gpt-4o-mini-2024-07-18',
'system_fingerprint': 'fp_560af6e559', 'id': 'chatcmpl-C6DVyKrbbGZqfDU8ykJMNy9GZVEdJ', 'service_tier': 'default',
'finish_reason': 'stop', 'logprobs': None} id='run--b6ef0591-1ab8-4ce2-abe2-7ec509204fd0-0'
usage_metadata={'input_tokens': 159, 'output_tokens': 15, 'total_tokens': 174,
'input_token_details': {'audio': 0, 'cache_read': 0}, 'output_token_details':
{'audio': 0, 'reasoning': 0}}
从流程与代码中可以看到,实际上我们调用了两次聊天模型:
- 第一次:仅将【 HumanMessage 】发送给聊天模型进行处理,结果返回了【包含工具调用的 AIMessage 】,并没有返回我们想要的结果。然后我们执行工具,得到 ToolMessage 。
- 第二次:将【 HumanMessage + AIMessage + ToolMessage 】消息记录发送给聊天模型进行处理,结果返回了【包含结果的 AIMessage 】
7. LangChain 提供的工具
工具也不是全部都需要我们自己手搓,其实 LangChain 官方也已经给我们提供了很多现成的工具(Tool)和工具包(Toolkit)。
LangChain 提供的工具见官网。写好的工具一般都是为了使用 LangChain 中集成的三方组件或工具而创造的,有搜索、数据库、网页浏览器等相关的工具。
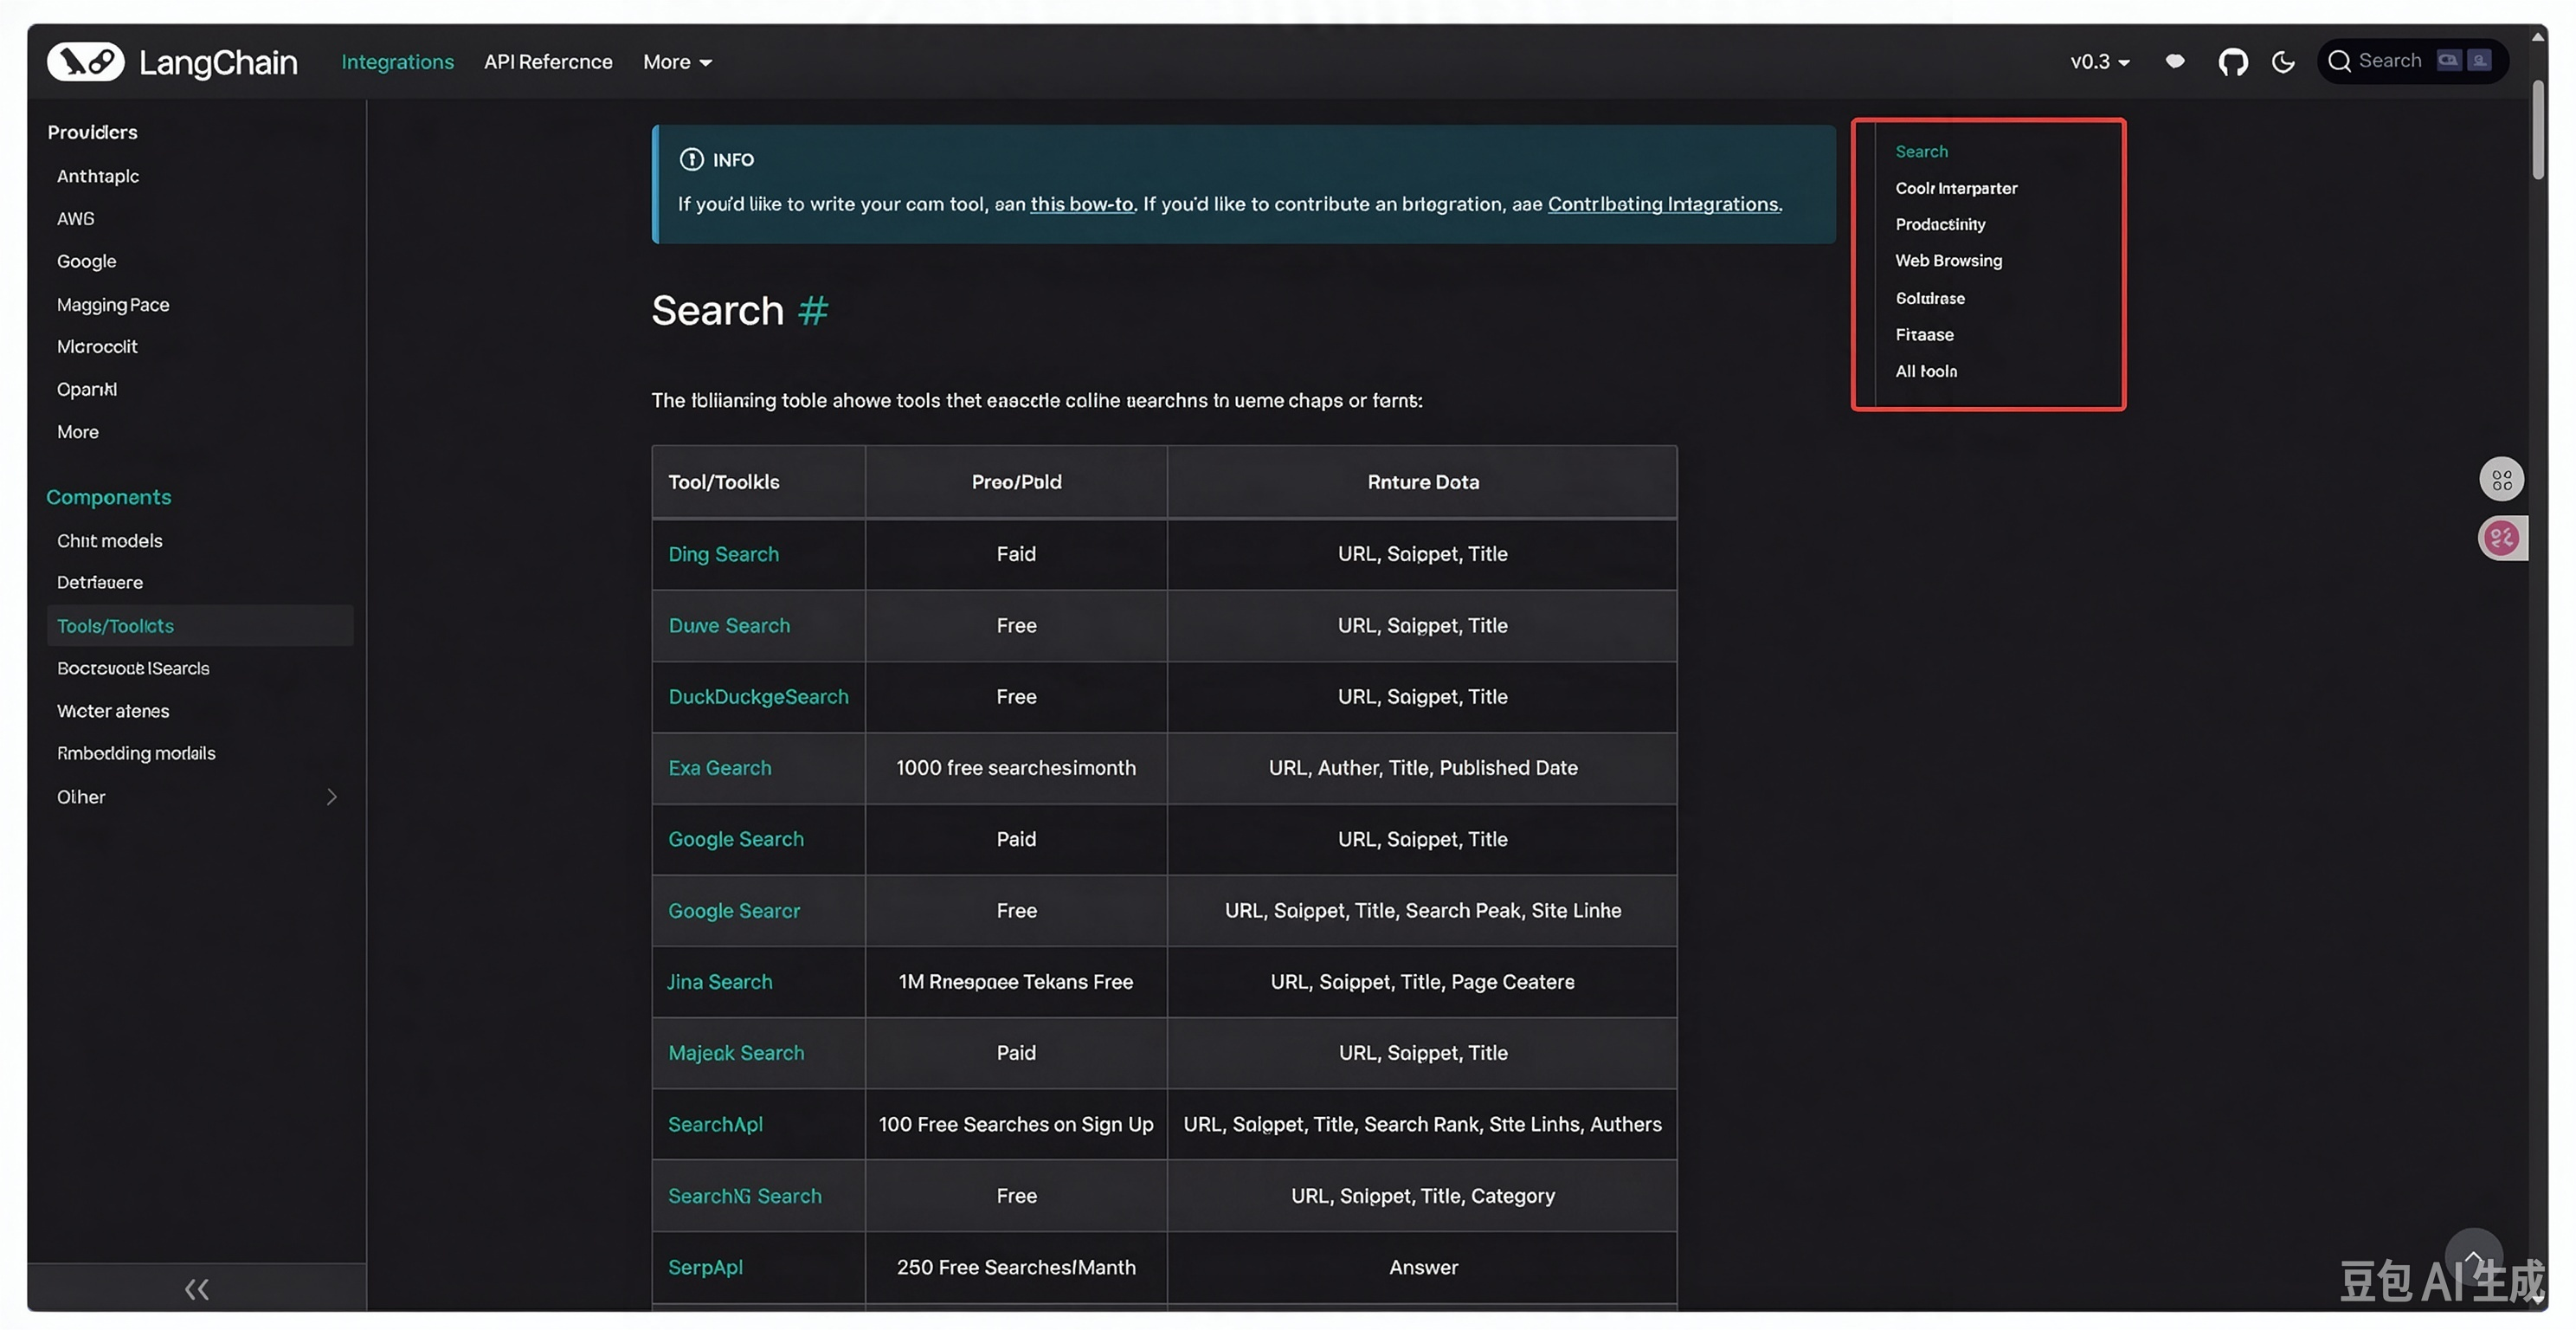
LangChain 中的工具实际上是继承了 BaseTool 与 BaseToolkit 。我们可以从下载的关于 LangChain 包的 Lib 中查看,全局搜索 BaseTool 和 BaseToolkit 。
下面我们简单看一个搜索工具类。
7.1 TavilySearch
TavilySearch 类可以支持我们进行搜索,Tavily 是一个专门为 AI 设计的搜索引擎,专为智能体检索与推理需求量身打造的工具。
Tavily 不仅提供了高度可编程的 API 接口,还具备显著优于传统搜索引擎的上下文相关性理解能力。能够以结构化、可解析的形式返回搜索结果,便于将检索到的信息直接用于后续的推理、生成或任务执行流程。
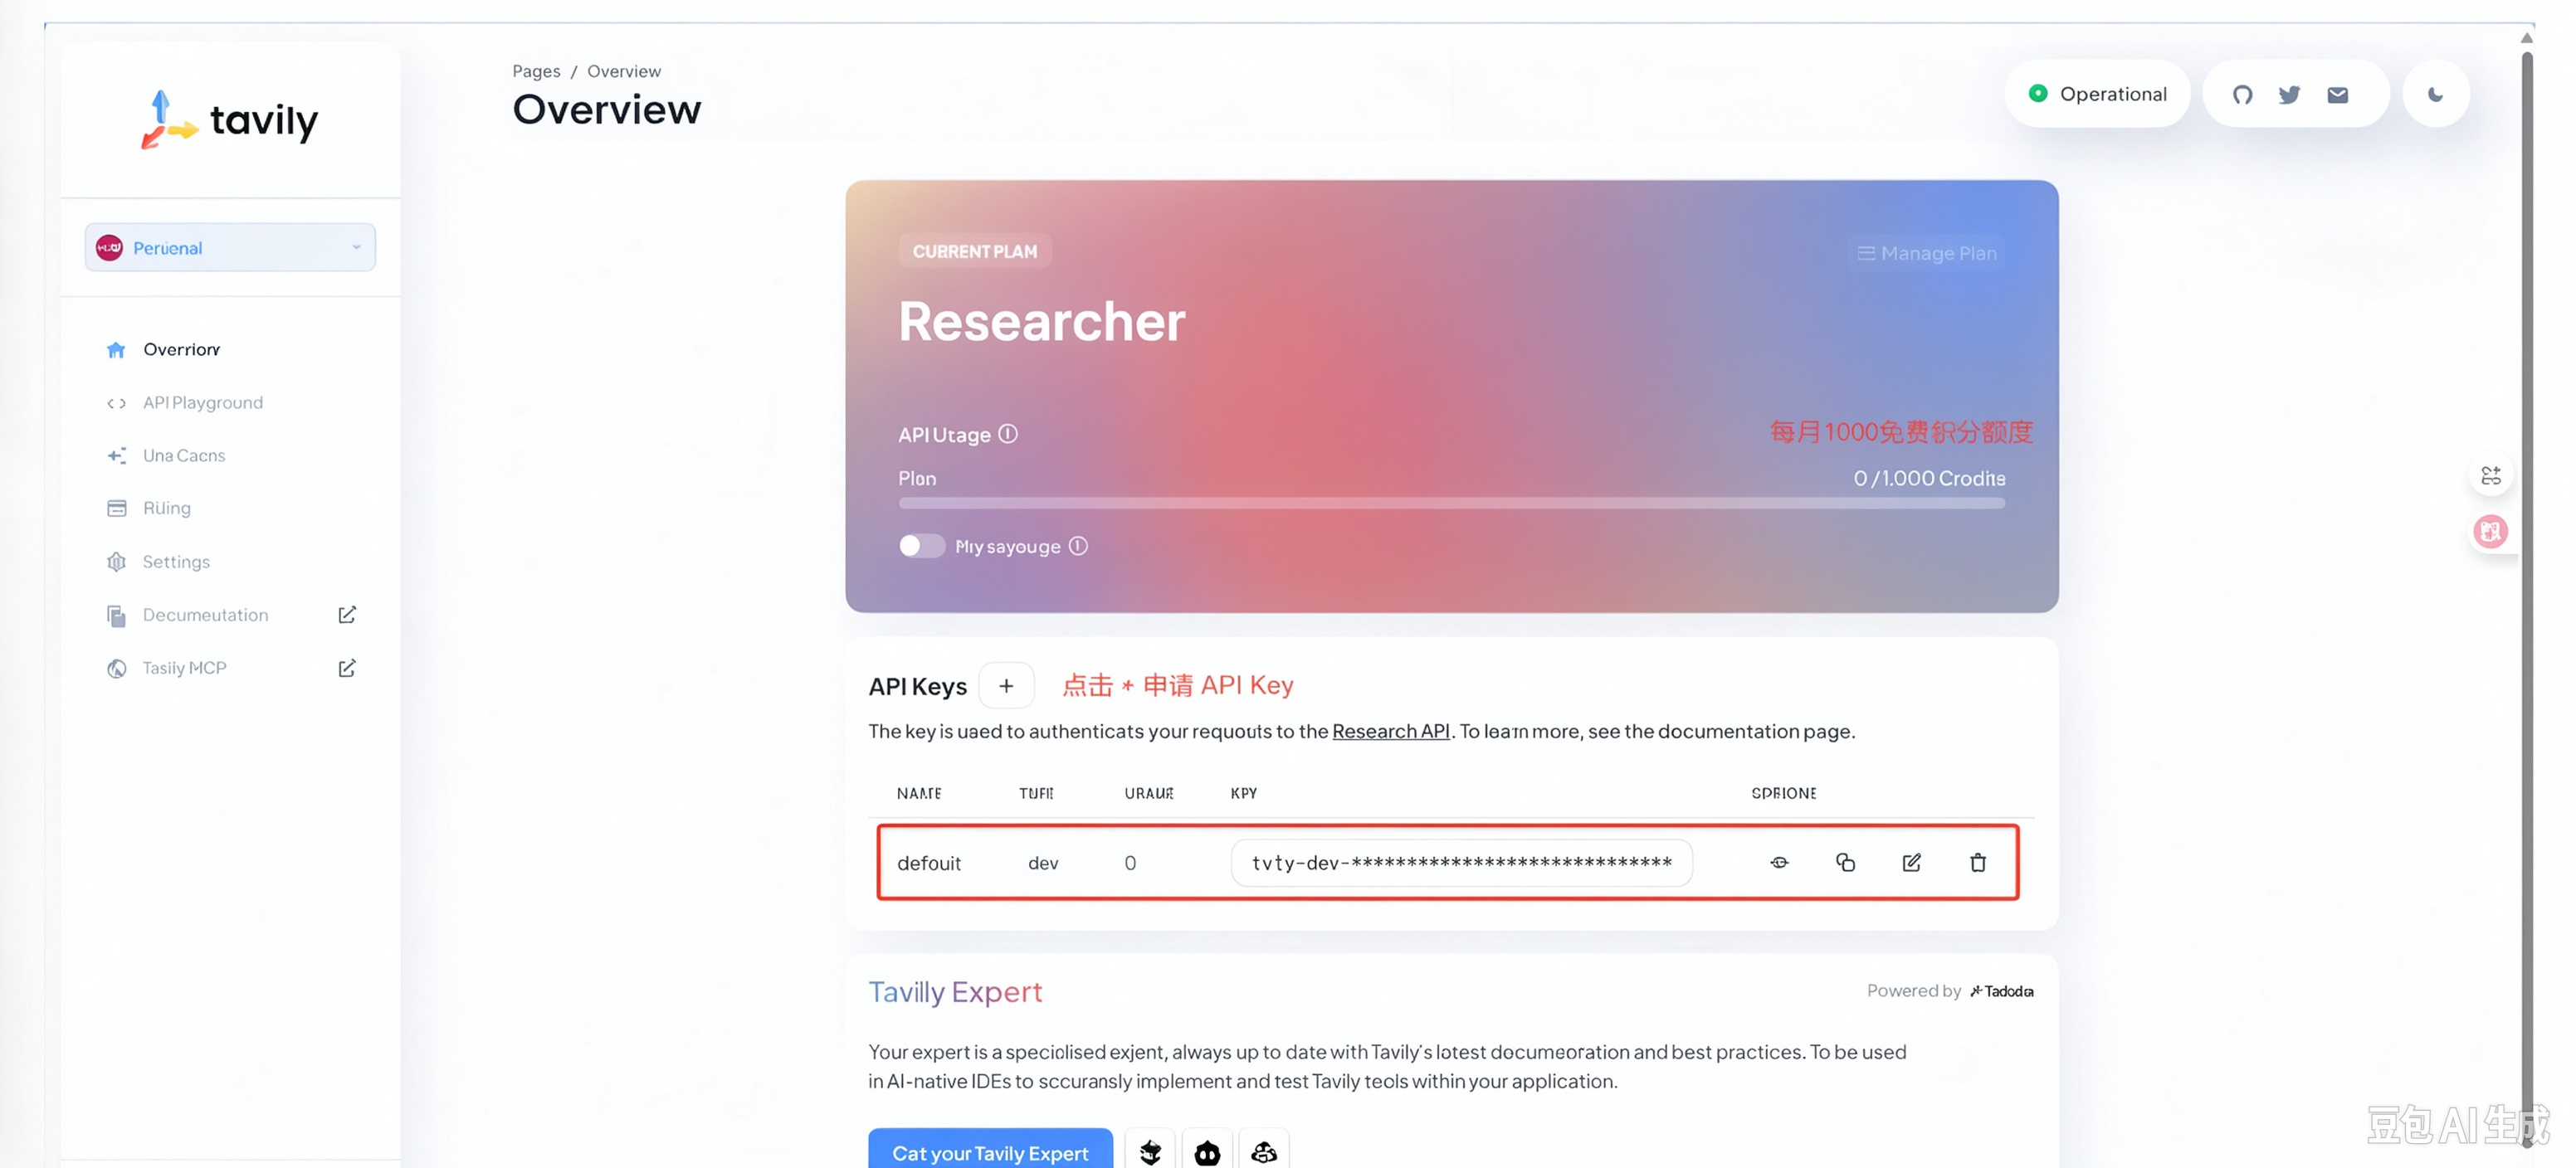
Tavily 官网:Tavily,需魔法使用。登录完成后,新建 API Keys。
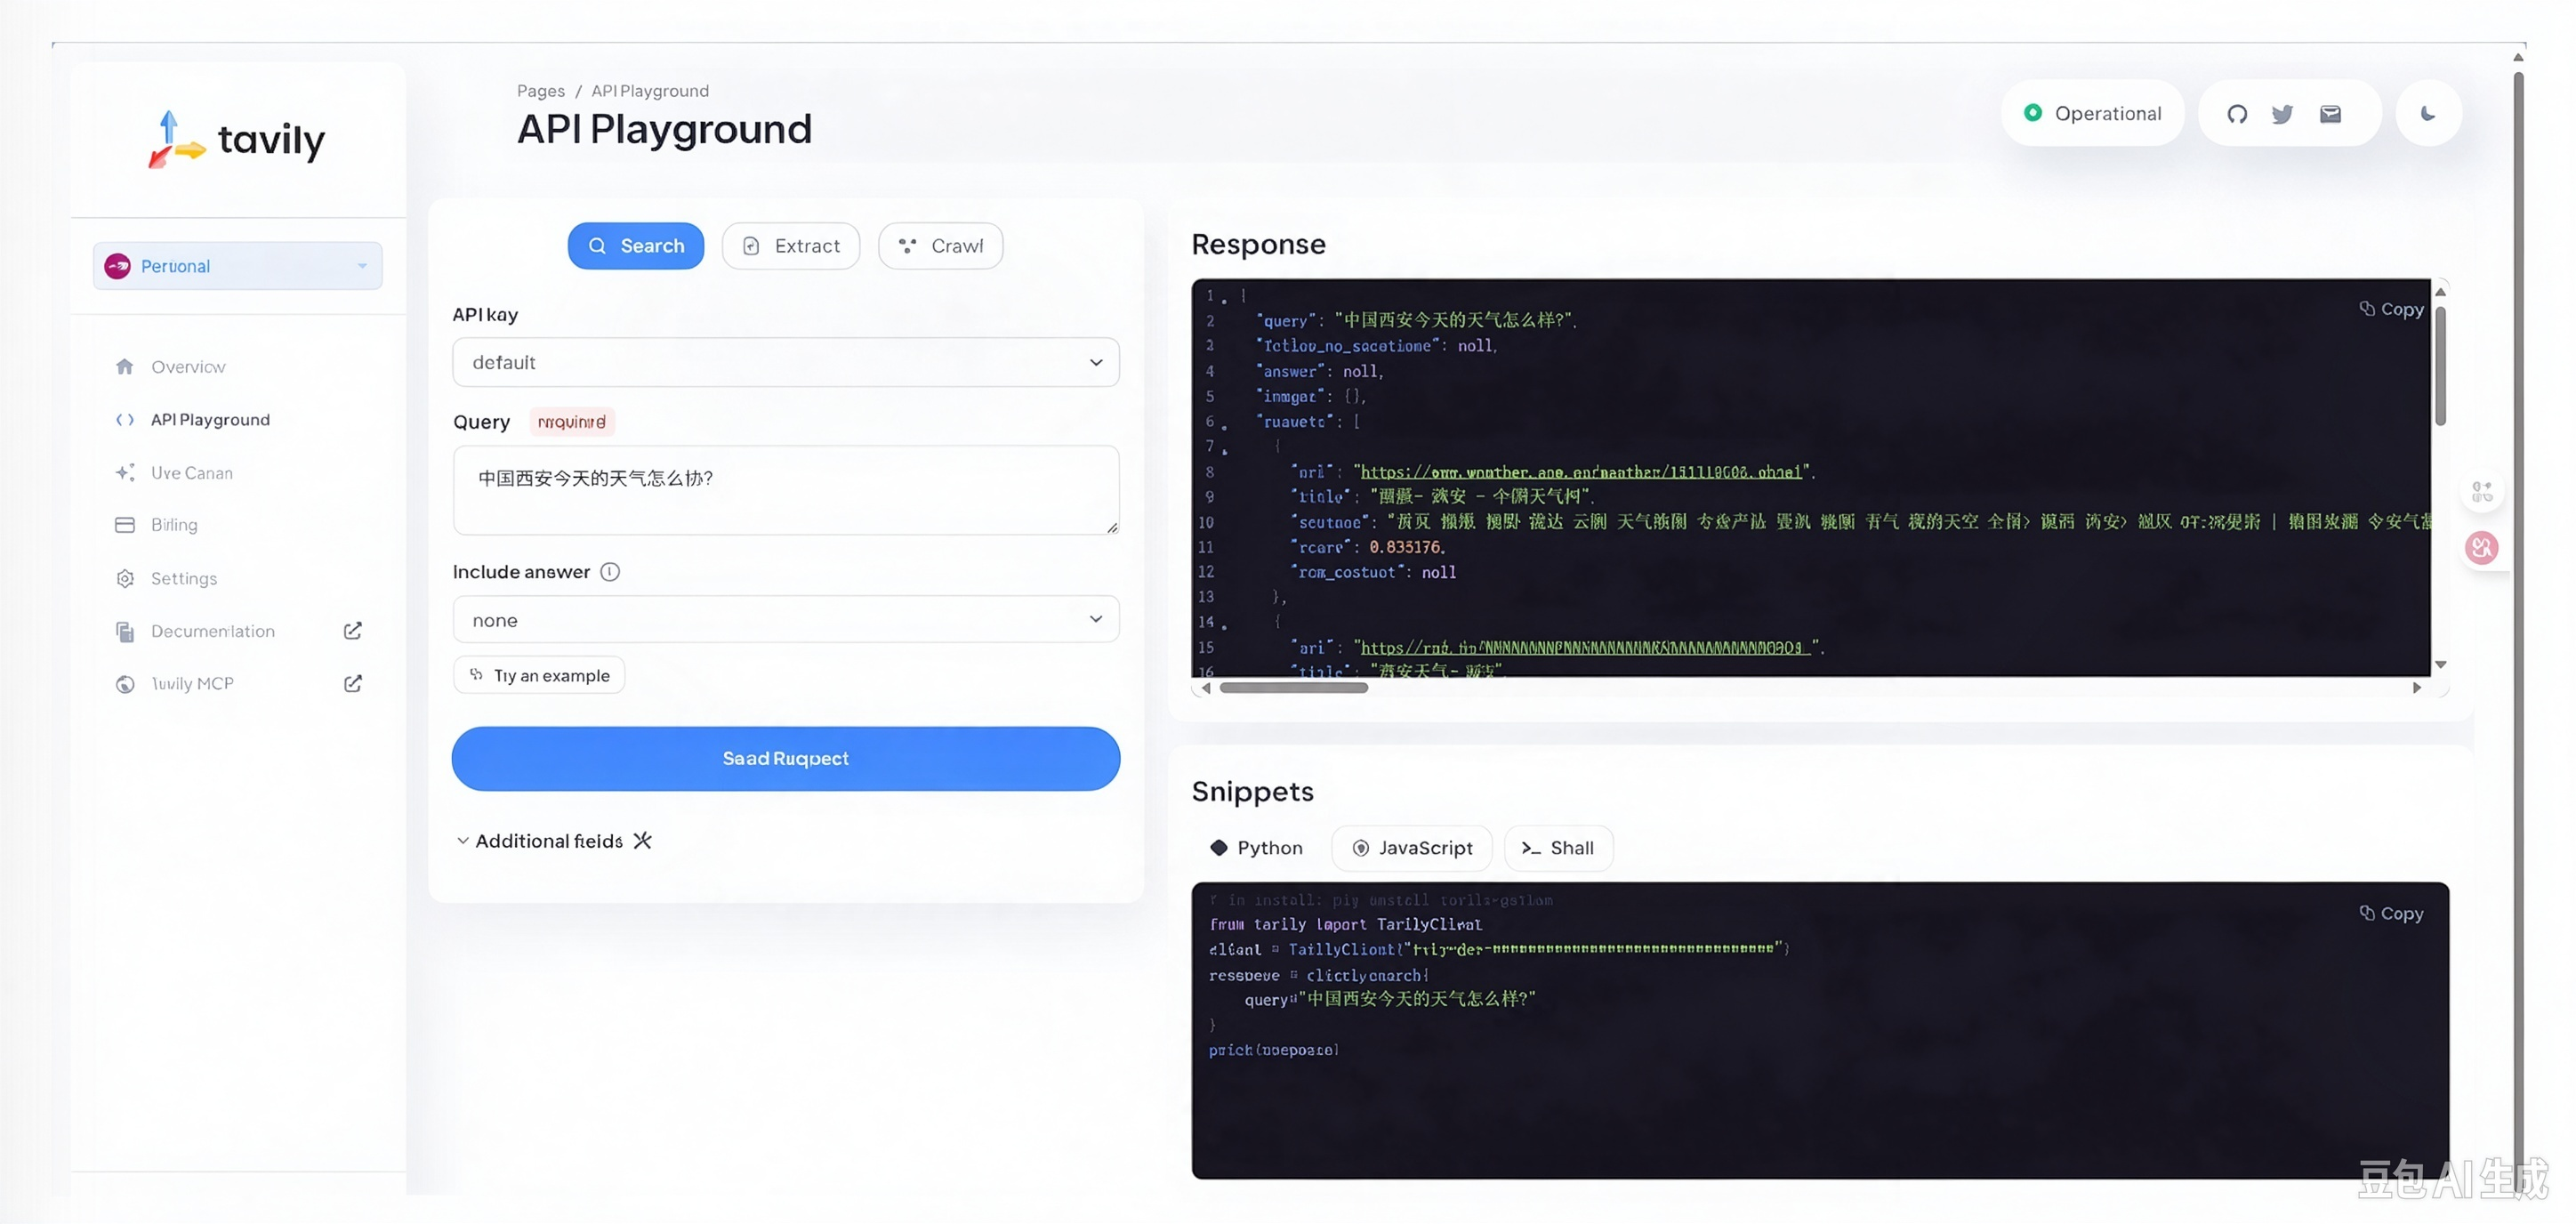
点击左侧 API Playground,可以使用刚申请的 API Keys,进行搜索测试。这会返回根据查询内容得到的多条搜索结果。
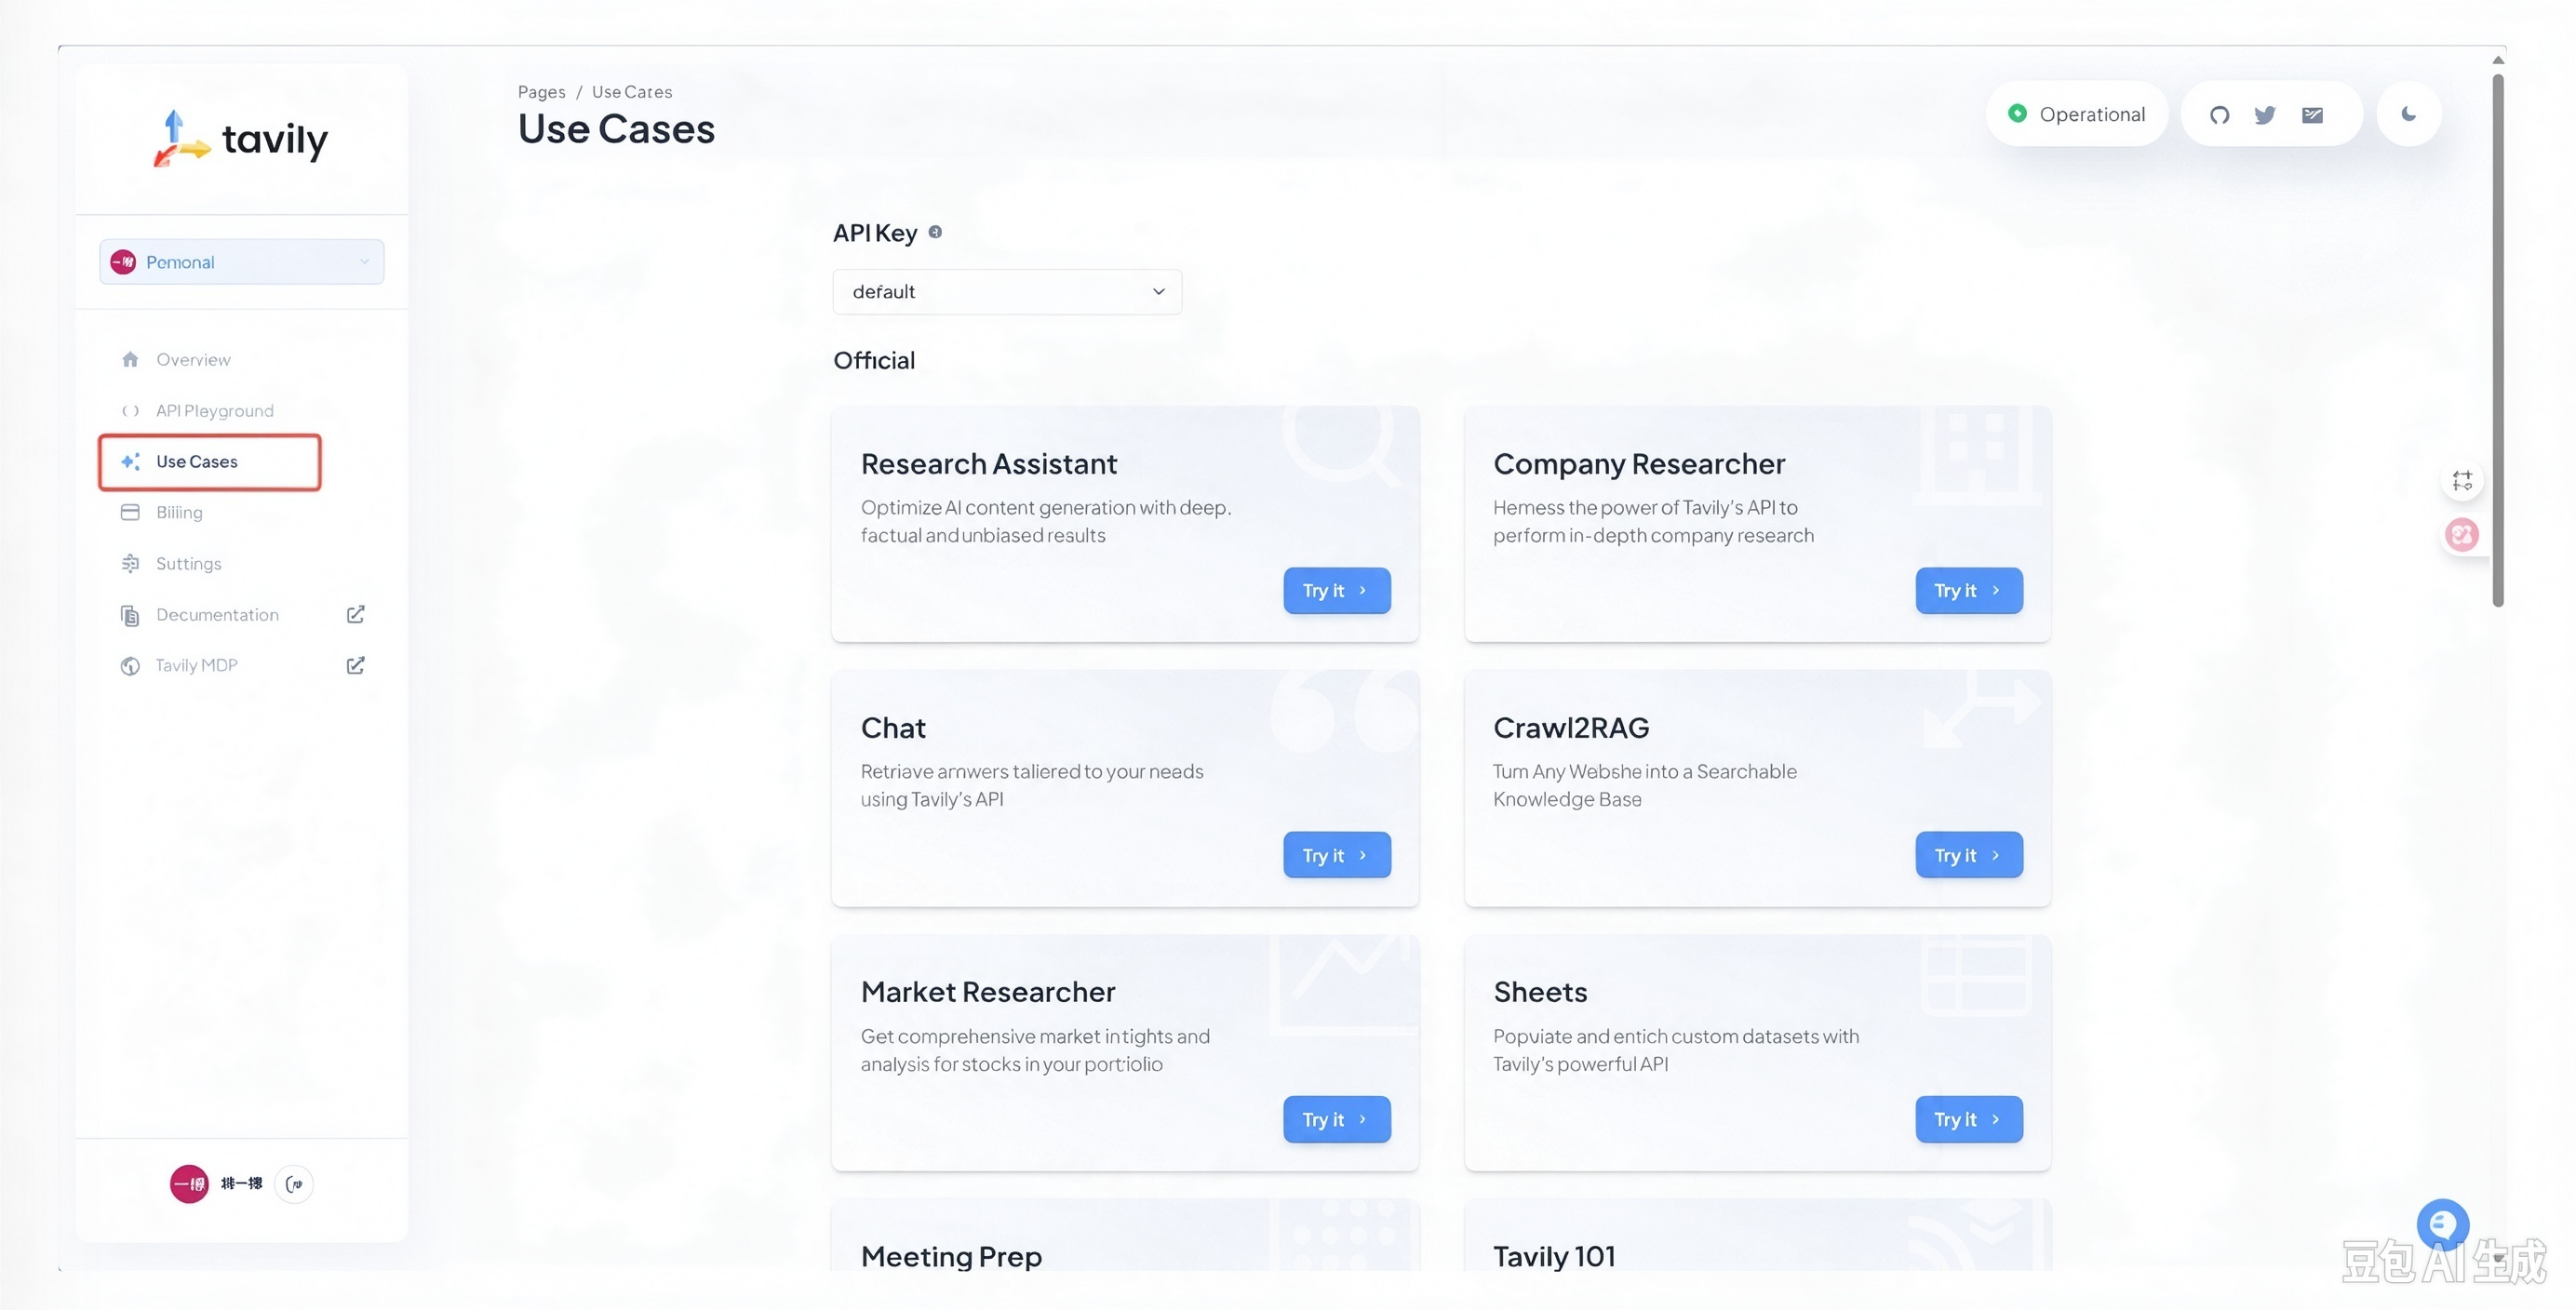
点击左侧 Use Cases,可以试用提供好的案例,如聊天中可以支持搜索(Chat)
使用 Chat。
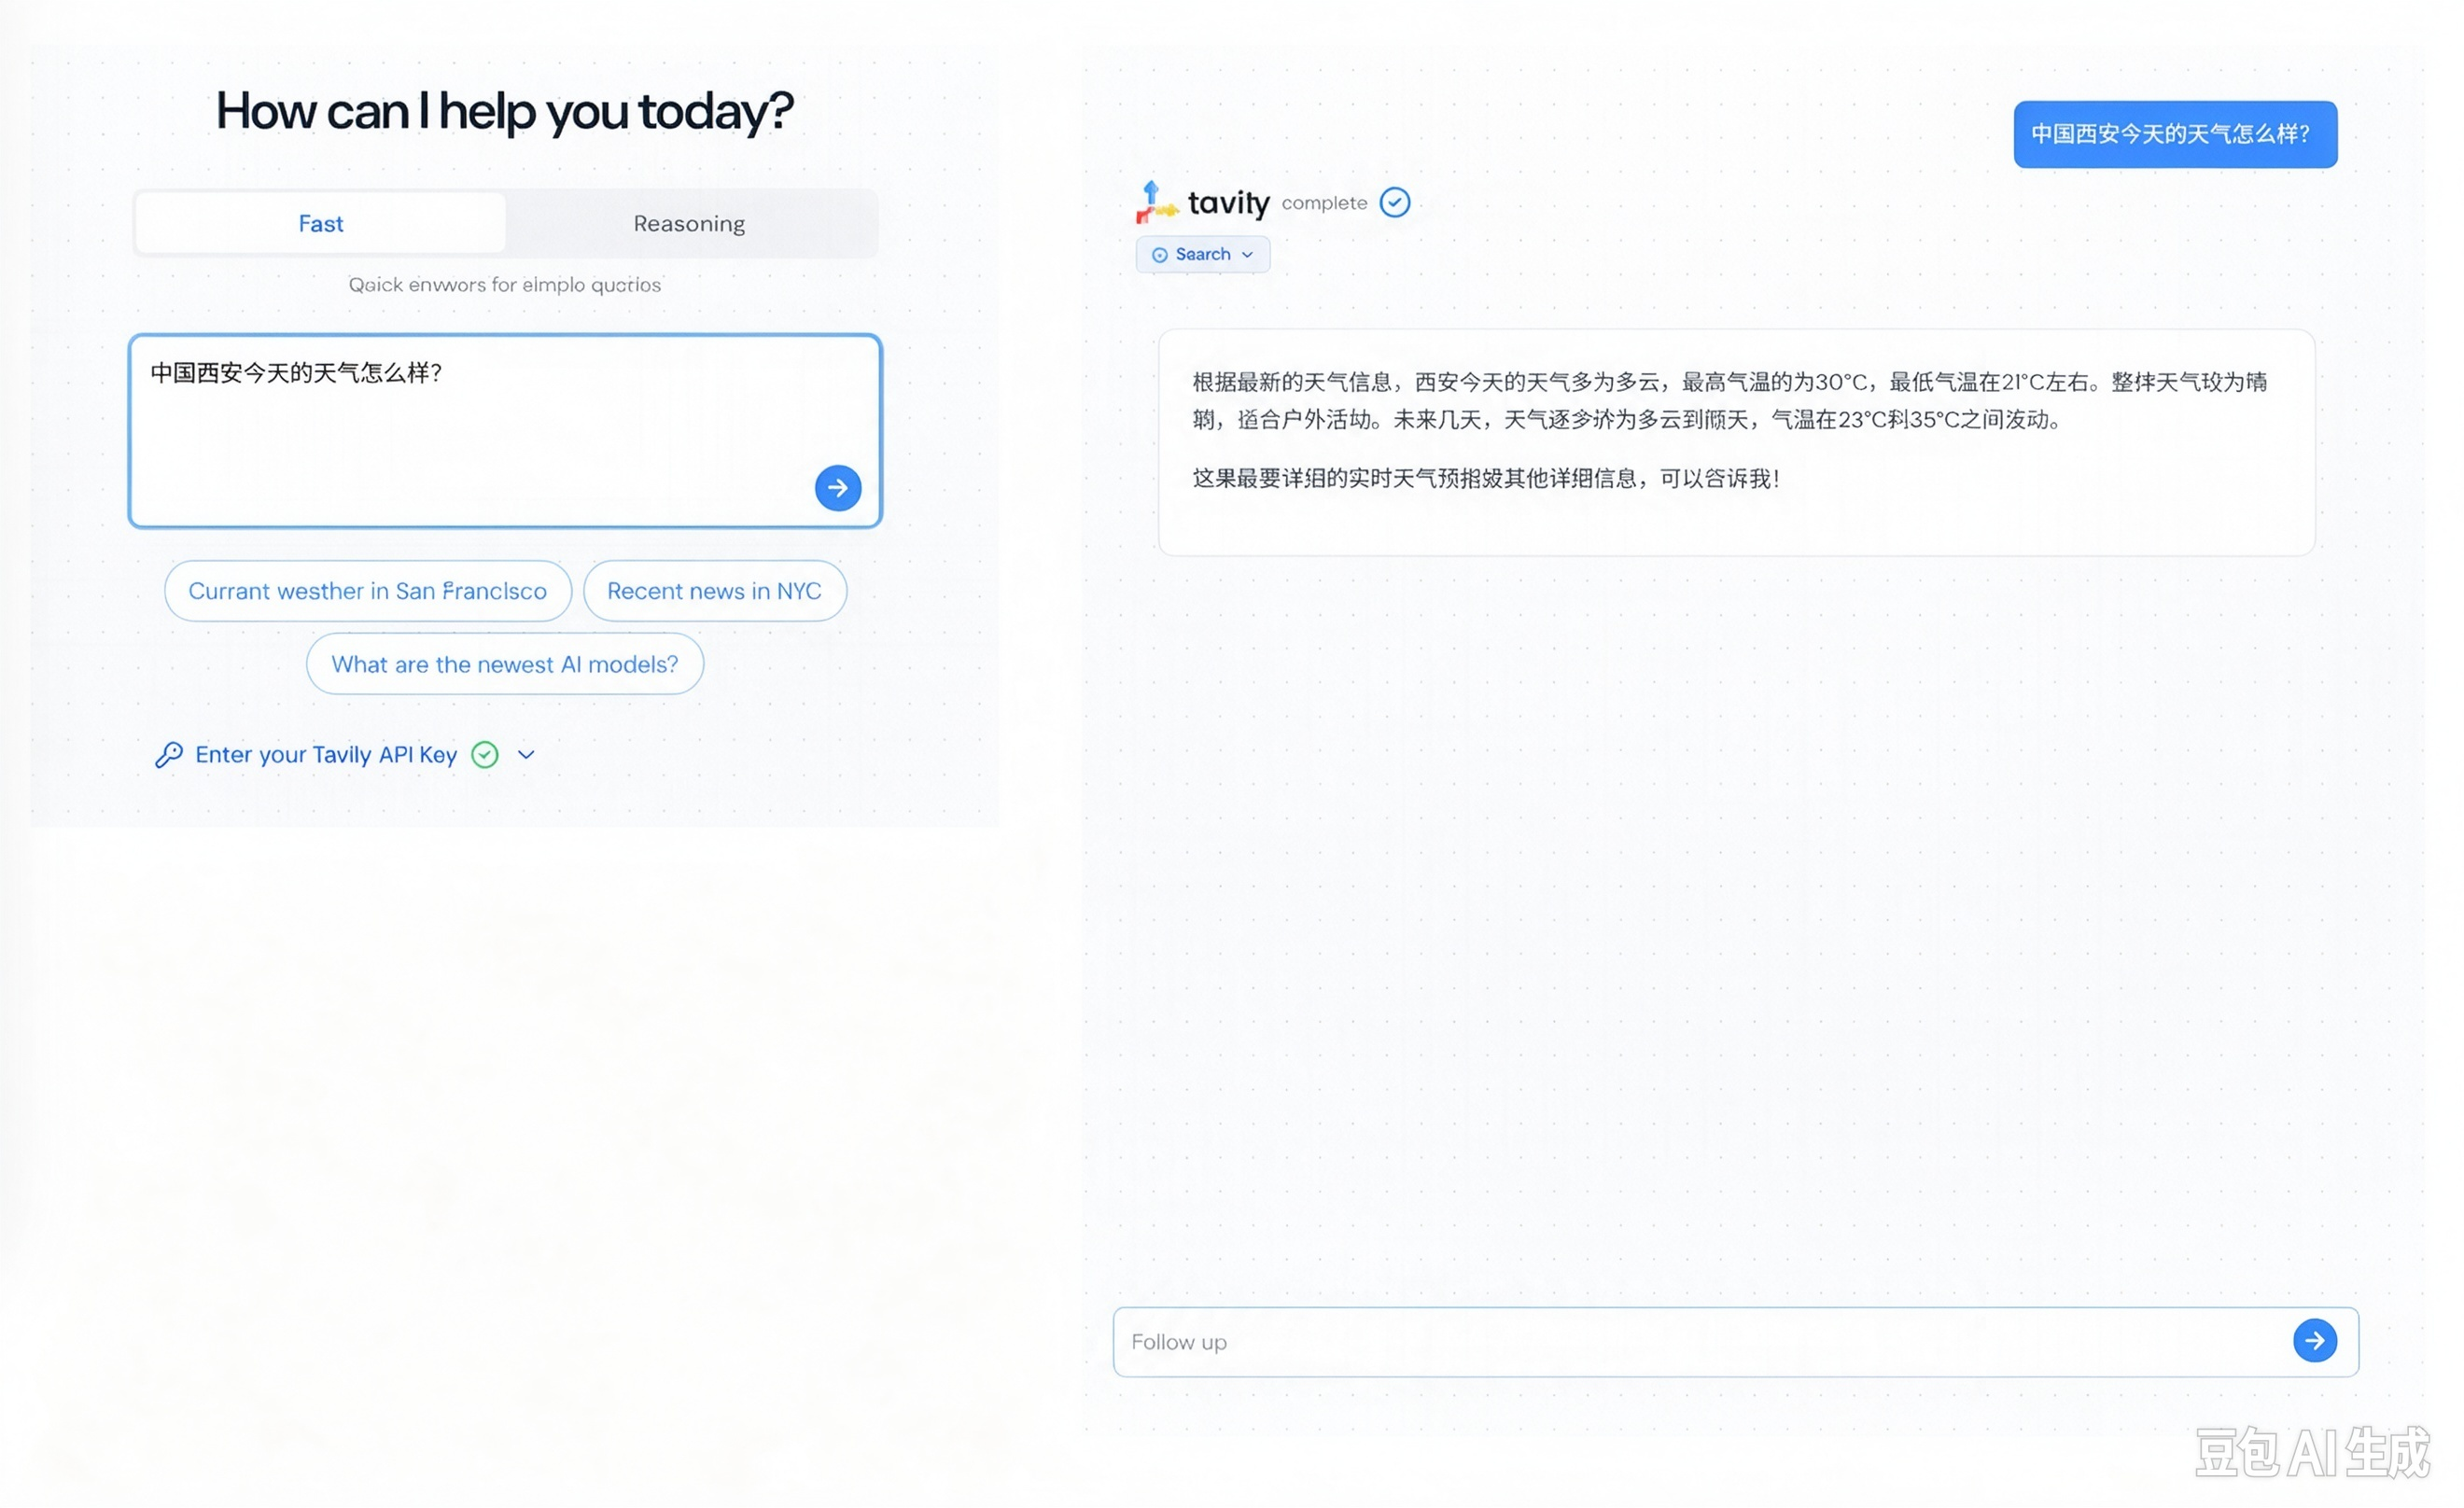
下面我们在 LangChain 中接入该搜索工具,步骤如下:
1、安装 langchain-tavily 包:
python
pip install -U langchain-tavily2、配置环境变量 TAVILY_API_KEY ,值为我们申请的 API Key。
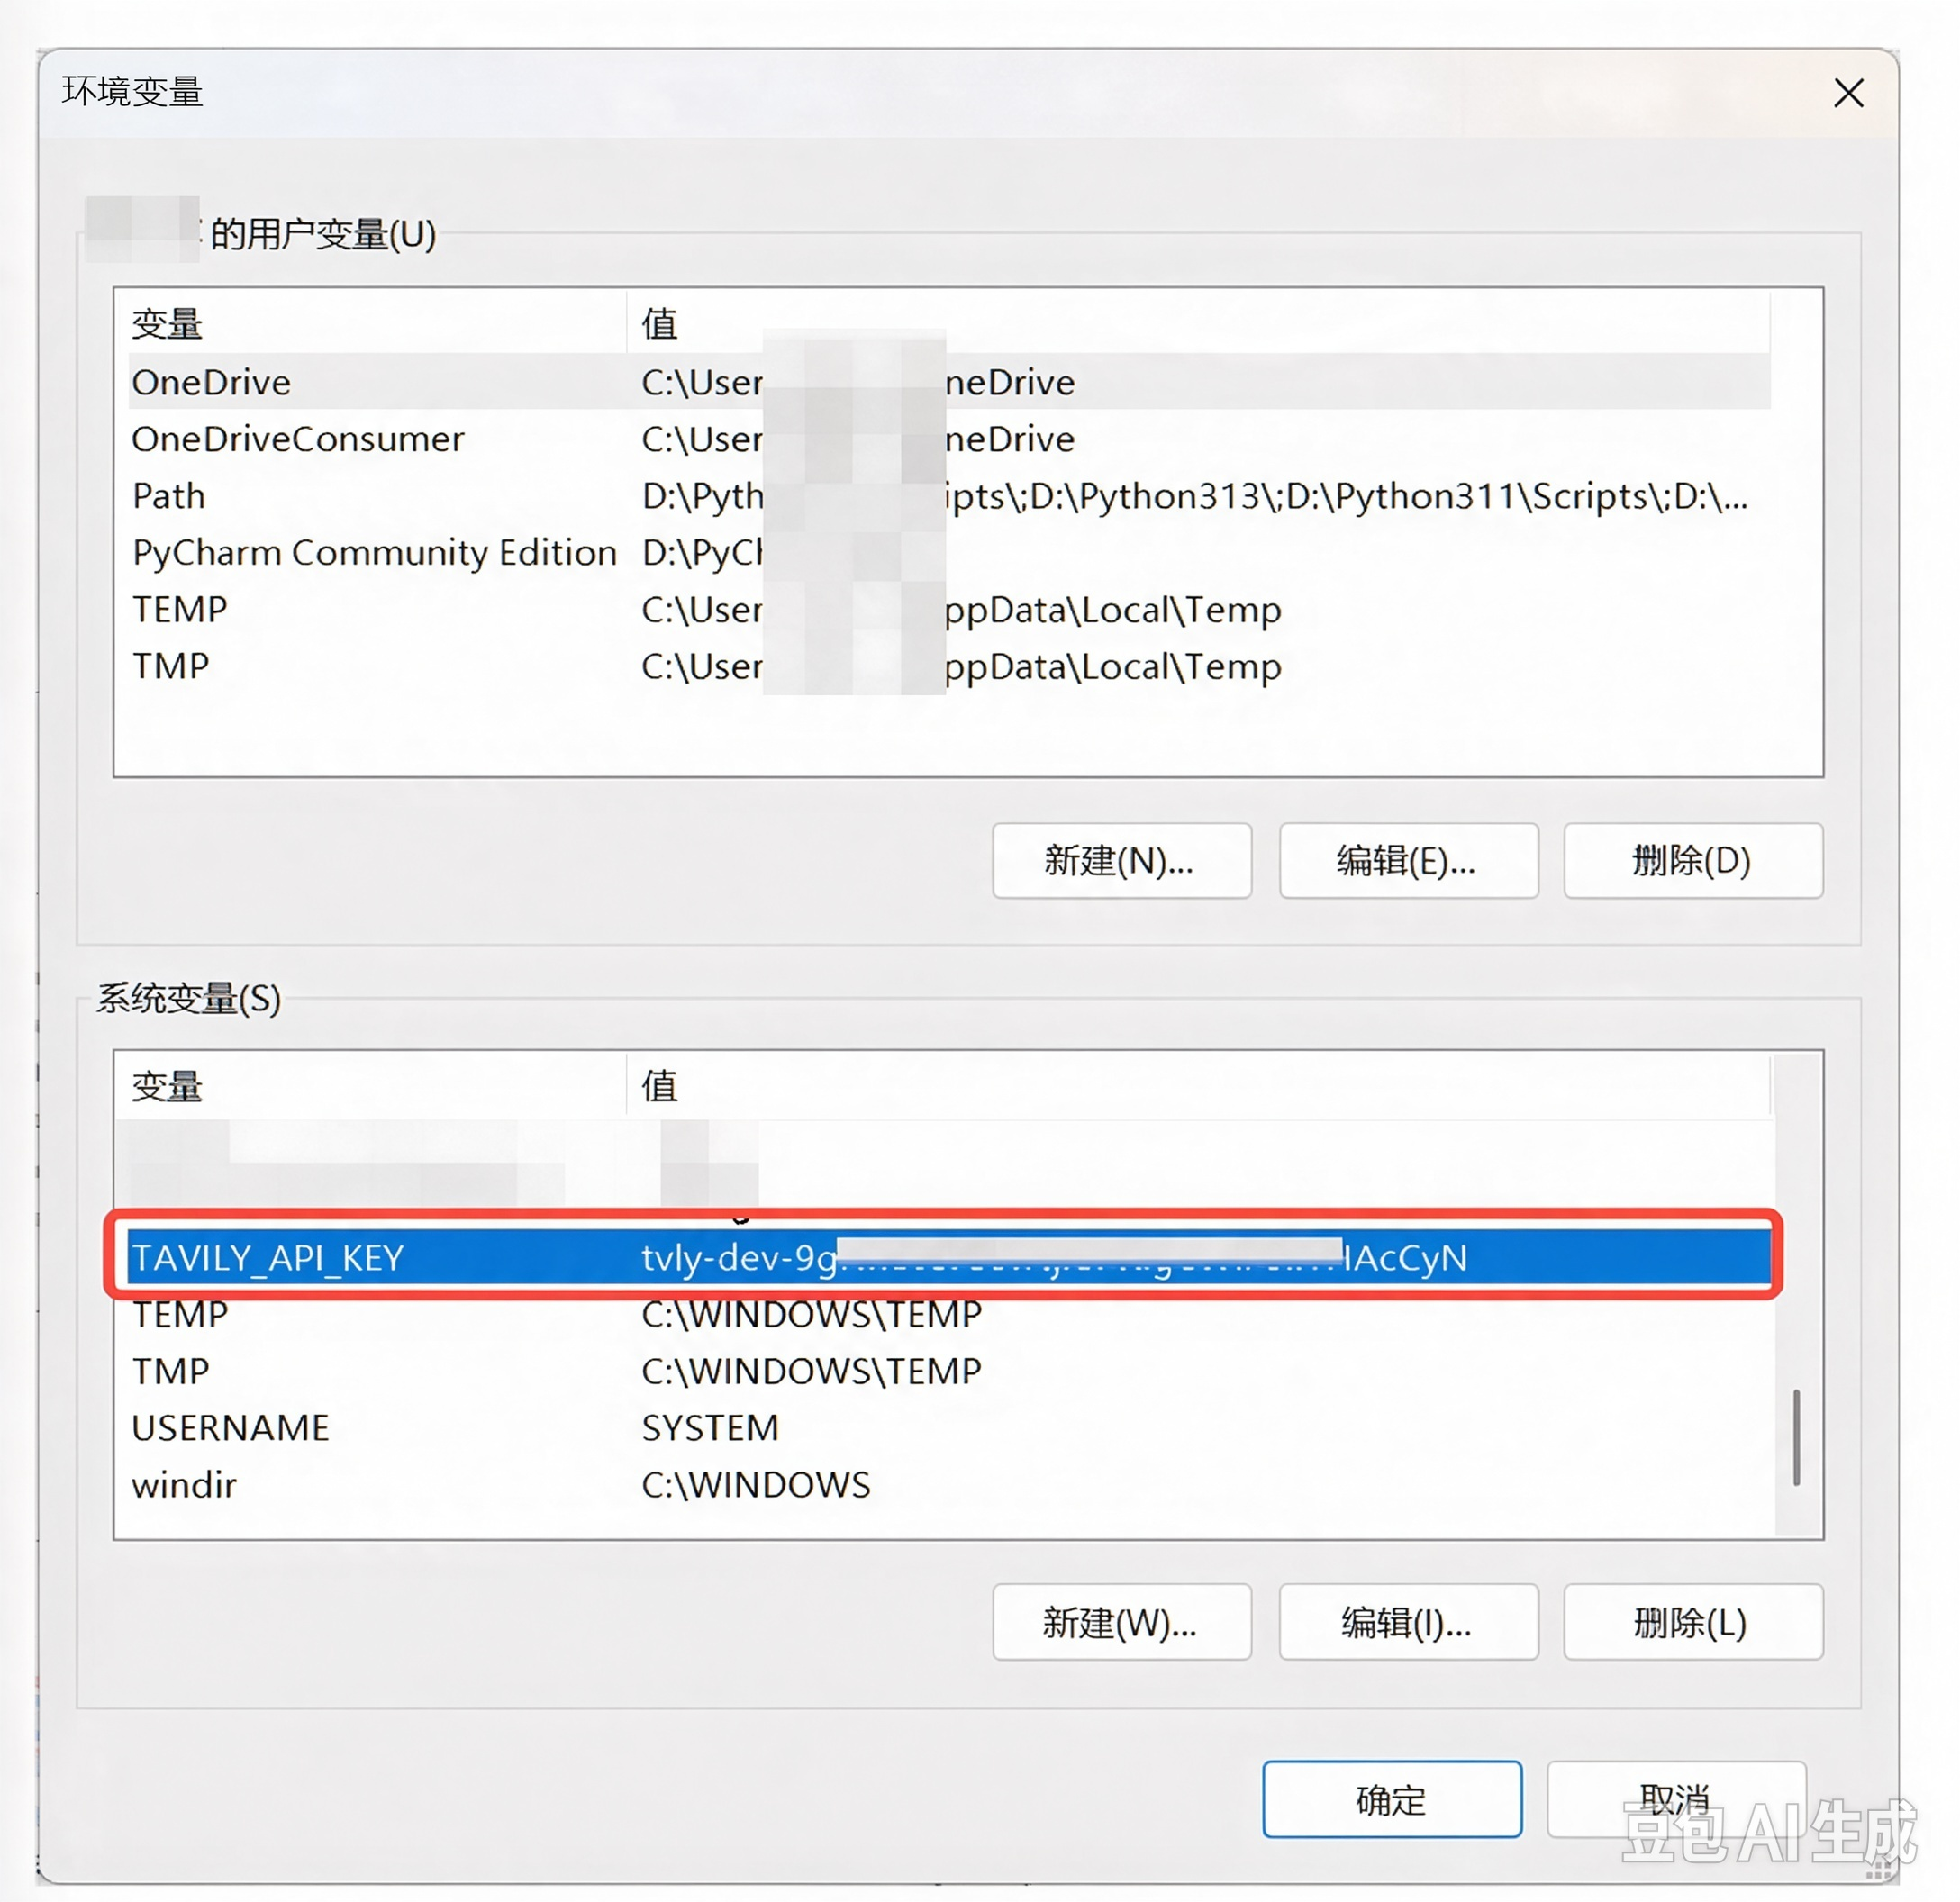
3、代码接入 TavilySearch 类,实现搜索功能:
python
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage
from langchain_tavily import TavilySearch

# 定义大模型
model = ChatOpenAI(model="gpt-4o-mini")
# 绑定工具
tool = TavilySearch(max_results=4) # max_results 返回的最大搜索结果
model_with_tools = model.bind_tools([tool])

# 添加AIMessage到消息中去
messages = [
    HumanMessage("中国西安今天的天气怎么样?")
]
ai_msg = model_with_tools.invoke(messages)
messages.append(ai_msg)

for tool_call in ai_msg.tool_calls:
    # 执行工具调用,返回 ToolMessage
    tool_msg = tool.invoke(tool_call)
    # 将 ToolMessage 加入消息
    messages.append(tool_msg)

result = model_with_tools.invoke(messages)
print(result.content)
结果打印:
今天西安的天气情况如下:
- **天气**:晴天转多云
- **最高气温**:约31℃
- **最低气温**:约21℃
- 预计在晚上会有降雨。
有关更详细的信息,你可以查看[中国气象局的天气预报](https://weather.cma.cn/web/weather/V8870.html)或其他相关天气网站
这里就是聊天模型的调用工具的部分,下面还会接着讲述关于聊天模型结构化输出的内容,感兴趣的可以持续关注。