模型本身的智力只是基础,上下文的质量才是 Agent 能力的真正上限。
换一个更强的模型,只是把基础抬高。它这一步看不见的文件、没写进消息的工具结果、含糊的工具说明,不会因为参数更多就自动出现。Agent 的每一次判断,都发生在这一次请求送进去的那一份上下文里。
目录
- [1. 上限在这一次请求里](#1. 上限在这一次请求里)
- [2. 一次调用长什么样](#2. 一次调用长什么样)
- [3. 消息的四种角色](#3. 消息的四种角色)
- [4. 工具定义为什么单独放](#4. 工具定义为什么单独放)
- [5. 结果如何按编号拼回去](#5. 结果如何按编号拼回去)
- 参考链接
1. 上限在这一次请求里
上一章把 Agent 写成 Model + Harness。上下文是 Harness 交给模型的那一叠材料:系统说明、到目前为止的消息、可用工具、刚执行完的结果。材料缺一页,模型就在缺页的地方做决定。
所以「能力上限」不是一句口号。同一模型、同一套工具,上下文脏了或漏了,表现会先掉。Anthropic 把这件事写成 context engineering:每次采样时放进窗口的 token 集合,才是模型实际在用的世界。他们还指出一种叫 context rot 的现象:窗口变长以后,模型从中准确取回信息的能力会下降。上下文因此是有限预算,不是越大越好。Effective context engineering for AI agents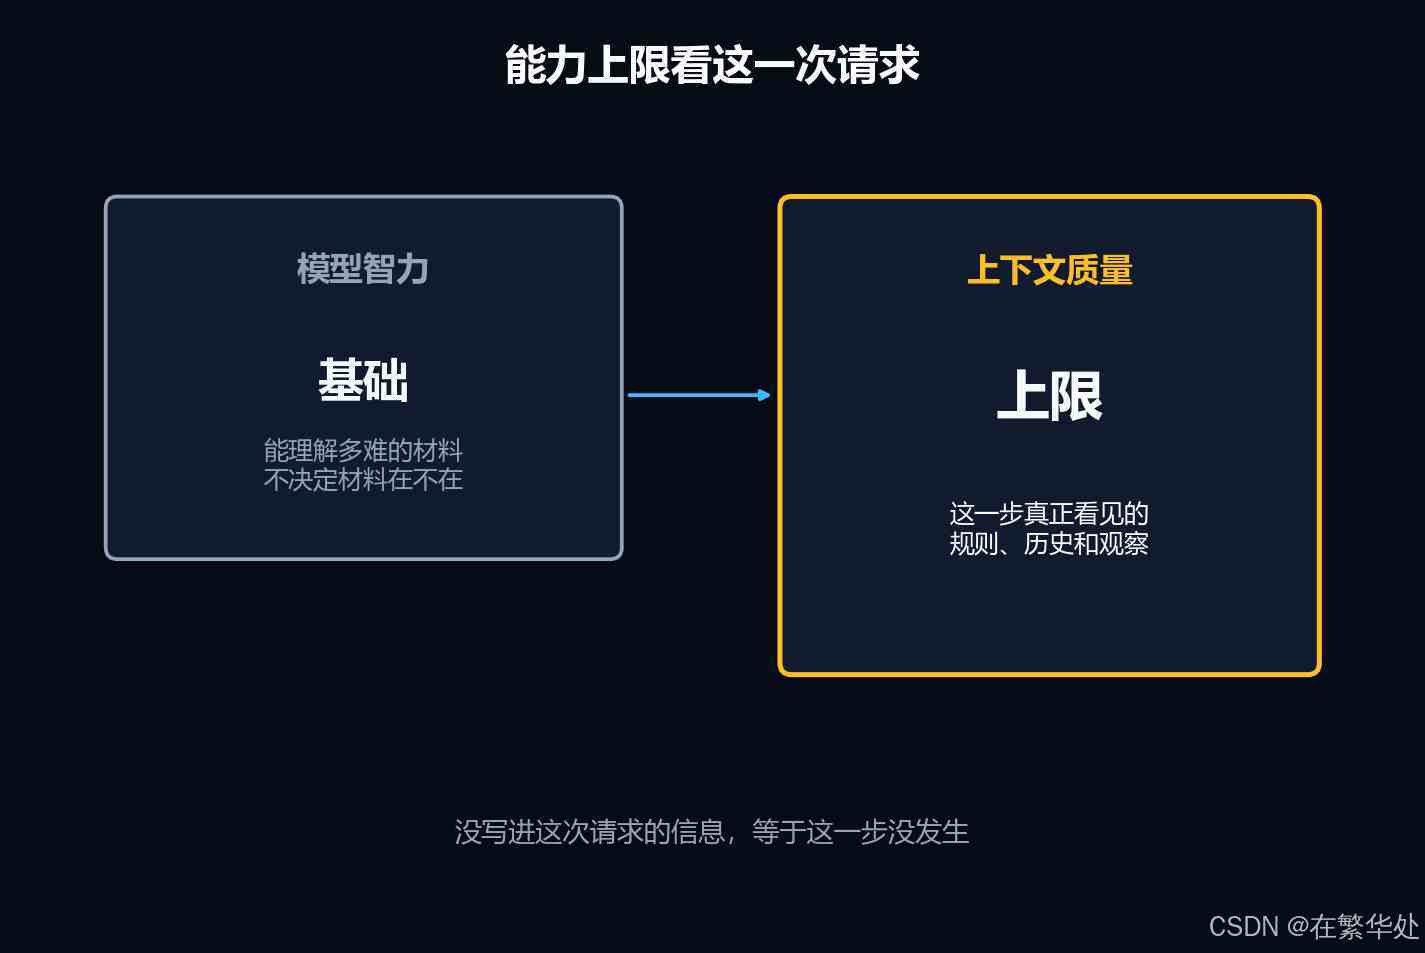
笔记里的判断可以落成三条:
- 智力决定它能理解多难的材料,不决定材料是否在场。
- 质量看的是高信号,不是字数。重复日志、过期结果、含糊的工具说明,都在占预算。
- 上限按「这一次请求」计算。上一轮知道的事,如果没写回消息列表,这一轮就等于没发生。
2. 一次调用长什么样
Agent 调用大模型,不是丢过去一段纯文本。一次请求至少有两块:消息列表,以及可选的工具定义。模型根据每条消息的角色,判断这句话是谁说的、能不能当作指令、是不是一次观察。
| 字段 | 放什么 | 不放什么 |
|---|---|---|
| messages | 按时间排好的对话。每条有 role | 工具的参数说明书 |
| tools | 有哪些工具、各自接受什么参数 | 某一次调用的执行结果 |
工具定义告诉模型「可以怎么问」。工具结果告诉模型「问完以后世界返回了什么」。两件事混在一条系统提示词里,模型分不清哪些是规则、哪些是刚发生的观察。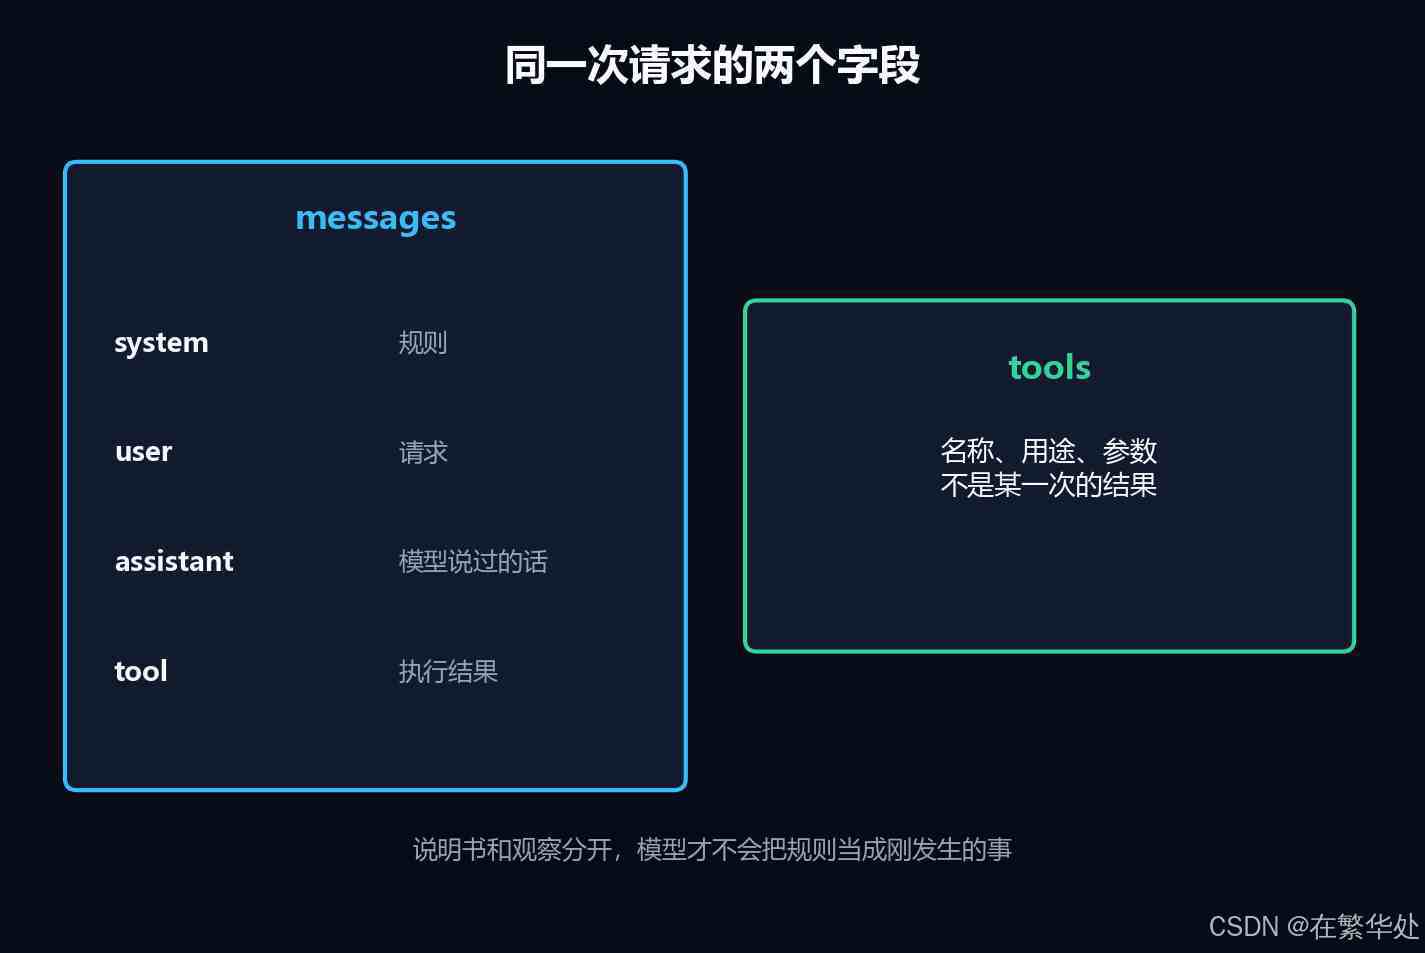
下面用 Chat Completions 常见的形状演示。这是笔记采用的四种角色;别的厂商会把同样的事实装进不同字段,下一节单独说。
json
{
  "tools": [{
    "type": "function",
    "function": {
      "name": "lookup_city_weather",
      "description": "查询城市当日天气。已有结果时不要再调用。",
      "parameters": {
        "type": "object",
        "properties": {
          "city": {"type": "string", "description": "城市名,例如上海"}
        },
        "required": ["city"]
      }
    }
  }],
  "messages": [
    {"role": "system", "content": "没有实时数据时必须调用工具。"},
    {"role": "user", "content": "上海今天天气怎么样?"}
  ]
}
OpenAI 的函数调用说明写得很明确:工具在每次请求的 tools 参数里声明,包含名称、用途和参数结构。模型若决定调用,返回的是请求,不是结果。应用执行之后,再把输出连同原来的对话送回去。Function calling
3. 消息的四种角色
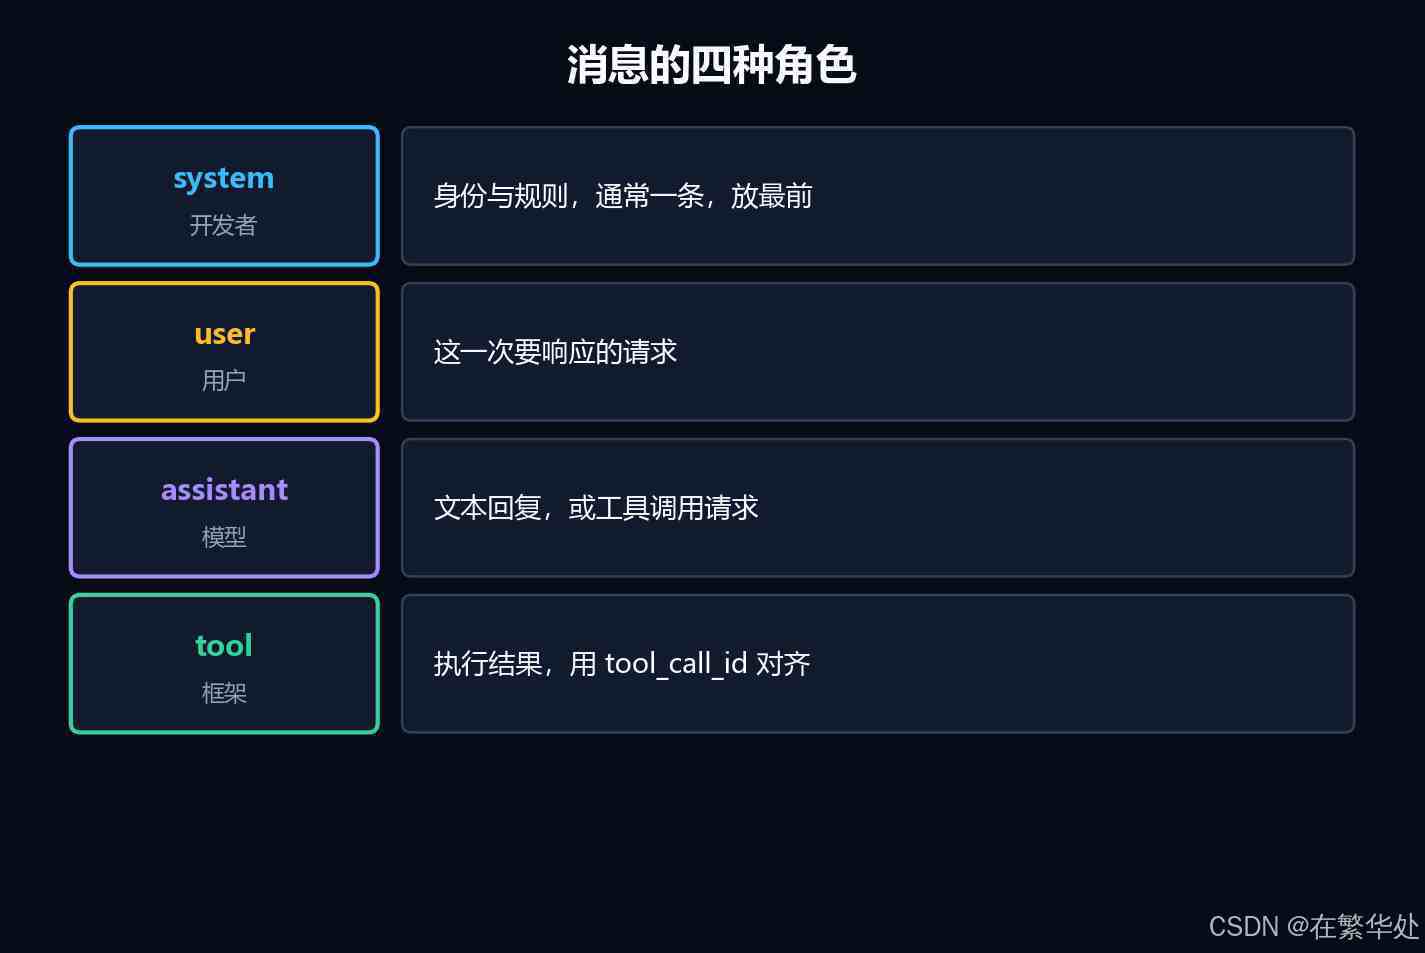
大模型 API 的核心是一个消息列表(messages) 。每条消息都有一个角色(role)。模型靠角色理解含义和来源,而不是靠你在正文里写「以下是系统指令」。
| 角色 | 谁写的 | 模型怎么理解 |
|---|---|---|
| system | 开发者 | 身份、行为规则、约束。通常视为最高优先级。整个对话一般只有一条,放在列表最前面 |
| user | 终端用户 | 需要响应的请求。后面每一轮新问题也用这个角色追加 |
| assistant | 模型自己 | 之前的回复。可以是文本,也可以是工具调用请求。放回列表,模型才「记得」自己说过什么、要过什么 |
| tool | Agent 框架 | 工具执行后的结果。每条通过 tool_call_id 对上某一次调用,不能只靠文字里的工具名去猜 |
四种角色解决的是来源,不是重要性排序的全部。system 负责岗位说明书;user 负责这一次要解决的问题;assistant 负责模型自己的历史;tool 负责外部世界的观察。少任何一种,模型都会把别人的话当成自己的话,或把规则当成刚刚发生的事实。
有一个容易记混的差别,需要单独标出来。上面四行是 Chat Completions 这一路的装法。Anthropic 的工具调用把结果放进下一次请求的 tool_result 内容块,并用 tool_use_id 和模型发出的 tool_use 对齐;系统说明常常是请求顶层的独立字段,而不是消息列表里的一条 role=system。事实相同:规则、用户请求、模型请求、执行结果要分开,并用编号对上。字段名不要背成全世界只有一套。How tool use works
4. 工具定义为什么单独放
工具定义不是第五种消息。它是请求的独立字段,告诉模型有哪些工具可以用、每个工具接受什么参数。
一条合格的定义至少有三样:
- 名称:短、稳定、不要把整段流程焊进名字里。
- 用途:什么时候用,什么时候不要用。
- 参数 :每个字段的类型和例子。必填项写进
required。
定义会进入模型这一步能看见的材料。OpenAI 写过:函数说明会被放进模型训练过的系统消息语法里,因此占用上下文预算,并按输入 token 计费。工具一多、说明一长,上限就被说明书吃掉,即使用户只问了一句天气。
所以「工具越多 Agent 越强」不成立。和上下文一样,工具清单也要高信号。一个说不清边界的工具,比少一个工具更伤这一步的判断。
5. 结果如何按编号拼回去
模型不会自己执行工具。它在 assistant 消息里留下调用请求,请求上有一个 id。框架执行后,用 tool 消息把结果送回,tool_call_id 必须等于那个 id。对不上,模型就不知道这条观察属于哪一次提问。
python
def append_tool_result(messages, tool_call, result: dict):
    """把模型的请求和框架的观察按同一个 id 写回列表。"""
    call_id = tool_call["id"]
    messages.append({
        "role": "assistant",
        "content": None,
        "tool_calls": [tool_call],
    })
    messages.append({
        "role": "tool",
        "tool_call_id": call_id,
        "content": result,
    })
    return messages

def next_request(messages, tools):
    # 下一跳看到的世界 = 旧消息 + 刚追加的请求与结果 + 同一份工具定义
    return {"messages": messages, "tools": tools}
一轮天气查询,列表的生长顺序是固定的:
- system 放好规则,user 放入问题,tools 放上
lookup_city_weather。 - 模型若没有当日数据,assistant 消息里带上
id=call_01的调用请求。 - 框架执行后追加 tool 消息,
tool_call_id写成call_01,内容是结构化结果,而不是模型自己编的一句「查好了」。 - 把整份列表再送回去。模型这时才有资格用文字回答。
少第 3 步,模型只能重复发出调用,或者直接编一个温度。少了 id 对齐,两条工具结果挤在一起时,它会对错观察。上下文的质量,在这一步就是:该在的角色在,该对齐的编号对齐,不该进窗口的噪声没进。
下一节如果继续,就只写一件事:系统提示词怎样写,才不会把本该放在工具定义和验证里的规则,全部堆进那一条 system。