目录标题
-
-
- 一、先看列子(怎么算正则化项)
- 二、噪音被强行拟合例子
- 三、这个公式的物理意义(为啥这么算)
- [四、XGBoost 的四个"刹车片"是怎么生效的?](#四、XGBoost 的四个“刹车片”是怎么生效的?)
- [五、 λ \lambda λ这个值人为设定,怎么知道该设置多少](#五、 λ \lambda λ这个值人为设定,怎么知道该设置多少)
- [六、举个列子一步步解释最优叶子权重中 G j G_j Gj和 H j H_j Hj到底是啥(最后写完才知道是对损失函数的二阶泰勒展开)](#六、举个列子一步步解释最优叶子权重中 G j G_j Gj和 H j H_j Hj到底是啥(最后写完才知道是对损失函数的二阶泰勒展开))
-
叶子节点的输出权重 w j w_j wj,本质上就是这个叶子节点的输出值(预测值)。
它俩是同一个东西,只是从不同角度去称呼它,所以名字听起来不一样:
- 叫"输出值":是因为从**前向计算(预测)**的角度看,样本落在这个叶子里,模型给它的预测分数就是这个数。比如图里小男孩落到 Leaf 1,模型给他的预测就是 +2。
- 叫"权重( w j w_j wj) ":是因为从数学推导 的角度看,XGBoost 把叶子节点看作是一个参数(就像线性回归里的系数 w w w)。这个叶子里的所有样本,共享这一个权重值。
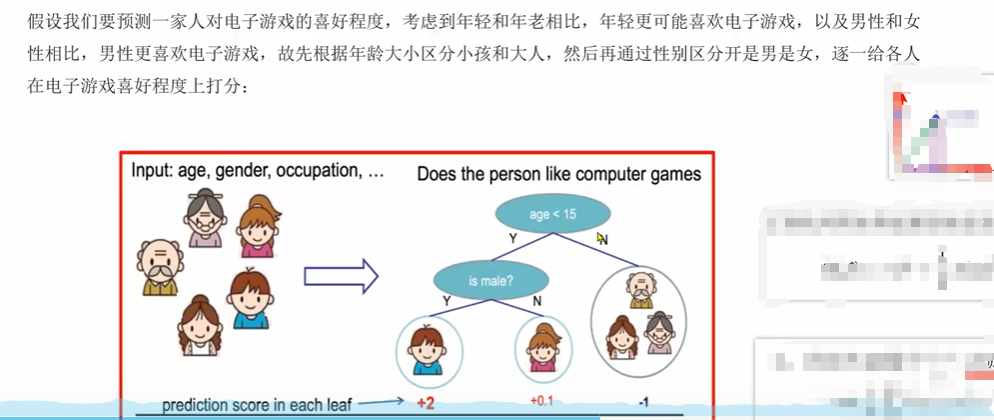
一、先看列子(怎么算正则化项)
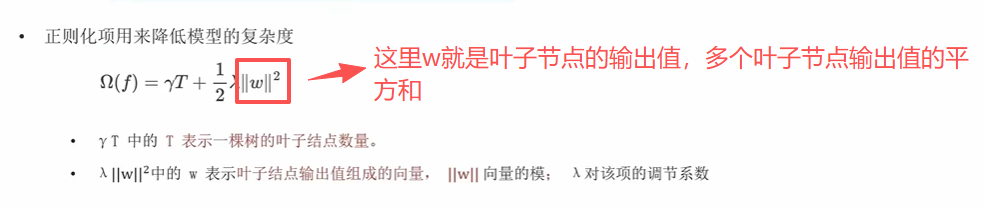
occupation:工作,职业
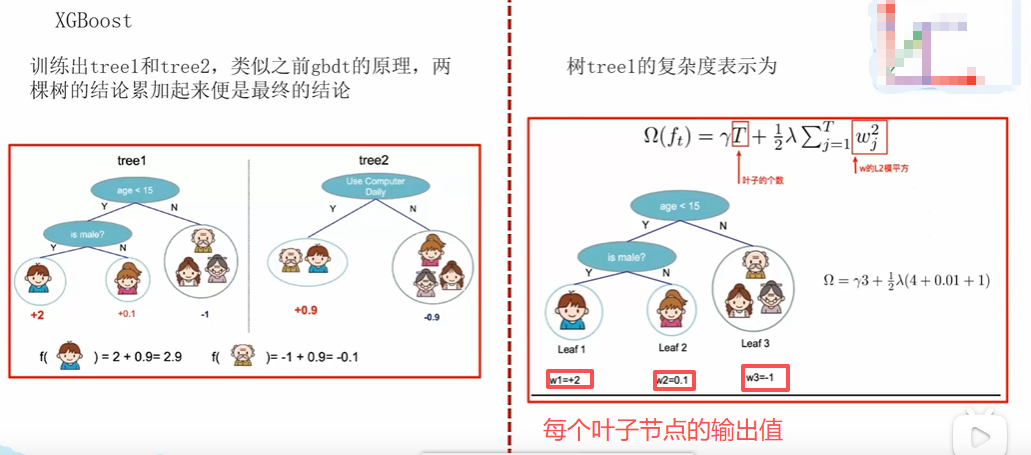
图片是tree1 的Ω值 Ω = γ 3 + 1 2 λ ( 4 + 0.01 + 1 ) \Omega = \gamma 3 + \frac{1}{2}\lambda(4 + 0.01 + 1) Ω=γ3+21λ(4+0.01+1)
tree2的Ω值
Ω = γ 2 + 1 2 λ ( 0.81 + 0.81 ) \Omega = \gamma 2 + \frac{1}{2}\lambda(0.81 + 0.81) Ω=γ2+21λ(0.81+0.81)
二、噪音被强行拟合例子
场景还原:训练集 vs 测试集
假设我们要预测的是"一个人是否会买某个昂贵的游戏皮肤",我们需要根据特征来预测。
特征只有两个(为简化):
- 年龄(数字)
- 是否常玩手游(是/否)
真实规律(上帝视角):只要"常玩手游",基本都会买;不常玩就不买。
1. 训练集(5个人,因为样本少,里面恰好混入了怪异的噪音)
| 姓名 | 年龄 | 常玩手游? | 是否购买(真实值) | 第一轮预测(均值) | 第一轮残差(真实-预测) | 备注 |
|---|---|---|---|---|---|---|
| 张三 | 18 | 是 | 买 (1) | 0.5 | +0.5 | 正常的"常玩就买" |
| 李四 | 25 | 是 | 买 (1) | 0.5 | +0.5 | 正常 |
| 王五 | 30 | 否 | 不买 (0) | 0.5 | -0.5 | 正常 |
| 赵六 | 35 | 否 | 不买 (0) | 0.5 | -0.5 | 正常 |
| 钱七 | 40 | 是 | 不买 (0) | 0.5 | -0.5 | ⚠️ 这就是噪音! 一个40岁大叔,虽然常玩手游,但就是不买 |
(注:真实值是 0 或 1,均值是 0.5,残差就是 0.5 或 -0.5)
注意看钱七:按照正常规律,他应该买,但他没买。这个"不买"就是训练集里特有的随机噪音(可能是他刚好那天没钱,或者心情不好)。
2. 第二轮树是怎么"拟合"这个噪音的?
第二轮树的任务,是去拟合那 5 个残差(目标变成 +0.5, +0.5, -0.5, -0.5, -0.5)。
为了让训练集的 Loss 降到 0,第二轮树会怎么做?
它会尽力去寻找特征(年龄、是否常玩),把残差相同的样本分到同一个叶子里。
它可能学到的规则是这样的(注意这个规则非常诡异):
- 规则 A:如果 (年龄 < 35) 且 (常玩手游=是) → 预测残差 +0.5 (覆盖张三、李四)
- 规则 B:如果 (年龄 >= 35) → 预测残差 -0.5 (覆盖赵六、钱七)
- 规则 C:如果 (年龄在25-35之间) → 预测残差 -0.5 (覆盖王五)
发现了吗?这棵树为了强行把钱七(40岁)的 -0.5 拟合进去,硬生生编出了一个"年龄 >= 35 就不买"的规则。
但这根本不是真实规律!真实规律只看"是否常玩手游",年龄根本不是决定性因素。第二轮树把"钱七的年龄40岁"当成了规律,这就是"强行拟合噪音"。
此时,模型在训练集上:
- 张三预测:0.5 + 0.5 = 1 (完美)
- 钱七预测:0.5 + (-0.5) = 0 (完美)
训练集 Loss = 0!模型看起来极其聪明。
3. 测试集一进来,为什么就"一塌糊涂"了?
现在来了一个全新的测试集,里面有一个同样不买的 40 岁大叔(叫孙八),但是他其实是因为不常玩手游才不买的。
模型开始预测孙八:
- 第一轮:输出 0.5(因为全局均值是0.5)。
- 第二轮:模型看到孙八"年龄40岁",立刻触发了它学到的诡异规则 B(年龄>=35 → 残差-0.5)。
- 最终预测:0.5 + (-0.5) = 0。预测"不买"。(猜对了,运气好)
但再换一个测试样本:一个 35岁、常玩手游的狂热玩家(叫周九),他其实是买的(真实值1)。
模型开始预测周九:
- 第一轮:输出 0.5。
- 第二轮:模型看到周九"年龄35岁",又触发了诡异规则 B(年龄>=35 → 残差-0.5)。
- 最终预测:0.5 + (-0.5) = 0。预测"不买"。(大错特错!)
发现了吗?
模型在训练集上,为了强行拟合钱七(一个40岁不买的人),把"年龄>=35"错当成了规律。
到了测试集,遇到周九(35岁想买的人),模型因为这个错误的规律,直接给出了错误的预测。
这就是"训练完美,测试一塌糊涂"的本质:
模型把训练集里偶然的、个别的巧合(噪音),当成了普遍的、必然的规律(信号)去学习。它在训练集上把这种巧合抓得越准(Loss越低),在测试集上违背真实规律就越狠,错得就越离谱。
三、这个公式的物理意义(为啥这么算)
你可能会问:为什么要用"叶子个数"和"权重的平方"来代表复杂度?
- γ T \gamma T γT(惩罚叶子数量 ):树长得越宽,叶子越多,模型越复杂,越容易切分出只包含一个异常样本的叶子。所以叶子越多,罚得越狠。(这就是控制树宽度的)
- 1 2 λ ∑ w j 2 \frac{1}{2}\lambda \sum w_j^2 21λ∑wj2(惩罚叶子权重过大 ):假设某个叶子只落进了一个异常样本(比如那个 40 岁不买皮肤的大叔),为了拟合他,这个叶子算出来的权重 w w w 会非常极端(比如 +5 或者 -5)。平方后变成 25,这就极大地增加了惩罚项。为了降低总 Loss,XGBoost 会被迫把这个叶子的权重缩小(往 0 拉) ,不让它去迎合极端的噪音。(这就是控制树对噪音敏感度的)
总结:
图中那个值( 4 + 0.01 + 1 4 + 0.01 + 1 4+0.01+1),就是这 3 个叶子各自权重的平方。这就是 XGBoost 把"模型有多复杂"这件事,变成了一个可以直接算出来的具体数字,并把它加进目标函数里,逼迫模型在"学数据"和"保持简单"之间做平衡。
四、XGBoost 的四个"刹车片"是怎么生效的?
XGBoost 不是靠一个参数,而是靠四个参数的组合拳来"盲控"噪音的:
1. 限制树深 max_depth(最直接)
比如限制 max_depth=3。这意味着模型最多只能做3次判断。
效果:异常值被迫和其他正常样本挤在一个叶子里,它的"极端残差"被其他正常样本的残差平均掉了。这就是用"欠拟合"的代价,换取了"抗噪音"的能力。
2. 惩罚叶子数量 ( γ (\gamma (γ)(你的笔记里提到的 Gain > ( γ (\gamma (γ))
看你的笔记,分裂条件是 Gain > $(\gamma$)。
假设钱七所在的节点,分不分效果都一样(Gain很小)。如果不加 ( γ (\gamma (γ),模型为了那一点点 Loss 的下降,也会强行分裂去学钱七。加了 ( γ (\gamma (γ),要求"必须带来足够大的收益才允许分裂",直接掐死了那些为了迎合个别噪音而生的无效分裂。
3. 惩罚叶子权重 ( λ (\lambda (λ)(你的笔记里写的 ( w j = G j H j + λ (w_j = \frac{G_j}{H_j+\lambda} (wj=Hj+λGj))
这是最精妙的一步!
假设钱七那个叶子只有他一个人,他的残差是 -0.5。如果不加 ( λ (\lambda (λ),这个叶子的输出权重就是 -0.5(完全迎合噪音)。
加上 ( λ = 10 (\lambda = 10 (λ=10),那么叶子权重 = ( − 0.5 / ( 1 + 10 ) ≈ − 0.045 (-0.5/(1 + 10) \approx -0.045 (−0.5/(1+10)≈−0.045)。
效果:XGBoost 并不禁止树去学钱七,但是它把学到的"极端结论"给大幅度缩水了。即使这棵树记住了钱七,它对最终预测的影响也微乎其微。
4. 学习率 ( ν (\nu (ν) (Shrinkage)
就算前三步都没拦住,最终整棵树的输出还要乘上学习率(比如 0.1)。
效果:就算这棵树学了 100% 的噪音,最终传递到预测值上,也只干扰了 10%。剩下的 90% 还是靠前面那些学到"真实规律"的树撑着。
五、 λ \lambda λ这个值人为设定,怎么知道该设置多少
这些超参数(λ,γ,max_depth)我到底该填几?
没有公式能直接算出该填多少,这些值不是"猜"出来的,而是"试"出来的
在工业界,这个过程叫超参数调优(Hyperparameter Tuning)。下面我把工程师们实战中"怎么试"的完整流程,一步步拆给你看。
第一步:理解"代价"与"收益"(为什么不能乱填)
你图中的公式: Ω = γ T + 1 2 λ ∑ w j 2 \Omega = \gamma T + \frac{1}{2}\lambda \sum w_j^2 Ω=γT+21λ∑wj2
这个公式是加到总目标函数 O b j = 预测误差 + Ω Obj = \text{预测误差} + \Omega Obj=预测误差+Ω 里的。
这意味着存在一场"拔河比赛":
- 如果 λ \lambda λ 设得太大(比如 10000):模型怕惩罚怕得要死,所有叶子权重 w j w_j wj 都被压成 0。模型预测永远是均值,欠拟合(Underfitting),啥也没学会。
- 如果 λ \lambda λ 设得太小(比如 0):模型毫无顾忌,拼命分裂去迎合噪音。过拟合(Overfitting),训练完美,测试崩盘。
- 我们要找的,是中间那个"刚刚好"的平衡点。
第二步:实战怎么找?(四个步骤)
1. 划定一个"合理区间"(凭经验)
虽然不能精确算,但有经验范围(不同数据集有差异,但大致如此):
max_depth(树深):通常在 3 到 10 之间。3 是最常用的起点。learning_rate( ν \nu ν 学习率):通常在 0.01 到 0.3 之间。0.1 是最经典的起点。lambda( λ \lambda λ L2正则):默认 1。如果数据噪音大,可以试 5、10、100。gamma( γ \gamma γ 分裂门槛):默认 0。数据噪音大,可以试 0.1、1、10。
2. 用"验证集"当照妖镜(最关键的一步)
你不能用训练集来试参数,因为训练集永远希望参数越小越好(不惩罚)。你必须切出一部分数据做验证集(Validation Set)。
- 你设 λ = 1 \lambda = 1 λ=1,训练模型,在验证集上跑一下,得到一个误差 E 1 E_1 E1。
- 你设 λ = 10 \lambda = 10 λ=10,重新训练,验证集误差是 E 2 E_2 E2。
- 你设 λ = 100 \lambda = 100 λ=100,验证集误差是 E 3 E_3 E3。
- 对比 E 1 , E 2 , E 3 E_1, E_2, E_3 E1,E2,E3,哪个误差最小,说明那个 λ \lambda λ 最合适。
3. 网格搜索(Grid Search)------ 暴力穷举
这是最笨但最有效的方法。你设定几个候选值,让电脑全部跑一遍:
max_depth候选:3, 4, 5, 6lambda候选:0.1, 1, 10, 50gamma候选:0, 0.1, 1, 5
电脑会把这些参数交叉组合( 4 × 4 × 4 = 64 4\times4\times4 = 64 4×4×4=64 种组合),全部训练一遍,最后告诉你哪组参数在验证集上表现最好。
这就是为什么你在跑 XGBoost 的时候,会觉得训练很慢------有时候机器确实在背后帮你跑了几十上百次实验。
4. 随机搜索与贝叶斯优化(进阶)
网格搜索太慢了,现在实战常用 随机搜索(Random Search) (在区间内随机选参数组合跑)或 贝叶斯优化(Bayesian Optimization) (根据上一次的结果,智能推断下一次该试哪个区间)。比如 Python 的 Optuna 库,就是专门干这个的。
第三步:一个实战调参的"土办法"口诀
如果你拿到一个真实数据集,不知道该从哪下手,按这个顺序试:
- 先把学习率 ν \nu ν 设小(0.05),把树的数量
n_estimators设大(1000棵)。 - 调
max_depth:从 3 开始往上加(4, 5, 6...),盯着验证集误差。什么时候验证集误差开始不降反升,就退回到上一个深度。 - 调 λ \lambda λ 和 γ \gamma γ :如果发现树长得太疯(叶子太多),就加大 λ \lambda λ(比如从 1 加到 10)或者加大 γ \gamma γ(比如从 0 加到 1)。如果验证集误差还在降,就继续加。
- 最后加早停(Early Stopping) :设个
early_stopping_rounds=50。只要验证集误差连续 50 轮不下降,程序自动停止,直接避免后续学噪音。
六、举个列子一步步解释最优叶子权重中 G j G_j Gj和 H j H_j Hj到底是啥(最后写完才知道是对损失函数的二阶泰勒展开)
** w j ∗ = − G j H j + λ w_j^* = -\frac{G_j}{H_j + \lambda} wj∗=−Hj+λGj 看"乘法"是怎么生效的**
机器学习:集成学习4(XGBoost推导)里推导最优叶子权重公式。这是 XGBoost 对叶子权重求导并令其为 0 后,算出的最优叶子权重。
这个公式彻底解释了" λ \lambda λ 是怎么惩罚的":
- G j G_j Gj 是叶子中样本的一阶导之和(残差和)。
- H j H_j Hj 是叶子中样本的二阶导之和(样本个数)。
- λ \lambda λ 被放在分母上。
假设某个叶子只落进了一个极端异常的样本:
- G j = − 5 G_j = -5 Gj=−5(极端残差)
- H j = 1 H_j = 1 Hj=1(只有一个样本)
如果没有 λ \lambda λ:
w j ∗ = − ( − 5 ) / ( 1 + 0 ) = + 5 w_j^* = -(-5)/(1 + 0) = +5 wj∗=−(−5)/(1+0)=+5。模型完美迎合了这个极端噪音。
如果有 λ = 10 \lambda = 10 λ=10:
w j ∗ = − ( − 5 ) / ( 1 + 10 ) = 5 / 11 ≈ + 0.45 w_j^* = -(-5)/(1 + 10) = 5/11 \approx +0.45 wj∗=−(−5)/(1+10)=5/11≈+0.45。
你看!分母里加了 λ \lambda λ,把原本要输出 +5 的极端权重,硬生生"拉回"到了 +0.45。这个叶子对最终预测的修正力度被削弱了 90% 以上。
好戏开始了
开始回顾一下GBDT里面 机器学习:集成学习2(GBDT算法) 中
就是因为损失函数用的是平方损失,所以求导(求梯度)刚好梯度方向就是预测值减去真实值
就是下面这个图片
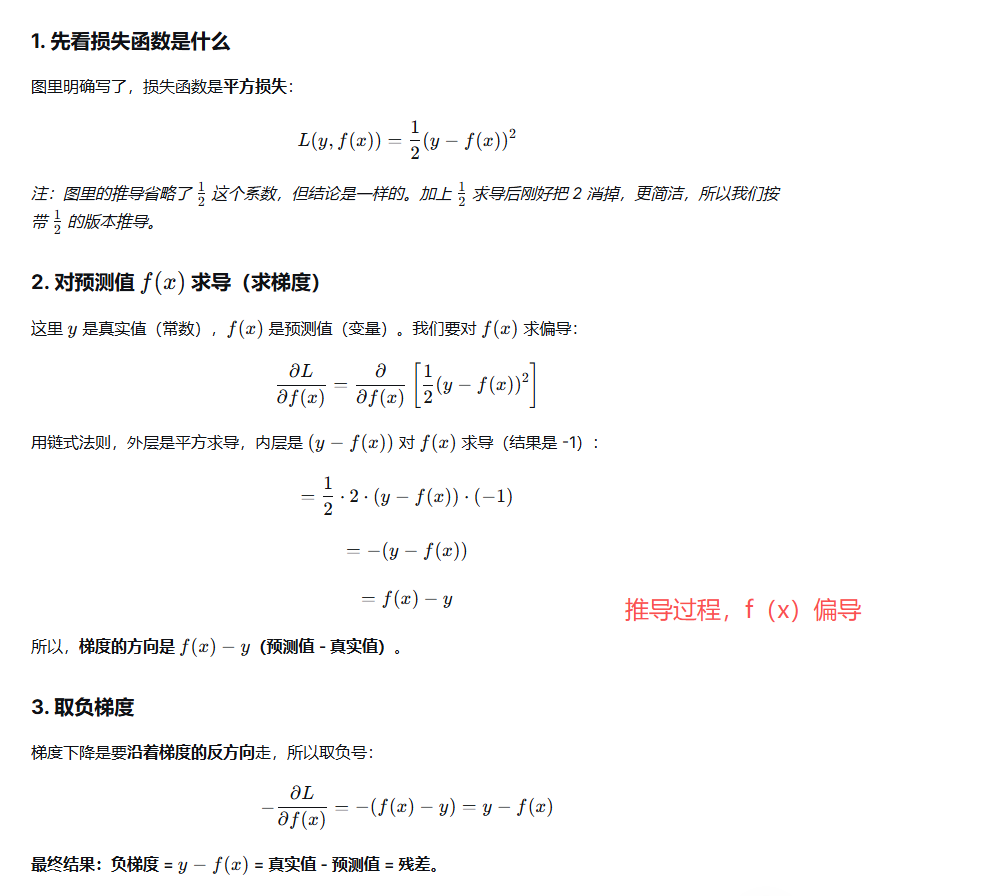
很多人只知道" λ \lambda λ 能惩罚权重",但不知道为什么 G j G_j Gj 是残差和、 H j H_j Hj 是样本个数。
损失函数做了二阶泰勒展开且损失函数是平方损失
损失函数做了二阶泰勒展开
损失函数做了二阶泰勒展开
在 XGBoost 中,为了用牛顿法优化,它把损失函数做了二阶泰勒展开。
简单来说:
- G j G_j Gj(一阶导之和):在当前叶子里的所有样本,它们的残差之和(如果是平方损失,一阶导数就等于残差)。
- H j H_j Hj(二阶导之和):在当前叶子里的所有样本,它们的二阶导数之和。对于平方损失(MSE),二阶导数恒等于 1,所以 H j H_j Hj 恰好就是样本个数。
核心规律:
w j ∗ = − 残差之和 样本个数 + λ w_j^* = - \frac{\text{残差之和}}{\text{样本个数} + \lambda} wj∗=−样本个数+λ残差之和
这个公式其实就是"平均残差"加了一个分母的"防噪阻尼"。
一、一步步举例:为什么是残差和与样本个数?
假设我们正在训练第 t t t 棵树,这一轮的目标值(Target)是上一轮的残差。
我们假设现在有一个叶子节点,里面落进了 3 个样本。它们这一轮的残差(也就是目标值)分别是:
- 样本A:残差 = +2
- 样本B:残差 = +4
- 样本C:残差 = -2
我们来看看 G j G_j Gj 和 H j H_j Hj 是多少,以及它怎么算最优权重(输出值)。
1. 传统 GBDT(没有正则化 λ \lambda λ)怎么算叶子权重(输出值)?
在没有 XGBoost 的正则项之前,传统 GBDT 算这个叶子输出值的方式极其简单粗暴:直接求残差的平均值。
w j = 2 + 4 + ( − 2 ) 3 = 4 3 ≈ 1.33 w_j = \frac{2 + 4 + (-2)}{3} = \frac{4}{3} \approx 1.33 wj=32+4+(−2)=34≈1.33
2. 把这个过程翻译成 XGBoost 的语言(代入公式)
现在我们把上面的算术,套进 XGBoost 的 G j G_j Gj 和 H j H_j Hj 公式里:
- G j G_j Gj(残差之和) = 2 + 4 + ( − 2 ) = + 4 = 2 + 4 + (-2) = +4 =2+4+(−2)=+4
- H j H_j Hj(样本个数) = 1 + 1 + 1 = 3 = 1 + 1 + 1 = 3 =1+1+1=3
代公式(假设暂时没有 λ \lambda λ,即 λ = 0 \lambda = 0 λ=0):
w j ∗ = − G j H j = − 4 3 ≈ − 1.33 w_j^* = - \frac{G_j}{H_j} = - \frac{4}{3} \approx -1.33 wj∗=−HjGj=−34≈−1.33
注意:为什么这里有个负号?
因为在梯度提升中,我们要往梯度的反方向走。上一轮的残差 y − y ^ y - \hat{y} y−y^ 是正梯度方向,我们要减去它(也就是加上负梯度),所以公式里带个负号,算出来正好和传统方法一样。
结论: G j G_j Gj 和 H j H_j Hj 并不是凭空捏造的,它们就是把"残差求和"和"样本计数"换了个高等数学(泰勒展开)的外衣。
二、加上 λ \lambda λ,威力是怎么爆发的?
现在我们把 λ \lambda λ 加进去,看看它是怎么"防噪"的。
场景 1:叶子里的样本很多(很安全,噪音被平均了)
假设一个叶子有 100 个样本,残差之和 G j = 50 G_j = 50 Gj=50。
- 没入 λ \lambda λ 时: w = − 50 100 = − 0.5 w = - \frac{50}{100} = -0.5 w=−10050=−0.5
- 有 λ = 10 \lambda = 10 λ=10 时: w = − 50 100 + 10 = − 0.45 w = - \frac{50}{100+10} = -0.45 w=−100+1050=−0.45
变化不大。因为样本多,个别噪音影响不大,分母的 100 已经足够大了, λ \lambda λ 只是个零头。
场景 2:叶子里的样本极少(极度危险,噪音把持了这里)
假设这个叶子只有 1 个极端的异常样本,它的残差是 G j = 10 G_j = 10 Gj=10(极大的正残差)。
- 没有 λ \lambda λ: w = − 10 1 = − 10 w = - \frac{10}{1} = -10 w=−110=−10。
- 模型完美迎和了这个噪音!预测值被强行拉低了 10。
- 加上 λ = 10 \lambda = 10 λ=10: w = − 10 1 + 10 = − 0.91 w = - \frac{10}{1+10} = -0.91 w=−1+1010=−0.91。
- 你看!原本要输出 -10 的极端权重,被 λ \lambda λ 硬生生拉到了 -0.91!修正力度削弱了 90% 以上!
这就是 λ \lambda λ 的物理意义:
λ \lambda λ 就像一个"杠杆 "。样本越少( H j H_j Hj 越小),分母小, λ \lambda λ 在分母里的占比就越大,对权重的压制就越狠。它专门用来对付那些"靠少数几个样本就敢给出极端预测"的叶子。