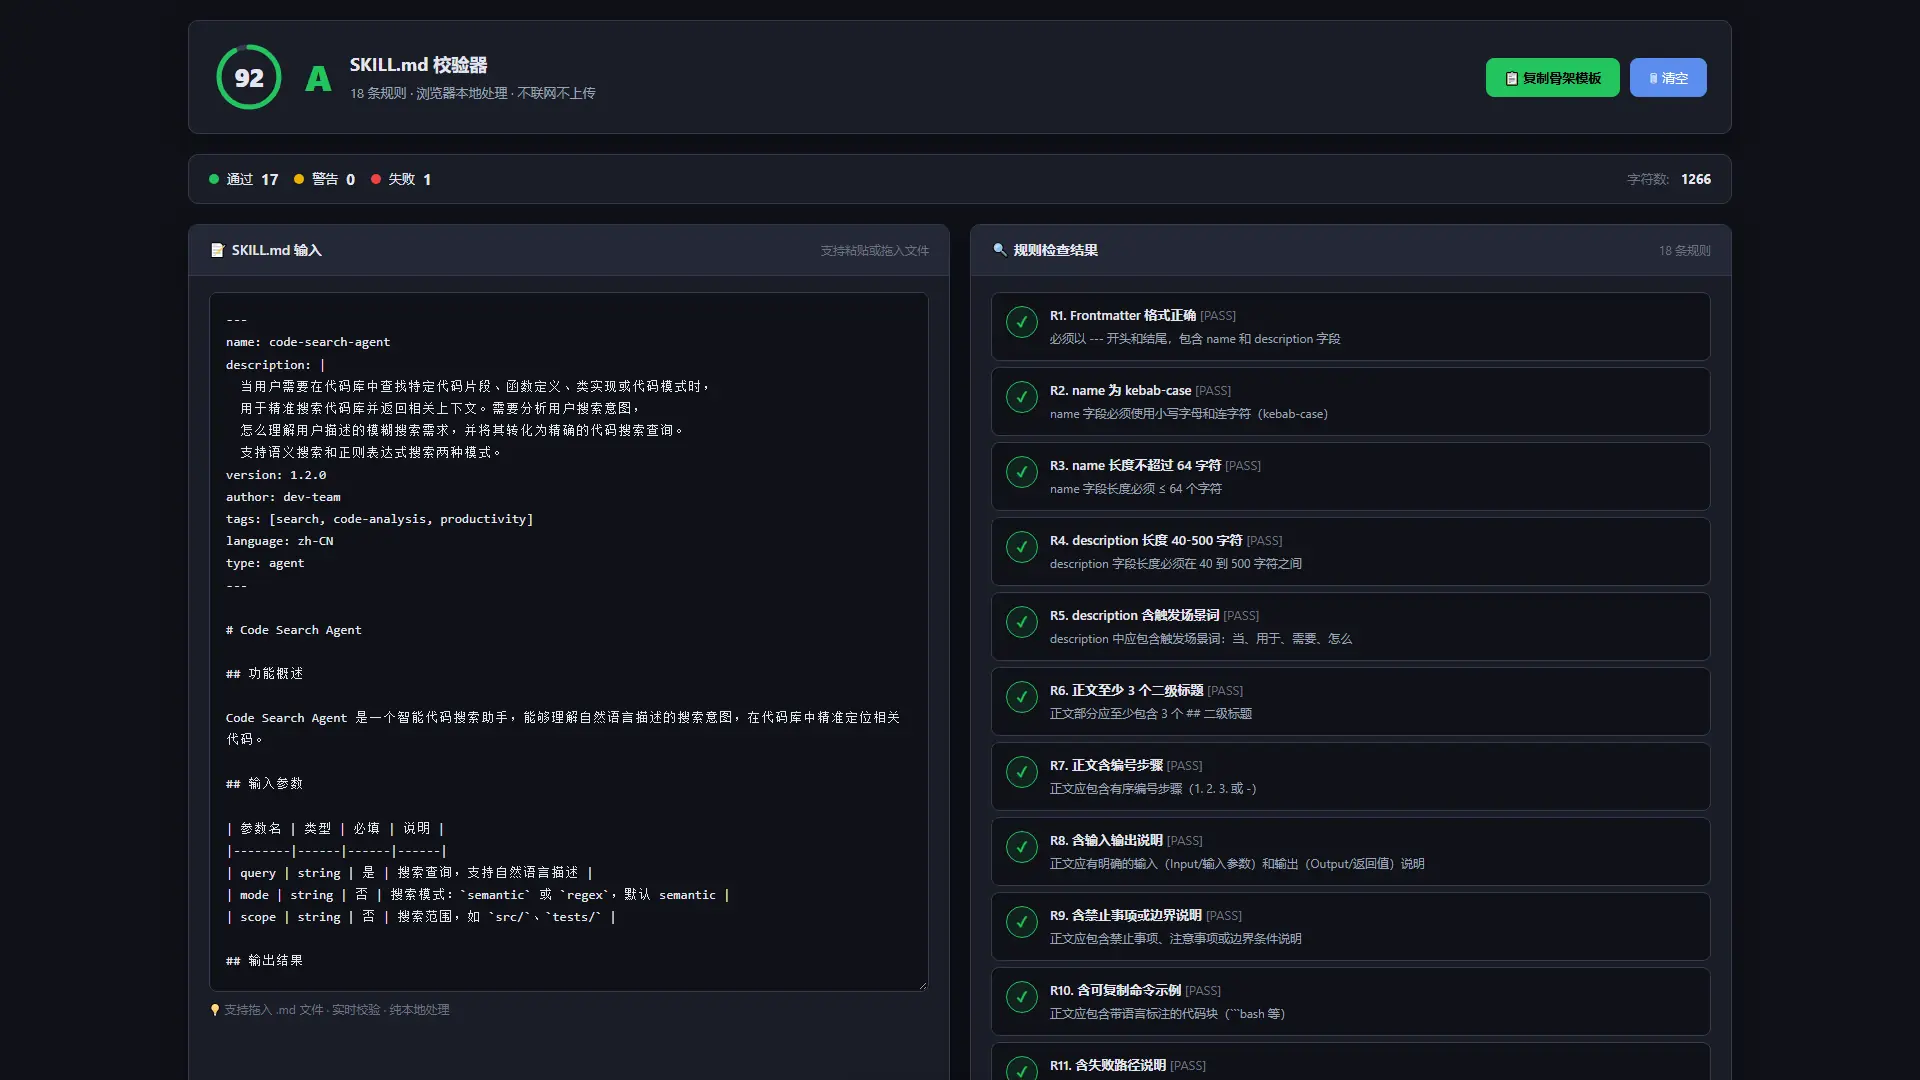
同一份 SKILL.md,只改一个字段的写法,得分能差 60 多分。我把「一份 SKILL.md 该有什么」拆成 18 条可判定规则,做成一个单文件校验器:粘贴或选中文件就能跑,分数、每条规则的结论、修复建议一屏给全。三份真材料的实测结果:规范样例 92 分(A)、故意写坏的问题样例 29 分(F)、缺 frontmatter 的普通 Markdown 30 分(F)。
分数不是拍脑袋给的:100 分起扣,每条 FAIL 扣 8 分、每条 WARN 扣 3 分,上面三组数字都能手算复现(第五节有复算过程)。成品只有一个 index.html(42 KB),双击就能跑,不联网、不上传内容、不引第三方库。
先把边界说清楚:这是个文档结构检查器,不是自然语言质量评分器。它判得了「description 是不是 40-500 字符」「有没有编号步骤」,判不了「换一种说法 Agent 是不是更容易命中」。18 条规则来自 SKILL.md 的通行写法,不是某个官方标准的等价物。
一、先看结果:三份材料、三个分数、18 条规则
三份输入在同一台机器、同一个页面上连续跑出来的结果:
| 输入材料 | 字符数 | 分数 | 等级 | PASS / WARN / FAIL | 手算复检 |
|---|---|---|---|---|---|
| 规范样例(code-search-agent 风格的 SKILL.md) | 1266 | 92 | A | 17 / 0 / 1 | 100 − 8 = 92 ✔ |
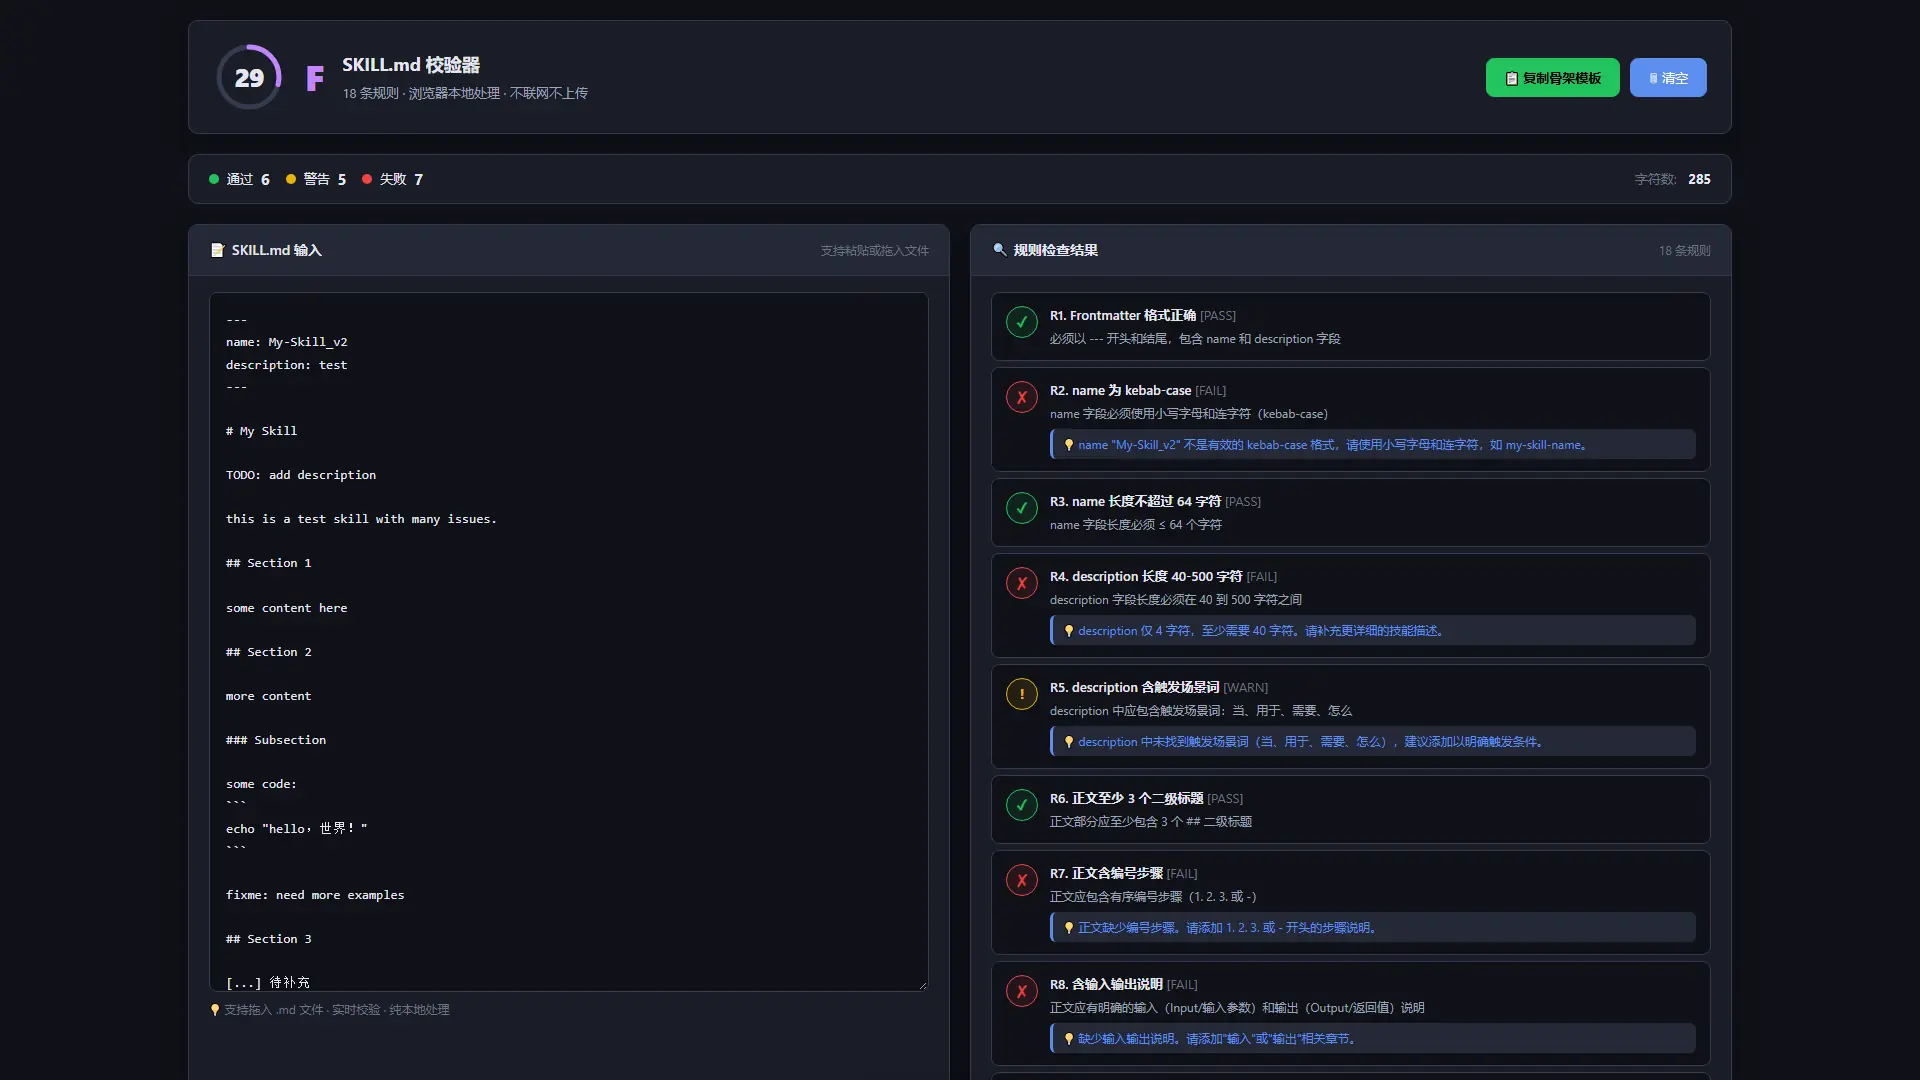
| 问题样例(name 写成 My-Skill_v2、description 只有 test) | 285 | 29 | F | 6 / 5 / 7 | 100 − 7×8 − 5×3 = 29 ✔ |
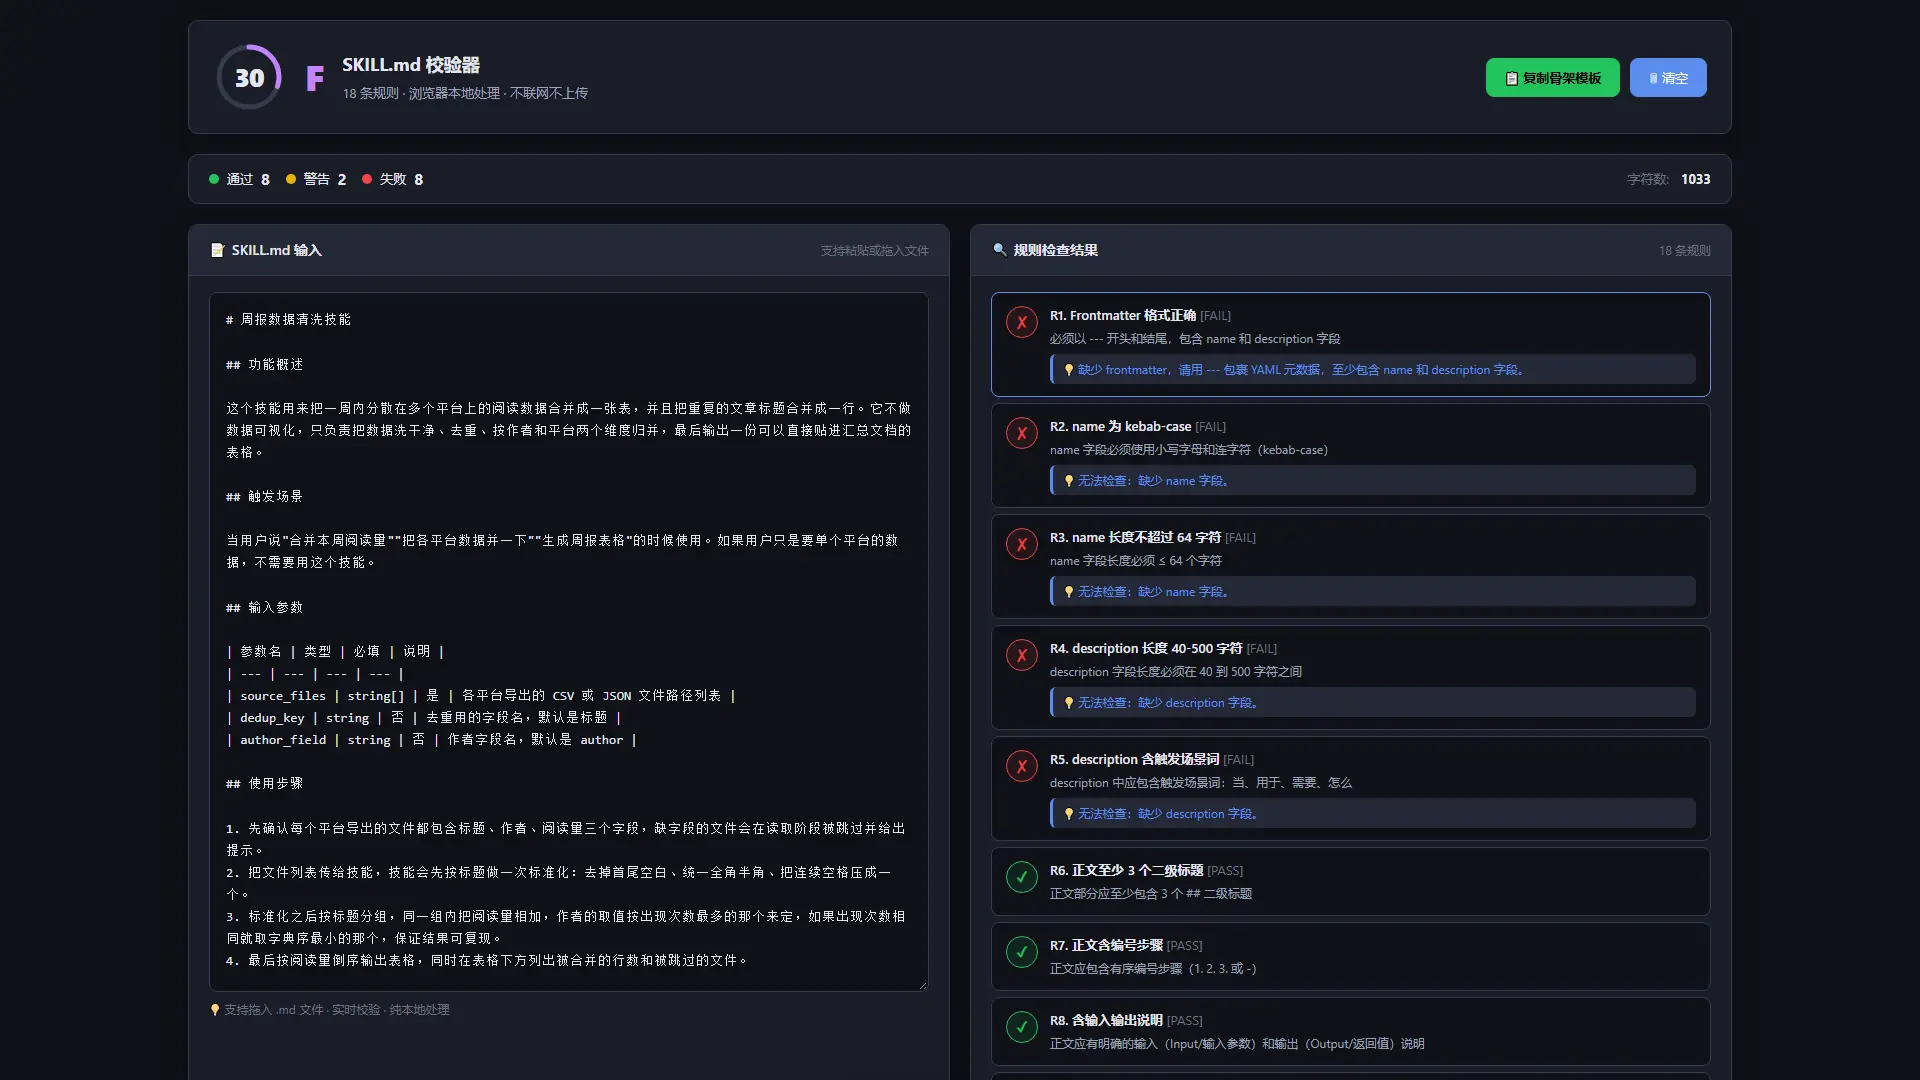
| 缺 frontmatter 的普通 Markdown(周报数据清洗技能) | 1033 | 30 | F | 8 / 2 / 8 | 100 − 8×8 − 2×3 = 30 ✔ |
等级线是 A ≥ 90、B ≥ 75、C ≥ 60、D ≥ 40,再低是 F。所以「92 分」不是加权平均出来的感觉分,就是一个 FAIL 的价钱。18 条规则按管的事分四组:
| 分组 | 规则编号 | 条数 | 管什么 |
|---|---|---|---|
| Frontmatter 元数据 | R1--R5、R15 | 6 | 开头 YAML 块能不能被解析、name 是不是 kebab-case 且不超过 64 字符、description 是不是 40--500 字符且带触发场景词、有没有多余字段 |
| 正文结构 | R6、R7、R12、R16、R17 | 5 | 至少 3 个二级标题、有编号步骤、总长度 1500--20000 字符、带使用示例、标题层级不跳级 |
| 可执行信息 | R8、R10、R14 | 3 | 输入输出说明、可复制的命令示例、命令行里不能出现全角标点 |
| 边界与诚实度 | R9、R11、R13、R18 | 4 | 禁止事项或边界说明、失败路径说明、没有 TODO 与占位符、带版本或日期 |
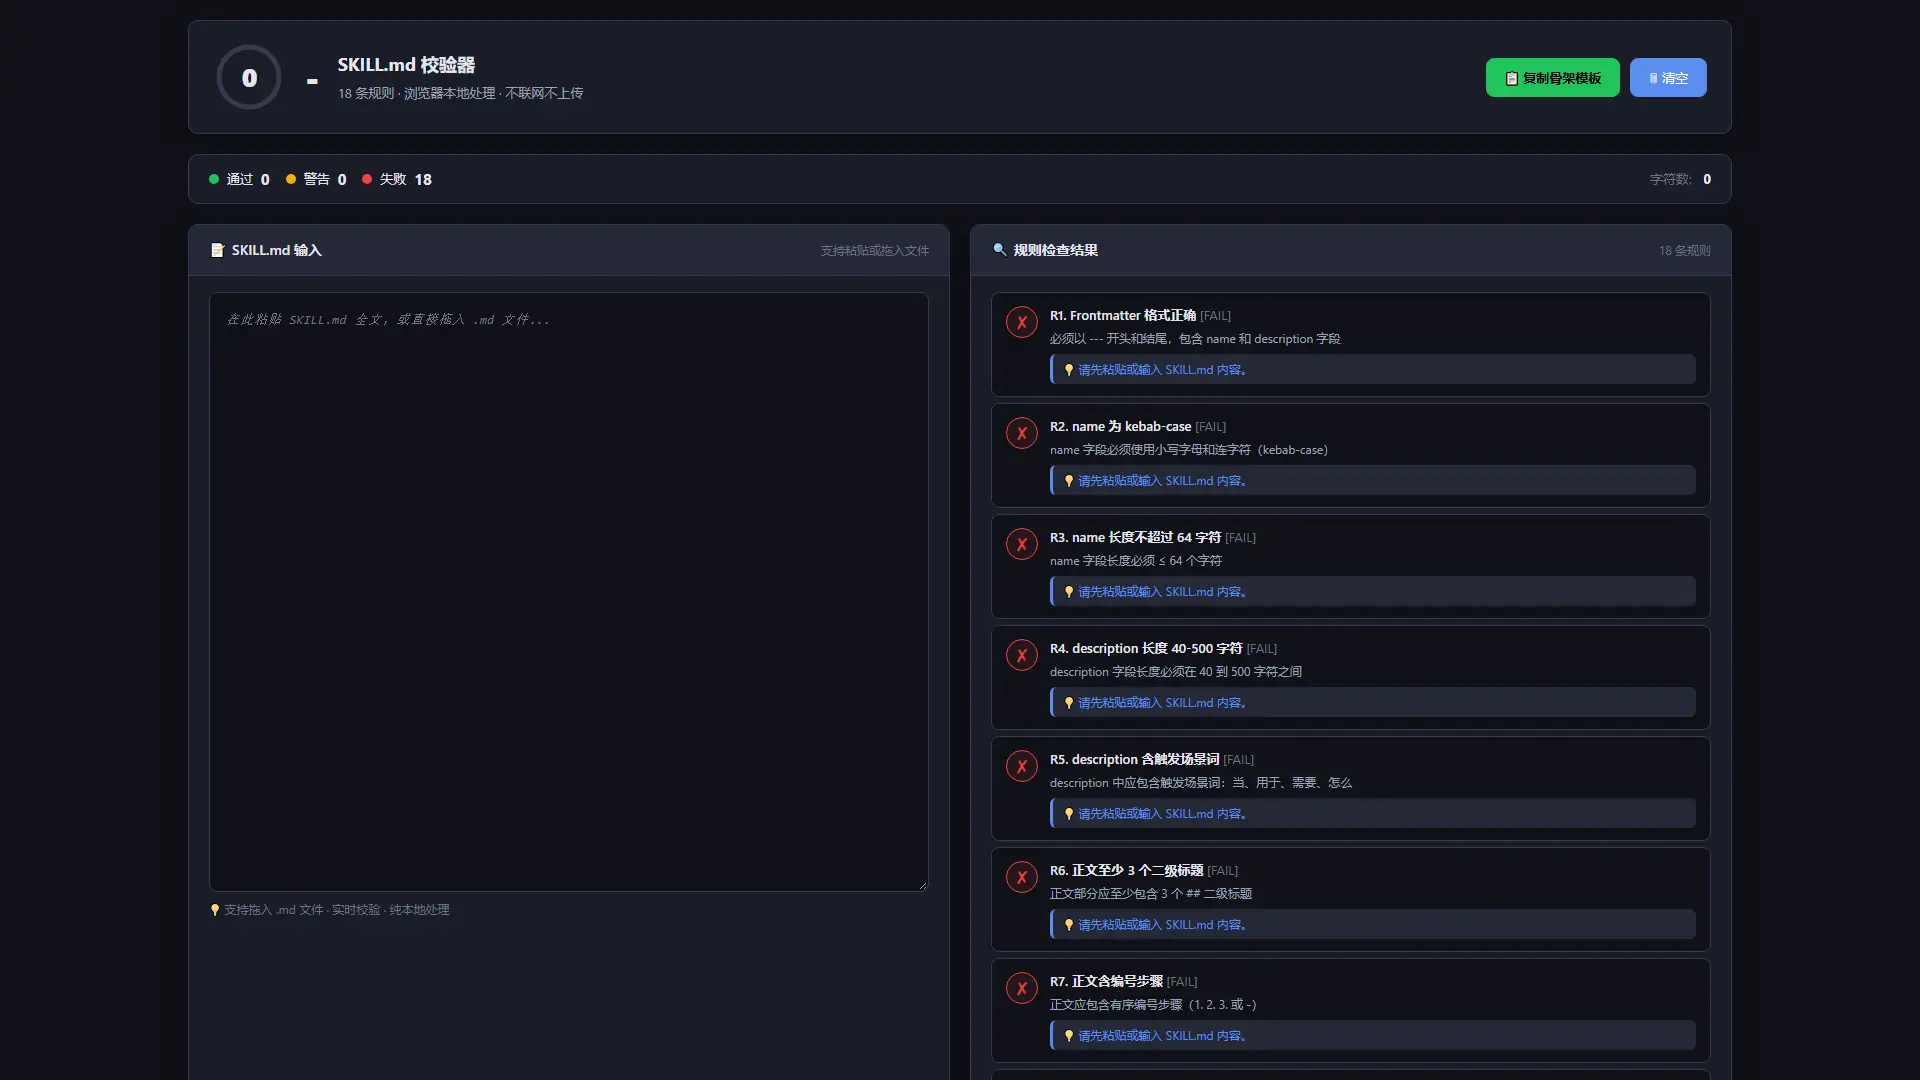
空输入也照跑,不弹错、不白屏:0 分、18 条 FAIL,每条建议都是「请先粘贴或输入 SKILL.md 内容」这种能直接照做的话。校验器最怕的是遇到坏输入就静默,所以「任意输入都必须有结论」是我写进需求的第一条。
二、为什么值得看:SKILL.md 是 Agent 的入口,但它没有编译器
这几天刷技术社区,Agent 和 Skill 工程化是出现频率最高的两个词。大部分讨论都停在「怎么写更好」,但真正让人卡住的是一件更具体的事:SKILL.md 写错了不会报错。
代码写错,编译器会拦你;配置写错,启动会失败;而一份描述写得含糊的 Skill,表现只是「Agent 不用它」或者「用了但不是你想要的效果」。没有报错、没有堆栈、没有失败提示------唯一的反馈是沉默。于是「我的 Skill 为什么不生效」这类问题在社区里反复出现,答案往往落在一个很小的细节上:name 里带了大写和下划线、description 里没有触发场景词、正文里还留着 TODO。
这类问题的共性是可判定。既然可判定,就不该靠人肉记忆。我把 18 条规则从「经验」翻译成「断言」,好处有三个:分数可以对比(改前 29、改后 92)、问题可以定位(FAIL 到具体第几条)、修复有指引(每条 FAIL 都带一句建议)。它解决的不是「写得漂亮」,而是「写得不合格时你能立刻知道」。
三、准备环境:进入码道 Web,把需求写成一份可验收清单
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。本文用的是 WebUI 版。浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat?source...,登录后就能在对话窗口输入需求,不需要装软件。
需求是这么写的(节选,规则部分逐条列全):做一个单文件 index.html 的 SKILL.md 校验器,中文界面、零外部依赖、不联网、双击可跑。18 条规则逐条实现:R1 frontmatter 格式正确、R2 name 为 kebab-case......每条规则的判定必须给出「实测值」,不能只给 PASS 或 FAIL;页面里要有自检面板,至少 13 条断言并显示实测值;失败路径要写清空输入与超长输入的处理,页面不能白屏;所有文案用中文,不出现英文占位符和 TODO。完成后打开预览。
这段需求里有三句话最值钱,后来都变成了文章里的证据:
- 「每条规则要给出实测值」。只写 PASS/FAIL,事后你没法核对自己算的对不对;写上「description 仅 4 字符,至少需要 40 字符」,一眼就能反推。
- 「页面里要有自检面板」。让页面自己证明自己,而不是让我去猜它有没有跑对。
- 「失败路径写清楚」。坏输入的表现必须被设计,不能被撞见。
四、验证与踩坑:交付的页面我先在本机跑了一遍,修掉 7 处真缺陷
交付的页面能打开,不等于它对。我把页面拉回本机逐条核对,一共修了 7 处真缺陷------没有一处是美化,全都是「不修就出错误结论」:
| # | 现象 | 根因 | 改法 |
|---|------------------------------------|----------------------------------------------------------------------------------|-----------------------------------|-----------|-------------|--------------------------|
| 1 | 页面完全没反应,控制台一片红 | 正则后面多打了两个字母,test(fm.name)me)) 不是合法 JS | 删掉多余字符,整个页面才能跑 |
| 2 | 规范样例只拿 81 分,description 相关 3 条规则全红 | 解析器只认单行 key: value,遇到 YAML 块标量 `description: | 时把 description 读成了字符串 | `(1 个字符) | 重写解析器,支持 ` | 与>` 块标量,读到下一个 key 为止 |
| 3 | 同一份文件,重新粘贴一次分数从 92 掉到 44 | 编辑器 CSS 是 white-space: normal,contenteditable 的 innerText 会吃掉行首缩进、把多个空格折叠成一个 | 改成 white-space: pre-wrap,缩进原样保留 |
| 4 | Windows 上另存的 .md 一律 44 分 | 文件是 CRLF,行尾的 \r 让所有按行判断的规则失效 | 校验入口先把 \r\n 统一成 \n |
| 5 | 点空白编辑器打不开文件选择器 | <input type="fil"file">,属性值被写坏 | 改成 type="file" |
| 6 | 页面渲染不出来,源码里全是反斜杠 | 模板字符串的反引号被转义成 \``(46 处),插值也写成了 ${`(19 处) | 全部还原成正常的模板字符串 |
| 7 | 命令行检查误报全角标点 | 字符串里混进了裸单引号,判定用的字符集把英文引号也当成了全角标点 | 改成只匹配中文全角标点 |
第 2 处和第 4 处是最值的两条,因为它们都属于「代码能跑,但结论是错的」。第 2 处的修复只有十几行:
js
// 之前:只认单行 key: value,description: | 会被读成字符串 "|"
const m = line.match(/^(\w+):\s*(.*)$/);
fm[m[1]] = m[2];

// 之后:遇到 | 或 > 就继续往下读缩进块,直到下一个 key
if (value === '|' || value === '>') {
  const buf = [];
  while (i + 1 < lines.length && /^\s+\S/.test(lines[i + 1])) buf.push(lines[++i].trim());
  fm[key] = buf.join('\n');
}
修完之后,规范样例从 81 分变成 92 分;CRLF 归一化让同一份文件在 Windows 上不再掉分。也正是因为这两处,文章里所有分数都注明「字符数」,因为规则 R12(总长度 1500-20000 字符)对短文件是真的会扣分------图 1 里那个唯一的 FAIL 就是它:规范样例只有 1266 字符,差 234 字符,不是误判。
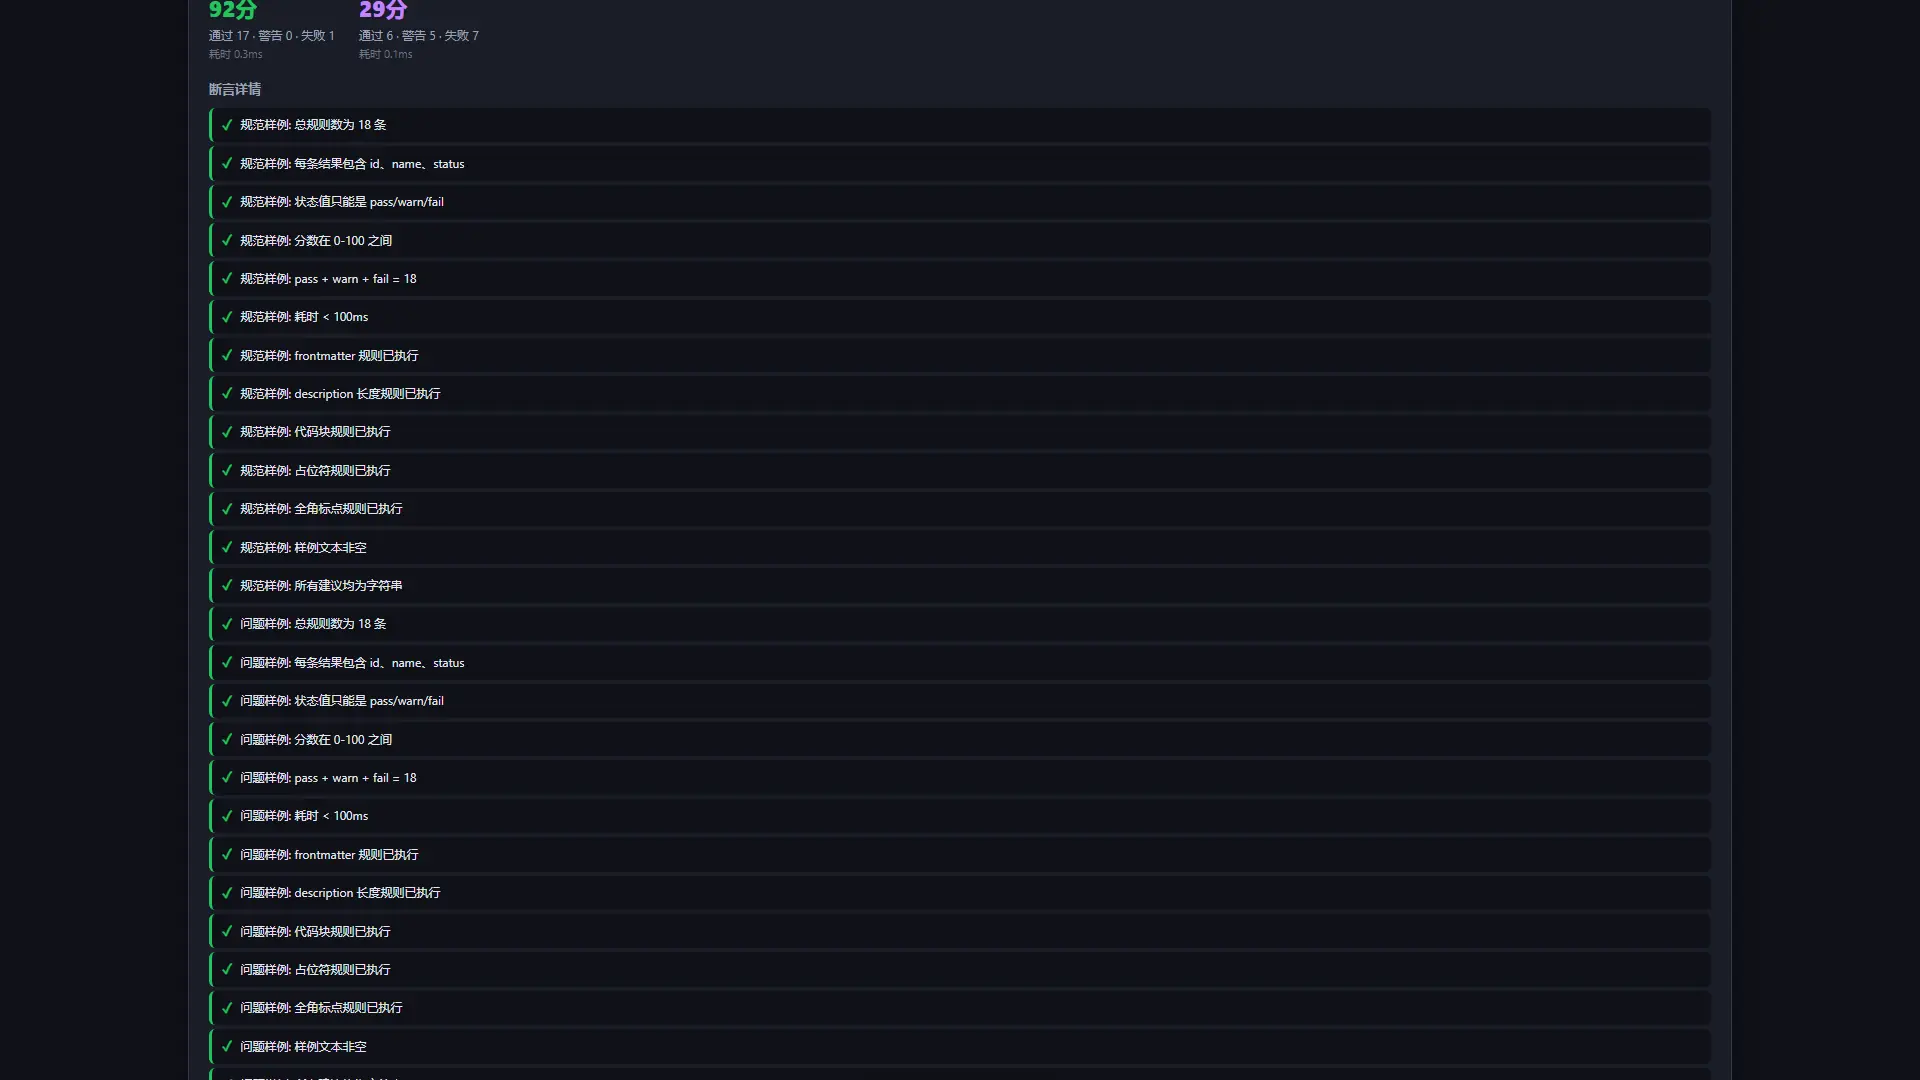
页面自己带的断言面板也是核对手段之一:两个样例各跑 13 条断言,一共 26 条,全部通过(26/26)。断言不看主观判断,只看结构事实------「总规则数为 18 条」「每条结果包含 id、name、status」「状态值只能是 pass/warn/fail」「分数在 0-100 之间」「pass + warn + fail = 18」「耗时 < 100ms」。两份样例跑完的耗时是 0.3ms 和 0.1ms。
失败路径实测:空输入给 0 分、18 条 FAIL、等级「-」,不抛错也不白屏;上传非文本文件是它真实的短板------文件选择器没有做类型校验,选一张 PNG 会被当文本读进来(74250 个字符、5 分、F)。这不是设计取舍,是没做,我把它留在这里当已知问题。
五、本地复现:三条命令核对全部数字
成品是单文件,复现不需要装任何东西:
bash
python -m http.server 8000
# 浏览器打开 http://localhost:8000/index.html
# 逐个载入规范样例、问题样例,对照上表的字符数与分数
复算过程也很直白:92 = 100 − 8×1;29 = 100 − 8×7 − 3×5;30 = 100 − 8×8 − 3×2。三组数字和页面上的 PASS/WARN/FAIL 计数一一对应,没有第四种算法参与。如果你自己改一条规则,记得同步改断言里「总规则数为 18 条」那一项,否则自检面板会立刻变红------这就是断言面板的意义。
六、使用码道体会:把「可验证」写进需求
这一轮下来,有 6 条经验值得留下:
- 需求里写清「输出格式」,不只是「输出内容」。要求「每条规则给实测值」,交付物才可核对;否则拿到的是一屏 PASS/FAIL,你说不清它对不对。
- 把自检写进需求。要求页面自带断言面板,等于让它自己对账;26 条断言比任何一句话的「已完成」都可信。
- 边界当成验收项写。空输入、超长输入、非法值各写一行要求,比事后自己补缺陷便宜得多。
- 交付后逐条对照需求核,而不是「能打开就行」。这轮 7 处缺陷里有 5 处属于「页面能打开、逻辑是错的」,只看截图一个都发现不了。
- 「零依赖、不联网」要明确写。不写清楚,很容易塞进一个 CDN 字体或外部图标库,离线场景直接崩。
- 规则明确的小工具特别适合这种协作方式。需求里把 18 条规则列清楚,一遍就能交付到接近可用的程度;反过来,规则含糊时,改起来就是反复来回。
七、结论与下一步
18 条规则、三组可复算的分数、7 处真缺陷、26 条断言,构成了这份 SKILL.md 校验器的全部底账。它不能替你写出更好的描述,但能在你把描述写坏的时候立刻告诉你坏在哪一条、差多少个字符、该怎么改。对一份「写错了不会报错」的文档来说,这已经是最有价值的那部分了。
公开仓库:atomgit.com/deli007/dem...;本案例目录:atomgit.com/deli007/dem...。下一步想做两件事:把 18 条规则做成可开关的规则包,以及支持一次选中整个目录批量校验,把「写完一篇就查一篇」变成「提交前查一遍」。