【Manacher 算法】
- Manacher 算法(谐音:马拉车算法),可以在 (O(n)) 时间内,维护出字符串以任何一个位置为中心时的最长回文串的长度。
一、相关概念
【回文字符串】
- 正着读和反着读都一样的字符串就是回文字符串; 或者可以在中心位置画线,如果左右对称,就是回文字符串。 如果回文串的长度为奇数,则称为奇回文串 ;如果回文串的长度为偶数,则称为偶回文串。
【回文子串】
- 字符串中的某个子串如果是回文,那么就是回文子串。 其中,所有回文子串中长度最长的被称为最长回文子串。
【性质】
- 如果一个字符串是回文串,那么依次删掉左右两个字符后,依旧是回文。 证明比较简单,根据对称性易得。 有了这个性质,当我们知道以某个点为中心的最长回文子串之后,就能找到以这个点为中心的所有回文串。
【回文中心和回文半径】
- 回文中心,用 c 表示,顾名思义,就是回文串最中心的位置。
如果是奇回文串,回文中心在 (n + 1) / 2,如:"abcba";
如果是偶回文串,回文中心在 (n / 2, (n + 1) / 2) 之间,如:"aabbaa"。
- 回文半径,用 d 表示,表示回文中心到回文左右端点的距离。 例如,回文串 "abcba" 的回文半径为 3;回文串 "aabbaa" 的回文半径也是 3。
有了回文中心和回文半径,就可以在字符串中表示出一个回文子串。 例如,在字符串 "caababaae" 中,有一个 c=5,d=4 的回文子串。
二、中心扩展算法
对于回文串,我们经常会解决如下问题:
- 问题一:在一个字符串中,找出所有的回文子串。
- 问题二:在一个字符串中,找出最长的回文子串。
两个问题可以看做同一个问题,因为只要能找出所有的回文子串,肯定也能找出最长的回文子串。
中心扩散算法可以在 O(n^2) 时间内解决上述问题,算法原理很简单:
- 从前往后遍历字符串,以 si 或 si 与 si+1 的中间作为回文串的中心位置;
- 从中间位置开始,枚举半径长度,逐渐向两边扩展,找出以该点为中心的最长回文子串。
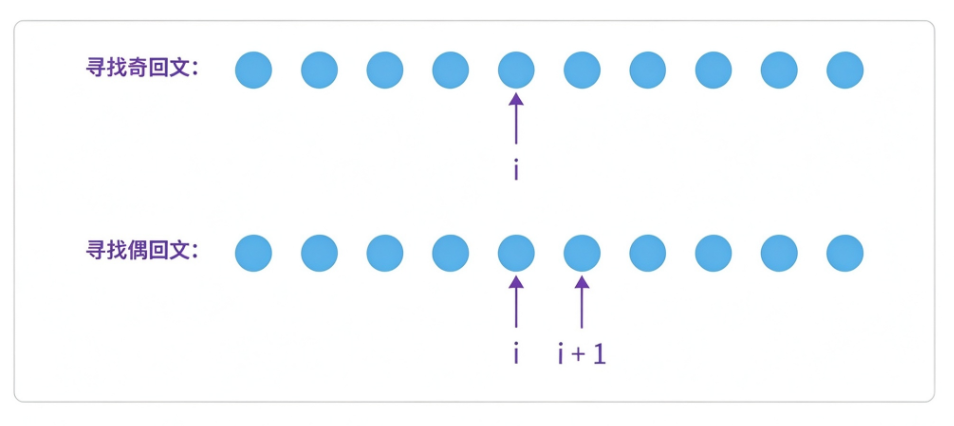
寻找奇回文:以单个点 i 为中心
寻找偶回文:以 i 和 i+1 中间为中心
我们发现,奇偶回文会让我们在找回文串时分情况讨论。为了避免这种情况,我们一般会先把字符串预处理一下,使所有的回文子串都变成奇回文串。 因为奇回文串通常比偶回文串好处理:它只有一个中心,而且可以从中心向两边一步一步扩展得到。
【预处理字符串】
- 在相邻字符之间和整个字符串的两端任意加入一个字符,一般会选择加入
#。 例如,字符串 s="aabbaa"经过预处理之后就变成:s`="#a#a#b#b#a#a#"。
经过预处理之后:
- 本来是奇回文串,处理之后依旧是奇回文串。例如
"bab"处理后为"#b#a#b#"; - 本来是偶回文串,处理之后就变成奇回文串。例如
"abba"处理后为"#a#b#b#a#";
此时,在处理之后的串上跑中心扩展算法时,由于所有的回文串都是奇回文串,仅需枚举所有中心点,即可找到所有的回文串。
注意,不用加入一个不会出现的字符,这里可以加入任意字符。 因为判断回文的时候,只会原始字符和原始字符判断,新加入的字符和新加入的字符判断。因此,可以加入任意字符。
代码实现
cpp
string t, s;
int m, n;

// 以求解最长回文子串为例
int fun()
{
    // 预处理字符串
    cin >> t; m = t.size();
    s += " ";
    for(auto ch : t)
    {
        s += '#';
        s += ch;
    }
    s += "##";
    n = s.size() - 2;

    int ret = 1;
    //中心扩展法
    for(int i = 1; i <= n; i++)
    {
        int d = 1; // 枚举向右向左的距离
        while(s[i - d] == s[i + d]) d++;
        ret = max(ret, d - 1);
    }
    return ret;
}
时间复杂度:
- 根据算法流程,时间复杂度显然是 O(n^2)。
三、Manacher 算法
【解决问题】
- 问题一:在一个字符串中,找出所有的回文子串。
- 问题二:在一个字符串中,找出最长的回文子串。
【回文半径数组】
- 数组 di 表示:以 i 为中心的最长回文半径。
例如,字符串 "#a#a#a#b#a#",它的回文半径数组如下:
| 字符串 | # | a | # | a | # | a | # | b | # | a | # |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 下标 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 |
| 回文半径 d | 1 | 2 | 3 | 4 | 3 | 2 | 1 | 4 | 1 | 2 | 1 |
通过与原字符串比较可得如下两个性质:
- 原始字符串中,对应的回文串的长度为 di-1;
- 原始字符串中,对应位置为中心的回文串有 di / 2个。
比如 d4=4,在原始字符串中,对应位置的最长回文的长度为 3,对应位置为中心的回文串有 2 个。
【最右回文串 - 加速盒子】
这是这个算法第一个精妙的地方。
【最右回文串 - 加速盒子】
- 最右回文串:从前往后填表的过程中,能够找到的右端点最靠右的回文子串,用区间 l,r 维护。
- 一般用这个最右回文串来加速我们的填表,因此这个字符串也被称为加速盒子。
例如,生成字符串
"#a#a#a#b#a#"的回文半径数组时,我们依次维护的最右回文串的区间为:1,1 -> 1,3 -> 1,5 -> 1,7 -> 1,7 -> 1,7 -> 1,7 -> 5,11 -> 5,11 ...
index i: 1 2 3 4 5 6 7 8 9
【Manacher 算法 - 利用最右回文串加速更新回文半径数组】
算法流程,主要是分类讨论:
从前往后填表,当填到 di 时,d1 到 di-1 均已经填好,并且维护最右回文串 l,r。当填写 di 时,分下面两大类,四种情况讨论:
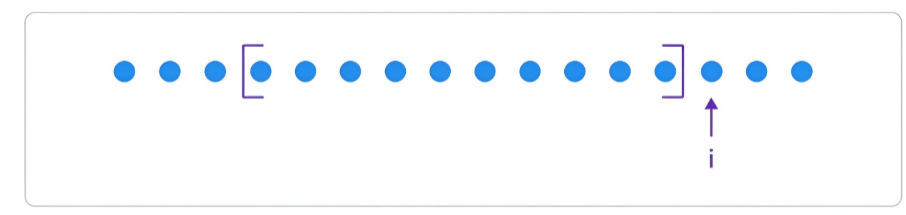
**i > r,**也就是当前点没有在最右回文串中。此时,d1 到 di-1 的回文信息提供不了任何帮助。 直接以 i 为中心暴力扩展(与中心扩展算法一致);
i <= r,也就是当前点在最右回文串中,根据对称点 j = r - i + l 的回文半径 dj,分三种情况讨论:
a. dj < r - i + 1,即以 j 为中心的最长回文串被 l,r 完全包含:
根据回文串的特性,此时 di = dj = dr - i + l。
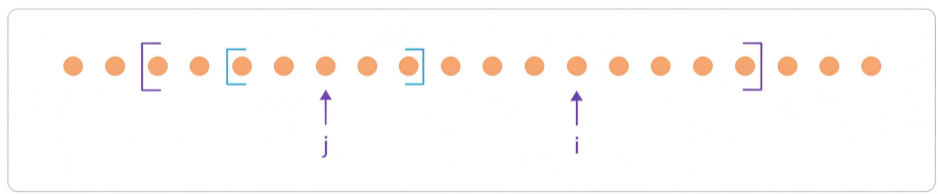
b. dj > r - i + 1 ,即以 j 为中心的最长回文串的左边界越过了 l:
根据回文串的特性,此时 di = r - i + 1。
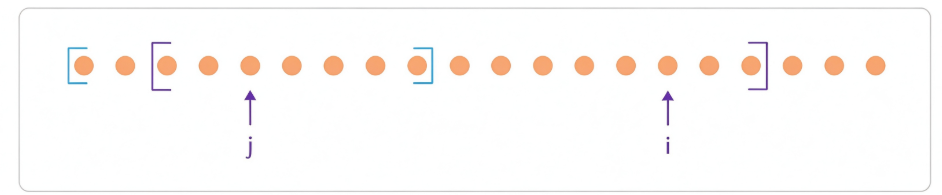
c. dj = r - i + 1,即以 j 为中心的最长回文串的左边界正好在 l 位置:
此时 di 至少为 dj,但是还有可能继续向外扩展。那就从长度 dj 开始,暴力向外扩。
每次分类讨论计算完 di 之后,都要判断是否更新最右回文串 l,r。
时间复杂度:
- 注意到,在整个算法执行的过程中 r 是不会回退的,相当于 (i, r) 两个指针不回退的向后移动。 因此整个时间复杂度为 O(n)。
代码实现:
这是这个算法第二个精妙的地方,四行代码,就可以把上述所有情况全部考虑进去。
cpp
string t, s;
int n, d[N];

void init()
{
    cin >> t;
    s = " ";
    for(auto ch : t)
    {
        s += '#';
        s += ch;
    }
    s += "##";
    n = s.size() - 2;
}

void get_d()
{
    d[1] = 1; // 初始化
    for(int i = 2, l = 1, r = 1; i <= n; i++)
    {
        int len = r >= i ? min(d[r - i + l], r - i + 1) : 1;
        while(s[i + len] == s[i - len]) len++;
        if(i + len - 1 > r) r = i + len - 1, l = i - len + 1;
        d[i] = len;
    }
}
四、模板题
代码:
cpp
#include <bits/stdc++.h>
using namespace std;

#define endl '\n'
#define int long long

const int mod = 1e9 + 7;
const int MOD = 998244353;

const int N = 2.2e7 + 10;
int d[N];
void solve()
{
    string a; cin >> a;
    string s = " ";
    int n = a.size();
    for(auto e : a)
    {
        s += '#';
        s += e;
    }
    s += "##";
    n = s.size() - 2;
    d[1] = 1;
    int ret = -1;
    for(int i = 2, l = 1, r = 1; i <= n; i++)
    {
        int len = r >= i ? min(r - i + 1, d[r - i + l]) : 1;
        while(s[i + len] == s[i - len]) len++;
        d[i] = len;
        if(i + len - 1 > r) r = i + len - 1, l = i - len + 1;
        ret = max(ret, d[i] - 1);
    }
    cout << ret << endl;
}

signed main()
{
    ios::sync_with_stdio(false);
    cin.tie(nullptr);
    int _ = 1;
    // cin >> _;
    while(_--)
    {
        solve();
    }
    return 0;
}