目录
[1. 这个工程可以做什么](#1. 这个工程可以做什么)
[2. 测试条件和统计方式](#2. 测试条件和统计方式)
[3. 固定尺寸对照:耗时和显存都明显降低](#3. 固定尺寸对照:耗时和显存都明显降低)
[3.1 推理耗时](#3.1 推理耗时)
[3.2 GPU 显存占用](#3.2 GPU 显存占用)
[4. 动态尺寸:从固定计划走向日常可用](#4. 动态尺寸:从固定计划走向日常可用)
[4.1 720×540 动态版的早期 CUDA 对照](#4.1 720×540 动态版的早期 CUDA 对照)
[5. 优化版:同轮 28 帧测试再降低 18.38% 耗时](#5. 优化版:同轮 28 帧测试再降低 18.38% 耗时)
[6. 精度和首次加载也要看](#6. 精度和首次加载也要看)
[7. VS2022 打开就能编译 C# 和 C++](# 和 C++)
[8. 用自己的图片复测](#8. 用自己的图片复测)
[9. 为什么推荐这个项目](#9. 为什么推荐这个项目)
做动漫超分辨率的桌面工具时,模型能跑只是第一步。图片稍大一些,推理耗时和显存就会成为实际问题;把程序交给别人后,还要处理依赖安装、图片尺寸变化,以及 C# 与原生 DLL 的编译联动。
这次分享一个完整的 APISR ×4 动漫超分辨率 WinForms 工程。它从已有 C# ONNX Runtime CPU 示例出发,补充 CUDA GPU 基线,再实现 C++ Vulkan FP32 执行器,最终整理为 VS2022 可以打开、编译和运行的解决方案。
先给出两项实测结果:在 RTX 4060 Laptop 8 GiB 上,640×480 的固定计划版 Vulkan 推理中位数为 884.01 ms,ONNX Runtime CUDA FP32 为 1956.88 ms,吞吐比约 2.21×;整卡显存采样峰值约为 3.55 / 7.98 GiB。 另外,在 720×540 的 28 帧序列同轮优化测试中,动态 Vulkan 耗时从 1172.96 ms 降至 957.33 ms,下降 18.38%。这两组来自不同阶段,下面分别展开。
1. 这个工程可以做什么
项目使用原始 4x_APISR_GRL_GAN_generator.onnx,输出宽高均为输入的 4 倍。APISR 原模型及研究背景可参考 APISR 原始项目;本文分享的是其 C# / Vulkan 部署实现。
界面保留选择图片、输入与输出双图预览、双击查看原尺寸、保存图片,同时提供四种后端:
| 后端 | 用途 |
|---|---|
| ONNX Runtime CPU | 保留原部署路线,检查输入输出和运行流程 |
| ONNX Runtime GPU · CUDA | 建立 GPU 速度、显存和数值基线 |
| Vulkan GPU · 固定计划 | 保留固定尺寸的性能对照 |
| Vulkan GPU · 动态尺寸 | 日常测试入口,按图片尺寸生成并缓存执行计划 |
还可以选择测试区域、多次测速、复用会话、导出 JSON,以及处理一个文件夹中的序列图片。默认动态 Vulkan 处理整张图片,不会偷偷把输入缩小来换取更好看的速度数字。
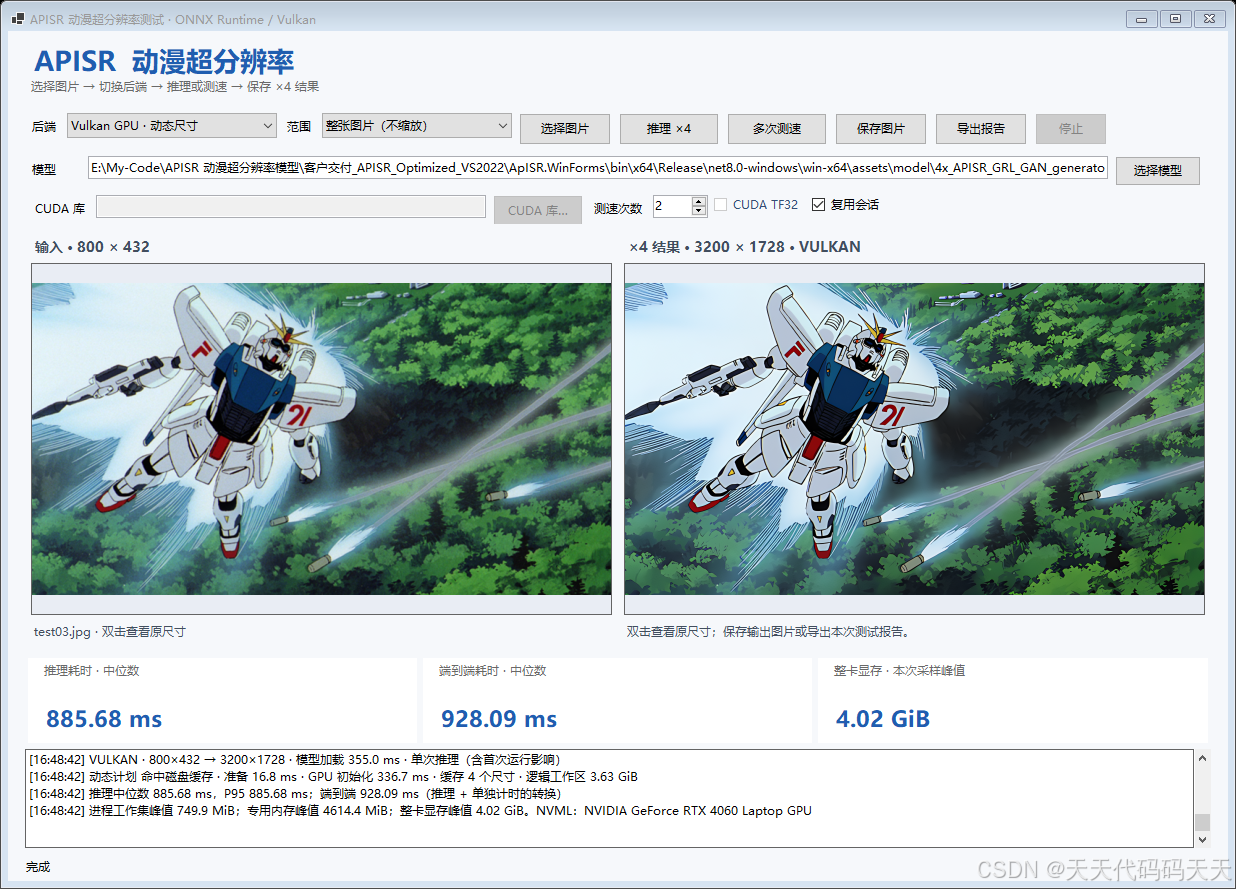
WinForms 实际测试界面
上图是 800×432 输入、3200×1728 输出的实际界面。界面截图中的耗时是一次运行读数,正式对照使用后面的多次采样报告;预览图按窗口大小显示,比较细节应双击查看原尺寸或查看保存的 PNG。
2. 测试条件和统计方式
所有本文引用的性能测试都来自 2026-10-08 保存的报告,没有使用模型作者在其它硬件上的速度作为本项目成绩。
| 项目 | 测试配置 |
|---|---|
| 操作系统 | Windows x64 |
| GPU | NVIDIA GeForce RTX 4060 Laptop GPU,8 GiB |
| 显卡驱动 | 596.36 |
| 模型 | 同一个 APISR GRL ×4 ONNX |
| ONNX Runtime | 1.20.1,CUDA Execution Provider |
| 主对照精度 | FP32;CUDA 关闭 TF32,cuDNN EXHAUSTIVE,prefer_nhwc=False |
| 运行时 | 固定计划历史基准为 .NET 10;动态尺寸与客户工程为 .NET 8 |
| 显存监测 | NVML,10 ms 采样,统计整卡已用显存 |
推理耗时 包含上传、GPU 执行、同步和回读。端到端耗时再加 RGB / CHW 转换和输出图像转换,不含文件解码、PNG 保存或界面绘制。模型加载、新尺寸计划构建和首次 GPU 管线准备单独记录,不混入预热后的推理中位数。
本文中的"GPU 占用对比"具体指 GPU 显存占用。NVML 整卡读数包括桌面和其它进程,不能称为模型独占显存;报告没有采集 GPU-Util / SM 利用率百分比,因此不提供"GPU 利用率下降多少"的结论。MiB = 2²⁰ bytes,GiB = 2³⁰ bytes。
3. 固定尺寸对照:耗时和显存都明显降低
这一组使用同图、同 ROI、同模型,在独立进程中顺序测量。每组预热 5 次,小区域采样 30 次,640×480 整图采样 10 次。64、128、256 是区域基准,不代表整张图片;640×480 是完整输入,输出为 2560×1920。
3.1 推理耗时
表中时间为 中位数 / P95,单位 ms。吞吐比按 CUDA 中位数 ÷ Vulkan 中位数计算。
| 输入尺寸 | 采样次数 | ORT CUDA FP32 | Vulkan FP32 固定计划 | 吞吐比 |
|---|---|---|---|---|
| 64×64 | 30 | 16.84 / 17.93 | 12.10 / 12.13 | 1.39× |
| 128×128 | 30 | 41.36 / 42.53 | 37.17 / 37.50 | 1.11× |
| 256×256 | 30 | 189.67 / 190.62 | 170.85 / 171.87 | 1.11× |
| 640×480 | 10 | 1956.88 / 1958.85 | 884.01 / 886.22 | 2.21× |
以 640×480 为例,推理中位数从 1956.88 ms 降至 884.01 ms ,耗时降低约 54.83%。这一组端到端中位数也从 2020.38 ms 降至 946.08 ms,说明收益保留到了图像转换后的实际流程。
3.2 GPU 显存占用
以下为预热后采样窗口中的整卡显存峰值,单位 MiB。
| 输入尺寸 | ORT CUDA | Vulkan 固定计划 |
|---|---|---|
| 64×64 | 463.2 | 294.8 |
| 128×128 | 847.2 | 430.2 |
| 256×256 | 2391.2 | 971.9 |
| 640×480 | 8175.2 | 3635.2 |
640×480 对应约 7.98 GiB / 3.55 GiB。整卡采样值下降约 55.53%,但这个百分比描述整卡读数,不是精确的后端独占显存节省比例。
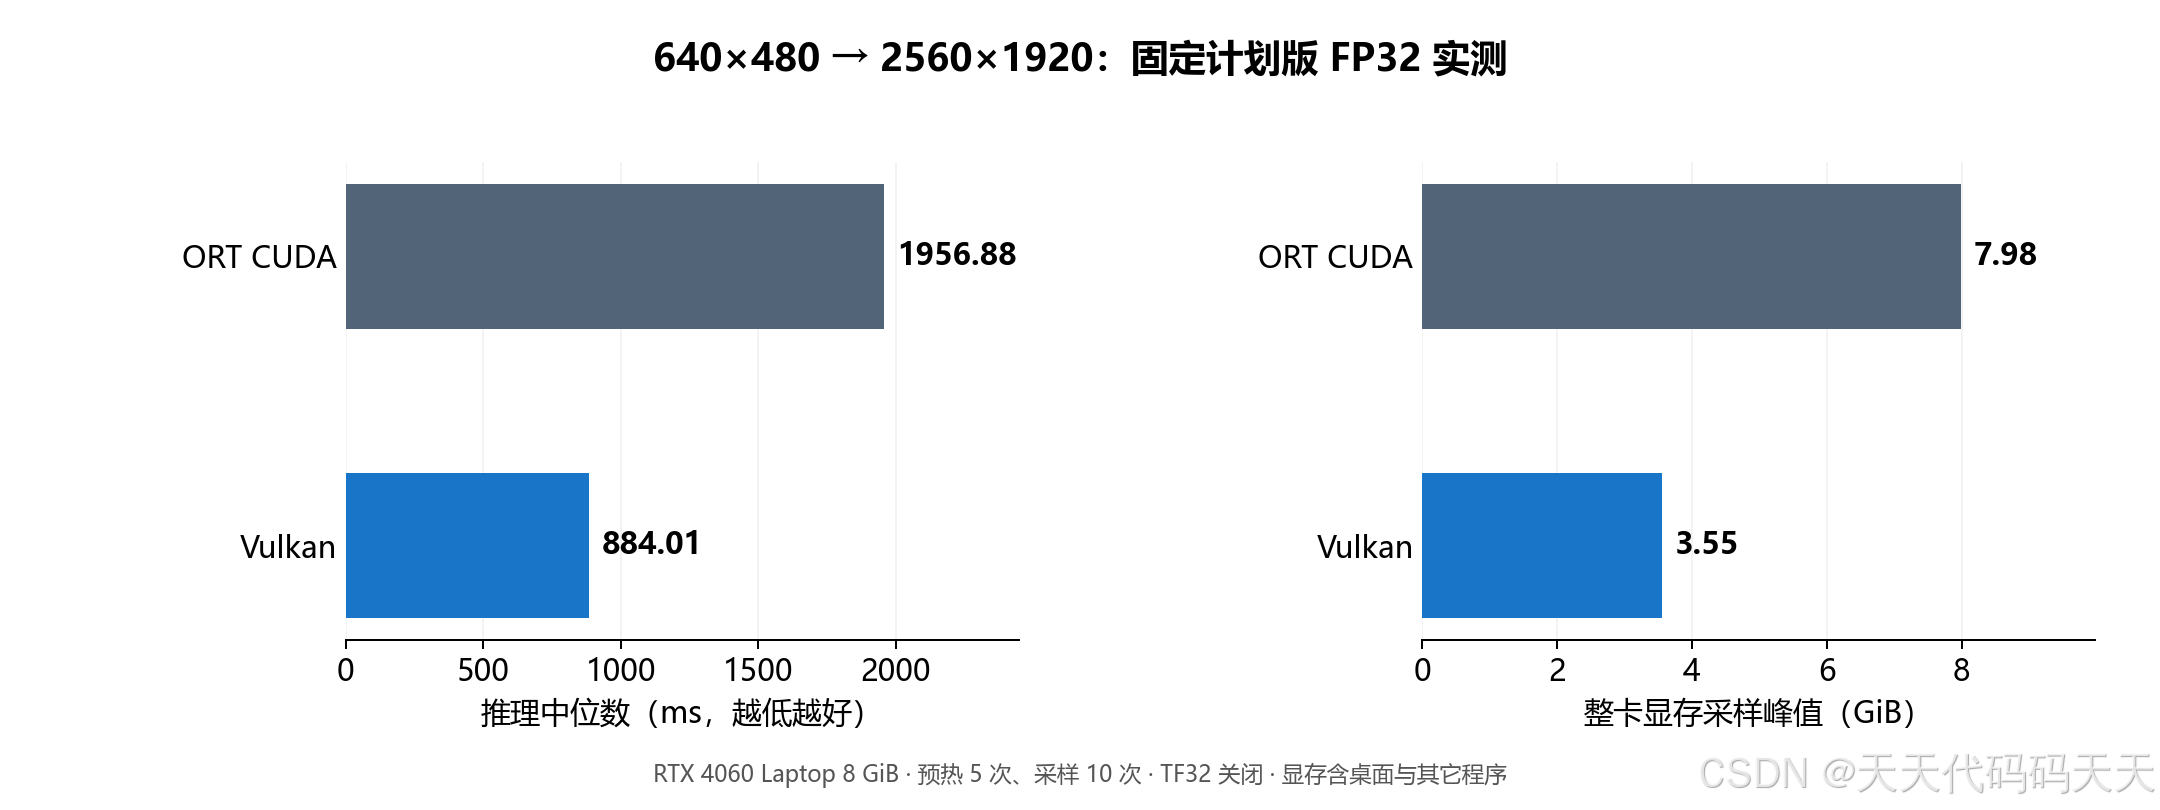
640×480 固定计划版耗时与显存
这台机器只有 8 GiB 显存,CUDA 测试已接近容量上限,WDDM 内存压力可能影响速度。因此 2.21× 是本机、本模型、这套配置的实测结果;换显卡、换显存容量或换运行配置,需要重新测量。
还有一组开启 TF32 的额外对照:640×480 下 CUDA 中位数为 1913.00 ms ,Vulkan FP32 为 884.01 ms ,比值约 2.16× 。这组数学精度不同,不与上面的 FP32 主对照混为一组;TF32 等选项可参考 ONNX Runtime 官方 CUDA 文档。
4. 动态尺寸:从固定计划走向日常可用
固定计划便于优化,但只准备几个尺寸,用户打开 800×432 图片就可能遇到"没有对应执行计划"的错误。新版增加了 APISR 专用 ONNX 导入器,用 C# 完成常量计算、形状推导、融合和显存规划,再交给 Vulkan 执行图像计算。
原始 APISR ONNX
  → C# 解析、常量计算与尺寸推导
  → 算子融合、显存规划、执行计划缓存
  → C ABI 调用 C++ Vulkan 执行器
  → GPU 运算、结果回读、输出 ×4 图片
模型基础权重只上传一次,同尺寸复用计划和已录制命令,新尺寸重新准备所需计划。例如 800×432 输出 3200×1728;83×61 会先补齐到模型要求的尺寸,再裁回 332×244。这里做的是模型要求的补齐和输出裁剪,不是缩小原图。
实现了ONNX 读取,并直接复用了其中的 protobuf 读取器,按本项目需求调整;Vulkan 设备与缓冲区基础代码复用了已有 lw.PPOCR.Vulkan 工程。
这部分是 APISR GRL 专用导入器,支持本模型所需的算子与形状规则,不是一个已经支持任意 ONNX / OCR 模型的通用运行时。当前也未实现超大图分块;尺寸仍受 padding、显存和 Vulkan storage-buffer 限制。
4.1 720×540 动态版的早期 CUDA 对照
使用"龙珠001"中的 28 张 720×540 序列图片,输出均为 2880×2160。
| 指标 | 动态 Vulkan,优化前的早期对照 | ONNX Runtime CUDA FP32 |
|---|---|---|
| 推理中位数 | 1190.89 ms | 3738.50 ms |
| 整卡显存采样峰值 | 4.64 GiB | 7.87 GiB |
Vulkan 的时间是 28 帧汇总中位数;CUDA 是首帧预热后 5 次采样的中位数,另外抽查第 15、28 帧,耗时约 3736~3740 ms。CUDA 没有完成同样的 28 帧全量采样,所以这不是严格对称的完整序列基准。 记录中的时间比约为 3.14×,用于说明该配置下的观察结果。
这组显存压力仍很明显:CUDA 整卡采样峰值约 7.87 GiB,Vulkan 约 4.64 GiB。它来自较早的一轮测试,不与下一节的优化版数字直接相除、拼成新的加速倍数。
5. 优化版:同轮 28 帧测试再降低 18.38% 耗时
在动态尺寸版本可用后,进一步优化了执行图。下面的原版与优化版在同一台机器上顺序运行,使用相同 C# 图像转换和计时方式:首帧预热 3 次,推理与端到端各采样 5 次;其余 27 帧单次计时,连续复用会话。逐算子诊断关闭。
| 指标 | 动态 Vulkan 原版 | 动态 Vulkan 优化版 |
|---|---|---|
| 28 帧推理中位数 | 1172.96 ms | 957.33 ms |
| 推理 P95 | 1175.75 ms | 960.92 ms |
| 整卡显存采样峰值 | 4.38 GiB | 4.38 GiB |
| 逻辑工作区 | 约 4.12 GiB | 约 4.12 GiB |
| 全组墙钟时间 | 60.71 s | 52.63 s |
本轮推理耗时下降 18.38% ,吞吐提高约 1.225×。显存仍约 4.38 GiB,逻辑工作区没有缩小,本轮的收益主要是速度。
全组墙钟包含加载、首帧额外预热和测速、解码与 PNG 保存,不能用"28 ÷ 全组秒数"宣称实时视频帧率。按优化版推理中位数换算,纯推理吞吐约为 1.04 帧/秒,还未包括视频解码、编码和其它流水线开销。
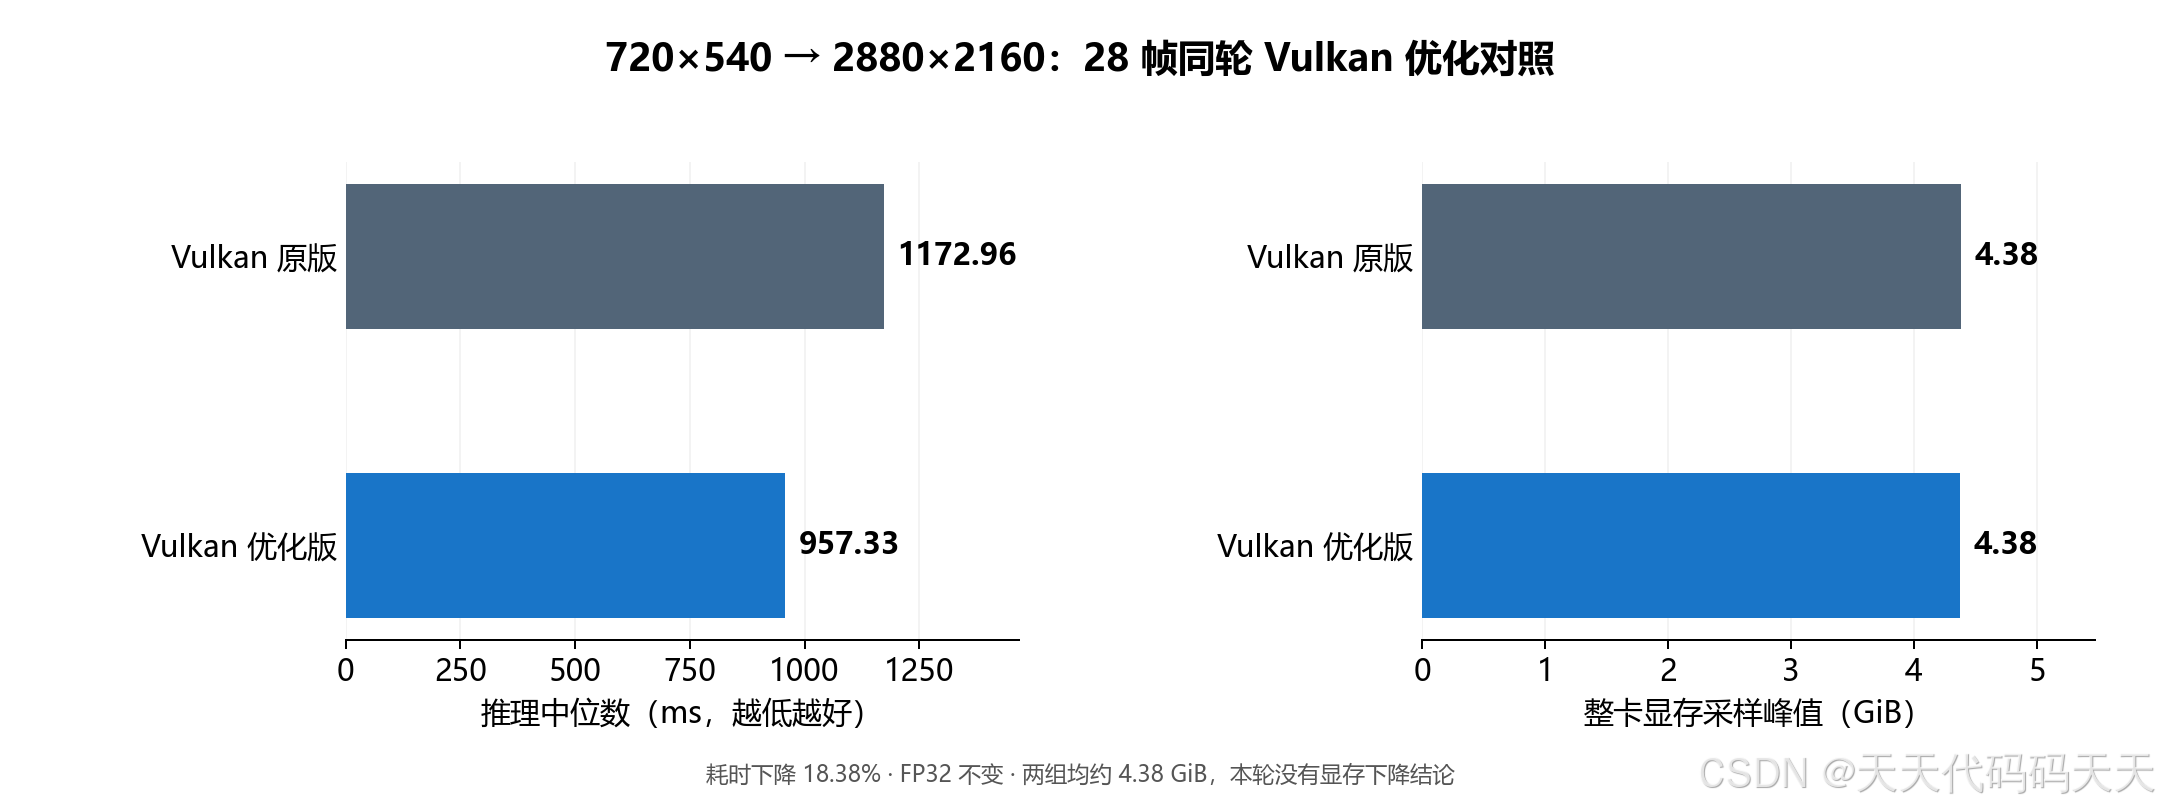
动态 Vulkan 原版与优化版
主要优化是减少中间结果读写和调度:
- 将卷积与 LeakyReLU、最近邻 2 倍放大与卷积融合。
- 将残差乘加融合,同时保留运算舍入顺序。
- 将 MLP 中的矩阵乘与 GELU 融合。
- 简化连续张量、标量广播和拷贝的寻址。
- 按完整操作数访问范围选择对应显存段,减少通用分段判断。
720×540 的 GPU 调度从 823 次减少到 769 次。模型、输入尺寸和 FP32 精度不变,图像计算没有回退到 CPU 或 ONNX Runtime。
6. 精度和首次加载也要看
只看更快还不够,需要确认输出一致。
| 验证项目 | 结果 |
|---|---|
| 640×480 固定 Vulkan 与 CUDA FP32 | 最大绝对浮点误差约 7.60×10⁻⁶ |
| 动态版 720×540 首、中、尾三帧与 CUDA FP32 | 最大误差约 3.25×10⁻⁶~4.86×10⁻⁶,量化像素差最多 1 |
| 优化版与原动态 Vulkan,全部 28 帧 | 保存的 28 个 PNG 文件 SHA256 逐文件一致 |
| 优化版与原动态 Vulkan,首、中、尾完整 FP32 张量 | 最大差值均为 0 |
"优化版与原版 PNG 一致"不等于宣称所有输出都与 CUDA 位级相同;CUDA 数值对照与优化前后对照是两种验证。
另外,早期动态版中,720×540 未命中计划缓存时的完整首次准备曾测得约 33.50~39.47 秒,不能忽略。新增磁盘计划缓存后,已经生成过的 720×540 尺寸在一次重启测试中,加载约 674.09 ms ,计划读取约 26.04 ms;当时 GPU 驱动管线缓存也已预热。这是缓存命中的结果,不是首次打开任意新尺寸都只需 0.67 秒。
磁盘缓存绑定模型、基础权重 SHA256、尺寸、FP32 与编译版本,并检查数据完整性。内存 LRU 最多保留 8 个尺寸;磁盘最多 32 个计划、总计 512 MiB。GPU 缓冲区按需要增长并保留,切回小尺寸后的实际占用不一定立即下降,关闭会话才会释放资源。
7. VS2022 打开就能编译 C# 和 C++
分享版本使用 .NET 8 + C# 12 + C++17,解决方案中同时包含:
APISR.WinForms.VS2022.sln
├─ ApISR.WinForms       C# 界面、ONNX 导入器、测速与图像转换
└─ ApISR.Vulkan         C++ Vulkan 执行器,生成 apisr_vulkan.dll
完整文件夹还包含模型、测试图片、离线 NuGet 包、冻结 SPIR-V、第三方许可证和验证报告。生成解决方案时先编译 C++,再自动将对应 Debug / Release 的 DLL 与 PDB 复制到 WinForms 输出目录,不需要手工替换 DLL。
普通编译步骤:
- 安装 VS2022 17.8+,勾选".NET 桌面开发"和"使用 C++ 的桌面开发",包含 .NET 8 SDK、MSVC v143 和 Windows SDK。
- 完整解压到较短的可写路径,例如
D:\APISR。 - 打开
APISR.WinForms.VS2022.sln,选择Release | x64。 - 将
ApISR.WinForms设为启动项目,按 F5 或 Ctrl+F5。
这个交付版本已经随包提供 Vulkan C API 头文件和 x64 导入库,不需要另外安装 Vulkan SDK,也不依赖 VULKAN_SDK 环境变量。 C++ 使用已提供的内嵌 SPIR-V,普通编译无需 Python、CMake 或 glslc。只有修改 GLSL 并重新生成内核时,才需要开发用的着色器编译工具。
运行 Vulkan 需要支持 Vulkan 的显卡驱动;运行 CUDA 后端则需要 NVIDIA、CUDA 12 / cuDNN 9 依赖,可以在界面中选择 DLL 目录或设置 APISR_CUDA_DLL_DIR。目前本文实测平台是 Windows x64 / RTX 4060 Laptop,其它 GPU 需要另行验证。
8. 用自己的图片复测
先在界面选择 Vulkan 动态尺寸、整张图片,使用"多次测速"检查预热后的中位数、P95 和显存,再切到 CUDA 做相同尺寸与精度的对照。正式测速使用 Release,关闭逐算子诊断,并分别运行两个后端。
批量序列测试可以在包根目录执行:
$exe = Join-Path $PWD 'ApISR.WinForms\bin\x64\Release\net8.0-windows\win-x64\ApISR.WinForms.exe'
$p = Start-Process -FilePath $exe `
    -ArgumentList @('--sequence-test', '"D:\龙珠001"', '"D:\APISR结果-Vulkan"', 'vulkan') `
    -WindowStyle Hidden -PassThru -Wait
$p.ExitCode
最后一个参数可换成 cuda 或 cpu,输出目录应分别设置,避免覆盖。该公开入口默认首帧预热 3 次,推理与端到端各采样 3 次;历史优化正式对照首帧采样 5 次,复测时请记录实际采样方式,不要求新机器得到相同数字。
程序会输出 ×4 PNG、progress.json 和 sequence-report.json,失败时记录 failure.txt。一次 GPU 调度不能瞬时中断,停止操作会等待当前推理返回。
9. 为什么推荐这个项目
如果你正在做 C# 动漫图片放大工具,或者需要给客户交付一个能实际测试的 GPU 桌面程序,这个项目有几处值得参考:同一界面保留 CPU / CUDA / Vulkan 对照,速度与显存都有报告,动态尺寸不需要为每张图重新发布 DLL,C# 与 C++ 编译链也已经打通。
对学习部署优化的人来说,它还展示了如何从通用推理基线出发,为一个明确的模型做常量计算、算子融合、显存复用和执行计划缓存。收益来自具体模型和工程条件,需要用数据证明;小图、大图、首次加载和连续处理,应分别看待。
配套工程下载:完整源码
工程内 verification 保留动态版与优化版验证;固定计划原始数据位于开发工程 artifacts/final/report.json,本文配图对应的汇总数据保留在 assets/benchmark-data.json。