用单个 Agent 顺序跑几十个同类子任务,耗时随任务量线性膨胀,一次超时或限流还会把整批进度一起拖死,这在批量摘要、批量审核、批量数据清洗里几乎是必然遇到的坑。
Pipeline 串行流水线擅长有先后依赖的链式任务,但面对彼此独立、可任意重排的批量作业时,节点只能一个接一个地等,算力利用率被串行依赖锁死,加机器也换不来吞吐。
本文分享一套可直接落地的 MapReduce 式多 Agent 协作方案:分片函数切任务 + 信号量限流扇出 + 归并函数收结果,配失败降级与调参口径,附最短可运行代码。
一、批量任务压垮串行 Agent 的三个信号
先判断你是不是真的需要 MapReduce,下面三类信号出现任意两条就该动手:
- 耗时线性增长:任务数翻倍、总耗时几乎同步翻倍,说明没有并行度可言,瓶颈在执行而非模型。
- 错误互相牵连:第 N 个子任务失败导致整批重跑,已完成结果被丢弃,返工成本远高于单点修复。
- 资源间歇空闲 :Agent 在等待模型返回时 CPU 与网络几乎无事可做,吞吐上限被单连接串行阻塞。
**核心结论:**批量独立任务的三个典型症状是线性耗时、连坐失败与资源空闲,命中即应引入分治并行。
二、Map 与 Reduce 的职责边界划分
角色边界越干净,后面出问题时定位越快,先按阶段把职责钉死:
| 阶段 | 职责 | 输入 | 输出 |
|---|---|---|---|
| Split | 把大任务切成互不重叠的分片 | 原始任务列表 | 分片数组 |
| Map | 每个分片交给一个 Agent 独立处理 | 单个分片 | 结构化子结果 |
| Shuffle | 按 key 分组、去重、校验字段 | 子结果集合 | 规整后的分组 |
| Reduce | 归并计数、去重、择优、汇总错误 | 分组结果 | 最终交付物 |
- Map 只做加法:单个 Map Agent 只允许追加自己的结果,不读全局状态,天然支持水平扩容。
- Reduce 只做收口 :聚合 Agent 不重新调用大模型做二次加工,只做规约,保证同一份输入永远得到同一份输出。
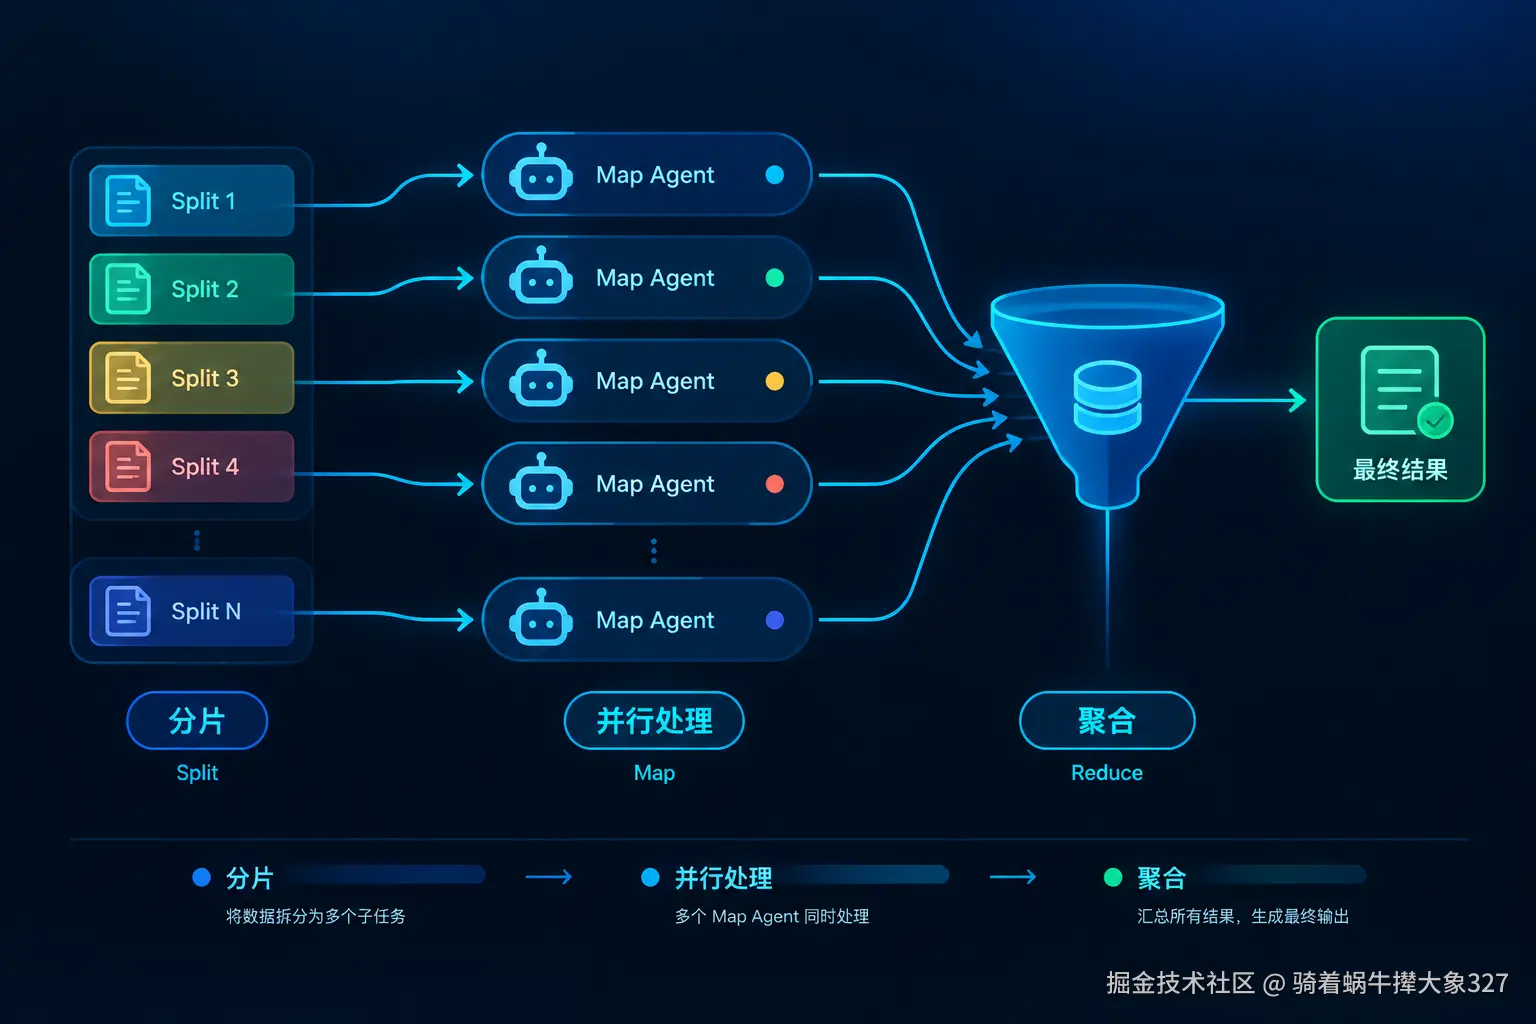
**核心结论:**Split 切分、Map 并行加法、Reduce 单点收口,四段职责互不越界才谈得上可重试。
三、任务分片:把大任务切成互不重叠的子任务
分片是整个模式的地基,切不好后面全是返工,这里给出一个最短可用的切分函数:
这段代码用 Python 标准库把任务列表按固定条数切块,适合批量文本处理与批量 API 调用场景:
python
def make_shards(items: list, size: int = 20) -> list[list]:
    """按固定条数切片,尾部不足 size 的分片照常保留"""
    return [items[i:i + size] for i in range(0, len(items), size)]

tasks = [f"doc_{i}" for i in range(47)]
shards = make_shards(tasks, size=20)
print(len(shards), [len(s) for s in shards]) # 3 [20, 20, 7]分片大小直接决定重试粒度:一个分片 20 条失败只重跑 20 条,一个分片 200 条失败就要重跑 200 条。
- 按条数切:实现最简单,适合单条成本接近的任务。
- 按 token 预算切:适合长短差异大的文本,避免某个分片因超长而单独成为长尾。
**核心结论:**先定重试代价再定分片大小,分片粒度与失败重跑成本成正比。
四、并发控制:给扇出装上限与信号量
扇出不是越多越好,没有上限的并发会把限流打满,这段代码用 asyncio 信号量做限流扇出:
这段代码适配 Python 3.10+ 的 asyncio 环境,client.run 换成你自己的 Agent 调用即可:
python
import asyncio

sem = asyncio.Semaphore(8)   # 全局并发上限

async def map_one(shard, client):
    async with sem:
        return await client.run(shard)

async def run_map(shards, client):
    results = await asyncio.gather(
        *(map_one(s, client) for s in shards),
        return_exceptions=True,          # 单个失败不拖垮整批
    )
    ok = [r for r in results if not isinstance(r, Exception)]
    bad = [r for r in results if isinstance(r, Exception)]
return ok, bad- 并发上限:经验值取限流配额的 50%~70%,留出突发重试的余量。
- 异常隔离 :
return_exceptions=True把异常当数据返回,失败只降级不中断。
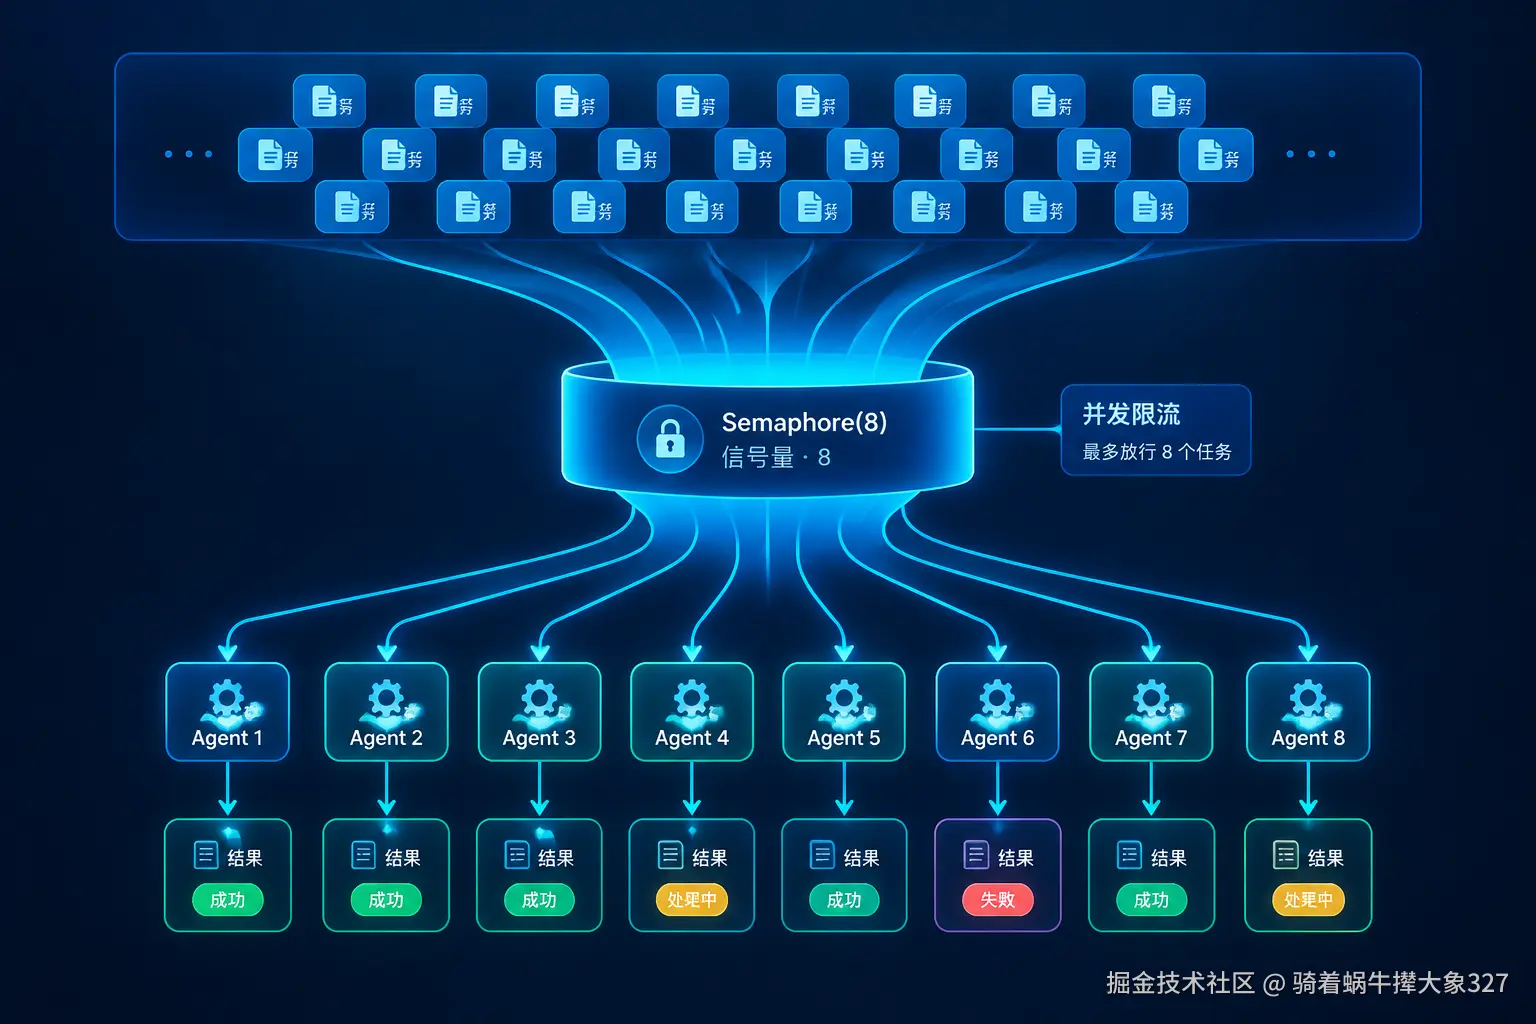
**核心结论:**扇出必须有闸门,信号量定并发上限、gather 定失败边界,两者缺一不可。
五、聚合阶段:规约函数合并子结果
Reduce 段不要塞模型调用,纯函数规约最稳,这段代码演示最小归并逻辑:
这段代码在 Python 3 任意版本可直接运行,负责合并子结果并单独收集错误项:
python
def reduce(results: list) -> dict:
    merged = {"items": [], "score": 0.0, "errors": [], "total": 0}
    for r in results:
        if not isinstance(r, dict) or r.get("status") != "ok":
            merged["errors"].append(r)
            continue
        merged["items"].extend(r.get("items", []))
        merged["score"] = max(merged["score"], r.get("score", 0))
        merged["total"] += len(r.get("items", []))
    return merged

merged = reduce([
    {"status": "ok", "items": ["a", "b"], "score": 0.8},
    {"status": "ok", "items": ["c"], "score": 0.9},
    {"status": "fail", "reason": "timeout"},
])
print(merged) # items 3 条、score 0.9、errors 1 条- 可结合律 :
max、计数、集合去重都满足结合律,换分片顺序结果不变,便于并行重算。 - 错误单列 :失败项不参与主体合并,单独进
errors供后续补跑。
**核心结论:**聚合函数只做规约不做加工,满足结合律才能让分片顺序无关。
六、失败处理:局部重试与部分成功降级
并行越大,撞上偶发失败的概率越高,处置策略要提前约定:
| 现象 | 可能原因 | 处置动作 |
|---|---|---|
| 单分片超时 | 分片过长或模型抖动 | 指数退避重试 2 次,仍失败则拆半重切 |
| 大面积 429 | 并发超限流配额 | 信号量下调 30%,退避 5 秒后再放量 |
| 字段缺失 | 模型输出不合规 | 走校验钩子,原分片带强约束重写一次 |
| 部分成功 | 个别分片持续失败 | 交付已完成部分 + 错误清单,标记非全量 |
- 重试只打失败分片 :用
errors里的分片 id 精确补跑,避免整批推倒重来。 - 降级要显式 :返回体里带上
complete: false,让调用方知道这不是全量结果。
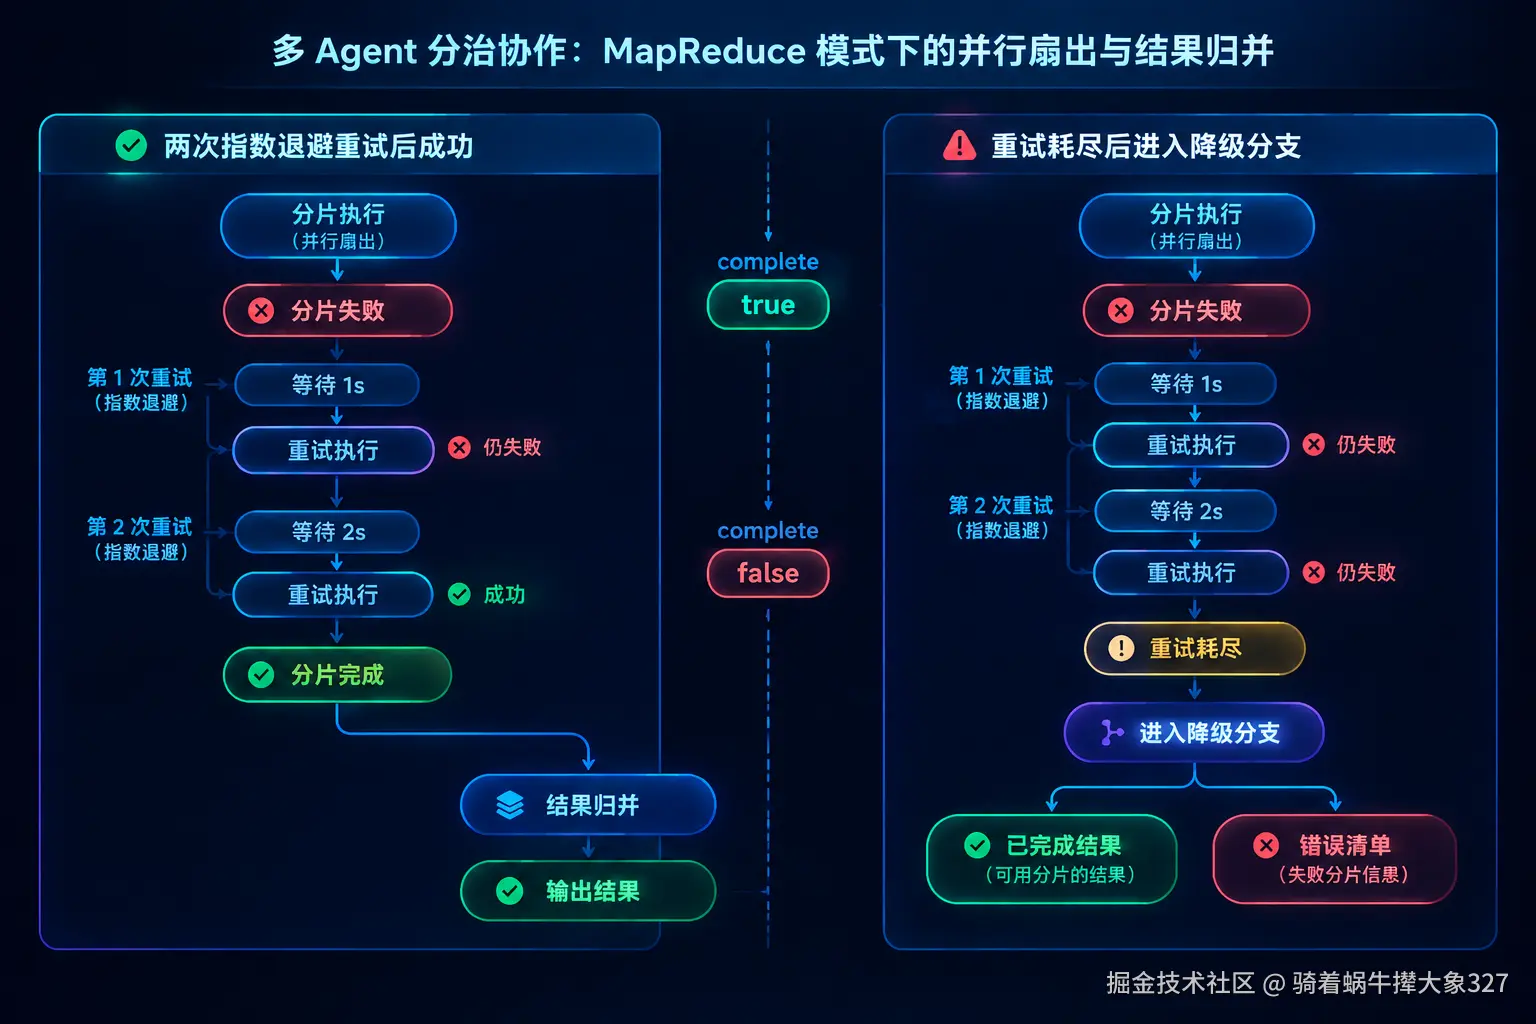
**核心结论:**重试按分片粒度打、降级按结果粒度标,两者一起才构成可控的失败面。
七、可观测:把并行进度落到结构化日志
并行任务的日志是乱序的,必须靠结构化字段才能还原现场,一条命令跑起来并留档:
这段命令用于本地或 CI 环境启动一轮 MapReduce 运行,并把日志同时落盘:
bash
python run_mapreduce.py \
  --input ./tasks.jsonl --concurrency 8 --shard 20 --retry 2 \
| tee run_$(date +%Y%m%d_%H%M).log- 每条日志带三元组 :
run_id+shard_id+stage,乱序也能按分片重排回时间线。 - 关键指标四个 :分片总数、成功数、平均耗时、P95 耗时,慢分片比总耗时更能暴露问题。
**核心结论:**并行可观察性靠 run_id 串起来,慢分片与失败分片是两个必须盯的指标。
八、选型对照:MapReduce 与 Pipeline 分别何时用
两种模式没有优劣,只有匹配度,按下表对号入座:
| 维度 | MapReduce 模式 | Pipeline 模式 |
|---|---|---|
| 任务关系 | 子任务彼此独立 | 节点间有前后依赖 |
| 并行度 | 高,受信号量约束 | 低,天然串行 |
| 失败影响 | 单分片局部重试 | 需从断点续跑 |
| 聚合方式 | Reduce 统一规约 | 上游结果直传下游 |
| 适用场景 | 批量摘要、批量审核 | 多步生成、分镜产出 |
- 独立批量选 MapReduce:任务之间没有数据依赖时,并行收益最大。
- 链式加工选 Pipeline:后一步依赖前一步产物时,强行拆并行只会增加编排成本。
- 混合形态 :先按 Pipeline 排大阶段,每个阶段内部再套一层 MapReduce 扇出,这是生产环境最常见的组合。
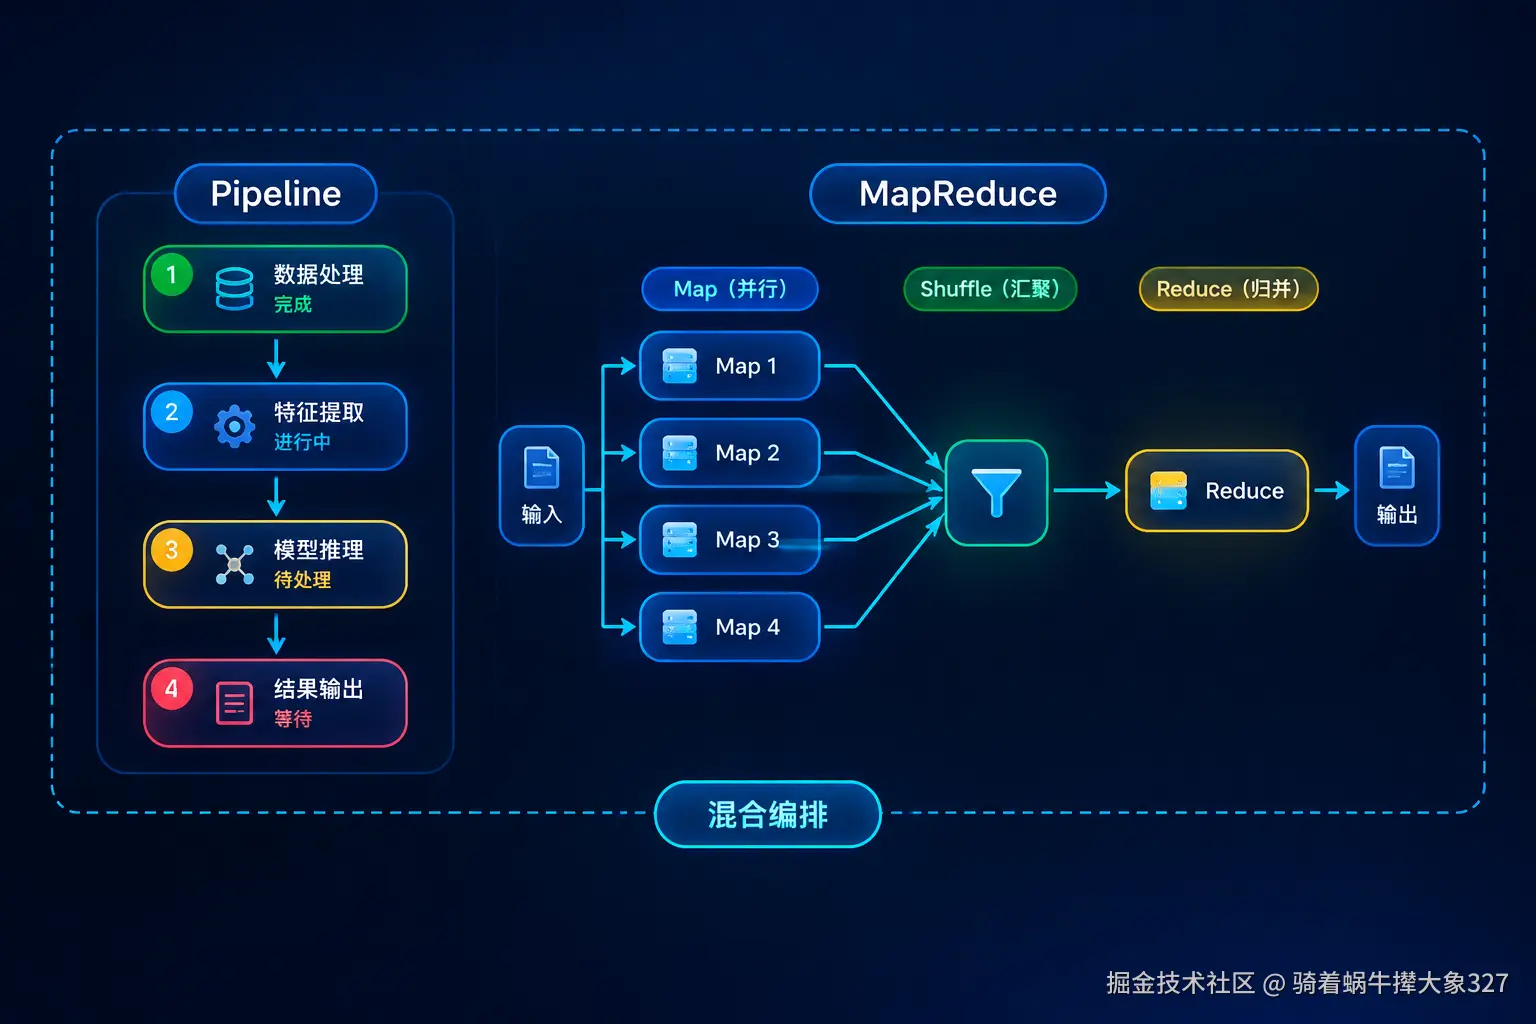
**核心结论:**看依赖关系选模式,无依赖用扇出、有依赖走流水线,混合场景两者可嵌套。
九、最小可运行骨架:四十行跑通一轮
把前面四段拼起来,就得到一个可直接改造的最小骨架:
这段代码把分片、扇出、聚合串成一条完整链路,把 fake_agent 换成真实调用即可:
python
import asyncio

sem = asyncio.Semaphore(8)

async def fake_agent(shard):          # 占位:替换为真实 Agent 调用
    await asyncio.sleep(0.1)
    if "bad" in shard[0]:
        raise RuntimeError("boom")
    return {"status": "ok", "items": shard, "score": 0.9}

async def run(shards):
    async def one(s):
        async with sem:
            for _ in range(2):        # 局部重试两次
                try:
                    return await fake_agent(s)
                except Exception as e:
                    last = e
            return {"status": "fail", "reason": str(last)}
    return await asyncio.gather(*(one(s) for s in shards))

shards = [[f"t{i}"] for i in range(40)]
print(asyncio.run(run(shards)))
分片 → 限流扇出 → 局部重试 → 归并交付,四步闭环,去掉占位函数就能上生产。
**核心结论:**骨架只保留 Split、Map、Reduce 三层,其余横切逻辑一律走钩子注入。
十、压测调参:并发度与分片粒度怎么定
参数不是拍脑袋,跑三轮基准就能收敛,参考口径如下:
| 参数 | 偏小的代价 | 偏大的代价 | 建议起点 |
|---|---|---|---|
| concurrency | 吞吐低、总耗时长 | 触发 429、被封禁 | 配额的 50% |
| shard_size | 调度开销占比高 | 单次重跑代价大 | 10~30 条 |
| retry | 偶发失败即降级 | 雪上加霜放大限流 | 2 次 + 指数退避 |
- 先升并发再拆分片:并发从 4 提到 8 收益明显时,说明还没到限流拐点。
- 观察长尾而非均值 :P95 与中位数差距拉大,说明分片粒度不均或个别分片超长。
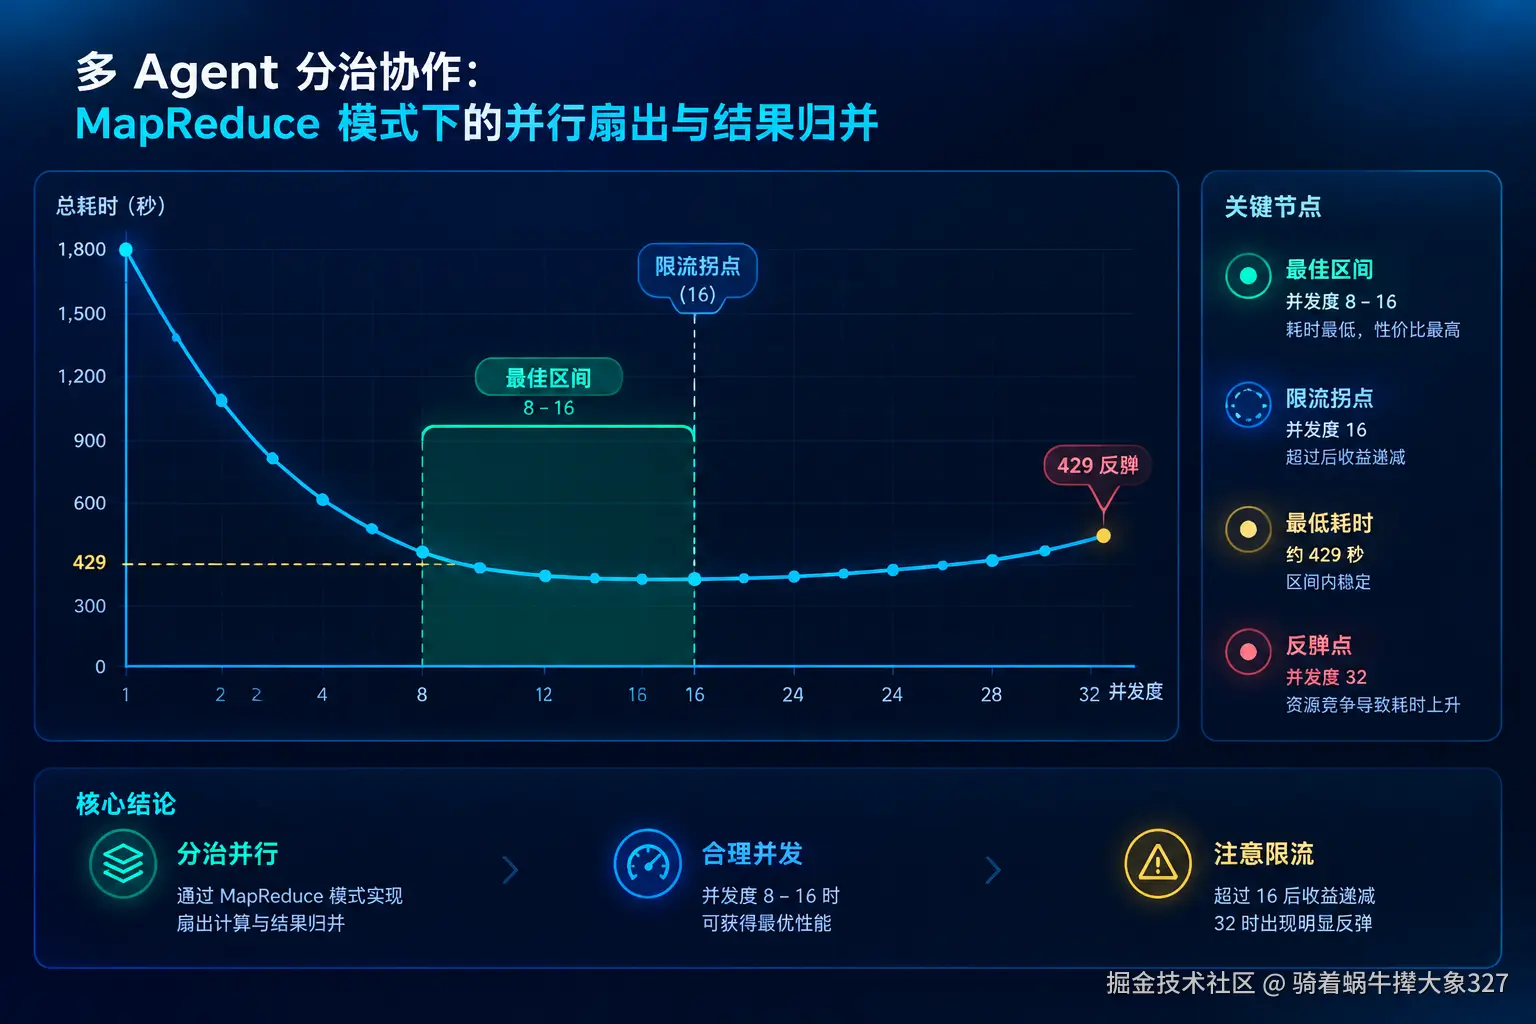
**核心结论:**调参顺序是并发度、分片粒度、重试次数,拐点之前加并发、拐点之后拆分片。
结语
多 Agent 并行的核心不是让机器人跑得更多,而是让任务切得更碎、失败收得更窄、结果合得更稳。分片决定重试代价,信号量决定限流风险,聚合函数决定结果可信度,三者配套才有完整的分治闭环。
这套骨架不绑定任何具体框架,fake_agent 换成你的模型调用、reduce 换成你的业务规约,就能直接承接批量摘要、批量审核、批量清洗这类作业,也可以嵌进现有 Pipeline 的某个阶段做二次扇出。
把任务切碎、把并发限住、把结果收严,就是 MapReduce 模式在多 Agent 场景下的全部要义。