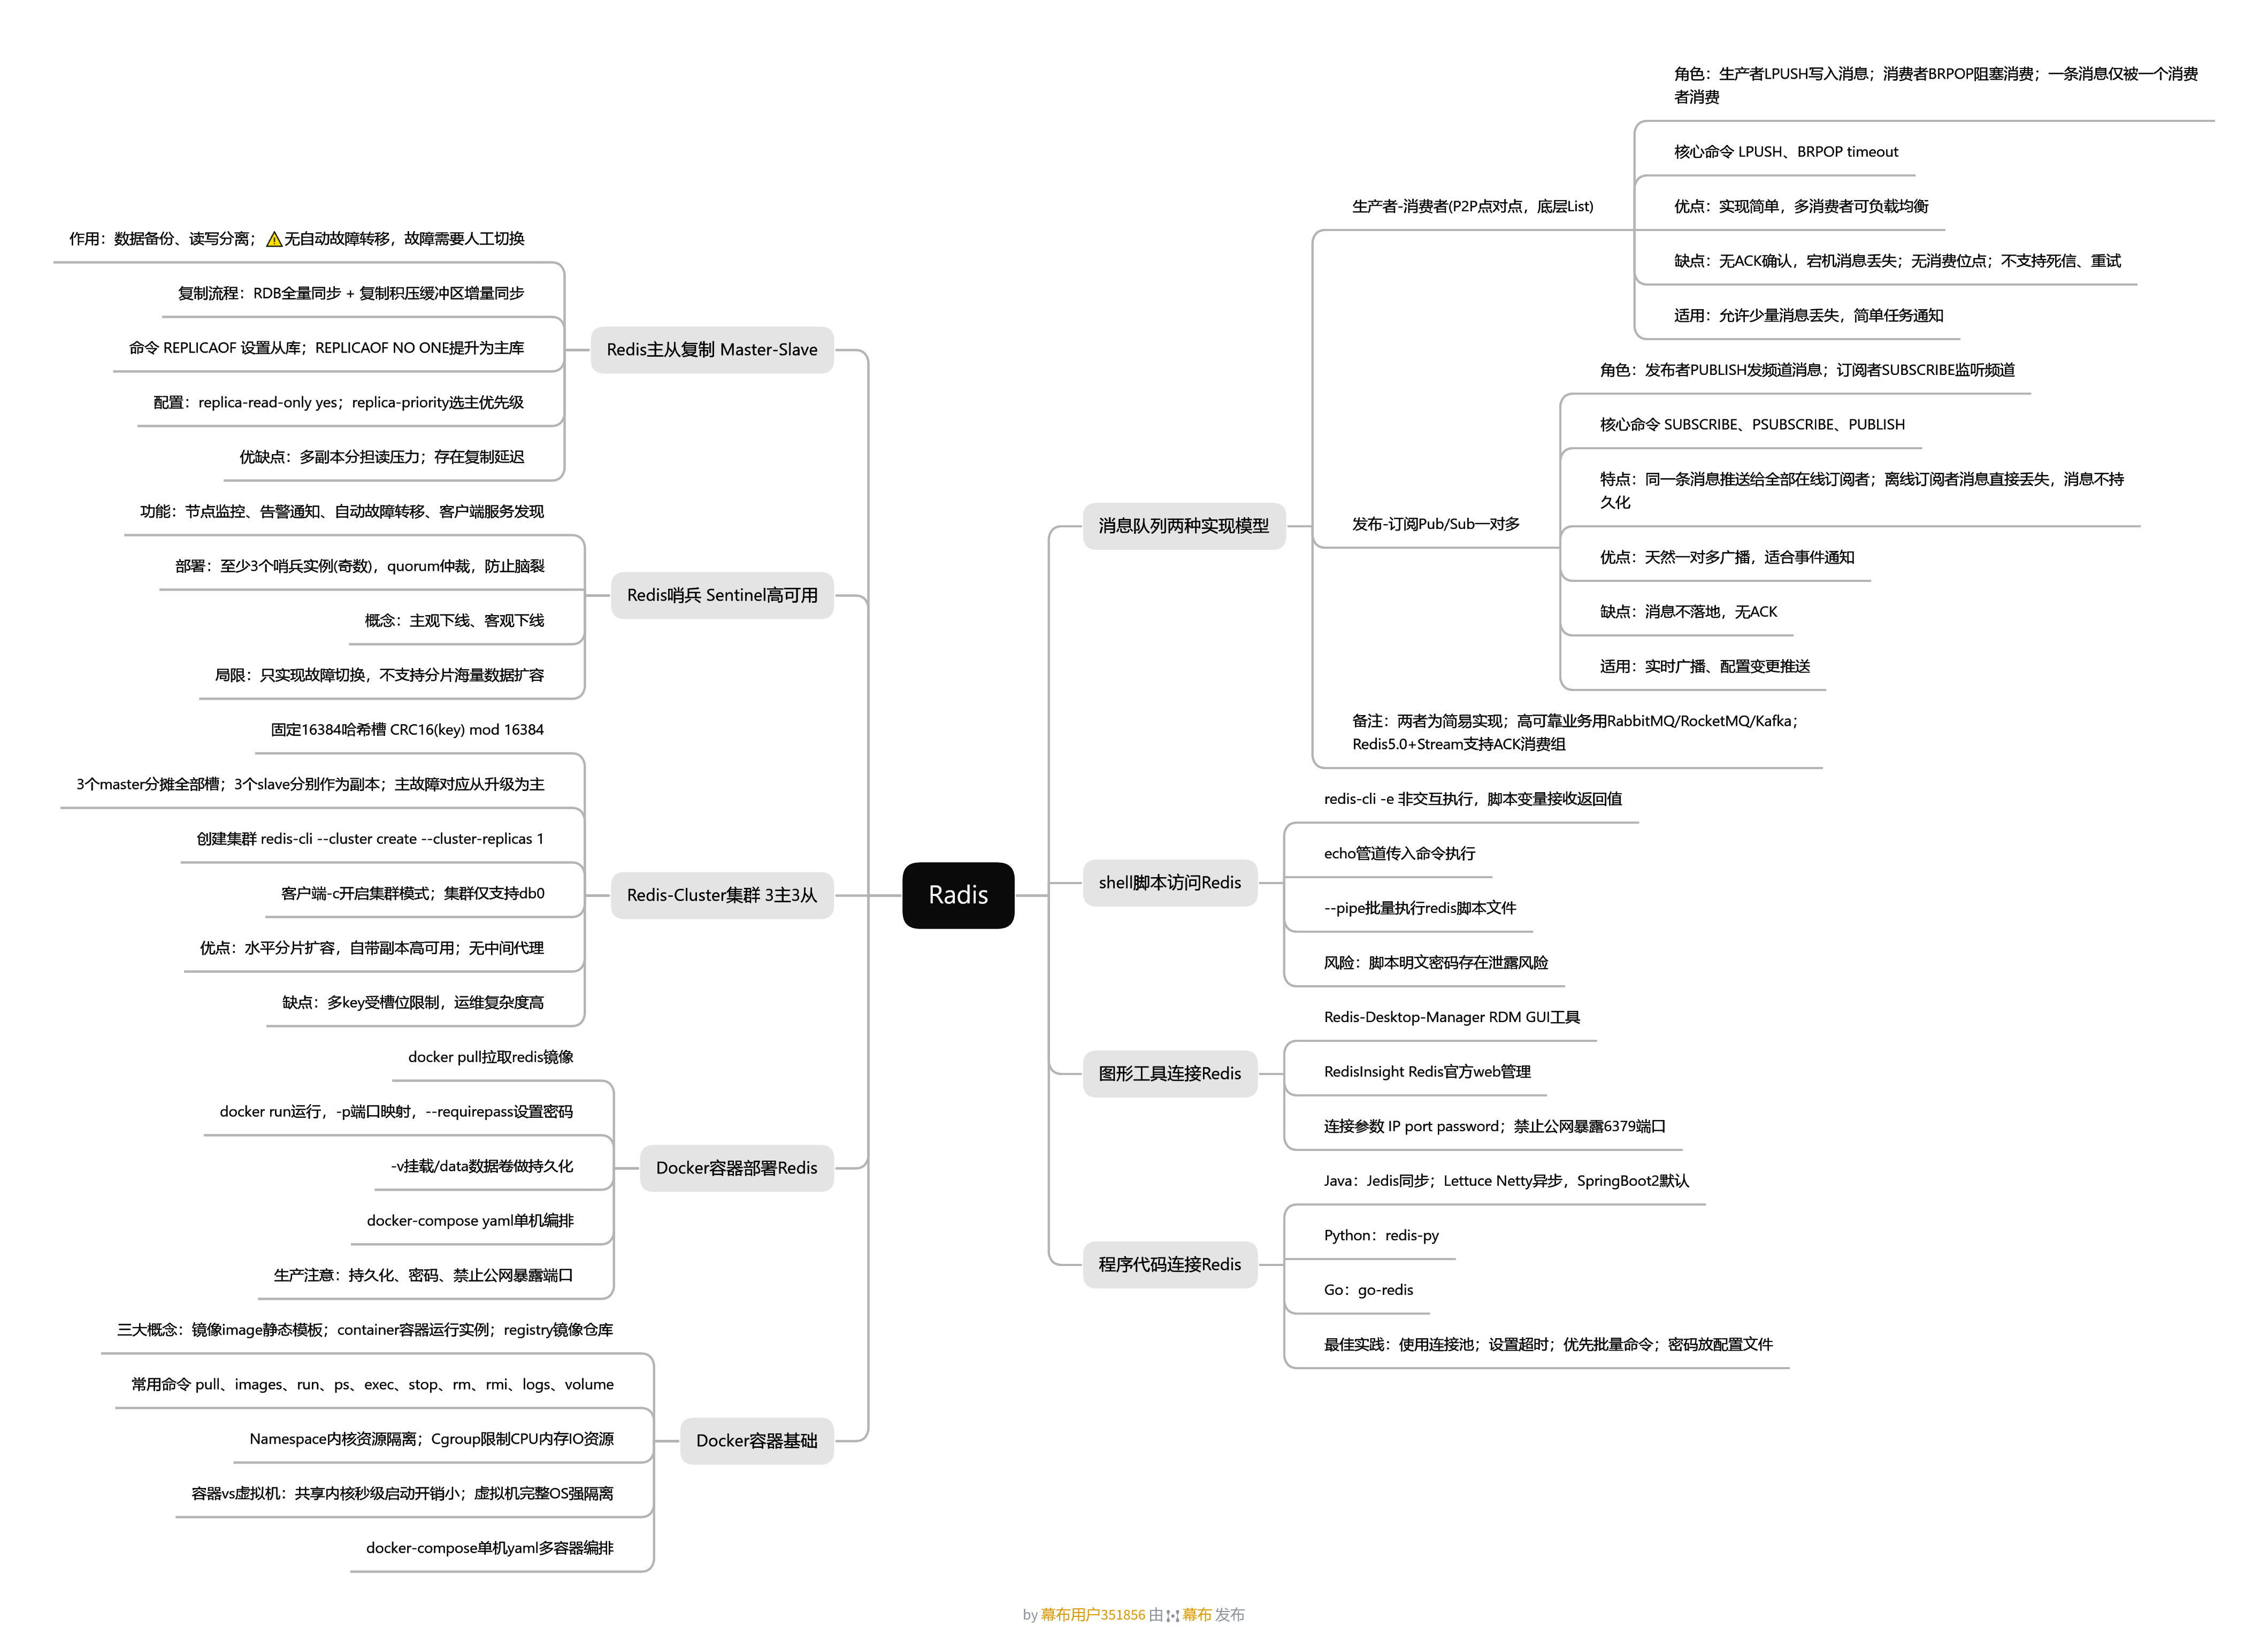
一、消息队列(两种模型)
1. 生产者‑消费者模式(P2P 点对点,底层 List)
-
角色
- 生产者:负责产生业务消息,使用
LPUSH把消息写入 List 队列。 - 消费者:使用
BRPOP阻塞读取消息;一条消息只会被一个消费者消费,消息被取出后直接从队列删除。
- 生产者:负责产生业务消息,使用
-
核心命令
LPUSH task_queue "消息内容" #生产者入队
BRPOP task_queue 10 #消费者阻塞消费,超时10秒返回nil -
工作流程:生产者把消息压入 List;多个消费者阻塞等待;消息到达,只有一个消费者抢到消息进行处理。 ✅优点:实现简单;支持多个消费者竞争消费,实现消费端负载均衡。 ❌缺点:没有 ACK 确认,消费者取出消息后宕机,消息直接丢失;无消费位点;不支持消息重试、死信队列。 适用场景:允许少量消息丢失,简单内部通知、轻量任务。
2. 发布者‑订阅者模式(Pub/Sub 一对多)
-
角色
- 发布者 (Publisher):调用
PUBLISH向指定频道 channel 发送消息。 - 订阅者 (Subscriber):调用
SUBSCRIBE订阅频道;同一条消息会推送给所有在线订阅客户端。
- 发布者 (Publisher):调用
-
核心命令
SUBSCRIBE news_channel #订阅频道,客户端进入阻塞监听
PSUBSCRIBE news:* #通配符模式批量订阅频道
PUBLISH news_channel "消息内容" #发布者发送消息 -
工作流程:发布者发送消息;Redis 把消息复制推送给全部在线 订阅者;离线订阅者收不到历史消息,消息不会持久化保存。 ✅优点:天然一对多广播,适合事件通知。 ❌缺点:消息不落地、无持久化;离线直接丢失消息;没有 ACK 确认。 适用场景:实时广播、配置变更推送,不要求保存历史消息。
补充:List、Pub/Sub 都属于简易消息实现,不能用于高可靠生产业务;高可靠选用 RabbitMQ、RocketMQ、Kafka;Redis5.0 + 提供 Stream (XADD/XREADGROUP),支持 ACK、消费组。
二、shell 脚本访问 Redis,实现自动写入多条数据
1.非交互执行,redis‑cli -e,脚本变量接收返回结果
ret=$(redis‑cli -h 127.0.0.1 -p 6379 -a "123456" -e "GET username")
echo $ret
2.管道方式传入命令
echo "GET username" | redis‑cli -h 127.0.0.1 -p 6379 -a "123456" 3.--pipe批量执行 redis 命令脚本文件
redis‑cli -h 127.0.0.1 -p 6379 -a "123456" --pipe < test.redis⚠️风险:脚本中明文密码会存在泄露风险,生产尽量避免明文写密码。
三、图形工具连接 Redis
- Redis‑Desktop‑Manager(RDM):跨平台 GUI 工具;支持查看 key、执行命令、数据导入导出、慢日志查看。
- RedisInsight:Redis 官方 Web 图形管理工具。
- 连接参数:RedisIP、端口 6379、访问密码。
- 安全注意:禁止直接把 6379 端口暴露到公网;需要外部访问设置
bind 0.0.0.0,防火墙放行,配置强密码。
四、程序代码连接 Redis
- Java
- Jedis:同步阻塞客户端,使用简单。
- Lettuce:基于 Netty 异步非阻塞,线程安全;SpringBoot2.x 默认客户端。
- Python:
redis‑py库。 - Go:
go‑redis客户端。
开发最佳实践 1)使用连接池,避免频繁创建销毁 TCP 连接; 2)设置 IO 超时,防止程序阻塞; 3)不要循环执行单 key 查询,优先 mget 等批量命令; 4)密码存配置文件 / 环境变量,禁止代码硬编码密码。
五、Redis 主从复制(Master‑Slave Replication)
-
作用 :实现数据多副本备份、读写分离;不具备自动故障转移,主节点宕机需要人工切换主库。
-
复制流程
- 从节点与主节点建立网络连接;
- 主节点执行 BGSAVE 生成 RDB 快照,发送快照给从节点;
- 从节点清空本地数据,加载 RDB 文件完成全量同步;
- 主节点使用复制积压缓冲区,持续把写命令同步发送给从节点,做增量同步。
-
操作命令
REPLICAOF 192.168.1.100 6379 #设置当前实例为从库
REPLICAOF NO ONE #取消复制,提升成为独立主库
- 核心配置:
replica‑read‑only yes从节点只读;replica‑priority从节点优先级,0 代表永远不会被选为 master。 ✅优点:数据多副本,读请求分摊到从节点,减轻主库压力。 ❌缺点:无自动故障转移;存在复制延迟。
六、Redis 哨兵 Sentinel(高可用服务,端口号26379)
- 核心功能 :基于主从复制实现高可用;①监控主从节点状态;②故障告警通知;③自动故障转移;④服务发现,给客户端返回当前 master 地址。
- 部署要求:哨兵集群至少3 个哨兵实例(奇数),依靠 quorum 仲裁,防止脑裂。
- 两个状态概念
- 主观下线:单个哨兵认为节点故障。
- 客观下线:达到 quorum 数量哨兵判定故障,触发故障转移流程。
- 工作流程:检测 master 故障 → 投票选出最优 slave 升级新 master → 其余从节点自动复制新 master。
局限:哨兵只做故障切换,不支持海量数据分片水平扩容,分片需要 Redis‑Cluster 集群。
七、Redis‑Cluster 集群(3 主 3 从,端口号16379)
-
核心原理:Redis 官方分片集群;固定 16384 个哈希槽(0‑16383) ;计算公式
CRC16(key) mod 16384,同一个 key 映射固定槽。 -
3 主 3 从标准架构
- 3 个 Master 主节点:分摊 16384 个哈希槽,承担读写;
- 3 个 Slave 从节点:分别作为对应主节点副本;主节点故障,对应从节点升级为新主节点。
-
创建集群命令
redis‑cli --cluster create 7001 7002 7003 7004 7005 7006 --cluster‑replicas 1
- 客户端连接:
redis‑cli -c -p 7001,‑c开启集群模式自动槽跳转。
限制:集群环境只能使用 db0 逻辑数据库;多 key 操作要求 key 落在同一个哈希槽。 ✅优点:支持海量数据水平分片扩容;自带副本高可用,无中间代理。 ❌缺点:运维复杂度提升;多 key 命令受槽限制。
八、容器部署 Redis(Docker)
1.基础运行单实例 Redis
#拉取镜像
docker pull redis:6.2
#运行容器,端口映射,设置密码,挂载数据卷实现持久化
docker run -d --name redis‑01 -p 6379:6379 -v /opt/redis_data:/data redis:6.2 redis‑server --requirepass "123456" --appendonly yes
#进入容器客户端
docker exec -it redis‑01 redis‑cli -a 123456
2.docker‑compose:编写 yaml 配置,单机编排,一键启停 Redis 服务。
生产注意:挂载
/data目录持久化;设置访问密码;不要直接把容器端口暴露公网。
九、容器部署集群(Docker容器)
1.三大核心概念
- 镜像 image:静态只读模板,包含应用、依赖库、配置。
- 容器 container:镜像运行实例,读写层;一个镜像可以启动多个容器。
- 仓库 registry:存放镜像;Docker Hub 公共仓库,Harbor 私有镜像仓库。
2.常用核心命令
docker pull       #拉取镜像
docker images     #查看本地镜像
docker run        #创建并启动容器
docker ps / ps -a #查看运行/全部容器
docker exec -it   #进入运行容器
docker stop/start #停止、启动容器
docker rm         #删除容器
docker rmi        #删除镜像
docker logs       #查看容器日志
docker volume     #数据卷,实现容器数据持久化
3.内核底层技术
- Namespace:内核隔离(PID、网络、挂载、用户等),容器拥有独立系统视图。
- Cgroup:资源限制,限制容器 CPU、内存、IO,避免耗尽宿主机资源。
4.容器 vs 虚拟机
- 容器:共享宿主机内核;秒级启动;资源开销小;隔离能力较弱。
- 虚拟机:拥有完整独立操作系统内核;分钟级启动;资源开销大;强隔离。
5.docker‑compose:单机多容器编排,yaml 文件描述服务,一键部署整套应用。