多模态 AI 浪潮下,企业的向量数据正以远超预期的速度膨胀。一场"向量数据回流数据湖"的架构迁移悄然发生:以 Lance 开放格式为代表的湖格式正在成为 AI 数据基础设施的新范式之一。围绕这一范式,阿里云 Milvus 交出了一份性能与成本兼得的答卷------以全托管的向量检索服务 Milvus 版作为湖上检索引擎,对 Lance 数据零拷贝直读,让企业在对象存储的成本曲线上,跑出在线级检索的性能。当数据湖逐渐成为企业数据的默认归属,把向量检索能力直接"长"在湖上、而非另建一座数据孤岛,正成为 AI 基础设施演进的确定方向。
一、向量数据的"囤积之痛"
过去,企业做向量检索的主流做法,是把向量从数据湖里导出,灌进专用向量数据库。这带来三重代价:数据双份存储,成本直接翻倍;入湖出湖两条同步链路,数据一致性与工程复杂度居高不下;治理被拦腰截断,湖上的权限、血缘、审计到向量库为止。向量数据成了湖外的"飞地"。
而直接在湖上暴力扫描,延迟与开销随规模线性恶化,百亿级向量基本不可用。业界真正需要的是:向量留在开放格式里享受湖的低成本与开放治理,检索性能却不下线。这正是向量湖要解的题。
二、数据不动,检索来找数据
阿里云 Milvus 方案,是把检索能力"搬到湖边",而不是把数据搬进检索服务。 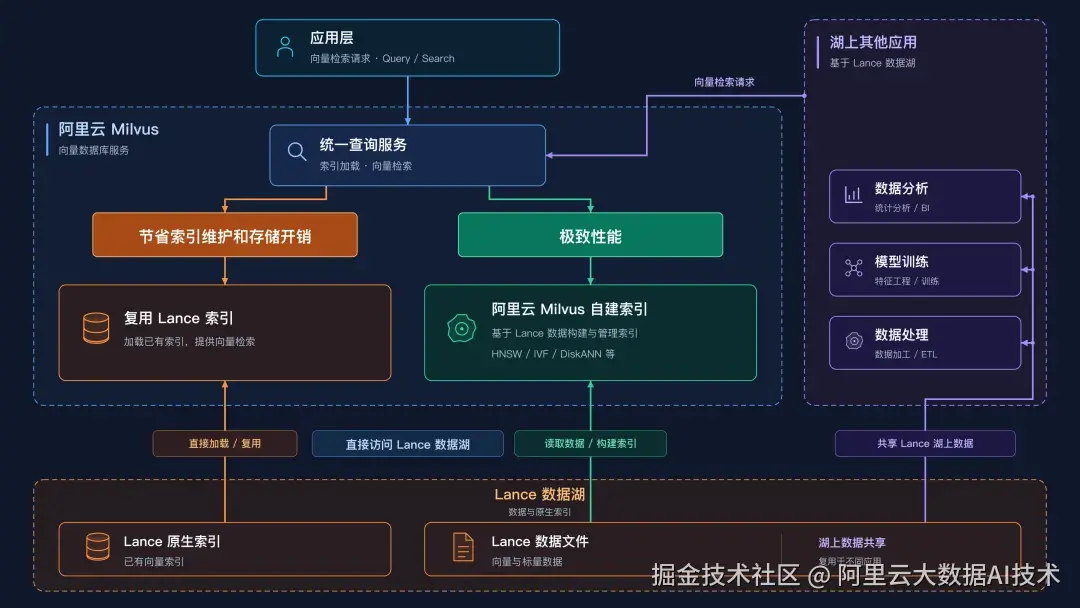 阿里云 Milvus 团队深度参与了开源社区 Milvus 3.0 的湖原生(Lake-Native)架构与 External Collection 能力的从设计到开发的生命周期,阿里云 Milvus(2.6.18+)可以对 OSS 上 Lance 格式的数据直接建立向量索引并对外提供检索服务,也支持直接使用Lance格式已经建好的索引,全程零拷贝、无需数据搬迁,"湖上数据不动,检索来找数据"。
在对象存储这样的"慢介质"上跑出在线检索性能,靠的是引擎层的硬功夫:Milvus 通过列式裁剪与 manifest 索引,大幅降低单次点查的 I/O 开销。存算彻底分离,计算随流量伸缩,存储始终以对象存储计价------性能与成本,第一次不再是单选题。
三、性能与成本,一本算得清的账
在 LAION 1 亿级多模态数据集上,阿里云 Milvus 提供两种检索模式:既能直接复用 Lance 的原生索引,也能在 Lance 数据上构建自有的容量型 AUTOINDEX 索引。对比开源单机方案(LanceDB 自建,32C128G,IVF_RQ),大 TopK 召回场景下二者均实现数量级领先:
| P99 延迟(秒,括号内为召回率) | Top 1 万 | Top 100 万 |
|---|---|---|
| LanceDB 自建(IVF_RQ) | 42.33(0.914) | 2120.60(0.629) |
| Milvus 直读 Lance 索引 | 3.11(0.968) | 24.06(0.651) |
| Milvus AUTOINDEX + Lance | 0.32(0.997) | 4.80(0.975) |
同样直读 Lance 数据,Milvus 把 Top 1 万查询从 42 秒压到 3 秒级、Top 100 万从逾 2000 秒(约 35 分钟)压到 24 秒,延迟仅为开源单机方案的约 1/13 与 1/88;若启用阿里云 Milvus 深度优化的 AUTO INDEX 索引,Top 100 万更是缩短到 4.8 秒、较对手快约 440 倍,召回率还从 0.63 升至 0.98,速度与精度不再互斥。
这里也需要给读者一句提醒:Top 100 万场景下 60% 出头的召回率,往往难以满足很多常见业务的精度要求。选型因此有一条清晰的分界:若确有大批量、高召回的检索需求,现阶段建议直接使用 Milvus 内置索引,以极致性能换来非常高的准确率(上表 Top 100 万召回达 0.975);若对召回与吞吐没有那么高的要求,复用湖上的 Lance 原生索引同样是很好的选择,还能省去额外建索引的开销。而随着阿里云 Milvus 即将推出的 on-demand 计算能力,企业更可以用堪比离线计算的预算,拿到秒级响应的大批量向量检索,真正把"大规模召回"从一项重资产投入,变成按需取用的弹性能力。
以某车企的自动驾驶研发为例,路测采集的海量视频、图像、传感器数据与场景日志本就以开放格式沉淀在数据湖,而挖掘长尾极端场景的相似检索,过去往往要把向量单独导出、再灌进专用库;如果有embedding算法升级,那么全量数据都得重新保存。接入向量湖方案后,检索直接在湖上的 Lance 数据上完成,训练与检索共用同一份底座,数据无需为"能被检索"而再存一份。
四、不只是检索,而是湖上 AI 全链路
检索只是入口,阿里云铺的是整条链路:Milvus AI 中心与 DashScope 通义模型打通一站式向量化,PAI、LangChain 生态支撑 RAG 应用,全托管 Spark/Ray 让批处理与检索共享同一份湖上数据。数据只在湖上存在一份,训练、检索、治理各取所需------湖仓一体由此迈向"湖仓 AI 一体"。
结语
数据基础设施的每一次范式转移,逻辑都一样,那就是让数据留在最开放、最便宜的地方,让计算去找数据。向量湖正重演这一逻辑,而阿里云 Milvus 已把答案写在性能与成本两条曲线上,当百亿级向量检索从"数据库的奢侈消费"变成"对象存储的日常开销",AI 应用的边界也将随之外移,AI 探索物理世界,借助向量湖方案,将会前进一大步。