一、引言
早期的数据处理任务常由 Linux Cron 驱动,这种方式对少量、相互独立的脚本足够有效。在大数据平台中,任务调度远不只是"每天凌晨执行一段 SQL"。一条数据链路可能包含数据采集、清洗、聚合、质量检查、指标计算和结果分发,任务之间存在复杂依赖,还要处理补数、重试、超时、节点宕机和资源隔离。
因此,调度系统逐渐从"定时器"演化为"工作流状态机",它不仅触发任务,还要保存任务状态、判断依赖、分配执行节点、处理事件和恢复异常。
DolphinScheduler 聚焦的正是这类数据工程问题:用 DAG 管理复杂依赖,用可视化界面降低编排门槛,再通过多 Master、多 Worker 和故障转移机制提升调度控制面的可用性。
二、核心定位与概念
Apache DolphinScheduler 是一个面向数据编排场景的分布式、可扩展、可视化工作流调度平台。它使用 DAG 表达任务依赖,由 Master 负责工作流编排和状态推进,由 Worker 执行具体任务,并通过注册中心、元数据库和插件体系构建集群协调及扩展能力。它定位为解决大数据任务依赖复杂、ETL 关系难维护、任务健康状态难监控等问题的平台。
理解 DolphinScheduler,可以先掌握六个概念。
| 概念 | 含义 |
|---|---|
| Project | 工作流、任务定义和实例的组织边界 |
| Workflow Definition | 工作流的静态定义,包含任务节点和依赖边 |
| Workflow Instance | 某次实际运行形成的工作流实例 |
| Task Definition | Shell、SQL、Spark 等任务的静态定义 |
| Task Instance | 某个任务在一次工作流运行中的实例 |
| Schedule | 工作流的定时触发配置 |
静态定义和运行实例必须分开理解。例如,一条"每日销售指标"工作流只有一个定义,但每天运行一次便会产生一个新的工作流实例;工作流内的每个任务也会生成对应任务实例。
DAG 则负责描述任务间的偏序关系:
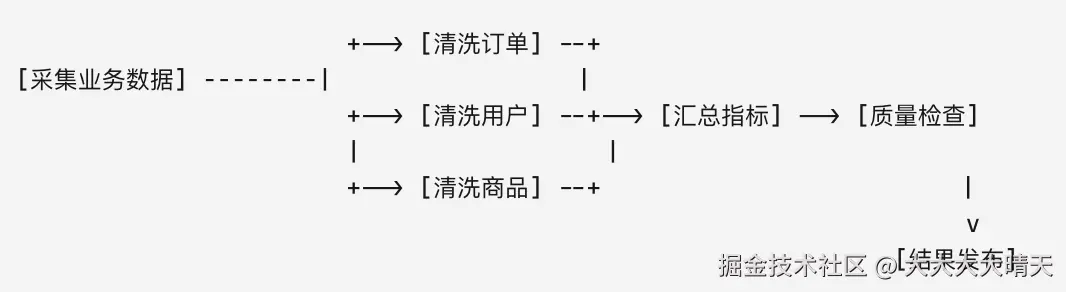
DAG 只规定依赖,不强制所有任务串行。如果三个清洗任务互不依赖,调度器可以并行分发,从而缩短工作流总耗时。
三、总体架构
DolphinScheduler 采用控制面与执行面分离的思路。Master 负责"决定运行什么",Worker 负责"执行具体任务"。
sql
+------------------------- 访问与管理层 --------------------------+
|                                                                  |
|     Browser / Open API / Python SDK                              |
|                 |                                                |
|                 v                                                |
|        +------------------+          +------------------+         |
|        |    API Server    |<-------->|        UI        |         |
|        +------------------+          +------------------+         |
|                 |                                                |
+-----------------|------------------------------------------------+
                  |
                  v
+------------------------- 调度控制层 ------------------------------+
|                                                                  |
|  +----------------+       +----------------+                      |
|  | MasterServer 1 |       | MasterServer 2 |      ...             |
|  | DAG 解析       |       | 状态推进       |                      |
|  | 任务分发       |       | 故障转移       |                      |
|  +--------+-------+       +-------+--------+                      |
|           |                       |                               |
|           +-----------+-----------+                               |
|                       |                                           |
|               +-------v--------+                                  |
|               | Registry Center|                                  |
|               | ZK/JDBC/Etcd   |                                  |
|               +----------------+                                  |
|                                                                  |
|               +----------------+                                  |
|               | Metadata DB    |                                  |
|               | 定义/实例/命令 |                                  |
|               +----------------+                                  |
+---------------------------|---------------------------------------+
                            |
                            v
+------------------------- 任务执行层 ------------------------------+
|                                                                  |
|  +----------------+  +----------------+  +----------------+       |
|  | WorkerServer 1 |  | WorkerServer 2 |  | WorkerServer N |       |
|  | Shell / SQL    |  | Spark / Flink  |  | DataX / Python |       |
|  +----------------+  +----------------+  +----------------+       |
|                                                                  |
+---------------------------|---------------------------------------+
                            |
                            v
                  HDFS / Hive / Spark / Flink
                  数据库 / 对象存储 / 外部 API

                          +----------------+
                          |  AlertServer   |
                          | 邮件/脚本/插件 |
                          +----------------+
1.MasterServer
MasterServer 是工作流调度的大脑,主要负责:
- 扫描待执行命令;
- 创建或恢复工作流实例;
- 解析 DAG;
- 判断当前哪些任务满足运行条件;
- 创建并持久化任务实例;
- 选择 Worker 并分发任务;
- 接收任务状态事件;
- 推进后继节点;
- 处理超时、重试和故障转移。
Master 内部值得关注的组件包括:
| 组件 | 职责 |
|---|---|
| DistributedQuartz | 管理周期调度的启停 |
| MasterSchedulerService | 扫描 t_ds_command 并处理调度命令 |
| WorkflowExecuteRunnable | 解析 DAG,推进工作流状态 |
| TaskExecuteRunnable | 创建、持久化和提交任务实例 |
| EventExecuteService | 消费工作流运行事件 |
| StateWheelExecuteThread | 处理超时、重试和依赖轮询 |
| FailoverExecuteThread | 处理 Master、Worker 故障转移 |
DolphinScheduler 的核心并不是简单地遍历 DAG,而是以事件和持久化状态驱动整个工作流生命周期。
2.WorkerServer
WorkerServer 是任务执行节点。它接收 Master 下发的任务,将任务放入线程池,然后由对应任务插件执行。
Worker 内部的关键职责包括:
WorkerManagerThread:消费任务队列并提交线程池;TaskExecuteThread:调用相应任务插件;RetryReportTaskStatusThread:向 Master 上报状态,未收到 ACK 时继续重报。 状态 ACK 重报值得特别注意。分布式系统中,任务已经执行完成,不代表 Master 一定收到完成消息。Worker 在未收到确认时继续上报,可以降低网络抖动导致任务状态丢失的概率。
3.注册中心
注册中心承担以下职责:
- Master、Worker 服务注册;
- 节点存活状态维护;
- 节点变化事件通知;
- 分布式锁;
- 故障转移协调。
DolphinScheduler 支持多种注册中心,有 ZooKeeper、JDBC Registry 和 Etcd 三种实现。
4.元数据库
元数据库保存工作流调度的持久化状态,包括:
- 用户、租户和项目;
- 工作流定义及版本;
- 调度配置;
- 调度命令;
- 工作流实例;
- 任务实例;
- 执行状态和参数。
Master 会扫描数据库中的t_ds_command 表来获取待处理命令。数据库因此不只是配置存储,也是调度链路中的关键组件。数据库连接池、索引、事务延迟和可用性都会影响控制面的稳定性。
四、一次工作流如何运行
DolphinScheduler 的典型执行过程如下:
yaml
用户发布并触发工作流
          |
          v
生成调度命令,写入元数据库
          |
          v
MasterSchedulerService 扫描 t_ds_command
          |
          v
创建或恢复 Workflow Instance
          |
          v
解析 DAG,查找当前可运行节点
          |
          v
创建并持久化 Task Instance
          |
          v
按 Worker Group 与负载策略选择 Worker
          |
          v
Worker 调用任务插件执行
          |
          v
Worker 上报 RUNNING / SUCCESS / FAILURE
          |
          v
Master 更新状态并检查后继依赖
          |
     +----+----+
     |         |
依赖满足    仍需等待
     |         |
     v         +------> 等待后续事件
调度后继任务
     |
     v
所有节点进入终态
     |
     v
计算工作流最终状态并触发告警
这里有三个工程细节。
第一,Master 会先持久化任务实例,再进行任务分发。这使系统能够在故障恢复时识别哪些任务已经创建、哪些任务已经提交、哪些任务仍在运行。
第二,Master 推进的是状态机,而不只是调用脚本。一次状态变化可能触发后继节点、重试、失败策略、告警或工作流结束。
第三,任务执行结果必须具备幂等语义。调度系统可以重新提交任务,却无法自动判断重复执行一条INSERT 、文件上传或外部接口调用是否会产生业务副作用。
五、Worker 负载分配
Worker 选择策略包括:
RANDOM:随机选择;ROUND_ROBIN:轮询;FIXED_WEIGHTED_ROUND_ROBIN:固定权重平滑轮询;DYNAMIC_WEIGHTED_ROUND_ROBIN:动态权重平滑轮询。
动态权重策略会综合 CPU 使用率、内存使用率和任务线程池使用率,默认权重分别为 30%、30% 和 40%,三项配置之和必须为 100。负载越低的 Worker,越容易被选中。
调度器看到的"线程池较空"不一定意味着业务执行引擎也有资源。例如 Worker 只负责提交 Spark 作业,而 Spark 集群已经过载,此时 Worker 指标无法完整反映下游计算资源。因此,Worker 分配策略还应配合 Yarn、Kubernetes 或 Spark 队列容量管理。
六、容错机制
1.Master 故障转移
多个 Master 会向注册中心注册。某个 Master 失联后,存活 Master 获取故障转移锁,接管相关工作流实例,然后根据数据库中的持久化状态重新分析 DAG。
恢复过程大致如下:
yaml
Master A 宕机
     |
     v
注册中心检测节点消失
     |
     v
Master B 获取故障转移锁
     |
     v
查询 A 负责的工作流实例
     |
     +--> RUNNING 任务:继续监控
     |
     +--> 已创建但未入队任务:重新提交
     |
     +--> 已完成任务:保留状态
     |
     v
重新计算 DAG,继续推进
分布式锁用于避免多个 Master 同时恢复同一个实例,节点与注册中心连接超时可能由网络抖动导致;相关服务会选择停止自身,防止节点在失去协调能力后继续运行。
2.Worker 故障转移
Worker 失联后,Master 找出该 Worker 上的任务实例,将任务置于故障转移状态,并重新提交。
这并不等于业务层面的"恰好执行一次"。例如:
sql
INSERT INTO result_table
SELECT * FROM source_table;
如果任务在写入成功后、状态上报前发生故障,调度器可能重跑任务。业务应通过分区覆盖、事务、幂等键或先写临时表再交换分区等方式控制重复执行风险。
3.三种重跑行为
DolphinScheduler 区分三种容易混淆的行为:
| 行为 | 级别 | 触发方式 | 起点 |
|---|---|---|---|
| 任务失败重试 | Task | 自动 | 当前失败任务 |
| 工作流失败恢复 | Workflow | 手动 | 失败节点或指定节点 |
| 工作流重新运行 | Workflow | 手动 | 工作流起点 |
任务重试适合瞬时错误,例如网络超时。失败恢复适合修复数据或环境后继续执行。全量重跑则适合前序结果也需要重新生成的场景。
七、功能特性与优势
- 可视化 DAG:DolphinScheduler 支持通过 Web UI 拖拽任务节点并连接依赖边。相比纯代码式工作流,可视化方式更便于数据开发、运维和业务技术人员共同查看依赖关系。
- 任务插件:DolphinScheduler 通过插件封装具体任务类型,常见类型包括shell/sql/spark/flink/datax/http/子工作流等。
- 工作流运维:DolphinScheduler具备定时、暂停、恢复、停止、全局及局部参数等工作流控制能力,并强调可视化 DAG、模块化、高可靠和扩展性。
- 补数能力:DolphinScheduler提供补数能力,用于重新计算过去某个时间区间的数据。串行补数对下游压力小,适合任务间存在跨日依赖的场景;并行补数速度更快,但可能瞬间占满数据库、计算队列或外部接口限额。
DolphinScheduler的主要优势:
- 面向数据工程的开箱体验:DolphinScheduler 把 SQL、Shell、Spark、Flink、数据集成、依赖检查和子工作流放在统一平台中。对于传统大数据平台,它通常比从通用任务队列或 Cron 自建依赖系统更省成本。
- 可视化与平台治理结合:可视化 DAG 不只降低创建门槛,也便于故障定位。运维人员可以直接观察失败节点、上下游影响和任务日志,而不必先阅读一套代码仓库。
- 分布式控制面:多 Master 和多 Worker 支持横向扩展。Master 负责调度计算,Worker 负责执行,两类服务可以按不同压力分别扩容。
- 恢复手段较完整:任务重试、失败节点恢复、全流程重跑和服务故障转移分别覆盖不同故障层级。对于依赖链较长的数据工作流,这比"失败后全部重跑"更节省计算资源。
- 插件边界清晰:任务、告警和注册中心均具有插件化扩展路径。团队可以把公司内部计算平台或数据工具封装为任务插件,而不用改写整个调度内核。
DolphinScheduler的局限与使用边界:
- 元数据库压力不可忽略:调度命令、工作流实例和任务实例都保存在数据库中。当任务数量很大时,数据库写入和状态更新可能成为瓶颈。(慢 SQL/表和索引膨胀/历史实例清理/连接池使用率/大字段查询等)
- 调度容错不等于任务幂等:Worker 故障转移、网络超时和状态重报都可能形成不确定的执行边界。任务设计应默认接受"可能重试",并通过业务主键、分区覆盖、事务或去重机制控制副作用。
- Worker 环境治理有成本:如果通过物理机 Worker 运行 Shell、Spark、Flink、Python 等任务,各节点必须保持客户端、配置文件、JAR、Python 包和环境变量一致。环境漂移会导致"同一个任务在某些 Worker 成功、在另一些 Worker 失败"。
- 可视化编排也会产生治理问题:在 UI 中直接修改工作流很方便,但如果没有发布规范,容易出现环境定义不同、修改缺少代码审查、变更来源不可追踪、批量迁移困难等问题。
八、适用场景
DolphinScheduler 较适合以下场景:
- 企业数据中台和离线数仓;
- Spark、Flink、Hive、SQL 混合任务;
- 数据采集、清洗、质量检查和指标计算;
- 需要按业务日期补数的数据链路;
- 数据开发与运维人员共同管理工作流;
- 需要多租户、Worker Group 和资源权限的平台;
- 希望通过 UI 降低 DAG 维护门槛的团队。
以下场景需要谨慎评估:
- 所有任务都已容器化,并以 Kubernetes CRD 和 GitOps 为主要治理方式;
- 团队坚持工作流必须由代码定义并通过单元测试及代码审查;
- 只有少量独立 Cron 任务,没有复杂依赖和补数需求;
- 大量任务要求强事务或严格的 exactly-once 语义;
- 主要需求是实时流式事件处理,而不是批处理工作流编排。
九、部署使用
DolphinScheduler 提供多种部署方式:
| 方式 | 适用范围 | 特点 |
|---|---|---|
| Standalone | 本地体验 | 部署简单,不适合生产 |
| Pseudo-Cluster | 单机完整验证 | 各组件独立,但运行在同一机器 |
| Cluster | 传统生产环境 | 多机部署 Master、Worker、API、Alert |
| Docker Compose | 本地集成测试 | 快速拉起数据库、注册中心和服务 |
| Kubernetes/Helm | 云原生环境 | 使用 Helm 管理部署和扩缩容 |
基本部署过程如下:
yaml
准备 JDK、数据库、注册中心
          |
          v
下载并解压 DolphinScheduler
          |
          v
安装所需插件依赖和 JDBC Driver
          |
          v
配置数据库、注册中心、时区和任务运行环境
          |
          v
初始化元数据库
          |
          v
启动 API / Master / Worker / Alert
          |
          v
创建租户、用户、项目和工作流
          |
          v
发布并运行工作流
各服务启动成功后,默认 UI 地址为:http://localhost:12345/dolphinscheduler/ui 。
DolphinScheduler最小使用路径可以归纳为:
sql
创建 Tenant
    |
创建并授权 User
    |
创建 Project
    |
创建 Workflow
    |
拖入 Shell / SQL 等任务
    |
连接上下游依赖
    |
配置重试、超时和 Worker Group
    |
保存并上线
    |
手动运行或配置 Schedule
    |
查看 Workflow Instance
    |
进入 Task Instance 查看日志
User 和 Tenant 不是同一个概念:
- User 用于登录、调用 API 和执行管理操作;
- Tenant 表示任务实际执行时使用的租户身份;
- 在传统 Linux Worker 上,Tenant 通常需要映射到操作系统用户。
十、同类平台对比
| 维度 | DolphinScheduler | Airflow | Oozie | Azkaban | Argo Workflows |
|---|---|---|---|---|---|
| 工作流定义 | GUI、API、Python SDK | Python 代码 | XML | Job 配置和项目包 | YAML、Kubernetes CRD |
| 核心运行环境 | Java 分布式服务 | Python 组件及多种 Executor | Hadoop/YARN | JVM、多 Executor | Kubernetes |
| UI 定位 | 创建、运维、监控 | 查看、触发、调试 | 管理和监控 | 上传、运行、监控 | 查看和管理 |
| 主要优势 | 数据任务开箱即用、可视化 | Python 生态、代码治理 | Hadoop 数据依赖触发 | 模型简单、适合存量批任务 | 容器原生、GitOps |
| 适合团队 | 数据平台、多角色协作 | Python 工程团队 | 存量 Hadoop 平台 | 传统批处理平台 | Kubernetes/云原生团队 |
| 主要限制 | 版本与插件治理成本 | 非开发人员编排门槛高 | 技术栈及文档偏旧 | 现代生态覆盖有限 | 强依赖 Kubernetes |
调度平台选型建议:
lua
所有任务是否已经容器化,并以 Kubernetes 为统一底座?
    |
    +-- 是 --> 是否强调 CRD、GitOps、Pod 级资源控制?
    |             |
    |             +-- 是 --> 优先评估 Argo Workflows
    |
    +-- 否 --> 团队是否希望主要使用 Python 代码定义 DAG?
                  |
                  +-- 是 --> 优先评估 Airflow
                  |
                  +-- 否 --> 是否需要可视化编排、补数和多角色协作?
                                |
                                +-- 是 --> 优先评估 DolphinScheduler
                                |
                                +-- 否 --> 是否维护传统 Hadoop 存量系统?
                                              |
                                              +-- Oozie / Azkaban