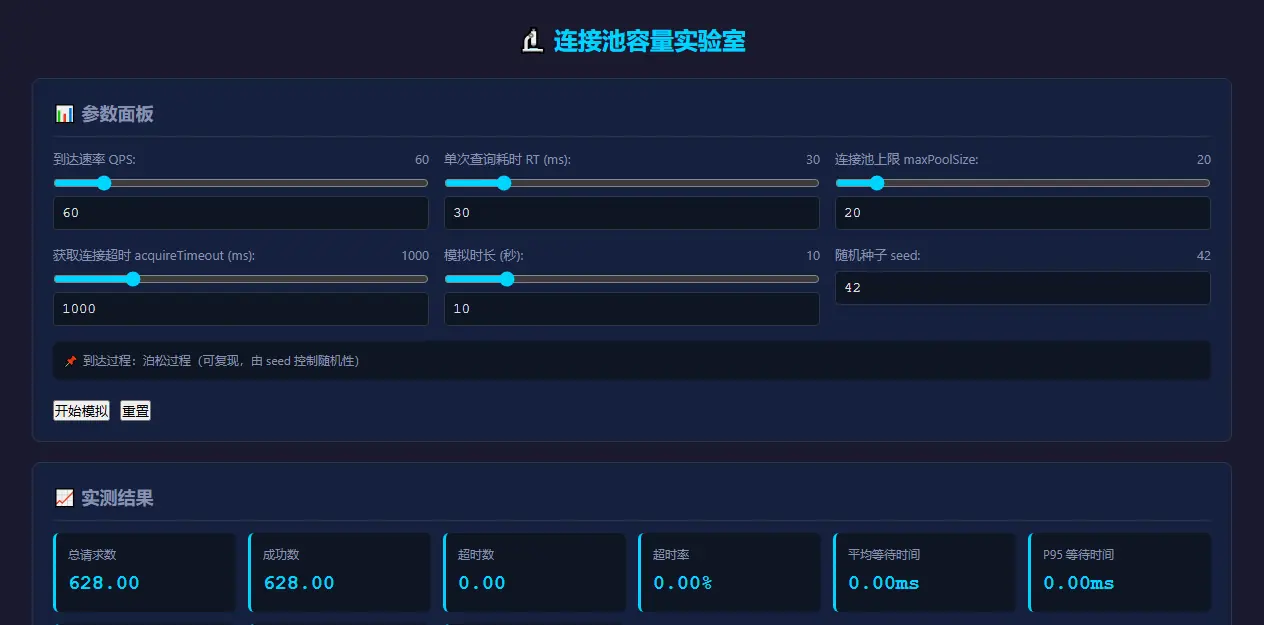
同一份参数,我只改连接池上限,让 3000 个请求轮流去抢连接。
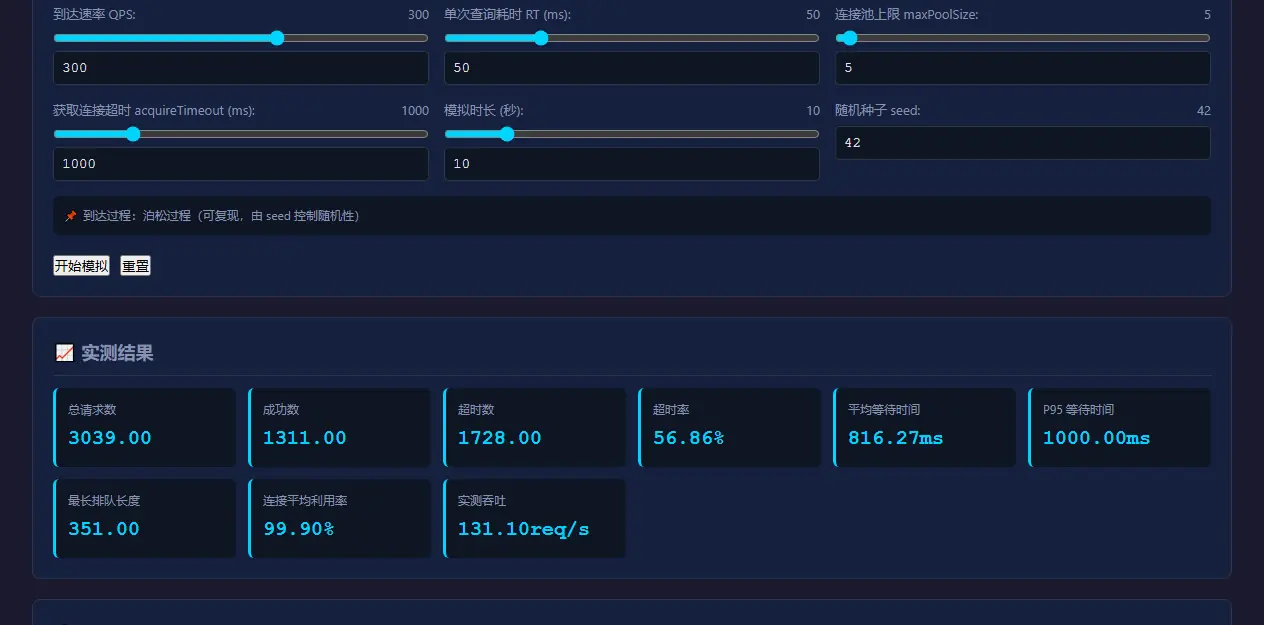
池配 5,1728 个请求拿到超时,超时率 56.86%,平均要等 816 毫秒。
池配 20,一个都没超时,平均等待 1.13 毫秒。
再往上一档,池配 40,一样是 0% 超时,只是连接平均利用率从 75.66% 掉到 37.83%。
| 我关心的 | 跑出来的结果 |
|---|---|
| QPS 60 / RT 30ms / 池 2 | 0% 超时,但平均等待 49.75ms、P95 150ms |
| QPS 60 / RT 30ms / 池 20 | 0% 超时,平均等待 0ms,利用率 9.39% |
| QPS 300 / RT 50ms / 池 5 | 56.86% 超时,平均等待 816.27ms,最长队列 351 |
| QPS 300 / RT 50ms / 池 20 | 0% 超时,平均等待 1.13ms,利用率 75.66% |
| QPS 500 / RT 60ms / 池 20 | 24.36% 超时,最长队列 556 |
| 自检断言 | 默认参数 17/18 通过,加压参数 18/18 通过 |
一句话结论:池小于 QPS 乘 RT 再除以 1000,超时率会陡起来;池大于这条线,再加池只是浪费连接。
成品是一个 index.html,双击就能跑,不联网、不引第三方库、没有构建步骤。
案例目录在这里,下载下来直接打开:
text
https://atomgit.com/deli007/demo_park/tree/main/codearts-connection-pool-lab这是一个跑在浏览器里的排队沙盘,不是压测工具。
它的请求是页面自己按泊松过程造出来的,连的是内存里的假连接,所以它算的是「参数配错会怎样」,不是真实数据库能扛多少 QPS。
为什么值得看:连接池配小了不报错,只会超时
连接池大小是少数几个配错不会报错的参数。
配小了,监控上只是偶尔冒出几个获取连接超时;配大了,连接数上去了,数据库那头的连接数上限又顶不住。
常见的经验公式「核数乘 2 加 1」,在数据库这条链路上基本没用。
真正决定池大小的是三个数:到达速率、每次查询要占用连接多久、你能容忍多长的排队等待。
这三个数都是能算的,我把它做成一个页面,一秒一秒地摊开给你看。
一、先看结果:池大小和超时率之间有一条线
我把 QPS、RT、获取超时(1000ms)、模拟时长(10 秒)、随机种子(42)都固定,只动池上限。
| QPS | RT | 池上限 | 负载 ρ | 总请求 | 超时数 | 超时率 | 平均等待 | P95 等待 | 最长队列 | 利用率 |
|---|---|---|---|---|---|---|---|---|---|---|
| 60 | 30ms | 2 | 0.90 | 628 | 0 | 0% | 49.75ms | 150ms | 15 | 92.90% |
| 60 | 30ms | 5 | 0.36 | 628 | 0 | 0% | 0.54ms | 0ms | 5 | 37.55% |
| 60 | 30ms | 10 | 0.18 | 628 | 0 | 0% | 0ms | 0ms | 0 | 18.77% |
| 60 | 30ms | 20 | 0.09 | 628 | 0 | 0% | 0ms | 0ms | 0 | 9.39% |
| 300 | 50ms | 5 | 3.00 | 3039 | 1728 | 56.86% | 816.27ms | 1000ms | 351 | 99.90% |
| 300 | 50ms | 20 | 0.75 | 3039 | 0 | 0% | 1.13ms | 9ms | 9 | 75.66% |
| 300 | 50ms | 40 | 0.38 | 3039 | 0 | 0% | 0ms | 0ms | 0 | 37.83% |
| 500 | 60ms | 20 | 1.50 | 5091 | 1240 | 24.36% | 799.20ms | 1000ms | 556 | 99.76% |
| 500 | 60ms | 35 | 0.86 | 5091 | 0 | 0% | 1.67ms | 10ms | 13 | 86.96% |
ρ 是负载,等于 QPS 乘 RT 再除以 1000 乘池上限。
前四行藏着一个容易被忽略的事:QPS 60、RT 30ms、池只给 2,超时率是 0%。
不是因为它够用,而是因为获取超时填了 1000ms,而最长排队也没超过 150ms。
池 2 那行连接利用率 92.90%,池 5 直接掉到 37.55%。
池从 2 加到 5,换来的不是「不超时」,是「不用排队」。
后面四行是真正翻车的场景:负载 ρ 超过 1 之后,队列会一直涨。
QPS 300、池 5 的时候最长队列到 351,P95 等待顶在 1000ms,那是被获取超时掐掉的。
二、池大小的那条线,就在 QPS 乘 RT 除以 1000
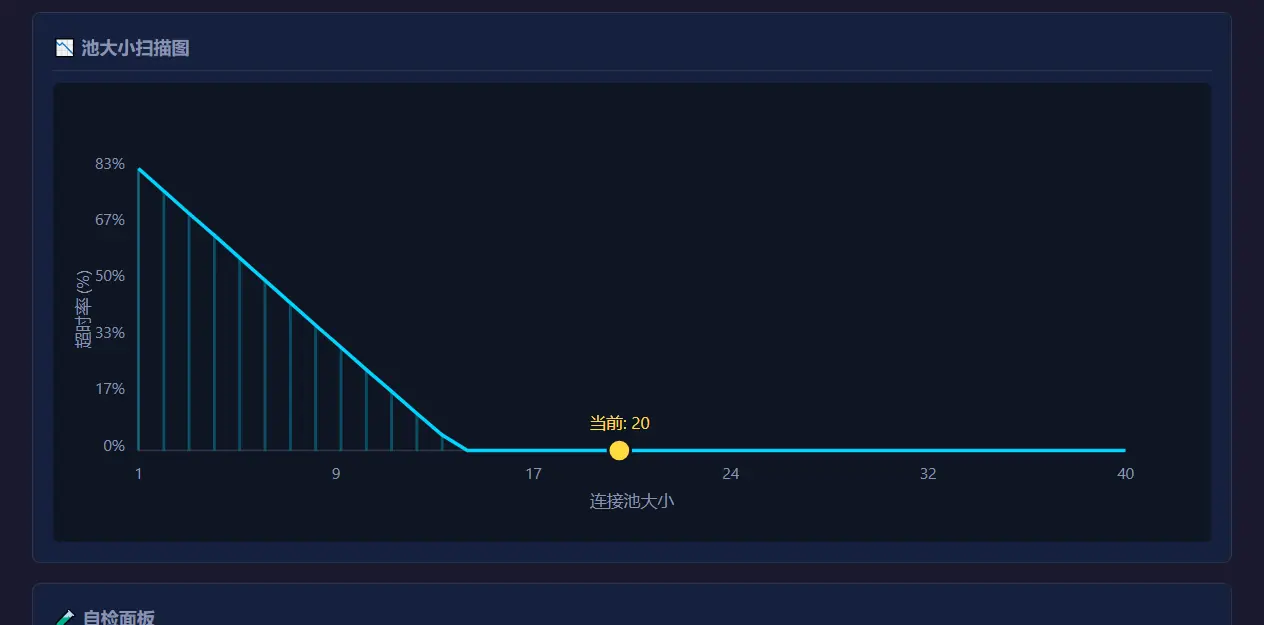
QPS 300、RT 50ms,一个连接每秒最多服务 20 个请求(1000 除以 50),300 个请求需要 15 个连接。
页面上那条曲线,池从 1 开始的 83% 一路往下,到 14 左右贴到 0%,之后一直是 0%。
15 就是这条线:QPS 乘 RT 除以 1000。
比它小,排队时间会随负载指数式往上走;比它大,超时率就一直是 0。
至于要大多少,取决于你愿意接受多长的排队,这部分下一页再说。
三、超时阈值才是超时率的旋钮
池不变,只改获取连接超时,同一份流量给出三组完全不同的数字。
| 池上限 | 获取超时 | 超时数 | 超时率 | 平均等待 | 吞吐 |
|---|---|---|---|---|---|
| 5 | 100ms | 2009 | 66.11% | 93.91ms | 103.00 req/s |
| 5 | 1000ms | 1728 | 56.86% | 816.27ms | 131.10 req/s |
| 5 | 5000ms | 473 | 15.56% | 2750.77ms | 256.60 req/s |
QPS 300、RT 50ms、池 5,负载 ρ 一直是 3,池一点没动。
把获取超时从 100ms 放到 5000ms,超时率从 66.11% 掉到 15.56%,看起来好看了四倍多。
但平均等待从 93.91ms 一路涨到 2750.77ms。
超时率、等待时间、吞吐这三个数是一起动的,把超时调大只是把「失败」换成了「变慢」。
真实系统里,那个 2750ms 的等待会占用上游的线程和连接,代价只是从数据库挪到了应用层。
四、理论公式和实测,差的不是精度
页面右边那栏用 Erlang-C(M/M/c)算理论值。
池 2、QPS 60、RT 30ms 的时候,理论给的排队概率是 85.26%,而实测超时率是 0%。
这两个数不是一回事:P(wait) 说的是「需要不需要排队」,超时率说的是「排队有没有超过你设的阈值」。
拿 P(wait) 当超时率看,池 2 会被误判成重度故障。
反过来,池足够大的时候,理论的平均系统请求数还是能对上的:QPS 300、池 20 时理论 15.481,实测 16.033,差 3.56%。
所以理论值的正确用法是判断「池够不够」,不是预测「会有多少请求失败」。
五、怎么做与踩坑:这不是一把过的
我在码道 Web 里把需求写清楚:1 毫秒一个时间步、泊松到达、每个请求占一个连接 RT 毫秒带正负 20% 抖动、等待超过获取超时就记失败、页面上要有自检面板。
第一版生成出来,逻辑看着对,跑起来全是错的。
最要命的一处:连接用完是用 setTimeout 归还的,而整个模拟循环是同步跑完的,回调在循环结束前根本不会执行。
结果就是第 21 个请求之后连接再也不释放。默认参数跑出来 600 个请求、520 个超时、超时率 86.67%,而同样参数的理论排队概率应该接近 0。
第二处是自检面板一片空白。runAssertions 里写了一行 bindParam(...)(),而 bindParam 不返回函数,直接抛 TypeError,异常没人接住,面板就空着。
第三处在理论对照栏:理论值是 0 的时候,偏差百分比算出了 9105379845733382%。
我把这三条整理成一份缺陷清单发回去,要求用模拟时间推进、不要用任何真实时间 API,自检外面套 try/catch。
修复版把引擎改对了(每个连接记一个 busyUntil 释放时刻),但合并的时候把 runAssertions 定义了两遍。
多出来的那份还带着一个没有 try 的 catch,整个页面直接白屏,点什么都没反应。
我把重复的那份删掉,页面才跑出上面这些数字。
六、验证与踩坑:18 条断言里那条红的
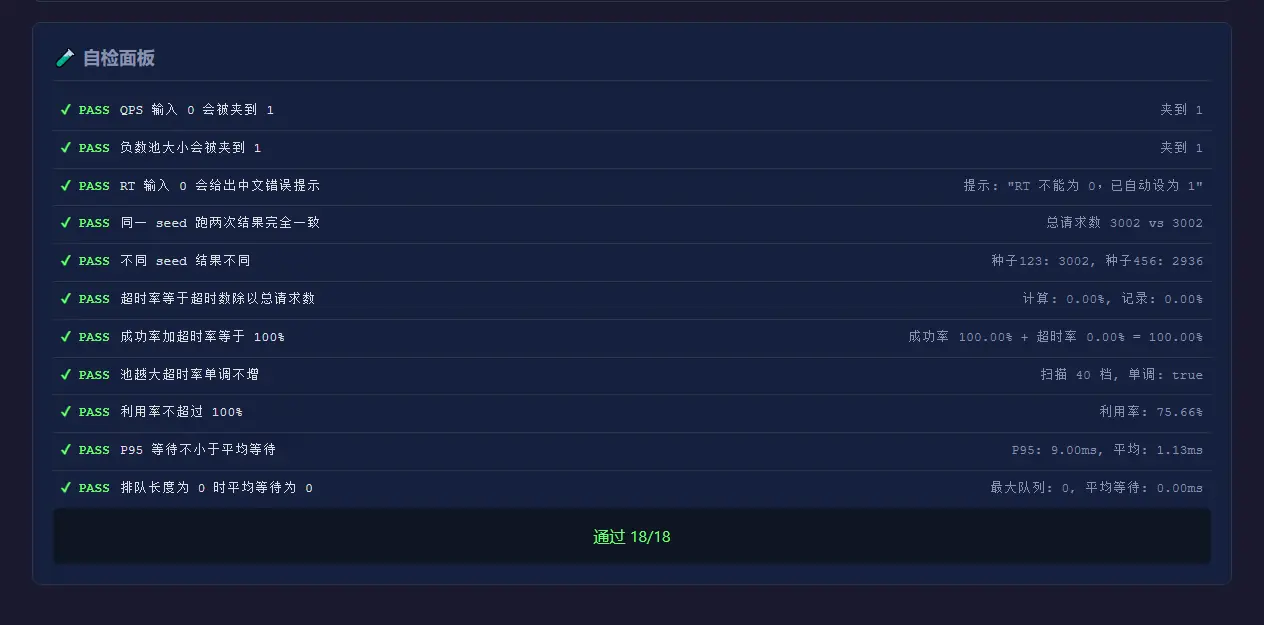
页面加载后自动跑 18 条断言,覆盖输入夹紧、可复现性、指标一致性、单调性、过载判定。
默认参数(QPS 60、RT 30ms、池 20)下是 17/18,唯一红的是「RT 抖动生效(等待有变化)」这条。
它断言平均等待大于 0。可池够大的时候连接随手就有,平均等待真就是 0,这条断言必然红。
这是断言本身写错了,不是代码错了,我把它如实留在了页面里。
换成 QPS 300、RT 50ms、池 20 之后,18 条全绿。
七、失败路径:RT 填 0 会怎样
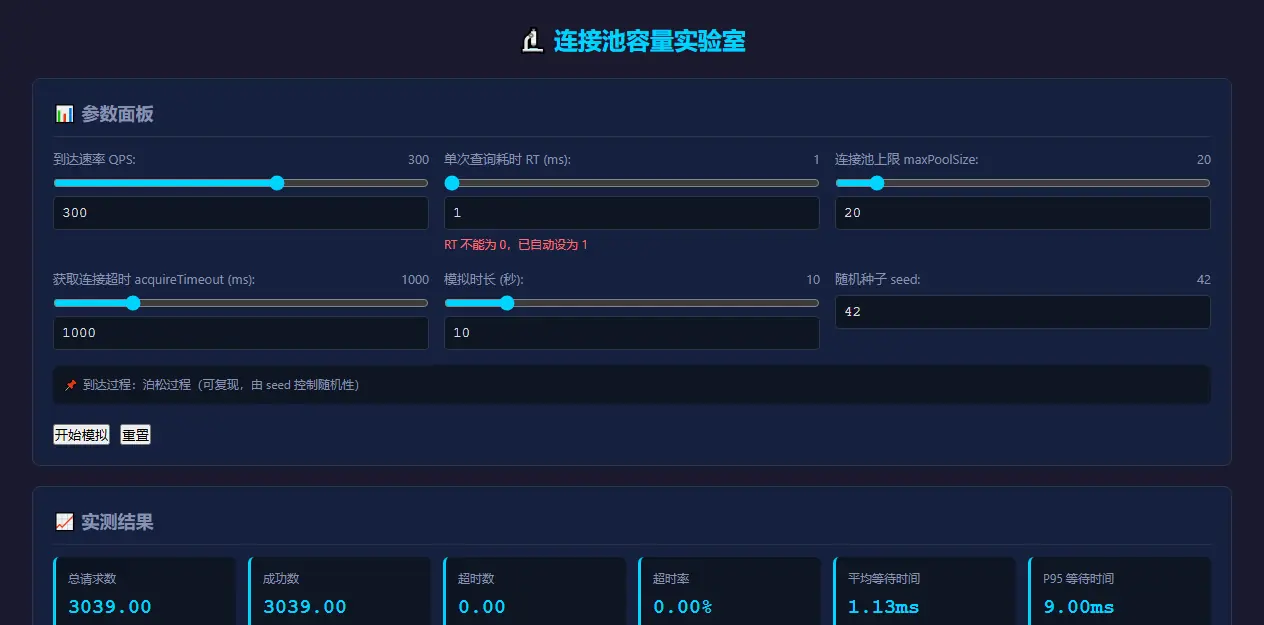
我把 RT 输入框手动改成 0。
页面立刻在下面给出红字提示「RT 不能为 0,已自动设为 1」,同时把参数夹回 1,没有白屏。
上一次的运行结果也还在,没被清掉。
同类的夹紧还有两条:QPS 填 0 会被夹到 1,池上限填负数会被夹到 1,自检面板里都有对应的 PASS。
已知的边界也交代一下:获取超时输入框因为滑块步长是 100,只能填 100 的整数倍。
而且想表示「不超时」填 0 是不生效的,页面读到 0 会当成没填、回落到默认的 1000ms,这一条我没改,写在页面里当已知问题。
八、本地复现
页面是单文件,不需要构建:
text
python3 -m http.server 8080然后在浏览器里打开 http://localhost:8080/index.html,或者直接双击 index.html。
要复核里面的数字,改完参数点「开始模拟」,种子保持 42,同一份参数会给出完全一样的结果。
自检面板在页面最下面,18 条断言的通过数和实际值都在那里。
九、准备环境:进入码道 Web
码道有三种使用方式:WebUI(浏览器对话)、TUI(终端命令行)和桌面 IDE(IDE 插件)。本文用 WebUI 版演示。
浏览器打开码道 Web 版:devcloud.cn-north-4.huaweicloud.com/chat?source...,登录后就能在对话窗口输入需求,不需要装软件。
十、使用码道体会
这次最值钱的经验是「把验收方式写进需求」。
我在需求里写明「页面上要有自检面板,逐条显示 PASS/FAIL 和实际值」,交付时就有了 18 条可点可验的断言,文章里的测试数才有出处。
第二点是交付后一定要自己跑一遍。
上面那三个缺陷,看代码看不出来,跑一次默认参数就露馅了------86.67% 的超时率太反常,顺着反常的数字往回查,才找到 setTimeout 那一行。
第三点是修复轮要带清单,不要只说「再优化一下」。
我把「哪个函数、什么现象、期望值是多少」一条条写清楚,修复才落到了点上;即便如此,合并时还是会出岔子,所以修完必须重跑一遍验收。
十一、总结
连接池配多大,先算 QPS 乘 RT 除以 1000。
低于这条线,超时率会陡起来,怎么调超时都只是把失败换成变慢。
高于这条线,接着决定你能接受多长的排队等待,再留一点余量就够了,多配的连接只是闲在那里占着数据库的连接数。
案例目录(下载下来双击就能跑):
text
https://atomgit.com/deli007/demo_park/tree/main/codearts-connection-pool-lab全部实测数据和自检结果都能在页面里自己复现,种子填 42 就是我这篇里的数字。