数据同步中断后,KFS 怎么把链路接回来
在线迁移时,同步服务停一次并不可怕,麻烦在于它重新启动以后,没人能说清楚"接着传"究竟接在什么位置。源端的订单还在写,支付状态还在变,目标端可能已经落后了一段时间。这个时候重做全量往往没有窗口,直接从当前时间继续又可能漏掉中间的事务。
遇到这种情况,我会把链路拆开看:源端有没有读到新事务,跟踪文件有没有留下尚未应用的内容,目标端最后落到了哪一笔。金仓异构数据同步软件 Kingbase FlySync(KFS)正是按这几段工作------采集已提交事务,写入跟踪文件,再由应用端写入目标库。官方KFS 产品介绍列出的实时同步和数据流转,落到现场排查时就是这三个位置。位置对上了,后面的恢复动作才有依据。
先确认中断发生在哪一段
KFS 增量同步时,目标库不会反过来轮询源库。源端提交的 INSERT、UPDATE、DELETE 先由采集模块读取,跟踪文件暂存变更,应用模块再把文件里的内容写到目标端。目标端连接中断时,采集可能还在继续;也可能采集已经停了,只是应用端没有跟上。两种情况处理方法不同,不能只看一个服务状态就下结论。
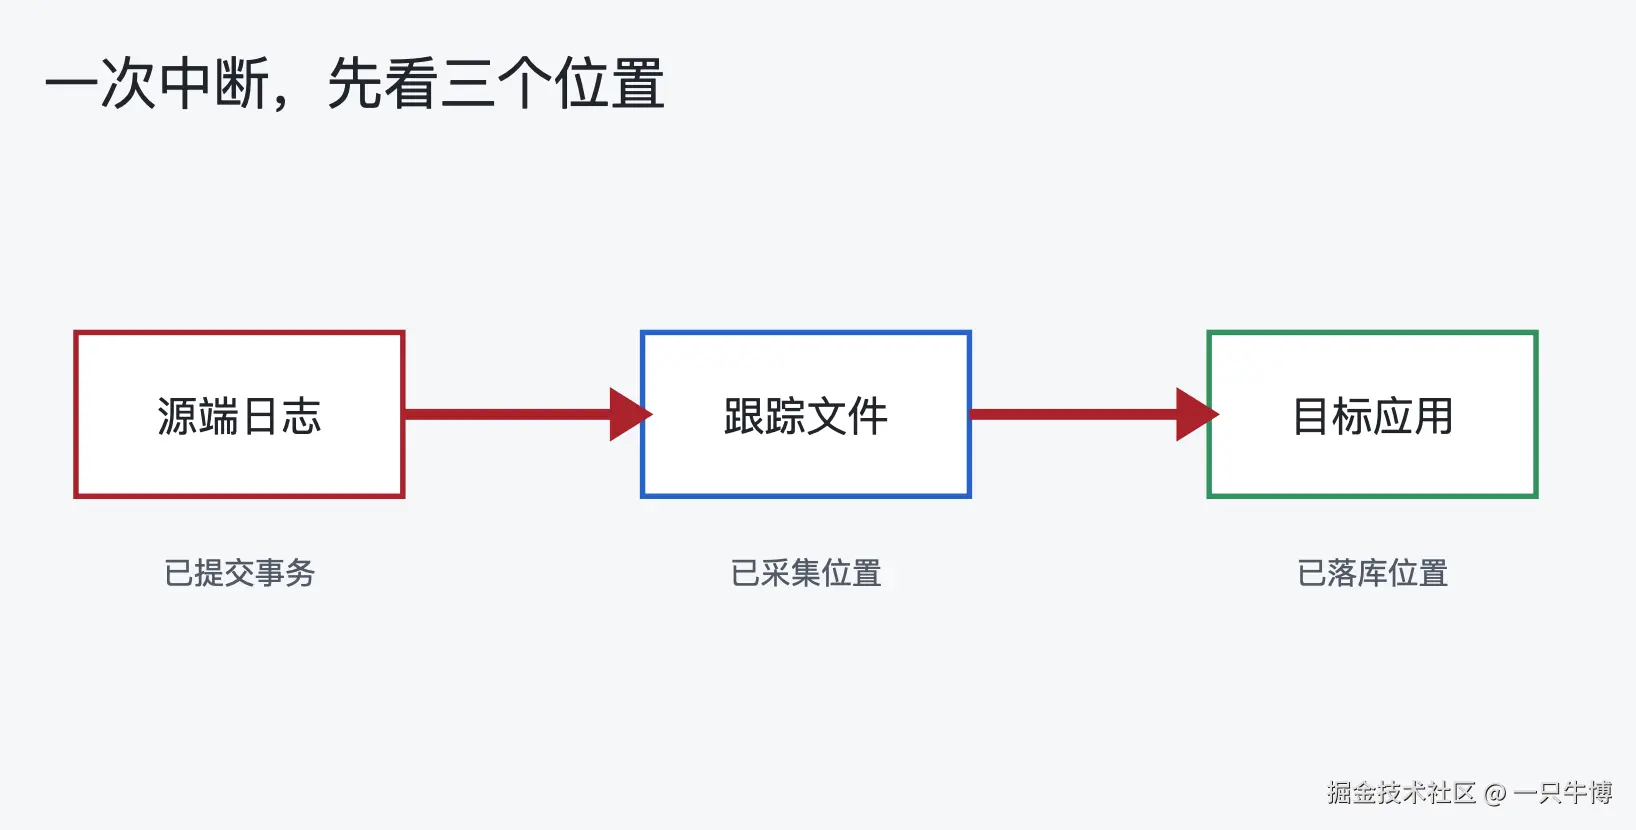
现场我按固定顺序敲这三条命令,先看服务,再看解析位置,最后看跟踪文件:
lua
replicator status
fsrepctl status
kufl list
replicator status 显示 ERROR 或 OFFLINE 时,我先把三条命令的输出留档,再去看日志和目标库连接。这个阶段不清理跟踪文件,也不直接执行跳过序号的命令;最后位置还在,才能继续判断是采集没有前进、文件没有传完,还是应用线程卡在目标库连接上。等原因确认后,再决定从原位恢复还是处理某一笔异常事务。
用事务边界判断是否真的落后
同步延迟可以用时间看,也可以用业务表里的更新时间看。时间差适合看趋势,业务水位适合判断某一批订单有没有到达目标端。比如订单表里有 updated_at 和单调递增的 change_id,可以在两端各查一次当前水位:
sql
SELECT MAX(change_id) AS max_change_id,
       MAX(updated_at) AS last_updated_at,
       COUNT(*) AS row_count
FROM biz_order
WHERE updated_at >= TIMESTAMP '2026-10-01 00:00:00';
这条 SQL 不能代替 KFS 的位点信息。它只能告诉我们业务表目前看到了什么,不能证明源端某个事务已经被目标端按原顺序应用。真正排查时,我会把水位查询和同步服务输出放在一起看:如果源端日志位置已经前进,目标表水位没有变化,问题更可能在传输或应用;如果目标表水位已变化,但某笔订单状态不对,则需要回到事务内容和目标端约束继续查。
涉及订单主表和支付流水时,还要用关联条件检查是否出现半笔事务:
vbnet
SELECT o.order_id,
       o.order_status,
       p.payment_status,
       o.updated_at AS order_updated_at,
       p.updated_at AS payment_updated_at
FROM biz_order AS o
LEFT JOIN biz_payment AS p
  ON p.order_id = o.order_id
WHERE o.updated_at >= TIMESTAMP '2026-10-01 00:00:00'
  AND (p.order_id IS NULL OR p.updated_at < o.updated_at)
ORDER BY o.updated_at, o.order_id;
如果业务本来允许订单先写入、支付稍后回传,这个结果不一定是同步故障,所以不能只看"左表有、右表没有"。这里需要结合源端事务提交顺序和业务状态流转判断。KFS 按事务单位应用变更的设计,解决的是复制过程中的提交边界;业务本身允许的中间状态仍然要由业务规则确认。
恢复时不要一上来跳过序号
服务重新启动后,先让任务按原有位置继续追。只有明确定位到某个源端事务已经损坏、且业务确认可以放弃时,才讨论跳过。fsrepctl online -skip-seqno 这类命令是处理特殊故障的工具,不是普通的"加速同步"按钮。跳过以后,目标端少的不是一条日志,而可能是一笔包含多张表变更的事务。
恢复过程可以按下面的顺序执行:
- 保存服务状态、解析位置、跟踪文件列表和目标端连接错误;
- 确认源端数据库日志仍在保留期内,跟踪文件没有被清理;
- 修复网络、目标库连接或应用线程后,先恢复同步服务;
- 观察解析位置是否继续前进,再用核心表水位查询确认目标端追上;
- 只有在事务内容已经确定不可应用时,才由负责人审批跳过并记录序号。
目标端存在约束冲突时,也不要把冲突行直接删掉再重启。先确认是重复应用、目标端人工改过数据,还是源端确实存在同键记录,再决定是修复目标数据、调整冲突处理策略,还是回到前一条可用位点重新应用。KFS 的同步冲突处理能力可以按项目规则配置,但规则不能替代数据责任人对这笔业务的判断。
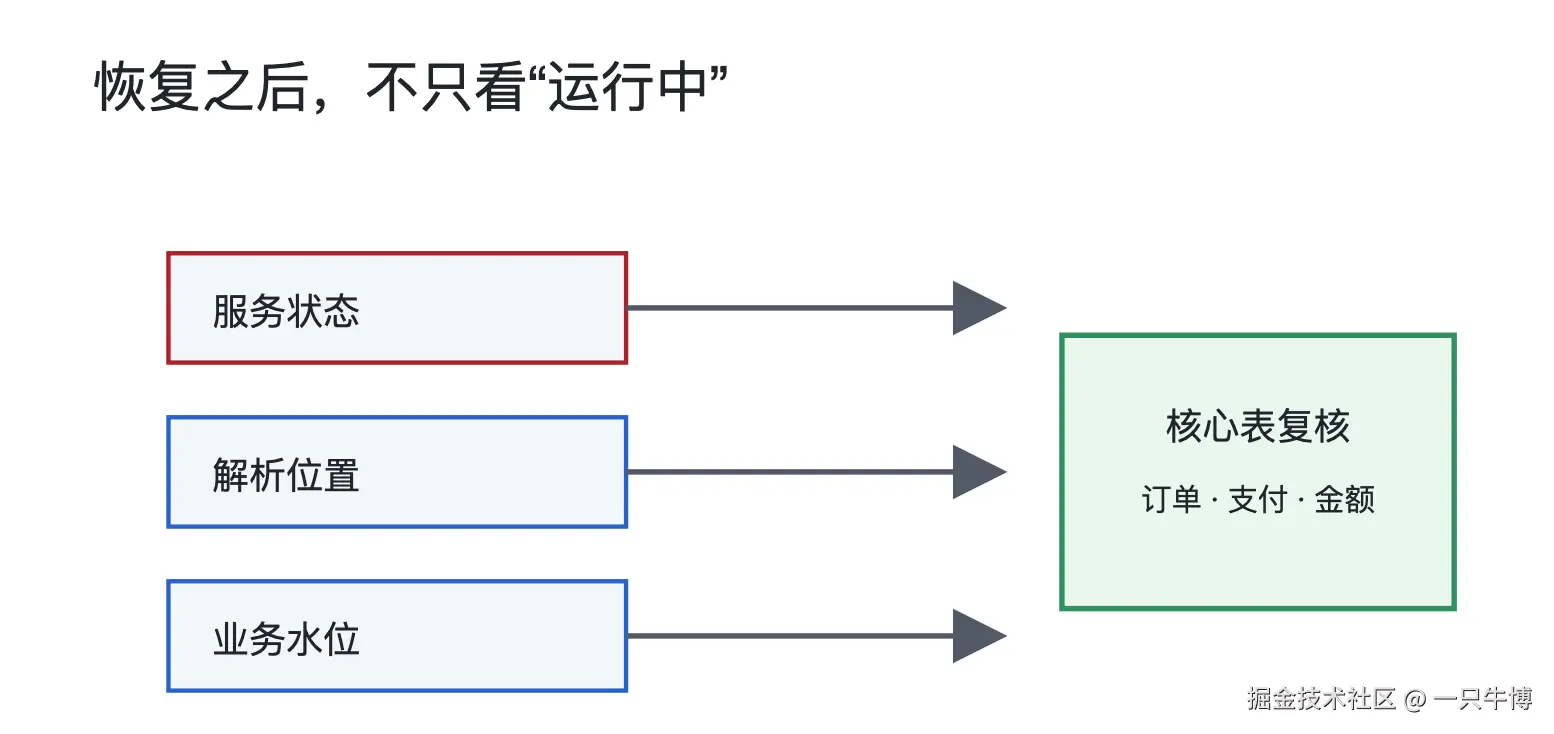
断点接上以后,还要确认"接的是同一条链"
同步状态恢复为正常,只能说明服务重新工作。割接前至少再做三类核对:核心表的业务水位、关键订单的状态链、同步任务的解析位置。订单数量可以用来做快速巡检,金额和状态则要按业务口径复核:
vbnet
SELECT order_status,
       COUNT(*) AS order_count,
       SUM(order_amount) AS amount_sum,
       MAX(updated_at) AS last_updated_at
FROM biz_order
WHERE updated_at >= TIMESTAMP '2026-10-01 00:00:00'
GROUP BY order_status
ORDER BY order_status;
对大表可以先做精简比对,找出有风险的表后再做详细比对。KFS 的数据校验和差异修复是独立能力,适合用来补足同步任务恢复后的检查;但比对结果也要区分"业务仍在写导致的正常差异"和"同步链路漏了一笔变化"。正在写入的订单表,不能因为两次查询的行数不一样就直接判定丢数。
这类同步任务怎样才算可运维
我认为 KFS 的同步任务至少要留下四份能复查的东西:任务配置、源端和目标端连接信息、故障前后的位点记录、每次人工处理的原因。只保留一个"已恢复"的状态,下一次故障还会重新从头猜。
KFS 适合不停机迁移、灾备同步和多节点数据流转,但它并不会替业务决定哪些表必须一致、哪些状态可以延后。断点续传解决的是变更链路如何接回去,数据校验解决的是两端哪里不同,业务 SQL 解决的是这笔订单是否符合真实流程。三件事各自留证,恢复动作才有边界。