先还原一个我刚工作时真踩过的坑。
账户表 t_account 里有一行 id=1, balance=90。我在事务 A 里做了一次查询,这期间同事的事务 B 把余额改成了 70 并且已经 commit。我在同一个事务 A 里又查了一次------结果还是 90。
当时我第一反应是:是不是他没提交成功?还是我事务隔离级别配错了?更诡异的是,我把语句换成 select ... for update 再查,70 又出来了。
同一条记录、同一个时刻,两种查法给出两个答案。这背后就是 InnoDB 并发控制的核心------MVCC(多版本并发控制)。
一句话先给结论:InnoDB 在后台给每行数据偷偷存了一串历史版本,你的普通 select 读到的不是"最新数据",而是"对你这个事务可见的那个版本"。 这篇就把这套机制拆开讲。
读和写,本来是要打架的
先想一个问题:数据库最怕并发读写冲突。事务 A 正在读一行,事务 B 同时要改它,怎么办?
最笨的办法是加锁------A 读的时候锁住这行,B 想改?等着。写阻塞读、读阻塞写,并发一上来整个库都在排队,吞吐直接垮掉。
InnoDB 换了个思路:既然读和写抢的是"同一份数据",那我就多存几份。 写操作去生成新版本,读操作安心读它该读的旧版本,各读各的,谁也不阻塞谁。这就是 MVCC 的核心思想------用空间和历史版本,换无锁的并发读。
它靠三样东西落地:行里的三个隐藏字段、undo log 串起来的版本链、以及决定"你能看到哪一版"的 ReadView。
每行都藏着三个你没建过的字段
你 create table 时只写了业务列,但 InnoDB 会偷偷给每一行再加上几个隐藏列,和 MVCC 相关的是这三个:
DB_TRX_ID(6 字节):最后一次插入或修改这行的事务 ID。删除在 InnoDB 内部也算一次修改,只是打了个删除标记。DB_ROLL_PTR(7 字节) :回滚指针,指向 undo log 里这行的上一个版本。DB_ROW_ID(6 字节):如果表没有显式主键,InnoDB 用它自动生成一个行 ID 当聚簇索引。有主键就没它什么事。
真正撑起 MVCC 的是前两个。
undo log 版本链:一行数据的"前世今生"
每当一行被 update 或 delete,InnoDB 都会在 undo log 里记下修改前的旧值,并让当前行的 DB_ROLL_PTR 指向这个旧版本。旧版本自己也带着指针,再指向更老的版本......这么一路串下去,就形成了一条版本链。
拿这行余额数据来说,它被一连串事务改过,每改一次 InnoDB 就在 undo log 留一个旧版本、再用回滚指针串起来,最后形成这样一条链(具体是哪些事务、按什么顺序改的,下一节对着时间线细讲):
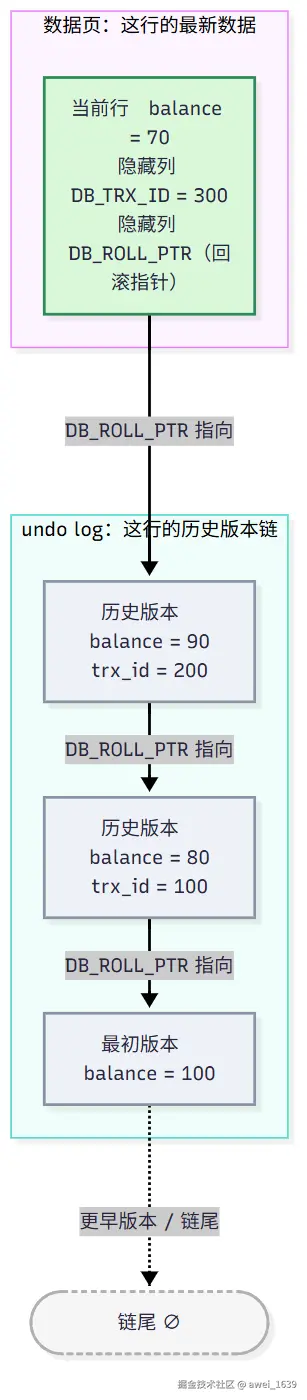 最新的数据在数据页里,历史版本在 undo log 里,每个版本都盖着一个"是谁改的"的戳------也就是它的
trx_id。这条链,就是 MVCC 判断可见性时要一路翻回去的"档案"。
顺带一提,undo log 其实分两种:insert 产生的 undo log 只用于事务回滚,事务一提交就能立刻回收;而 update/delete 产生的 undo log 不能随便删,因为版本链还要靠它,得等所有事务都不需要这些历史版本了,才由后台 purge 线程清理。这个区别后面还会提到。
ReadView:你手里的一张"能见度名单"
光有版本链还不够,得有个东西告诉事务"链上哪些版本你能看、哪些不能看"。这就是 ReadView(一致性视图)。
它在事务执行快照读(也就是普通 select)的那一刻生成,里面有四个关键字段:
creator_trx_id:创建这个 ReadView 的事务自己的 IDm_ids:生成视图那一刻,系统里所有**还活跃(已开启但没提交)**的事务 ID 列表min_trx_id:m_ids里最小的那个 IDmax_trx_id:生成视图时,系统下一个将要分配的事务 ID(当前最大 ID + 1)
拿到一个版本的 trx_id,InnoDB 按下面这套规则判断它对你可不可见:
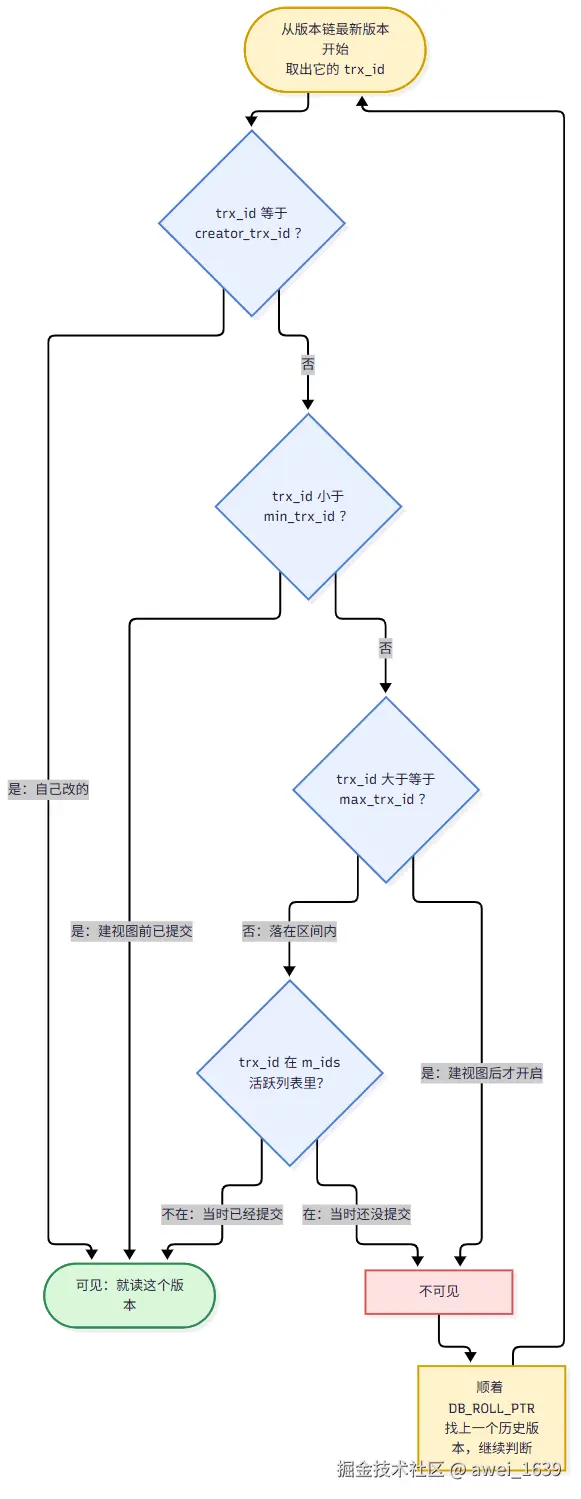 文字版整理一下,一共五种情况:
trx_id == creator_trx_id:这是我自己改的,当然可见;trx_id < min_trx_id:改这行的事务在我建视图之前就提交了,可见;trx_id >= max_trx_id:这是我建视图之后才冒出来的事务,不可见;min_trx_id <= trx_id < max_trx_id:落在区间里,再看它在不在m_ids名单上------在 ,说明建视图时它还没提交,不可见;不在,说明那会儿已经提交了,可见;- 当前版本不可见?那就顺着
DB_ROLL_PTR翻到上一个历史版本,重复上面的判断,直到找到第一个可见版本为止。
拿一个完整例子走一遍
规则干巴巴的,我们把开头那个场景的时间线补全,你就彻底明白了。
- 一开始,
id=1这行balance=100,由早已提交的事务写入; - 事务 100 把它改成 80,提交;事务 200 又改成 90,提交。此时版本链是:
90(trx200) → 80(trx100) → 100(更早),数据页里的当前值是 90; - 事务 300 开启,把余额改成 70,改完但还没提交;
- 这时事务 A 开启并执行第一次普通 select ,生成 ReadView。此刻 100、200 都已提交,唯一还活跃的写事务就是没提交的 300,于是 A 的视图里
m_ids = {300},min_trx_id也是 300。
A 第一次查询,沿版本链判断:
- 当前版本
70,trx_id=300,在m_ids活跃名单里 → 不可见; - 顺着指针翻到
90,trx_id=200,比min_trx_id还小(早就提交了)→ 可见,A 读到 90。
接着事务 300 commit ,余额 70 正式落库。A 在同一个事务里第二次普通 select:
- 注意,RR 级别下 A 复用的还是第一次那张 ReadView,旧名单里 300 依然"被记着没提交";
- 于是当前版本 70 照样不可见,翻到 90 才可见------A 读到的还是 90,哪怕 300 早就提交了。
这就是开头那个现象的答案。那为什么 for update 又能读到 70?因为它根本不走 MVCC,这个下面说。
RC 和 RR 的差别,就差在 ReadView 什么时候建
四种隔离级别里,和 MVCC 关系最大的是 RC(读已提交)和 RR(可重复读),它俩底层用的是完全相同的一套版本链和判断规则,唯一的区别是 ReadView 的生成时机:
- RC(读已提交) :每次 select 都重新生成一张 ReadView。所以上面例子里,事务 300 一提交,A 第二次 select 用的是新视图,名单里没有 300 了,立刻就能读到 70;
- RR(可重复读,MySQL 默认) :只在事务里第一次快照读时生成一张 ReadView,之后整条事务期间一直复用它,所以你反复查都是同一个结果。
一句话:RC 每次查都"刷新一下世界",RR 给你定格在第一次查询的那个瞬间。
快照读 vs 当前读:为什么 for update 能读到新值
这是另一个特别容易混的点。InnoDB 的读分两种:
- 快照读 :普通
select,走 MVCC,读的是 ReadView 决定的历史版本,不加锁; - 当前读 :
select ... for update、select ... lock in share mode、以及insert / update / delete,读的是最新版本,并且要加锁。
所以 A 用 for update 查时,它绕过了那张定格的 ReadView,直接读最新已提交数据,70 自然就出来了。MVCC"读不阻塞写"的红利,只对快照读成立。
四个不那么显而易见的点
讲到这儿,面试基本能答了。但下面这几个坑,是真写过、真查过问题才会注意到的:
1. RR 下,你自己 update 之后再 select,能立刻看到自己的新值。
很多人以为可重复读就是"一条道读到黑,全是旧值"。不是。可见性规则第一条就是"trx_id == creator_trx_id 时可见"------新版本是你自己这个事务改的,盖的是你自己的戳,无论 ReadView 多旧都对你可见。所以"可重复读"锁得住别人,锁不住你自己。
2. ReadView 不是 begin 那一刻建的,而是第一条快照读才建。
你 begin; 之后什么都不查,视图并不会建立。普通事务里,它在你执行第一条普通 select 时才生成;如果你想在事务一开始就把快照定格住,得显式用 start transaction with consistent snapshot。这也是为什么有时候你以为自己"早就在事务里了",结果一查还是能看到别人刚提交的数据。
3. 事务 ID 也不是 begin 就分配的,纯只读事务压根不分配。
InnoDB 对确定只读的事务做了优化,不给它分配事务 ID,省掉一套开销;只有当事务第一次做增删改、或发起 for update 这类锁定读时,才去申请一个全局严格递增的 trx_id。所以别想当然地认为"谁先 begin 谁的 trx_id 就小"------一个开了半天但只做查询的事务,可能根本没有 ID。
4. RR 并没有靠 MVCC "完全"消灭幻读。
幻读指的是同一个事务里两次查同一范围,中途别人插进一条新行,第二次莫名多出一条。快照读下,新插入行的 trx_id 对你那张旧 ReadView 不可见,所以 MVCC 确实让你"看不见幻影";但当前读 要读最新数据,这时候靠的是 next-key lock(记录锁 + 间隙锁) ,把记录和记录之间的缝隙一并锁住,让别的事务压根插不进来。所以准确说法是:RR 下 InnoDB 靠 MVCC 管快照读、靠 next-key lock 管当前读,两手一起才基本消除了幻读。
代价:一个长事务,能把 undo log 撑爆
MVCC 不是免费的。历史版本必须一直保留,直到系统里最老的那张 ReadView 都不再需要它,purge 线程才敢清理。
这就带来一个经典生产事故:某个事务开着忘了提交(常见于长事务、或连接池里泄漏的空闲连接),它手里的 ReadView 一直不释放,导致它之后产生的所有 undo log 历史版本都没法 purge。版本链越堆越长,回滚表空间(ibdata 或独立 undo 表空间)持续膨胀,磁盘告警,查询翻版本链也越来越慢。
平时可以用这条 SQL 揪出存活超过 60 秒的长事务:
sql
SELECT trx_id, trx_state, trx_started,
       TIMESTAMPDIFF(SECOND, trx_started, NOW()) AS duration_sec
FROM information_schema.innodb_trx
WHERE TIMESTAMPDIFF(SECOND, trx_started, NOW()) > 60;
再配合观察 Innodb_history_list_length 这个指标:如果它只涨不跌、持续走高,基本就是 purge 跟不上、版本链在堆积的信号,多半背后藏着一个没提交的长事务。写代码时记得事务尽量短、别在事务里塞 RPC 和人工等待,能帮你避开这个坑。
写在最后
回头串一下 MVCC 这台机器是怎么转的:
- 隐藏字段记录每行最后是谁改的、上一版在哪;
- undo log 版本链保存一行的所有历史版本;
- ReadView 拿着一张活跃事务名单,决定当前事务能看到链上的哪一版;
- RC 每次 select 重建视图、RR 只建一次复用,这就是两种隔离级别的全部底层差异;
- 快照读靠 MVCC 不加锁,当前读读最新并加锁,RR 再用 next-key lock 补上幻读。
理解了这套"多版本 + 可见性规则",你就明白 InnoDB 凭什么能在高并发下做到读写互不阻塞,也能解释那些"明明提交了我却查不到"的诡异现象了。
你在线上有没有被长事务撑大 undo 表空间、或者被 RR 的可见性坑过?当时是怎么发现和处理的?评论区聊聊。