最近,一位国外的独立开发者secemp将约 315 万篇 arXiv 论文整理成一份约 16TB 的公开可下载数据集,引发外网热议,很多人拍手叫好。
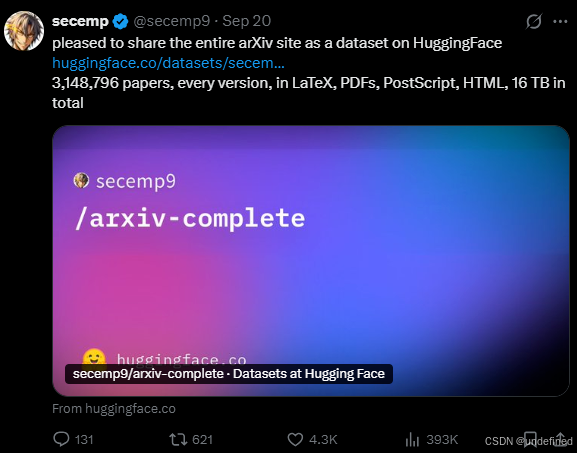
看到这个消息,我们一方面很欣喜:公开的论文数据集受到欢迎,反映出大家对获取科研文献的需求。但另一方面,我们也深知:数据可以下载了,离好用却还差得远------庞大的数据包交到大家手里,后面大量的工程还得自己做。
我们做过大规模数据处理,知道从下载、文本处理、内容切分,到构建索引、搭建检索服务的不容易,每一步都耗时耗力。真心觉得,都已经进入 Agent 时代了,这些工作没必要每个人再做一遍。
分享一下我们团队重点打造的**Sciverse 科学数据基座,这些准备工作,它已经做好了。**
Sciverse 是一个什么样的产品?你可以把它理解为一个我们 专为 Agent 打造的文献知识库:汇集海量论文、图书和专利信息,为 AI 提供直接使用的高质量全文内容;你能通过 API / Skills 接入Codex、Cursor、Claude Code、WorkBuddy 等 AI 助手,让 Agent 帮你查文献、读全文、找到对应的原文出处,为学术研究、文献综述和技术方案调研提供依据;全部资源免费供学术研究使用,并以 T+1 机制持续更新,减少你自己搜集、整理和维护文献数据的投入。目前该能力已全面接入书生·端砚科学发现平台。

📚 Sciverse官网:Sciverse|科研 Agent 的可信科学证据数据层
·运行以下命令安装 Skills,再到 Sciverse 官网创建 API Token 并完成配置,即可开始使用:
npx skills add https://sciverse.space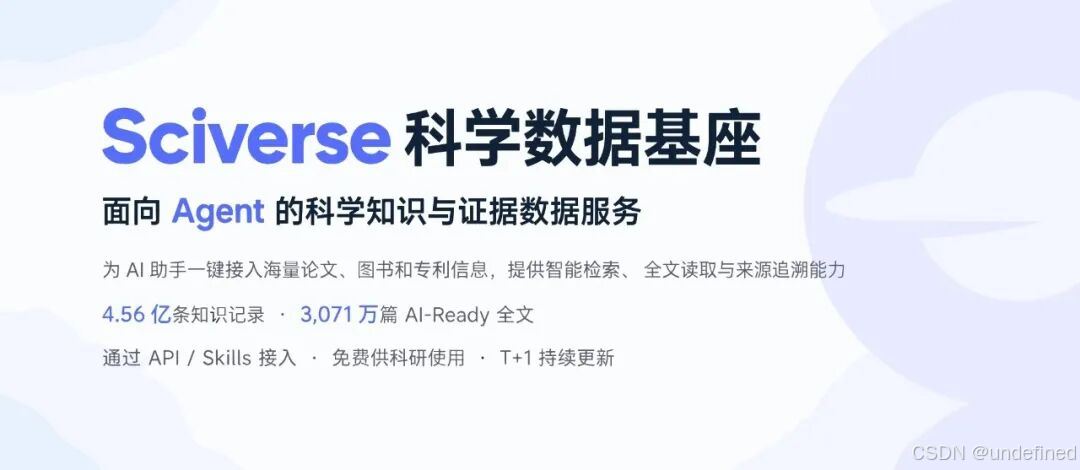
01 跨越六个世纪的海量科学知识资源
Sciverse收录 4.56 亿条知识记录,提供 3,071 万篇 AI-Ready 全文、8,233 万条图书记录和 7,000 万条专利记录。
● 汇聚 arXiv 在内的 20 余个知名学术数据库,学术文献覆盖 1400年---2026 年,跨越六个世纪。
● 涵盖数学与计算科学、物理、化学、生命科学、地球与大气科学、天文学、医学与健康、材料、能源、工程制造等 10 大核心科学领域。
● 覆盖 814 种语言、236 万期刊与会议来源的跨语种、跨学科的研究成果。
02 文献全文结构化,T+1 持续更新
Sciverse 采用团队研发的 MinerU 智能文档解析工具,对全文进行结构化处理:将正文提取为文本,公式转换为 LaTeX,保留表格的结构化内容,为图片关联图注与资源路径,同时保留内容块的页码和版面坐标。
在解析的基础上,Sciverse 建立了完整的数据处理流程:从多源采集、标准化处理,到知识与证据组织、索引管理,支持全文与向量检索,并统一管理来源、版权和版本信息。
数据也在持续更新。Sciverse 采用 T+1 同步机制,每日新增百万级文献与专利记录入库,不断跟进前沿研究。
接入 Sciverse,你无需再批量下载和存储论文、部署解析工具、自建检索索引,也不用持续维护数据更新管线。省下存储、算力和工程投入,把资源和精力留给研究。
03 Agent 原生,直达研究证据
Sciverse 提供 七类 API,覆盖字段发现、元信息检索、语义检索、全文读取、图表资源获取、论文关系查询及 Paper Schema 结构化研究。
文献层:按范围查找文献。 Sciverse 支持按年份、作者、期刊、学科等条件筛选,并在指定文献集合内检索相关内容;还可以通过参考文献、被引论文和相关研究,继续查找关联文献。
**证据层:找到有出处的片段。**语义检索返回相关原文、文档标识和来源位置,需要补充上下文时,再通过全文接口继续读取。这样,Agent 获取的研究材料就有了可核验的依据。
**研究结构层:梳理问题、方法与结果。**Paper Schema 进一步抽取研究问题、方法组件、数据集、评价指标及发现,组织他们之间的关系,并关联原文证据。目前该能力处于 Beta 阶段,已覆盖百万级 AI 会议论文,现阶段仅开放其中已完成结构化抽取的内容。
04 免费开放,接入你的 AI 科研助手
Sciverse 汇聚海量科学文献,提供基于开放获取(OA)资源的高质量全文内容,免费供科研使用。 通过 API、Skills、MCP 和 Python / TypeScript SDK ,你可以把这些资源接入 Codex、Cursor、Claude Code、WorkBuddy 等 AI 助手,用到具体的深度研究任务中。
比如,面对一个新课题,可以让 Agent 通过 Sciverse 查找和研读文献,梳理已有发现与待解问题,辅助生成研究假设;准备实验时,可以比较前人的实验条件和评价指标,为实验设计提供参考;分析数据时,可以查找相关方法,对照已有研究理解结果,辅助数据分析。这些查文献、读全文、找依据的步骤,也可以串联成科研自动化工作流,减少重复搜集和整理资料的投入。快来试试吧!
📚 Sciverse官网:Sciverse|科研 Agent 的可信科学证据数据层
运行以下命令安装 Skills,再到 Sciverse 官网创建 API Token 并完成配置,即可开始使用:
npx skills add https://sciverse.space