写在前面
我们不打算教你"怎么跑起一个 vLLM"------这类教程已经够多了。
我们想回答一个更前置、也更贵的问题:当你决定上线一个模型时,你实际上在为哪些东西付费?
文中所有数字来自我们在三台 GPU 宿主机 + 一个网关上的实测记录,非公开基准。四个模型全部跑在生产环境,且与其他租户共享硬件资源。
一、先看事实:四条路径并排放在一起
去年下半年,我们的模型平台前后自持部署了四个模型。在配置文件里,它们看起来很像------同一个 YAML 列表,同样的 model / url / api_key 三个字段。
但把它们真实的基础设施摊开,是这样的:
| 维度 | GLM-5.3-Flash | Qwen3.8-Flash-Next | Qwen3.8-27B | DeepSeek-V4.1-Flash |
|---|---|---|---|---|
| 宿主 | 8×H100 80G | 8×L20 46G | A100 ×1 | 8×H100 80G(与 GLM 同机) |
| 权重体积 | 306 G | 173 G | 99 G | 476 G / 48 shards |
| 架构 | 混合注意力 · 62 层 | MoE 512 专家 · 48 层 | 27B 稠密 | MoE 384 专家 · 40 层 |
| 注意力 | linear/sparse 混合 | GQA 24Q:2KV | --- | MLA(KV head=1) |
| 原生上下文 | --- | 262,144 | --- | 1,048,576 |
| 部署上下文 | 1,048,576 | 1,179,648(外推 ×4.5) | 262,144 | 1,048,576(原生) |
| 量化 | --- | FP8 | --- | FP8 + 专家 FP4 |
| TP / EP | 8 / --- | 8 / EP | 1 / --- | 8 / --- |
| --gpu-memory-utilization | 0.75 | 0.95 | 0.90 | 0.85 |
| --max-num-batched-tokens | 4,096 | 8,192 | --- | 4,096 |
| sleep-mode | ✅ | ✅ | ❌ | ✅ |
| 引擎就绪耗时 | ~700 s | ~300 s | --- | ~482 s |
| 实测 KV 池 | 1,319,627 tok | 1,950,229 tok | 282,900 tok | 3,778,259 tok |
| 满长并发能力 | 1.26x @1M | 1.65x @1.18M | --- | 3.60x @1M |
看到这张表,第一个值得记住的结论是:
配置里的一行
model:,和它背后真实的基础设施,信息量完全不对等。
四个模型共用同一个配置 schema,但它们的硬件占用、并行策略、量化方案、生命周期管理方式几乎没有重叠。这意味着你无法用"加了一行配置"来估算一个新模型的上线成本。
二、四个决策轴
把上面那张表往下抽象一层,我认为所有"要不要自持一个模型"的决策,都可以拆到四个正交的轴上。它们彼此独立,可以分别评估。
轴一:所有权 ------ CapEx vs OpEx,以及看不见的那部分成本
这一刀最粗,也是唯一一个二进制的选择。
我们自己在四个模型上走过完整的自持路径,同时也在用外部 API(火山方舟的 doubao/deepseek 系列)。对比下来,自持的真实成本结构是:
自持成本 = GPU 折旧 + 权重存储 + 让 GPU 一直能被用上的工程投入
                                  ↑
                          这一项被严重低估
举个具体的例子。GLM-5.3-Flash 跑在 8 卡 H100 上,TP=8 意味着它必须同时拿到整整 8 张卡。这台机器有 39 个人在用。于是我们经历过:
- 别人的 8 卡训练作业启动 ⇒ 显存不够 ⇒ vLLM worker 初始化失败 ⇒ 容器崩溃循环(RestartCount 累计 71 次)
- 同机一个每 5 秒按进程名
kill -9 VLLM::Worker*的常驻脚本 ⇒ 崩溃循环 64 小时,2429 个失败周期,16602 次 SIGKILL - 一次
exitCode=137(SIGKILL)的容器死亡,外加 13 次"起来就被杀",持续 7 分钟
每一次,上层看到的都是同一个东西:502。
这里有一条值得单独拎出来的判据:
崩溃循环 ≠ vLLM 缺陷。 在共享 GPU 上,先查是不是有人/有作业在抢卡。判别的关键指标只有一个:GPU 是否为空。
空的 ⇒ 是被杀;不空的 ⇒ 是被占。
而外部 API 那一路的成本是:token 单价 × 用量。运维成本 ≈ 0,可观测性止步于"对方返回了什么"。它的代价不是钱,是控制权的丧失。
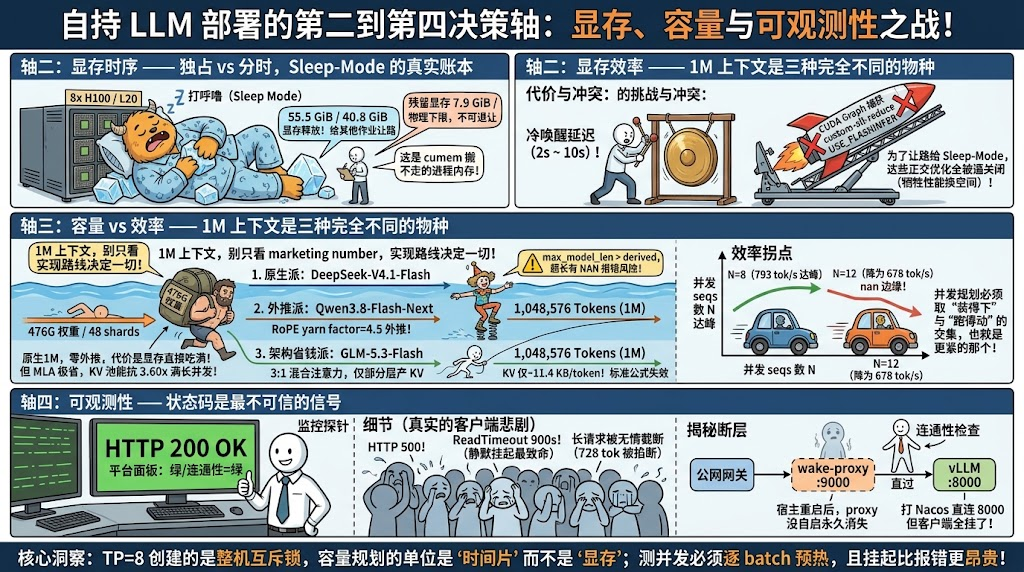
轴二:显存时序 ------ 独占 vs 分时,sleep-mode 的真实账本
四个自持模型里有三个开了 --enable-sleep-mode。这不是巧合------在共享机器上,这是让 GPU 变成可复用资产的前提。
实测的三组对照(同一模型,睡眠态 vs 清醒态,同分钟采样):
| 模型 | 清醒 | 睡眠 | 释放 | 残留 |
|---|---|---|---|---|
| GLM-5.3-Flash(H100) | 62,306 MiB/卡 | 8,096 MiB/卡 | 52.55 GiB | 7.9 GiB |
| Qwen3.8-Flash-Next(L20) | 43,272 MiB/卡 | ~1.4 GiB/卡 | 40.81 GiB | 1.35 GiB |
| DeepSeek-V4.1-Flash(H100) | --- | --- | 55.51 GiB | 21.78 GiB |
残留数字的差异很说明问题:同样是 cumem sleep,GLM 留 7.9 GiB、Qwen 只留 1.35 GiB、DeepSeek 留 21.78 GiB。原因在于 cumem allocator 只能搬移 torch 托管的内存段------这部分是"让出显存"的物理下限,不是泄漏,也不是配置问题。
DeepSeek 的日志原文很值得看:
bash
CuMemAllocator: sleep freed 55.58 GiB memory in total, of which 48.43 GiB
is backed up in CPU and the rest 7.15 GiB is discarded directly.
Sleep mode freed 55.51 GiB memory, 21.78 GiB memory is still in use.
注意这两个 55 不是一回事:前者是 allocator 视角(搬走的量),后者是进程视角(显存下降的量)。差出来的就是"搬走了但进程还占着"的部分。
而 sleep-mode 的代价,很多人只算了唤醒延迟:
| 代价项 | 实测 |
|---|---|
| 冷唤醒 | GLM POST /wake_up 2.16 s;Qwen 2~10 s(1.96 s / 9.23 s 两次) |
| 已醒时重复调用 | 6~7 ms,幂等,恒 200 |
| 宿主 RAM 占用(Qwen) | 17.04 GiB × 8 ≈ 136 GiB |
| 入睡耗时(DeepSeek) | 44.7 s |
| 完整重载 | GLM ~700 s / DeepSeek ~482 s / Qwen ~300 s |
第二行是整套设计里最实用的性质:预热调用可以无条件前置,不需要先探活。
但 sleep-mode 有一个隐性代价:它会逼你关掉一批正交优化。DeepSeek 的环境变量里有:
bash
--disable-custom-all-reduce
VLLM_ALLREDUCE_USE_SYMM_MEM=0
USE_FLASHINFER=0
USE_BREAKABLE_CUDAGRAPH=0
这四项全是"依赖显存布局不变"的优化,都要为 sleep 让路。
轴三:容量 vs 效率 ------ "1M 上下文"是三种完全不同的东西
四个模型里有三个冲到了 1M 级上下文。但这个数字几乎不携带关于真实容量的信息------因为实现路线完全不同:
| 路线 | 模型 | 做法 | 工程含义 |
|---|---|---|---|
| 原生 | DeepSeek-V4.1-Flash | 权重里 max_position_embeddings: 1048576(yarn factor=16 已烧进 config) |
部署值=原生值,零外推;代价是 476G 权重吃掉显存大头 |
| 外推 | Qwen3.8-Flash-Next | 原生 262K,靠 --hf-overrides RoPE yarn factor=4.5 撑到 1.18M |
vLLM 启动会 WARNING "max_model_len > derived",超长有 nan 风险 |
| 架构省钱 | GLM-5.3-Flash | 62 层按 ~3:1 交替 linear_attention / deepseek_sparse_attention |
大部分层根本不产 KV,KV 仅 ~11.4 KB/token;标准 KV 公式失效 |
第一条可带走的判据:
评估任何长上下文模型时,第一个问题应该是:这个 1M 是原生的、外推的、还是靠架构省出来的?
三者的容量规划方式、失效模式、显存账本完全不同。只看 marketing number 会全盘算错。
真正的约束是 KV 池 ,而且它和 --max-model-len 基本无关(KV cache 只由 --gpu-memory-utilization 决定,vLLM V1 按请求实际 token 增量分配 block,不按 max_model_len 预留)。
以 GLM 为例:
- KV 池 = 1,319,627 tokens
- vLLM 自报:Maximum concurrency for 1,048,576 tokens per request: 1.26x
翻译过来:1M 上下文下,这组卡只装得下 1.26 个满长度请求。
而 DeepSeek 因为 MLA(KV head=1)压缩得狠,同样 1M 请求能到 3.60x ------这是 MLA 相对 GQA 在长上下文场景下最直观的收益,值 2.9 倍。
于是 --max-num-seqs 该定多少?我们的实测给出两个不同性质的上界:
- 容量上界(塞得下吗):1,319,627 ÷ 101,000(单请求实测上界)≈ 13,留余量取 12
- 效率上界 (划算吗):热态吞吐曲线测出来是 8 达峰,12 反而回落 15%
| 并发 N | 墙钟 | 生成量 | 聚合吞吐 | 加速效率 | GPU 利用率 |
|---|---|---|---|---|---|
| 1 | 1,660 ms | 256 | 154 tok/s | 100% | --- |
| 4 | 2,177 ms | 1,024 | 470 tok/s | 76% | 100% |
| 8 | 2,584 ms | 2,048 | 793 tok/s | 64% | 100% |
| 12 | 4,532 ms | 3,072 | 678 tok/s | 37% | 92--94%(反降) |
取更紧的那个 ⇒ 8。
并发参数从来不只有一个上界。 它有"装得下"的容量上界和"跑得动"的效率上界,二者取更紧的。只回答前者,会把系统推过效率拐点而不自知。
顺带两个测并发时必踩的坑(我们在同一个 N=8 上踩了):
- 必须逐 batch size 预热 :vLLM 首次遇到新 batch size 会做 CUDA graph 捕获,表现为一次性 10--20 s 且 GPU util 全程 0%。同一 N=8:首测 17,916 ms,复测 2,706 ms,差 6.6 倍。不预热会把冷启动伪影读成"并发退化"。
- 均值是被短请求拉低的假象:1110 次真实请求分布为 0--200: 381 / 200--1K: 443 / 1K--50K: 1 / 50K--100K: 284 / >100K: 1。均值 21K 不对应任何一类真实请求。规划并发必须用上界,不是均值。
轴四:可观测性 ------ 状态码是最不可信的信号
这是四个轴里最"软"、但事后看最贵的一个。
在我们这套系统上,"HTTP 200"出现过以下几种含义:
- 真的成功了
- 模型正被休眠打断:
content=null、finish_reason="abort"、耗时恰为检查周期 31 s - 上游挂了,但网关返回了 200
以及几种不报错的失败:
- vLLM 睡眠时
POST /v1/chat/completions不返回错误,而是挂起直到 ReadTimeout(900 s) - 休眠会掐断在飞的长请求(实测
max_tokens=1500在 728 token 处被截断,已生成 1107 字但未写完)
静默挂起是最坏的失败模式。 一个会 hang 到 900 s 超时的接口,比一个立刻返回 503 的接口贵得多------它把"快速失败 + 上层重试"降级成"占着连接等死"。设计上要主动把 hang 转成 error。
还有一次很典型的事故:平台面板显示"模型连通性=绿",但客户端全线 500。原因是两条链根本不是同一条------
- 客户端:公网网关 → L20 wake-proxy :9000 → vLLM
- 平台连通性检查:打 Nacos 里配的 url,直连 vLLM :8000,根本不经过 :9000
而 :9000 那个 proxy 是 nohup 孤儿进程、没有 systemd unit、没有 cron @reboot。宿主一重启,vLLM 容器靠 --restart unless-stopped 自己回来了,proxy 却永久消失。vLLM 活着这件事反而让故障更难定位。
"平台显示绿" 只证明它检查的那条链是通的。 判客户端故障时必须打真实的客户端链路,别拿别的探针当证据。
最后一条,也是最容易被忽略的:诊断端点必须对被测对象失效免疫 。我们自己的 /status 曾经因为内联调用健康探测,在后端挂掉时返回 500------观测手段反而先被击穿。正确做法是恒返回 200,错误信息放字段里。
三、一条贯穿性的洞察:TP=8 创建的是整机互斥锁
这是把四个模型放在一起之后才看得出来的东西。
GLM-5.3-Flash 和 DeepSeek-V4.1-Flash 在同一台 8×H100 上,都是 TP=8。算一下:
- GLM 清醒:62,306 MiB/卡(util 0.75)
- DeepSeek:util 0.85 ⇒ 约 68 GiB/卡
- 单卡总容量:81,559 MiB
两者绝对不可能同时清醒。 这不是"资源紧张",是结构性互斥。
我们在 10-08 抓到的容器生命周期恰好印证了这一点:
06:32:58  容器创建
06:33:14  APIServer 启动,打印参数
06:41:01  init engine 完成(136.24 s)
06:41:04  开始监听 :8000
06:44:01  收到 POST /sleep?level=1 → 200     ← 启动约 11 分钟后被睡
06:44:01  It took 44.71 seconds to fall asleep
06:47:50  shutdown triggered
06:49:06  容器退出(ExitCode=0,OOMKilled=false)
总存活 16 分钟。 而当前这台机器的 GPU 状态是:8 张卡全被一个训练作业占着(73--76.5 GiB/卡),GLM 容器 Exited (137),DeepSeek 容器 Exited (0)。
⇒ 这台机器上实际存在三个整机级互斥租户:GLM(TP8) / DeepSeek(TP8) / 别人的训练(8 卡)。
这条洞察的通用形式:
在一台 8 卡机器上部署 TP=8 的模型时,你创建的不只是"一个服务",而是"一个整机级的互斥锁"。 每多一个这样的模型,就多一个需要分时调度的租户。
容量规划的单位因此从"GPU 显存"变成了"整机时间片"------而每次切换的成本是 5~12 分钟的冷启动。
这也解释了为什么 sleep-mode 在这套系统里不是"优化项"而是"必需品":它把"释放整机"的成本从 8 分钟重载降到 45 秒入睡 + 2~10 秒唤醒。
四、量化策略的分层:MoE 时代的新变量
对比两个 MoE 模型的量化配置,能看到一个清晰的方向:
| 模型 | 权重量化 | 专家量化 |
|---|---|---|
| Qwen3.8-Flash-Next | FP8(全局) | FP8(同权重) |
| DeepSeek-V4.1-Flash | FP8 | expert_dtype: "fp4" |
MoE 模型里专家占参数量的绝对大头------DeepSeek-V4.1-Flash 是 384 个路由专家 + 1 个共享专家,top-6 激活,每层 moe_intermediate_size=2304。
⇒ 既然绝大部分参数是被稀疏激活的专家,那么对专家单独下探精度就是一个自然的优化方向。 476G 的权重能塞进 8×80G,这套分层量化是关键因素之一。
(说明:以上是直接从权重 config.json 读取的事实;FP4 专家对输出质量的具体影响我们未做系统评测,引用时建议标注。)
五、选型决策框架
把四个轴合起来,得到一个可以直接用的判断流程:
                    这个模型要不要自己持有?
                           │
        ┌──────────────────┴──────────────────┐
        │                                      │
    采购 (API)                            自持 (Server)
        │                                      │
   ┌────┴────┐                        ┌───────┴────────┐
   │评估单价  │                        │ 显存:独占?分时?│
   │/合规/数据│                        └───────┬────────┘
   │出境/SLA │                       ┌────────┴────────┐
   └─────────┘                    独占              分时
                                    │                 │
                               TP 打满整机       sleep-mode
                               (互斥锁!)       + wake-proxy
                                    │                 │
                                    └────────┬────────┘
                                             │
                                 并发:先算容量上界,
                                 再测效率拐点,取更紧的
                                             │
                                             ▼
                                 可观测性:状态码不可信,
                                 挂起比报错更坏
四条路径在这张图上的位置与各自的"人格":
| 路径 | 位置 | 它是什么 | 什么时候选 |
|---|---|---|---|
| Qwen-27B / A100 | 自持 · 独占 · 单卡 | 最轻、最省心、能力最弱。一个人就能管 | 内部工具、预算敏感、不需要长上下文 |
| Qwen-Flash-Next / L20 | 自持 · 分时 · TP8+EP | 显存效率冠军(util 0.95,512 专家切到每卡 64) | 要在 46G 卡上跑大模型、能接受 2~10 s 冷唤醒 |
| DeepSeek-V4.1 / H100 | 自持 · 分时 · TP8 · 原生 1M | 长上下文容量最强(KV 池 3.78M,3.60x) | 原生超长上下文刚需 |
| GLM / H100 | 自持 · 分时 · TP8 · 混合架构 | KV 最省(11.4 KB/token),但冷启动最慢 | 长上下文 + 混合架构收益,且启动窗口充裕 |
六、六条可以带走的原则
如果这篇只记六句话:
- 复杂度不由模型数量决定,由所有权决定。 清单里加 10 个
source: api的模型,Infra 成本是 0;加 1 个自持模型,成本是整机级的。按所有权分类管理,不要按数量。 - TP=8 创建的是整机互斥锁,不是"一个服务"。 容量规划的单位从"GPU 显存"变成"整机时间片",而每次切换成本是 5~12 分钟冷启动。
- "支持 1M"要拆开看。 原生 / 外推 / 架构省 KV 三条路线,容量账本和失效模式完全不同。这是选型时第一个该问的问题。
- 判活必须取自消费方,不是代理方。 任何"空闲回收 / 自动休眠"机制,活跃度判据要读被调用者自身的单调计数器(如 vLLM 的
*_tokens_total),而不是"经过我的请求数"。后者会把"流量走了别的路"误读成"没人用"。 - 静默挂起是最坏的失败模式。 会 hang 到 900 s 超时的接口,比立刻返回 503 的接口贵得多。设计上要主动把 hang 转成 error。
- 并发有两个上界,取更紧的。 容量上界回答"装得下吗",效率上界回答"划算吗"。测后者必须逐 batch size 预热,且用请求长度上界而非均值。
七、关于"共享 GPU"这一条补充
四个模型全部跑在别人也在用的机器上。这段经历给了我们一个与技术无关的教训:
我们遇到过按进程名 kill -9 的常驻脚本、遇到过占满 8 卡的训练作业、遇到过来源不明的 SIGKILL。我们尝试过绕行方案(把 worker 进程改名让它匹配不上),实测有效------但它的天花板很清楚:进程名后缀是硬编码的,对方加一条规则就破;而且它完全挡不住 docker stop。
结论是:技术对抗在权限对称的共享环境里赢不了,它只能争取时间。真正的解法是分时约定。
这听起来像一句废话,但它的价值在于:当你下次看到"vLLM 又崩了"的时候,你会知道先去查是不是有人在抢卡,而不是先去翻 vLLM 的 issue 列表。我们在崩溃循环 64 小时之后才想到这一步。
结语
这篇文章的核心不是"教你怎么部署 vLLM",而是试图回答:当你决定自持一个模型时,你实际上在为哪些东西付费?
答案是:GPU 折旧只是冰山一角。真正的成本在于让这些 GPU 一直能被用上的工程投入------分时调度、崩溃循环的诊断、观测链路的完整性、并发参数的反复测试、以及与其他租户的资源协调。
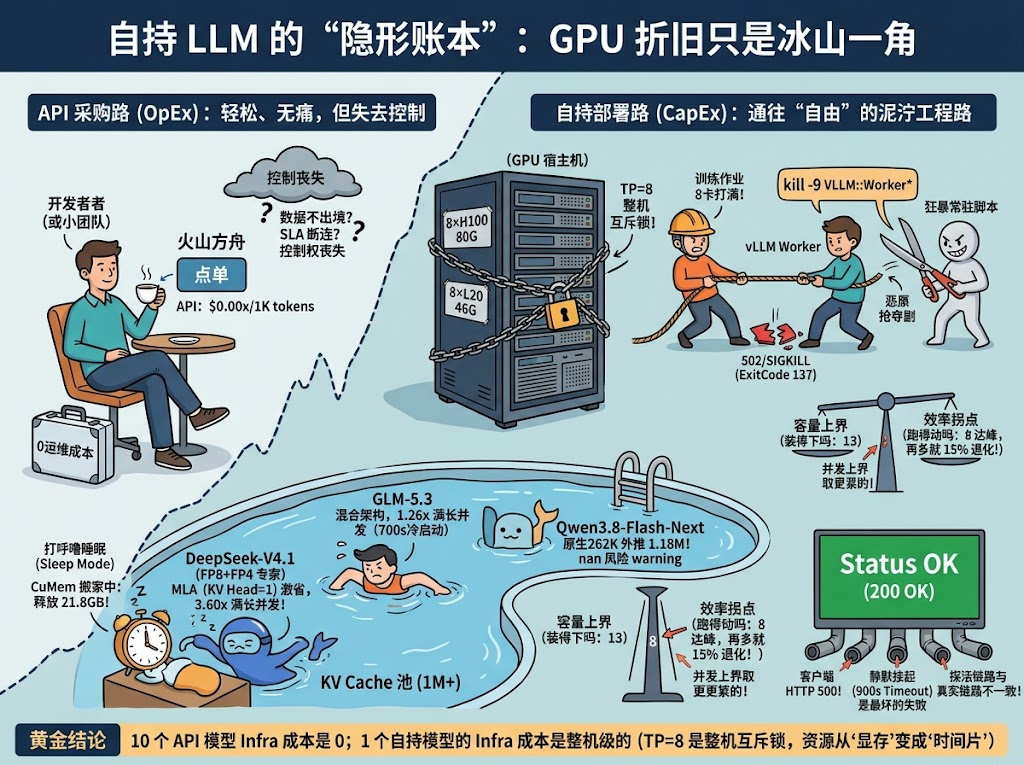
如果你正在评估是自持还是买 API,这张图可能有用:
复杂度来自所有权,不是数量。
10 个 API 模型的 Infra 成本是 0;1 个自持模型的 Infra 成本是整机级的。
而如果你已经决定自持,那么记住:
TP=8 创建的是整机互斥锁。
容量规划的单位不再是"显存",而是"时间片"。
文中涉及的主机地址、路径与凭证均已脱敏或直接省略。数据来自生产环境运维记录,具体数值受当时负载影响,引用时建议注明采样条件。