JavaEE多线程初阶(下篇)------多线程案例(单例模式,阻塞队列,线程池,定时器)
摘要 :欢迎读者阅读JavaEE多线程的初阶的内容,文章将分上中下篇.本文是 JavaEE 多线程初阶系列的下篇.文章围绕多线程的经典案例展开,依次讲解单例模式 (饿汉/懒汉及多线程安全改进)、阻塞队列 (生产者消费者模型、标准库用法与模拟实现)、线程池 (概念、内核态与用户态、标准库创建方式与模拟实现)以及定时器(标准库用法、时间戳概念与模拟实现.建议先掌握中篇的线程基础,再阅读本文效果更佳哦!
JavaEE多线程初阶(中篇)------线程安全,synchronized 关键字,死锁,volatile 关键字,wait 和 notify
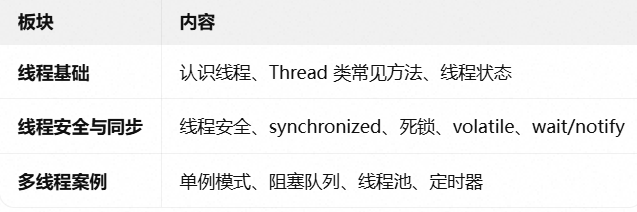
上中下篇按照下图三个板块进行:
目录
9.多案例模式
9.1 单例模式
9.2 阻塞队列
9.3 线程池
9.4 定时器
正文
9.多线程案例
9.1 单例模式
单例模式是设计模型中一种非常经典的模型,也是比较简单的模型,还是校招中最常考的设计模式 之一.单例模型要求,某个类 在某个程序 中只有唯一一个实例 .(不允许创建多个实例,即不允许new多次).这一点在很多场景上都需要.比如JDBC中的DataSource实例就只有一个.
- 什么是设计模式?
- 简单来说,设计模式就是前人踩坑后总结出的最佳实践 。当你在开发中遇到某个反复出现的问题时,不必从零开始摸索,直接套用对应的设计模式即可快速得到可靠的解决方案.
单例模式具体的实现方式有很多种.最常见的是**"饿汉"和"懒汉"**两种.
- 简单来说,设计模式就是前人踩坑后总结出的最佳实践 。当你在开发中遇到某个反复出现的问题时,不必从零开始摸索,直接套用对应的设计模式即可快速得到可靠的解决方案.
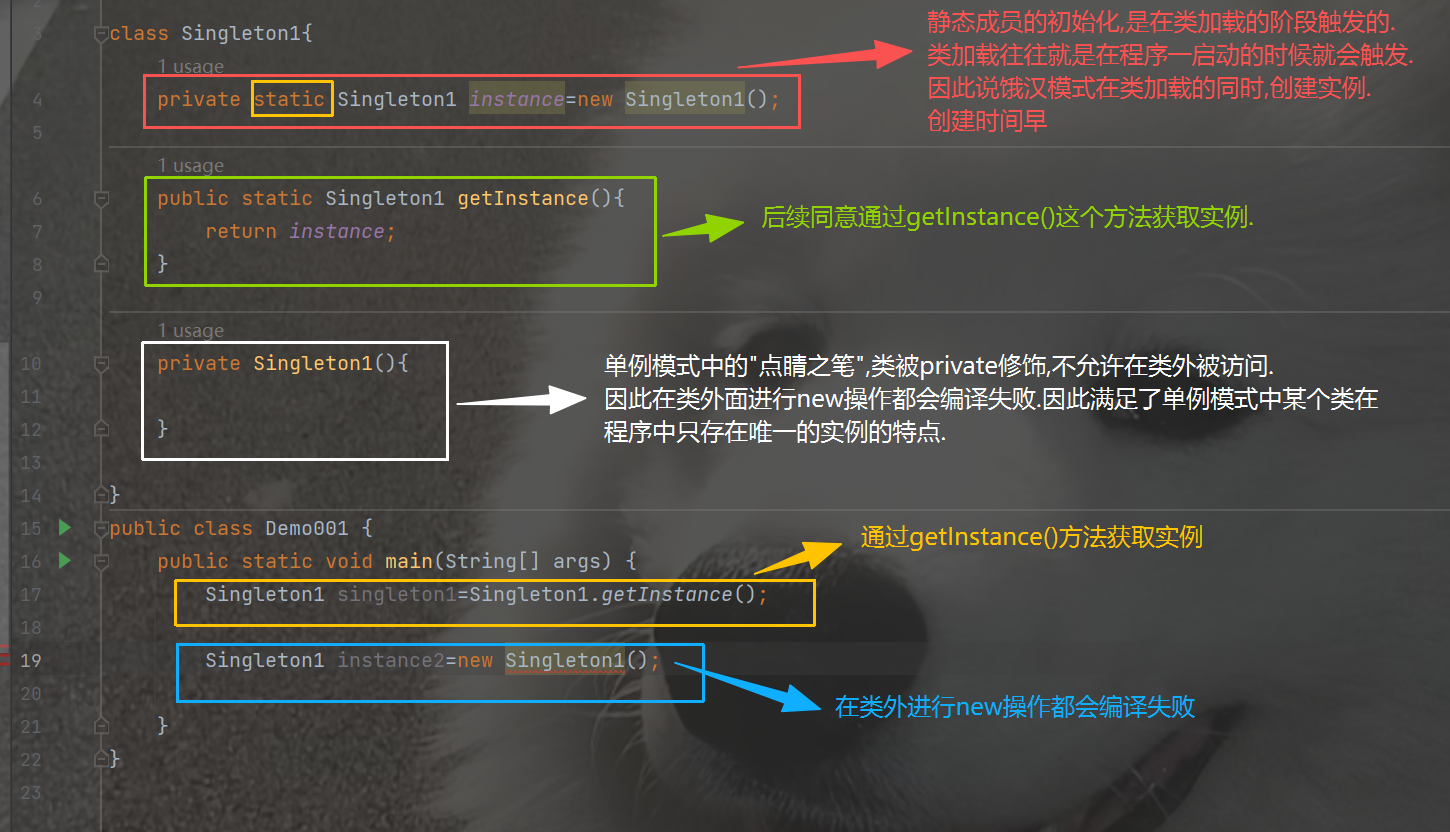
- 饿汉模式:尽早创建.类加载的时候,创建实例.
java
class Singleton1{
    // 饿汉模式:类加载时就创建实例(尽早创建)
    private static Singleton1 instance=new Singleton1();

    // 获取单例实例的入口
    public static Singleton1 getInstance(){
        return instance;// 直接返回已创建好的实例
    }

    // 构造方法私有化,禁止外部 new 创建新实例
    private Singleton1(){

    }

}
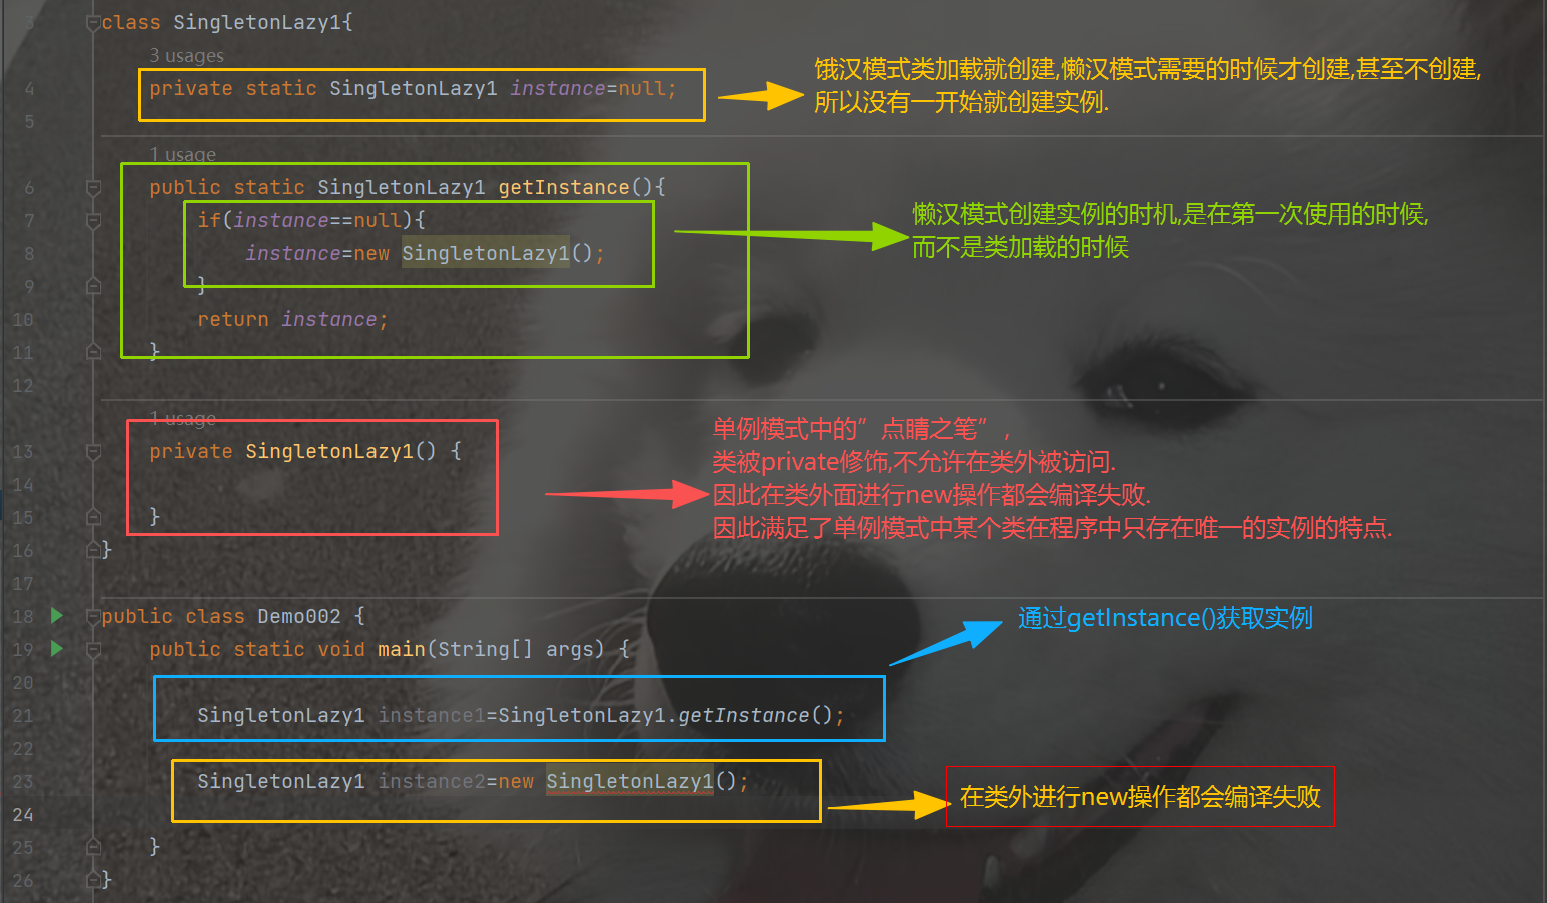
- 懒汉模式:类加载的时候不创建实例,第一次使用 的时候才创建实例.
java
class SingletonLazy1{
    // 懒汉模式:类加载时不创建实例,初始为 null
    private static SingletonLazy1 instance=null;

    // 获取单例实例的入口
    public static SingletonLazy1 getInstance(){
        // 第一次调用时 instance 为 null,才创建实例(懒加载)
        if(instance==null){
            instance=new SingletonLazy1();// 真正创建实例
        }
        return instance;// 后续调用直接返回已创建的实例
    }

    // 构造方法私有化,禁止外部 new 创建新实例
    private SingletonLazy1() {

    }
}
单例模式,还有一些其他的写法,感兴趣的自行查阅,此处不过多展开.
其实上述饿汉/懒汉模式是存在有缺陷的.比如通过反射的方式可以创建该类的实例.但是反射本身就属于"非常规"的手段,在日常开发中并不推荐使用.
- 懒汉模式-多线程版(改进)
思考:上述谈到的单例模式,和线程有什么关系呢?刚才编写的两份代码(饿汉模式,懒汉模式)是否是线程安全的呢?如果不是,该怎么办?(经典面试题) - 饿汉模式:只涉及读操作,因此不涉及线程安全问题.
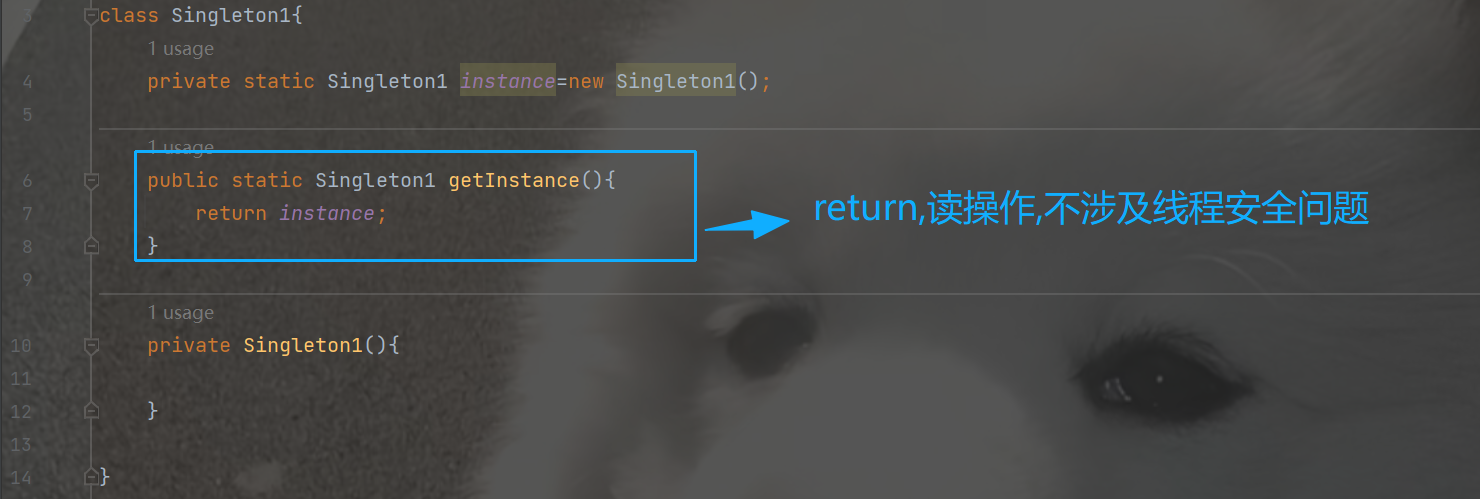
- 懒汉模式:
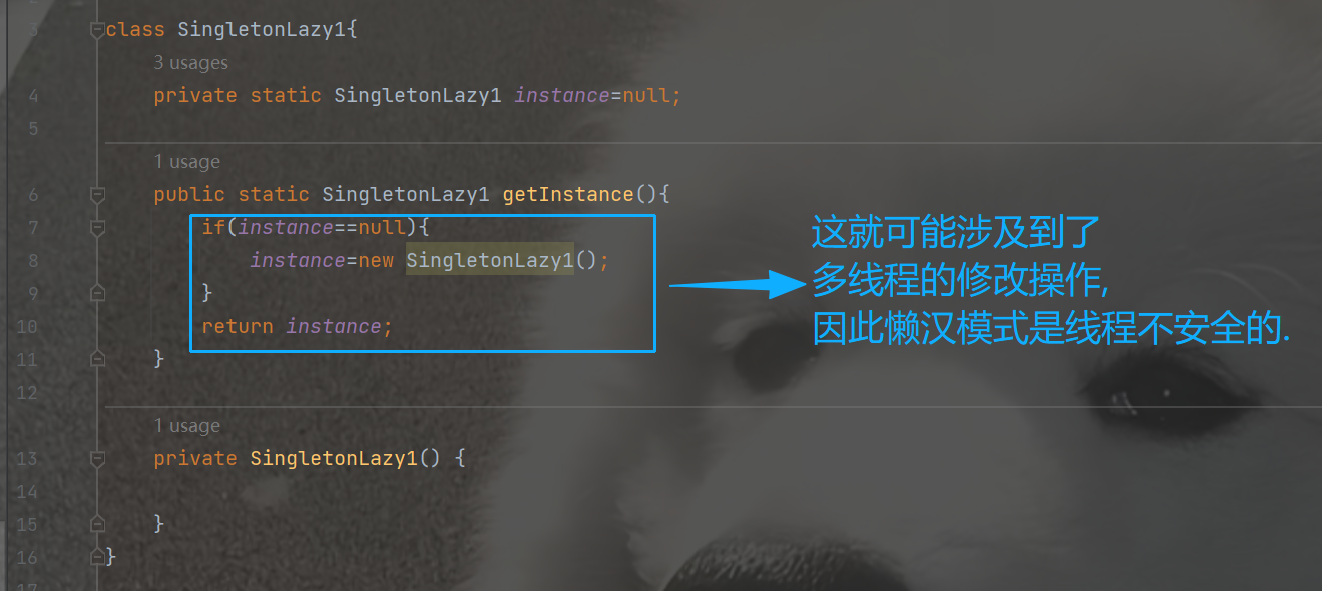
由于,此处是"条件修改",因此此修改操作不是原子的,那么就会涉及线程安全问题.我们希望把条件,修改打包成原子的.那么我们就可以使用我们前面学过的关键字synchronized进行加锁操作,保证修改操作的原子性.
代码修改如下:
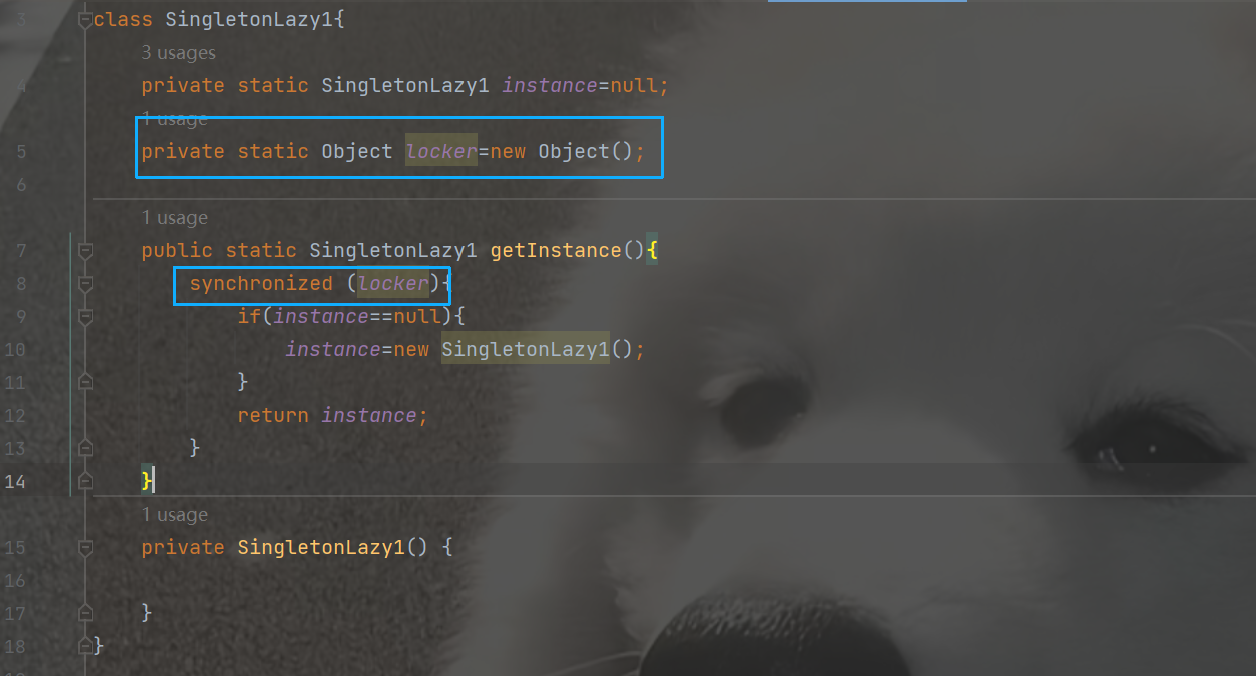
加入锁有没有引入新的问题呢?
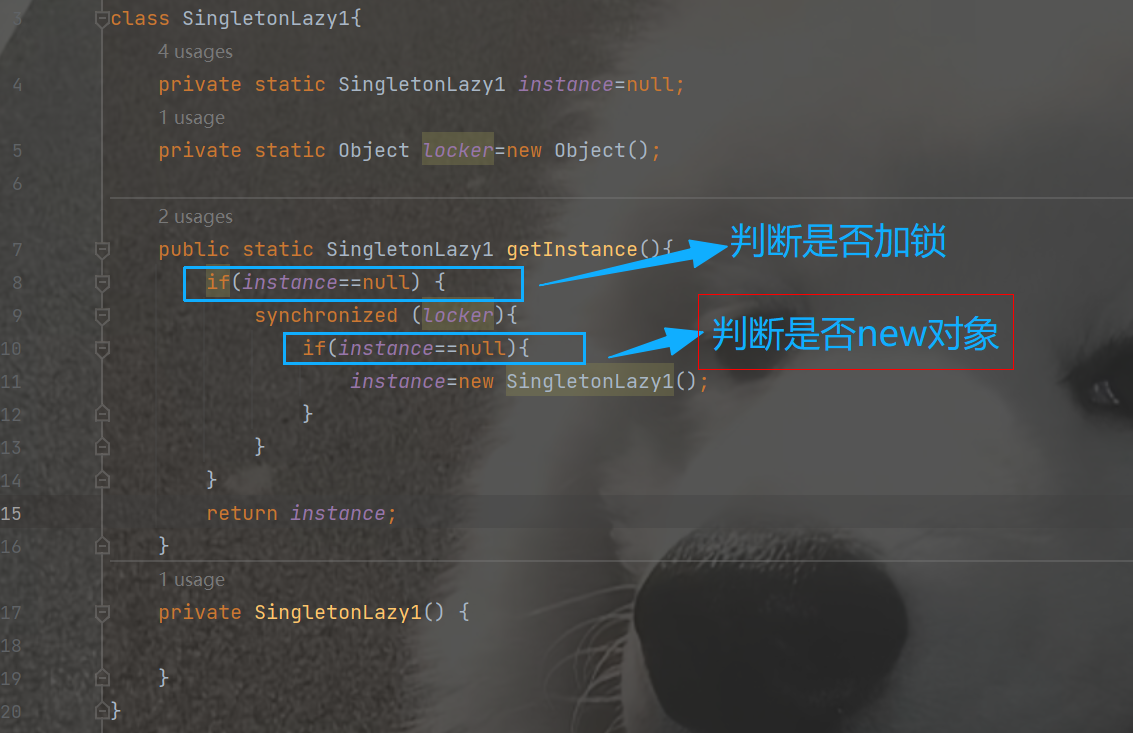
当第一次使用,把实例创建好之后,后续再调用getInstance(),此时直接执行if判定+return操作,此时只涉及读操作,读操作不再涉及线程安全.但是这个时候每调用一次这个方法都会触发一次加锁操作.虽然不涉及线程安全问题了,但是多线程情况下加锁就会发生阻塞等待,影响程序的性能.那么我们只需要在第一次使用创建实例的时候给条件修改操作加锁就可以了.后面再调用这个方法的时候不再进行加锁操作.
代码进一步修改如下:
java
class SingletonLazy1{
    // 懒汉模式:类加载时不创建实例,初始为 null
    private static SingletonLazy1 instance=null;
    // 锁对象:用于保证创建实例时的原子性
    private static Object locker=new Object();

    // 获取单例实例的入口
    public static SingletonLazy1 getInstance(){
        // 外层 if:先判断实例是否已创建,避免每次都加锁(加锁开销较大)
        if(instance==null) {
            // 只有首次创建时才进入加锁代码块
            synchronized (locker){
                // 内层 if:进入锁后再判断一次,防止多个线程同时通过外层 if 后重复创建
                if(instance==null){
                    instance=new SingletonLazy1();// 真正创建实例
                }
            }
        }
        return instance;// 后续调用直接返回已创建的实例
    }

    // 构造方法私有化,禁止外部 new 创建新实例
    private SingletonLazy1() {

    }
}
再仔细看代码思考,可能还会涉及到**"内存可见性问题"**.
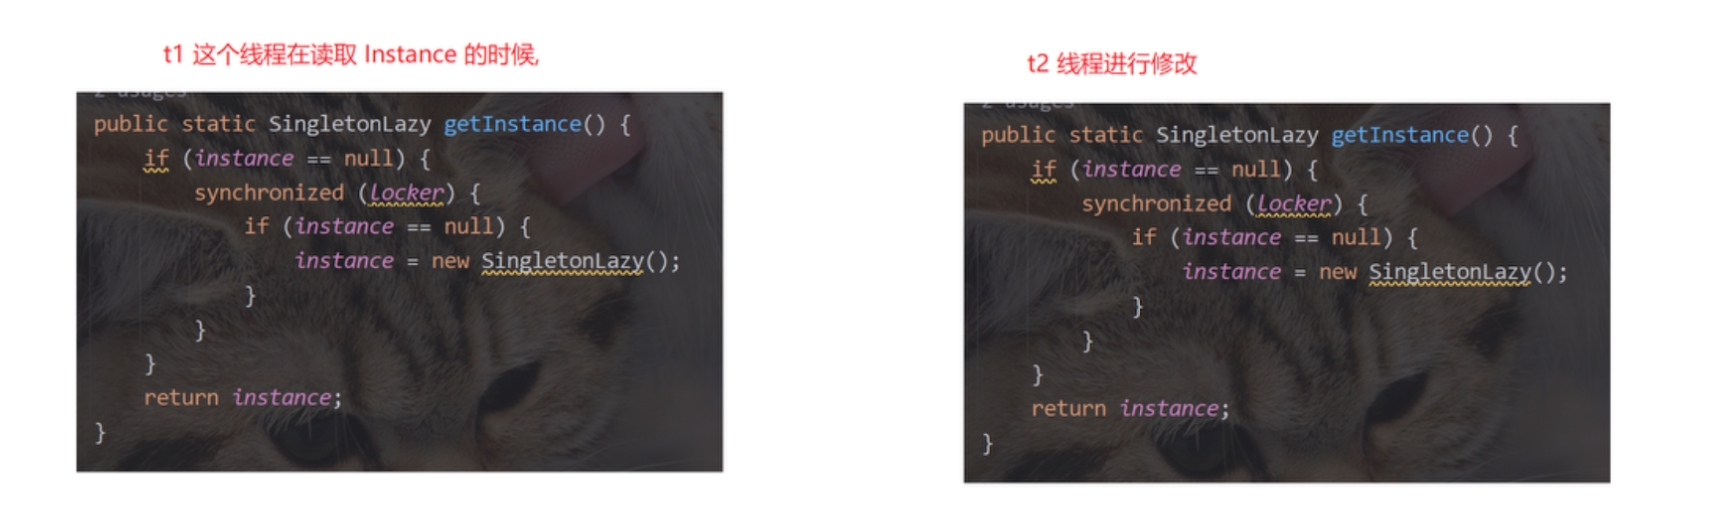
当在多线程的时候,一个线程t1进行读操作,一个线程t2进行修改操作,就有可能会涉及到内存可见性问题.但是此处有些难以验证,为了保险起见,我们可以给Instance加上volatile关键字,从根本上杜绝内存可见性问题.
java
class SingletonLazy1{
//volatile杜绝内存可见性问题
    private static volatile SingletonLazy1 instance=null;
    private static Object locker=new Object();

    public static SingletonLazy1 getInstance(){
        if(instance==null) {
            synchronized (locker){
                if(instance==null){
                    instance=new SingletonLazy1();
                }
            }
        }
        return instance;
    }
    private SingletonLazy1() {

    }
}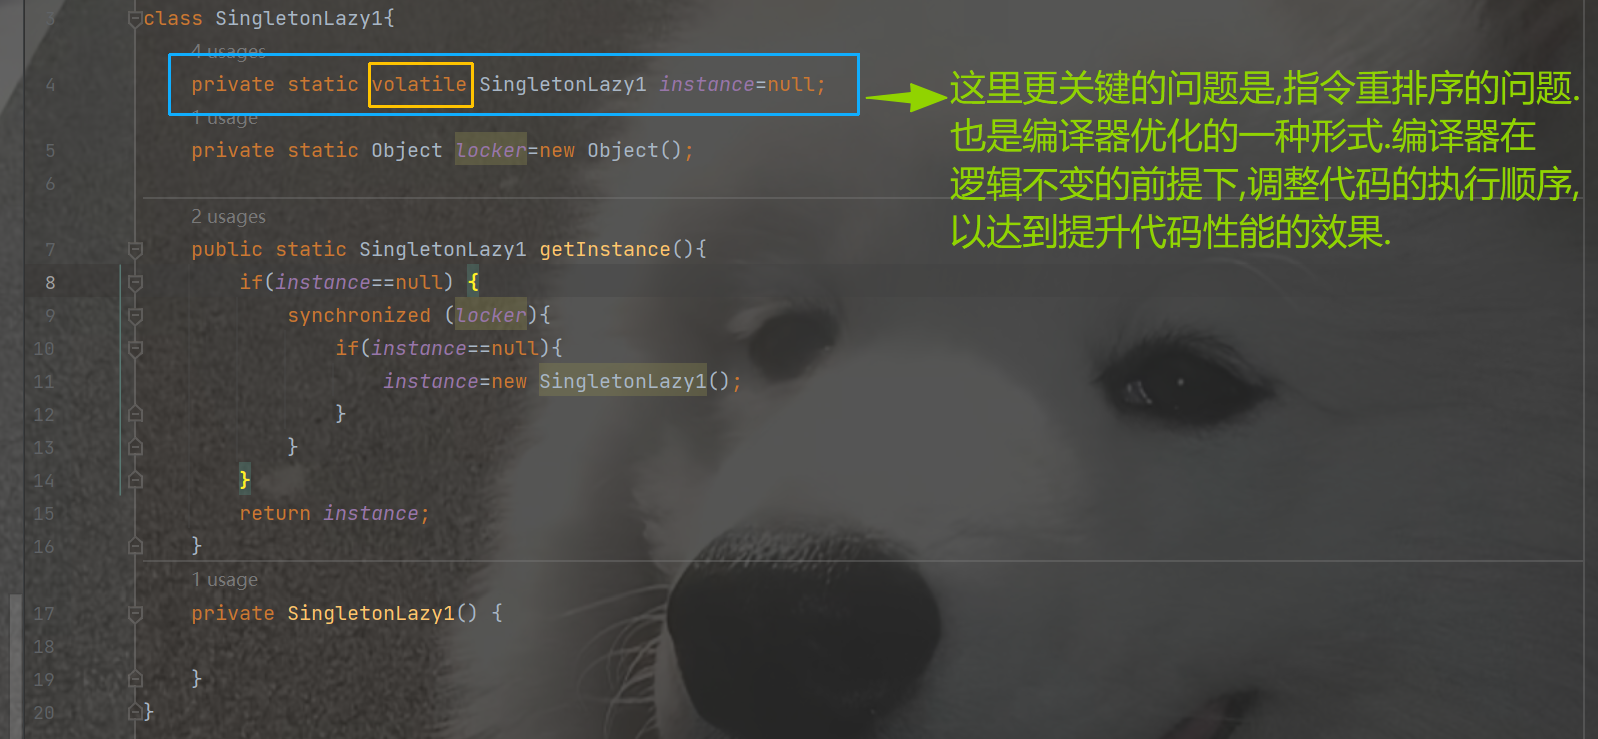
这里更关键的问题是指令重排序的问题 ,也是编译器优化的一种形式.编译器在逻辑不变的前提下,调整代码的执行顺序,以达到提升代码性能的效果.
如何理解指令重排序问题呢?
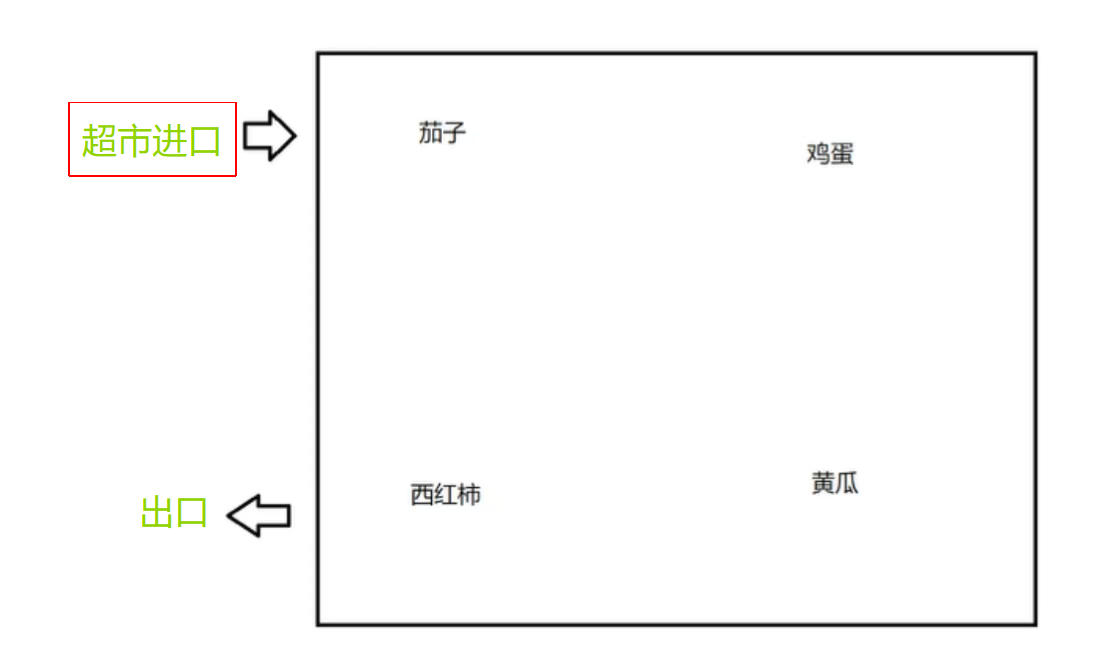
现在我要去超市买西红柿,鸡蛋,茄子,黄瓜.如果按照这个顺序的话我就要绕来绕去,导致花费的时间较长.但是,我们选择优化一下买菜的顺序,变成茄子->鸡蛋->黄瓜->西红柿就可以节省了很多时间.
同理,编译器优化也是这个道理,在不改变代码逻辑的情况下,调整代码的执行顺序,达到一个优化的效果.
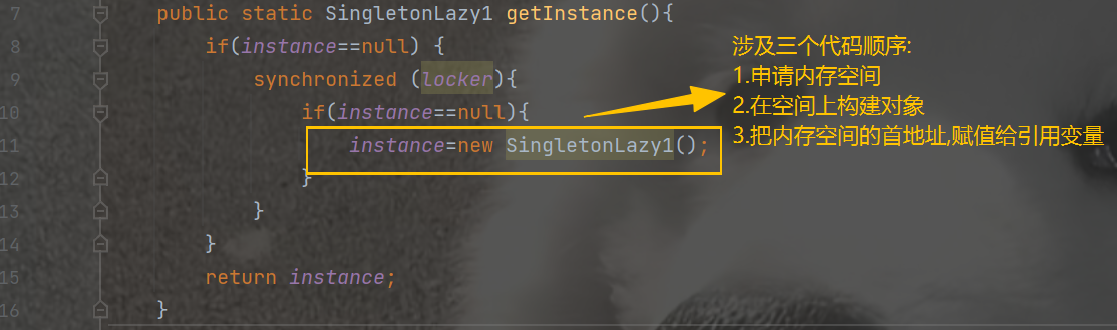
实则上面一行的new操作涉及到了3个代码顺序.正常来说是按照1,2,3这样的顺序来执行的.但是在指令重排序下就有可能变成132这样的顺序.单线程环境下123,132都是无所谓的.但是在多线程的环境下,就会出现bug.因此给instance加上关键字volatile有两方面的功能:
-
1.防止内存可见性问题,确保每次的读取操作都是读取内存.
-
2.防止指令重排序问题 ,保证该变量的读取和修改操作不会触发指令重排序.
总结懒汉模式:
-
1.最终版:
java
class SingletonLazy1{
    // 懒汉模式:类加载时不创建实例,初始为 null
    // volatile:防止内存可见性问题 + 防止指令重排序问题
    private static volatile SingletonLazy1 instance=null;
    // 锁对象:用于保证创建实例时的原子性
    private static Object locker=new Object();

    // 获取单例实例的入口
    public static SingletonLazy1 getInstance(){
        // 外层 if:先判断实例是否已创建,避免每次都加锁(加锁开销较大)
        if(instance==null) {
            // 只有首次创建时才进入加锁代码块
            synchronized (locker){
                // 内层 if:进入锁后再判断一次,防止多个线程同时通过外层 if 后重复创建
                if(instance==null){
                    instance=new SingletonLazy1();// 真正创建实例
                }
            }
        }
        return instance;// 后续调用直接返回已创建的实例
    }

    // 构造方法私有化,禁止外部 new 创建新实例
    private SingletonLazy1() {

    }
}
2.深入理解双重if判定/volatile
- 加锁/解锁是一件开销较高的事情.而懒汉模式的线程不安全只是发生在首次创建实例的时候.因此后续使用的时候,不必再进行加锁.
- 外层if是否加锁,内层的if判断是否
newinstance实例. - 同时为了避免"内存可见性问题"以及"指令重排序"问题,于是补充上了关键字
volatile. - 当多线程首次调用getInstance,会发现instance为null,于是继续往下执行来竞争锁,其中竞争成功的线程,再完成实例的创建.当这个实例创建完之后,其他竞争到锁的线程被里层if挡住了,也就不会继续创建实例.保证了单例模式的唯一实例的特性.
9.2 阻塞队列
9.2.1 什么是阻塞队列?
阻塞队列是一种特殊的队列.遵循**"先进先出".
阻塞队列是线程安全**的一种数据结构偶.并具有以下特性:
- 1.当队列满 的时候,继续入队列 就会阻塞,直到有其他线程从队列中取走元素.
- 2.当队列空 的时候继续出队列 就会阻塞 ,直到有其他线程往队列中插入元素.
阻塞队列的一个典型应用场景就是**"生产者消费者模型"**.
9.2.2 生产者消费者模型
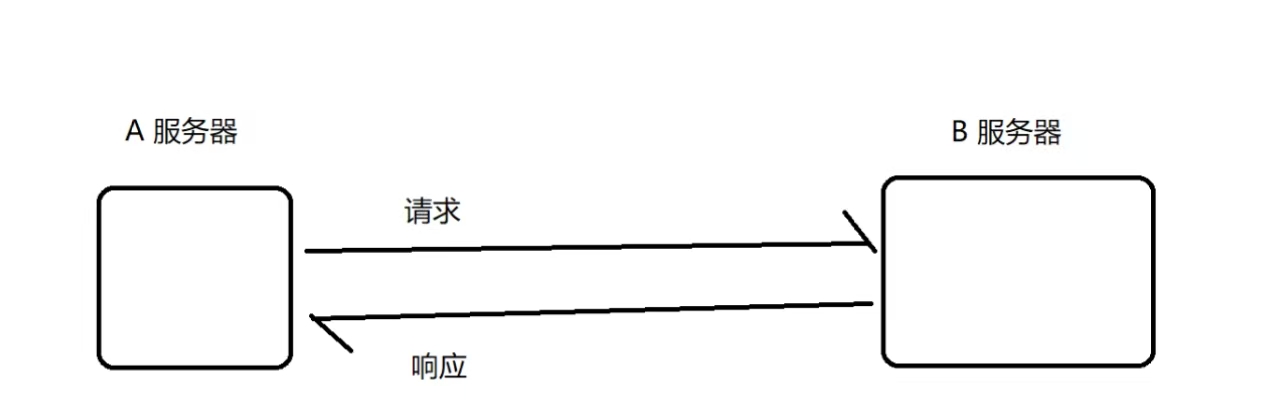
上图的A,B服务器是直接通讯的,A发出请求给B,B响应A的请求.如此A,B的耦合就会很高.编写A的代码的时候,多多少少会有一些和B相关的逻辑.编写B的代码时也会涉及A的相关逻辑.若后续需要修改或者维护程序的时候就会很不方便.我们更希望是低耦合的代码.
而生产者消费者模型是,彼此之间不直接通讯,而是通过阻塞队列来进行通讯,即A服务器和阻塞队列通讯,阻塞队列和B服务器通讯.在A,B服务器之间,阻塞队列就像一座"桥梁",连接了A,B服务器的通讯.
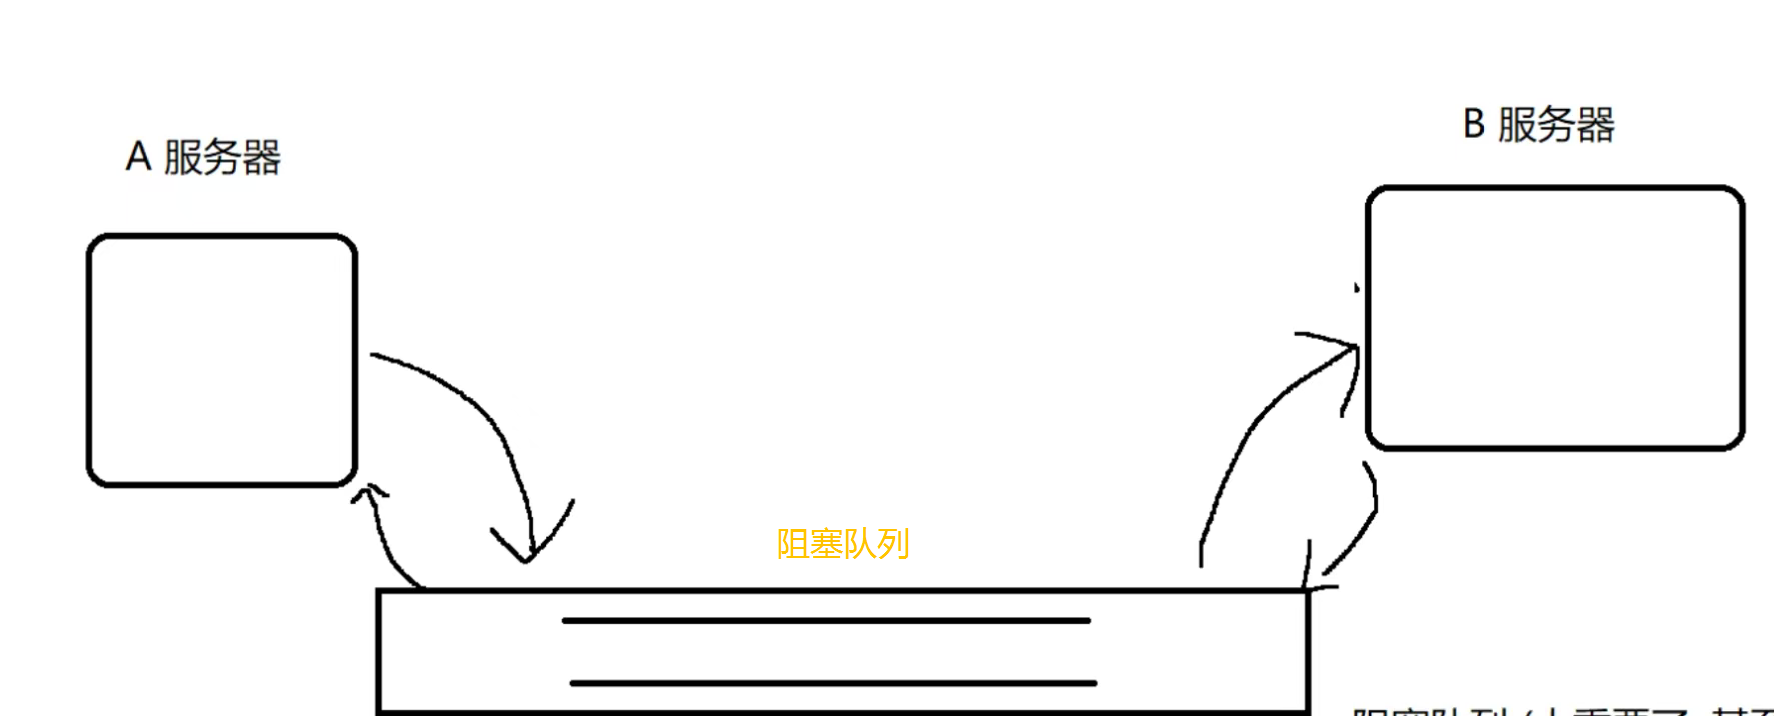
上图即是一个生产者消费者模型.生产者和消费者之间不直接通讯,而是通过阻塞队列来进行通讯,所以生产者生产完数据之后不用等待消费者处理,直接扔给阻塞队列,消费者不找生产者要数据,而是直接从阻塞队列中取.
如此一来:
好处:
- 1.阻塞队列就相当于一个缓冲区,平衡了生产者和消费者的处理能力.(一般来说,A 这类上游服务器(尤其是入口服务器)处理的逻辑比较简单,单个请求消耗的资源较少;而 B 这类下游服务器通常承担更重的任务,例如复杂的计算和存储工作,单个请求消耗的资源更多。如果没有阻塞队列,当 A 遇到请求高峰时,会把所有请求直接转发给 B,而 B 处理每个请求消耗的资源远多于 A,很容易被瞬间的高负载压垮。引入阻塞队列后,情况就不同了:A 在请求高峰时先把请求放入队列,B 再从队列中逐个取出并慢慢处理,从而平滑了请求压力。同时,B还可以利用请求低谷期尽快处理并响应这些请求。)
- 2.阻塞队列也能使生产者和消费者之间解耦.(降低了AB之间得高耦合,便于后期得修改操作).
坏处: - 1.引入阻塞队列后,整体的结构会变得更复杂.此时,就需要更多 的机器进行部署.生产环境的结构会变得更复杂,管理起来也会更麻烦.
- 2.性能被影响.(生产者和队列网络通信,队列和消费者网络通信,还有数据在队列中流转都需要消耗时间,因此对性能要求高的程序不建议使用生产者消费者模型)
9.2.3 标准库中的阻塞队列
在Java标准库中内置了阻塞队列.如果我们需要在一些程序中使用阻塞队列,直接使用标准库中的即可.
- BlockingQueue是一个接口,真正实现的类是LinkenBlockingQueue.
- put方法用于阻塞队列的入队列,take用于阻塞队列的出队列.
- BlockingQueue和我们之前数据结构学过的Queue一样提供了
offerpollpeek方法,但是这些方法不带有阻塞特性.
java
import java.util.concurrent.BlockingQueue;
import java.util.concurrent.LinkedBlockingQueue;

public class demo001 {
    public static void main(String[] args) throws InterruptedException {
        //BlockingQueue是一个接口,真正实现类的是LinkedBlockingQueue
        BlockingQueue<String> queue2=new LinkedBlockingQueue<>(100);//如果不设置capacity,默认是一个非常大的数值.
        																												//实际开发中建议把最大值设置上,数值过大可能会把内存耗尽
        for(int i=0;i<100;i++){
            queue2.put("abc");
        }
        System.out.println("队列已满");
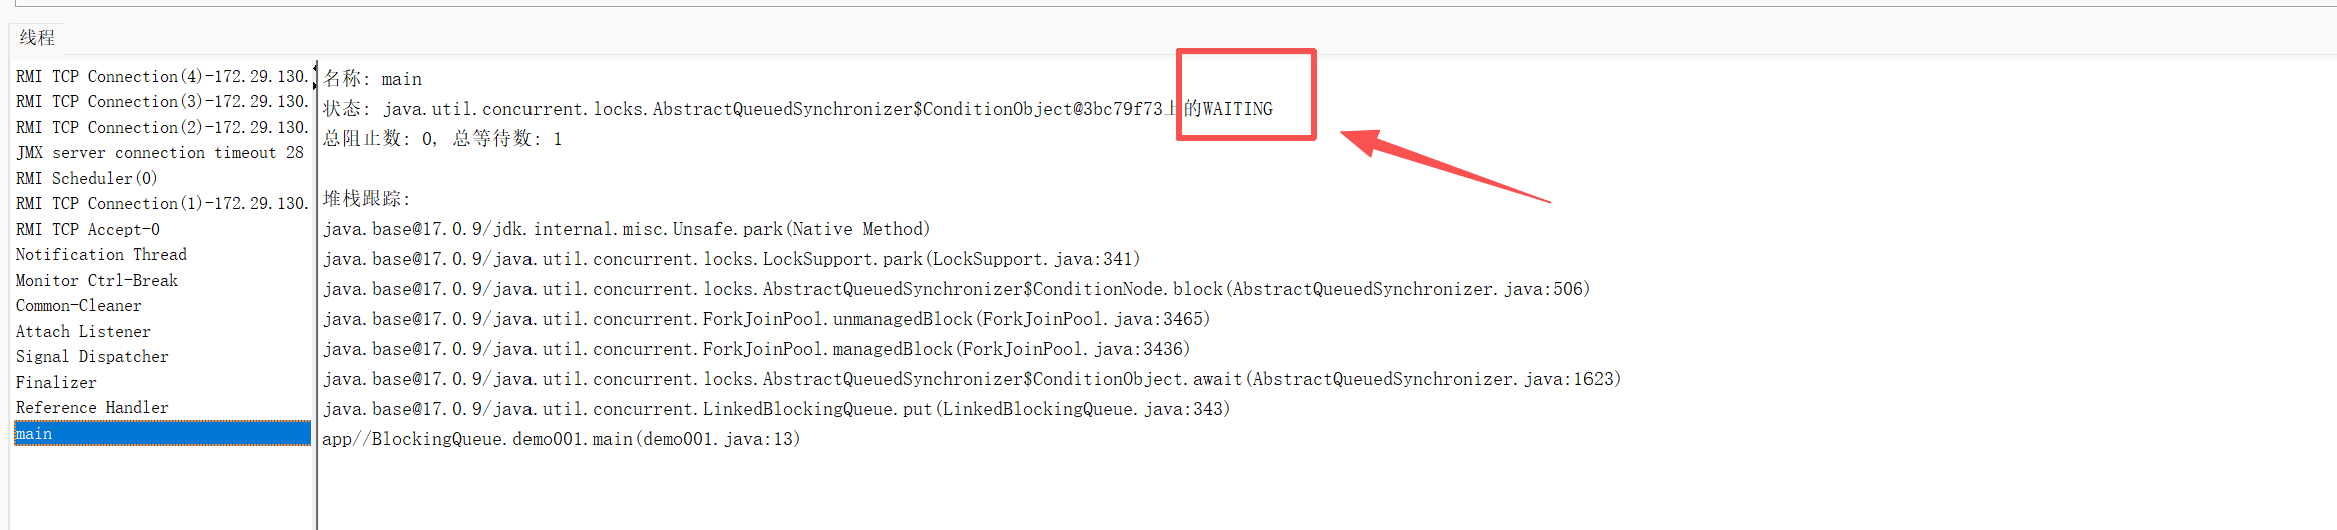
        queue2.put("abc");//阻塞队列已经满了,继续尝试入队列会发生阻塞,直到其他线程从队列中取走元素.
        System.out.println("已满后继续入队");
    }
}
运行结果:
9.2.4 阻塞队列的经典应用场景------生产者消费者模型的实现:
java
package BlockingQueue;

import java.util.concurrent.BlockingQueue;
import java.util.concurrent.LinkedBlockingQueue;

//由于生产者和消费者两个线程的速度旗鼓相当,所以很难见到阻塞的效果,想要看到阻塞的效果可以让两者之一的速度减慢

public class Demo002 {
    public static void main(String[] args) {
        //此处的泛型可加可不加,不加的话后面代码的取出take操作就要手动转换一下数据类型
        BlockingQueue<Integer>  queue=new LinkedBlockingQueue<>();
        Thread producer=new Thread(()->{
            int n=0;
            while(true){
                try {
                    queue.put(n);
                } catch (InterruptedException e) {
                    throw new RuntimeException(e);
                }
                System.out.println("生产元素:"+n);
                n++;
            }
        },"producer");

        Thread consumer=new Thread(()->{

            while(true){
                int n= 0;
                try {
                    n=queue.take();
                    //n = (Integer)queue.take();不加泛型就要手动转换
                } catch (InterruptedException e) {
                    throw new RuntimeException(e);
                }
                System.out.println("消费元素:"+n);

            }
        },"consumer");

        producer.start();
        consumer.start();
        producer.join();
        consumer.join();
    }
}
9.2.5 模拟实现阻塞队列
java
package BlockingQueue;

class MyBlockingQueue002 {
    private int size=0;
    private int head=0;
    private int tail=0;
    private String[] queue=null;
    public MyBlockingQueue002(int capacity){
        queue=new String[capacity];
    }

    public void put(String elem) throws InterruptedException {
       synchronized (this){
           while(size>=queue.length){
               this.wait();//队列满了就要阻塞等待
           }
           queue[tail]=elem;//没有满就把元素插入到队尾
           tail++;
           if(tail>=queue.length){
               tail=0;//当tail比队长大就从新循环
           }
           size++;
           this.notify();//只要发生了元素的入队,说明队列一定不会为空,就可以通知别的等待要取出的线程继续执行代码.
       }
    }
    public String take() throws InterruptedException {
        synchronized (this){
            while(size==0){
                this.wait();//队列为空,继续取出,阻塞等待
            }
            String ret=queue[head];//不为空就把元素记录下来,方便最后返回结果
            head++;
            if(head>=queue.length){
                head=0;//若对头比队长大就重新循环
            }
            size--;
            this.notify();//只要发生了元素的取走take,就说明队列一定不为满,就可以通知因为满了想要继续插入元素的等待队列
            return ret;
        }
    }
}

public class Demo006 {

    public static void main(String[] args){
        MyBlockingQueue002 queue1=new MyBlockingQueue002(1000);
        Thread producer=new Thread(()->{
        int n=0;
            while(true){
                try {
                    queue1.put(n+" ");//一直插入元素

                } catch (InterruptedException e) {
                    throw new RuntimeException(e);
                }
                System.out.println("生产元素:"+n);
                n++;
            }
        },"producer");
        Thread consumer=new Thread(()->{
            while(true){
                try {
                    System.out.println("消费元素:"+queue1.take());//一直取出元素
                    Thread.sleep(1000);//通过sleep方法控制生产者和消费者的速度.此代码是生产快,消费慢
                } catch (InterruptedException e) {
                    throw new RuntimeException(e);
                }

            }
        },"consumer");
        producer.start();
        consumer.start();
    }
}
为什么模拟实现阻塞队列时要加锁?
加锁(synchronized)保证同一时刻只有一个线程执行入队/出队,确保操作的原子性 与可见性 ,让阻塞队列在多线程下安全可靠。
具体来说,put 和 take 内部对 size、head、tail 的修改都不是原子操作,多个线程并发执行时可能互相干扰,导致数据错乱。加锁后,同一时刻只有一个线程能进入临界区,避免了竞态条件;同时配合 wait/notify 实现满时阻塞、空时等待的线程协作机制。
9.3线程池
9.3.1线程池的概念
线程池(Thread Pool) 是一种多线程处理技术,它预先创建一组线程 并放入"池"中统一管理 ,当有任务 需要执行时,直接从池中取出 一个空闲线程来处理,任务执行完线程不销毁 ,而是归还池中 等待下一个任务.(即把一组线程提前创建好,放到一个地方.需要用到的时候随时可以去取,用完之后还回池中).
创建线程池的原因:
起初我们创建线程是因为:频繁创建销毁进程太慢了.随着互联网的发展,随着我们对程序性能的进一步需求.现在觉得,频繁创建和销毁线程也不太能满足我们的需求了.于是有了两个解决方案:
- 1.线程池
- 2.协程(轻量级线程)
思考:为什么我们认为直接创建新的线程的开销会比直接从线程池中取要大呢?
因为直接创建新的线程 ,每次都要向操作系统申请资源+销毁时释放资源 (涉及操作系统内核的操作),而线程池 把创建成本一次性付清了,之后取线程只需要从池中拿现成的,自然快得多.
深入理解:为什么创建线程的开销大?------内核态与用户态
要真正理解这个开销,需要引入**内核态(Kernel Mode)与用户态(User Mode)**的概念。
- 用户态 :应用程序代码运行的状态。我们平时写的 Java 代码(如
new Thread()、queue.put())都运行在用户态,权限受限,只能访问自己进程内的资源。 - 内核态:操作系统内核代码运行的状态。拥有最高权限,可以访问 CPU、内存、磁盘、网卡等所有硬件资源。
用户态与内核态的切换(上下文切换)是有开销的,因为切换时要保存当前线程的寄存器、程序计数器等现场信息,再恢复目标线程的现场,这个过程本身就要消耗 CPU 时间。
直接创建线程的完整流程(涉及多次内核态切换):
- 用户态发起请求 :Java 代码调用
new Thread(),本质上是向 JVM 发起创建线程的请求。 - JVM 调用系统调用 :JVM 通过
pthread_create等系统调用,向操作系统内核申请创建线程。 - 陷入内核态:执行系统调用时,CPU 从用户态切换到内核态。
- 内核分配资源 :内核态下,操作系统需要为这个新线程分配线程控制块(TCB) 、栈空间 、寄存器上下文等资源,并把它加入调度队列。
- 返回用户态:内核完成创建后,CPU 再切换回用户态,把控制权交还给应用程序。
- 销毁时同理 :线程执行完毕,
run()返回后,JVM 又要发起系统调用,再次陷入内核态,由内核回收该线程占用的资源,再切回用户态。
也就是说,每创建/销毁一个线程,都要经历「用户态 → 内核态 → 用户态」的多次切换,而每次切换都有开销。频繁创建销毁线程,这些开销会被无限放大。
而线程池为什么快?
线程池在初始化时,一次性创建好一组线程(只经历一次创建开销),之后:
- 取线程 :只是从池中拿一个空闲线程,纯用户态操作,不涉及系统调用,不陷入内核态。
- 还线程 :任务执行完,线程不销毁,而是归还池中,同样不涉及内核态。
所以线程池把「创建/销毁线程」的内核态开销一次性付清,后续取用线程几乎零成本,自然比每次直接创建线程快得多。
一句话总结: 直接创建线程每次都要==「用户态 ↔ 内核态」切换,向操作系统申请/释放资源;而线程池只在初始化时付一次内核态开销,之后取用线程都在用户态==完成,所以更快。
9.3.2标准库中的线程池
9.3.2.1通过直接调用 ThreadPoolExecutor 类构造方法创建线程池
Java 线程池核心类 ThreadPoolExecutor 的官方 Oracle JDK API 文档链接:
-
JDK8(经典,面试最常看)
https://docs.oracle.com/javase/8/docs/api/java/util/concurrent/ThreadPoolExecutor.html
-
JDK17(推荐新项目)
-
JDK21
这些文档中给我们提供了 7 个参数的全参构造方法。这是 Java 官方提供的最底层、最灵活的线程池创建方式,允许开发者对线程池的行为进行完全自定义.

这7个参数的含义:
-
int corePoolSize:核心线程数.(即有多少个线程.线程池一创建这些线程也随之创建.直到整个线程池销毁,这些线程才会销毁)
-
int maximumPoolSize:最大线程数(核心线程数+非核心线程数).(非核心线程不繁忙的时候就销毁,繁忙再创建)
-
long keepAliveTime:非核心线程允许空闲的最大时间.
-
TimeUnit unit:keepAliveTime的时间单位.(秒?分钟?还是其他值?)
-
BlockingQueue workQueue:工作队列.
-
ThreadFactory threadFactory:工厂模式(也是一种设计模式,和单例模式是并列的关系).
-
RejectedExecutionHandler handler:拒绝策略.
此处详细展开简述工厂模式 和拒绝策略:
-
工厂模式 :工厂模式弥补了构造方法的缺陷.比如在数学中,我们想要拿到一个二维坐标中的一个坐标点,我们可以通过平面直角坐标系 的方法/极坐标 的方法.于是我们有了下面的代码:
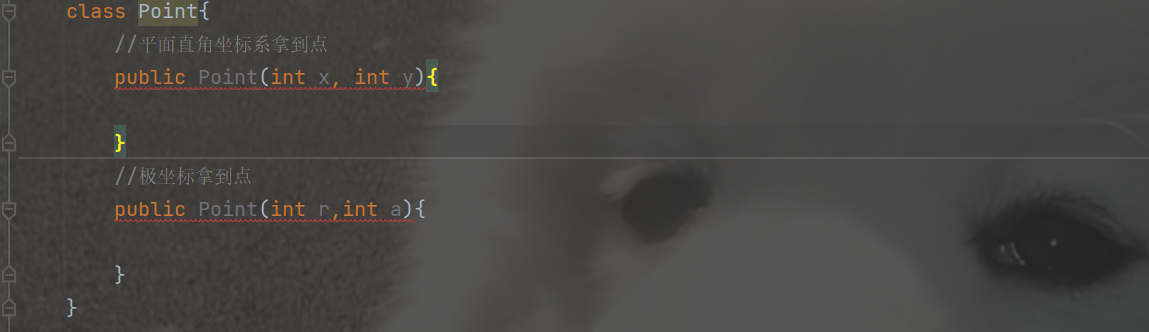
此时就会出现一个问题:构造方法的名字是固定的,想要提供不同的版本就要通过重载,但是有时候重载不一定能成功.比如上面就是重载失败的例子.(重载:方法名相同即为重载,不看参数是否相同).解决方案之一:使用工厂模式.
工厂模式的核心是通过静态的方法,把构造对象new的过程,各种属性初始化的过程封装了起来.
工厂模式通过提供多组静态方法,实现不同情况的构造.
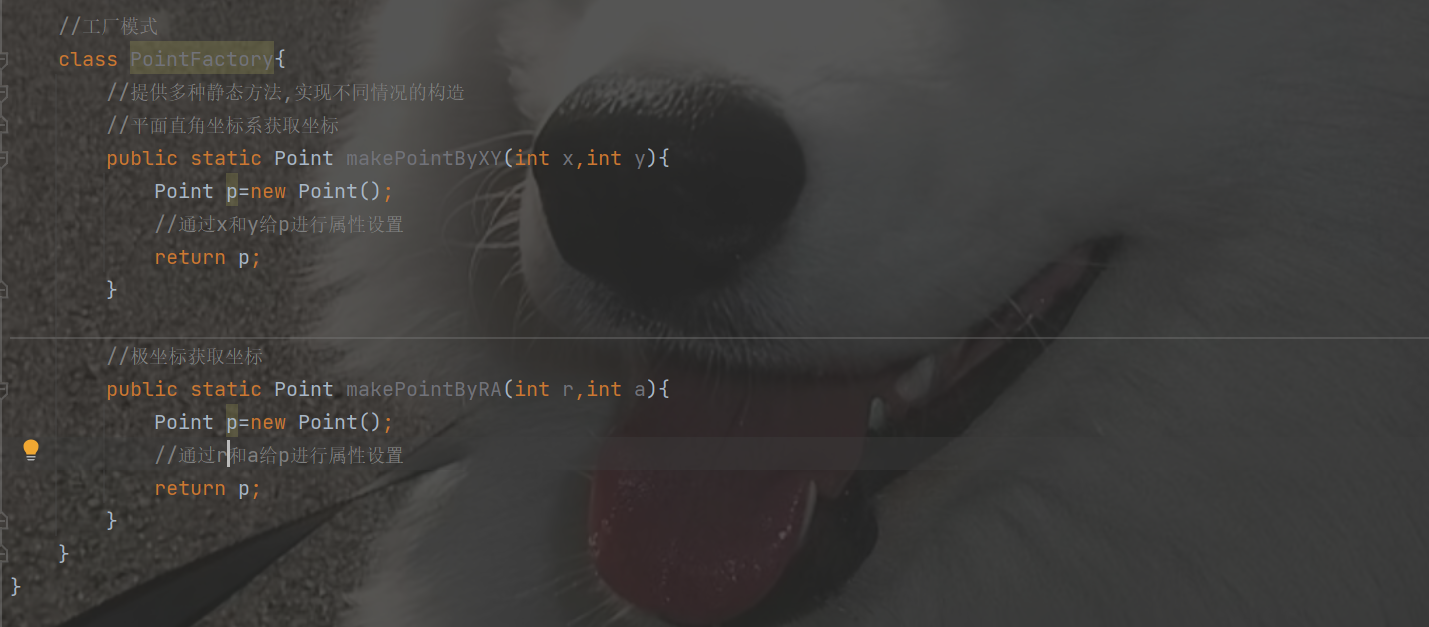
java
    //工厂模式
    class PointFactory{
        //提供多种静态方法,实现不同情况的构造
        //平面直角坐标系获取坐标
        public static Point makePointByXY(int x,int y){
            Point p=new Point();
            //通过x和y给p进行属性设置
            return p;
        }

        //极坐标获取坐标
        public static Point makePointByRA(int r,int a){
            Point p=new Point();
            //通过r和a给p进行属性设置
            return p;
        }
}- 拒绝策略 :是指如果任务量超出了公司的负荷接下来的应对策略.有4种方案.
- AbortPolicy():直接抛出异常.
- CallerRunsPolicy():让调用submit的线程自己执行任务.
- DiscardOldestPolicy():丢弃队列中最古老的任务.
- DiscardPolicy():丢弃当前队列最新的任务.
拒绝策略的生活化理解------大学生满课 vs 班长派活
拒绝策略听起来抽象,其实用生活中的场景一对比就很好懂了。假设你是一个大学生 ,今天从早到晚满课 (相当于线程池里的线程已经全部被占用,工作队列也满了),这时候班长又来找你,让你去参加一个活动(相当于又提交了一个新任务)。此时你「忙不过来」了,该怎么应对?这四种拒绝策略就是四种不同的应对方式:
- AbortPolicy()(直接抛出异常):你直接跟班长说「我去不了,这活我不接」,干脆利落地拒绝掉。对应到线程池,就是直接抛出异常,告诉调用方任务被拒绝了。
- CallerRunsPolicy()(让调用者自己执行) :你实在抽不开身,就跟班长说「这活动你自己去参加吧」。对应到线程池,就是让提交任务的那个线程自己来执行这个任务,而不是丢给线程池。
- DiscardOldestPolicy()(丢弃最老的任务) :你手头已经排了一堆事,实在塞不下了,就把最早安排的那件事 先放一放,腾出空来参加班长这个新活动。对应到线程池,就是丢弃队列中最老的那个任务,给新任务腾位置。
- DiscardPolicy()(丢弃最新的任务) :你实在忙不过来,就跟班长说「这个新活动我去不了,你找别人吧」,把班长刚提的这个新任务 直接丢掉。对应到线程池,就是静默丢弃当前提交的这个新任务,不抛异常也不执行。
9.3.2.2通过Executors类创建线程池
ThreadPoolExecutor 的官方给我们提供的含7个参数构造方法来创建线程池过于复杂了,所以java标准库中给我们提供了另一组类,针对ThreadPoolExecutor进行了进一步的封装,简化了线程池的使用.
- 使用Executors类下的newFixedThreadPool方法意味着核心线程数和最大线程数一样.这个数目自定义.

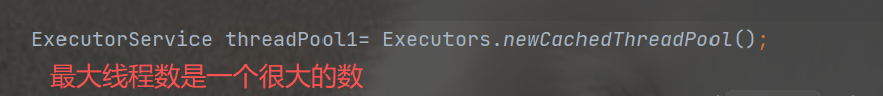
- 使用Executors类下的newCachedThreadPool方法意味着此时线程池中的线程数是一个很大的数目.
- 代码实例:
java
package MyThreadPool;

import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;

public class Demo02 {
    //标准库中的线程池也是前台线程
    public static void main(String[] args) {
        ExecutorService threadPool1= Executors.newCachedThreadPool();
        ExecutorService threadPool2=Executors.newFixedThreadPool(10);
        for(int i=0;i<100;i++){
            int id=i;
            threadPool1.submit(()->{
                System.out.println(Thread.currentThread().getName()+"执行任务"+id);
            });
        }
        for(int i=0;i<100;i++){
            threadPool2.submit(()->{
                System.out.println(Thread.currentThread().getName()+"  hello world");
            });
        }
        //shutdown能够把线程池里的线程全部关闭,但是不能保证线程池中的任务全部执行完.强行终止
        //所以需要线程池把所有任务都执行完比,可以调用awaitTermination()方法终止.
        threadPool1.shutdown();
        threadPool2.shutdown();
    }
}- 运行结果:
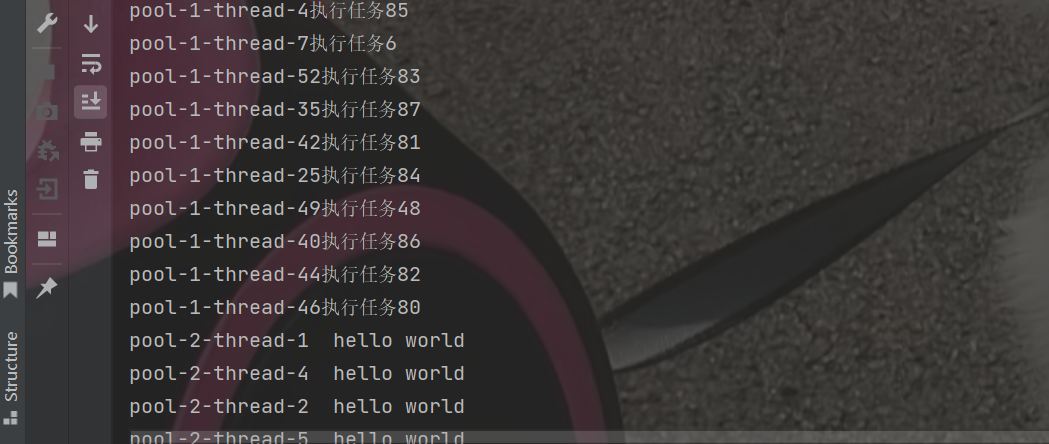
观察结果就可以看出,使用newCachedThreadPool方法的时候线程数较大,newFixedThreadPool则是固定的线程数.
9.3.2.3模拟实现线程池
java
package MyThreadPool;

import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;

class MyThreadPool02{
    //置为后台线程
    private BlockingQueue<Runnable> queue=new ArrayBlockingQueue<>(1000);
    public MyThreadPool02(int n){
        for(int i=0;i<n;i++){
            Thread t=new Thread(()->{
                try{
                    while (true) {
                        Runnable task=queue.take();
                        task.run();
                    }
                }catch(InterruptedException e){
                    e.printStackTrace();
                }
            });
            // 标准库中的线程池默认创建的是前台线程(非守护线程),
            // 这里为了演示方便,将工作线程设为后台线程,
            // 这样主线程结束后 JVM 会直接退出,无需手动关闭线程池。
            //也可以不置为后台线程,知识这样的话程序会一直处于挂起即运行状态.
            t.setDaemon(true);
            t.start();
        }
    }
    public void submit(Runnable task) throws InterruptedException {
        queue.put(task);
    }

}
public class Demo03 {
    public static void main(String[] args) throws InterruptedException {
        MyThreadPool02 myThreadPool02=new MyThreadPool02(10);
        for(int i=0;i<1000;i++){
            int id=i;
            myThreadPool02.submit(()->{
                System.out.println(Thread.currentThread().getName()+"执行任务"+(id+1));
            });
        }
        Thread.sleep(1000);
    }
}
9.4定时器
定时器是软件开发中的一个重要组件,类似于一个闹钟.时间到了就执行一些逻辑.
9.4.1标准库中的定时器
- 标准库中提供了一个Timer类.Timer类的核心方法是
schedule. - 正常描述任务都是用
Runnable,在定时器这里稍有特殊,把Runnable封装成了TimerTask.
java
package Timer;

import java.util.Timer;
import java.util.TimerTask;

public class Demo01 {
    public static void main(String[] args) {
        //创建一个定时器对象
        Timer timer = new Timer();
                        //正常描述任务是Runnable,但是定时器稍有特殊
        timer.schedule(new TimerTask() {
            //重写run方法
            //任务内容
            @Override
            public void run() {
                System.out.println("hello 1000");
            }
        },1000);//1秒后执行

        timer.schedule(new TimerTask(){
           public void run(){
               System.out.println("hello 2000");
           }
        },
                2000);//两秒后执行

        timer.schedule(new TimerTask() {
            @Override
            public void run() {
                System.out.println("hello 3000");
            }
        },3000);//3秒后执行

    }
}
9.4.2模拟实现定时器
此处我们需要引入一个概念:时间戳
什么是时间戳?
时间戳(Timestamp)是计算机中用来表示某个时刻 的一种方式,本质上是一个数字 ,代表从某个固定的起始时间点(称为纪元 ,Epoch)到当前时刻所经过的时间量。
在 Java 中,最常用的是毫秒时间戳 ,获取方式就是 System.currentTimeMillis(),它返回一个 long 类型的整数。
例如,System.currentTimeMillis() 返回 1697000000000,就表示从 1970 年 1 月 1 日 0 点到现在已经过去了 1697000000000 毫秒。
为什么定时器要用时间戳?
定时器要判断「某个任务该不该执行」,就需要知道当前时间 和任务的执行时间 。用时间戳来表示,两者都是数字,直接比较大小即可:
- 当前时间戳 < 任务时间戳 → 还没到点,继续等待;
- 当前时间戳 >= 任务时间戳 → 时间到了,执行任务。
一句话总结: 时间戳就是用一个数字 表示一个时刻 ,在 Java 中常用System.currentTimeMillis()获取毫秒时间戳;定时器正是靠「比较当前时间戳与任务时间戳」来判断任务是否到期。
java
package Timer;

import java.util.PriorityQueue;

/**
 * 定时器任务
 * 实现 Comparable 接口,让 PriorityQueue 能按执行时间排序
 */
class MyTimerTask1 implements Comparable<MyTimerTask> {
    private  Runnable task;   // 要执行的任务
     long time;       // 任务的绝对执行时间(毫秒时间戳)

    public MyTimerTask1(Runnable task, long time) {
        this.task = task;
        this.time = time;
    }

    /**
     * 按执行时间从小到大排序
     */
    public int compareTo(MyTimerTask o) {
        return (int)(this.time - o.getTime());
    }


    public long getTime() {
        return time;
    }

    public void run() {
        task.run();
    }
}

/**
 * 简易定时器
 * 内部用一个工作线程不断检查优先队列的队首任务是否到期
 */
class MyTimer1 {
    private final Object locker = new Object();                        // 用于线程间等待/通知的锁对象
    private final PriorityQueue<MyTimerTask> queue = new PriorityQueue<>(); // 按执行时间排序的小顶堆

    /**
     * 提交一个延迟任务
     * @param task  要执行的任务
     * @param delay 延迟多少毫秒后执行(相对时间)
     */
    public void schedule(Runnable task, long delay) {
        synchronized (locker) {
            // 把相对延迟转换成绝对时间戳:当前时间 + 延迟
            MyTimerTask timerTask = new MyTimerTask(task, System.currentTimeMillis() + delay);
            queue.offer(timerTask);   // 加入优先队列,会自动按时间排序
            locker.notifyAll();       // 唤醒工作线程,让它重新检查队首
        }
    }

    public MyTimer1() {
        // 创建一个守护线程,负责不断检查并执行到期的任务
        Thread t = new Thread(() -> {
            while (true) {
                MyTimerTask task = null; // 在锁外执行任务,避免持有锁时执行耗时操作

                synchronized (locker) {
                    try {
                        // 队列为空时,工作线程一直等待,直到有新任务提交
                        while (queue.isEmpty()) {
                            locker.wait();
                        }

                        MyTimerTask peek = queue.peek(); // 查看队首(最早要执行的任务)
                        long delay = peek.getTime() - System.currentTimeMillis(); // 计算还需要等多久

                        if (delay > 0) {
                            // 还没到执行时间,等待剩余时间
                            // wait 可能被提前唤醒,所以醒来后用 continue 重新计算剩余时间
                            locker.wait(delay);
                            continue;
                        }

                        // 时间已到(或已过期),从队列中取出
                        task = queue.poll();
                    } catch (InterruptedException e) {
                        // 线程被中断时退出循环
                        Thread.currentThread().interrupt();
                        break;
                    }
                }

                // 在锁外执行任务,避免阻塞其他线程调用 schedule
                if (task != null) {
                    try {
                        task.run();
                    } catch (Throwable ex) {
                        // 捕获任务抛出的异常,防止工作线程被杀死
                        ex.printStackTrace();
                    }
                }
            }
        });
        t.setDaemon(true); // 设为守护线程,主线程结束后程序可以正常退出
        t.start();
    }
}

public class Demo3 {
    public static void main(String[] args) {
        MyTimer myTimer = new MyTimer();

        // 3秒后执行
        myTimer.schedule(new Runnable() {
            @Override
            public void run() {
                System.out.println("hello 3000");
            }
        }, 3000);

        // 1秒后执行,验证排序是否正确
        myTimer.schedule(() -> System.out.println("hello 1000"), 1000);
    }
}
到这里,我们JavaEE多线程初阶的学习就到此结束了!!!有不足的地方欢迎大家在评论区留下你们宝贵的建议,如果文章对你有用,大家可以戳戳赞哦!接下来还会更新多线程进阶的文章,进阶的内容的话多用于面试.(嗯~也就是八股).