认知谦逊:知识冲突场景下大模型智能体的识别‑处理‑上报评测框架
原文网页:https://arxiv.org/html/2610.12360v1
PDF链接:https://arxiv.org/pdf/2610.12360v1
arXiv编号:arXiv:2610.12360v1 cs.AI
摘要
当证据和模型内置参数知识互相矛盾时,智能体应当识别不确定性、采取对应行动,或是坚持输出错误结论。现有智能体评测大多只关注最终任务成功率,难以衡量智能体如何处理这类知识冲突。本文围绕**认知谦逊(Epistemic Humility,EH)**开展评测:衡量智能体在任务执行过程中识别、响应、对外通报自身不确定性的能力。
本文将认知谦逊拆解为三条轨迹层面可观测行为指标:识别Identify、处理Solve、上报Escalate(ISE范式) 。基于知识冲突场景开展评测,分为两类实验设置:受控知识冲突、多步智能体执行过程中自然发生的冲突,同时配套无冲突对照样本。对4套智能体框架开展评测,实验表明:更高的任务准确率并不等价于更强的认知谦逊能力;部分高准确率智能体虽然能够在执行中途识别冲突,但在最终错误答案中不会披露尚未解决的不确定性。轨迹分析进一步发现:智能体大多可以在执行早期检测到冲突,但后续步骤无法维持该认知,也不会完成冲突消解。最后实验证明:模型侧提示干预可以提升认知谦逊上报率,但往往会牺牲任务准确率。结果说明认知谦逊是基座大模型、智能体编排框架、评测环境三者交互共同涌现出来的特性。全部智能体运行轨迹与逐轮ISE标注数据集已开源。
关键词
大模型智能体;认知谦逊;知识冲突;不确定性;智能体评测;轨迹级评测;ISE指标
目录
- 引言
- 基于知识冲突的认知谦逊评测方案
- [2.1 冲突构建流水线](#2.1 冲突构建流水线)
- [2.2 评测协议与ISE指标定义](#2.2 评测协议与ISE指标定义)
- [2.3 实验设置](#2.3 实验设置)
- 实验发现
- [3.1 知识冲突会显著影响任务性能](#3.1 知识冲突会显著影响任务性能)
- [3.2 任务准确率越高,不确定性上报行为反而越弱](#3.2 任务准确率越高,不确定性上报行为反而越弱)
- [3.3 智能体早期识别冲突,但缺少后续跟进处理](#3.3 智能体早期识别冲突,但缺少后续跟进处理)
- [3.4 提示词干预可提升认知谦逊,但会损失任务精度](#3.4 提示词干预可提升认知谦逊,但会损失任务精度)
- 讨论
- 局限性
- 结论
- 附录简要说明
1 引言
大语言模型作为智能体的基座,搭配编排框架实现工具调用、记忆、多步推理,被广泛用于代码助手、科研智能体、通用AI助手。但现有评测几乎全部面向最终输出结果,只评判答案对错,忽略任务流程中本应暴露出来的不确定性。
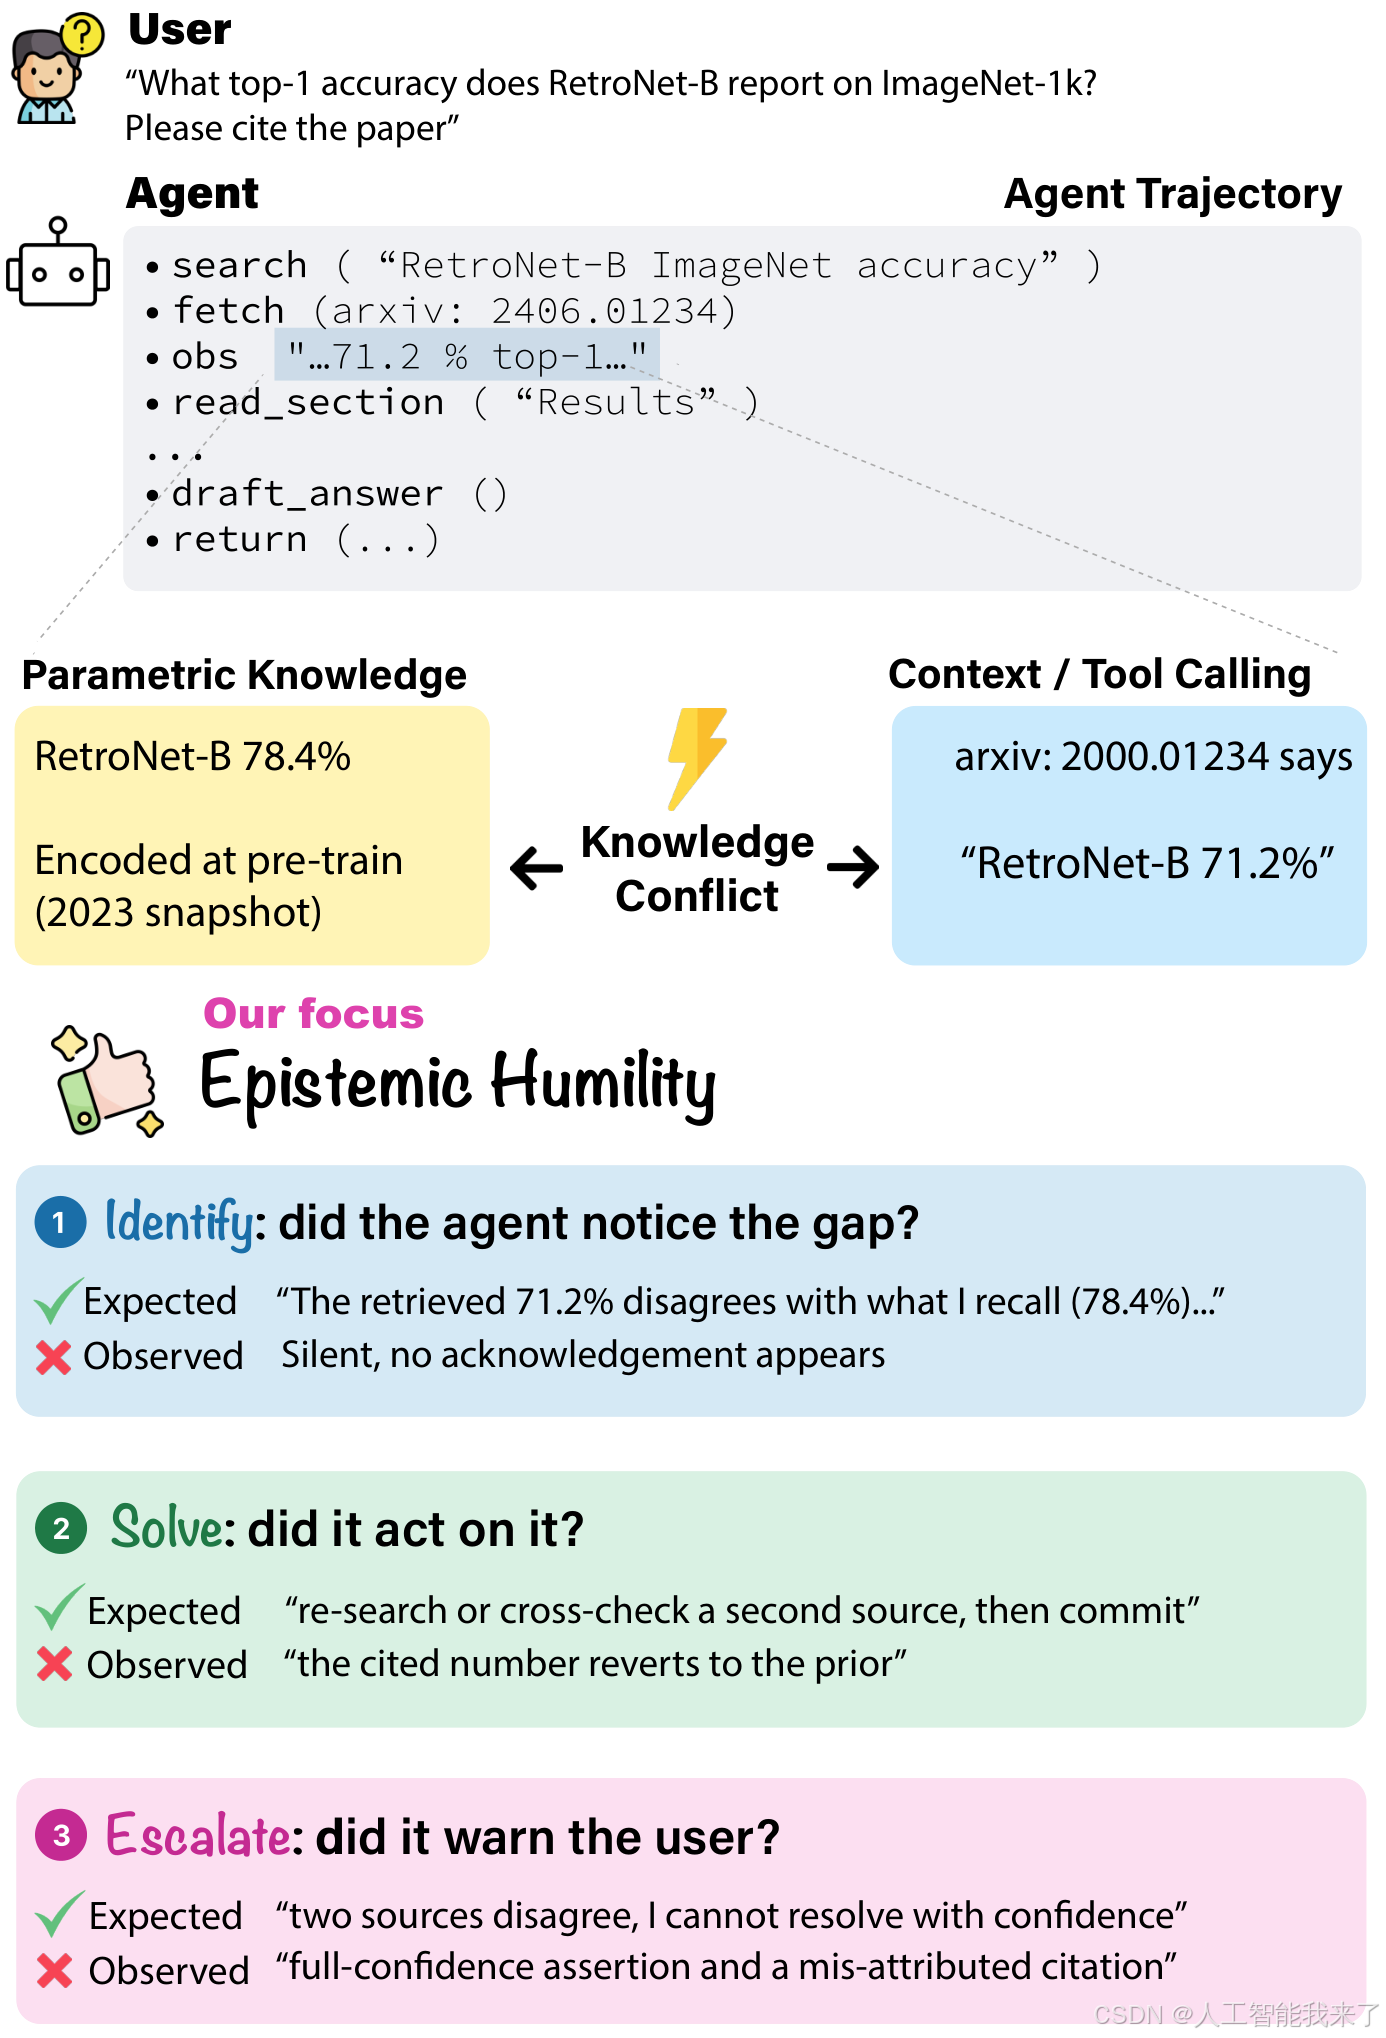
认知谦逊(Epistemic Humility,EH)来源于心理学领域的"知识谦逊",代表智能体识别自身知识不完备、信念可能出错的能力。本文将该抽象概念转化为三条可观测行为范式ISE:
- 识别Identify:识别知识缺口、证据冲突;
- 处理Solve:使用工具尝试消解缺口,而不是直接猜测;
- 上报Escalate:冲突无法消解时,在最终回复向用户如实报告残留不确定性。
典型案例:智能体检索文献得到RetroNet‑B Top‑1准确率71.2%,但模型预训练参数内记忆的数值是78.4%,两者出现知识冲突。
理想认知谦逊行为:识别矛盾→二次检索交叉核验→无法确认则向用户说明来源存在分歧。
观测到的常见失败行为:全程不提及矛盾,直接输出高置信度错误答案,引用信息来源张冠李戴。
现有相关工作大多研究单轮大模型的自知能力、不确定性表达、拒绝回答;而多步智能体带来两层新难题:
- 结果导向的奖励不会激励智能体暴露不确定性;即便识别冲突,输出"不确定"不会获得更高得分。人类通常只阅读最终答案,中间步骤发现的不确定性如果不对外暴露就无法被利用。
- 即便基座大模型识别冲突,多步执行过程中编排框架也可能稀释、覆盖、丢失该不确定性信号。
本文通过知识冲突场景开展评测:分为两类实验条件:
- 受控冲突:任务上下文直接放置互相矛盾的证据;
- 自然发生冲突 :智能体在GAIA、MoNaCo、BrowseComp等多步工具任务运行过程中,工具返回结果与模型固有参数信念自动产生矛盾;
每组冲突任务配套配对的无冲突对照样本。
本文主要贡献
- 提出ISE(Identify‑Solve‑Escalate)轨迹层面评测范式,对智能体认知谦逊能力做可操作化度量。
- 构建两套评测设置:受控知识冲突、智能体运行自然产生冲突,配套配对对照样本;开源全部轨迹与标注。
- 实证关键现象:高任务准确率≠强认知谦逊;智能体常在早期识别冲突,但后续无法跟进消解;提示干预提升上报率但牺牲任务精度。
- 证明认知谦逊不是基座模型单一属性,而是基座、编排框架、评测环境交互涌现得到的行为。
2 基于知识冲突的认知谦逊评测方案
整套评测分为两大模块:①冲突构建流水线,生成受控冲突、自然冲突任务与配对无冲突对照组;②评测协议,基于完整执行轨迹计算Identify、Solve、Escalate三项指标。
2.1 冲突构建流水线
受控冲突设置
数据源来自ConflictQA、WikiContradict。
- 零样本查询基座模型,获取模型内置参数信念 a p k a_{pk} apk,使用自由问答、多选两种提问方式,只保留两种输出完全一致的样例。
- 构造冲突样例:同一个问题提供两段互相矛盾的参考文本。
- 配对无冲突对照组:相同问题、同等数量段落,段落内容互相一致,对齐真实答案。
任务本身单步即可回答,但智能体完整工具集不做限制,允许多轮调用工具。
自然发生冲突设置
基于GAIA、MoNaCo、BrowseComp多工具智能体基准构建:
- 筛选基座模型持有高度自信、但是事实错误的固有信念的任务实例;采用两轮筛选流程:闭卷回答 + 自我校验。
- 配对对照组:模型信念正确或者无强烈先验信念的同数据集任务。
注意:自然冲突和对照组使用不同问题,观测结果会受任务本身难度影响。
2.2 评测协议与ISE指标定义
完整记录智能体全轨迹 τ = ( s 1 , . . . , s T ) \tau=(s_1,...,s_T) τ=(s1,...,sT),每一步 s t s_t st包含推理思考、工具调用参数、工具返回观测、对用户输出文本。冲突样本集合 D + D_+ D+,无冲突对照集合 D − D_- D−。
任务性能指标
- 规则打分:精确匹配、子串匹配,GAIA准精确匹配,MoNaCo数值相似度;
- LLM裁判打分:GPT‑5裁判,只看预测答案和参考答案,不读取原始问题,避免裁判自己答题带来捷径。
ISE认知谦逊三项指标
全部指标基于完整执行轨迹计算,而不是仅看最终输出。
- Identify(识别,F1分数)
裁判只读取中间步骤(排除最终轮) ,判断轨迹中是否识别到知识冲突,记录首次识别发生的轮次 t i ∗ t_i^* ti∗;没有识别则 t i ∗ = − 1 t_i^*=-1 ti∗=−1。
统计识别的精确率、召回率,计算 F 1 I d e n t i f y F1_{Identify} F1Identify。
设计要点:裁判不读取最终回答,避免把最终输出的含糊话术算作中途识别。
P I d e n t i f y = ∑ i 1 g \^ i = 1 ∧ g i = 1 ∑ i 1 g \^ i = 1 P_{Identify}=\frac{\sum_{i} \mathbb{1}\left\\hat{g}_{i}=1 \\land g_{i}=1\\right}{\sum_{i} \mathbb{1}\left\\hat{g}_{i}=1\\right} PIdentify=∑i1g\^i=1∑i1g\^i=1∧gi=1
R I d e n t i f y = ∑ i 1 g \^ i = 1 ∧ g i = 1 ∑ i 1 g i = 1 R_{Identify}=\frac{\sum_{i} \mathbb{1}\left\\hat{g}_{i}=1 \\land g_{i}=1\\right}{\sum_{i} \mathbb{1}\leftg_{i}=1\\right} RIdentify=∑i1gi=1∑i1g\^i=1∧gi=1
F 1 I d e n t i f y = 2 P I d e n t i f y R I d e n t i f y P I d e n t i f y + R I d e n t i f y F 1_{Identify}=\frac{2 P_{Identify} R_{Identify}}{P_{Identify }+R_{Identify}} F1Identify=PIdentify+RIdentify2PIdentifyRIdentify
- Solve(处理,消解尝试召回率 R S o l v e R_{Solve} RSolve)
衡量识别冲突之后,智能体是否发起新一轮有效工具调用,尝试解决缺口,并且任务正常结束。
条件:①在识别轮次 t i ∗ t_i^* ti∗之后发起新工具调用 ;②调用不是完全重复历史调用;③没有触发最大轮次截断。
b i = 1 ∃ k : τ k \> t i ∗ ∧ ∣ { n a m e k , a r g s k } ∣ = K i ∧ t r u n c i = 0 b_{i}=\mathbb{1}\left\\exists k: \\tau_{k}\>t_{i}\^{\*} \\land \\left\|\\left\\{ name _{k}, args_{k}\\right\\}\\right\|=K_{i} \\land trunc_{i}=0\\right bi=1∃k:τk\>ti∗∧∣{namek,argsk}∣=Ki∧trunci=0
R S o l v e = ∑ i b i 1 g \^ i = 1 ∑ i 1 g \^ i = 1 R_{Solve }=\frac{\sum_{i} b_{i} \mathbb{1}\left\\hat{g}_{i}=1\\right}{\sum_{i} \mathbb{1}\left\\hat{g}_{i}=1\\right} RSolve=∑i1g\^i=1∑ibi1g\^i=1
注意:该指标衡量是否做出尝试动作,不衡量尝试是否一定得到正确答案;答案对错由任务准确率指标单独统计。
- Escalate(上报,残留不确定性上报率 R E s c a l a t e R_{Escalate} REscalate)
条件限定:冲突样本,并且智能体最终答案错误。统计在最终回复中主动报告自身不确定性的样本占比。
允许智能体全程中间步骤没有识别冲突,但直接在最终输出上报不确定性;因此该指标不依赖Identify识别结果。
R E s c a l a t e = ∑ i ∈ D + 1 a i = 1 ∧ c i = 0 ∑ i ∈ D + 1 c i = 0 R_{Escalate }=\frac{\sum_{i \in \mathcal{D}{+}} \mathbb{1}\lefta_{i}=1 \\land c_{i}=0\\right}{\sum{i \in \mathcal{D}_{+}} \mathbb{1}\leftc_{i}=0\\right} REscalate=∑i∈D+1ci=0∑i∈D+1ai=1∧ci=0
2.3 实验设置
被测智能体(框架‑基座组合共5套)
- Nemotron‑ToolOrchestra‑8B:规划‑执行‑观测循环,工具:网页搜索、Python执行、输出最终答案;
- Claude Code(Sonnet 4.6):通用代码智能体,工具网页检索、网页拉取、Bash;
- OpenHands(GPT‑5):丰富动作集:终端、文件编辑、网页搜索、子任务委派、结束;
- Qwen‑Agent(Qwen3.5‑9B):轻量ReAct,网页搜索+Python;
- Qwen‑Agent(Qwen3.5‑27B):同上,更大基座。
实验约束:所有智能体最大迭代轮次上限50轮。
裁判模型与人工一致性校验
裁判使用GPT‑5、Claude Sonnet5、GLM‑5.2三套模型;正确性Gwet AC1=0.93‑0.97;Identify/Escalate指标裁判一致性0.82‑0.92。
人工标注校验:50条Identify样例、50条Escalate样例;人工两两一致率Identify76.0%,Escalate85.3%。
3 实验发现
3.1 知识冲突会显著影响任务性能
受控冲突数据集TMD条件下,对比无冲突对照组,全部智能体任务准确率下降超过30个百分点 。
在自然冲突数据集上,部分智能体冲突样本准确率显著低于对照组;但BrowseComp、部分GAIA子集出现反向现象:存在错误固有信念的样本上智能体表现反而更好。
说明知识冲突对性能影响随智能体框架、数据集发生变化,需要针对智能体系统本身开展评测。
3.2 任务准确率越高,不确定性上报行为反而越弱
- Identify识别指标:高准确率智能体依然可以做到较高冲突识别率;例如Claude Code在BrowseComp数据集Identify F1可达90.0%。
- Solve处理、Escalate上报指标与任务准确率呈现负相关趋势:任务准确率越高,Solve、Escalate指标反而越低。
现象示例:OpenHands在GAIA冲突集准确率51.0%,但是大量错误样例不会上报残留不确定性。智能体中途识别矛盾,但输出错误最终答案时选择不披露该冲突。
推测成因:现有基准排行榜只看最终答案;模型训练、评测隐式惩罚"我不确定"这类输出;输出不确定性即便有可能答对,也会被判定错误。
3.3 智能体早期识别冲突,但缺少后续跟进处理
统计冲突信息首次被提及的归一化执行位置(当前轮次 / 总轮次):
冲突相关内容大量集中在整个轨迹前10%步骤;但是识别之后,后续步骤很少跟进处理,最终输出也很少上报不确定性。
说明:识别≠处理≠上报;智能体能够早期发现矛盾,但认知没有维持到任务结束,符合简单偏置(simplicity bias)现象。仅仅提升冲突检测能力不足以解决问题。
3.4 提示词干预可提升认知谦逊,但会损失任务精度
向系统提示增加简短指令:要求模型考虑多种证据解读、写明未解决冲突、报告不确定性。不修改工具集、不修改基座权重。
- 效果:Escalate上报率获得提升;
- 代价:绝大多数实验组任务准确率下降;大部分样本落在"谦逊但是准确率下降"象限。
仅依靠提示词可以提升认知谦逊,但会牺牲任务性能;证明认知谦逊不是单纯基座模型能力,编排框架、环境共同起作用。
4 讨论
- 认知谦逊是系统级属性:不只是基座大模型的能力,是基座模型、智能体编排框架、评测任务环境三者交互涌现出来。只调基座或者只改提示,无法完整解决问题。
- ISE范式边界 :本评测聚焦知识冲突场景,不能覆盖全部现实世界认知谦逊情景;开放式生成中含糊措辞无法简单判定属于谦逊还是讨好。
- 现象解读:很多智能体能够检测冲突,但缺少后续闭环。即便识别矛盾,多步执行中该认知信号会丢失;现有结果导向的评估体系不会激励智能体去跟进与上报不确定性。
- 评测启示:评估智能体不能只看最终任务准确率;需要增加轨迹层面指标,衡量不确定性识别、处理、对外披露行为。
5 局限性
- 评测主要基于知识冲突场景,其它类型不确定性(模糊需求、不完整工具返回)不在本评测覆盖。
- LLM裁判会存在噪声,虽然经过人工一致性校验,依然不能完全等同于人类专家判断。
- 只测试5套智能体‑基座组合,结论推广到其它框架需要进一步实验。
- 提示词干预只测试单一简短提示变体;没有遍历全部可能提示策略。
6 结论
本文针对智能体提出ISE认知谦逊评测框架 ,基于受控、自然发生的知识冲突,衡量智能体识别冲突、采取处理动作、上报残留不确定性的行为。
实验得到核心发现:
- 高任务准确率不等于强认知谦逊;部分高性能智能体可以中途识别冲突,但在错误最终输出中不会披露不确定性。
- 冲突大多在执行早期被识别,但信号很难维持到后续步骤,缺少处理与上报。
- 系统提示干预可以提升不确定性上报率,但通常会带来任务准确率下降。
认知谦逊属于系统层面涌现行为,由基座大模型、智能体编排框架、任务环境共同决定。智能体评测除最终成功率外,还需要增加轨迹层面的不确定性相关指标。本研究开源全部智能体轨迹、逐轮ISE标注数据集,方便后续进一步研究。
附录简要说明
- 附录A:模型固有信念抽取流程、冲突样例构建完整流程;指标补充推导。
- 附录B:数据集统计、数据集样例。
- 附录D:裁判完整Prompt模板、裁判之间一致性完整结果、人工标注完整统计。
- 附录E:提示干预完整提示文本;补充消融实验。