一张人像照片,加上一段驱动视频,就能把视频里的转头、眨眼和表情迁移到照片中的人物身上。
最近,我们将 LivePortrait 人像与动物驱动、图片编辑、动作模板软件 整理成了一款 Windows 桌面工具。选择素材、调整参数、预览画面、生成视频,都可以在一个界面中完成。
算法与模型基础来自 LivePortrait 官方项目(github.com/KlingAIRese... C# / C++ 桌面软件适配、Vulkan GPU 推理,以及视频、编辑和模板功能的整合。
这次先把 人像精简版 分享给大家。它已经上传到 QQ 群共享文件中:
群名称:天天代码码天天
群号码:264292622
完整版因体积较大,暂时不提供下载。当前群文件提供的是人像精简版。
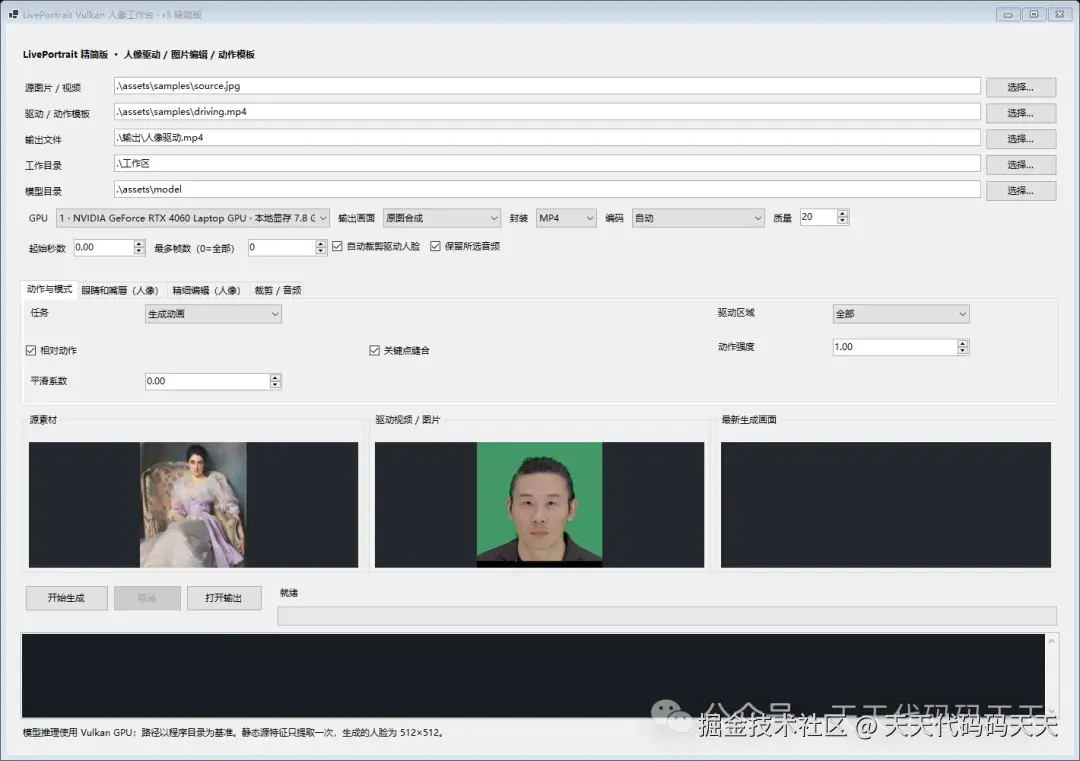
LivePortrait 人像精简版实际界面
软件的操作围绕"源素材"和"驱动素材"展开:源素材决定画面中的人物,驱动素材提供动作。你可以用一张图片作为源素材,也可以使用源视频;驱动则支持图片、视频和本软件导出的动作模板。
人像精简版保留了这些功能:
- **人像动画:**将驱动素材中的动作迁移到源人像,导出 MP4 或 MKV 视频。
- **区域控制:**选择全部、姿态、表情、眼睛或嘴唇区域,调整动作强度与平滑系数。
- **眼嘴控制:**选择跟随驱动或固定开合比例,也可以进行源嘴唇闭合归一化。
- **图片编辑:**调整俯仰、转头、倾斜、微笑、眨眼、眉毛、视线和面部缩放,导出 PNG。
- **图片驱动:**用一张驱动图片提供姿态和表情,生成静态人像结果。
- **动作模板:**把驱动视频的动作导出为
.lpmt,以后换一张源人像,就能复用这段动作。
下面是软件导出的图片编辑样例,可用于观察姿态、表情和眼睛开合的调整效果。
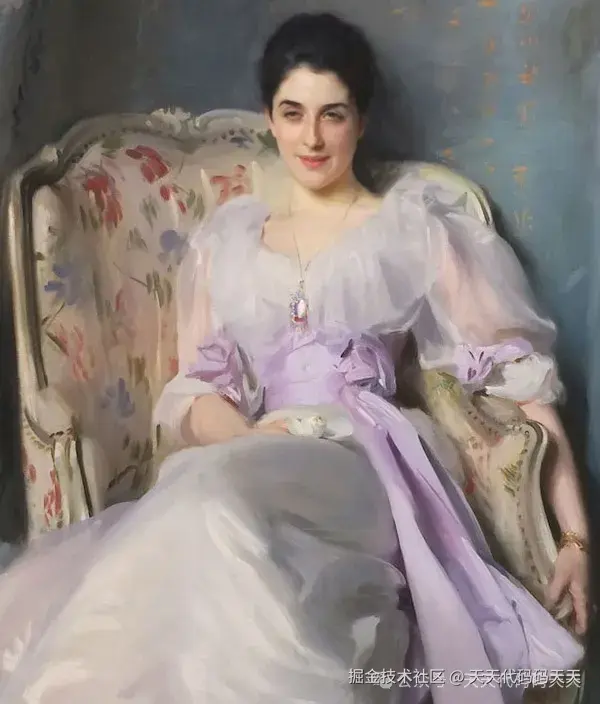
人像图片编辑样例
动作模板保存的是动作数据,回放时可以减少驱动侧的重复处理,生成画面仍需逐帧推理。.lpmt 是我们这款软件的模板格式,不能直接读取官方 Python 版本的 .pkl。
"精简"主要减少了部署体积,保留了完整的人像功能。
两版的功能区别,可以直接看下面这张表:
| 功能 / 项目 | 人像精简版 | 完整版 |
|---|---|---|
| 人像源图片 / 源视频驱动 | 支持 | 支持 |
驱动图片、视频和 .lpmt 模板 |
支持 | 支持 |
| 人像区域、强度与平滑控制 | 支持 | 支持 |
| 人像眼嘴控制、关键点缝合 | 支持 | 支持 |
| 人像姿态与表情精细编辑 | 支持 | 支持 |
| 动作模板导出与回放 | 支持 | 支持 |
| MP4 / MKV / PNG、音频选择 | 支持 | 支持 |
| Vulkan FP32 人像推理 | 相同模型与代码 | 相同模型与代码 |
| 动物 v1.1 图片驱动 | 不提供 | 支持 |
| X-Pose 动物脸自动定位与裁剪 | 不提供 | 支持 |
| 使用预裁剪的动物头部素材 | 不提供 | 支持 |
| 模型数量 | 9 个 | 13 个 |
| 自带运行时,解压即可使用 | 支持 | 支持 |
| 压缩包体积 | 约 756 MiB | 约 1.44 GiB |
| 本次对外分享 | 已上传 QQ 群文件 | 体积较大,暂不提供 |
人像精简版 适合主要做人物动画、表情编辑和动作复用的朋友。它保留 9 个人像模型,移除了动物模型和 X-Pose,压缩包约 756 MiB ,比完整版缩小约 49% 。
两版使用相同的人像权重和推理代码。精简版没有降低人像模型精度,也没有新增水印或帧数上限。动物驱动和动物脸自动定位留在完整版中,本次分享的精简版界面不提供这些入口。
完整版在全部人像功能之外,增加了动物 v1.1 模型和 X-Pose 动物脸自动定位。可以选择猫、狗的静态源图片,配合人像驱动素材生成动物动画;自动定位负责寻找动物脸并准备裁剪,关闭自动定位时也可以使用提前裁好的动物头部素材。
完整版的动物模式目前使用静态源图片 ;眼嘴控制网络和精细编辑用于人像模式。完整版包含 13 个模型,压缩包约 1.44 GiB ,由于体积较大,本次暂不提供完整版下载。
下载后,可以按下面的步骤完成第一次生成:
- **完整解压。**把 ZIP 解压到可写目录,例如
D:\LivePortrait,不要在压缩软件里直接运行。 - **启动软件。**双击
启动软件.cmd。包内已经放好了模型和运行时。 - **先跑默认样例。**软件默认选择了源人像和驱动视频,点击"开始生成",先确认环境与输出正常。
- **换成自己的素材。**选择源图片或源视频,再选择驱动图片、视频或动作模板,调整输出格式与参数。
- **先测短片段。**首次可以将"最多帧数"设为 30;确认效果后设为 0,按素材长度生成完整视频。
完成后点击"打开输出"查看结果。默认输出在 app\输出,工作区在 app\工作区,相对路径统一以 exe 所在目录为基准。
视频支持选择驱动音频、源视频音频或无音频。NVIDIA 显卡在自动模式下使用 H.264 NVENC 编码;遇到编码问题,可以切换到软件 H.264 编码,模型仍由 Vulkan GPU 执行。
这次的部署重点,是把运行环境也一起准备好。
人像精简版内置 .NET 桌面运行时、模型、OpenCV、VC++ 运行库和 FFmpeg。使用者无需安装 Visual Studio、Python、CUDA Toolkit、cuDNN 或 Vulkan SDK,也无需另外安装 .NET 或联网下载模型。电脑需要有支持 Vulkan 的显卡及其厂商驱动。
推理和视频生成都在本机完成。工作区会保存任务设置、耗时指标、日志和模型缓存,方便后续查看与排查。
Vulkan 是面向图形与通用计算的底层 API,也能用于 GPU 上的模型计算。可以从 Khronos 官方学习资料(www.vulkan.org/learn) 了解它的图形和计算能力。
在我们的实现中,C# 负责界面与任务组织,C++ / Vulkan 后端负责模型计算,OpenCV 处理图像和关键点几何,FFmpeg 负责视频读写、编码与音频封装。运行时使用的是针对这组模型适配的 Vulkan 推理后端。
一次完整生成,大致经过四个阶段:
- **准备源人像。**检测人脸和关键点,完成裁剪,提取外观特征与源动作信息。
- **读取驱动动作。**从驱动图片、视频帧或模板中取得姿态、表情及眼嘴相关信息。
- **生成新画面。**结合区域、强度和编辑参数,通过 Vulkan 模型计算生成新的脸部画面,再合成到输出画面中。
- **输出文件。**通过 FFmpeg 编码视频、处理所选音频,或直接保存 PNG 图片。
对于静态源图片,外观特征只提取一次,后续帧复用;视频解码、生成和编码通过内存管道连接,避免先保存整段图片序列再重新读取。模型执行计划也会缓存,后续任务可以复用。
我们此前使用同一套 r3 人像引擎,在 RTX 4060 Laptop 8 GB 上做过一组 78 帧样例测试。Release x64、FP32 Vulkan、输出 600×704,记录如下:
| 项目 | 开发机样例记录 |
|---|---|
| 平均模型推理耗时 | 299.91 ms / 帧 |
| 整段任务耗时 | 34.36 秒 |
| 整卡显存采样峰值 | 约 2.72 GiB |
模型推理时间不包含图像合成与视频编码;整段耗时包含加载、源准备、生成和封装。显存数字包含系统和其他程序占用。这是同一人像引擎的历史样例记录,具体速度会随显卡、素材和控制选项变化。
这次精简部署包另外进行了重新解压验收,已通过界面启动、人像生成、眼嘴控制、图片编辑,以及动作模板导出和回放检查。
使用环境为 Windows 10 / 11 64 位。目前主要在 NVIDIA 开发机上验证,AMD / Intel 的实际兼容性和速度尚未验证。首次运行会生成计划和准备 GPU,加载时间会较长;请预留至少 3 GB 可用空间,长视频另留输出空间。
使用及分发请阅读包内的许可证和模型来源说明。人脸检测、关键点等模型的商业授权仍需确认,不能把整个软件包统一视作 MIT 商用授权。完整版中的 X-Pose 上游许可(github.com/IDEA-Resear...
人像精简版已上传 QQ 群共享文件,欢迎下载体验并交流使用反馈。
天天代码码天天|264292622
进入群文件,找到 LivePortrait 人像精简版,完整下载、解压后即可开始尝试。完整版因体积较大,暂不提供下载。