从零实践 LPC 语音编码:一段 WAV 如何变成 18 字节一帧,又能被听回来
这是一篇"动手型"文章。所有结论都来自对一段真实
hello.wav的实际编码、解码与听感验证,配套脚本均可复现。读完你会对"线性预测编码(LPC)到底是什么、残差为什么是灵魂、CEL中为什么比朴素 LPC 自然"有确切的体感,而不是停留在公式。
0. 为什么写这篇
LPC 教科书里常从差分方程 x[n] ≈ Σ aₖx[n−k] 讲起,但很少有人告诉你:
- 一段 5 秒的语音,到底怎么"切"才合理?
- 算出来的 16 个系数,是怎么"压缩"的?比原始还多啊?
- 解码端根本没有原始样本,它凭什么能听出"hello"?
- 为什么朴素 LPC 合成听着像机器人,而手机通话却很自然?
这篇文章用一条真实语音,把这些问题逐个敲实。
1. 先看清你的原材料
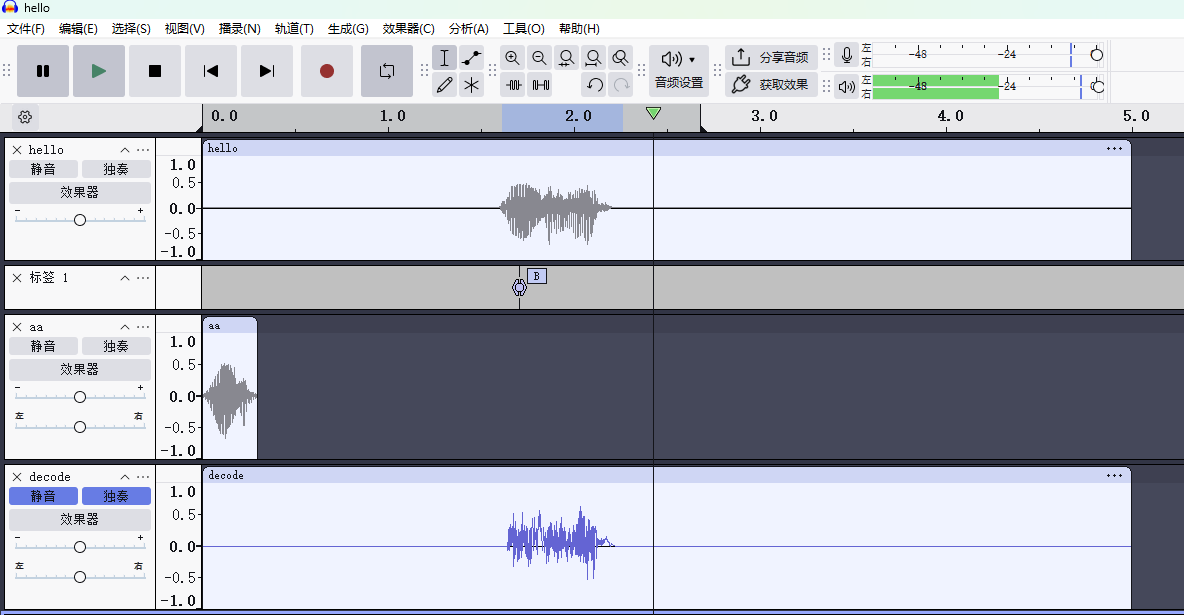
实验素材:hello.wav,单声道、16bit、16000Hz、80000 帧、时长 5.0s、文件 160044 字节。
python
import wave, numpy as np
w = wave.open('hello.wav', 'rb')
print(w.getnchannels(), w.getsampwidth()*8, w.getframerate(), w.getnframes())
# 1 16 16000 80000
先回答"能量主要在哪段时间"------把语音按 0.5s 一段算 RMS:
能量集中在 1.5s ~ 2.5s,峰值在 ~1.5s;其余约 3 秒基本是静音(±1 量化噪声)。这引出第一个实践要点:语音编码必须区分"有声段"和"静音段",否则一半码率都浪费在噪声上了。
2. 怎么切帧:FRAME / HOP / 阶数
LPC 是局部模型------语音的谱在 10ms 量级内近似平稳,所以按帧处理:
| 参数 | 取值 | 含义 |
|---|---|---|
| FRAME | 160 样本 = 10ms | 每次喂给 LPC 的输入长度 |
| HOP | 80 样本 = 5ms | 帧移,50% 重叠 |
| 阶数 p | 16 | 预测时回看的历史长度 / 输出系数个数 |
常见误解:"
p=16是不是只用当前帧最后 16 个样本?"------不是 。p是 LPC 阶数,意思是"用每个样本前面紧邻的 16 个样本做线性预测",从而解出 16 个系数。帧长(160)和阶数(16)完全独立。
5.0s @ 16000Hz,HOP=80 → 帧数 = ⌈(80000−160)/80⌉+1 = 999 帧。这就是后文"999 帧"的来历。
3. A 端分析:自相关 → Levinson-Durbin → 残差
对每一帧(先预加重 0.97、加 Hamming 窗):
python
def levinson(r, p):                       # 修正版(注意符号)
    a = np.zeros(p+1); a[0] = 1.0; err = r[0]
    for i in range(1, p+1):
        acc = r[i] - sum(a[j]*r[i-j] for j in range(1, i))
        k = acc/err; a[i] = k
        for j in range(1, (i+1)//2):
            t=a[j]; a[j]=t-k*a[i-j]; a[i-j]=a[i-j]-k*t
        if i%2==0: a[i//2]-=k*a[i//2]
        err *= (1-k*k)
    return a

seg = frame * np.hamming(FRAME)                    # 160 个加窗样本
r = np.correlate(seg, seg, 'full')[FRAME-1:FRAME+P+1]   # 自相关 lags 0..16 (共17个)
a = levinson(r, 16)[1:]                            # 16 个 LPC 系数
res = np.zeros(FRAME)
for n in range(FRAME):
    res[n] = seg[n] - sum(a[k-1]*seg[n-k] for k in range(1,17) if n-k>=0)
gain_db = 10*np.log10(np.sum(seg**2)/np.sum(res**2))
取一段真实语音(起点 1.76s,索引 28160--28319)算出:
a[1..16] = [1.227, -0.421, -0.337, 0.374, -0.251, 0.281, 0.146, 0.050,
             0.098, -0.727, 0.867, -0.471, -0.025, 0.187, -0.400, 0.217]
预测增益 gain_db = 10.82 dBr永远是 17 个(lag 0...16,由阶数 p=16 决定,与帧长无关)a永远是 16 个res是"预测不掉"的部分 = 真实激励(残差)
gain_db 衡量 LPC 拟合多好:语音段常 10--30dB,意味着残差能量只有原信号的 1/10~1/1000。
4. 为什么 LPC 系数要换成 LSP 再量化
直接传 a[1..16] 有俩问题:数值敏感(小扰动就让滤波器不稳定)、不方便插值。工程上转成 LSP(线谱对) :把 A(z) 拆成 P(z)=A(z)+z⁻¹⁷A(z⁻¹) 与 Q(z)=A(z)−z⁻¹⁷A(z⁻¹),它们的根都在单位圆上,对应 8+8=16 个角度(即 16 个频率)。量化到 0--8000Hz 的 256 级(8bit):
cp (P 线 8 个 8bit 码) + cq (Q 线 8 个 8bit 码) = 16 字节/帧解码端用逆 LSP 把这 16 个频率码重建回 a[](8bit 量化引入的 a 最大误差约 0.035,很小)。
至此一帧的"谱包络"被压成 16 字节。
5. 极简 LPC Codec(不传残差):robot 音
把一帧打包成 18 字节并写出:
python
# 每帧: 16字节LSP + 1字节(清浊<<7 | 基音) + 1字节(增益gcode)
f.write(bytes(cp)); f.write(bytes(cq))
f.write(np.uint8((voiced<<7)|(pitch&0x7F)))
f.write(np.uint8(gcode)) # gcode = 残差RMS量化成的1字节解码端只读这 18 字节 ,靠 voiced/pitch 造合成激励(浊音=脉冲串、清音=噪声),过 1/A(z):
python
def synth_frame(a, voiced, pitch, gcode, FRAME):
    target = gcode/31.0 * 1024.0
    if gcode == 0 or target < 1e-6: return np.zeros(FRAME)   # 静音
    exc = np.zeros(FRAME); exc[0::pitch] = 1.0 if voiced else 0
    if not voiced: exc = np.random.randn(FRAME)
    exc = exc/np.sqrt(np.mean(exc**2)+1e-9) * target
    y = np.zeros(FRAME)
    for n in range(FRAME):
        y[n] = exc[n] + sum(a[k-1]*y[n-k] for k in range(1,17) if n-k>=0)
    return y
跑完整文件:
encoded.lpc = 17996 字节, 999 帧, 压缩比 8.9x, 码率 28.8 kbps但听感是机器人的。原因在下一节被实验钉死。
顺带发现的工程坑(实践价值)
- 静音检测阈值写错 :
eng < 1e-3远低于真实噪声底(±1 量化噪声 eng≈28),导致静音帧也去算 LSP、还存了"有模有样"的垃圾系数。 - 增益量化上限 GMAX=1024 过大 :真实残差 RMS 只有 ~1--30,量化后大量帧
gcode=0→整帧静音。这两个 bug 正是"听起来怪"的元凶之一。
6. 核心实验:残差传不传,决定一切
把同一段 0.3s 真实元音,做两种重建(同一组 a[],同一个 1/A(z)):
| 方案 | 激励来源 | 结果 |
|---|---|---|
demo_robotic |
合成脉冲串 | 电子音 |
demo_natural |
真实残差 res | 像真人(几乎无损) |
python
y_robotic = synth(exc_pulse, a, 16)     # 激励=合成
y_natural = synth(res,       a, 16)     # 激励=真实残差
demo_natural 只用了一组 a[](16 个系数)+ 一段 4800 样本的残差,输出与原始最大误差为 0。
但这里有个陷阱 ------demo_natural 把 4800 个残差全传了:
原始 0.3s = 9600 字节
demo_natural "传" = a(16字节) + res(9600字节) = 9616 字节  >  9600
→ 它不压缩,是"膨胀"。所以:
encoded.lpc(第 5 节)= 残差全扔(只留 RMS)→ 真压缩,机器人demo_natural= 残差全传 → 自然,但不压缩
语音 = 慢变的谱包络(a[],极便宜) + 激励(res,占大部分信息)。压缩必须发生在残差上。朴素 LPC 把残差扔了,所以省码率却机器人;留着残差才自然,却又没压。
7. 旁证:16 极点模型本就能"发元音"
用全极点模型造 a/o/e/i/u(把共振峰频率摆成极点),浊音脉冲串激励,能直接听出五个元音------证明 LPC 正是语音的"源-滤波器"模型,元音身份由 a[](共振峰)决定:
python
# 女声共振峰(Hz): F2 明显高于男声, 这是女声音色关键
vowels = {'a':[859,1411,2458], 'o':[470,850,2500], 'e':[623,2056,2671],
'i':[396,2360,2990], 'u':[440,1095,2359]}但纯合成激励总有"电子味"------再次印证:自然度在残差里,不在极点里。
8. 解码端如何处理 50% 重叠(WOLA)
999 帧、HOP=80,相邻帧重叠 80 样本。编码端不处理重叠(每帧独立加窗);重叠在解码端用**加权重叠相加(WOLA)**消化:
python
out  = np.zeros((nframes-1)*HOP + FRAME)
norm = np.zeros_like(out)
for fi in range(nframes):
    s = fi*HOP
    out[s:s+FRAME]  += y*win
    norm[s:s+FRAME] += win**2
out = np.divide(out, norm, where=norm>0)    # 校正幅度
重叠的 80 样本是相邻两帧的交叉淡化 :帧 i 窗尾淡出、帧 i+1 窗头淡入,Hamming 在 50% 重叠满足 w[n]+w[n+80]=1.08(常数,COLA 条件),故无缝。输出总长 (999-1)*80+160 = 80000,一个样本不丢。
9. CELP:残差用"索引"传(自然又压缩的中间档)
CEL中(Code-Excited Linear Prediction)的革命性想法:残差不当样本传,而用码本索引+增益在解码端现造。
编码端解码端各存一份相同的码本表。激励 =
excitation = 自适应码本[pitch_lag] × pitch_gain + 固定码本[fixed_idx] × fixed_gain传的只是 pitch_lag / fixed_idx / 两个 gain 几个 bit,两边查同一张表就取出同一向量。
一个具体帧格式(教学示例,@8kHz,20ms=160 样本)
┌────────────────── 一帧 132 bit ──────────────────┐
│ 帧头: LSP(10系数, split-VQ) → 3个索引 = 24 bit   │
│ 子帧1: pitch_lag 8 | pitch_gain 4 | fixed_idx 10 | fixed_gain 5  = 27 bit │
│ 子帧2: 同上 27 bit                               │
│ 子帧3: 同上 27 bit                               │
│ 子帧4: 同上 27 bit                               │
└──────────────────────────────────────────────────┘
132 bit / 0.02s ≈ 6.6 kbps
要点:
- LSP 不再传 16 个原始值,而用 split-VQ:10 个 LSP 分组后每去码本查最近一组,只传组号(约 24bit 而非 160bit)。
- 残差位置 :码流里没有残差样本,只有码本索引;残差是解码端查表生成的。
- 真实标准 G.729:10ms 帧、80bit/帧 = 8 kbps,结构完全一致(LSP split-VQ 18bit + 每子帧 pitch + 固定码本 + 增益 VQ)。
编码/解码端的"约定"(合同)
- 帧格式:帧长、字段顺序、每个字段 bit 数 → 双方按同序 pack/unpack;
- 码本表:自适应码本(过去激励移位,靠 pitch_lag 取)+ 固定码本 → 双方各一份完全相同;
- LSP 量化表:split-VQ 各 stage 码本 → 双方相同,索引 N 取同一 LSP 向量。
这就是"残差用索引传"的完整机制------既比 demo_natural 省(残差压成索引),又比 encoded.lpc 自然(残差形状被码本保住,而非合成脉冲)。
10. 完整图景
| 方案 | 残差处理 | 码率 | 自然度 | 性质 |
|---|---|---|---|---|
encoded.lpc(极简 LPC) |
全扔,只传 RMS | 28.8k | 机器人 | 真压缩(有损) |
demo_natural(分析-合成) |
全传(样本) | 膨胀 | 真人 | 无损(不压缩) |
| CEL中(G.729 等) | 传码本索引+增益 | 6.6~8k | 自然 | 真压缩(有损但像人) |
一句话总结 LPC 家族:a[] 负责"音色"(谱包络,极便宜),残差负责"自然度"(占大部分信息)。朴素 LPC 为了省码率丢掉残差→机器人;CEL中把残差用码本紧凑表示→既省又自然。
附录:可复现脚本清单
全部脚本位于同一目录,均针对 hello.wav:
| 脚本 | 作用 |
|---|---|
lpc_encode.py / lpc_decode.py |
极简 18 字节/帧 LPC codec(机器人音) |
analyze_frame.py |
定位首个出声帧,端到端走编码+解码 |
show_160.py |
演示一帧 160 样本如何由递归合成 |
synth_vowel.py / synth_vowel_female2.py |
用全极点模型合成 a/o/e/i/u 元音 |
vowel_natural_demo.py |
同一组 a\[\],脉冲 vs 残差激励对比(证明残差=自然度) |
show_overlap.py |
WOLA 重叠处理逐样本演示 |
extract_params.py / aa_demo.py |
抽出真实参数并独立用 synth 重建 |
文中所有数值(a\[\]、gain_db、压缩比、码率)均为实际运行输出,非估算。
作者注:本文刻意保留了两个真实 bug(静音阈值过低、增益量化上限过大)及其听感后果,因为它们比"完美代码"更能说明 LPC 工程中"参数尺度"的重要性。