1.binlog(service 层)
service层日志,所有引擎都用;
逻辑日志,用于主从复制,数据恢复
2.Undo Log (InnoDB)
undo 记录的是修改前的数据
应用事务回滚
MVCC :读旧版本数据,实现一致性读
举个例子:
sql
UPDATE user SET age = 30 WHERE id = 1;
-- 原值是 age = 20
undo 会记录
sql
id=1, age=20如果事务回滚,就用这个恢复
3.Redo Log(InnoDB)
redo 记录的是:物理修改
ruby
表空间 + 页号 + 偏移量 + 改了什么用于崩溃恢复;
保证事务的持久性
工作流程:
1.事务提交
2.先写redo log(prepare)
3.再写 binlog
4.redo log 提交(commit)
今典的2阶段提交
场景设定
sql
UPDATE account SET balance = 200 WHERE id = 1;
-- 原值 balance = 100
一、执行阶段(Binlog 什么时候生成?)
1️⃣ 事务开始
分配事务 ID
分配 undo log(记录 balance=100)
2️⃣ 执行 UPDATE
修改 Buffer Pool 中的数据页
写 Redo log(prepare)
写 Undo log
📌 注意:
Binlog 此时还没写
3️⃣ 事务提交(关键节点)
Step 1:Binlog 写入(Binlog Cache → OS Cache)
每个事务有 binlog cache
提交时:
从 cache 写入 OS cache
不保证立刻 fsync
Step 2:Redo log 刷盘(prepare → commit)
顺序如下:
sql
1. Redo log prepare
2. Binlog write
3. Redo log commit
二、Binlog 落盘策略
由参数控制:
sql
sync_binlog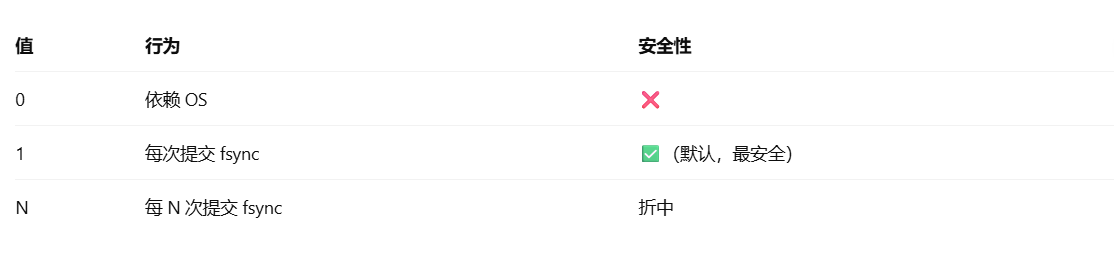
三 、主从复制流程(Binlog 的核心用途)
1️⃣ Master
写 Binlog
dump 线程读取 Binlog
2️⃣ Slave
IO 线程:
拉取 Binlog
写入 relay log
SQL 线程:
重放 relay log
写自己的 Binlog(可选)
Undo Log 为什么会"空间增大"?
1️⃣ Undo Log 不是用完就删
Undo Log 的清理依赖两个条件 同时满足:
✅ 事务提交
✅ 没有更早的事务还需要它(MVCC 读)
📌 也就是说:
sql
只要还有一个"老事务"在跑
→ 它之前版本的数据就不能删
2️⃣ 长事务 / 高并发写 = Undo 膨胀(经典场景)
比如:
一个大查询跑了 10 分钟
这期间表被疯狂 UPDATE
所有 旧版本行 都必须保留
结果:
sql
Undo Log 暴涨
→ 回滚段(rollback segment)膨胀
三、Undo Log 怎么"间接导致页分裂"?
sql
Undo Log 膨胀
  ↓
旧版本行不能清理
  ↓
Purge 线程追不上
  ↓
新版本行写入聚簇索引
  ↓
页满 → 页分裂
详细解释
1️⃣ InnoDB 行里藏着"隐藏字段"
每一行都有:
DB_TRX_ID
DB_ROLL_PTR ← 指向 Undo Log 中的旧版本
2️⃣ UPDATE ≠ 原地改(很重要)
InnoDB 实际是:
标记旧行为删除
插入新行
旧行通过 roll_pointer 链起来
📌 所以:
一次 UPDATE = 一次"逻辑删除 + 插入"
3️⃣ 页满 → 页分裂(B+Tree)
当新行插不进去:
B+Tree 页分裂
页利用率下降
索引"变胖"
⚠️ 二级索引也可能分裂
(因为二级索引里也有 DB_TRX_ID)
Redo Log 为什么没有这种问题
因为redo log 是循环写入的,它的大小是固定的,不会增加
只有对应的脏页已经被刷到磁盘数据文件后,那部分 redo 才能被覆盖
如果脏页一直没刷盘(比如写入太快、刷盘太慢),redo 写到了尾部但 checkpoint 追不上------
纯文本
=写指针=\] ←→ \[=checkpoint=
↑ 追上了,写不动了
这时候 MySQL 会强制卡住写入,等 checkpoint 推进。