一、Java程序设计概述
Java的11个关键术语
简单性、面向对象、分布式、健壮性、安全性、体系结构中立、可移植性、解释型、高性能、多线程、动态性。
二、Java程序设计环境
安装下载JDK,设置环境变量。
1.术语
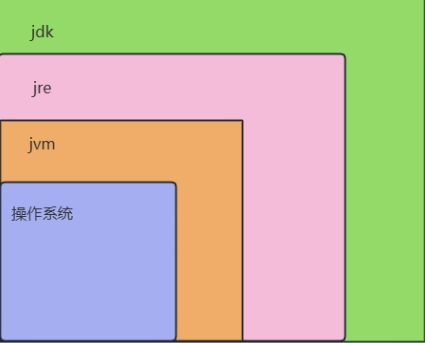
·JDK:编写Java程序的程序员使用的软件,.java->.class
·JRE:运行程序的用户使用的软件,Java运行时环境
·EE:复杂应用(web开发)
·SE:用于桌面或简单的服务器应用的Java平台(核心语法)
·ME:用于手机和小型设备的Java平台(app开发)
·SDK:样例代码,功能如何使用要写一个例子
2.对jdk内容的解释
Bin目录:放各种可执行文件
Db目录:数据库
Include目录:开发时引入的资源
Lib目录:类库资源
Src目录:放jdk的一些核心代码
Jre:
·bib目录:第二次翻译的可执行文件,jvm(Java虚拟机)
·lib 目录:类库
因为Java自带JVM,所以操作系统只提供调度和运算,可以实现跨平台,可移植性好。
三、Java基本程序设计结构
1.命名规则
我们对Java类的命名通常为小驼峰的形式,对Java变量名、方法名则使用小驼峰,对常量使用全大写。
2.注释说明
(1)单行
java
//单行注释(2)多行
java
/* 多行注释*/
java
/**
*文档注释
*代码作者
*最后一次维护
*联系邮箱
*作用
*/
3. 代码块
java
{
任意开头和结尾
}
4. 数据类型
不同的数据类型决定了数据在计算机内部存储的形式。
Java是强类型语言,声明变量必须要声明类型。
(1)Java的数据类型
分为基本类型 和引用类型。
==基本类型==
1字节=1B=8bit 1024B=1KB 1024KB=1MB ...
整形
·byte (1字节 2^8)
·short(2字节 2^16)
·int(4字节 2^32)
·long(8字节 2^64)long数据比较大的时候后应该加一个L,比如1L。
·浮点型
·float 后边加f
·double
·字符型 char
·布尔型 boolean
浮点型
Float
32bit 可以组合出232种结果
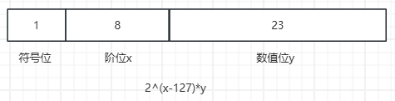
越靠近0的地方越密集,表示得越精确。
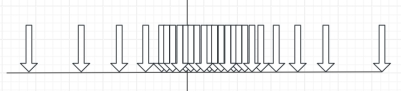
像是2^128*2^23之后只能表示突变之后的2^128*2^22,它们之间的数一概不能表示。
Int和float谁的精度更高?
表示像0.125只能用float来做到,int不可以,但是数字变大之后比如2^31-2,能用int准确表示,float做不到。所以在数据靠近0或者数据比较小的时候,float的精度会更高一些,反之int精度更高一些。
Double
64bit 有264种结果
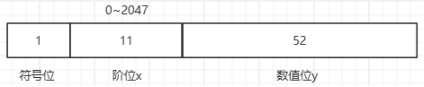
Boolean
32bit
为什么用0/1 表示就能完成的事情要延展到32位?
CPU先从各个缓存拿数据,拿不到再去内存里拿。想去缓存行里读写也是需要一根导线(传递电压信号)的,电压信号同一时刻只能传输一个,低或高,意味着我只能读取其中一个数据,想要去读很多个数据,未取的数据就需要排队等待。
这就意味着缓存行数据越多,数据越有可能等待,拿数据的效率越低,相反效率越高。
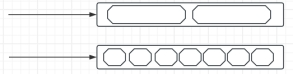
我想拿boolean类型结果越快越好,所以一个数据设置的很大把内存行占上,数量少,拿的快。至于为什么不用64bit是因为占的特别大,把缓存占满了。
Char
字符本身是一种图形,所有我们看到的图形等视觉信息都是由颜色和亮度组成的,像素点的不同呈现使得我们能看见不同图形。
例如我们的分辨率1920x1080,说明我们电脑屏幕是由1920x1080个像素点来渲染的,控制不同像素点的颜色(三原色0~255)、亮度(0~255)。
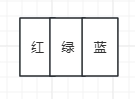
8bit+8bit+8bit=24bit,一个像素点需要用24bit来存储它的状态。
除了视觉的信息,我们还需要渲染像素点的位置信息,拿到其在电脑屏幕的xy(16bitx16bit,用short存储)轴的位置。
所以存储一个像素点至少要存储24bit+16bit+16bit=56bit
为什么说至少?比如 ,这一个a字符不能够只去渲染单单黑色的区域,而是要渲染整个选中字符的区域。

写文章的时候那占的位置岂不是很大?
其实在系统里已经设置好了,给对应图形编号(编码,一种映射关系),写好文章之后最终存储的并不是一个个字符,而是字符对应的一个个编号,通过编号拿到字符,呈现到显示器上。
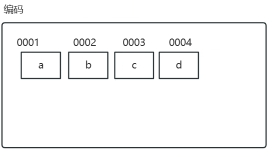
如上图,存储'abc'字符实际存储的是000100020003
乱码的出现
在编码和解码的时候用的不是同一套编码规则,也就形成了乱码。
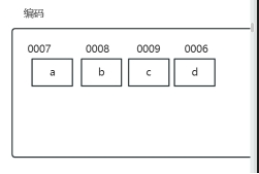
比如上边存储的000100020003实际存储的是abc,通过下边这种编码规则可能翻译成sdf等其他的字符。
关于记事本
像是记事本里,文件底层存储的仍是编码,打开记事本想看内容,就读取编码,解析出来呈现就是预期字符了。
WPS:
相比与记事本,WPS更花里胡哨,意思就是说它可以渲染的地方更多,它还有自己的字体库等其他帮助渲染的数据,还会通过一些算法对图形进行放大、压缩、加粗等操作,底层依然是编码的形式来存储图形,但是占用的空间会更大。
==引用类型==
·类
·接口
·数组
5.变量
变量
变量类型 变量名字;
Java大小写敏感,所以要做区分,变量名长度几乎不限制。
声明:创建变量
初始化:赋值
全局变量:类下边,方法外声明的变量。
局部变量:方法内部的量,只在方法内部有效,必须要赋值。
常量
被final修饰的变量,赋值之后值不能再改变,所以很少修饰局部变量。
全局常量必须赋值,不然第一次默认赋值为0也看做为一次赋值
final static int NUM=0;
Final关键字的作用
·final修饰的基本类型不可二次赋值;
·final修饰的引用类型地址不能改变指向;
·final修饰的方法不能被重写;
·final修饰的类不能被继承;
·final可以防止指令重排序,遏制指令流水线优化,保障多线程场景下的可见性
·final一般和static一起使用
6.运算符
+、-、*、/
5/0 报错by/zero
5.0/0 则输出Infinity表示无穷大
数学函数(高等数学一般用python,python封装的数学函数更多)
例如Math.sqrt(4)计算4的平方根,利用Math.pow(4,2)计算4的平方。
开根号具体是如何实现的?
比如21.00 00 00 00 00......,我们需要寻找一个x使得x2小于21,令x=4,21-16=5。
现在要计算4.x的x是多少,带入(4*20+x)*x使得结果小于500,取得最大的x,
令x=5,结果为425,500-425=75,4.5x再带入式子使得结果小于7500,取得最大的x,x=8,4.58x.......
四、关于数据在内存中存储的一系列问题
为什么存数据没有1bit 1bit地去存,而是最少8bit?
在内存中存1bit数据的实际上是电容器,在磁盘上实际上是以小磁颗粒的形式存储的。
其实我们存的数据不仅仅是数据本身,还包含了它的地址值信息。10bit占地址1bit作信息。
但是我们以字节的形式存,同样1024个字节,每个数据占8bit,只需要128个小组件来存,即27 ,7个组件来存。
以1bit在电容器中存,需要通过一个导线存到电容器中,断电后电容器放电,数据丢失。实际上设计8个电容器一组,一根导线统一供电。
short f =20;int b=10;long c=100000000000L;float d=10.0f;double e=20.6;计算机常见的进制
实际上计算的执行在计算机底层上是以二进制的形式进行的
·0b 二进制 (Bin)
·0 八进制 (Oct)
·0x 十六进制(Hex)
因为反码存在正0和负0的关系,所以计算真正用的是补码,补码直接出结果,转成原码只是为的给我们看。
正数的原码、反码和补码值一样。
负数的反码是不动符号位原码取反,+1之后变为补码超范围运算
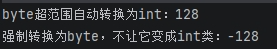
我们知道byte类型的数据范围是-128~127,在byte127的时候+1会变为128,这是因为byte类型自动转换成了int类型,但是我们不让他变类型,就会直接使得其变成-128.
底层是因为补码的相加,127的二进制存储是0111 1111,+1之后会变成1000 0000,byte只取后边七位,会变成000 0000,变成原码之后会变成-128。
byte a=127;System.out .println("byte超范围自动转换为int:"+(a+1));System.out .println( "强制转换为byte,不让它变成int类:"+(byte)(a+1));