PG实战笔记 | 03 PostgreSQL发展历史:从伯克利到AI数据库
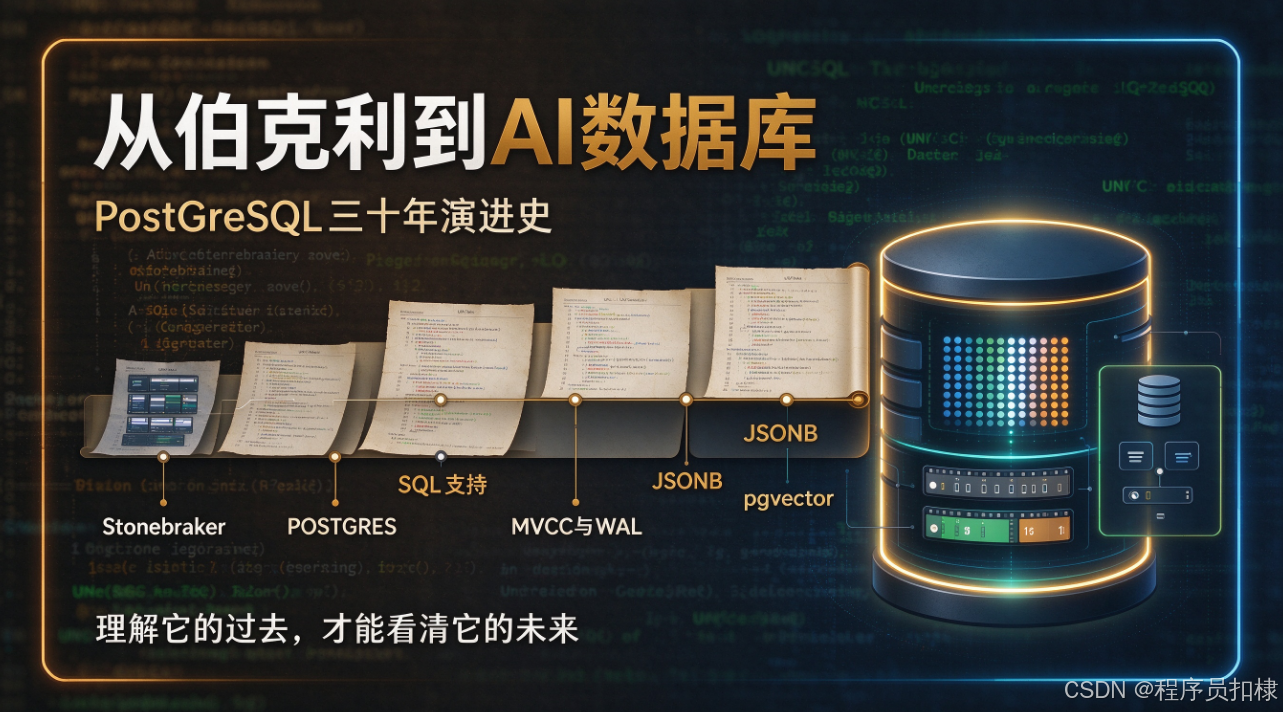
上一篇我们聊了为什么 PostgreSQL 是 AI 时代的首选数据库。这一篇,我们把时间轴拉长,看看这个数据库是如何从伯克利的一个学术项目,一步步走到今天,成为 AI 时代的数据基础设施。理解它的历史,你才能真正理解它的设计哲学。
一、起源:伯克利 POSTGRES 项目(1986--1994)
PostgreSQL 的故事,要从一位传奇计算机科学家说起:Michael Stonebraker。
1980 年代,Stonebraker 在加州大学伯克利分校领导了 Ingres 项目,这是最早的关系数据库之一。Ingres 后来商业化,演变成了 Sybase、SQL Server 等产品的技术源头。但 Stonebraker 觉得 Ingres 的设计有局限,于是在 1986 年启动了新项目:POSTGRES(Post Ingres)。
POSTGRES 的目标很大胆:在关系模型基础上,支持更丰富的数据类型和更复杂的查询。当时的关系数据库只支持简单的表格和标量类型,而 POSTGRES 想要支持:
- 自定义数据类型;
- 可扩展的索引;
- 规则系统(Rule System);
- 过程语言;
- 事务和时间旅行查询。
这些想法在 1980 年代非常超前。POSTGRES 用 C 语言编写,运行在 UNIX 系统上,很快成为学术界的研究平台。
关键点:从第一天起,POSTGRES 的基因就是"可扩展"。 这个设计哲学,一直延续到今天。
二、转折:从 POSTGRES 到 PostgreSQL(1994--1996)
1994 年,两个伯克利研究生 Andrew Yu 和 Jolly Chen 做了一件改变历史的事:给 POSTGRES 加上了 SQL 支持。
当时 POSTGRES 使用的是自己的查询语言 QUEL,而不是 SQL。但 SQL 正在成为行业标准,没有 SQL 支持,POSTGRES 很难被工业界接受。于是他们把 QUEL 解释器替换成了 SQL 解释器,项目改名为 Postgres95。
1996 年,项目再次改名:PostgreSQL 。这个名字既保留了 POSTGRES 的历史,又明确了对 SQL 的支持("Postgres" + "SQL")。同年,项目从伯克利迁出,成立了 PostgreSQL Global Development Group,开启了真正的开源社区治理模式。
关键点:SQL 支持让 PostgreSQL 从学术项目走向工业应用,而社区治理模式保证了它的长期独立性。
三、成长:关键特性演进时间线
从 1996 年到现在,PostgreSQL 每年发布一个大版本,持续演进近 30 年。以下是几个关键节点:
1990 年代末:打下基础
- 1997:PostgreSQL 6.0 发布,引入唯一索引、外键约束;
- 1998 :6.3 版本引入 MVCC(多版本并发控制),读写不阻塞,这是 PG 的核心竞争力之一;
- 1999 :6.5 版本引入 WAL(预写日志),保证崩溃恢复和持久性。
2000 年代:企业级能力
- 2000 :7.0 版本引入 TOAST,支持大对象存储;
- 2001 :7.1 版本引入 WAL 归档和 PITR(时间点恢复);
- 2005 :8.0 版本支持 Windows 原生,引入表空间、保存点;
- 2006 :8.1 版本引入 分区表 (继承方式)、两阶段提交;
- 2009 :8.4 版本引入 窗口函数 、CTE(WITH 查询)、并行查询雏形。
2010 年代:现代化与扩展
- 2010 :9.0 版本引入 流复制 、热备,高可用能力大幅提升;
- 2011 :9.1 版本引入 同步复制 、FDW(外部数据包装器);
- 2012 :9.2 版本引入 JSON 类型 、范围类型;
- 2014 :9.4 版本引入 JSONB(二进制 JSON),支持索引和高效查询;
- 2016 :9.6 版本引入 并行查询,分析性能大幅提升;
- 2017 :10.0 版本引入 逻辑复制 、声明式分区;
- 2018 :11.0 版本引入 存储过程事务控制 、JIT 编译;
- 2019 :12.0 版本引入 生成列 、CTE 内联。
2020 年代:AI 与云原生
- 2020 :13.0 版本引入 并行 VACUUM 、增量排序;
- 2021 :14.0 版本引入 管道查询模式 、多范围类型;
- 2022 :15.0 版本引入 MERGE 语句 、逻辑复制行过滤;
- 2023 :16.0 版本引入 逻辑复制并行应用 、JSON 构造函数;
- 2024 :17.0 版本引入 增量备份 、流式 I/O 、逻辑复制故障转移。
关键点:PG 的演进不是推倒重来,而是持续叠加。每一个版本都保持向后兼容,这让企业敢于长期投入。
四、扩展生态:从 PostGIS 到 pgvector
PostgreSQL 最强大的地方,不是内核功能,而是它的 扩展生态。内核提供基础能力,扩展按需添加新功能。
PostGIS(2001)
PostGIS 让 PostgreSQL 支持地理空间数据。它引入了 geometry、geography 类型,支持空间索引(GiST)、距离计算、地图分析。如今,PostGIS 是地理信息领域的行业标准,被广泛应用于物流、地图、位置服务。
TimescaleDB(2017)
TimescaleDB 把 PostgreSQL 变成时间序列数据库。它通过自动分区、连续聚合、压缩,让 PG 能高效处理 IoT、监控、金融行情等时序数据。你可以在同一张表里,既存业务数据,又存时间序列。
pgvector(2021)
pgvector 是 AI 时代最重要的扩展之一。它给 PG 增加了 vector 类型、相似度运算符、IVFFlat 和 HNSW 索引。这让 PostgreSQL 能直接存储和检索向量数据,成为 RAG、推荐、语义搜索的底座。
其他重要扩展
- Citus:分布式 PostgreSQL,水平扩展;
- pg_partman:分区管理自动化;
- pg_stat_statements:SQL 性能监控;
- PostgreSQL FDW:查询外部数据源;
- PL/Python:用 Python 写存储过程。
关键点:扩展机制让 PG 不是一个封闭的数据库,而是一个数据平台。它不用把所有功能塞进内核,而是让社区按需创新。
五、为什么 PG 能持续演进 30 多年?
这是一个值得深思的问题。很多开源项目火几年就沉寂了,为什么 PostgreSQL 能保持活力?
1. 社区治理模式
PostgreSQL 不属于任何一家公司,由 PostgreSQL Global Development Group 管理。核心开发者来自全球各地,决策透明,没有商业公司绑架。这种独立性,让 PG 能长期保持技术中立。
2. 向后兼容的承诺
PG 每个版本都尽量保持向后兼容。升级不会导致现有应用崩溃。这种稳定性,让企业敢于长期使用。
3. 每年一个大版本
PG 每年发布一个大版本,节奏稳定。新特性经过充分讨论和测试,不会为了赶进度而牺牲质量。
4. 扩展机制
PG 不需要把所有功能都做进内核。向量搜索、地理数据、时序数据,都由扩展解决。内核保持精简,扩展自由创新。
5. 学术与工业结合
PG 从伯克利起步,保留了学术研究的严谨性。同时,它又被广泛应用于工业界,反馈驱动改进。
6. 文档与社区
PG 的官方文档质量极高,社区邮件列表活跃。遇到问题,很容易找到答案。
关键点:PG 的长期主义,是技术、治理、生态三者共同作用的结果。
六、从历史看未来:PG 在 AI 时代的位置
回顾 PG 的历史,你会发现一条清晰的主线:它始终在扩展数据库的边界。
- 1980 年代:扩展数据类型和查询能力;
- 1990 年代:支持 SQL,走向工业界;
- 2000 年代:企业级事务、复制、高可用;
- 2010 年代:JSON、并行查询、逻辑复制;
- 2020 年代:向量、AI、云原生。
每一次技术浪潮,PG 都能通过扩展或内核演进抓住机会。AI 时代也不例外。pgvector 的出现,让 PG 从"关系数据库"变成了"AI 数据库"。
未来,PG 可能会继续在以下方向演进:
- 向量搜索性能:更高效的 ANN 索引、GPU 加速;
- 多模态融合:向量 + 全文 + 地理 + 时序统一查询;
- 云原生:与 Kubernetes、Serverless 深度集成;
- AI 原生:内置模型推理、自动嵌入生成。
七、总结
PostgreSQL 的历史,是一个关于 扩展、兼容、社区 的故事。从伯克利的 POSTGRES 项目,到今天的 AI 数据库,它用 30 多年证明了一件事:一个数据库的生命力,不在于它一开始有多强大,而在于它能否持续演进。
一句话:PG 的历史,就是数据库技术演进的缩影。理解它的过去,才能看清它的未来。
下一篇,我们聊聊 PostgreSQL 的市场地位与实际案例:哪些公司在用?从 Oracle/MySQL 迁移到 PG 的真实收益是什么?
思考题:
你觉得 PostgreSQL 能持续演进 30 多年的最关键因素是什么?是社区治理、扩展机制,还是向后兼容?欢迎在评论区聊聊。