源码地址:GitHub - king-yyf/CMeKG_tools · GitHub
源码简介:
中文医学知识图谱CMeKG CMeKG(Chinese Medical Knowledge Graph)是利用自然语言处理与文本挖掘技术,基于大规模医学文本数据,以人机结合的方式研发的中文医学知识图谱。
CMeKG 中主要模型工具包括:医学文本分词,医学实体识别和医学关系抽取。这里是三种工具的代码、模型和使用方法。
0. 学习计划
| 课次 | 主题 | 预计学时 |
|---|---|---|
| 阶段一 · 地基 | --- | 5.5 小时 |
| 1 | 认识三大任务 | 1 小时 |
| 2 | 文本与标签 | 2 小时 |
| 3 | 神经网络速成(里程碑 ①) | 2.5 小时 |
| 阶段二 · 原理 | --- | 6 小时 |
| 4 | BERT 精讲 | 2.5 小时 |
| 5 | LSTM | 1.5 小时 |
| 6 | CRF(里程碑 ②) | 2 小时 |
| 阶段三 · 代码精读 | --- | 9.5 小时 |
| 7 | utils.py 全解 | 2.5 小时 |
| 8 | 模型代码精读 | 2 小时 |
| 9 | 推理与训练脚本 | 2.5 小时 |
| 10 | 关系抽取专题(里程碑 ③) | 2.5 小时 |
| 阶段四 · 实战 | --- | 6.5 小时 |
| 11 | 跑通实战 | 2 小时 |
| 12 | 仿写项目(上) | 2 小时 |
| 13 | 仿写项目(下,毕业) | 2.5 小时 |
| 合计 | 13 课 | 约 27.5 小时(含练习与答疑) |
1. 第1课 认识三大任务
把整个项目想象成一座病历加工厂。
原料 = 原始病历文本(一串连着写的汉字),最终产品 = 知识图谱(一张巨大的医学知识网络)。厂里有三道关键工序,恰好就是代码中的三个程序。
1.1 工序一:分词------划边界
第一道工序拿到的原料是这样的:
高血压病人不可食用阿莫西林等药物机器看到这串字只会犯迷糊:哪里是一个词?哪里是词和词的分界?所以第一道工序负责把它切开:
高血压 / 病人 / 不可 / 食用 / 阿莫西林 / 等 / 药物- 输入:一句连着写的中文
- 输出:切开成词的一串
- 代码 :
medical_cws.py
为什么必须切?因为后面所有分析都建立在「哪些字构成一个词」上。举例:如果「高血压」被切成「高 / 血压」,机器看到的就是两个不同的碎片,后面全乱套。
医学文本尤其难切:专业词超长(「促肾上腺皮质激素释放激素」12 个字才是一个词)、缩写多(CT、MRI)、新药名不断出现。
1.2 工序二:实体识别------找东西、分类
句子切开后,第二道工序负责:找出句子里「重要的东西」,并说出它属于哪一类。
高血压病人不可食用阿莫西林等药物 高血压 = 疾病 阿莫西林 = 药物医学术语管这些「重要的东西」叫实体 。项目里定义了 9 种实体类别:
【疾病、症状、身体、药物、医疗程序、医疗设备、科室、微生物、检验项目】
- 输入:一句中文
- 输出 :像
{"疾病": "高血压", "药物": "阿莫西林"}这样的「类别: 实体」清单 - 代码 :
medical_ner.py
和分词的区别在于:分词看的是「边界 在哪」,实体识别看的是「这块文本属于哪一类」。
1.3 工序三:关系抽取------连关系
前两道工序产出的是一个个孤立的东西。第三道工序回答最后一个问题:它们之间是什么关系?
(高血压)------ 禁忌 ------(阿莫西林)高血压病人不可食用阿莫西林 → 三元组:(高血压, 禁忌, 阿莫西林)术语叫SPO 三元组 :(主语 subject, 谓词 predicate, 宾语 object)。医学关系也是固定清单,predicate.json 里定义了 23 种:临床表现、病因、适应症、禁忌、不良反应......
- 输入:一句中文
- 输出:(主语, 谓词, 宾语) 的清单
- 代码 :
model_re/medical_re.py
1.4 拼装成图 + 为什么用专门的模型
1. 三道工序拼起来 = 知识图谱
继续用工厂比喻:前面三道工序各自产出半成品,把它们串成一条流水线,最终产品就出来了。看一个完整例子:
原始文本:新型冠状病毒肺炎患者常见发热、咳嗽等症状
     │ ① 分词(划边界)
     ▼
新型冠状病毒肺炎 患者 常见 发热 、 咳嗽 等 症状
     │ ② 实体识别(找东西、分类)
     ▼
{疾病: 新型冠状病毒肺炎, 症状: 发热, 症状: 咳嗽}
     │ ③ 关系抽取(连关系)
     ▼
(新型冠状病毒肺炎, 临床表现, 发热)
(新型冠状病毒肺炎, 临床表现, 咳嗽)
     │
     ▼
知识图谱(一张网):
    发热 ◀──临床表现── 新型冠状病毒肺炎 ──临床表现──▶ 咳嗽
注意三件事:
- 每一步的产物,是下一步的原料------文本 → 词 → 实体 → 关系,层层提炼
- 实体变成图上的节点 (一个个圆圈),关系变成节点之间的连线(带箭头的边)
- 为什么叫「图」而不是「表格」?因为知识和知识是互相连接成网的:从「新型冠状病毒肺炎」这个节点出发,能顺着连线找到它的所有症状、药物、并发症......这就是知识图谱的用处(智能问答、辅助诊断,都是在这张网上"顺藤摸瓜")
2. 为什么医学文本要用"专门训练"的模型
机器要完成这三道工序,前提是它得学过中文------学习方式是"阅读大量文本"。那为什么不直接用通用模型,要专门做医学模型?
打个比方:
- 通用模型 = 一个只读新闻和百科长大的人
- 医学模型 = 一个读了几十万份医学文献长大的人
让这两人去读病历,后者顺得多。因为医学语言和日常语言差距很大:
- 专业术语日常几乎不出现:「嗜酸性粒细胞」「糖皮质激素」,新闻里见不到
- 新术语不断出现:新疾病、新药名,词典永远追不上
- 一词多义:「阴性」在日常是性格词,在医学里指检测结果
所以本项目三个模型的地基,都是一个用医学语料预训练过的 BERT(可以先把它理解成"读过海量医学文本的语言理解引擎")。它到底怎么"读"、怎么"懂",是阶段二(第 4 课)的主角。
1.5 本课小结
- 三道工序:分词 = 划边界;实体识别 = 找东西、分类(9 类实体);关系抽取 = 连关系(SPO 三元组,23 种谓词)
- 合起来:节点(实体)+ 边(关系)= 知识图谱
- 医学文本难:术语多、新词多、含义特殊 → 需要医学预训练的 BERT 打底
1.6 课堂练习
第一题·对这句话做三道工序:
糖尿病患者应定期检查血糖,必要时注射胰岛素。
- 分词 :用
/把它切开 - 找实体:每个实体属于 9 类中的哪一类?(提示:至少能找出 3 个)
- 写三元组 :写 1~2 个「(主语, 谓词, 宾语)」,谓词从
predicate.json的 23 种里挑(提示:检查、治疗都在清单里)
第二题·用自己的话(两三句即可):三道工序分别做什么?它们怎么拼出知识图谱?
参考答案:
第一题答案:
1.分词:糖尿病/患者/应/定期/检查/血糖/,/必要/时/注射/胰岛素/。
2.找实体:
糖尿病=疾病,胰岛素=药物,血糖-检验项目
3.写三元组
糖尿病-治疗-胰岛素,糖尿病-检查-血糖
第二题答案:
三个工序分别是:分词、找实体、关系抽取
分词是找实体的前提,先将自然语言按词语切分,找出边界;找实体是按照预设的实体类别,模型逐字判断属于哪个类别,找出重要的实体及其所属类别;关系抽取是抽取实体与实体之间的关系,最终形成多个实体之间的关系网,这就是知识图谱。
2. 第2课 文本与标签
2.1 项目文件分类
CMeKG_tools-main/
│
├─ 【推理入口】用户使用的三个"工具"                      ← 你以后调用的就是它们
│   ├─ medical_cws.py        分词工具(类名 medical_seg)
│   ├─ medical_ner.py        实体识别工具(类名 medical_ner)
│   └─ model_re/medical_re.py  关系抽取工具
│
├─ 【模型定义】"大脑"的结构说明                            ← 工具内部靠它们干活
│   ├─ model_cws/   (bert_lstm_crf.py + crf.py)
│   ├─ model_ner/   (bert_lstm_crf.py + crf.py)
│   └─ model_re/    (medical_re.py)
│
├─ 【训练脚本】带着答案教模型                                  ← 第 9 课精读
│   ├─ train_cws.py
│   └─ train_ner.py
│
├─ 【公共工具】所有文件都借用的"扳手螺丝刀"              ← 第 7 课精读
│   └─ utils.py              读数据、读词表、算 P/R/F1
│
├─ 【配置常数】把"设置"集中放的小抽屉
│   ├─ cws_constant.py       分词的设置(标签表、超参数)
│   └─ ner_constant.py       实体识别的设置(标签表、超参数)
│
└─ 【数据文件】
    ├─ predicate.json        23 种"关系"的名单(RE 用)
└─ train_example.json 关系抽取的训练样本示例调用关系:推理入口 → 借用 utils 读数据 → 交给 model_ 里的大脑 → 按 _constant.py 的标签表翻译回中文。
比如用实体识别工具,medical_ner.py 会:先用 utils.py 把句子变成数字 → 送进 model_ner/ 的模型 → 模型吐出一串标签编号 → 按 ner_constant.py 的标签表把编号翻回"疾病""药物"等中文。
2.2 文本变数字:模型的"语言"
模型是数学函数,它不认识汉字,只认识数字。所以第一道工序永远是:把一句话变成一串整数编号。
2.2.1. vocab:一张"字 → 编号"的大字典
做法很朴素:预先准备一张表(词表,vocab),把每个字编个号。查表即可:
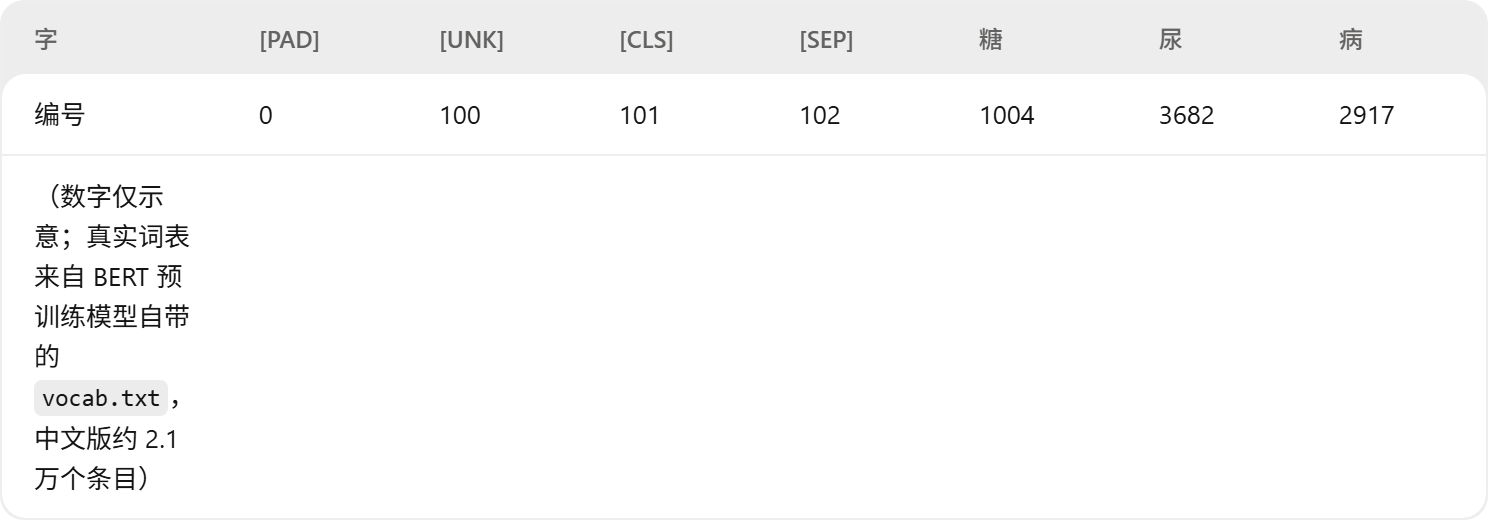
于是"糖尿病"就变成了 1004, 3682, 2917 这样的整数列表。为什么按「字」切分,不按「词」? 两个原因:
- 中文没空格,切词本身就要靠算法,词表会不停遇到没见过的新词;
- 医学领域新词极多("新型冠状病毒""奥密克戎"......),按字切分永远不"缺字",词表稳定可控。
所以在中文 NLP 里,"字"是最小单位。一句话 = 一串字 = 一串编号。
2.2.2 四个"特殊符号":混在字里的 VIP
词表里不全是汉字,还有 4 个有特殊职责的符号,你在 utils.py 和模型里会反复看到它们:
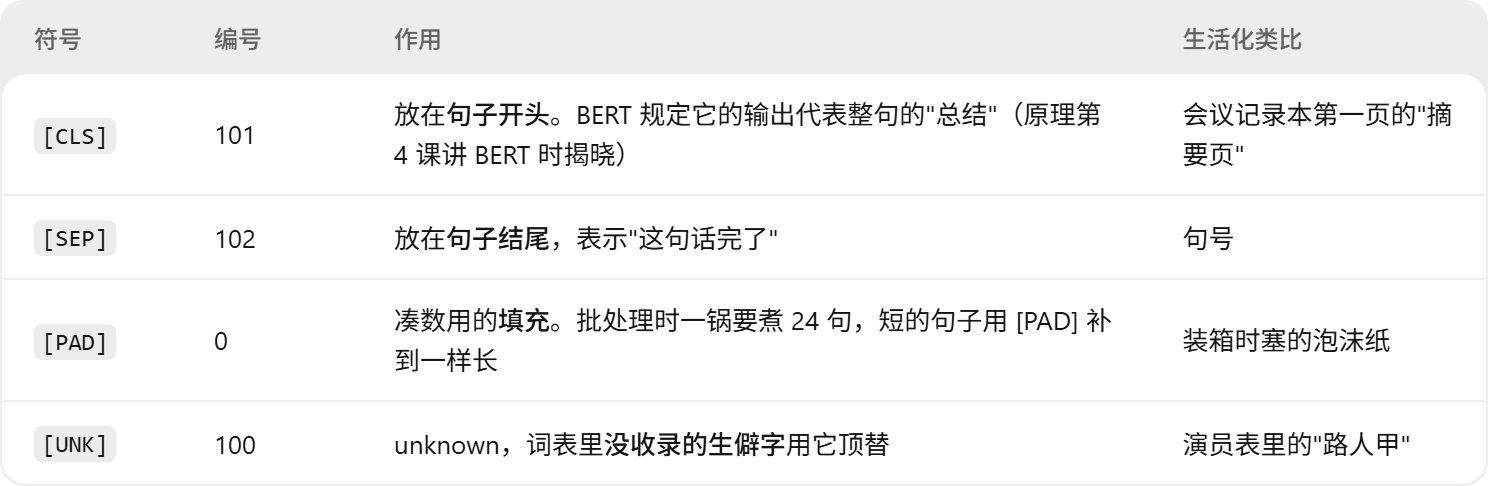
举个例子,"发热。" 进入模型前会变成:
[CLS] 发 热 。 [SEP] [PAD] [PAD] [PAD] ...   ← 补齐到固定长度(如 450)
 ↓
101   2071 8832 511 102   0     0     0  ...
补齐长度是为了批处理:一批句子装进一个矩阵,长度必须一致,短句子剩下的位置塞 PAD。但模型不能把泡沫纸当内容,所以还要配一张掩码(mask):真字位置记 1,PAD 位置记 0------"这些位置是假的,别当真"。这个 mask 你在 train_ner.py 里见过,就是那个 masks 变量。
2.3 核心思路:模型在做"逐字贴标签"的比赛
回忆第 1 课:模型是逐字做判断题。既然是判断题,就得有标准答案 ------标准答案就是标签。任务不同,标签表就不同:
| 输入侧 | 输出侧(标签) | |
|---|---|---|
| 通用 | [CLS] [SEP] [PAD] [UNK] |
--- |
| 分词 CWS | 字序列 | S / B / M / E + <pad> <start> <eos> = 7 个 |
| 实体识别 NER | 字序列 | 9 类 × B/M/E + o + 3 个特殊的 = 31 个 |
注意:输入侧有 4 个特殊符号,输出侧也有特殊标签,两边是对称的设计。下面逐一拆。
2.4 分词标签表:只要 7 个(打开 cws_constant.py 第 3 行)
l2i_dic = {"S":0, "B":1, "M":2, "E":3, "<pad>":4, "<start>":5, "<eos>":6}l2i_dic = label to index(标签→编号)。前 4 个是主角,描述的是"这个字在词里的位置":
- S = Single:自成一个词
- B = Begin:词的开头
- M = Middle:词的中间
- E = End:词的结尾
为什么 4 个就够?因为任何词的结构都是"开头 →(中间)→结尾":
| 词长 | 例子 | 标签 |
|---|---|---|
| 1 字 | 应 | S |
| 2 字 | 患者、注射 | B E |
| 3 字 | 糖尿病、胰岛素 | B M E |
| 4 字 | 阿司匹林 | B M M E |
所以一句话贴完标签,答案就出来了。例:
code.txt
字:  糖  尿  病  患  者  应  注  射  胰  岛  素  。
标签:B   M   E   B   E   S   B   E   B   M   E  S
程序拿到这串标签,划词规则极简单:"S 单独一刀;从 B 划到 E"→ 糖尿病 / 患者 / 应 / 注射 / 胰岛素 / 。 ✓
后 3 个是工具标签------和输入侧的 PAD、CLS、SEP 一一对应:
<pad>:标签侧的填充位,对应输入里补的泡沫纸<start>/<eos>:句子起点/终点。留个悬念 :标签表为什么要塞这两个?模型的线性层为什么输出tagset_size+2个分数而不是tagset_size个?这就是给它们留的位置,第 6 课 CRF 揭晓。
第 5 行 i2l_dic 是 l2i_dic 的反向表(编号→标签),模型吐出编号后靠它翻回字母,就是 utils.py 里 recover_label 用的那张表。
2.5 实体识别标签表:31 个的来历(打开 ner_constant.py 第 4-6 行)
分词标签只说"位置",不说"是什么"。NER 必须再叠一层类别 ,做法就是:类别代号 + - + 位置字母。按结构拆开看,31 个一目了然:
o                       ← 1 个:非实体(o = Outside),句子里大部分字都是它
d-B d-M d-E             ← 疾病
s-B s-M s-E             ← 临床表现(工具输出时叫"症状")
b-B b-M b-E             ← 身体
e-B e-M e-E             ← 医疗设备
p-B p-M p-E             ← 医疗程序
m-B m-M m-E             ← 微生物类
k-B k-M k-E             ← 科室
i-B i-M i-E             ← 医学检验项目
y-B y-M y-E             ← 药物
<pad> <start> <eos>     ← 3 个工具标签(同分词,和 CRF 有关)
9 类 × 3 位置 + 1 个 o + 3 个工具 = 31 。ner_constant.py 第 24 行 tagset_size = len(l2i_dic) 就是 31------模型最后一层要输出 31 个分数,对应 31 种标签的可能。
同一句话用 NER 的表贴标签:
字:  糖   尿   病   患  者  应  使  用  胰   岛   素   。
标签:d-B  d-M  d-E  o   o   o   o   o   y-B  y-M  y-E  o
对比分词版本(B M E / B E / S / B E / B M E / S),看出区别了吗:
- 分词的 B、E 只管词边界 ;NER 的 d-B、y-E 同时管边界 + 类别;
- NER 里"患者""使用"这些没被划进 9 类的字全部标
o; - 两个任务里 B 都是 Begin、M 都是 Middle------字母含义相同,只是 NER 在前面挂了类别代号。
2.6 对齐规则:一字一标签
最后一条铁律:输入 N 个字,模型就要吐 N 个标签,位置严格一一对应。这叫"序列标注"任务。打开训练数据文件(第 7、9 课会看)会发现每行的格式就是:
糖	d-B
尿	d-M
病	d-E
患	o
(空行) ← 空行表示一句话结束一行字、一行标签,天然对齐------数据格式本身就在强制这条规则。
2.7 课堂练习
练习 1(标分词):给下面这句话逐字标 S/B/M/E 标签(记住:先自己在心里划词,再贴标签):
发烧时可用阿司匹林退热。
练习 2(查代码) :打开 ner_constant.py,写出"药物"类的全部标签及对应编号(提示:看 l2i_dic,数一数行号)。
练习 3(相当于验收):回答上半段留的两道思考题------
- 为什么句子开头加
[CLS]、结尾加[SEP]? - 补齐长度的
[PAD]靠什么告诉模型"别当真"?
参考答案:
练习1:
发烧时可用阿司匹林退热。
BESBEBMMEBES
练习2: 每类实体占 3 个连续编号: "y-B": 25, "y-M": 26, "y-E": 27
练习3:
[SEP]:句子到此结束的记号[CLS]:它不只是"起点标记",更是 BERT 预留的"摘要位"------BERT 规定,CLS 经过层层计算后的输出向量,代表整句话的总结。做"整句判断"的任务(如情感分类:这句话是正面还是负面)时,就只看 CLS 的输出。咱们项目是逐字判断(CWS/NER),虽然用的是每个字的输出,但 CLS 依然按这个约定带着全句信息。这条讲透在第 4 课《BERT 精讲》。2.补齐长度的pad靠mask为0告诉模型别当真