数据孤岛的本质是协作断点,不是技术短板
在企业数据集成实践中,真正阻碍数据流动的往往不是数据库连不通,而是角色间语言不通、权责不清、流程断裂。DBA因安全顾虑拒开高危权限,业务方难以准确描述字段语义,开发需为每张Excel重复编写Python脚本------这些都属于典型的协作断点,而非技术能力缺失。
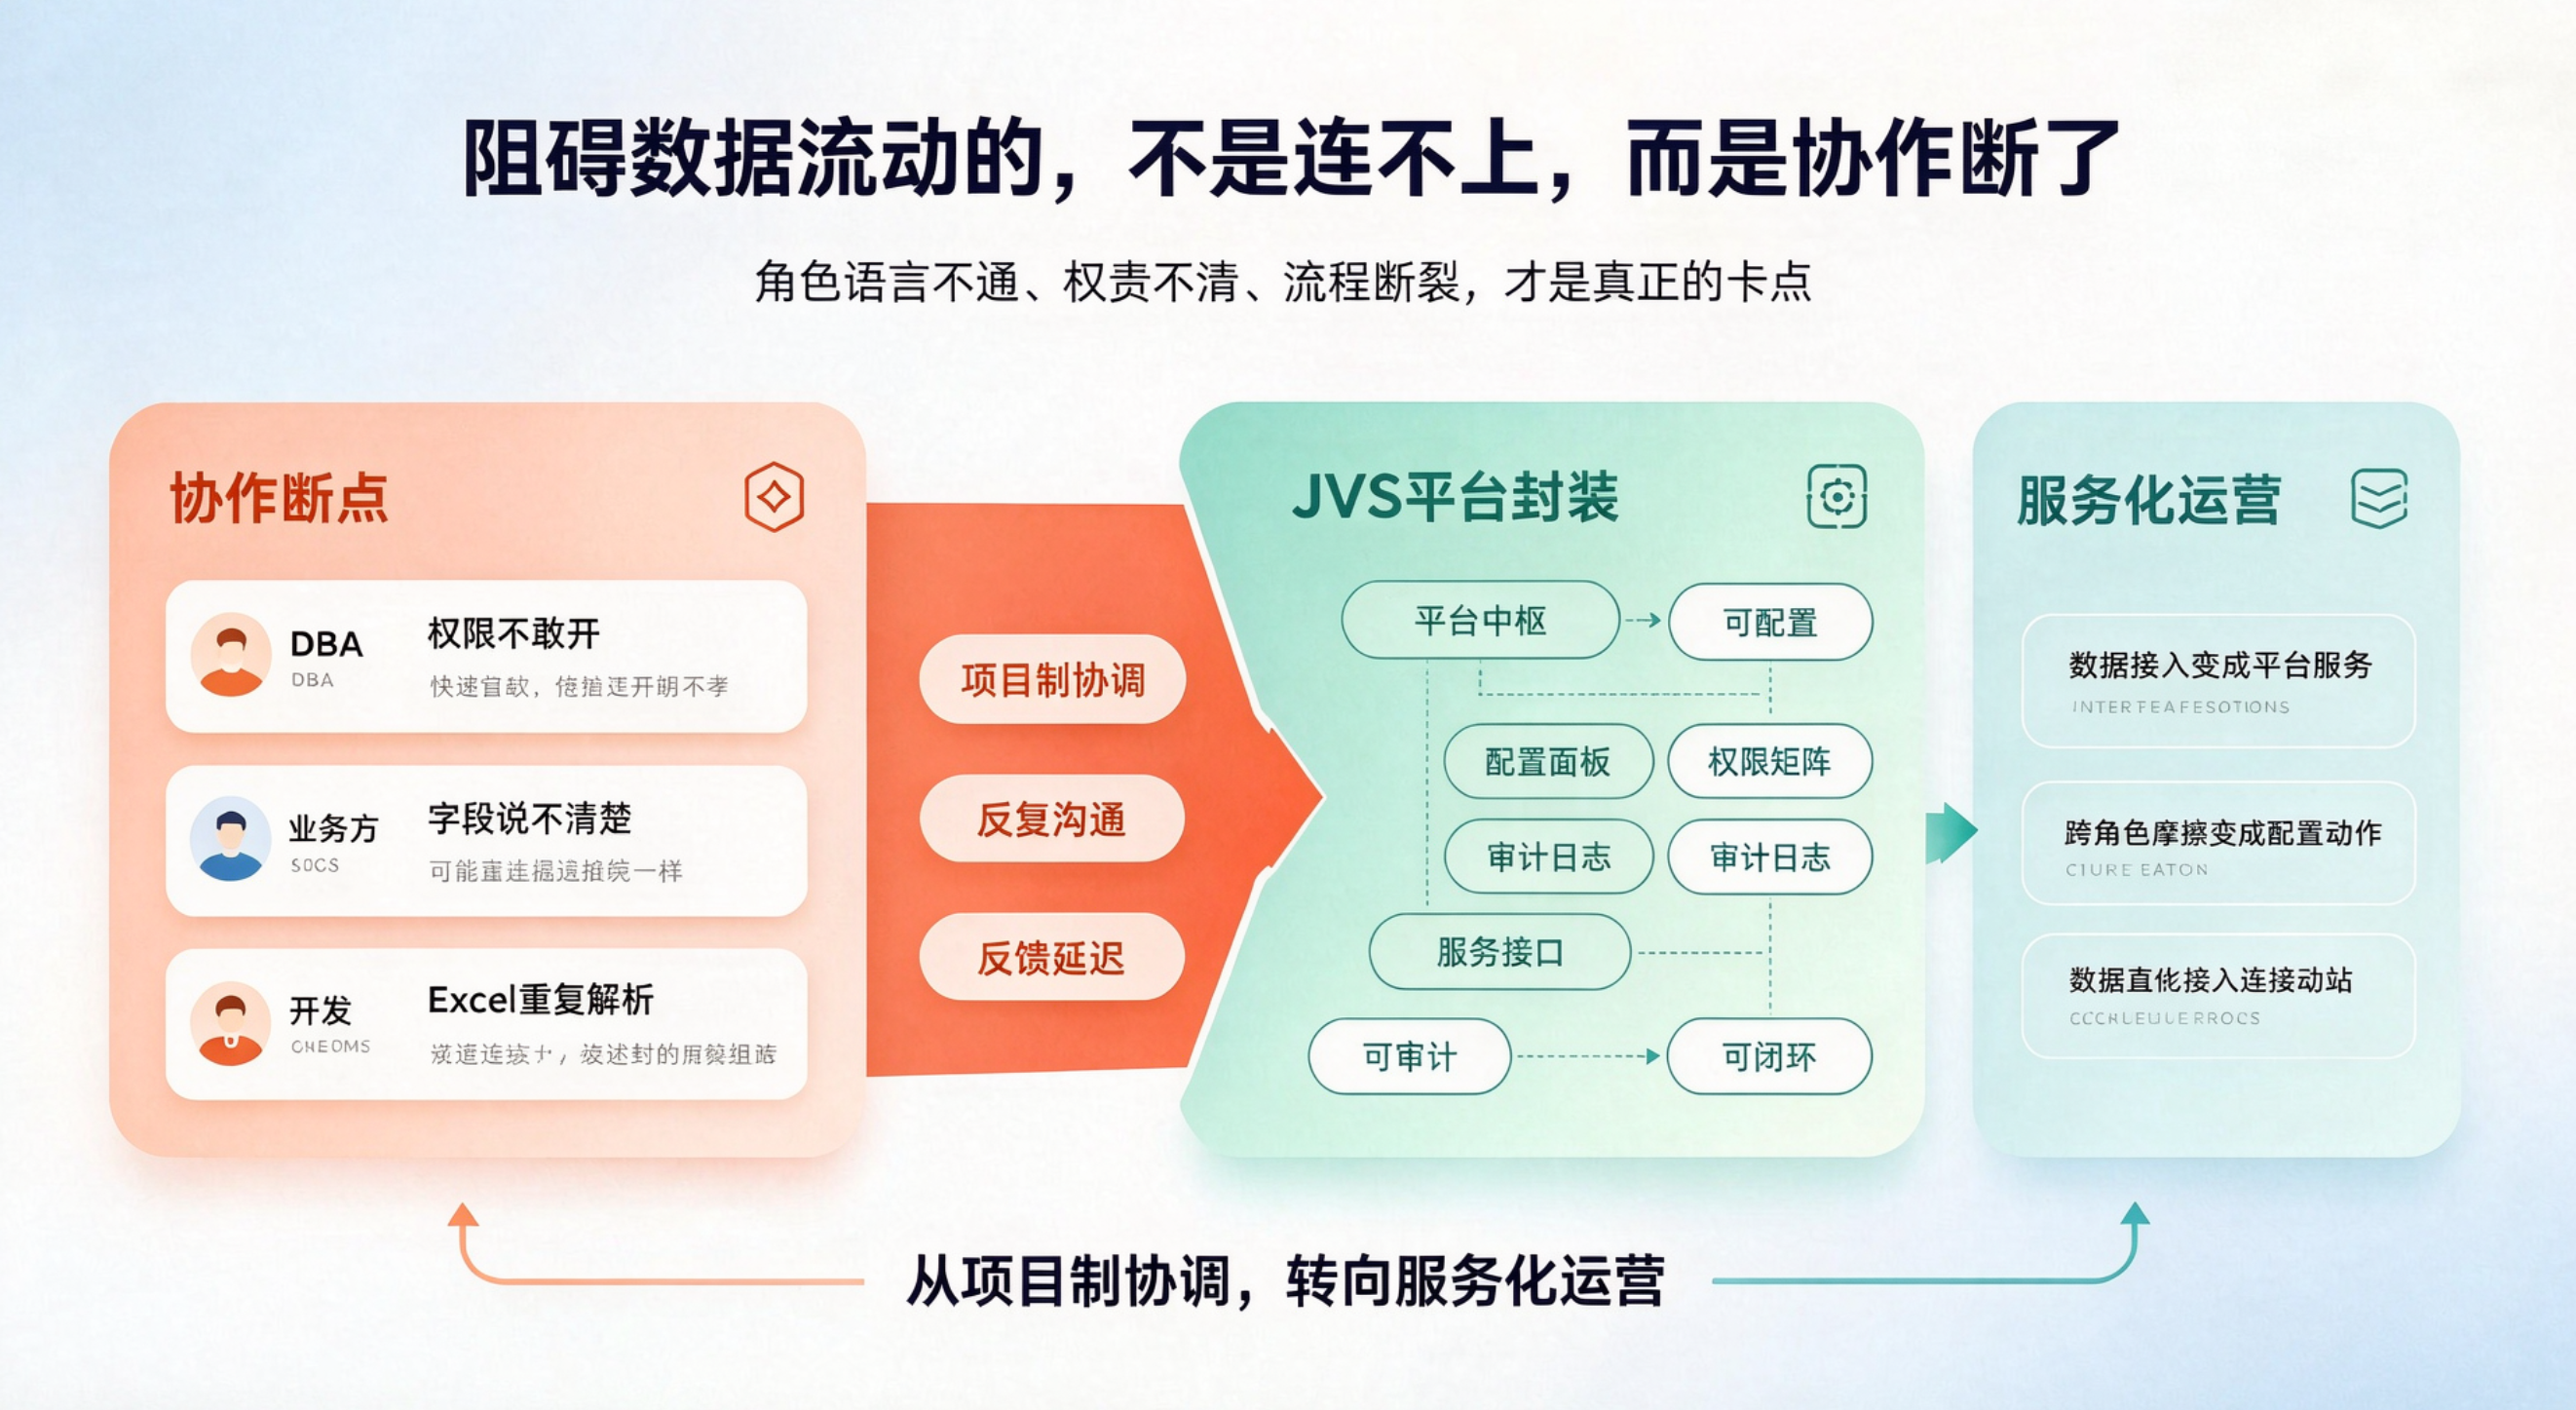
JVS的设计出发点正是将这类跨角色摩擦封装为平台内可配置、可审计、可闭环的服务动作,使数据接入从'项目制协调'转向'服务化运营'。
三类典型数据源的接入实践对比
以下基于真实场景提炼的接入方式差异,体现JVS如何将协作成本显性化、步骤化、低门槛化:
-
Excel直传接入
-
传统方案:业务导出→开发写Python脚本定义Schema→IT部署调度→每月人工校验,平均耗时3--5人日。
-
JVS方案:业务上传即识别字段类型、自动追加新列、保留历史版本,生成可用数据集,全程无需代码。
-
-
Oracle ERP直连接入
-
传统方案:DBA反复创建/验证只读账号,逐表授权,需多轮沟通确认权限范围。
-
JVS方案:基于标准JDBC协议,仅需主机、端口、服务名、用户名、密码五项参数;连接后自动探测表结构,DBA工作量压缩至分钟级。
-
-
钉钉审批API接入
-
传统方案:依赖SDK调用,手动处理Token刷新逻辑,逐字段映射JSON响应,需前后端协同调试。
-
JVS方案:提供可视化Token配置面板 + 拖拽式字段映射画布;业务方可自主完成字段选取、别名设置、空值处理,全程无须编码。
-
零改造接入的技术实现:三层解耦架构
JVS的'零改造'并非黑盒魔法,而是建立在清晰分层、职责隔离的工程设计之上:
-
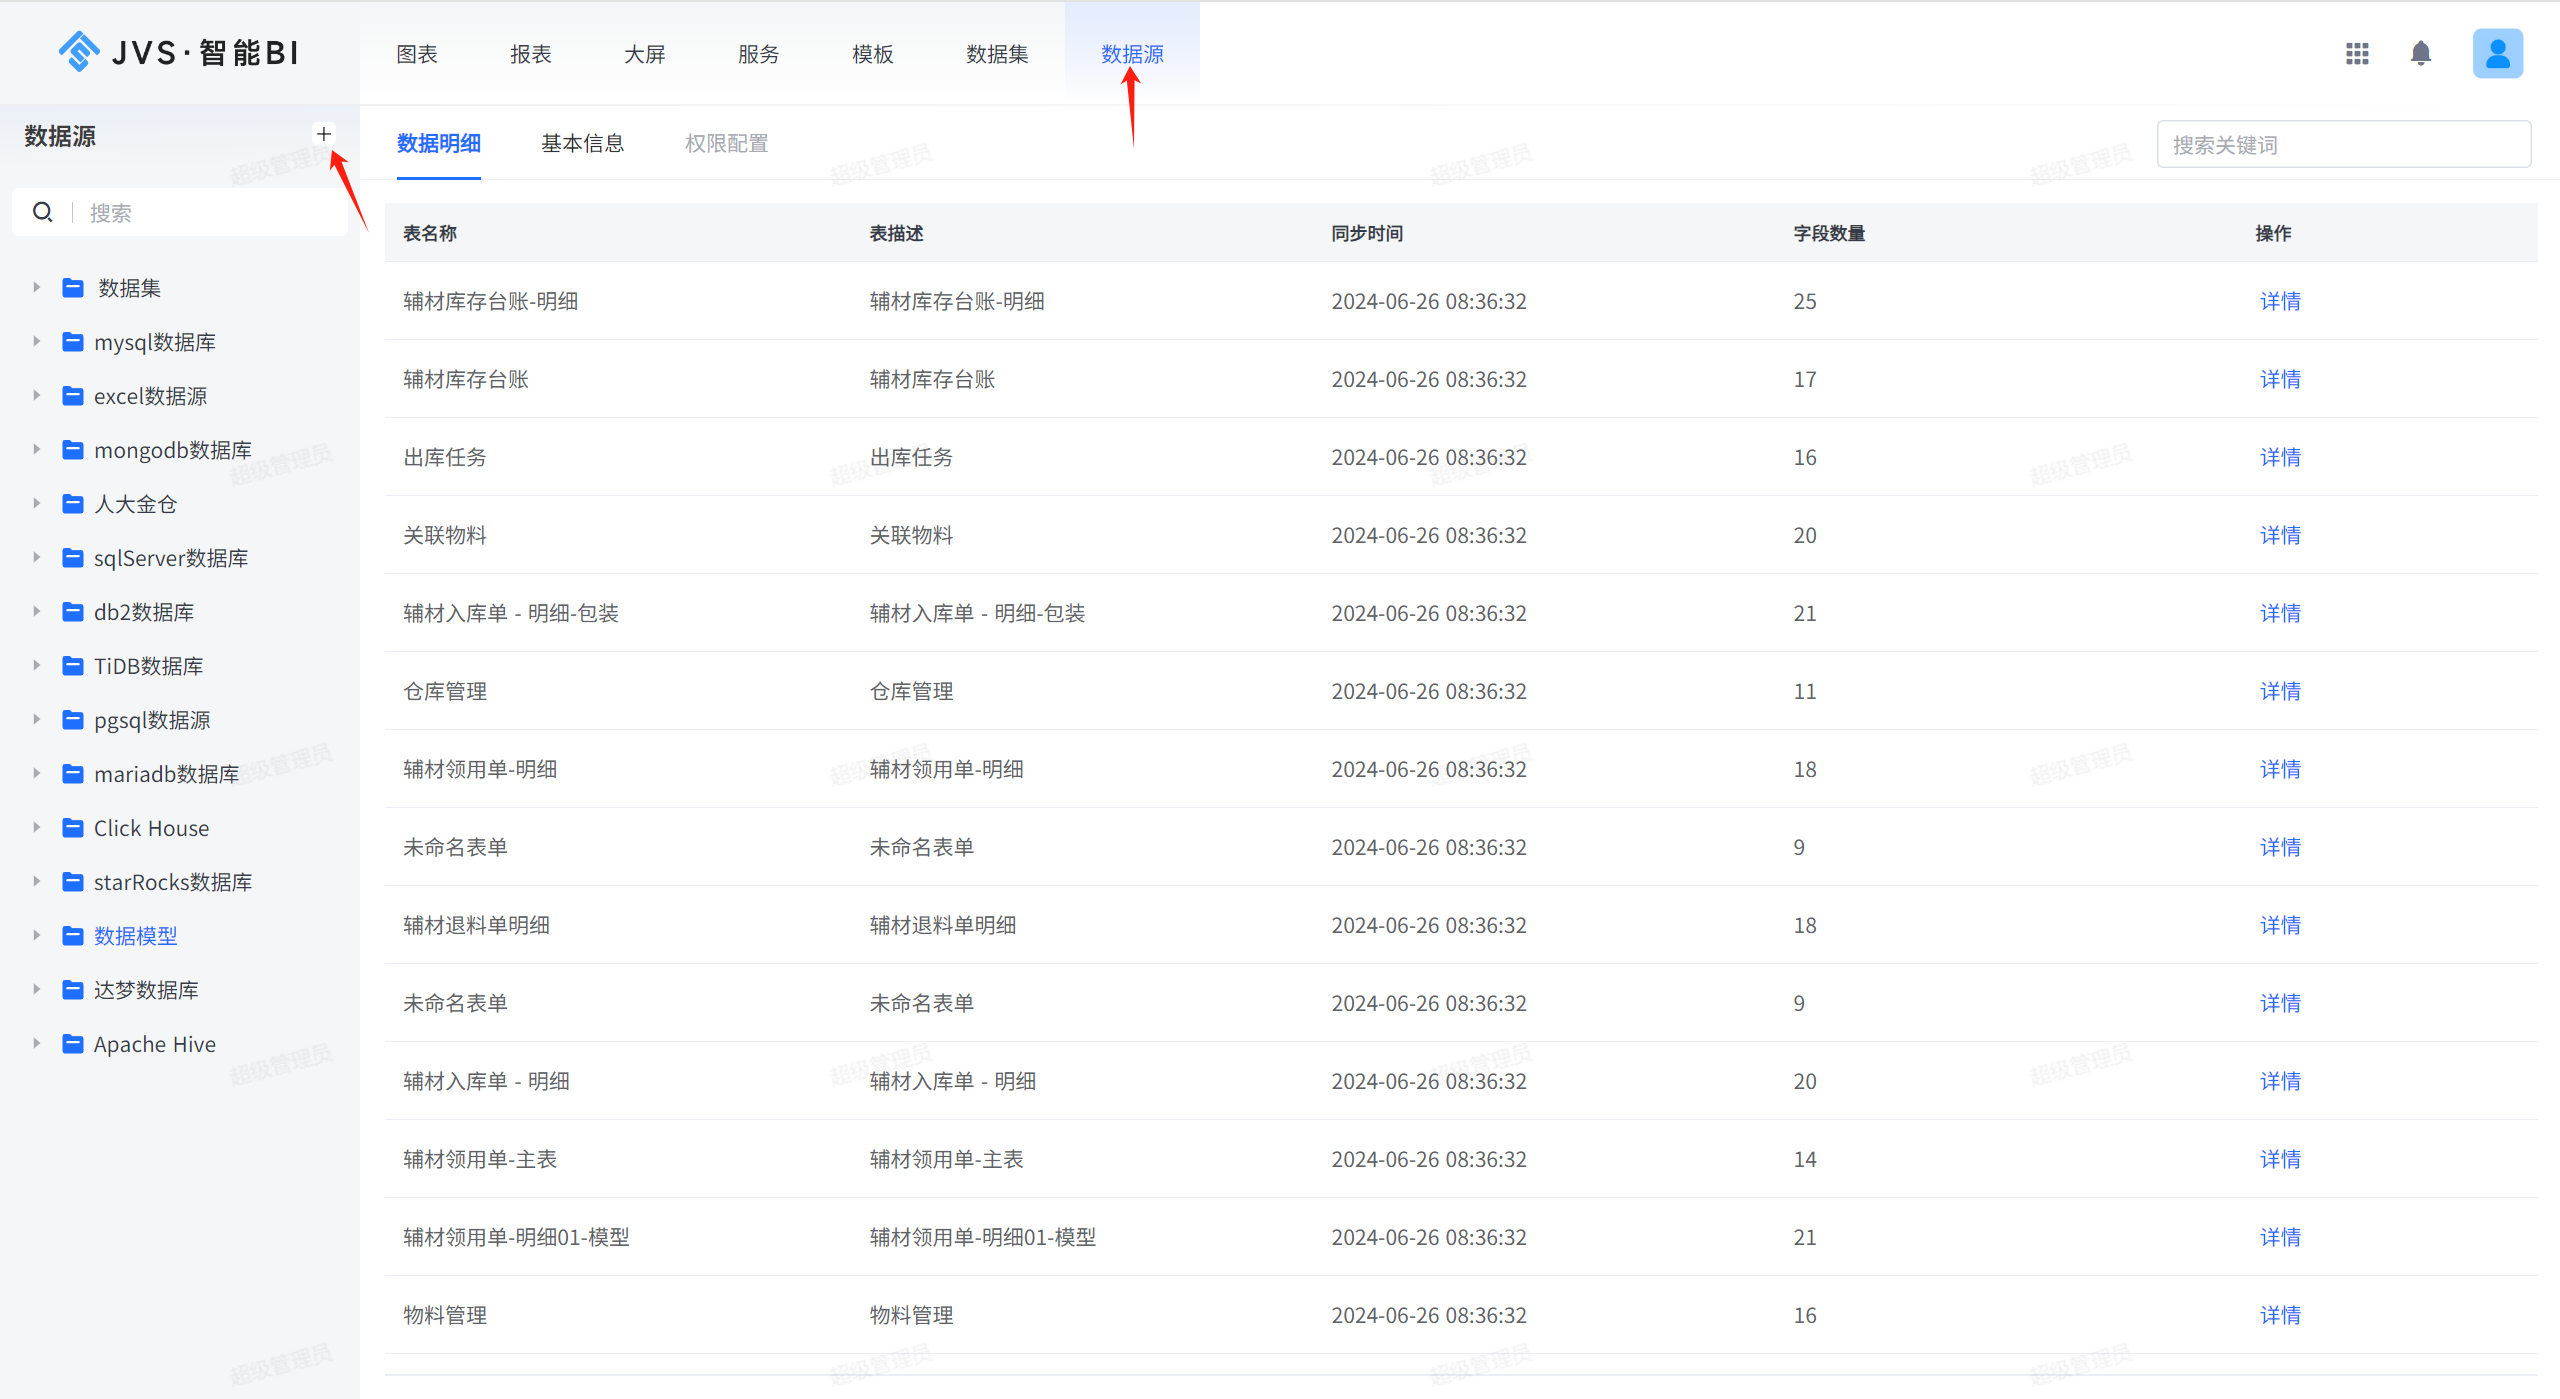
接入层:统一JDBC抽象协议
-
支持Oracle、MySQL、Excel(通过POI桥接)、REST API(通过HTTP Client封装)等异构源,全部归一为标准JDBC Driver调用接口。
-
上层不感知SQL方言差异(如Oracle的
ROWNUMvs MySQL的LIMIT),驱动适配由平台预置完成,避免开发重写或DBA逐项评估语法风险。
-
-
加工层:界面化ELT引擎(非ETL)
-
将SQL能力封装为拖拽节点:'筛选'对应
WHERE、'关联'对应JOIN、'分组聚合'对应GROUP BY + AGG()。 -
示例:关联ERP订单表与MES生产表,仅需选择两表→拖入'关联节点'→点击字段映射→预览结果,系统自动生成等效SQL并执行验证。
-
所有逻辑保存为JSON Schema格式的可版本化数据流定义,支持Git管理与CI/CD集成。
-
-
存储层:独立Doris分布式数仓
-
所有分析计算均在Doris中完成,与ERP、CRM等生产系统物理隔离。
-
DBA无需评估报表查询对OLTP系统的负载影响;IT可放心启用分钟级调度;业务方获得稳定亚秒级查询响应。
-
可持续运营的关键机制
要让零改造接入长期有效,需配套可落地的运营机制:
-
权限策略固化
-
按R14模型划分三级权限:DBA仅拥有'连接与校验'权;业务方可执行'同步结构''引用建模';数据治理岗统一审核变更发布。
-
权限边界通过平台RBAC策略强制执行,消除模糊协商空间。
-
-
模板化复用能力
-
预置高频场景模板:Excel日期字段自动识别规则、ERP订单号→MES工单号映射逻辑、钉钉API分页参数(
page=1&size=100)及Token刷新策略。 -
新需求直接调用模板+微调,避免重复试错与知识沉淀断层。
-
-
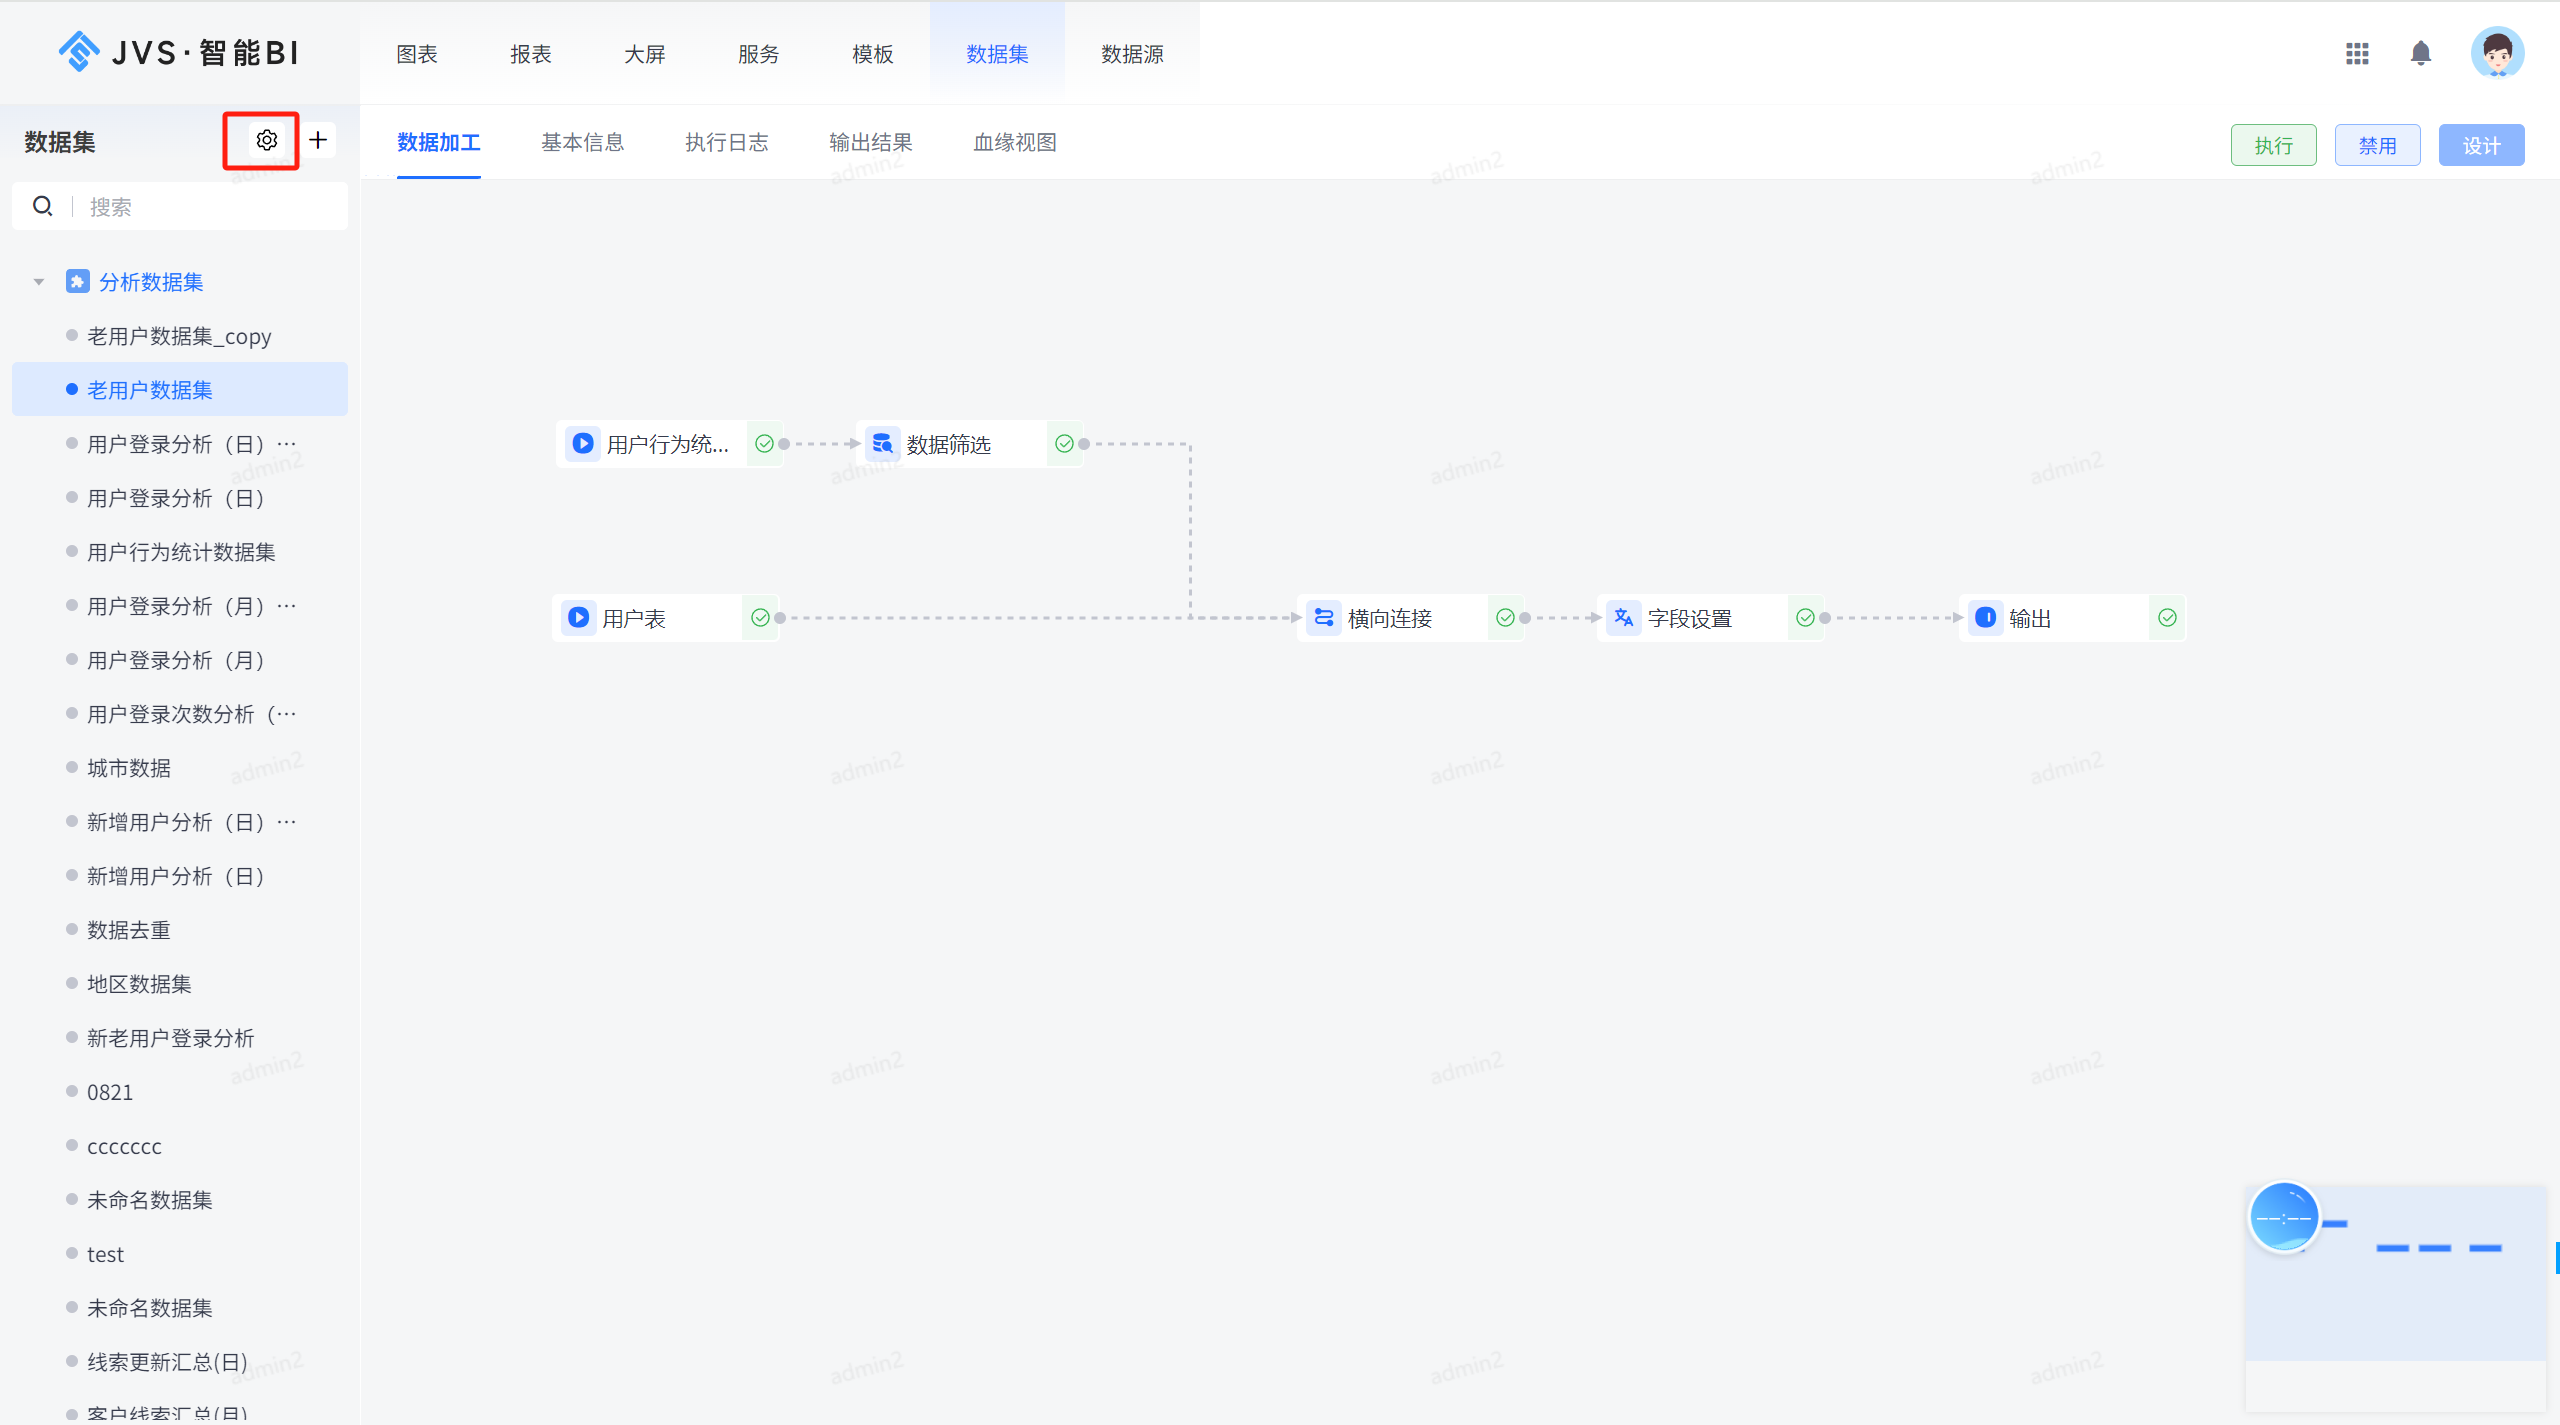
血缘驱动的问题定位
-
R12自动构建端到端血缘图谱(含源头字段、加工节点、目标报表)。
-
结合R16任务执行日志(输入/输出行数、耗时、错误堆栈),报表异常时可在3步内定位根因:字段删除?节点逻辑误配?权限变更导致数据截断?
-
-
低代码协同闭环嵌入
-
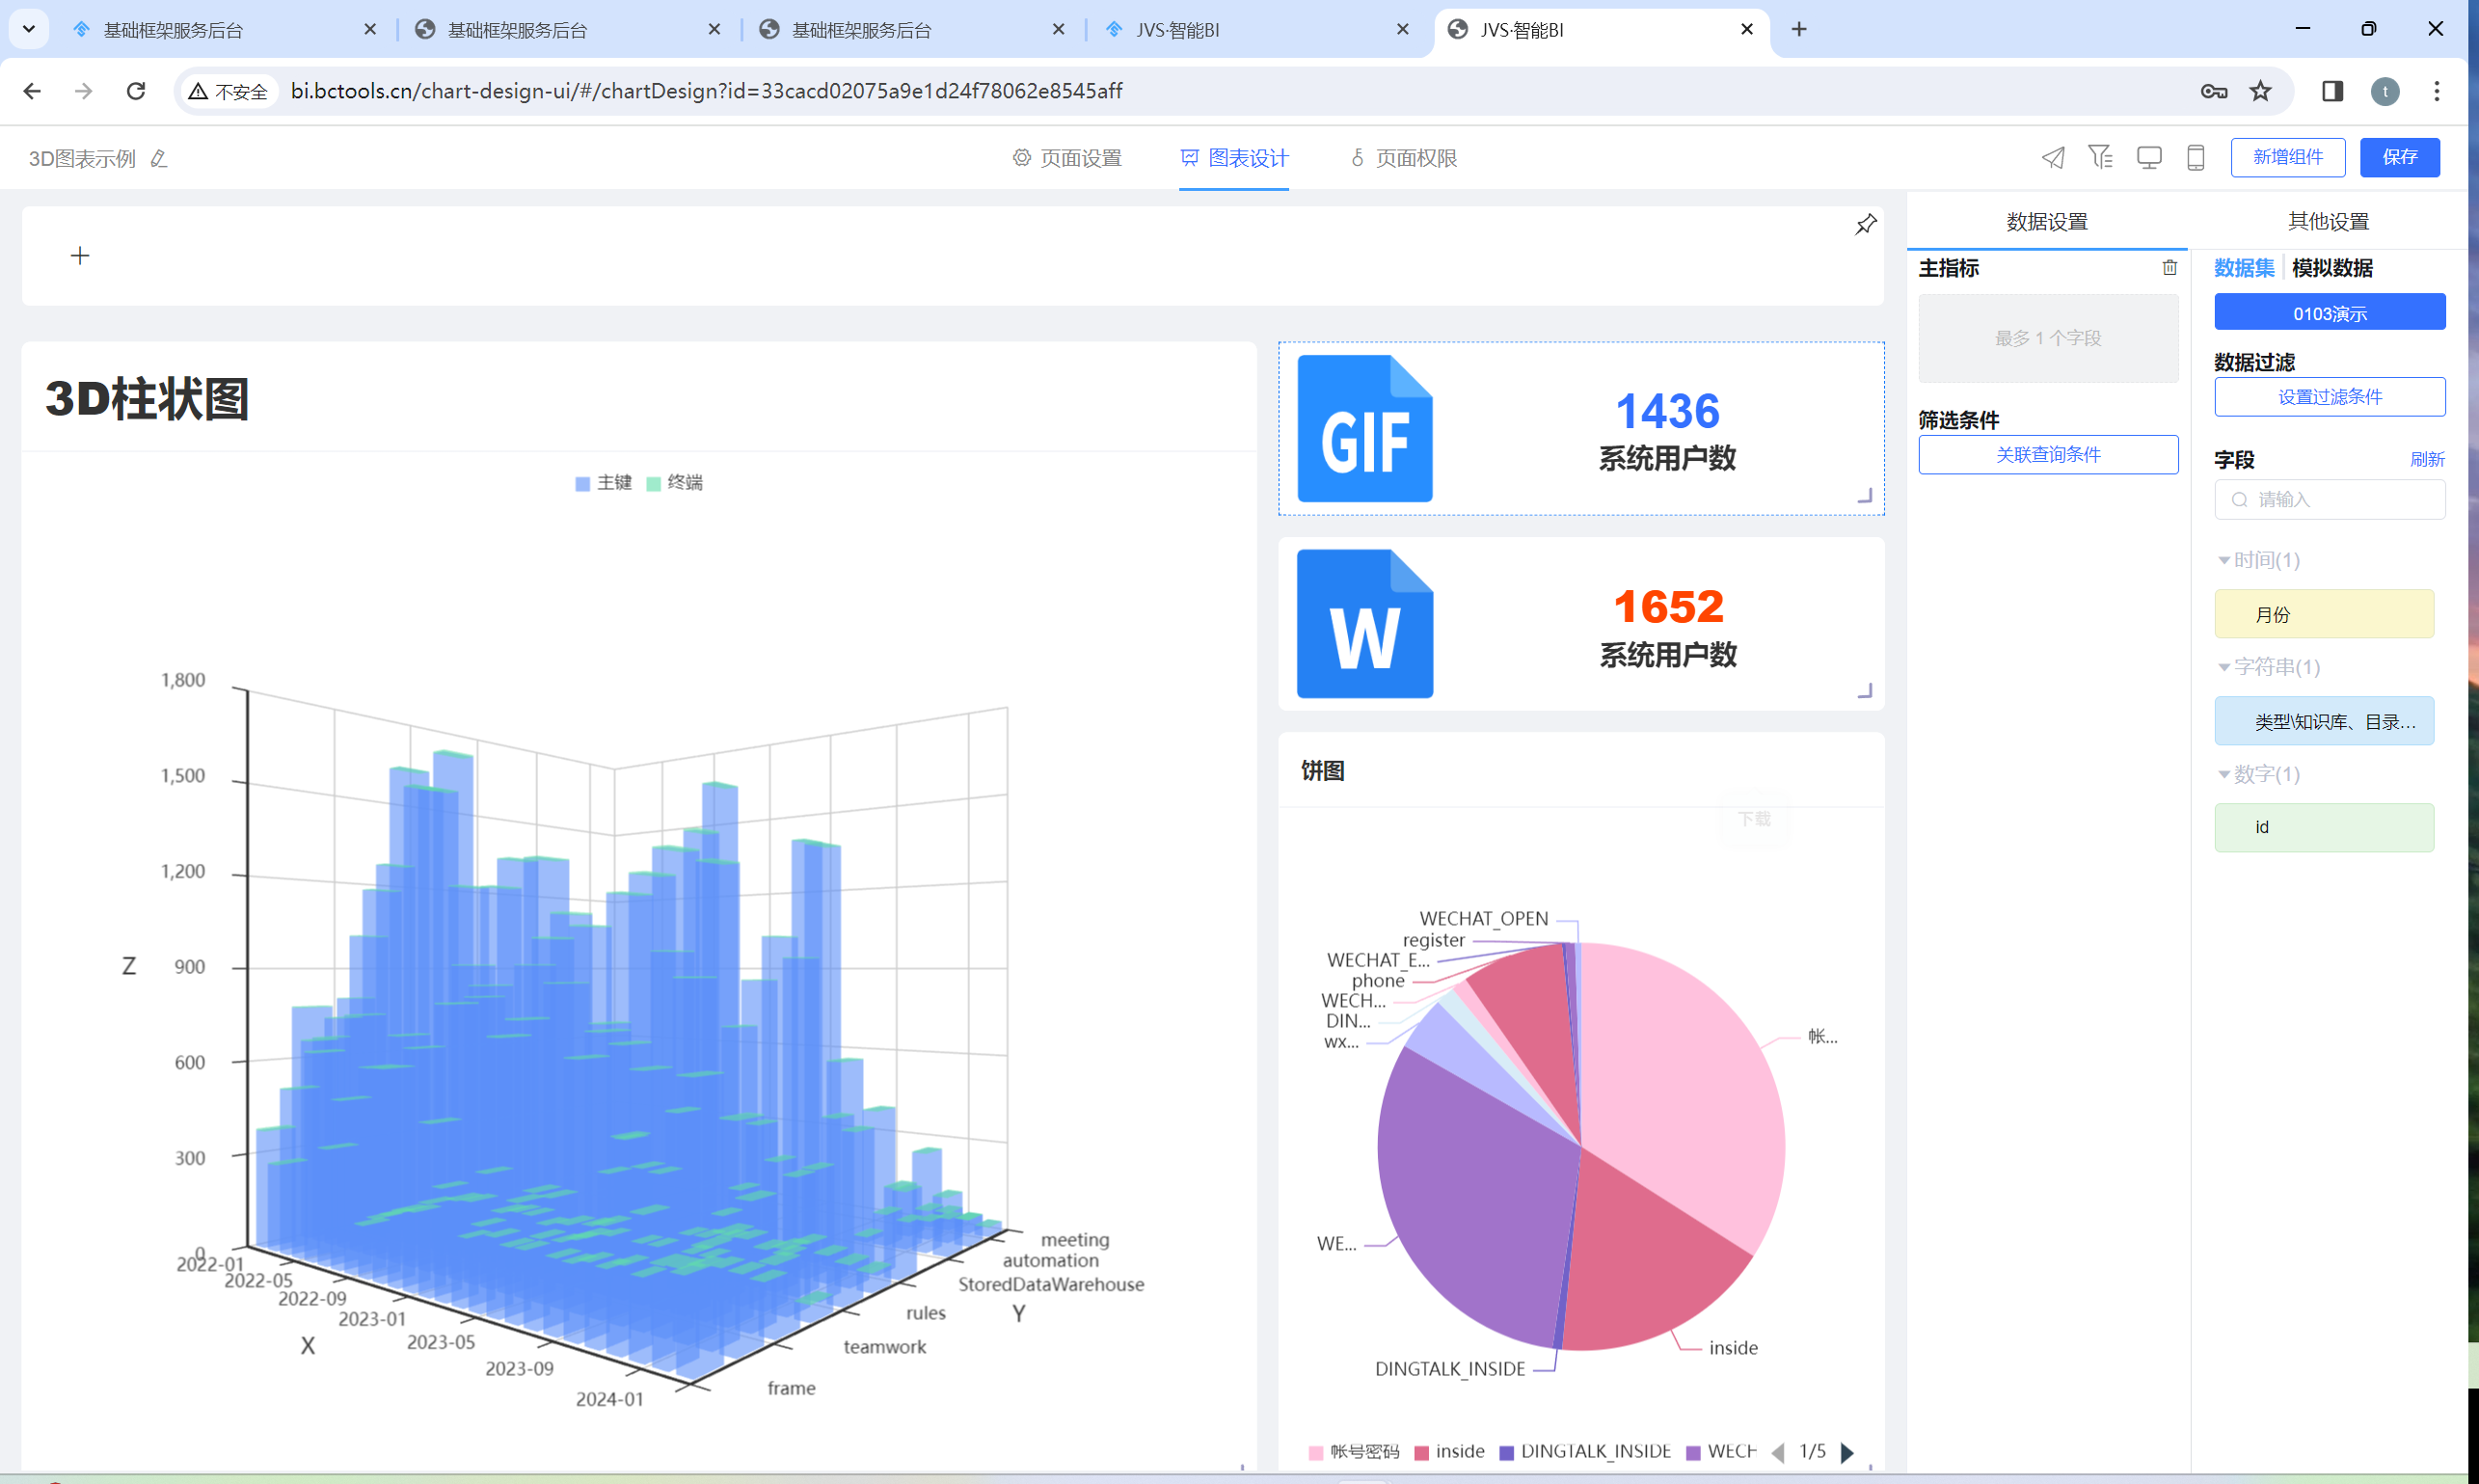
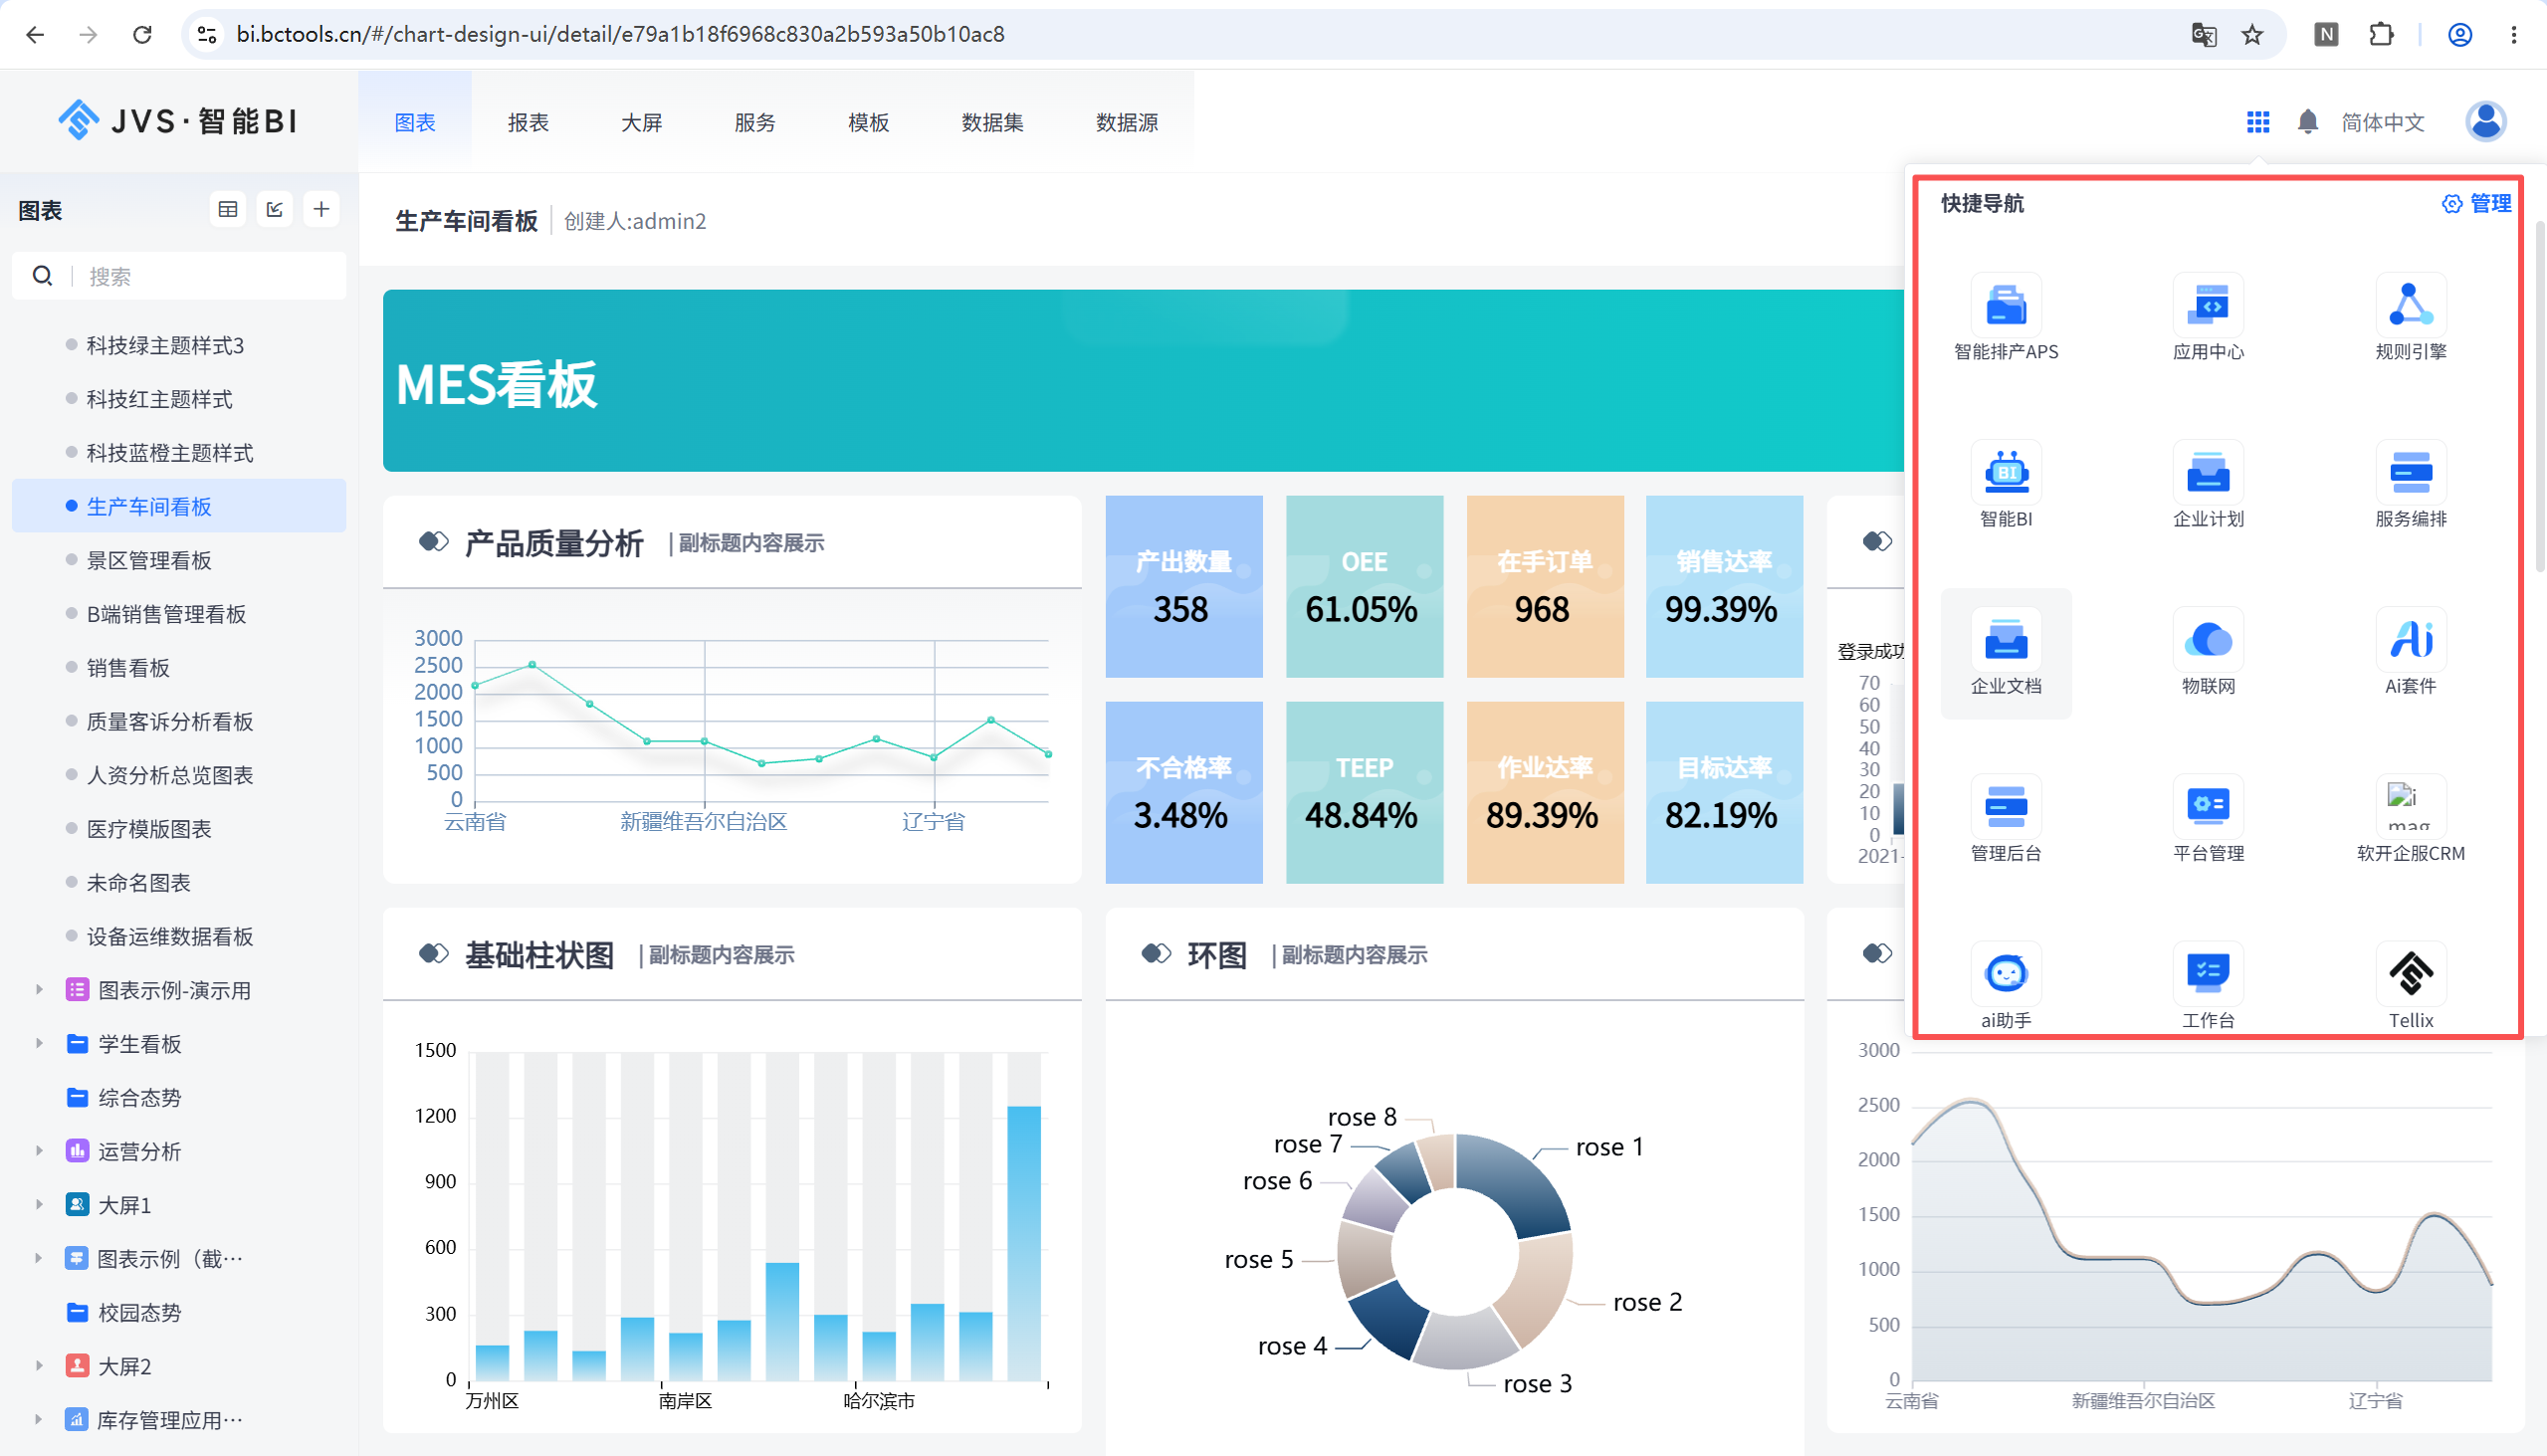
JVS-BI直连JVS低代码数据模型,新上线审批流、设备报修等应用,天然具备分析看板能力。
-
数据接入不再滞后于业务上线,实现'建即可见、用即有数'的正向反馈闭环。
-