记过账的人都有同感:真正让人放弃的不是算账,而是当天把账记完这一步。截图攒了一堆、发票拍了没整理,月底补记时早已想不起钱花在哪,月报永远停在月初。
常规的三种做法都不够用:记账 App 依赖手动选类目,一次录入要戳四五下;纯 OCR 工具只吐出金额和商户,归到哪类还得人判断;写死的规则引擎遇到「美团-晚餐-38.5」这种混合场景就失准。字段能识别,不等于账能记对。
本文分享一套可直接落地的记账链路:豆包 Seed Evolving 视觉抽取 + JSON Schema 强约束 + 校验回问纠错,从拍票到月报闭环,可直接落地。
一、需求拆解:记账链路最容易掉链子的三处
一笔账从拍票到进报表要过三道关,任何一道卡住都会让人弃用:
| 环节 | 传统做法的卡点 | Seed 方案的切入点 |
|---|---|---|
| 录入 | 手输四五步,容易拖延到月底 | 拍照/粘贴一键抽取,单次 1~2 秒 |
| 归类 | 规则匹配对混合描述失准 | 多模态理解上下文判断类目 |
| 复核 | 无校验,错账长期潜伏 | 金额/时间/类目三重硬校验 |
- 录入拖延:把动作压缩到「拍一张」,剩下的交给模型,用户的放弃成本才足够低。
- 归类失准:同一笔钱在不同平台叫法不同,静态关键词表永远追不上新商户。
- 复核缺位:错账不会自己浮出水面,必须在入库前就被拦下,而不是月底再对账。
**核心结论:**三个环节各装一个自动化闸口,记账才可能真正做到当天完成。
二、模型选型:豆包 Seed 担任主脑的三个理由
选主脑模型时我只看三件事,多模态票据理解、结构化输出稳定性、单位成本:
- 视觉理解:Seed Evolving 对小票、电子账单截图的字段定位稳,长条形小票也不丢行。
- 结构化输出 :支持
json_object与 Schema 约束,省掉大半正则清洗与容错分支。 - 成本延迟:单张票据一次抽取约 1~2 秒,日均百笔在按量计费下成本可忽略。
主链路固定成一条单向管道,任何一环失败都能单独重试:
拍照 → Seed 抽取 → 本地校验 → 写入流水 → 月报聚合
**核心结论:**模型负责理解与表达,钱和口径永远留在自己代码里算。
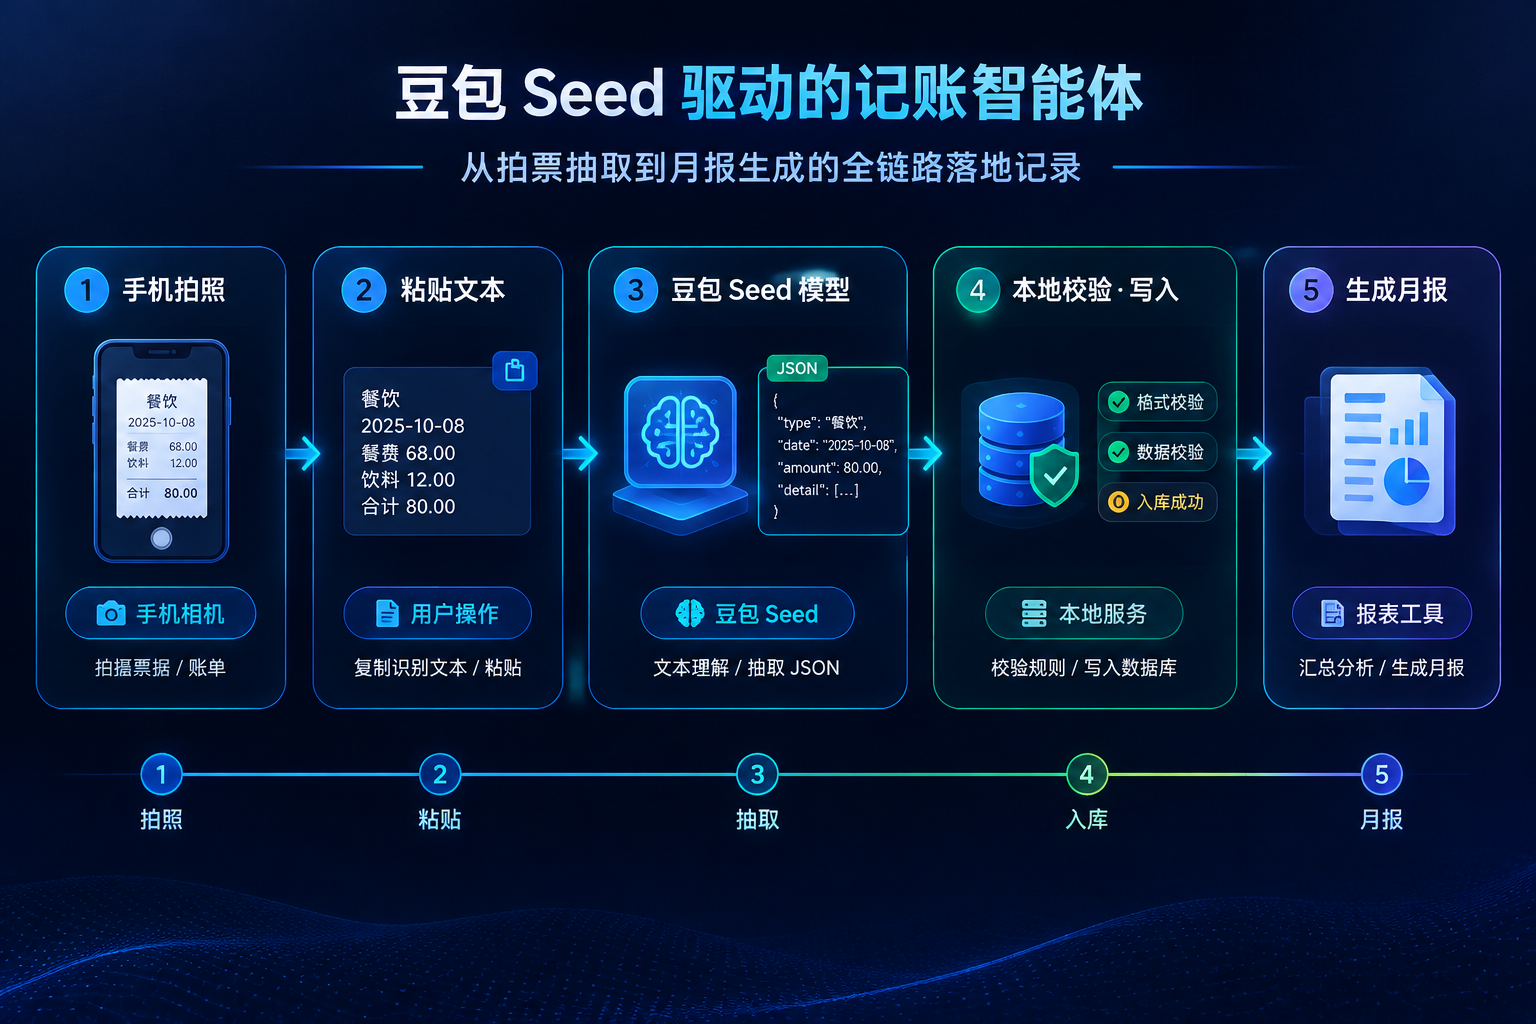
三、票据识别:图片到结构化流水的调用写法
抽取函数只做一件事,把图片交给豆包 Seed 拿回 JSON,这段代码用 Python 通过 OpenAI 兼容网关调用,适配主流大模型网关环境:
python
from openai import OpenAI

client = OpenAI(api_key=os.environ['ARK_API_KEY'],
                base_url='https://ark.cn-beijing.volces.com/api/v3')

def extract(image_b64: str) -> dict:
    resp = client.chat.completions.create(
        model='doubao-seed-evolving-vision',
        temperature=0,
        response_format={'type': 'json_object'},
        messages=[{'role': 'user', 'content': [
            {'type': 'image_url',
             'image_url': {'url': 'data:image/jpeg;base64,' + image_b64}},
            {'type': 'text',
             'text': '抽取商户、金额、时间、类目,只输出 JSON'}]}])
return json.loads(resp.choices[0].message.content)- 温度置 0:抽取是复现型任务,随机性只会污染金额和时间字段。
- 提示词点名字段:与 Schema 字段名保持一致,模型就不会输出解释性废话。
强约束生成 → 本地 Schema 校验 → 失败进重试队列 → 兜底转人工
四、字段约束:把金额与类目锁进 JSON Schema
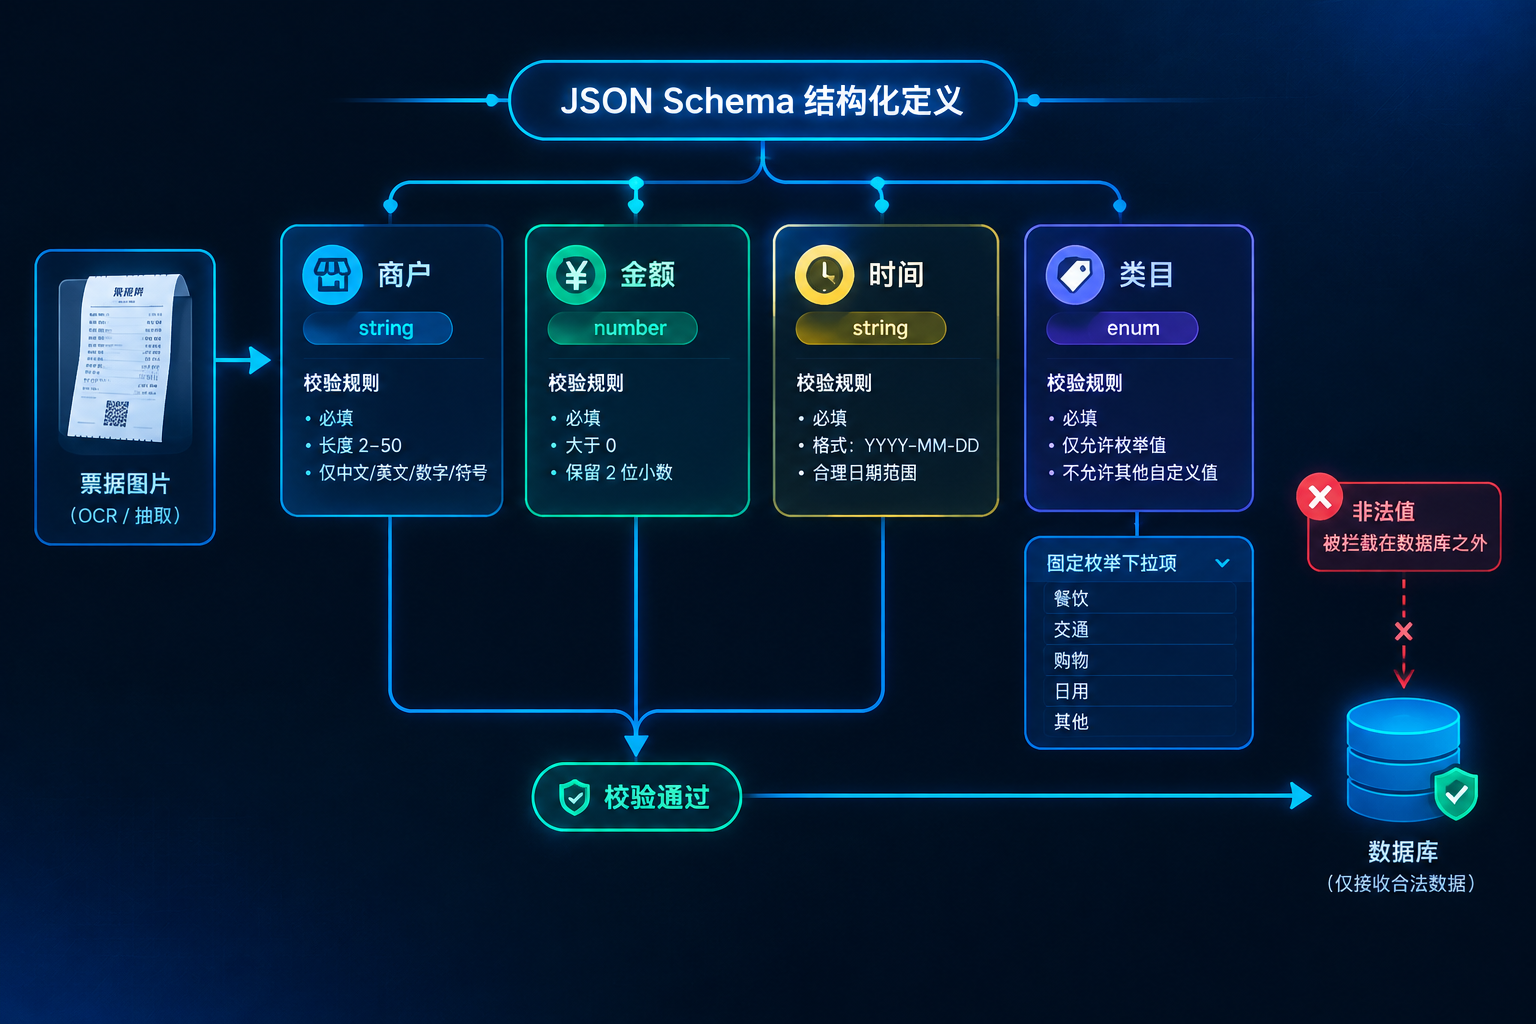
模型再聪明也要有围栏,四个关键字段的约束和兜底这样定:
| 字段 | 类型 | 校验规则 | 不通过时的兜底 |
|---|---|---|---|
| 商户 | string | 非空且不超过 40 字 | 截断后入库 |
| 金额 | decimal | 大于 0 且不超过 50000 | 转人工确认 |
| 时间 | datetime | 近 7 天内 | 默认取当天 |
| 类目 | enum | 24 个固定枚举 | 兜底为「其他」 |
- 枚举唯一真源:类目表在代码里只维护一份,提示词每次由模板渲染,避免与库表漂移。
- 金额守恒:明细项之和必须等于总额,差 0.01 元也拒绝入库。
**核心结论:**Schema 是给模型的软提示,代码里的校验器才是硬闸门。
五、多轮纠错:校验回问与有限次重写闭环
抽错不可避免,关键是把错误拦在入库之前,我用「校验---回喂---重写」三步收敛,这段代码演示校验失败就把错误原样喂回去、最多重写三次:
python
def parse_with_retry(text: str, budget: int = 3):
    for _ in range(budget):
        rec = json.loads(text)          # 1. 先按 JSON 解析
        errs = validate(rec)            # 2. 金额>0 / 时间近7天 / 类目在枚举
        if not errs:
            return rec
        text = ask_seed(                # 3. 把错误清单原样回喂
            f'修正这条流水,只回 JSON:{text}\n错误:{errs}')
return None # 4. 超预算转人工确认- 错误回喂:把校验器返回的错误清单原样塞回对话,比重新描述问题省一半 token。
- 重复判定:同商户同金额在 5 分钟内出现两次,先追问「是否已记过」再决定落库。
本地校验 → 错误回喂 → 有限次重写 → 兜底转人工
六、数据落库:流水表与分类字典的最小结构
本地库只保留两张表,足够支撑查询、回滚与月报聚合:
- 流水表 :
id、金额、商户、发生时间、类目、来源、原始报文,来源区分拍照、文本与语音。 - 分类字典:枚举值加父级分组,月报按父级汇总,改显示名不影响历史数据。
- 原始留档:模型返回的 JSON 原文单独存一列,回归评测时可以离线重放。
**核心结论:**保留原始报文,模型升级后能离线重跑,历史账不会被新口径悄悄改写。
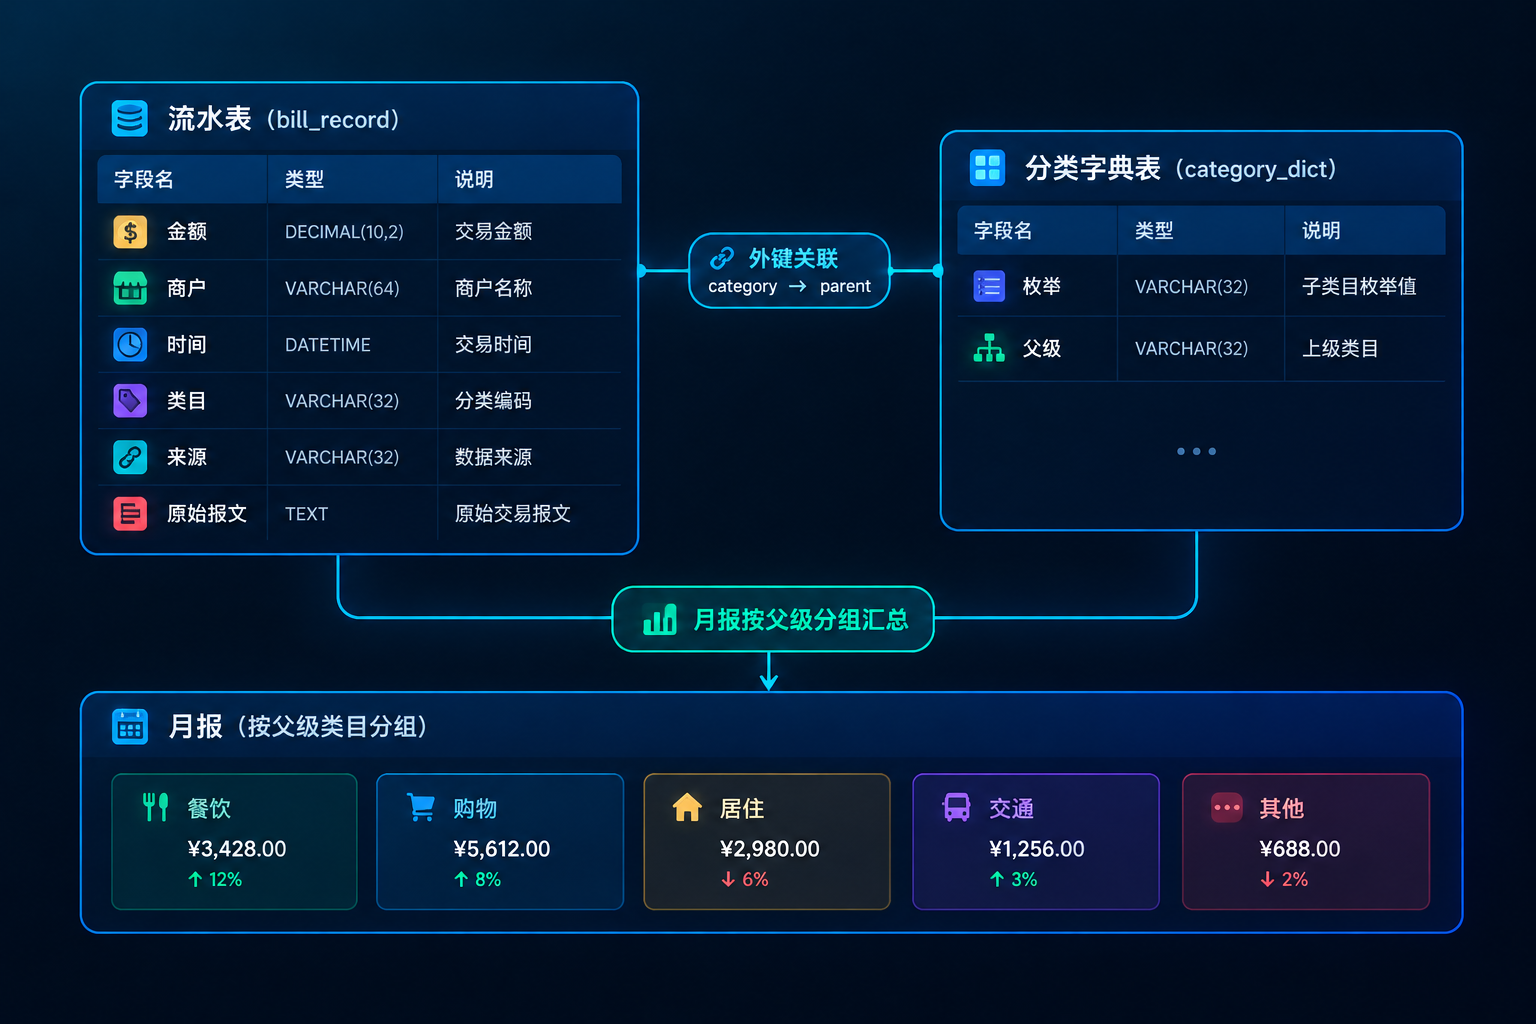
七、月报生成:先算后说的支出解读套路
月报不是把 sum() 打印出来就完事,Seed 在这里做的是归纳而不是计算:
- 先算后说:所有金额由 SQL 聚合产出,模型只拿统计结果写解读,从根上杜绝编造数字。
- 异常优先:环比超过 50% 的类目单独标记,作为解读的第一段,而不是流水账式罗列。
- 口径固定:提示词里写死「本月、上月、环比」的定义,避免模型自创算法口径。
**核心结论:**数字交给 SQL,观点交给模型,两者的边界不能越界。
八、评测回归:用固定样本集守住准确率
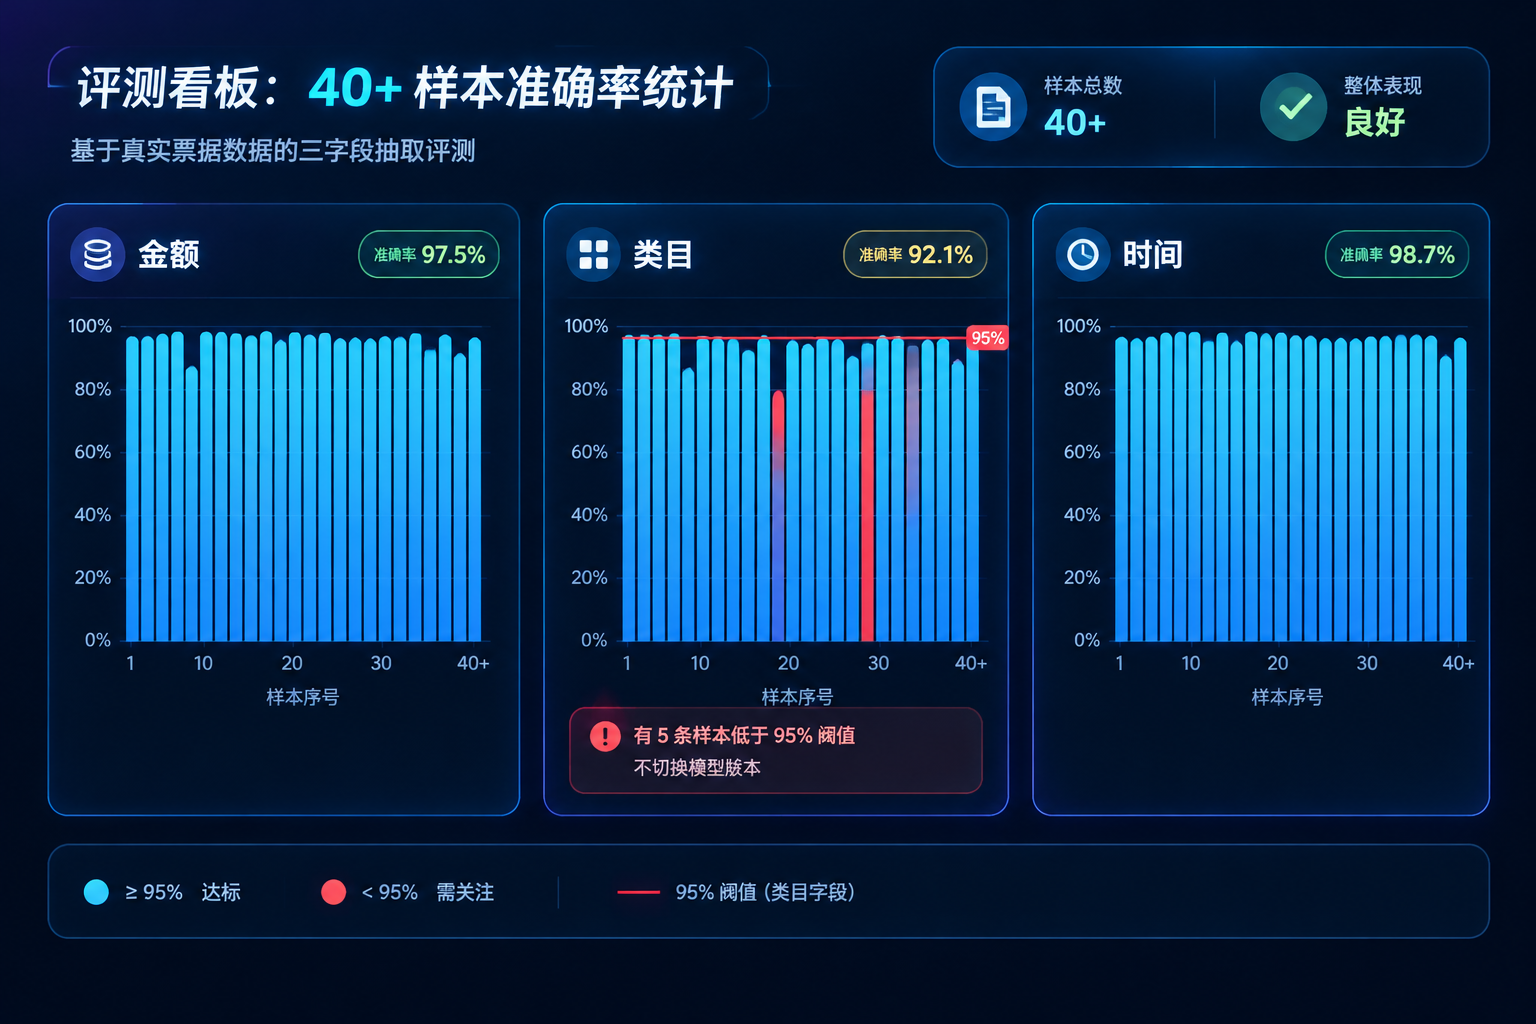
模型一升级,抽取结果可能悄悄变化,靠固定样本集守住底线,这段脚本按字段统计命中率,在本地跑一遍即可:
python
import json

cases = json.load(open('samples/eval.json'))   # 40 条固定票据样本
fields = ['amount', 'category', 'time']
stat = dict.fromkeys(fields, 0)

for c in cases:
    got = extract(c['image_b64'])
    for f in fields:
        stat[f] += (norm(got[f]) == norm(c['expect'][f]))

print({f: f'{v}/{len(cases)}' for f, v in stat.items()})- 分字段统计:金额、类目、时间分别看命中率,只报总分会掩盖类目漂移。
- 卡口前移:任一字段低于 95% 就不切新模型版本,宁可晚一周也不能错账。
分字段统计 → 任一字段低于 95% → 不切版本
九、踩坑排错:五个真实故障与定位手段
上线两个月踩过的坑,按现象到处置整理成排错表:
| 现象 | 定位手段 | 处置 |
|---|---|---|
| 金额取到折扣前价格 | 与原始报文逐字段对比 | 提示词写明取实付金额 |
| 切换模型后类目漂移 | 样本集分类差异对比 | 锁版本 + 双跑一周再切 |
| 长截图字段丢失 | 查输入 token 告警日志 | 长边等比缩到 2048 |
| 月报环比算错 | 回查 SQL 聚合口径 | 坚持先算后说 |
| 同一笔重复入账 | 库内同商户同金额探测 | 5 分钟窗口先追问 |
- 优先留痕 :每次抽取都记录
request_id与原始报文,事后能完整回放定位。
**核心结论:**能回放的问题都不是问题,回放不了的问题才最贵。
十、上线迭代:灰度、成本控制与后续计划
真正上线要考虑的不只是功能,还有可回滚和可计量,落地节奏按三步走:
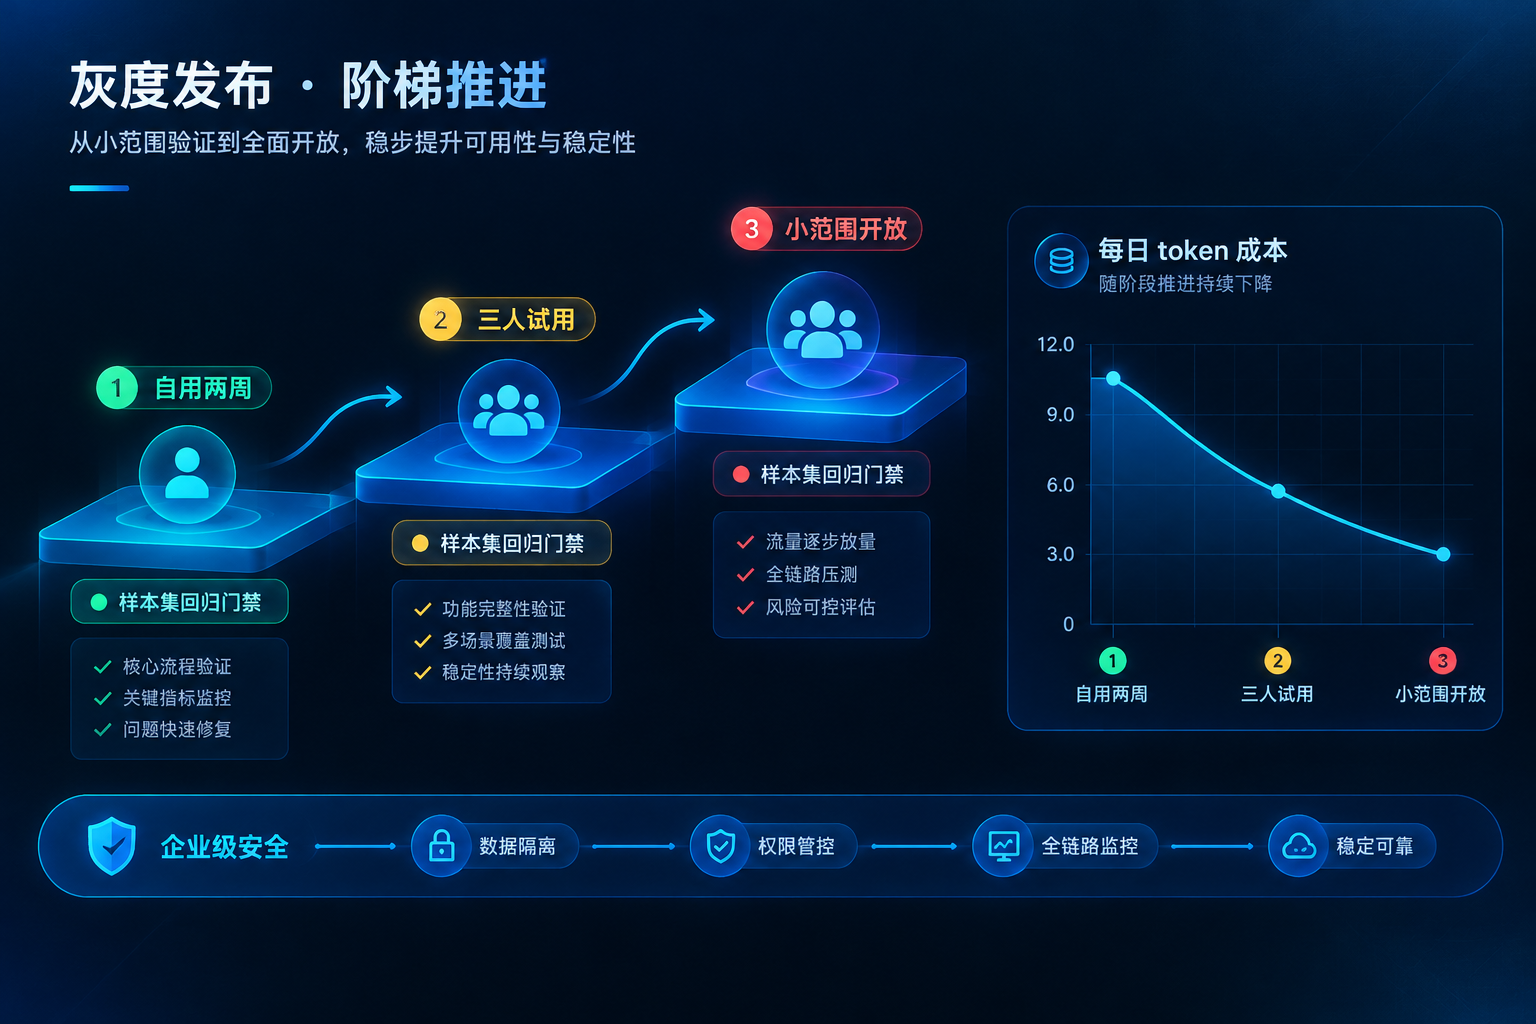
- 灰度三步:自己记两周 → 3 位朋友试用 → 小范围开放,每一步都先过样本集回归。
- 成本看板:按调用次数与 token 用量每日汇总,单用户月成本控制在 1 元以内。
- 下一步:接入银行短信解析与订阅扣款识别,把「被动拍票」升级成「主动提醒」。
**核心结论:**先让链路可回滚,再谈功能扩张,个人项目的容错比企业项目更脆弱。
结语
这套链路的价值在于把「记账」拆成了可独立验收的五段:抽取有 Schema 约束,纠错有有限次重写,落库有硬校验,月报先算后说,升级有样本集卡口。每一段都能单独替换实现,模型换了也不影响其余环节,个人开发者照着表结构和脚本可以直接搭起来。
更重要的是它给出了一个可复制的工程姿势:模型负责理解世界,代码负责守住边界。记账如此,任何要和真实数据打交道的 AI 应用也如此。