文章目录
- 前言
- 一、实验环境与验证思路
-
- [1.1 环境信息](#1.1 环境信息)
- [1.2 我准备验证什么](#1.2 我准备验证什么)
- [1.3 操作位置和测试前检查](#1.3 操作位置和测试前检查)
- [二、准备 sys_repair 与实验数据](#二、准备 sys_repair 与实验数据)
-
- [2.1 确认扩展和基础参数](#2.1 确认扩展和基础参数)
- [2.2 准备密码文件和服务环境](#2.2 准备密码文件和服务环境)
- [2.3 检查普通连接和复制认证](#2.3 检查普通连接和复制认证)
- [2.4 建立 10000 行样本和基线](#2.4 建立 10000 行样本和基线)
- [2.5 记录文件位置并导出校验数据](#2.5 记录文件位置并导出校验数据)
- [2.6 留下故障前的健康检查结果](#2.6 留下故障前的健康检查结果)
- 三、建立用于取页修复的物理备库
-
- [3.1 备份并启动备库](#3.1 备份并启动备库)
- [3.2 确认备库数据可作为修复来源](#3.2 确认备库数据可作为修复来源)
- 四、离线制造单页故障并扫描
-
- [4.1 冷备之后,再修改实验页](#4.1 冷备之后,再修改实验页)
- [4.2 普通查询和 sys_repair 扫描](#4.2 普通查询和 sys_repair 扫描)
- 五、先保护健康数据,再修复坏页
-
- [5.1 使用 get_health_row 保存正常行](#5.1 使用 get_health_row 保存正常行)
- [5.2 连接参数的实际排错](#5.2 连接参数的实际排错)
- [5.3 执行 repair_page](#5.3 执行 repair_page)
- 六、CHECKPOINT、全量比较与重启验证
-
- [6.1 为什么修复后扫描仍然是 f](#6.1 为什么修复后扫描仍然是 f)
- [6.2 比较完整数据,而不只比较行数](#6.2 比较完整数据,而不只比较行数)
- [6.3 重启后再检查一次](#6.3 重启后再检查一次)
- 七、失败时如何回退
- 八、总结
前言
这次继续体验一下金仓数据库,准备把"坏块检测与修复"完整测一遍。
测试目标比较明确:先准备一张正常的表和一套物理备库,再人为损坏主库的一个数据页,观察普通查询和坏块扫描的表现。随后把健康数据保存下来,从备库取正常页修复,最后做完整数据比较和重启验证。
本次使用 KingbaseES V009R002C016PS003,Oracle 兼容模式。过程里主要踩了两个坑:一是修复连接的参数和密码文件没有按插件实际使用方式配置;二是修复提示成功、查询也恢复了,马上扫描却还是返回 f。下面把环境准备、实际命令、报错和处理过程一起记录下来。
最终结果是:人为损坏实验表的一个 8 KB 数据页后,先保存了 9973 行健康数据,再从物理备库获取正常页进行修复,恢复全部 10000 行;执行检查点并重启数据库后,表级、库级扫描均通过,完整导出文件也与原始基线一致。
一、实验环境与验证思路
1.1 环境信息
| 项目 | 本次环境 |
|---|---|
| 操作系统 | UOS Server 20 1060e,x86_64 |
| 数据库版本 | KingbaseES V009R002C016PS003 |
| 兼容模式 | Oracle |
| 字符集 / 大小写 | UTF8 / 大小写敏感 |
| 存储块大小 | 8192 字节 |
| 数据校验和 | data_checksums = on |
| 程序目录 | /KingbaseES/V9/Server/bin |
| 主库 | /data,端口 54321 |
| 物理备库 | /data_kva_standby,端口 54322 |
| 数据库 / 管理用户 | test / system |
| 扩展 | sys_repair 1.0 |
| 实验模式 | repair_case |
| 证据与备份目录 | /home/kingbase/sysrepair_manual |
1.2 我准备验证什么
实验分为五步:建立原始数据基线;搭建物理备库;离线损坏主库实验表的一个页;扫描坏块并保存健康行;从备库修复后,复扫、比较数据并重启验证。这里特意做了"健康数据保护"这个环节,因为发生故障时,能先读取并保存正常数据,本身就很有价值。
1.3 操作位置和测试前检查
| 操作位置 | 执行内容 | 识别方式 |
|---|---|---|
| Linux root 终端 | 创建目录、systemd 服务管理、停库后的物理备份和故障注入 | whoami 返回 root |
| Linux kingbase 终端 | ksql、sys_basebackup、sys_ctl、CSV 比较 | whoami 返回 kingbase |
| 主库 ksql | 建表、配置、坏块扫描、修复和 CHECKPOINT | SHOW port; 返回 54321 |
| 备库 ksql | 检查恢复状态、回放位置、正常数据和页来源 | 端口 54322,sys_is_in_recovery() 返回 t |
root 切换到数据库操作系统用户:
bash
su - kingbaseroot 先检查本机环境、磁盘空间和端口:
bash
hostname
id kingbase
df -h /data /home/kingbase
ss -lntp | grep -E ':(54321|54322)\b'
systemctl status kingbased --no-pager
开始时主库 54321 应正常运行,54322 应未被其他实例使用。需要同时为备库数据、主库冷备和导出文件预留空间。
二、准备 sys_repair 与实验数据
2.1 确认扩展和基础参数
使用 kingbase 用户连接主库:
bash
/KingbaseES/V9/Server/bin/ksql -h 127.0.0.1 -p 54321 -U system -d test -W先确认连接目标和扩展状态:
sql
\pset pager off
SELECT version();
SHOW data_directory;
SHOW port;
SHOW block_size;
SHOW data_checksums;
SHOW shared_preload_libraries;

SELECT extname, extversion
FROM sys_extension
WHERE extname = 'sys_repair';
本次环境已经预加载 sys_repair,并在 test 库安装了扩展,查询结果为 sys_repair | 1.0。复现前先备份实际使用的数据库配置文件,记录原有预加载、复制和修复参数,方便实验后恢复。
预加载列表也要核对。本次环境使用了 sys_repair 预加载;如果你的环境需要调整,应在原有 shared_preload_libraries 列表中保留其他有效组件、加入 sys_repair,并去除冲突的 auto_bmr,由 root 重启数据库后重新检查。不要直接覆盖整串配置,导致原有插件丢失。官方插件说明明确说明这两个修复组件不能同时开启。
完成上述检查后,如果 test 库尚未安装扩展,在主库执行:
sql
CREATE EXTENSION IF NOT EXISTS sys_repair;
\dx sys_repair
\df repair_page另外,data_checksums 在本次必须为 on,block_size 必须为 8192。若与你的结果不同,先准备符合条件的独立实验实例;校验和不是通过这里的 ALTER SYSTEM 临时打开的。后续参数和输出均以本文的 C16PS003 安装包为准。
为了观察手工修复过程,我关闭自动页修复,并保持 zero_damaged_pages = off,避免通过置零坏页丢弃其中的数据:
sql
ALTER SYSTEM SET wal_level = 'replica';
ALTER SYSTEM SET max_wal_senders = 10;
ALTER SYSTEM SET max_replication_slots = 10;
ALTER SYSTEM SET full_page_writes = on;
ALTER SYSTEM SET synchronous_standby_names = '';
ALTER SYSTEM SET zero_damaged_pages = off;
ALTER SYSTEM SET sys_repair.enable_auto_repair_page = off;
ALTER SYSTEM SET sys_repair.sys_repair_conninfo = '127.0.0.1:54322';
2.2 准备密码文件和服务环境
root 用户创建实验目录和空的备库目录,目录归 kingbase 用户所有:
bash
install -d -o kingbase -g kingbase -m 700 /home/kingbase/sysrepair_manual
install -d -o kingbase -g kingbase -m 700 /data_kva_standby
随后使用 kingbase 用户编辑 /home/kingbase/sysrepair_manual/db.pass,写入下面两条记录。密码占位符需替换为实际值,包含冒号或反斜杠时需要按密码文件规则转义;不要把密码内容截图上传。
text
127.0.0.1:54321:*:system:<数据库 system 用户密码>
127.0.0.1:54322:*:system:<数据库 system 用户密码>
bash
chmod 600 /home/kingbase/sysrepair_manual/db.pass修复连接由数据库服务进程发起,所以只在登录终端中设置环境变量还不够。我使用 root 给 systemd 服务添加配置:
bash
mkdir -p /etc/systemd/system/kingbased.service.d
cat > /etc/systemd/system/kingbased.service.d/90-sysrepair-passfile.conf <<'EOF'
[Service]
Environment="KINGBASE_PASSFILE=/home/kingbase/sysrepair_manual/db.pass"
EOF

systemctl daemon-reload
systemctl restart kingbased
systemctl is-active kingbased
服务状态为 active。重新用 kingbase 连接主库,检查参数已经生效:
sql
SHOW wal_level;
SHOW max_wal_senders;
SHOW max_replication_slots;
SHOW full_page_writes;
SHOW zero_damaged_pages;
SHOW sys_repair.enable_auto_repair_page;
SHOW sys_repair.sys_repair_conninfo;
预期分别为 replica、10、10、on、off、off 和 127.0.0.1:54322。
2.3 检查普通连接和复制认证
本次已有密码认证规则可以使用。新环境还需检查认证文件的位置:
sql
SHOW hba_file;例如本机使用 /data/sys_hba.conf 时,先保留原文件,再按现有配置补充规则。下面是只允许本机回环地址的示例:
text
host    test           system    127.0.0.1/32    scram-sha-256
host    replication    system    127.0.0.1/32    scram-sha-256
第二条用于物理复制,system 用户还需要具备复制权限。认证规则按第一条命中项执行,要检查它们与现有 reject、其他认证规则的顺序。这里沿用密码认证,无需改成 trust。
在 Linux 上修改认证文件后,可在主库执行:
sql
SELECT sys_reload_conf();密码文件除了权限为 600,还要确保归数据库服务运行用户所有。root 可以核对:
bash
chown kingbase:kingbase /home/kingbase/sysrepair_manual/db.pass
chmod 600 /home/kingbase/sysrepair_manual/db.pass
ls -ld /home/kingbase/sysrepair_manual
ls -l /home/kingbase/sysrepair_manual/db.pass
只检查路径、属主和权限即可,不要用 cat 把密码打印到操作记录里。
2.4 建立 10000 行样本和基线
重新连接主库,创建一张不带索引的实验表,并关闭该表自动清理,减少实验过程中不必要的变化:
sql
CREATE SCHEMA repair_case;

CREATE TABLE repair_case.demo (
    id integer NOT NULL,
    payload text NOT NULL
) WITH (autovacuum_enabled = false);

INSERT INTO repair_case.demo
SELECT g, repeat(md5(g::text), 8)
FROM generate_series(1, 10000) AS s(g);

SELECT count(*) FROM repair_case.demo;

CREATE TABLE repair_case.baseline AS
SELECT * FROM repair_case.demo;
结果为 10000 行。接着提前记录第 5 号页上的行。这里块号从 0 开始,第 5 号页对应文件中的第六个 8 KB 块:
sql
CREATE TABLE repair_case.target_page_ids AS
SELECT id
FROM repair_case.demo
WHERE ctid::text LIKE '(5,%';

SELECT count(*) AS rows_on_page_5,
       min(id) AS first_id,
       max(id) AS last_id
FROM repair_case.target_page_ids;
我的实际结果是 27 行,id 为 136~162。这是本次样本的页分布,不应把这些数字当成其他环境的固定结果。
这里踩过一个兼容模式的小坑:最初想用 trim(both '()' from ctid::text) 去掉括号,Oracle 兼容模式报了 trim set should have only one character。后来直接使用页号前缀匹配。
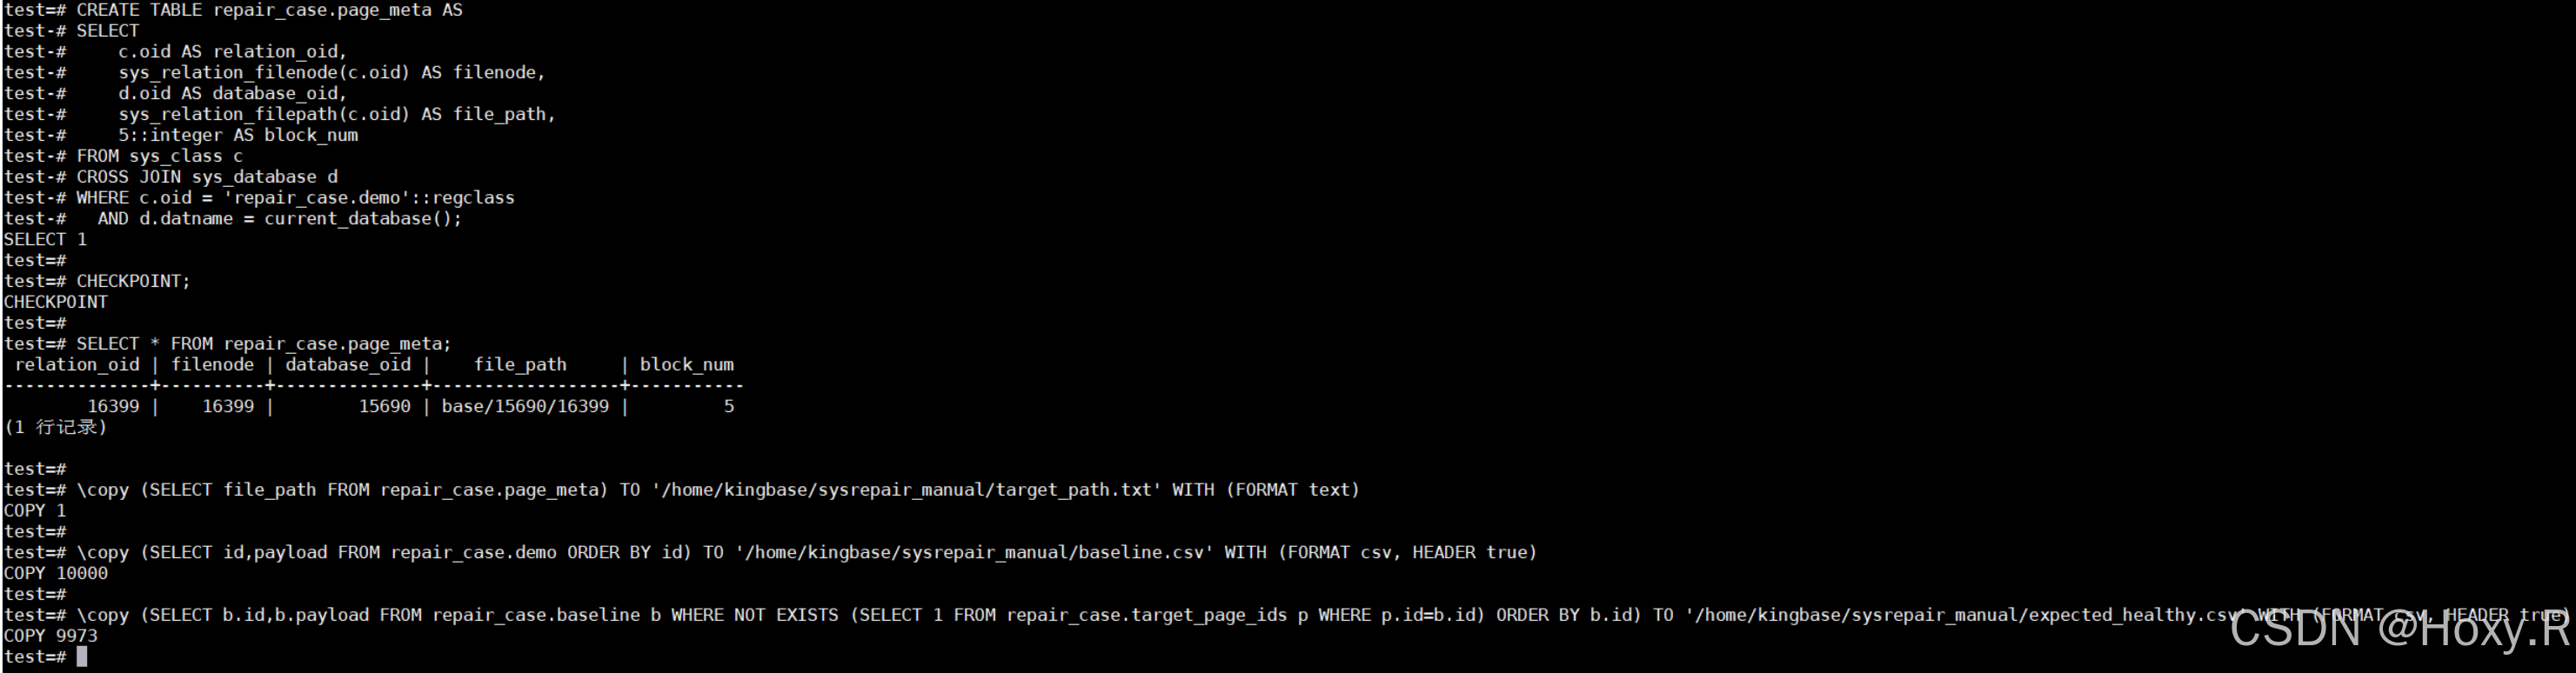
2.5 记录文件位置并导出校验数据
sql
CREATE TABLE repair_case.page_meta AS
SELECT c.oid AS relation_oid,
       sys_relation_filenode(c.oid) AS filenode,
       d.oid AS database_oid,
       sys_relation_filepath(c.oid) AS file_path,
       5::integer AS block_num
FROM sys_class c
CROSS JOIN sys_database d
WHERE c.oid = 'repair_case.demo'::regclass
  AND d.datname = current_database();

SELECT * FROM repair_case.page_meta;
CHECKPOINT;
本次记录为:关系 OID 和文件节点均为 16399,数据库 OID 为 15690,相对文件路径为 base/15690/16399。
以下三条 \copy 分别整行执行:
sql
\copy (SELECT file_path FROM repair_case.page_meta) TO '/home/kingbase/sysrepair_manual/target_path.txt' WITH (FORMAT text)
\copy (SELECT id,payload FROM repair_case.demo ORDER BY id) TO '/home/kingbase/sysrepair_manual/baseline.csv' WITH (FORMAT CSV, HEADER true)
\copy (SELECT b.id,b.payload FROM repair_case.baseline b WHERE NOT EXISTS (SELECT 1 FROM repair_case.target_page_ids p WHERE p.id=b.id) ORDER BY b.id) TO '/home/kingbase/sysrepair_manual/expected_healthy.csv' WITH (FORMAT CSV, HEADER true)
完整基线为 10000 行;排除目标页 27 行后,预期健康数据为 9973 行。
2.6 留下故障前的健康检查结果
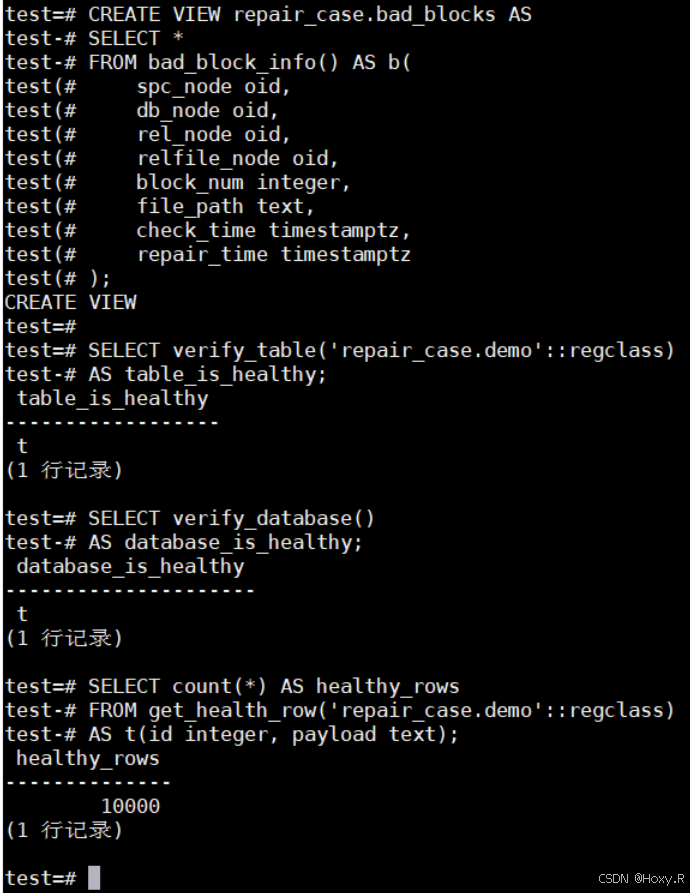
bad_block_info() 返回记录集合,需要按实际返回列定义查看。本次先创建视图,再记录故障前的扫描结果:
sql
CREATE VIEW repair_case.bad_blocks AS
SELECT *
FROM bad_block_info() AS b(
    spc_node oid,
    db_node oid,
    rel_node oid,
    relfile_node oid,
    block_num integer,
    file_path text,
    check_time timestamptz,
    repair_time timestamptz
);

SELECT verify_table('repair_case.demo'::regclass) AS table_is_healthy;
SELECT verify_database() AS database_is_healthy;
SELECT count(*) AS healthy_rows
FROM get_health_row('repair_case.demo'::regclass)
AS t(id integer, payload text);
结果分别为 t、t、10000。这里 verify_database() 检查的是当前连接的 test 数据库。
三、建立用于取页修复的物理备库
3.1 备份并启动备库
先在主库检查计划使用的复制槽名称:
sql
SELECT slot_name, slot_type, active
FROM sys_replication_slots
WHERE slot_name = 'kva_sysrepair_slot';
\q
全新实验应没有同名记录。如果有,要先核对归属,不能直接删除后继续。随后在 kingbase 用户的 Linux 终端确认目录为空:
bash
test -d /data_kva_standby
test -z "$(ls -A /data_kva_standby)"
检查通过后执行基础备份:
bash
/KingbaseES/V9/Server/bin/sys_basebackup \
  -d "host=127.0.0.1 port=54321 user=system passfile=/home/kingbase/sysrepair_manual/db.pass application_name=kva_standby" \
  -D /data_kva_standby -Fp -X stream -R -P -c fast \
  -C -S kva_sysrepair_slot -w
完成后检查并调整 /data_kva_standby/kingbase.auto.conf,保留备份生成的恢复配置,确保下列配置最终生效:
ini
data_directory = '/data_kva_standby'
port = 54322
listen_addresses = '127.0.0.1'
hot_standby = on
cluster_name = 'kva_sysrepair_standby'
external_pid_file = ''
primary_conninfo = 'host=127.0.0.1 port=54321 user=system passfile=/home/kingbase/sysrepair_manual/db.pass application_name=kva_standby'
primary_slot_name = 'kva_sysrepair_slot'
synchronous_standby_names = ''
sys_repair.sys_repair_conninfo = ''
sys_repair.enable_auto_repair_page = off
bash
/KingbaseES/V9/Server/bin/sys_ctl \
  -D /data_kva_standby \
  -l /home/kingbase/sysrepair_manual/standby-startup.log \
  -w -t 120 start
3.2 确认备库数据可作为修复来源
主库中查看复制状态,并保存一个 WAL 位置:
sql
SELECT application_name, state, sync_state, sent_lsn, replay_lsn
FROM sys_stat_replication;

SELECT sys_current_wal_lsn() AS target_lsn
\gset

\connect test system 127.0.0.1 54322

SHOW port;
SHOW data_directory;
SELECT sys_is_in_recovery();
SELECT sys_last_wal_replay_lsn() >= :'target_lsn' AS replay_caught_up;
SELECT verify_table('repair_case.demo'::regclass);
SELECT count(*) FROM repair_case.demo;
主库显示 kva_standby | streaming | async;备库端口为 54322,恢复状态、追平检查和表扫描均为 t,数据为 10000 行。追平检查如果为 f,需要等待后重新查询。
我还从备库导出了同样排序的完整数据:
sql
\copy (SELECT id,payload FROM repair_case.demo ORDER BY id) TO '/home/kingbase/sysrepair_manual/standby.csv' WITH (FORMAT CSV, HEADER true)
bash
cmp /home/kingbase/sysrepair_manual/baseline.csv /home/kingbase/sysrepair_manual/standby.csv比较一致后,才开始制造故障。备库在后续过程中保持运行,不做提升操作。
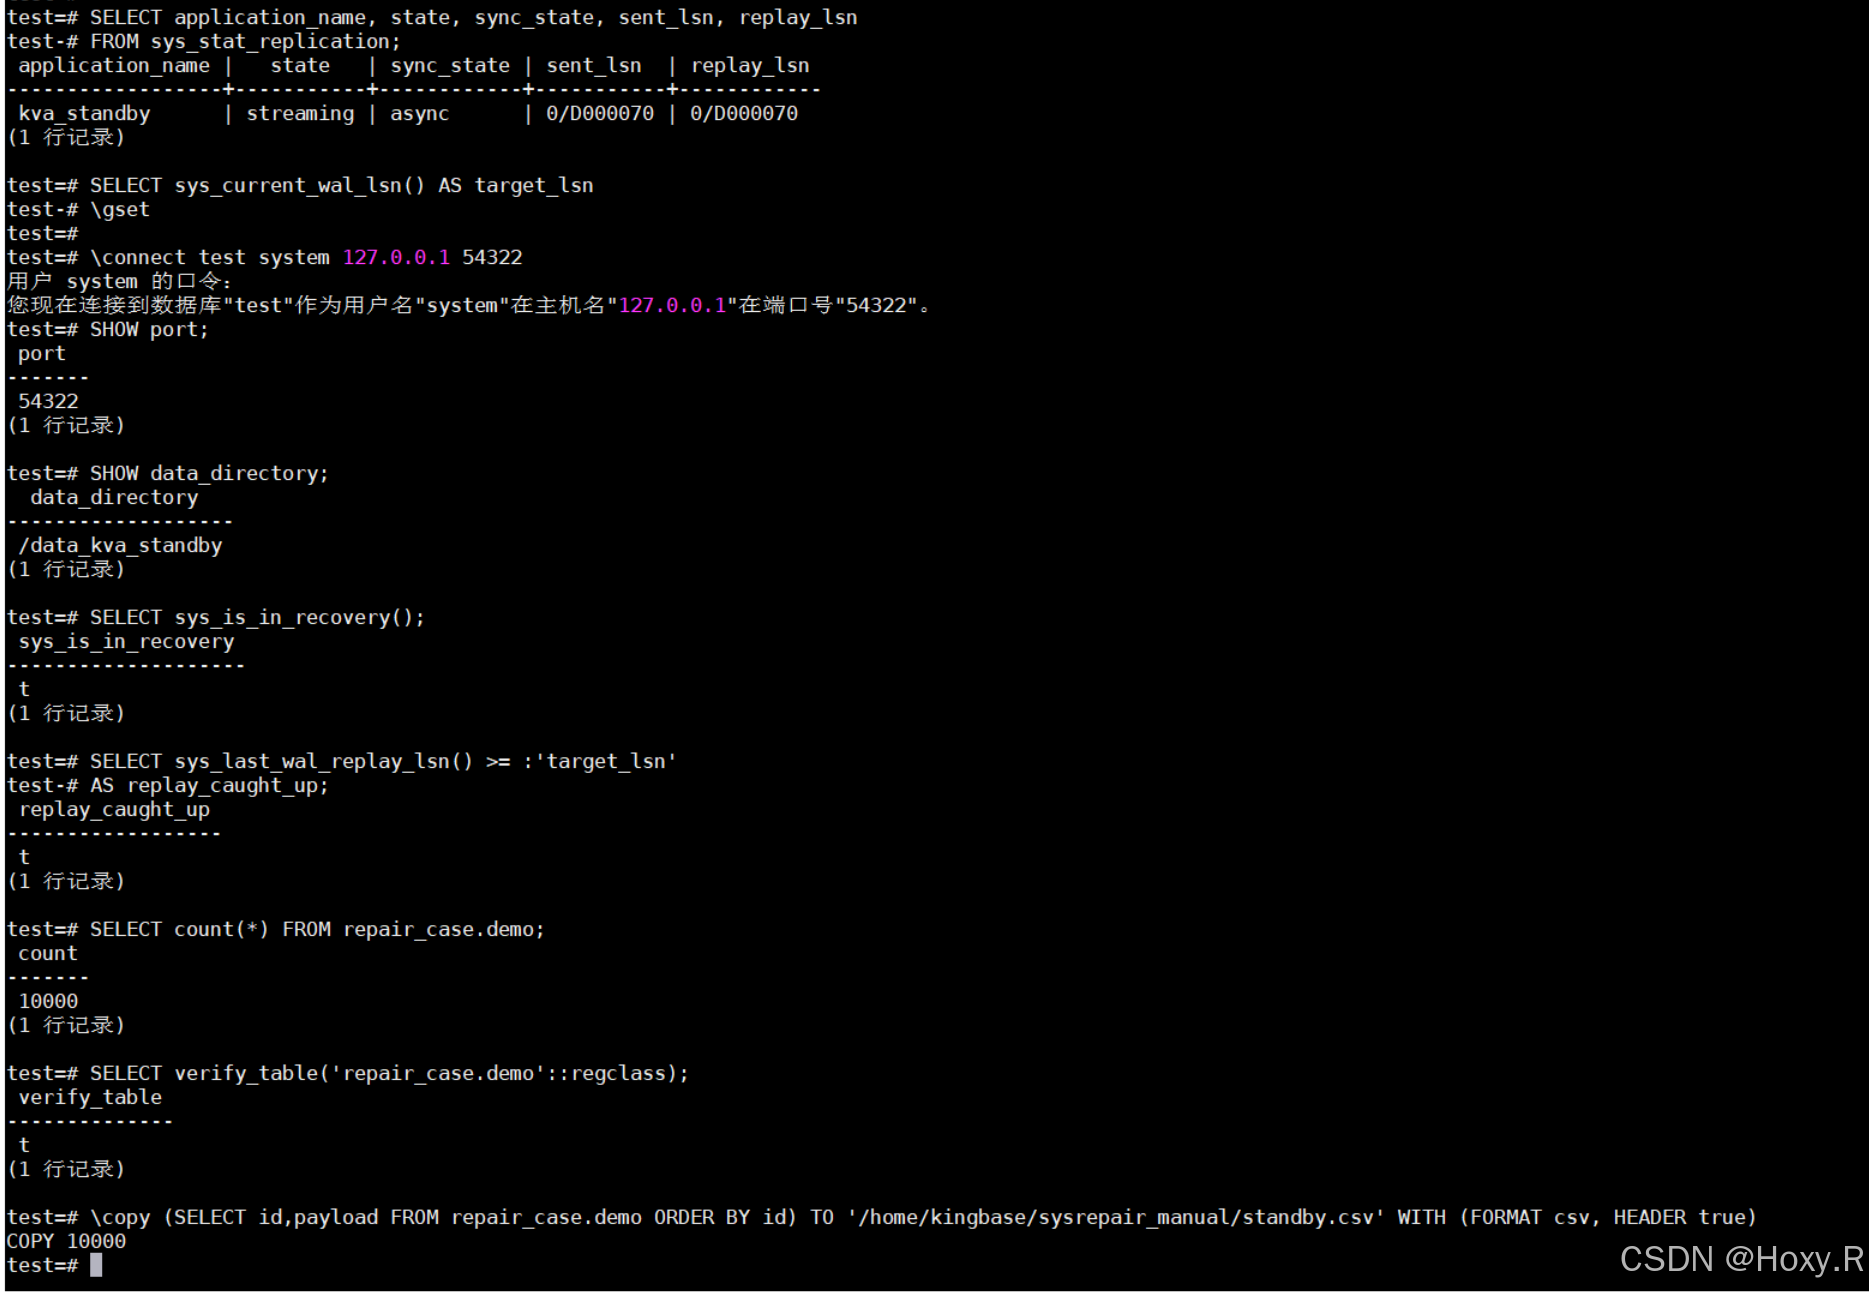
这一阶段的通过条件:主库能看到streaming连接;备库处于恢复状态;WAL 已追平;备库表扫描为 t;完整 CSV 与主库基线一致。
四、离线制造单页故障并扫描
4.1 冷备之后,再修改实验页
先退出数据库连接,root 停止主库服务,并确认状态为 inactive、主库 PID 文件不存在:
bash
systemctl stop kingbased
systemctl is-active kingbased
test ! -e /data/kingbase.pid
本次只修改 repair_case.demo 对应的文件。下面保留了路径核对、停库状态、冷备、原始页保存和读回验证;其中的文件路径只适用于本文这一套实验数据,其他环境必须重新查询并核对:
bash
# root 用户执行;主库已经停止,物理备库保持运行。
(
set -e
set -o pipefail
umask 077

LAB=/home/kingbase/sysrepair_manual
TARGET=/data/base/15690/16399

test "$(id -u)" -eq 0
test "$(systemctl show kingbased --property=ActiveState --value)" = inactive
test ! -e /data/kingbase.pid
test "$(cat "$LAB/target_path.txt")" = "base/15690/16399"
test -f "$TARGET"
test "$(readlink -f "$TARGET")" = "$TARGET"

FILESIZE=$(stat -c %s "$TARGET")
test "$FILESIZE" -ge 49152
test "$FILESIZE" -lt 1073741824
test "$((FILESIZE % 8192))" -eq 0
test ! -e "$LAB/primary-cold.tar"
test ! -e "$LAB/page5.original.bin"
cmp "$LAB/baseline.csv" "$LAB/standby.csv"

# 本实验没有额外表空间;先保存整个主库数据目录。
tar -C /data -cpf "$LAB/primary-cold.tar" .
tar -tf "$LAB/primary-cold.tar" >/dev/null
printf '%s\n' "$FILESIZE" > "$LAB/target_file_size.txt"

# 块号从 0 开始,skip=5 表示偏移 40960 字节。
dd if="$TARGET" of="$LAB/page5.original.bin" \
  bs=8192 skip=5 count=1 status=none
test "$(stat -c %s "$LAB/page5.original.bin")" -eq 8192
sha256sum "$LAB/page5.original.bin" > "$LAB/page5.original.sha256"

# 生成 8192 字节的 0xFF,并且只覆盖目标页。
head -c 8192 /dev/zero | LC_ALL=C tr '\000' '\377' \
  > "$LAB/page5.damaged.bin"
test "$(stat -c %s "$LAB/page5.damaged.bin")" -eq 8192
dd if="$LAB/page5.damaged.bin" of="$TARGET" \
  bs=8192 seek=5 count=1 conv=notrunc,fsync status=none

test "$(stat -c %s "$TARGET")" -eq "$FILESIZE"
dd if="$TARGET" bs=8192 skip=5 count=1 status=none \
  | cmp - "$LAB/page5.damaged.bin"
echo "故障注入完成:$TARGET,块号 5,8192 字节"
)
本次页偏移为 5 × 8192 = 40960 字节。实验使用默认表空间;存在额外表空间或外部路径时,备份范围也要相应核实。脚本任一检查失败时,应先确认原因,不要跳过检查继续覆盖文件。
注入完成后启动主库:
bash
systemctl start kingbased
systemctl is-active kingbased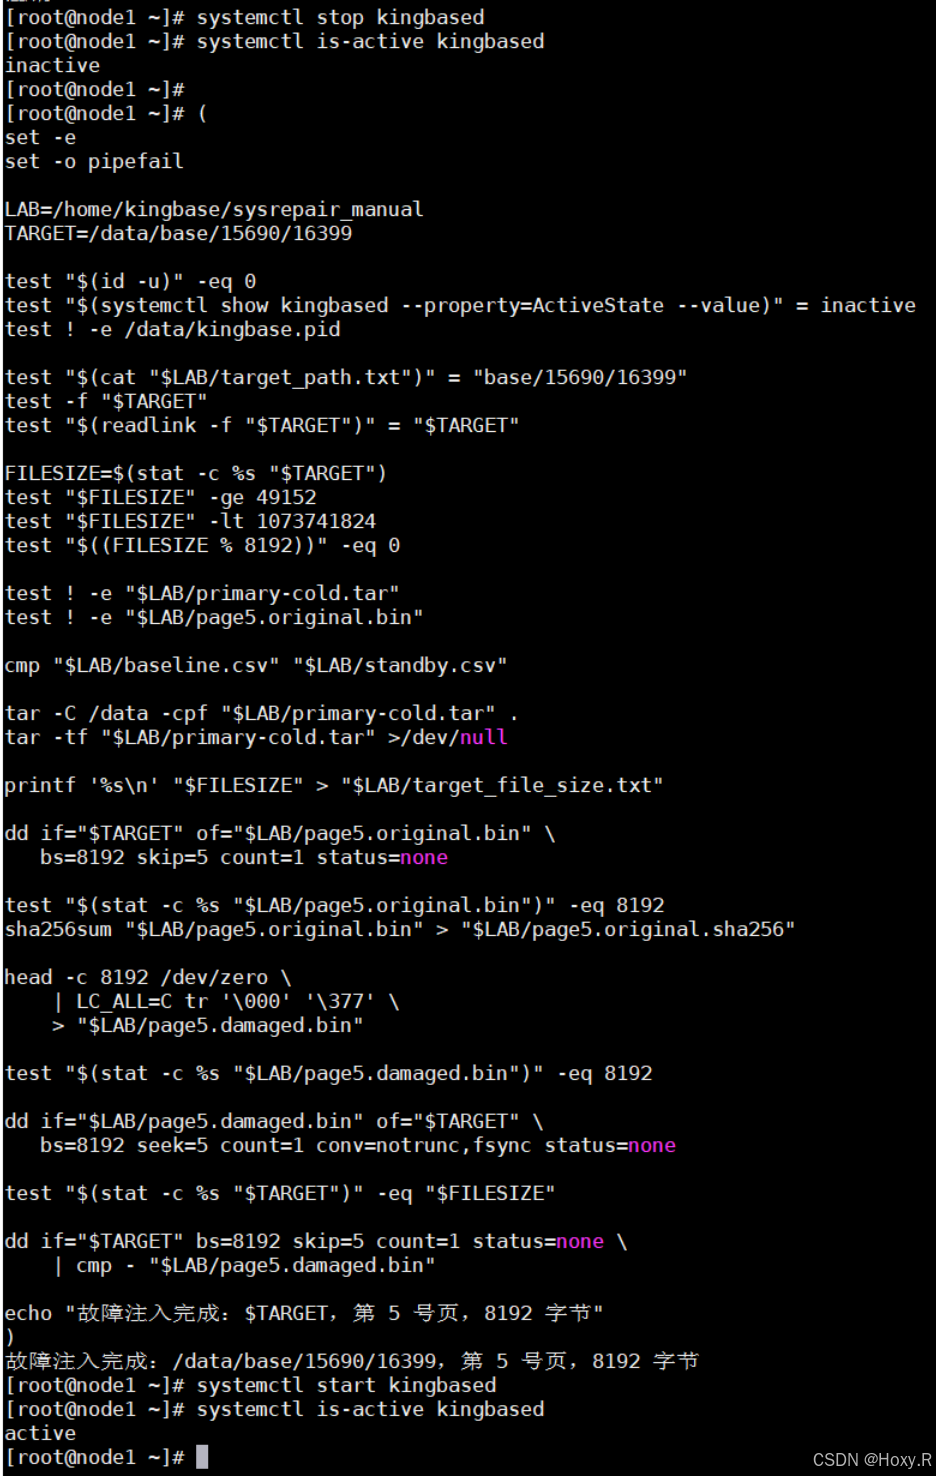
文件层面的损坏没有通过正常 SQL 写入 WAL,因此本次备库仍保留正常页。主库停库修改也避免了原有缓存直接掩盖磁盘坏页。后面仍会重新验证备库,不能仅凭故障前的检查推断它一直健康。
4.2 普通查询和 sys_repair 扫描
使用 kingbase 用户重新连接主库:
bash
/KingbaseES/V9/Server/bin/ksql -h 127.0.0.1 -p 54321 -U system -d test -W先检查目标,再运行普通查询:
sql
SHOW port;
SELECT sys_is_in_recovery();
SELECT count(*) FROM repair_case.demo;
这里端口应为 54321,恢复状态应为 f。
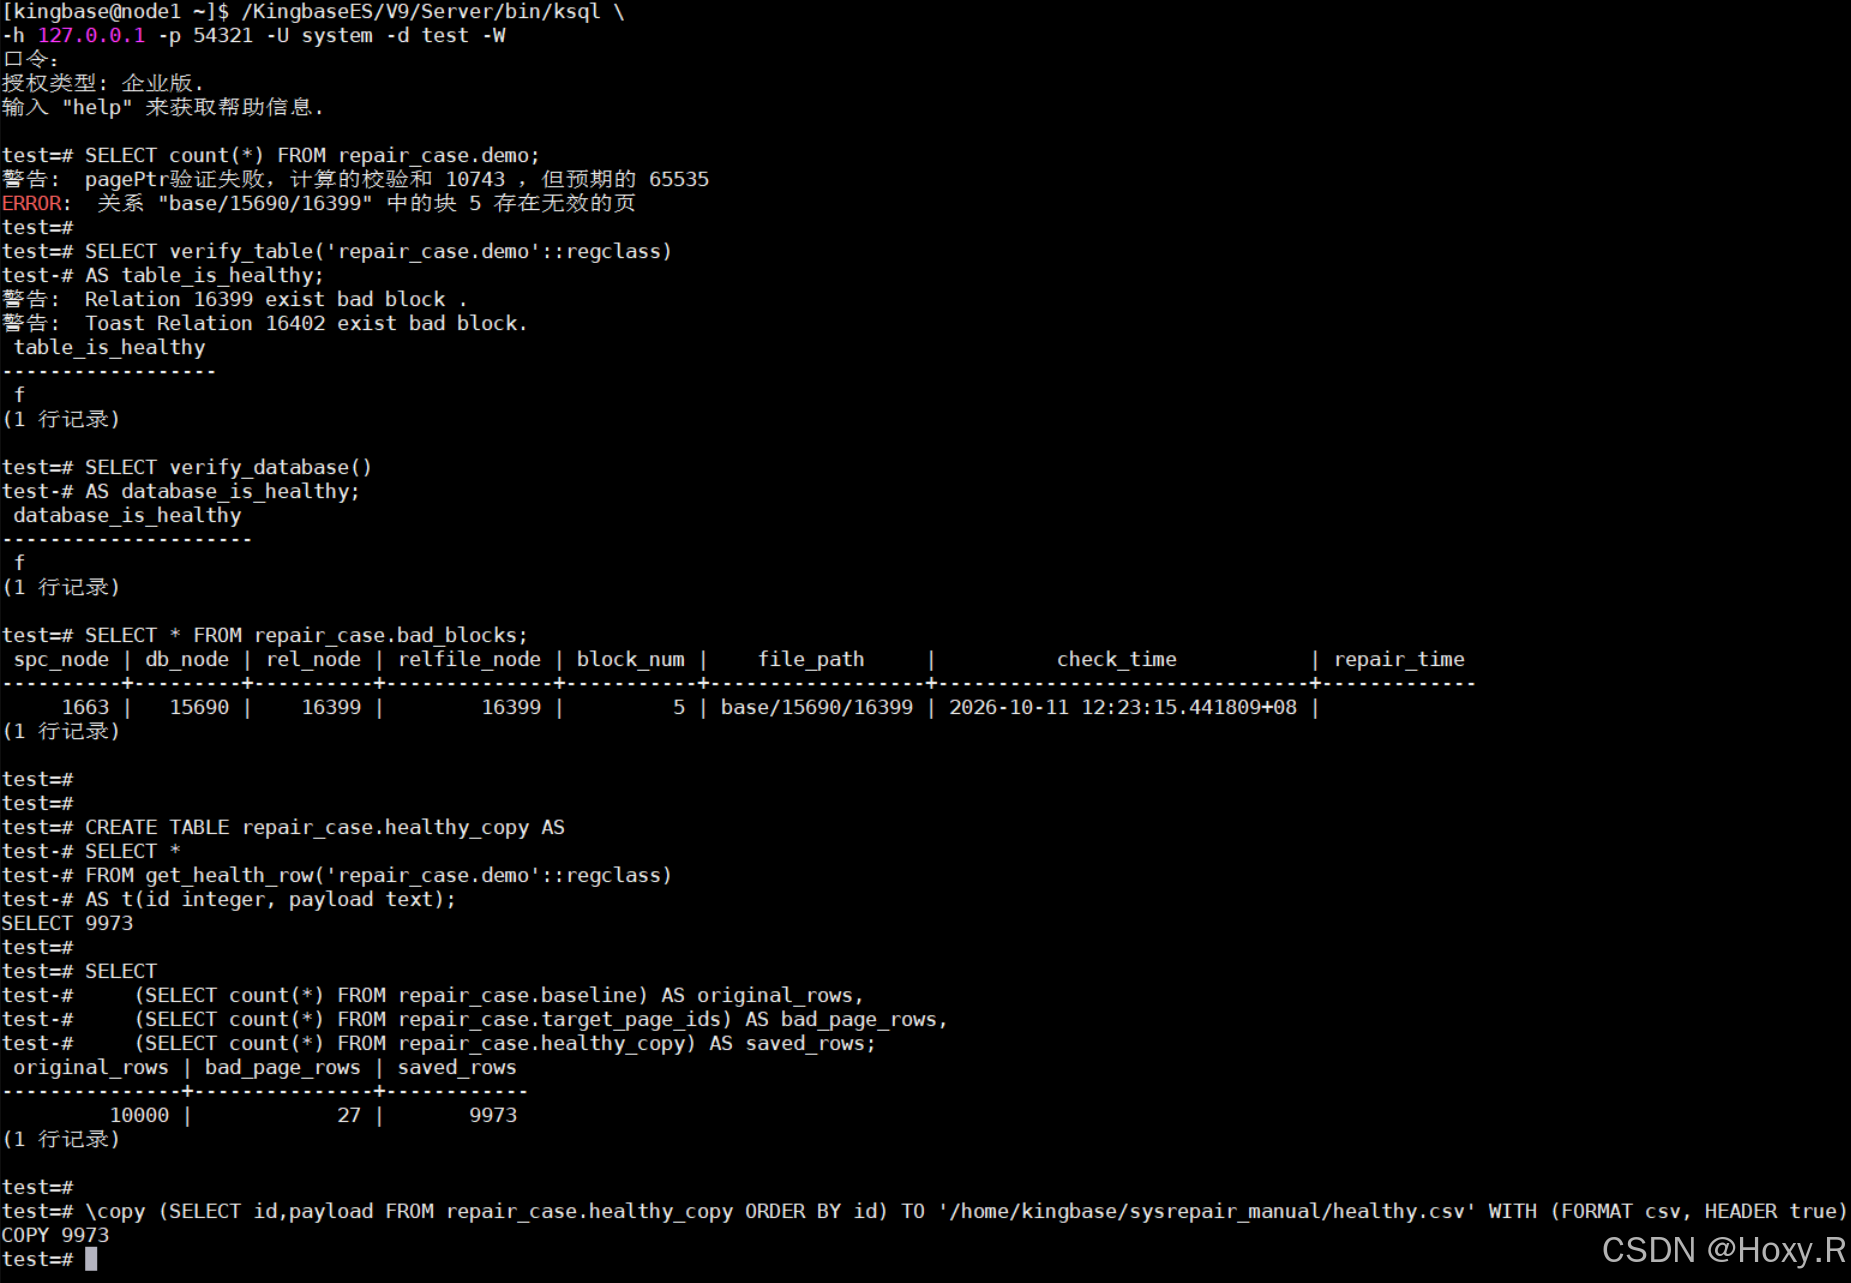
实际出现校验和验证失败,并提示关系 base/15690/16399 的块 5 存在无效页。接着扫描并查看已建立的坏块视图:
sql
SELECT verify_table('repair_case.demo'::regclass) AS table_is_healthy;
SELECT verify_database() AS database_is_healthy;
SELECT * FROM repair_case.bad_blocks;
表级和库级扫描均返回 f。坏块明细只有一条:表空间 1663、数据库 15690、关系和文件节点 16399、块号 5,修复时间为空。
扫描中还出现了 TOAST 提示。不过,本次明细只登记了主表第 5 页,不能仅凭这条提示就认定另有独立的 TOAST 坏页,更不能据此猜测参数继续修复其他文件。后面以实际明细及修复后的复扫为准。
五、先保护健康数据,再修复坏页
5.1 使用 get_health_row 保存正常行
sql
CREATE TABLE repair_case.healthy_copy AS
SELECT *
FROM get_health_row('repair_case.demo'::regclass)
AS t(id integer, payload text);

SELECT
    (SELECT count(*) FROM repair_case.baseline) AS original_rows,
    (SELECT count(*) FROM repair_case.target_page_ids) AS bad_page_rows,
    (SELECT count(*) FROM repair_case.healthy_copy) AS saved_rows;
实际结果为:
text
original_rows | bad_page_rows | saved_rows
--------------+---------------+-----------
        10000 |            27 |       9973
将健康数据导出,并与事先计算的预期文件比较:
sql
\copy (SELECT id,payload FROM repair_case.healthy_copy ORDER BY id) TO '/home/kingbase/sysrepair_manual/healthy.csv' WITH (FORMAT CSV, HEADER true)
bash
cmp /home/kingbase/sysrepair_manual/expected_healthy.csv /home/kingbase/sysrepair_manual/healthy.csv比较完全一致。这一步说明正常页上的数据已得到保护,但此时坏页中的 27 行仍未恢复,不能把"导出健康行"当作完整修复。

5.2 连接参数的实际排错
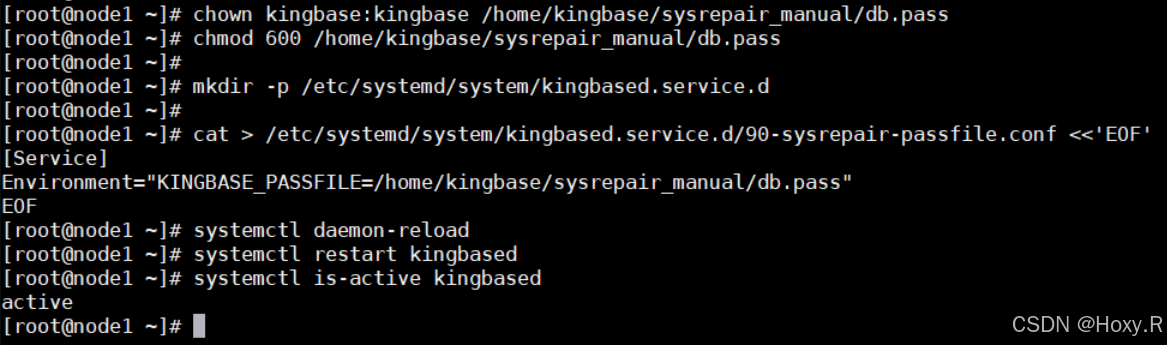
第一次调用 repair_page() 时,我使用了普通连接串形式的参数,结果提示连接远端失败和 no password supplied,日志中的目标端口甚至是主库的 54321。函数虽然返回了一行空白,但输出明确写着修复失败。
修正为前面的 127.0.0.1:54322,并通过 systemd 传入 KINGBASE_PASSFILE,重启主库后才成功连接备库。重启后坏块的内存记录需要重新扫描登记,因此我再次执行了 verify_table(),然后才重试修复。
如果遇到同样的问题,主库中的修正命令是:
sql
ALTER SYSTEM SET sys_repair.sys_repair_conninfo = '127.0.0.1:54322';
\q
然后按 2.2 节核对 systemd 配置,root 执行:
bash
systemctl daemon-reload
systemctl restart kingbased
systemctl is-active kingbased
重新登录主库后,核对连接参数并重新登记坏块:
sql
SHOW port;
SHOW sys_repair.sys_repair_conninfo;
SELECT verify_table('repair_case.demo'::regclass);
SELECT * FROM repair_case.bad_blocks;
如果一开始已经按第二章使用了正确配置,可以直接进入下一节。本段保留的是本次实际报错的处理办法。
5.3 执行 repair_page
修复前再核对一次主备。下面在同一个 ksql 会话执行,\gset 保存的变量会保留到切换连接后。
先连接主库,记录本次修复前的 WAL 位置:
sql
\connect test system 127.0.0.1 54321
SHOW port;
SHOW sys_repair.sys_repair_conninfo;
SELECT sys_current_wal_lsn() AS repair_lsn
\gset

\connect test system 127.0.0.1 54322
SHOW port;
SHOW data_directory;
SELECT sys_is_in_recovery() AS is_standby;
SELECT sys_last_wal_replay_lsn() >= :'repair_lsn' AS replay_caught_up;
SELECT verify_table('repair_case.demo'::regclass) AS standby_table_is_healthy;
SELECT count(*) AS standby_rows FROM repair_case.demo;
应看到备库端口 54322、恢复状态 t、追平 t、表扫描 t、10000 行。如果追平检查还没有通过,等待后重查;其他检查不通过时,先处理备库,暂不修复。
确认来源页正常后,明确切回主库,查看坏块记录:
sql
\connect test system 127.0.0.1 54321
SHOW port;
SELECT sys_is_in_recovery();
SELECT * FROM repair_case.page_meta;
SELECT * FROM repair_case.bad_blocks;
此时端口应为 54321,恢复状态为 f。对照坏块记录和之前保存的物理位置,再执行本次的修复命令:
sql
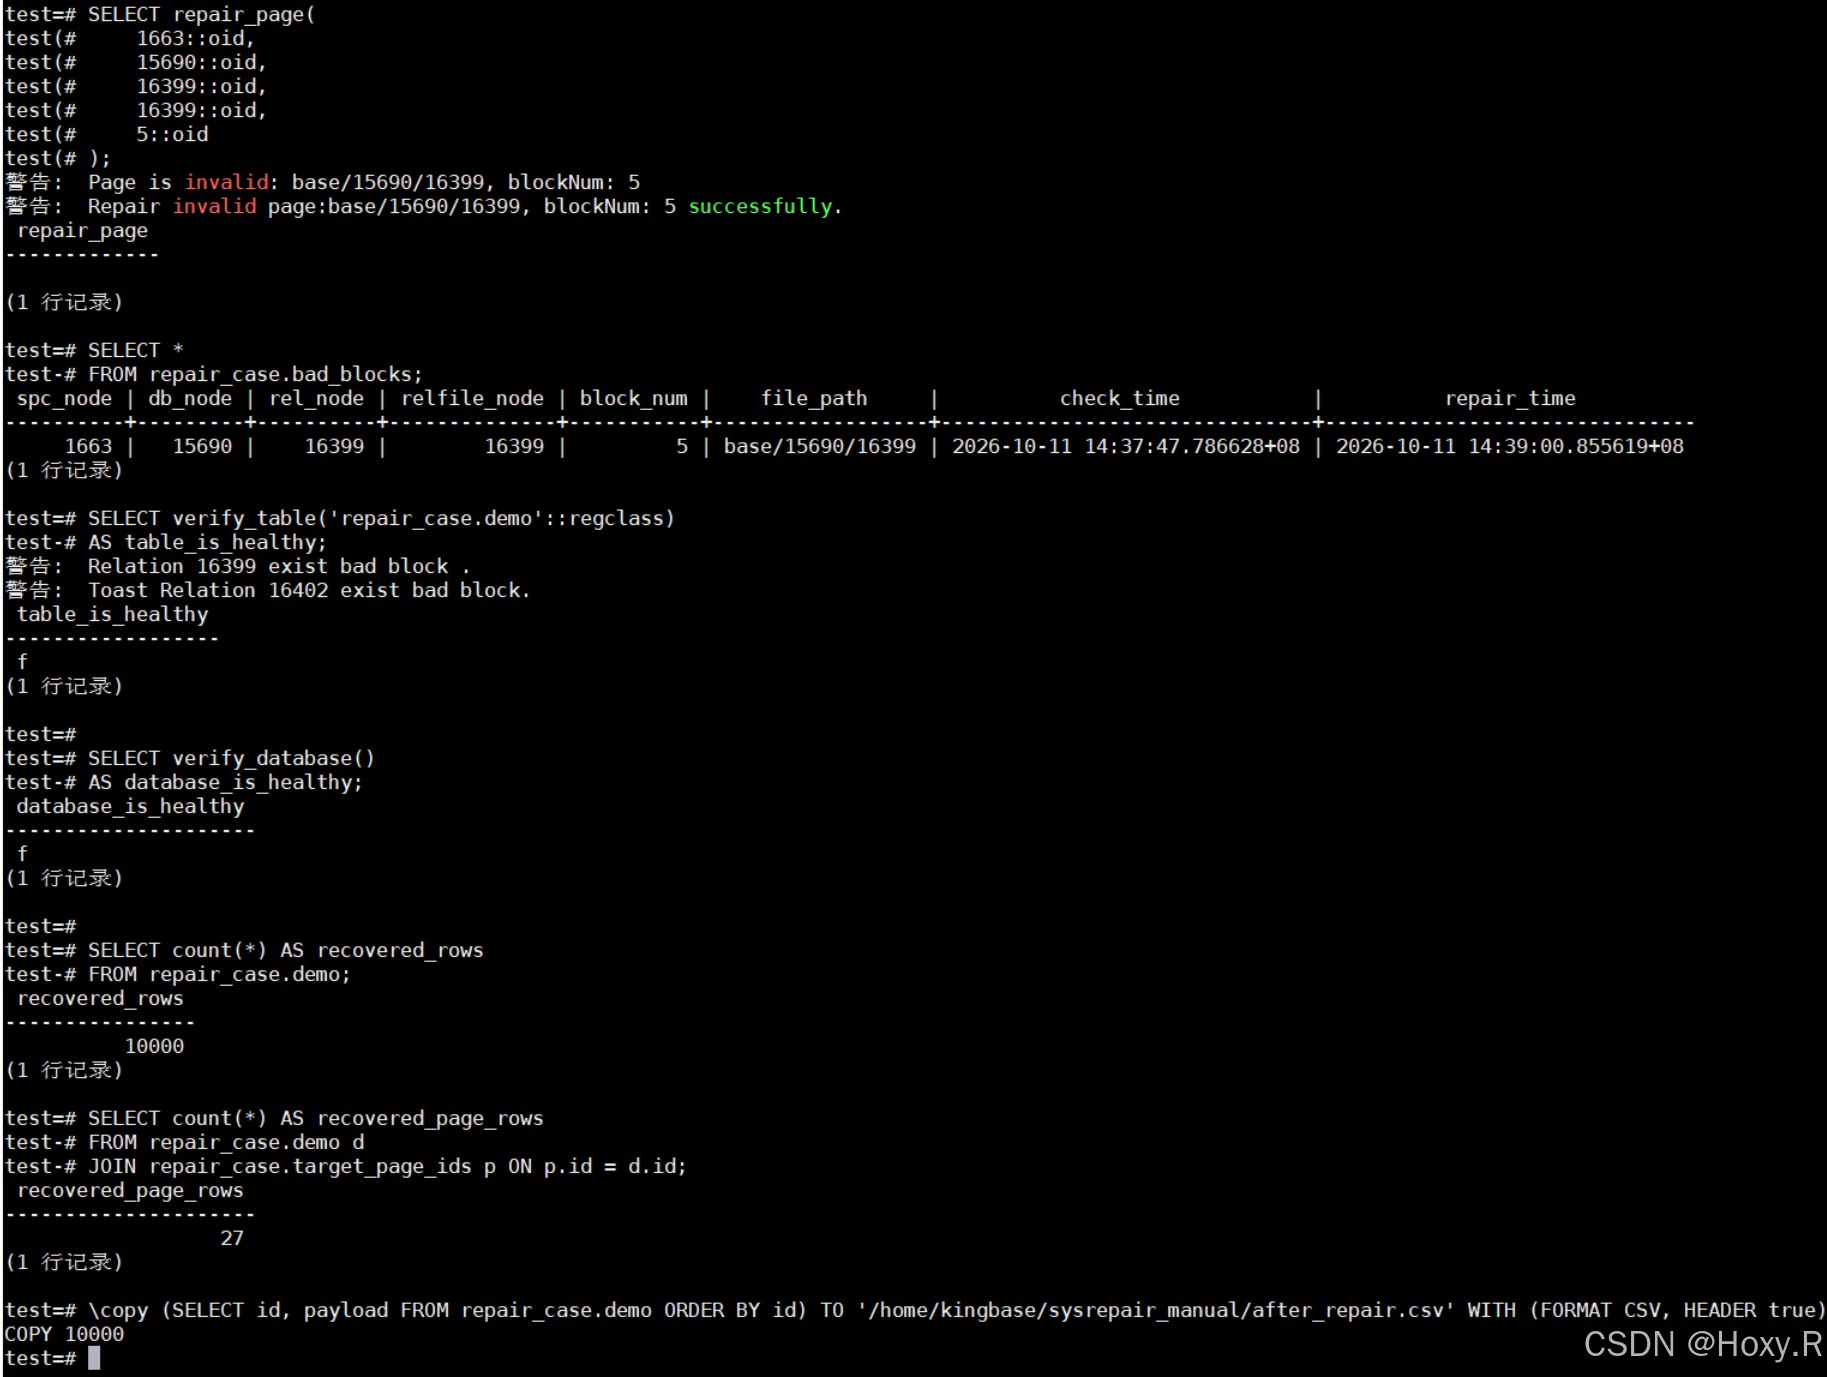
SELECT repair_page(
    1663::oid,
    15690::oid,
    16399::oid,
    16399::oid,
    5::oid
);

SELECT * FROM repair_case.bad_blocks;
SELECT count(*) FROM repair_case.demo;

SELECT count(*) AS recovered_page_rows
FROM repair_case.demo d
JOIN repair_case.target_page_ids p ON p.id = d.id;
五个参数依次为表空间 OID、数据库 OID、文件节点、关系 OID 和块号。这里两个 16399 恰好相同,不代表关系 OID 与文件节点在所有场景中都相同,实际操作必须分别核对。
输出出现 Repair invalid page ... successfully,坏块记录填写了 repair_time,总行数恢复为 10000,目标页对应的 27 行也可以读取。本次核对的安装包中函数返回 VOID;可使用 \df repair_page 检查实际库中的定义。官方页面展示的原型与本安装包存在差异,判断结果应结合成功日志、修复时间及后续验证,不能只看结果表格中的空白行。
六、CHECKPOINT、全量比较与重启验证
6.1 为什么修复后扫描仍然是 f
这是本次实验最值得记下来的一个现象:修复提示成功,查询也恢复了,马上执行 verify_table() 和 verify_database(),结果却仍然为 f。
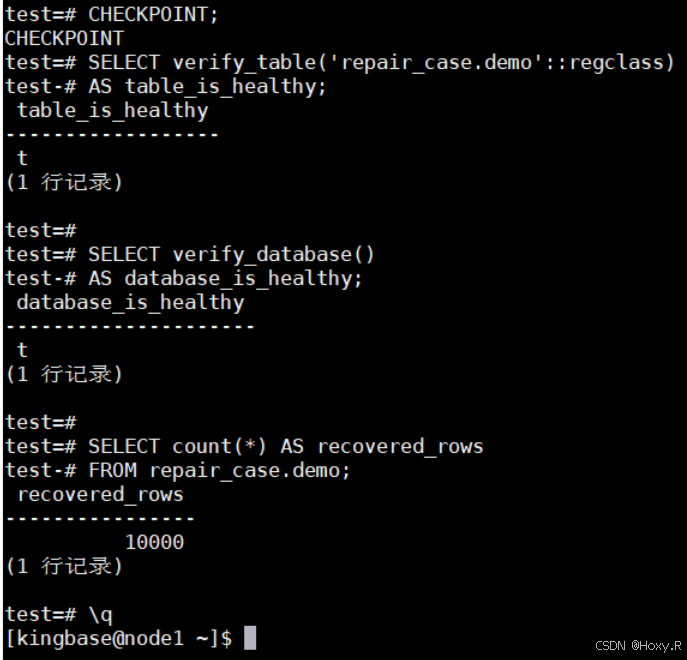
结合本次补丁的修复与扫描行为,原因在于写回时机:修复先更新缓冲中的页,尚未写回时,直接扫描存储文件仍可能读到原来的坏页。我显式执行检查点,让修复页落盘后再做扫描验证:
sql
CHECKPOINT;

SELECT verify_table('repair_case.demo'::regclass) AS table_is_healthy;
SELECT verify_database() AS database_is_healthy;
SELECT count(*) AS recovered_rows FROM repair_case.demo;
此时实际返回 t、t、10000,之前的 TOAST 提示也不再出现。检查点前后的差异说明,修复完成、查询可读与磁盘复扫通过,应当分别确认。
6.2 比较完整数据,而不只比较行数
sql
\copy (SELECT id,payload FROM repair_case.demo ORDER BY id) TO '/home/kingbase/sysrepair_manual/after_repair.csv' WITH (FORMAT CSV, HEADER true)
bash
cmp /home/kingbase/sysrepair_manual/baseline.csv /home/kingbase/sysrepair_manual/after_repair.csv导出为 10000 行,文件与原始基线一致。固定字段、排序和导出格式后进行完整比较,验证范围比单看 count(*) 更充分。

6.3 重启后再检查一次
我退出 ksql 后重启主库服务:
bash
systemctl restart kingbased
systemctl is-active kingbased
重新连接主库,再执行表扫描、库扫描和总行数检查,仍返回 t、t、10000。随后导出 after_restart.csv:
sql
SELECT verify_table('repair_case.demo'::regclass);
SELECT verify_database();
SELECT count(*) FROM repair_case.demo;
\copy (SELECT id,payload FROM repair_case.demo ORDER BY id) TO '/home/kingbase/sysrepair_manual/after_restart.csv' WITH (FORMAT CSV, HEADER true)
bash
cmp /home/kingbase/sysrepair_manual/baseline.csv /home/kingbase/sysrepair_manual/after_restart.csv重启后的完整数据仍与原始基线一致,至此本次验证完成。

七、失败时如何回退
如果修复失败,先保留报错和坏块明细,退出 ksql,root 停止主库,再核对原始页的大小、校验值和目标路径:
bash
systemctl stop kingbased

(
set -e
set -o pipefail
LAB=/home/kingbase/sysrepair_manual
TARGET=/data/base/15690/16399

test "$(id -u)" -eq 0
test "$(systemctl show kingbased --property=ActiveState --value)" = inactive
test ! -e /data/kingbase.pid
test "$(cat "$LAB/target_path.txt")" = "base/15690/16399"
test "$(readlink -f "$TARGET")" = "$TARGET"
test -f "$TARGET"
test "$(stat -c %s "$TARGET")" -eq "$(cat "$LAB/target_file_size.txt")"
test "$(stat -c %s "$LAB/page5.original.bin")" -eq 8192
sha256sum -c "$LAB/page5.original.sha256"

# 保留回退前的当前页,不覆盖已有证据。
test ! -e "$LAB/page5.before-rollback.bin"
dd if="$TARGET" of="$LAB/page5.before-rollback.bin" \
  bs=8192 skip=5 count=1 status=none

dd if="$LAB/page5.original.bin" of="$TARGET" \
  bs=8192 seek=5 count=1 conv=notrunc,fsync status=none
dd if="$TARGET" bs=8192 skip=5 count=1 status=none \
  | cmp - "$LAB/page5.original.bin"
)
仅在整个检查和回填流程成功后,再启动主库:
bash
systemctl start kingbased
systemctl is-active kingbased
八、总结
这次体验让我对 sys_repair 的使用过程有了更具体的认识:扫描负责发现并定位坏页,get_health_row() 可以先保护可读的健康行,repair_page() 则需要可用的正常页来源和正确的连接认证配置。修复之后,还要完成检查点、重新扫描、全量数据比较和重启验证。
| 验证环节 | 本次结果 |
|---|---|
| 人为故障 | 主表第 5 页,涉及 27 行 |
| 健康数据保护 | 9973 行,与预期文件一致 |
| 页级修复 | successfully,记录修复时间 |
| 检查点后扫描 | 表级 t,当前数据库级 t |
| 完整数据比较 | 10000 行与原始基线一致 |
| 重启验证 | 扫描通过,完整数据仍一致 |
本次结果来自同机双实例、单个实验表、单个数据页的受控故障,不能据此推导其他损坏类型或生产环境都能无损恢复。对我来说,这次最有价值的收获,是把"发现、保护、修复、验证"真正走了一遍,也把连接参数和检查点这两个容易忽略的细节留了下来。
整套流程走下来,最容易忽略的细节还是连接目标、服务进程的认证环境,以及修复页的写回验证。把这几个环节检查完整,最后的"修复成功"才有足够的证据支撑。