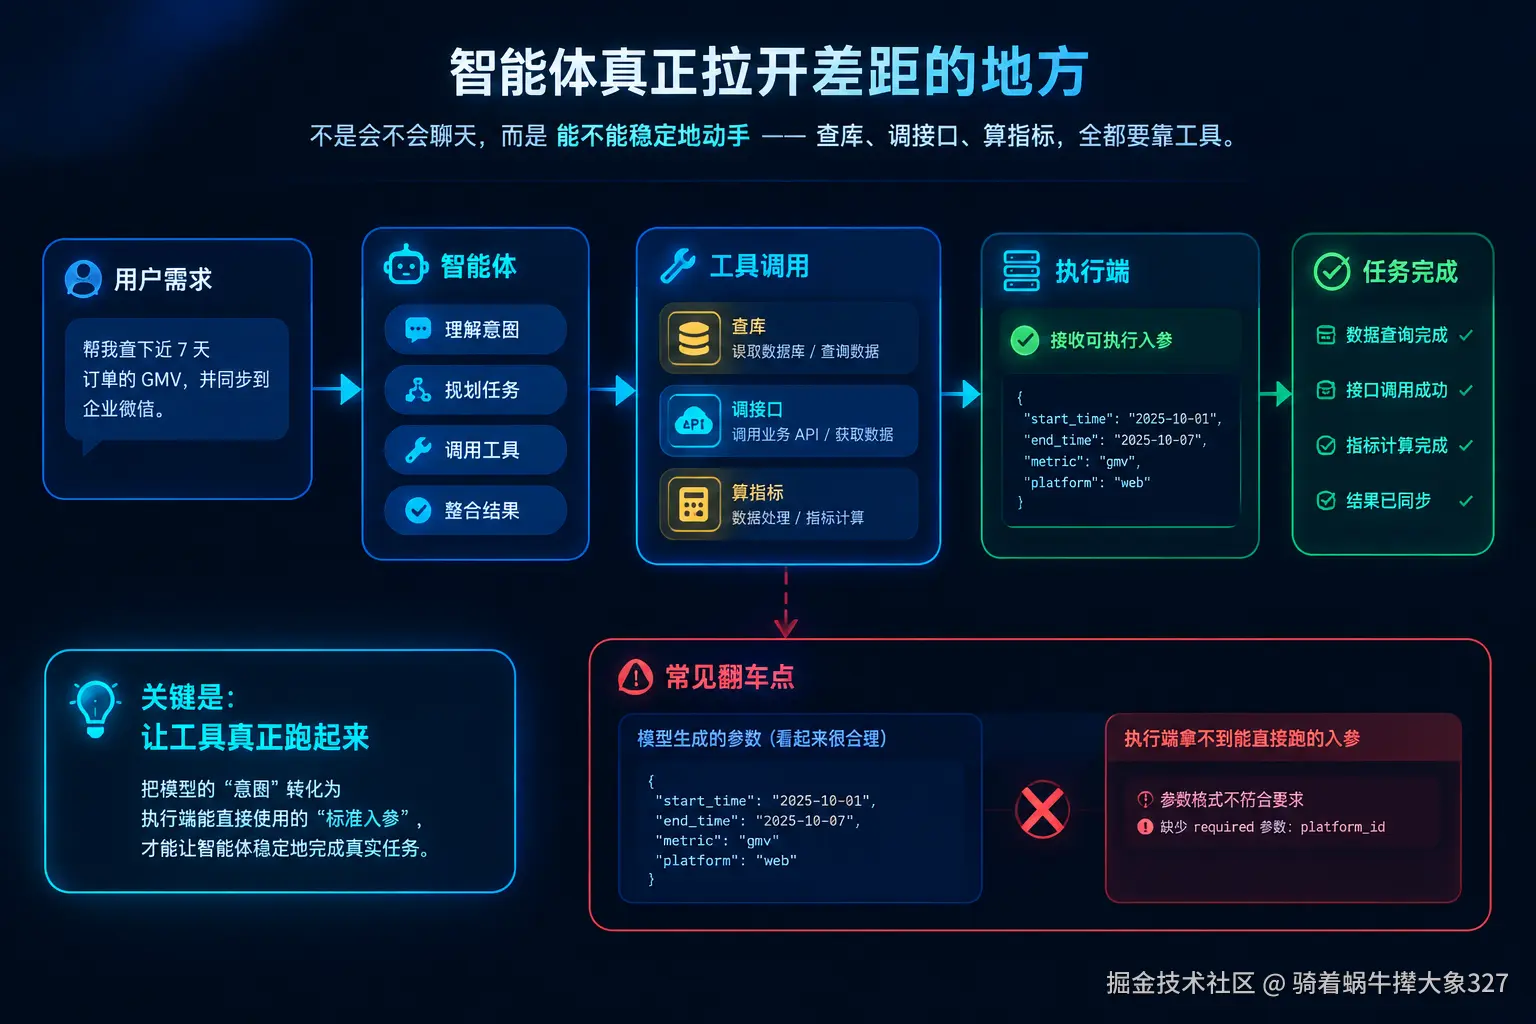
智能体真正拉开差距的地方,不是会不会聊天,而是能不能稳定地动手------查库、调接口、算指标,全都要靠工具。可现实里最常见的翻车是:模型把参数编得像模像样,执行端却拿不到能直接跑的入参。
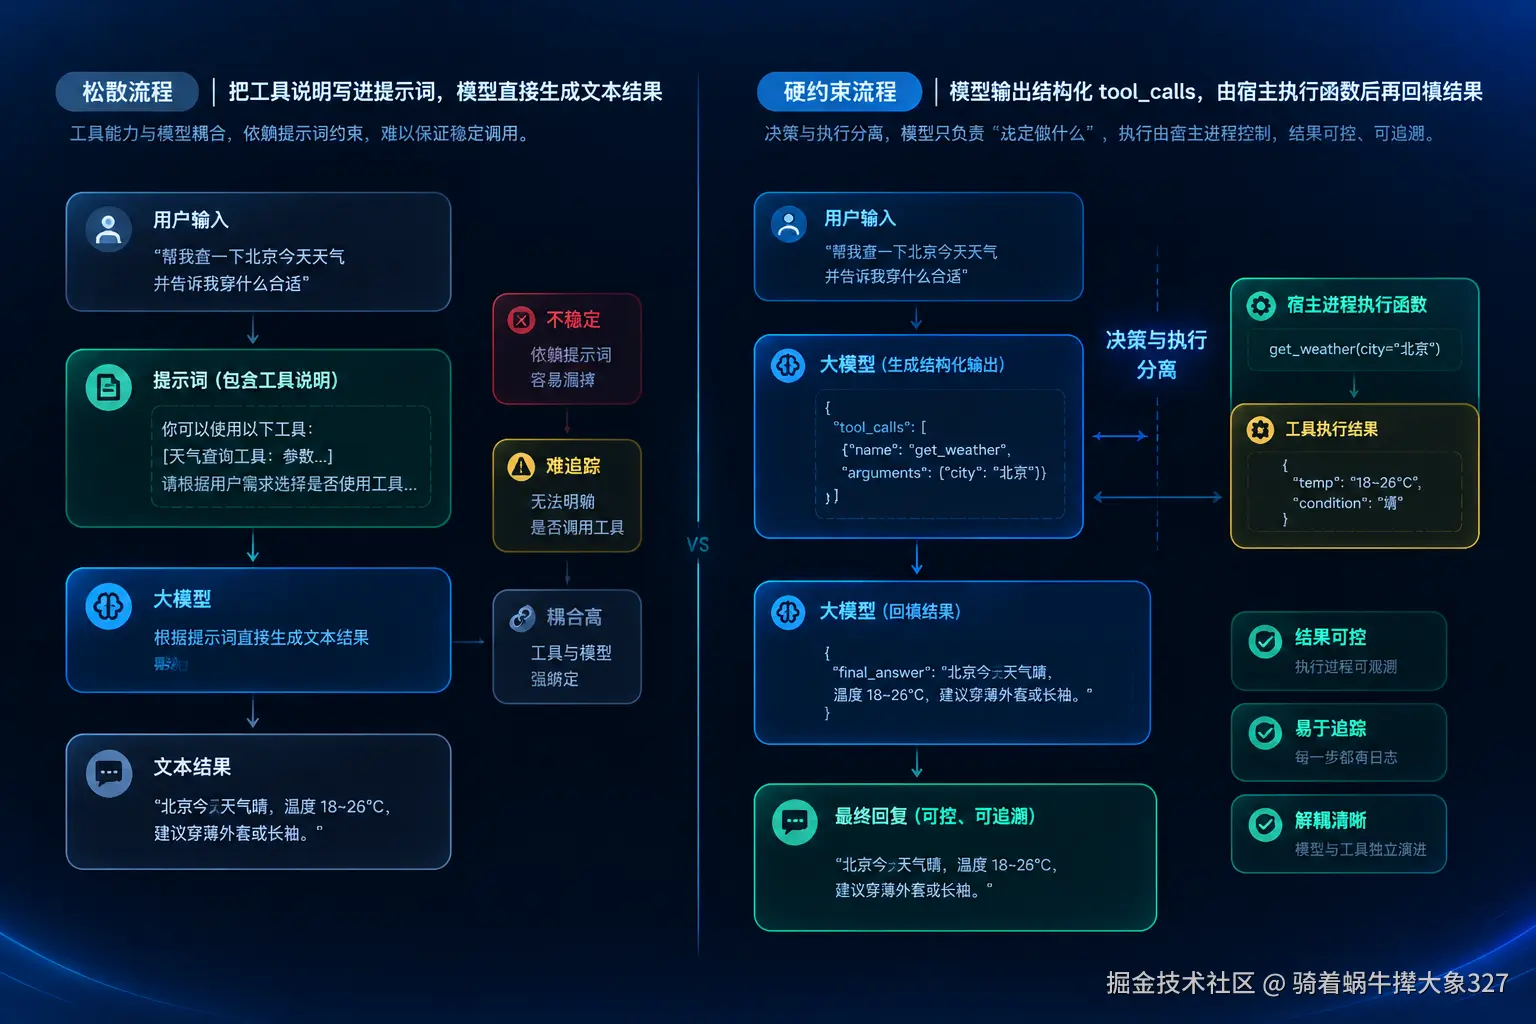
常规做法是把函数签名和说明整段塞进 Prompt,再补一句"请严格按 JSON 格式输出"。问题是提示词只是建议,不是合同:字段名会漂移、类型会退化成字符串,模型甚至会跳过调用直接编一个看起来很合理的答案,等上线才发现错误是在第 N 轮才炸出来的。
本文分享一套可直接落地的方案:装饰器声明契约 + 消息回填闭环 + LangGraph 条件边控循环,再配超时、白名单与日志三道护栏,从开发一路覆盖到上线。
一、工具调用定位:模型只决策不执行
智能体能力的分水岭,在于能否把意图稳定翻译成一次真实执行:
- 决策与执行分离:模型只产出"调用哪个工具、传什么参数",真正跑代码的是宿主进程,它从不替你执行。
- schema 即合同:参数名、类型、必填项写进工具描述,模型是在按合同填空,而不是自由发挥。
两种路线的差别并不玄乎,落到工程上就是下面这张表:
| 维度 | Prompt 描述工具 | 原生工具调用 |
|---|---|---|
| 参数格式 | 靠模型自觉,容易漂移 | 由 JSON Schema 强约束 |
| 执行方 | 模型"演"出一个结果 | 宿主代码真实执行 |
| 多工具 | 易串成一大段文本 | 返回多个结构化 tool_calls |
| 出错恢复 | 只能整段重新生成 | 可原样回填错误让模型改参 |
核心结论: Prompt 写得再细也只是建议,schema 加代码执行才是硬约束。
二、依赖与骨架:最小可运行环境
跑通一次工具调用,先把依赖和入口收敛到最小:
- 依赖分工 :
langchain提供工具抽象,langchain-openai提供模型客户端,langgraph负责编排循环,三者各管一段。 - 配置集中:API Key、模型名、超时统一放进一个配置模块,测试与生产只换环境变量,不改代码。
下面这段命令用于准备一个干净的最小工程,并把模型凭据注入环境:
bash
python -m venv .venv && source .venv/bin/activate
pip install -U langchain langchain-openai langgraph
export OPENAI_API_KEY=sk-xxxx          # 也可指向兼容网关的 base_url
export OPENAI_MODEL=gpt-4o-mini
一句话记住: 依赖只装三条主线,凭据全部走环境变量,仓库里不出现任何密钥。
三、装饰器声明工具:函数自带调用契约
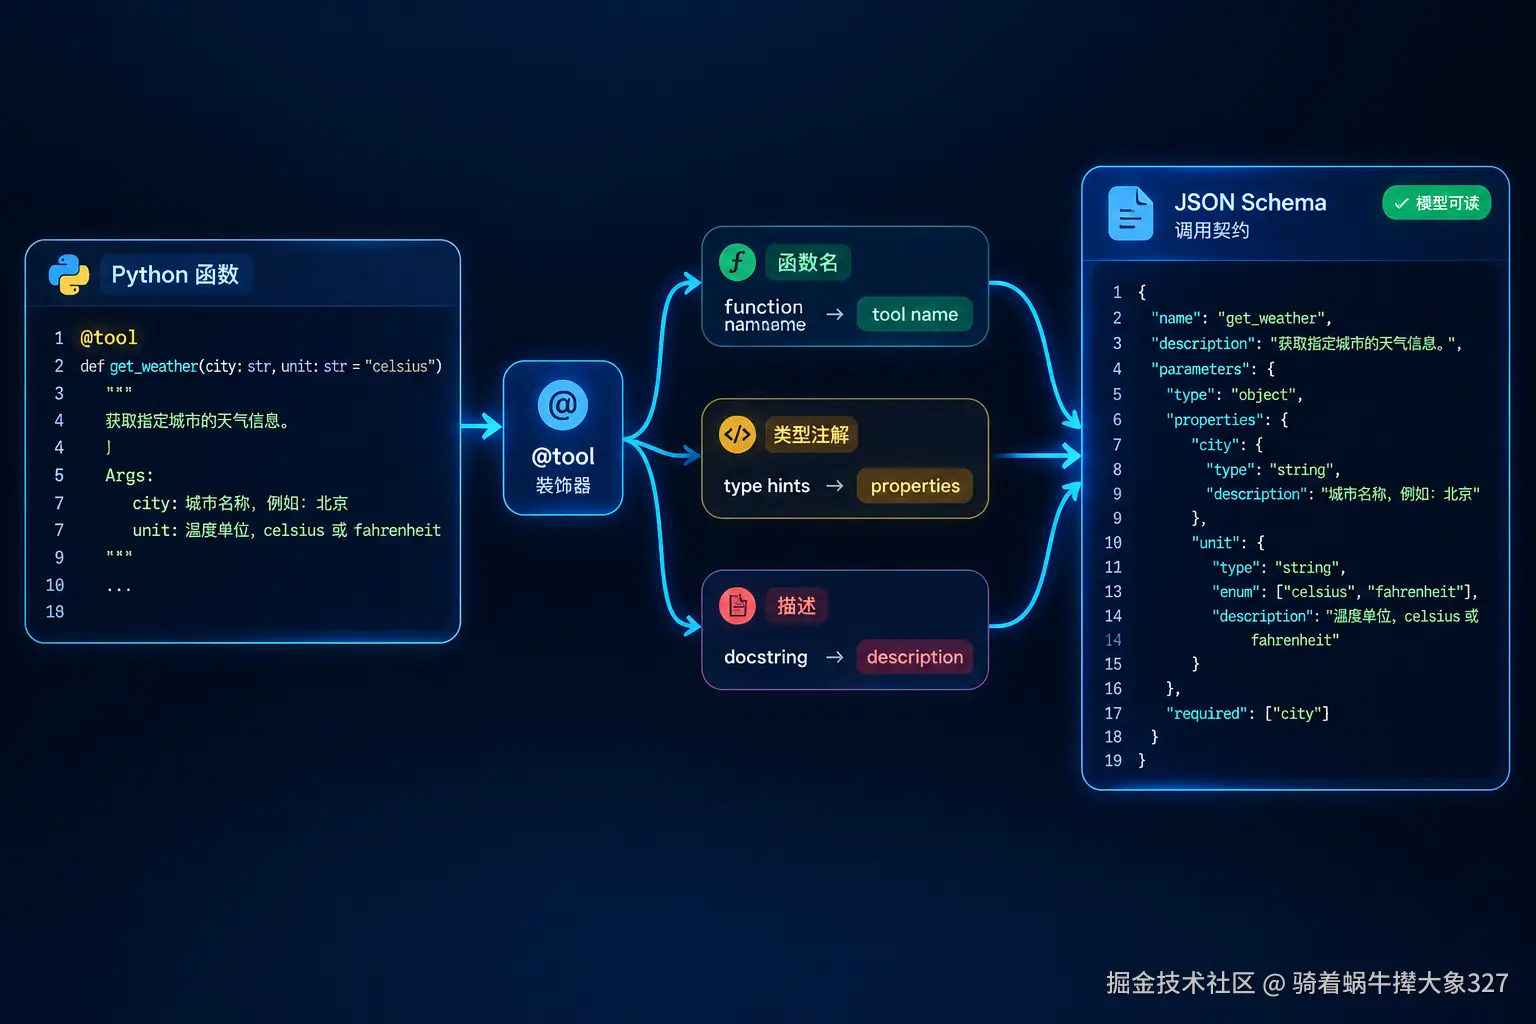
把业务函数变成模型可读的工具,最省事的写法就是装饰器:
python
from langchain_core.tools import tool

@tool
def get_weather(city: str) -> str:
    """查询指定城市的当前天气,city 需为中文城市名。"""
    return {"北京": "晴 26℃", "上海": "多云 24℃"}.get(city, "无数据")

print(get_weather.name)
print(get_weather.args_schema.model_json_schema()["properties"])- docstring 即说明书:那段中文描述会原样出现在模型上下文里,直接决定它"什么时候想起你"。
- 类型注解即校验器 :注解被转成 JSON Schema,
str传成123会在执行前被拦下。
核心结论: 描述回答"什么时候用",类型回答"参数长什么样",两件事别写在一起。
四、绑定与触发:读懂模型的调用请求
绑定工具之后的第一次调用,模型返回的常常不是答案而是调用请求:
python
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
agent_llm = llm.bind_tools([get_weather])
msg = agent_llm.invoke("北京今天天气怎么样")
print(msg.content)      # 往往是空字符串
print(msg.tool_calls) # [{'name': 'get_weather', 'args': {'city': '北京'}, 'id': '...'}]- 两段式返回 :真正有用的三件套是
name、args、id,别盯着content找答案。 - 绑定即白名单 :
bind_tools里传了什么,模型就只能调什么,这是最天然的权限边界。
核心结论: 一次 invoke 只负责"点单",上菜要等你把执行结果塞回去。
五、结果回填闭环:接上 ToolMessage
工具执行完必须把结果以固定消息类型回填,模型才知道下一步该说什么:
python
from langchain_core.messages import ToolMessage

results = [
    ToolMessage(content=get_weather.invoke(c["args"]), tool_call_id=c["id"])
    for c in msg.tool_calls
]
follow = agent_llm.invoke([msg, *results])
print(follow.content)- id 必须对齐 :回填时的
tool_call_id要和请求里的id严格一一对应,错一个整轮就断。 - 历史原样透传:把上一轮 AI 消息和 ToolMessage 一起喂回去,模型才看得见自己点过什么单。
核心结论: HumanMessage → AIMessage(tool_calls) → ToolMessage → AIMessage,这条链少一环都不成立。
六、参数校验:堵住模型编造的字段
模型偶尔会编出不存在的字段,得靠运行期校验兜住:
| 症状 | 根因 | 治理手段 |
|---|---|---|
| args 缺必填字段 | 描述未标必填 | 用类型注解强制 required 并抛错 |
| 参数是自然语言 | 描述过于文学化 | 在描述里给 2~3 个枚举示例 |
| 模型直接编结果 | 未走工具调用 | temperature=0 并在系统提示里强调必须调用 |
| 返回值无法解析 | 工具吐非字符串 | 工具内部统一 json.dumps 后返回 |
- 先校验后执行:让 schema 在调用前抛异常,好过让脏数据流进下游服务。
- 异常也是消息:校验失败的信息要用 ToolMessage 回填,模型才可能换参重试。
核心结论: 校验发生在执行前,事故就发生在测试期。
七、异常与重试:失败也不中断链路
工具抛异常不该让整条链路崩掉,统一捕获后把错误回填给模型:
python
def run_safely(call, max_round=2):
    for _ in range(max_round):
        try:
            return ToolMessage(
                content=str(get_weather.invoke(call["args"])),
                tool_call_id=call["id"],
            )
        except Exception as e:
            err = f"工具执行失败:{type(e).__name__}: {e}"
return ToolMessage(content=err, tool_call_id=call["id"], status="error")- 错误即消息:把异常类型和原文回填,模型能据此修正参数,而不是面对一串 Traceback 猜谜。
- 重试有上限:循环次数写死在函数里,防止模型在同一个坏参数上无限打转。
核心结论: 模型看得见错误,才有可能换参重试,否则只会把同样的错再犯一遍。
八、多工具扇出:并行与流式的取舍
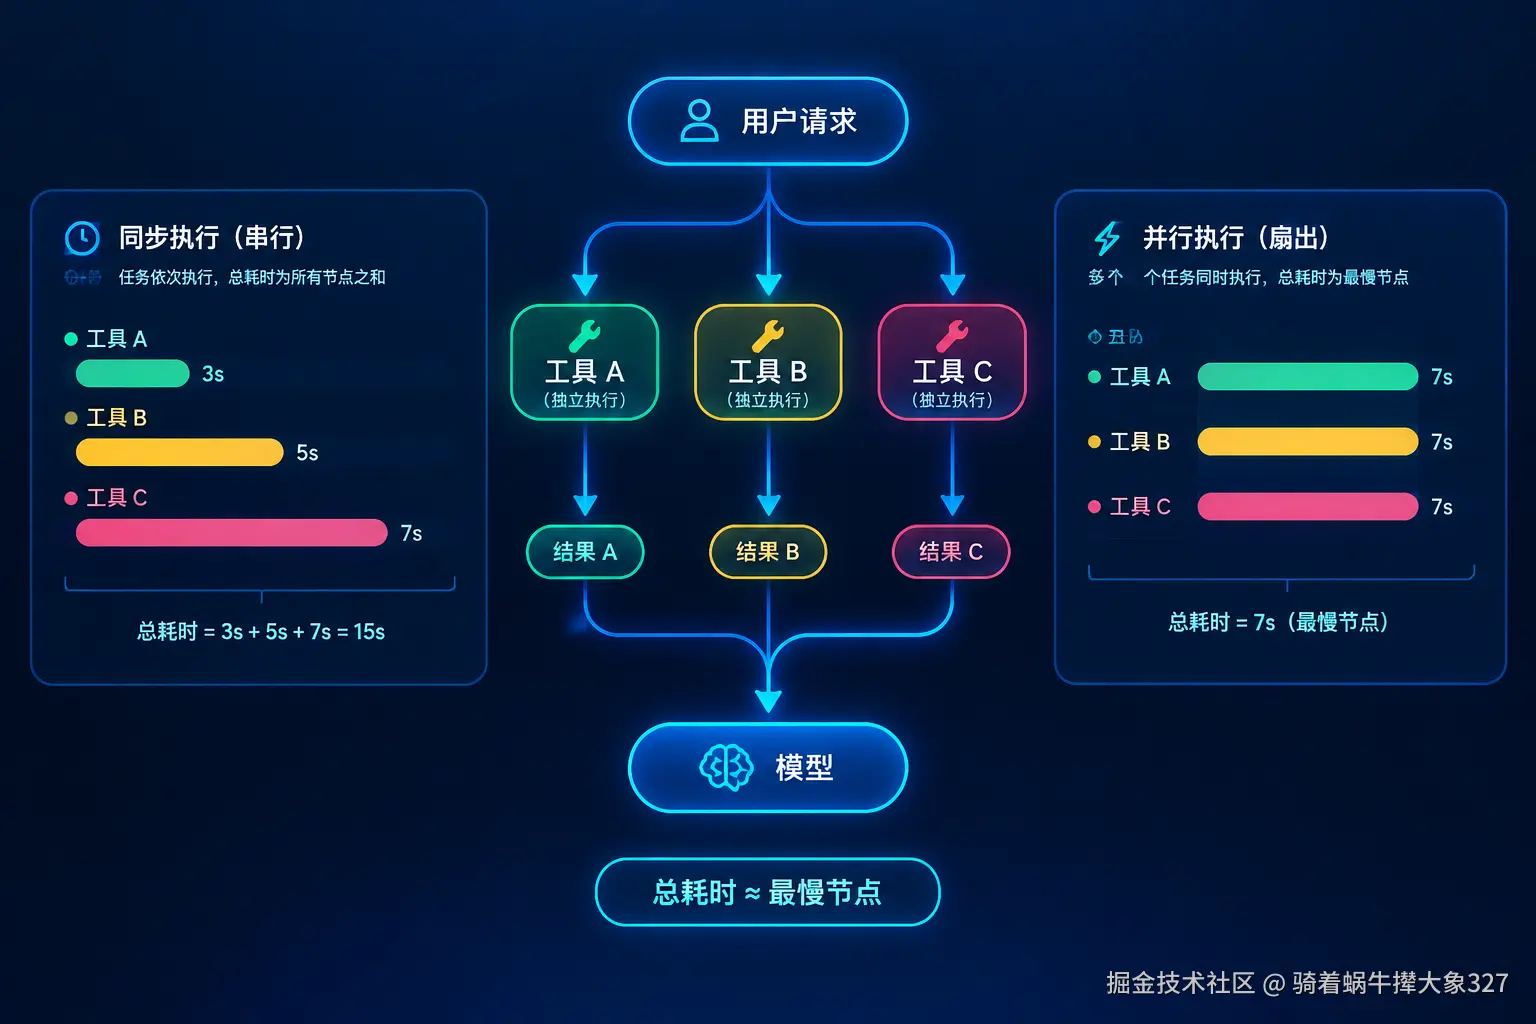
一次请求要触发多个独立工具时,执行策略直接决定响应时长:
| 场景 | 顺序同步执行 | 并行或流式 |
|---|---|---|
| 单个工具 | 实现最简单 | 收益接近零 |
| 3 个独立工具 | 总耗时 = 三者之和 | 总耗时 ≈ 最慢的那个 |
| 工具结果很长 | 用户全程干等 | 逐块吐出,体感更跟手 |
| 有依赖的工具 | 必须串行 | 强行并行会互相踩数据 |
- 先判依赖:互不相干的工具用线程池或 asyncio 扇出,有读写依赖的保持串行。
- 流式只给长输出:短工具走流式只会增加消息拼装的复杂度,得不偿失。
核心结论: 并行优化的是"最慢的那个",先找到它再动手。
九、LangGraph 收敛循环:节点与条件边
手工拼消息容易漏环节,用 LangGraph 把循环画成图更稳:
python
from langgraph.graph import StateGraph, MessagesState, END

def call_model(state):
    return {"messages": [agent_llm.invoke(state["messages"])]}

def call_tools(state):
    calls = state["messages"][-1].tool_calls
    return {"messages": [run_safely(c) for c in calls]}

g = StateGraph(MessagesState)
g.add_node("agent", call_model)
g.add_node("tools", call_tools)
g.set_entry_point("agent")
g.add_conditional_edges(
    "agent",
    lambda s: "tools" if s["messages"][-1].tool_calls else END,
)
g.add_edge("tools", "agent")
app = g.compile()
for chunk in app.stream({"messages": [("user", "北京天气如何")]}):
print(chunk)- 条件边就是刹车 :没有
tool_calls直接跳到END,有就回到tools节点,循环不再靠人肉判断。 - 递归上限是安全阀 :
recursion_limit默认 25,超了直接报错,避免坏循环烧光额度。
核心结论: 图结构把"要不要继续调"写成代码,比在 Prompt 里求模型"适可而止"可靠得多。
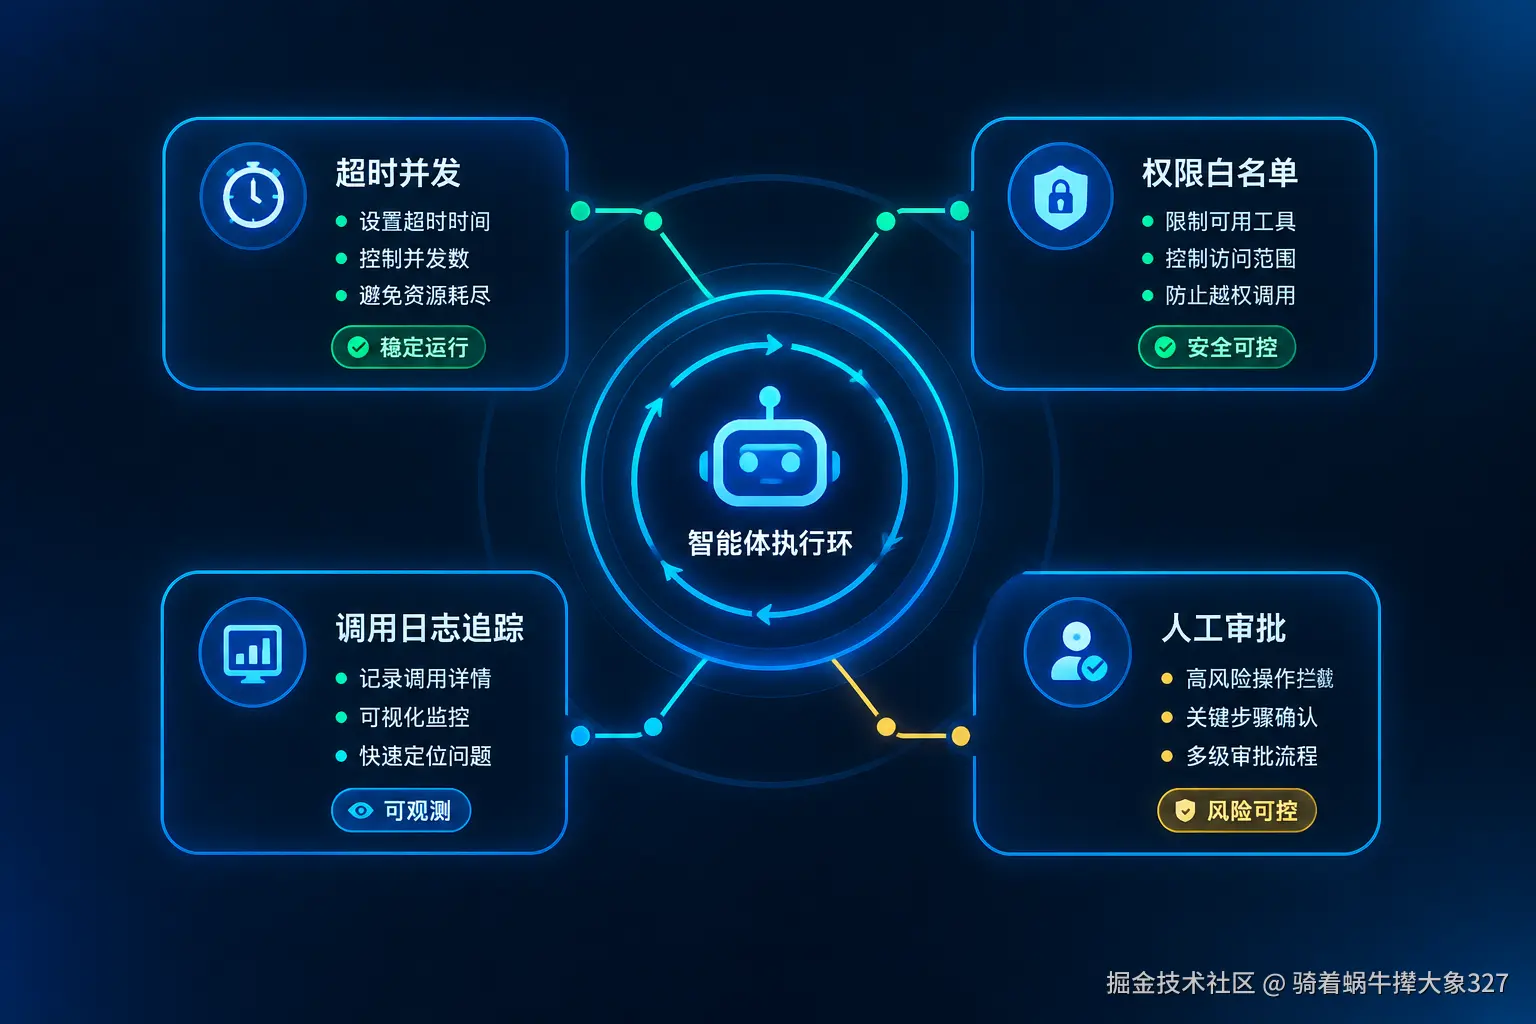
十、上线前加固:日志、超时与权限边界
链路能跑只是起点,上线前还要把边界钉死:
- 超时与并发 :每个工具加
timeout,同进程加信号量限并发,慢工具不能拖垮整轮响应。 - 权限白名单:只注册模型该碰的工具,写操作走人工审批或二次确认,绝不开放裸 SQL。
- 全链路日志 :把
tool_calls、入参、耗时、错误码打到日志,用trace_id串起一轮完整调用。
下面是一张上线前自检清单,逐条打勾再发布:
| 检查项 | 合格标准 |
|---|---|
| 工具超时 | 单工具 ≤ 5s,超时回填可读错误 |
| 递归上限 | 显式设置 recursion_limit ≤ 10 |
| 密钥管理 | 环境变量注入,仓库内零明文 |
| 调用审计 | 每条日志含 trace_id 与工具名 |
核心结论: 线上工具调用事故,几乎都出在"没人限制谁能调、调多久、调了什么"。
结语
工具调用不是"写个函数加个装饰器"就完事的活儿,它是一条从契约声明、模型触发、结果回填到循环控制的完整链路。把装饰器当成合同、把 ToolMessage 当成唯一回执、把条件边当成刹车,这三处一旦稳了,智能体在多轮任务里就不会轻易跑偏;再叠上超时、白名单和 trace 日志,开发环境里能跑的东西才敢放到生产上。
把工具调用当成接口工程来做,智能体才不只是会说,而是真的能做。