做 AI 塔罗小程序时,我为什么不让大模型自己抽牌:一次上线复盘
我做了一款基于韦特体系的 AI 塔罗应用,有微信小程序和网页版两端,项目名是「星语塔罗丨AI塔罗解读」。它的流程是:程序洗牌,用户亲手选牌,AI 结合用户的问题生成解读,并支持围绕同一组牌继续追问。
这篇文章会介绍背后的四个设计决定,以及上线后遇到的两个问题。文中的数字来自我自己的测试和线上日志,样本有限;我也会交代每组数据能够说明什么、不能说明什么。
先问一个问题
做 AI 塔罗时,一种直接的做法是把问题交给大模型:「帮我抽三张牌,解读一下我该不该换工作。」模型可能会回答:「我为你抽到了星星正位......」
但模型说「我抽到了」,不代表它真的执行过抽牌。
如果模型没有接入抽牌工具,牌名和正逆位就只是它生成的文字。生成过程确实带有随机性,但这种随机性发生在选择下一个词时,会受到提问方式和训练数据等因素影响,并不等同于从 78 张牌中等概率抽取。
因此,我把流程拆成四步,让模型只负责最后一步:
- 程序洗牌,用户点选,确定抽到哪几张牌;
- 程序查出这几张牌的传统牌义;
- 用一份写好的规则告诉模型解读该怎么写;
- 模型结合用户的问题,完成解读。
第一步:洗牌交给程序
洗牌用的是 Fisher--Yates 算法,代码很短:
ts
function shuffle<T>(arr: T[]): T[] {
  const a = [...arr];
  for (let i = a.length - 1; i > 0; i--) {
    const j = Math.floor(Math.random() * (i + 1));
    [a[i], a[j]] = [a[j], a[i]];
  }
  return a;
}

/** 洗全副 78 张,每张同时定好正逆位(各 50%)。 */
export function shuffleDeck(): DeckCard[] {
  return shuffle(CARDS.map((card) => ({ card, reversed: Math.random() < 0.5 })));
}
洗牌完成后,78 张牌的顺序和正逆位就都确定了。用户看到一排牌背,点选后对应的牌才会翻开;点选本身不会再引入随机性。
最初,正逆位是在用户点选时才决定的。后来我把这一步提前到了洗牌时。两种实现的统计结果完全等价:每张牌正位和逆位的概率各占一半。我调整实现,是为了贴近实体塔罗的流程:牌在洗牌时就可能翻转,因此在用户伸手选牌之前,整副牌的顺序和朝向都已确定。小程序和网页版使用同一套逻辑。
有两点要说清楚:
- Fisher--Yates 的性质是:如果随机源均匀,每一种牌序出现的概率就相同。
- 我用的随机源是
Math.random(),它不是密码学安全的随机源。抽牌独立于模型,不代表结果不可预测。对一个塔罗应用来说这足够了,但我不会把它说成「绝对随机」。
为了检查实现,我用线上同一套函数进行了自检:模拟 10 万次「洗牌后取第一张」,统计每张牌出现的次数,并计算卡方统计量。理论上,每张牌应出现约 1282 次。我一共跑了三轮:
| 轮次 | 被抽中最少的牌 | 被抽中最多的牌 | 卡方统计量 | 逆位占比 |
|---|---|---|---|---|
| 1 | 1209 次 | 1396 次 | 77.2 | 49.98% |
| 2 | 1197 次 | 1351 次 | 70.2 | 50.15% |
| 3 | 1226 次 | 1393 次 | 59.6 | 50.12% |
在自由度为 77、显著性水平为 0.05 时,参考阈值是 98.48;三轮结果都低于这个阈值。这说明这次检验没有发现明显偏离均匀分布的证据,但不能据此证明结果完全随机。
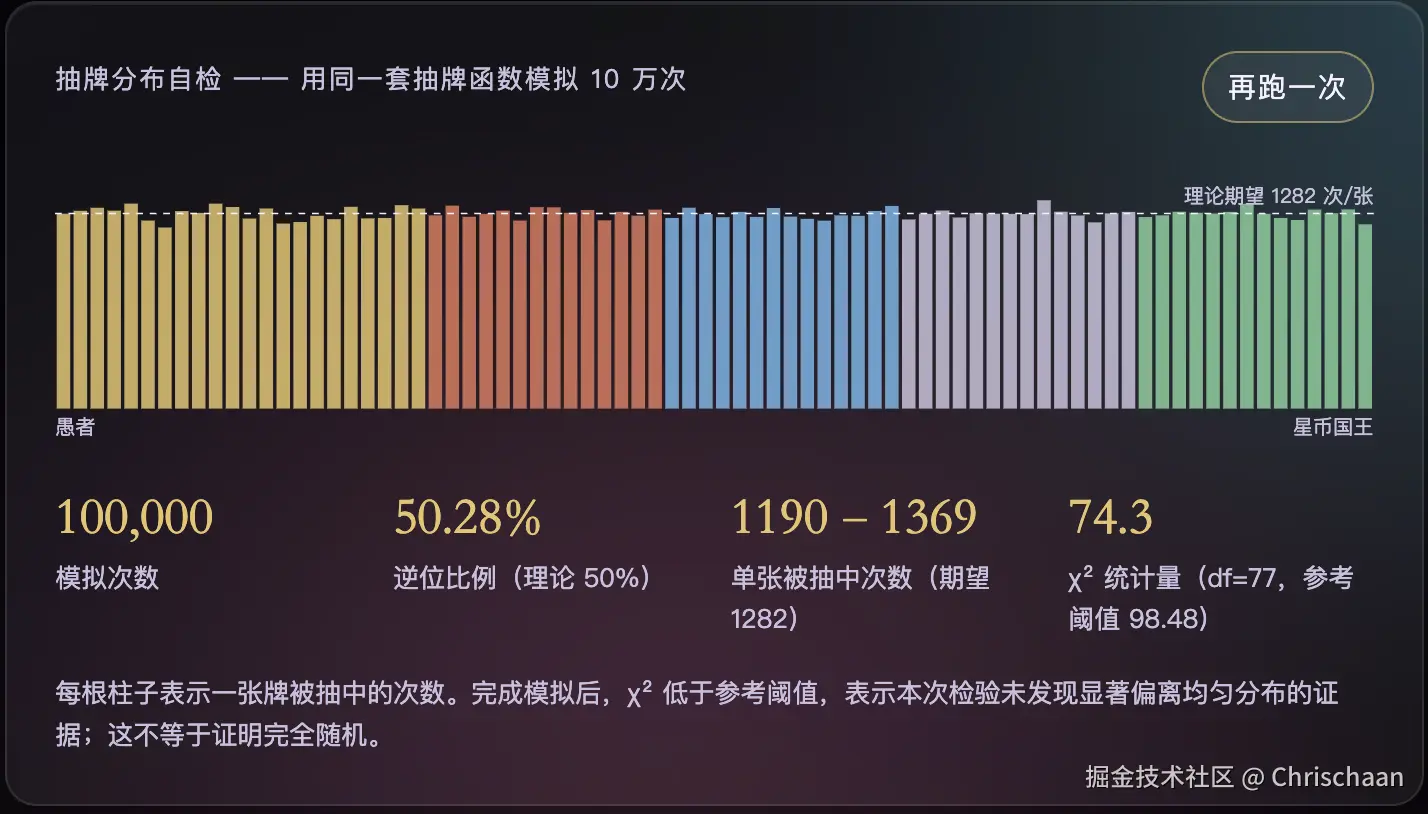
图 1:另一次 10 万次模拟的结果。这一轮的卡方统计量是 74.3,同样低于参考阈值。
第二步:牌义让程序查,不让模型背
同一张牌,在不同书籍和读者那里可能有不同解释。为了给解读提供统一参照,我整理了一份韦特体系牌义词库,涵盖 78 张牌;每张牌的正位和逆位各有五个关键词,以及一句简短释义。
用户抽到牌后,程序会取出对应词条,连同用户的问题一起交给模型。这就像查阅一份事先整理好的手册:程序根据牌和正逆位查找词条,而不是让模型临场回忆牌义。
我要求模型结合问题进行分析,而不是逐字复述词条。这有助于减少解读偏离主题的情况,但不能保证每次解读都准确。
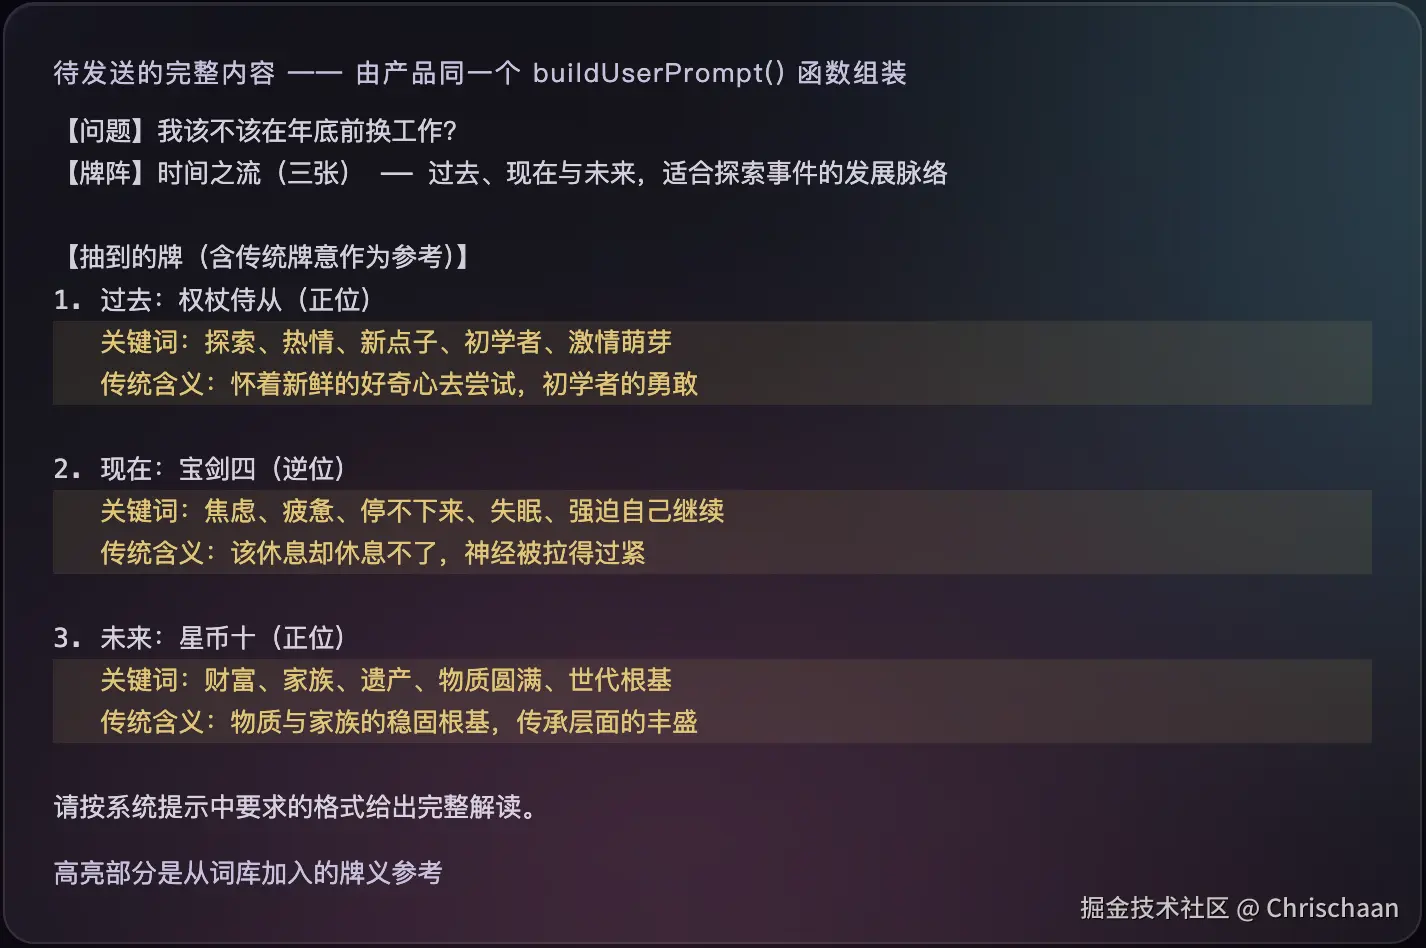
图 2:一次三张牌阵的请求里交给模型的内容。高亮部分是程序从词库里加入的牌义参考。
第三步:把「怎么说话」写成规则
系统提示词相当于给模型的工作说明,我把它分为四部分:角色与语气、输出模板、风格要求,以及身份与边界。
输出模板会随牌阵变化。单张牌的解读分为三个部分:一句话定调、深度解读和行动建议。多张牌则分为五个部分:一句话定调、牌阵概览、逐张解读、整体洞察和行动建议。两种结构都先呈现核心观点,再展开牌面分析。
风格要求中的每条规则,都针对一种我希望减少的问题:
| 规则 | 想减少的问题 |
|---|---|
| 诚实优先于安慰 | 把「困难」包装成「成长机会」的讨好式措辞 |
| 拒绝空洞鼓励 | 「保持积极」「相信自己」「一切都会好起来」 |
| 是非题第一段先给指向 | 罗列各种可能性,始终不正面回答 |
| 避免含糊措辞堆叠 | 「也许」「可能」「或许」层层叠加 |
| 行动建议必须 24 小时内可执行 | 「调整心态」「跟随内心」这类无法落地的建议 |
| 健康、法律、重大财务问题附专业意见提示 | 把塔罗当成决策依据 |
| 无关追问礼貌带回牌面 | 被当成通用聊天机器人 |
这些规则用于引导生成,并不意味着模型每次都会严格遵守;实际效果仍需持续检验。
第四步:模型与等待时间
我使用的是 DeepSeek Flash 系列。选型时,除了内容质量和成本,我最关注一个指标:用户多久能看到第一段文字。解读会边生成边展示;第一个字出现之前,用户只能等待。
这类模型会先「思考」再作答,思考时长会因设置而异。2026 年 9 月 8 日,我用同一段提示词和同一个模型做了一组对照,只调整推理强度这一个参数:
| 推理强度 | 思考长度 | 首字等待 | 结论 |
|---|---|---|---|
| 不设置 | 89--6476 字 | 1.5--50 秒 | 波动太大 |
| high | 1186--16903 字 | 11--135 秒 | 有长尾,会超时 |
| low | 498--976 字 | 4.4--8.1 秒 | 采用 |
| none | 0 | 0.7 秒 | 最快,但不返回思考过程 |
这组数据的样本量不大:low 测了 11 次,high 测了 3 次,不设置测了 2 次。它比较的是耗时,不能用于判断解读质量。基于这组结果,我决定在每个请求中显式设置推理强度,并采用 low。在这组测试里,low 的等待时间更集中,没有出现 high 那样的长尾。
上线后,我从日志中统计了 9 月 9 日至 10 月 12 日约一个月的首字等待时间:
| 分位 | 首字等待 |
|---|---|
| p50(一半请求在此时间内) | 3.3 秒 |
| p90 | 6.8 秒 |
| p95 | 8.2 秒 |
| 最长 | 17.7 秒 |
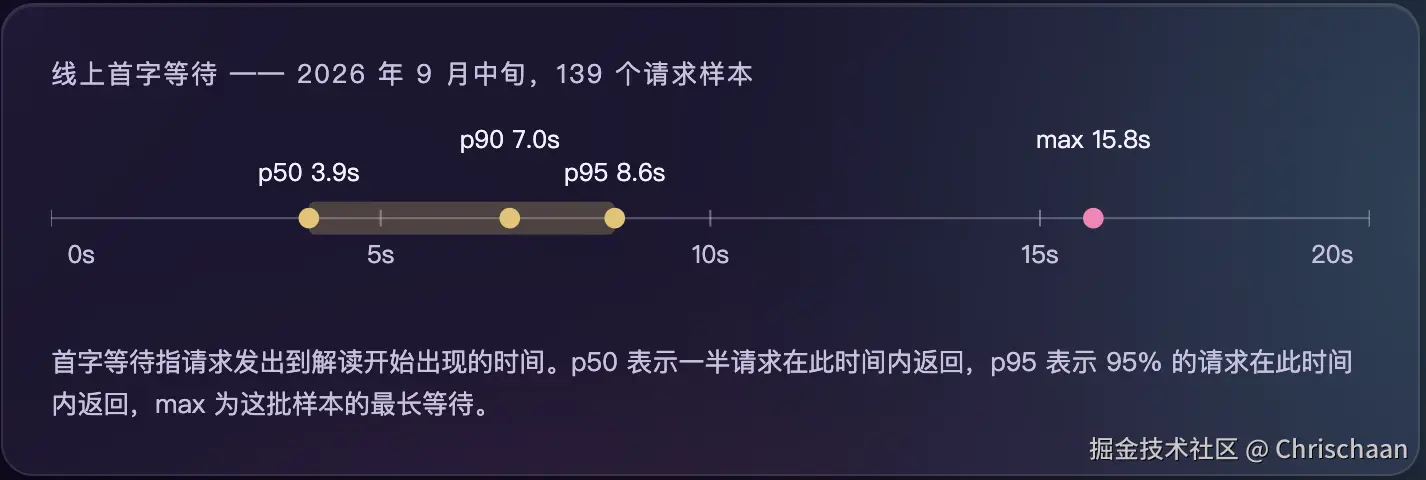
图 3:线上首字等待的分布。
模型服务通过统一接口接入,因此更换供应商时不需要修改业务代码。我还在这层接口上实现了请求对冲:主线路请求发出 10 秒后仍未返回第一个字,就同时向备用线路发起请求;哪条线路先返回内容,就采用哪条,并取消另一个请求。
目前还无法判断请求对冲是否实际缩短了用户等待时间。日志中确实有备用线路先返回内容的记录,但无法区分这是它通过对冲更快返回,还是主线路发生错误所致。因此,我把它视为应对慢响应的备用机制,尚不把它当作已验证的提速手段。
踩过的两个坑
坑一:差点认定「推理长度控制不了」
上面的对照表是第二天才测出来的。前一天,我得出的结论正好相反。
当时我给请求加上推理强度参数,但测得的思考长度仍然忽长忽短。我一度认为这个模型的推理长度无法控制,准备放弃这个方向。
后来我发现,问题出在接入方式上。同一个模型提供两种格式的接口;我当时使用的是 Anthropic 兼容格式,而推理强度参数只在 OpenAI 格式接口上生效。在另一种格式下,这个参数会被静默忽略,既不报错,也没有提示。我设置的另一个参数------思考预算------也没有生效:预算设为 512,实际却用了 3035。第二天,我在该接口格式下做了测试,思考长度从 53 字到 18871 字不等,首字等待最长达到 144 秒。
换用 OpenAI 格式接口后,参数便开始生效。
这里有两点教训。第一,参数没有生效时,应先确认接口是否支持并接收了它,再判断功能是否可控。第二,默认行为也可能有较大波动:同一接口在未设置参数时,两次实测的思考长度分别是 89 字和 6476 字。
由于我提前用统一接口封装了模型服务,更换接口格式时没有改动业务代码。
坑二:一个链接组件,把访客锁在网页版一年
官网的设计是:电脑访问首页时先看到落地页,页面上提供「继续用网页版」链接,地址为 /?web=1。访客点击后,服务端会写入一个有效期一年的 Cookie;之后访问时,网站会直接进入网页版,不再显示落地页。
2026 年 8 月 8 日,线上出现了一个问题:电脑访客第一次打开网站时能看到落地页,但刷新页面或下次访问时,就会直接进入网页版,无法再看到落地页。
原因是链接使用了 Next.js 的 <Link> 组件。<Link> 默认会自动预取进入视口的链接,而预取请求也会经过服务端中间件。于是,访客还没有点击,浏览器就已经替他请求了 /?web=1,服务端因此写入了有效期一年的 Cookie。
这个问题在本地开发环境无法复现,因为 <Link> 的预取只在生产构建中启用。
我分三步修复了这个问题:
- 把链接从
<Link>换成普通的<a>。我尝试过在中间件中识别预取请求,但实测发现,Next.js 会在请求到达中间件前移除用于标识预取的请求头,因此中间件无法据此判断。换成<a>后,浏览器不会再自动预取这条链接。 - 中间件仍会识别浏览器原生预取、Safari 预览等请求,因为这些请求对应的请求头可以正常读取。
- 对于已经被误写入 Cookie 的访客,仅修复代码并不能立即恢复落地页显示;旧 Cookie 原本还会持续一年。我将服务端认可的 Cookie 值从
1改为2,让旧 Cookie 一次性失效。受影响的访客下次访问时会自动回到官网;此前主动选择网页版的访客只需重新点击一次。
这次问题让我再次确认:不要让 GET 请求产生副作用。预取、预览、爬虫和安全扫描等机制,都可能自动发起 GET 请求。
现在的样子
这套设计已经在线运行:程序负责洗牌,用户亲手选牌,词库提供参考,规则约束表达,模型完成解读。
最后说明:塔罗解读由 AI 生成,仅供自我觉察与娱乐参考,不构成专业建议。