note
- 核心: 从原始视频自动构造时序排序、物体计数、异常定位等可验证任务,再通过 RLVR 提升模型的视频理解能力。
- VideoSSR 提出,不必依赖昂贵的人工标注或容易带偏见的模型标注,而是直接对原始视频做可控制的扰动,自动生成"答案天然可验证"的训练题,再用强化学习训练多模态大模型的视频理解能力。
- VideoSSR 最有价值的地方,不是单纯提出三个训练游戏,而是提出了一套数据生产机制。
- 传统范式是:人工理解视频 → 出题 → 标注答案 → 模型学习。
- VideoSSR 的范式是:视频本身保存答案 → 自动制造变化 → 程序自动验证 → 模型通过强化学习发现变化背后的规律。
- 使用三种Reward:
- 异常定位使用时间区间 IoU:比较预测异常区间和真实异常区间在时间轴上的重叠比例。
- 物体计数使用相对数量误差:先计算每一类预测数量与真实数量之间的相对误差,再取所有类别的平均。
- 时间拼图使用归一化位置位移误差:统计每个片段在预测排列中偏离正确位置的幅度,除以完全逆序时的最大位移。
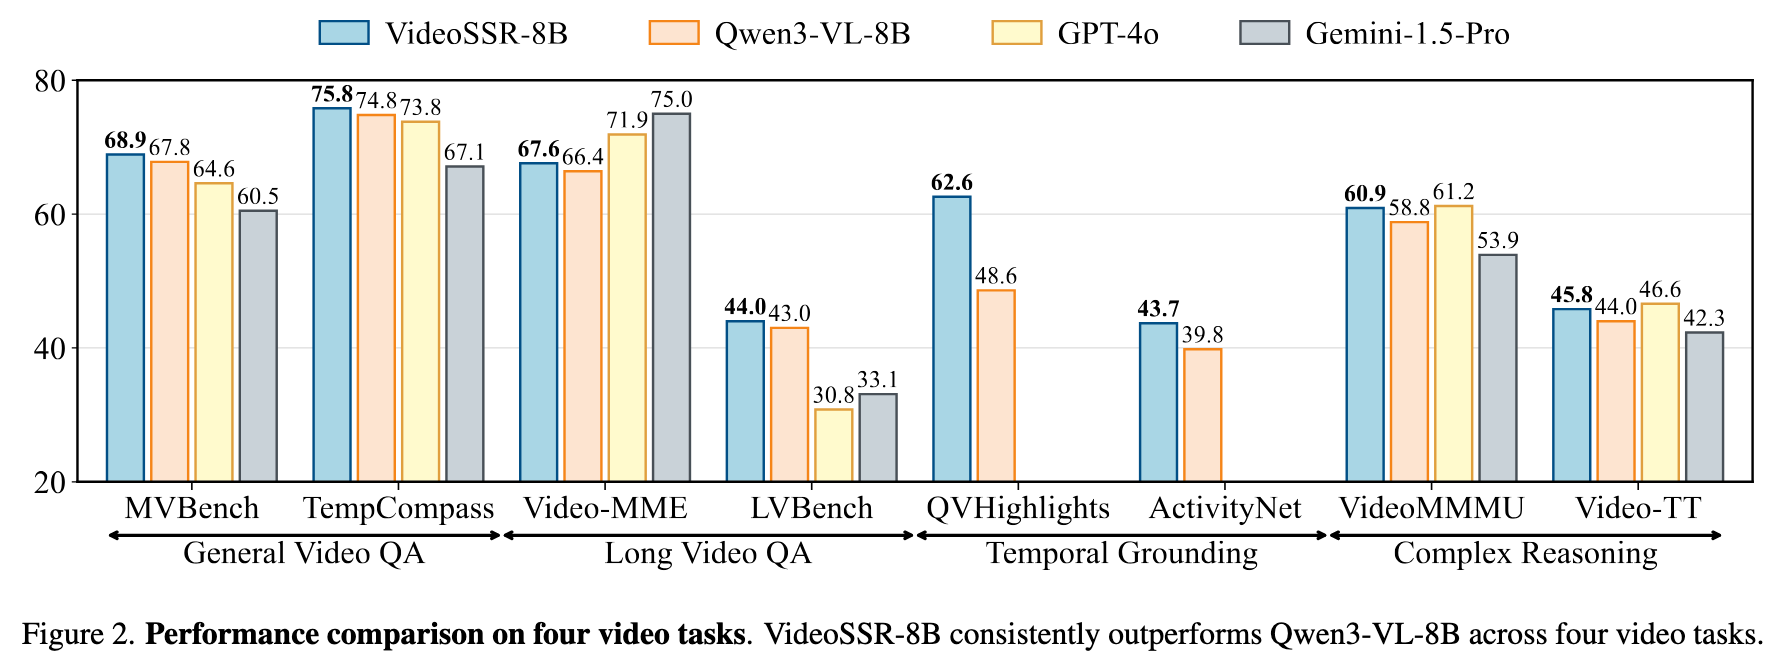
- 论文的实验表明,这套机制能够把异常定位、细粒度计数和时间顺序学习,迁移到通用视频问答、长视频问答、时间定位和复杂推理任务中。
文章目录
-
- note
- 一、研究动机:高质量视频训练数据为什么不够用了?
-
- [1. RLVR 的关键是"可验证答案"](#1. RLVR 的关键是“可验证答案”)
- [2. 人工标注太贵](#2. 人工标注太贵)
- [3. 现有数据正在"变简单"](#3. 现有数据正在“变简单”)
- [4. 弱模型标注可能"教坏"强模型](#4. 弱模型标注可能“教坏”强模型)
- [5. 论文想回答的核心问题](#5. 论文想回答的核心问题)
- [二、论文核心:VideoSSR 是怎么工作的?](#二、论文核心:VideoSSR 是怎么工作的?)
- [1. 三个自监督预训练任务](#1. 三个自监督预训练任务)
-
- [任务一:异常定位(Anomaly Grounding)](#任务一:异常定位(Anomaly Grounding))
- [任务二:物体计数(Object Counting)](#任务二:物体计数(Object Counting))
- [任务三:时间拼图(Temporal Jigsaw)](#任务三:时间拼图(Temporal Jigsaw))
- [2. 三个任务的共同设计原则](#2. 三个任务的共同设计原则)
-
- [① 不需要人工答案](#① 不需要人工答案)
- [② 标签没有模型偏见](#② 标签没有模型偏见)
- [③ 难度可以参数化](#③ 难度可以参数化)
- [④ 覆盖视频理解的不同能力轴](#④ 覆盖视频理解的不同能力轴)
- 三、VIUBench:证明这些任务确实够难
-
- [1. VIUBench 的组成](#1. VIUBench 的组成)
- [2. 为什么这个基准很重要?](#2. 为什么这个基准很重要?)
- [四、VideoSSR-30K 与强化学习训练](#四、VideoSSR-30K 与强化学习训练)
- 五、实验设计与主要结果
-
- [1. 实验覆盖哪些任务?](#1. 实验覆盖哪些任务?)
- [2. 主要结论](#2. 主要结论)
- [3. 代表性提升方向](#3. 代表性提升方向)
- [六、结果分析:为什么 VideoSSR 会有效?](#六、结果分析:为什么 VideoSSR 会有效?)
-
- [1. 训练题和下游任务之间存在"能力共享"](#1. 训练题和下游任务之间存在“能力共享”)
- [2. 避免了"越教越偏"的弱标注](#2. 避免了“越教越偏”的弱标注)
- [3. 难度可调,缓解数据饱和](#3. 难度可调,缓解数据饱和)
- [4. 平滑奖励提升了困难任务的训练效率](#4. 平滑奖励提升了困难任务的训练效率)
- 七、论文的主要贡献
- 八、局限性与理性评价
-
- [1. 合成扰动不等于真实视频困难](#1. 合成扰动不等于真实视频困难)
- [2. 合成图形与真实物体存在分布差异](#2. 合成图形与真实物体存在分布差异)
- [3. 时间拼图并非总有唯一答案](#3. 时间拼图并非总有唯一答案)
- [4. 当前证据主要集中在一个基础模型](#4. 当前证据主要集中在一个基础模型)
- [5. 实验设置仍然有限](#5. 实验设置仍然有限)
一、研究动机:高质量视频训练数据为什么不够用了?
1. RLVR 的关键是"可验证答案"
RLVR,即可验证奖励强化学习,要求模型作答后能够明确判断对错。比如:
- 答案是数字;
- 答案是时间区间;
- 答案是唯一排列;
- 答案可以由程序自动评分。
这类训练信号比模糊的主观偏好更适合数学、代码和结构化问答,也被引入到视频多模态大模型中。
但问题也很明显:视频问答的"标准答案"从哪来?
传统方式包括人工写题、人工标注时间戳、模型协作生成等,但这些方法存在三个主要瓶颈。
2. 人工标注太贵
视频包含时间、空间、动作、因果关系等多个维度。相比图片,视频标注不仅要处理单帧内容,还要处理:
- 事件何时开始、何时结束;
- 不同片段之间的顺序;
- 连续帧之间的关系;
- 长视频中的长期依赖。
因此,高质量视频数据很难像文本数据一样快速、低成本扩张。
3. 现有数据正在"变简单"
随着 Qwen3-VL 等模型能力增强,原来能够训练模型的数据可能不再具有足够挑战性。
论文特别指出一种"零方差"现象:
- 同一个问题采样 8 次;
- 模型要么几乎全答对;
- 要么几乎全答错。
如果 8 次结果全部正确,模型已经掌握该问题,继续训练收益很小;如果全部错误,可能只是任务过难或标准答案有偏差,模型也很难获得有效学习信号。
因此,真正有价值的训练题应该满足:
- 答案可以自动验证;
- 难度能够逐步调整;
- 模型部分会、部分不会;
- 不是依靠标注模型的偏见猜测答案;
- 能够覆盖细粒度、空间和时间维度。
4. 弱模型标注可能"教坏"强模型
使用多智能体或较弱模型生成和审核数据,虽然成本较低,但可能把错误推理、格式习惯或模型偏见写入训练集。
尤其当标注模型弱于目标训练模型时,数据可能同时出现两种问题:
- 对强模型来说过于简单;
- 对模型已经知道的知识形成错误奖励。
论文指出,用有问题的数据训练,有时不仅没有提升,反而导致性能下降。
5. 论文想回答的核心问题
能不能利用视频本身固有的时空结构,自动构造高质量、可验证、难度可调的训练数据?
答案是:可以。
因为视频本身包含大量"制造答案"的操作,例如:
- 哪一段被旋转;
- 哪个片段的帧序被调换;
- 在哪些帧添加了多少个图形;
- 打乱后的正确顺序是什么。
这些信息在合成训练数据时就已经确定,因此不需要人工再提供答案。
二、论文核心:VideoSSR 是怎么工作的?
VideoSSR 的核心流程可以概括为:
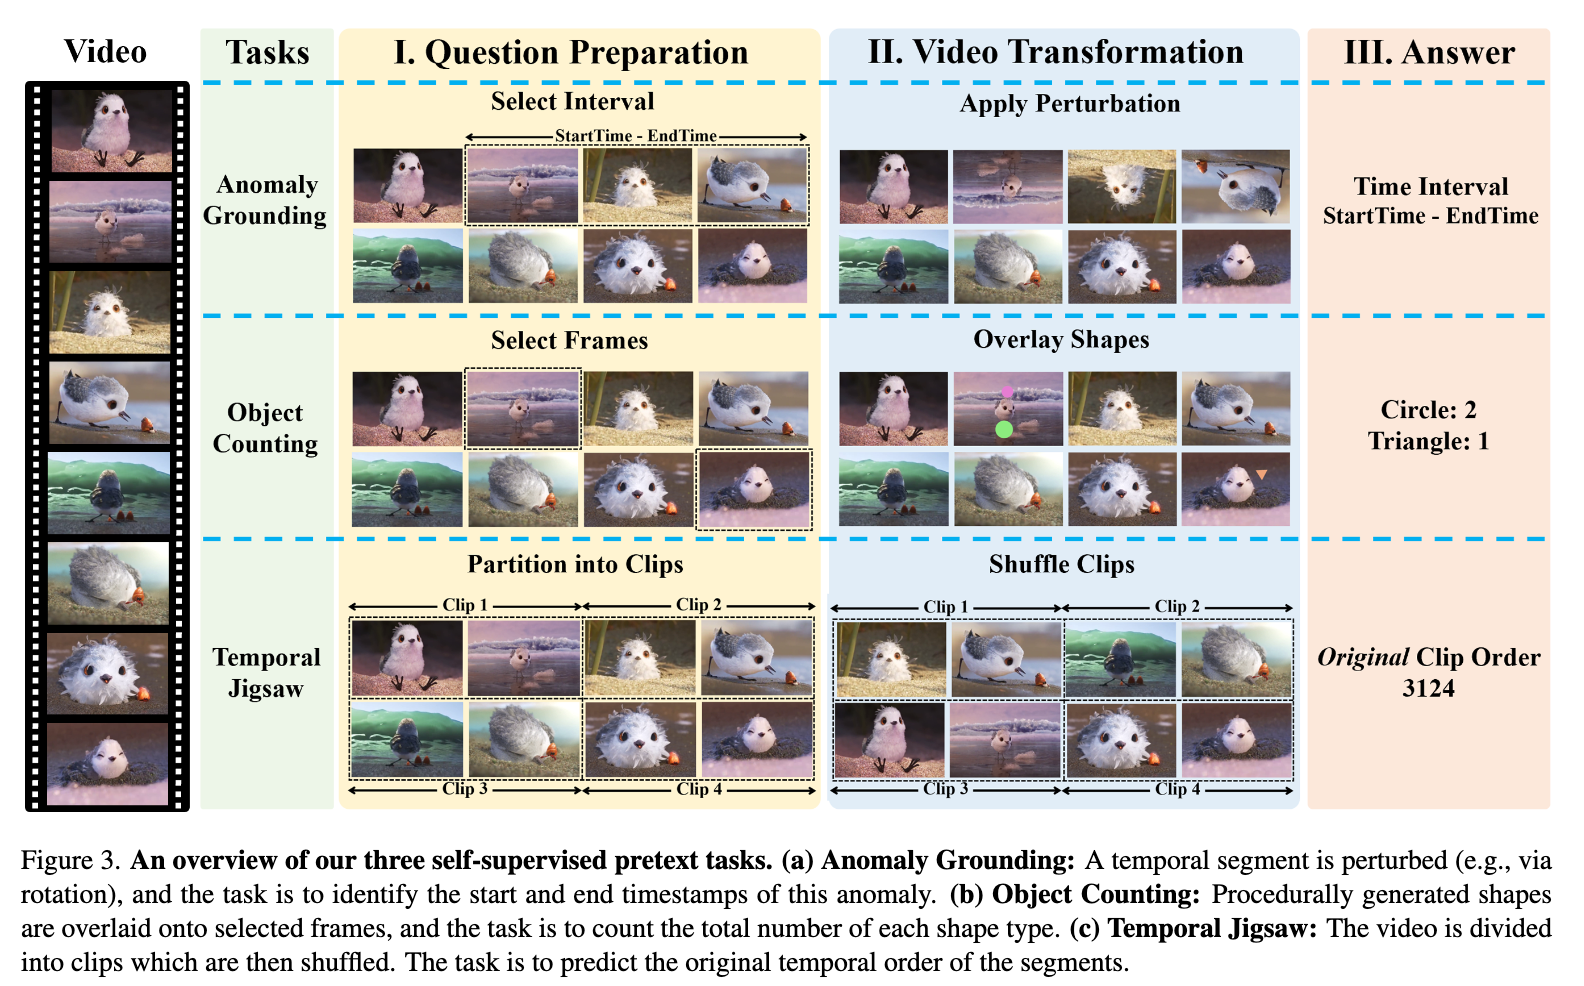
原始视频 → 设计自监督预训练任务 → 自动制造问题和答案 → 可验证奖励 → GRPO 强化学习。
1. 三个自监督预训练任务
任务一:异常定位(Anomaly Grounding)
任务定义:
从原始视频中随机选择一个连续时间段,对其施加扰动,然后要求模型找出异常区间。
例如,可以选择视频中的第 5~9 秒,并做以下处理:
- 交换红色和蓝色通道;
- 将片段旋转 180 度;
- 随机打乱该片段内的帧序;
- 删除、重复或加速部分帧。
随后把扰动后的片段放回原视频,形成新视频。模型需要预测异常段的: ( t s , t e ) (t_s,t_e) (ts,te),也就是异常开始和结束时间。
考察能力:
| 扰动类型 | 主要考察能力 |
|---|---|
| 颜色通道交换 | 细粒度视觉感知 |
| 旋转、镜像 | 空间感知 |
| 帧序打乱 | 时间顺序感知 |
| 删除或重复帧 | 时间连续性与完整性 |
| 片段加速 | 动态变化与速度感知 |
这个任务的优势是:异常位置是在数据构造时随机选定的,答案天然准确。
任务二:物体计数(Object Counting)
任务定义:
在视频的部分帧中叠加程序化生成的几何图形,例如:
- 圆形;
- 矩形;
- 三角形。
每个图形可以随机调整:
- 大小;
- 颜色;
- 旋转角度;
- 出现位置;
- 是否遮挡;
- 出现的帧数。
模型需要统计整个视频中每种图形的总数量。
其数学形式为: N k = ∑ f i ∈ F s u b ∣ { o ∈ O i ∣ t y p e ( o ) = c k } ∣ N_k=\sum_{f_i\in\mathcal{F}_{sub}}|\{o\in O_i\mid type(o)=c_k\}| Nk=∑fi∈Fsub∣{o∈Oi∣type(o)=ck}∣
简单理解就是:每种形状在全部选定帧中的数量之和。
考察能力:
- 小目标识别;
- 细粒度视觉感知;
- 同帧多目标计数;
- 跨帧累计;
- 抗相似颜色、遮挡和位置变化能力。
难度如何控制?
可以通过下面几个参数调整:
- 叠加帧数;
- 每帧物体数量;
- 形状种类;
- 物体大小;
- 颜色相似度;
- 重叠程度;
- 目标出现和消失的时间。
任务三:时间拼图(Temporal Jigsaw)
任务定义:
- 将视频均匀分成 (n) 个连续、不重叠的片段;
- 随机打乱片段顺序;
- 把打乱后的视频交给模型;
- 要求模型恢复原始顺序。
例如,原始片段顺序为: 1 , 2 , 3 , 4 1,2,3,4 1,2,3,4
打乱后可能变为: 3 , 1 , 4 , 2 3,1,4,2 3,1,4,2
模型需要预测逆排列,把视频重新排回: 1 , 2 , 3 , 4 1,2,3,4 1,2,3,4
考察能力:
- 事件发生的先后顺序;
- 动作连续性;
- 场景变化;
- 因果链;
- 局部运动与全局时间结构。
相比单纯问"视频发生了什么",这个任务要求模型更严格地判断"先发生什么、后发生什么"。
2. 三个任务的共同设计原则
这三个任务不是随意选择的,而是共享四项重要性质:
① 不需要人工答案
答案由数据构造过程直接产生,例如:
- 异常区间在生成时就知道;
- 图形数量可以精确统计;
- 打乱方式由排列程序决定。
② 标签没有模型偏见
数据不是由某个"标注模型"猜出来的,因此不会天然继承某个语言模型的思维习惯。
③ 难度可以参数化
论文称之为 parametrically scalable difficulty。
例如:
- 计数物体越多,任务越难;
- 时间片段分得越多,排列越难;
- 异常越细微,定位越难;
- 扰动越接近正常视频动态,任务越接近真实理解。
④ 覆盖视频理解的不同能力轴
- 异常定位:细粒度、空间、时间;
- 物体计数:细粒度感知与跨帧累计;
- 时间拼图:事件顺序和时间一致性。
因此,它不只是训练某一种题目,而是在训练视频理解的基础能力。
三、VIUBench:证明这些任务确实够难
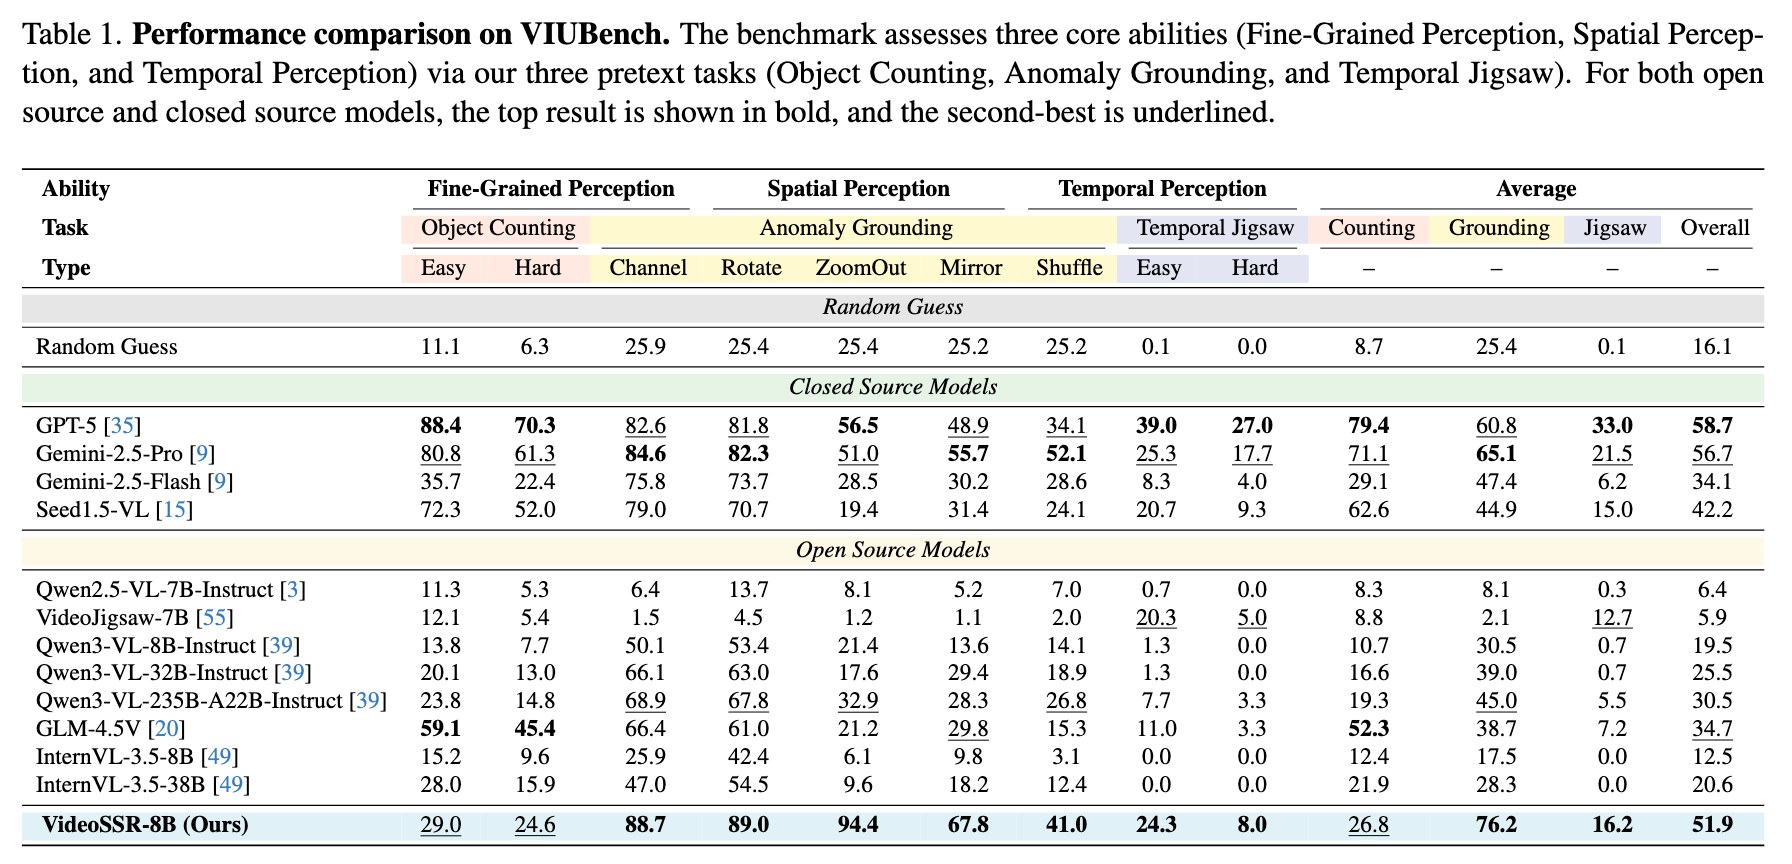
为了验证"模型到底需不需要学这些任务",作者构建了 VIUBench(视频内在理解基准)。
1. VIUBench 的组成
VIUBench 包含 2,700 个视频问答对,由三个预训练任务生成,主要考察:
- 细粒度感知;
- 空间感知;
- 时间感知。
论文报告,当前先进的多模态大模型在这些任务上表现明显不足。即使 GPT-5 这样的领先闭源模型,也未能达到很高水平。
这表明:看懂视频"讲了什么",不等于真正掌握视频的时空结构。
2. 为什么这个基准很重要?
很多传统视频问答存在"语言捷径"。模型可能根据:
- 问题中的高频词;
- 常识答案;
- 视频中显著的静态物体;
- 选项之间的语言差异;
就直接作答,而不必真正理解时间顺序或局部变化。
而 VIUBench 中的异常和扰动是随机施加的,答案与模型的语言先验没有固定关系。模型必须观察视频本身才能作答。
因此,它更适合检验模型是否真正"看懂了视频的时空过程"。
四、VideoSSR-30K 与强化学习训练
1. 数据集构成
作者基于上述任务构造了 VideoSSR-30K 数据集。
其关键特点是:
- 不依赖人工标注;
- 不依赖其他大模型的标注输出;
- 问题和答案完全由原始视频及生成规则确定;
- 覆盖三类基础时空理解任务。
按论文定义,它是一个真正意义上自监督生成、自动验证答案的 RLVR 视频数据集。
2. 使用什么强化学习算法?
论文采用 GRPO(Generalized Reinforcement Learning with Policy Optimization) 进行训练。
GRPO 的核心思想可以简单理解为:
对同一个问题采样多个回答,比较这些回答相对平均水平的好坏,再据此调整模型。
所以,如果一个问题总是全对或全错,多个采样之间没有有效差异,模型很难判断应该向哪个方向改进。
这正好解释了论文为什么要避免"饱和题"和"疑似错误题"。
3. 可验证奖励为什么还不够?
奖励可验证,并不意味着奖励足够好。
例如:
- 预测区间只有轻微偏移,却被判为完全错误;
- 预测顺序几乎正确,但一个位置错误,就直接得零分;
- 计数的最终答案错误,但中间推理基本正确。
这类"硬奖励"会产生稀疏奖励问题:
- 正确与错误之间缺少连续梯度;
- 模型容易获得全零奖励;
- 探索困难;
- 训练不稳定。
4. 平滑奖励函数
VideoSSR 为不同任务设计了连续奖励:
(1)异常定位
使用预测区间与真实区间的 IoU(交并比) 等连续指标:
- 区间完全不重合:低奖励;
- 部分重合:获得中间奖励;
- 完全重合:获得最高奖励。
这使模型能够从"接近正确"中学习。
(2)物体计数
不再只判断"总数完全正确"。论文设计更接近连续误差的奖励,使模型:
- 少计一个物体时不会与完全答错得到完全相同的惩罚;
- 能够逐步学习更准确的计数策略。
(3)时间拼图
使用排列之间的位置偏差等连续度量,例如预测序列离真实逆排列有多远,而不是只用"是否完全正确"进行二值判断。
其本质是:
把原本"全对或全错"的考试,改造成一个能够反馈接近程度的学习信号。
五、实验设计与主要结果
1. 实验覆盖哪些任务?
论文在 17 个视频基准上进行测试,覆盖四类任务:
- 通用视频问答
- 长视频问答
- 时间定位
- 复杂视频推理
实验还测试了不同输入帧数设置,以观察方法在 32、48、64 帧等条件下的稳定性。
2. 主要结论
论文报告的核心结果是:
- VideoSSR 在全部 17 个基准上均取得提升;
- 使用 48 输入帧时,平均提升超过 5%;
- 改善不只发生在任务最相近的测试集上;
- 基础视频问答、长视频问答、时间定位和复杂推理均出现正迁移。
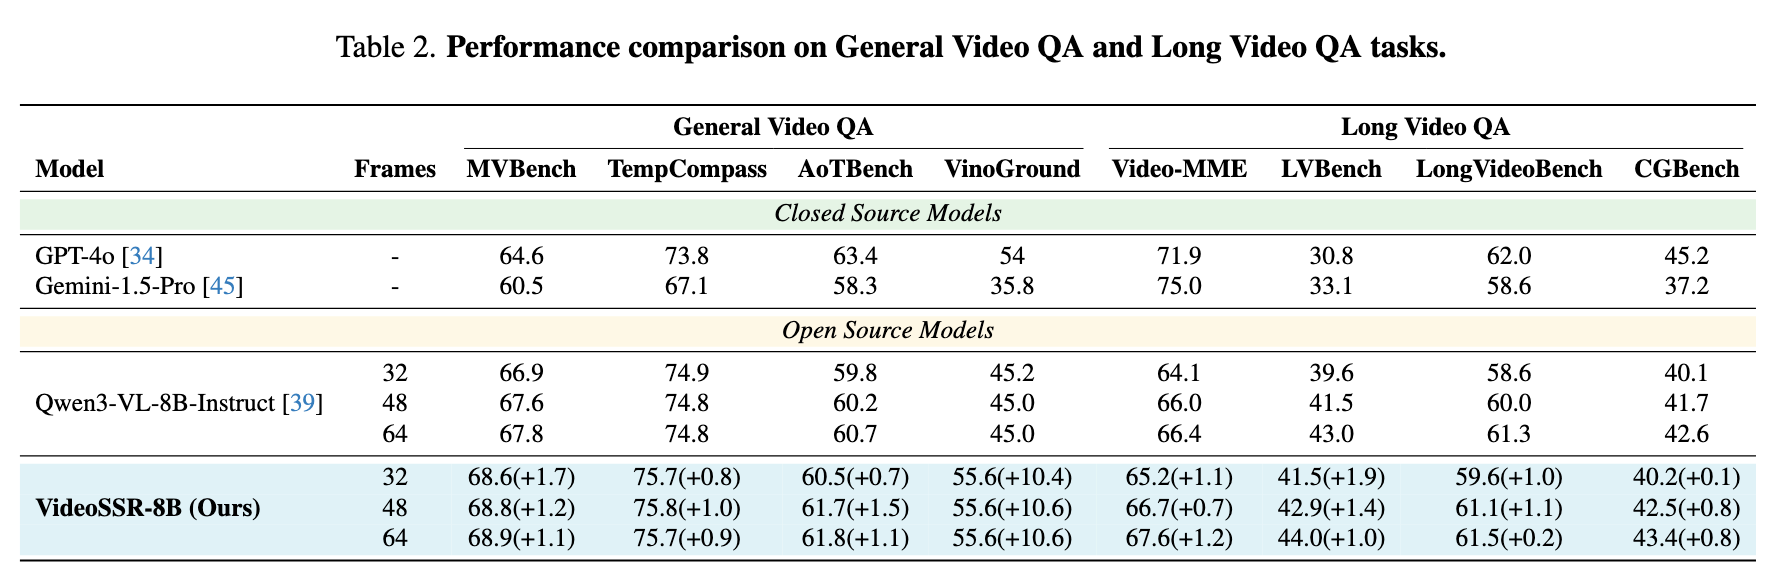
这说明三个合成任务并非单纯"刷同类题",而是在强化更通用的视频理解能力。
3. 代表性提升方向
| 下游能力 | 可能受益于哪个预训练任务 |
|---|---|
| 时间戳定位 | 异常定位 |
| 事件顺序判断 | 时间拼图 |
| 长视频事件检索 | 异常定位、时间拼图 |
| 多目标感知 | 物体计数 |
| 动作因果推理 | 时间拼图 |
| 局部视觉变化检测 | 异常定位 |
值得注意的是,任务之间并不是简单的一一对应。例如,时间拼图培养的顺序理解,也可能帮助复杂推理;异常定位带来的局部变化感知,也可能促进时间定位。
六、结果分析:为什么 VideoSSR 会有效?
1. 训练题和下游任务之间存在"能力共享"
VideoSSR 没有让模型直接背诵复杂的视频问答,而是训练以下基础能力:
- 关注局部变化;
- 跟踪连续时间;
- 恢复事件顺序;
- 精确识别细粒度目标;
- 在多个时间片段间建立关系。
这些能力是许多高级视频任务的底层组件。因此,基础能力提升后,可以在多个下游任务上产生迁移。
2. 避免了"越教越偏"的弱标注
传统多智能体标注存在这样一个风险:
弱标注模型认为对的,未必真的对;强训练模型已经知道错的,却被强迫学习。
VideoSSR 的标签由视频操作规则产生,训练目标更客观。其优势不是"数据一定更自然",而是数据来源更简单、答案更可控、偏见更容易分析。
3. 难度可调,缓解数据饱和
当模型变强后,可以:
- 增加时间片段数量;
- 增加计数物体数量;
- 使用更细微的扰动;
- 减少扰动持续时间;
- 增加相近片段的视觉歧义。
这使同一套数据生成机制能够持续制造新挑战,而不必每次重新雇佣大量标注人员。
4. 平滑奖励提升了困难任务的训练效率
对于答案结构复杂、容错空间低的任务,纯二值奖励很容易让模型长期"得不到正反馈"。
平滑奖励使模型可以从部分正确中继续学习,因而更适合:
- 时间区间;
- 排列顺序;
- 多类别计数;
- 坐标或边界框;
- 轨迹、路径等结构化输出。
因此,这套奖励设计思想可能不只适用于视频,也可以迁移到其他具有结构化答案的 RLVR 任务。
七、论文的主要贡献
-
提出一种新的数据生成范式
利用视频内在信号自动生成可验证训练数据,减少人工成本和标注偏见。
-
设计三类基础视频任务
包括异常定位、物体计数和时间拼图,分别针对局部视觉变化、细粒度感知和时间顺序。
-
建立 VIUBench 与 VideoSSR-30K
VIUBench 证明先进模型在视频内在理解上仍然薄弱;VideoSSR-30K 为 RLVR 提供无需人工或模型标注的数据。
-
提出 VideoSSR 与平滑奖励机制
针对困难任务中的稀疏奖励问题,使强化学习训练更加稳定、有效。
八、局限性与理性评价
尽管论文结果较强,但也不能把"平均提升 5%"直接理解为模型获得了全面的通用视频智能。
1. 合成扰动不等于真实视频困难
异常定位中的旋转、颜色交换、帧序打乱,是清晰的人工规则。真实视频中的异常可能是:
- 不符合常识的动作;
- 逻辑上的前后矛盾;
- 非常自然的错误;
- 没有明确视觉边界的变化。
模型有可能学会识别"人工编辑痕迹",而不只是学习一般性的异常理解。
2. 合成图形与真实物体存在分布差异
计数任务使用的是程序化几何图形。虽然数字可精确统计,但真实视频中的物体存在:
- 变形;
- 严重遮挡;
- 运动模糊;
- 类别边界模糊;
- 跨镜头外观变化。
因此,"计数几何图形"和"计数真实世界物体"的能力迁移需要谨慎验证。
3. 时间拼图并非总有唯一答案
许多视频片段,尤其是静态场景或循环镜头,可能存在多个合理顺序。论文把逆排列当作唯一正确答案,这种评估虽然便于自动评分,但可能与人类判断存在冲突。
4. 当前证据主要集中在一个基础模型
公开论文信息显示,VideoSSR 主要以 Qwen3-VL-8B 为核心实验对象。
因此,目前最有说服力的结论是:
在 Qwen3-VL-8B 上,VideoSSR 具有持续、跨任务的提升效果。
至于该方法能否同样适用于:
- 更大规模模型;
- 不同架构;
- 闭源模型;
- 更长的视频;
- 更复杂的真实场景;
还需要进一步实验。
5. 实验设置仍然有限
论文公开解读显示,训练和测试主要围绕较低输入帧数展开,重点并非真正长时、高帧率的超长视频。合成任务帮助模型改善时间结构理解,并不等于已经解决了小时级视频中的长期记忆和检索问题。
要判断它能否成为通用的视频 RLVR 基础设施,未来还需要重点验证:
- 合成痕迹是否影响真实场景迁移;
- 是否存在测试集与数据源重叠;
- 在其他模型架构上是否仍然有效;
- 在更长、更高帧率视频上能否保持优势;
- 任务组合与难度如何系统性缩放;
- 模型是否真正理解语义异常,还是主要检测人工扰动。