写在前面
欢迎大家关注Rocky的知乎:Rocky Ding
《三年面试五年模拟》AIGC/LLM/AI Agent算法工程师/开发工程师求职面试秘籍独家资源:【三年面试五年模拟】WeThinkIn/AIGC-Interview-Book,欢迎大家Star~
Rocky最新撰写的10万字AI Agent(AI智能体)深入浅出全维度解析文章: 深入浅出完整解析AI Agent(AI智能体)的核心基础知识
AIGC/LLM/AI Agent算法岗/开发岗求职面试内推学习社群 (涵盖AIGC、LLM大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI等AI行业最新面试干货经验与核心知识)欢迎大家加入:https://t.zsxq.com/33pJ0
大家好,我是Rocky。
核心导读:VideoChat3 如何分配有限的视觉预算
视频模型很容易陷入一种资源矛盾。为了看清细微运动,需要更多帧;为了读懂小物体和文字,需要更高分辨率;为了追踪长事件,还需要更长的上下文。把这三项同时拉高,视觉 token 会迅速挤占语言模型的计算和显存预算。
VideoChat3 给出的解决路径覆盖两层:在视觉编码阶段,将相邻帧组织成时空表示,压缩重复信息;在流式推理阶段,让模型的响应状态控制下一窗口的视觉分辨率,把细节预算集中到可能需要回答的时刻。配套的数据工程再教会模型"证据在哪里""何时足以作答"。
Rocky认为,VideoChat3 最值得研究的,是感知资源怎样随证据状态变化。 视觉压缩决定同样预算能看多少,主动感知决定预算花在哪里,时机监督决定看到了以后是否该开口。这三件事彼此制约,不能仅靠一个更大的语言骨干解决。
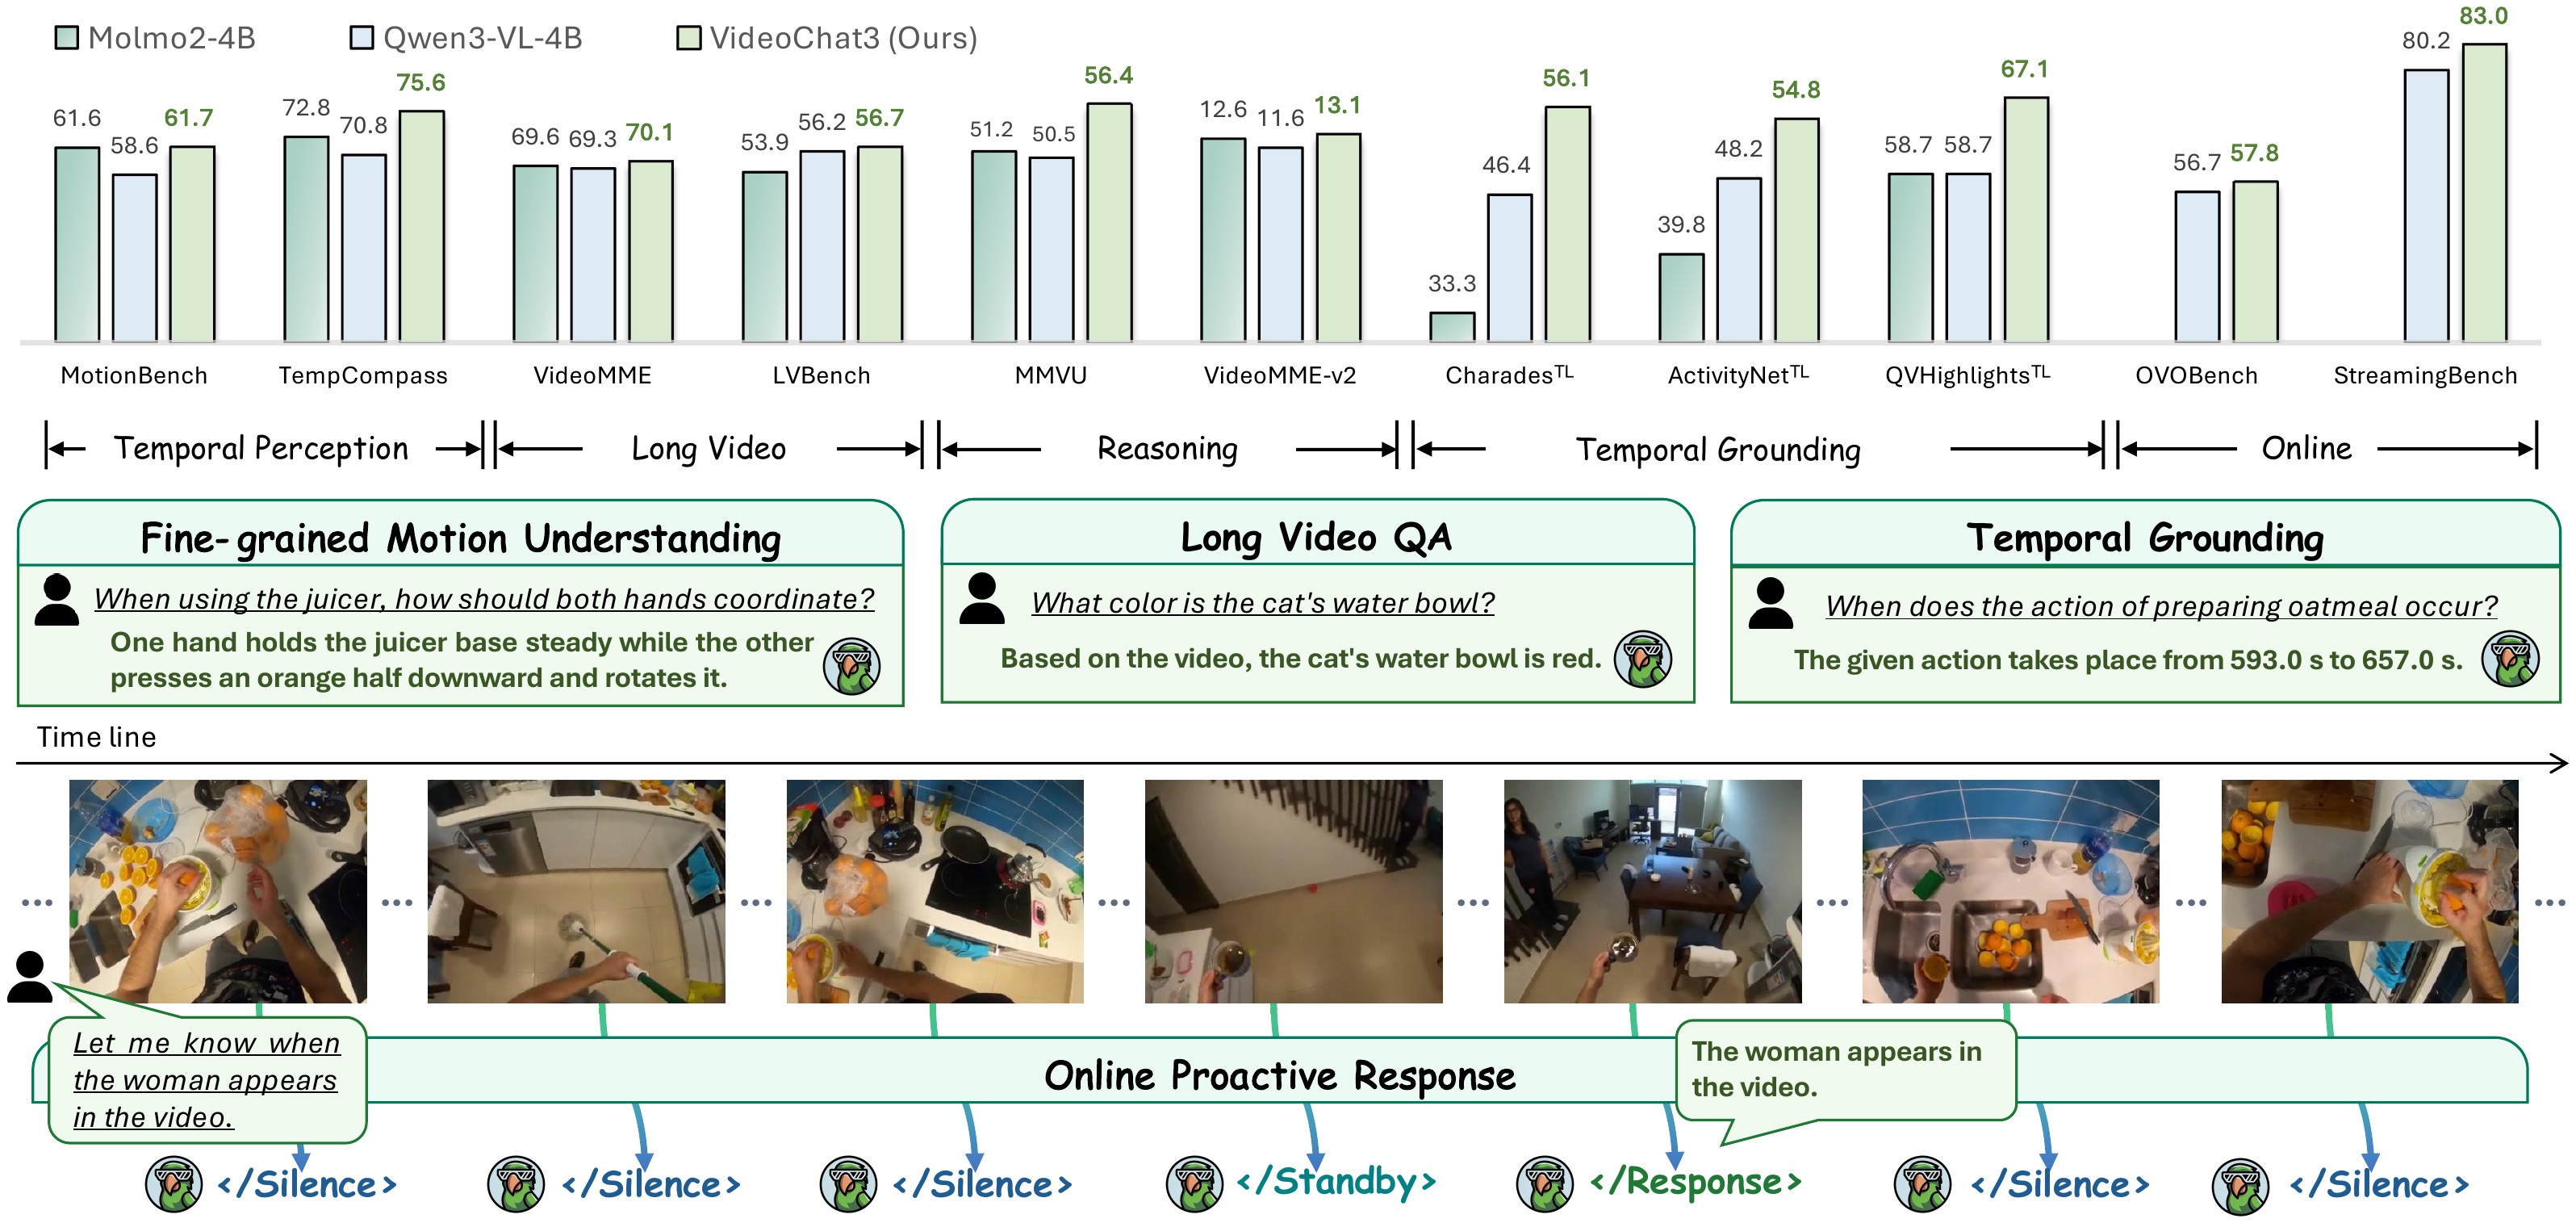
VideoChat3 是一个 4B 级通用视频多模态模型。本文依据 arXiv 2607.14935 v2、官方代码与发布资料,保留正文及附录的全部 15 幅图、12 张表。实验数字来自论文,本文没有重新训练模型或独立运行基准。
1. VideoChat3 的视觉入口:先建模运动,再压缩 token
普通图像编码器逐帧提取特征时,相邻帧的大量背景被反复编码,运动关系则留给后面的语言模型推断。如果为了控制长度而大幅降低采样率,短暂动作可能在进入模型前就消失了。
VideoChat3 的 I3D-ViT 从 MoonViT 初始化,在包含 T T T 帧的 chunk 内联合进行时空注意力,并加入可学习时间嵌入。随后沿时间轴池化,输出已包含局部运动上下文的紧凑表示。
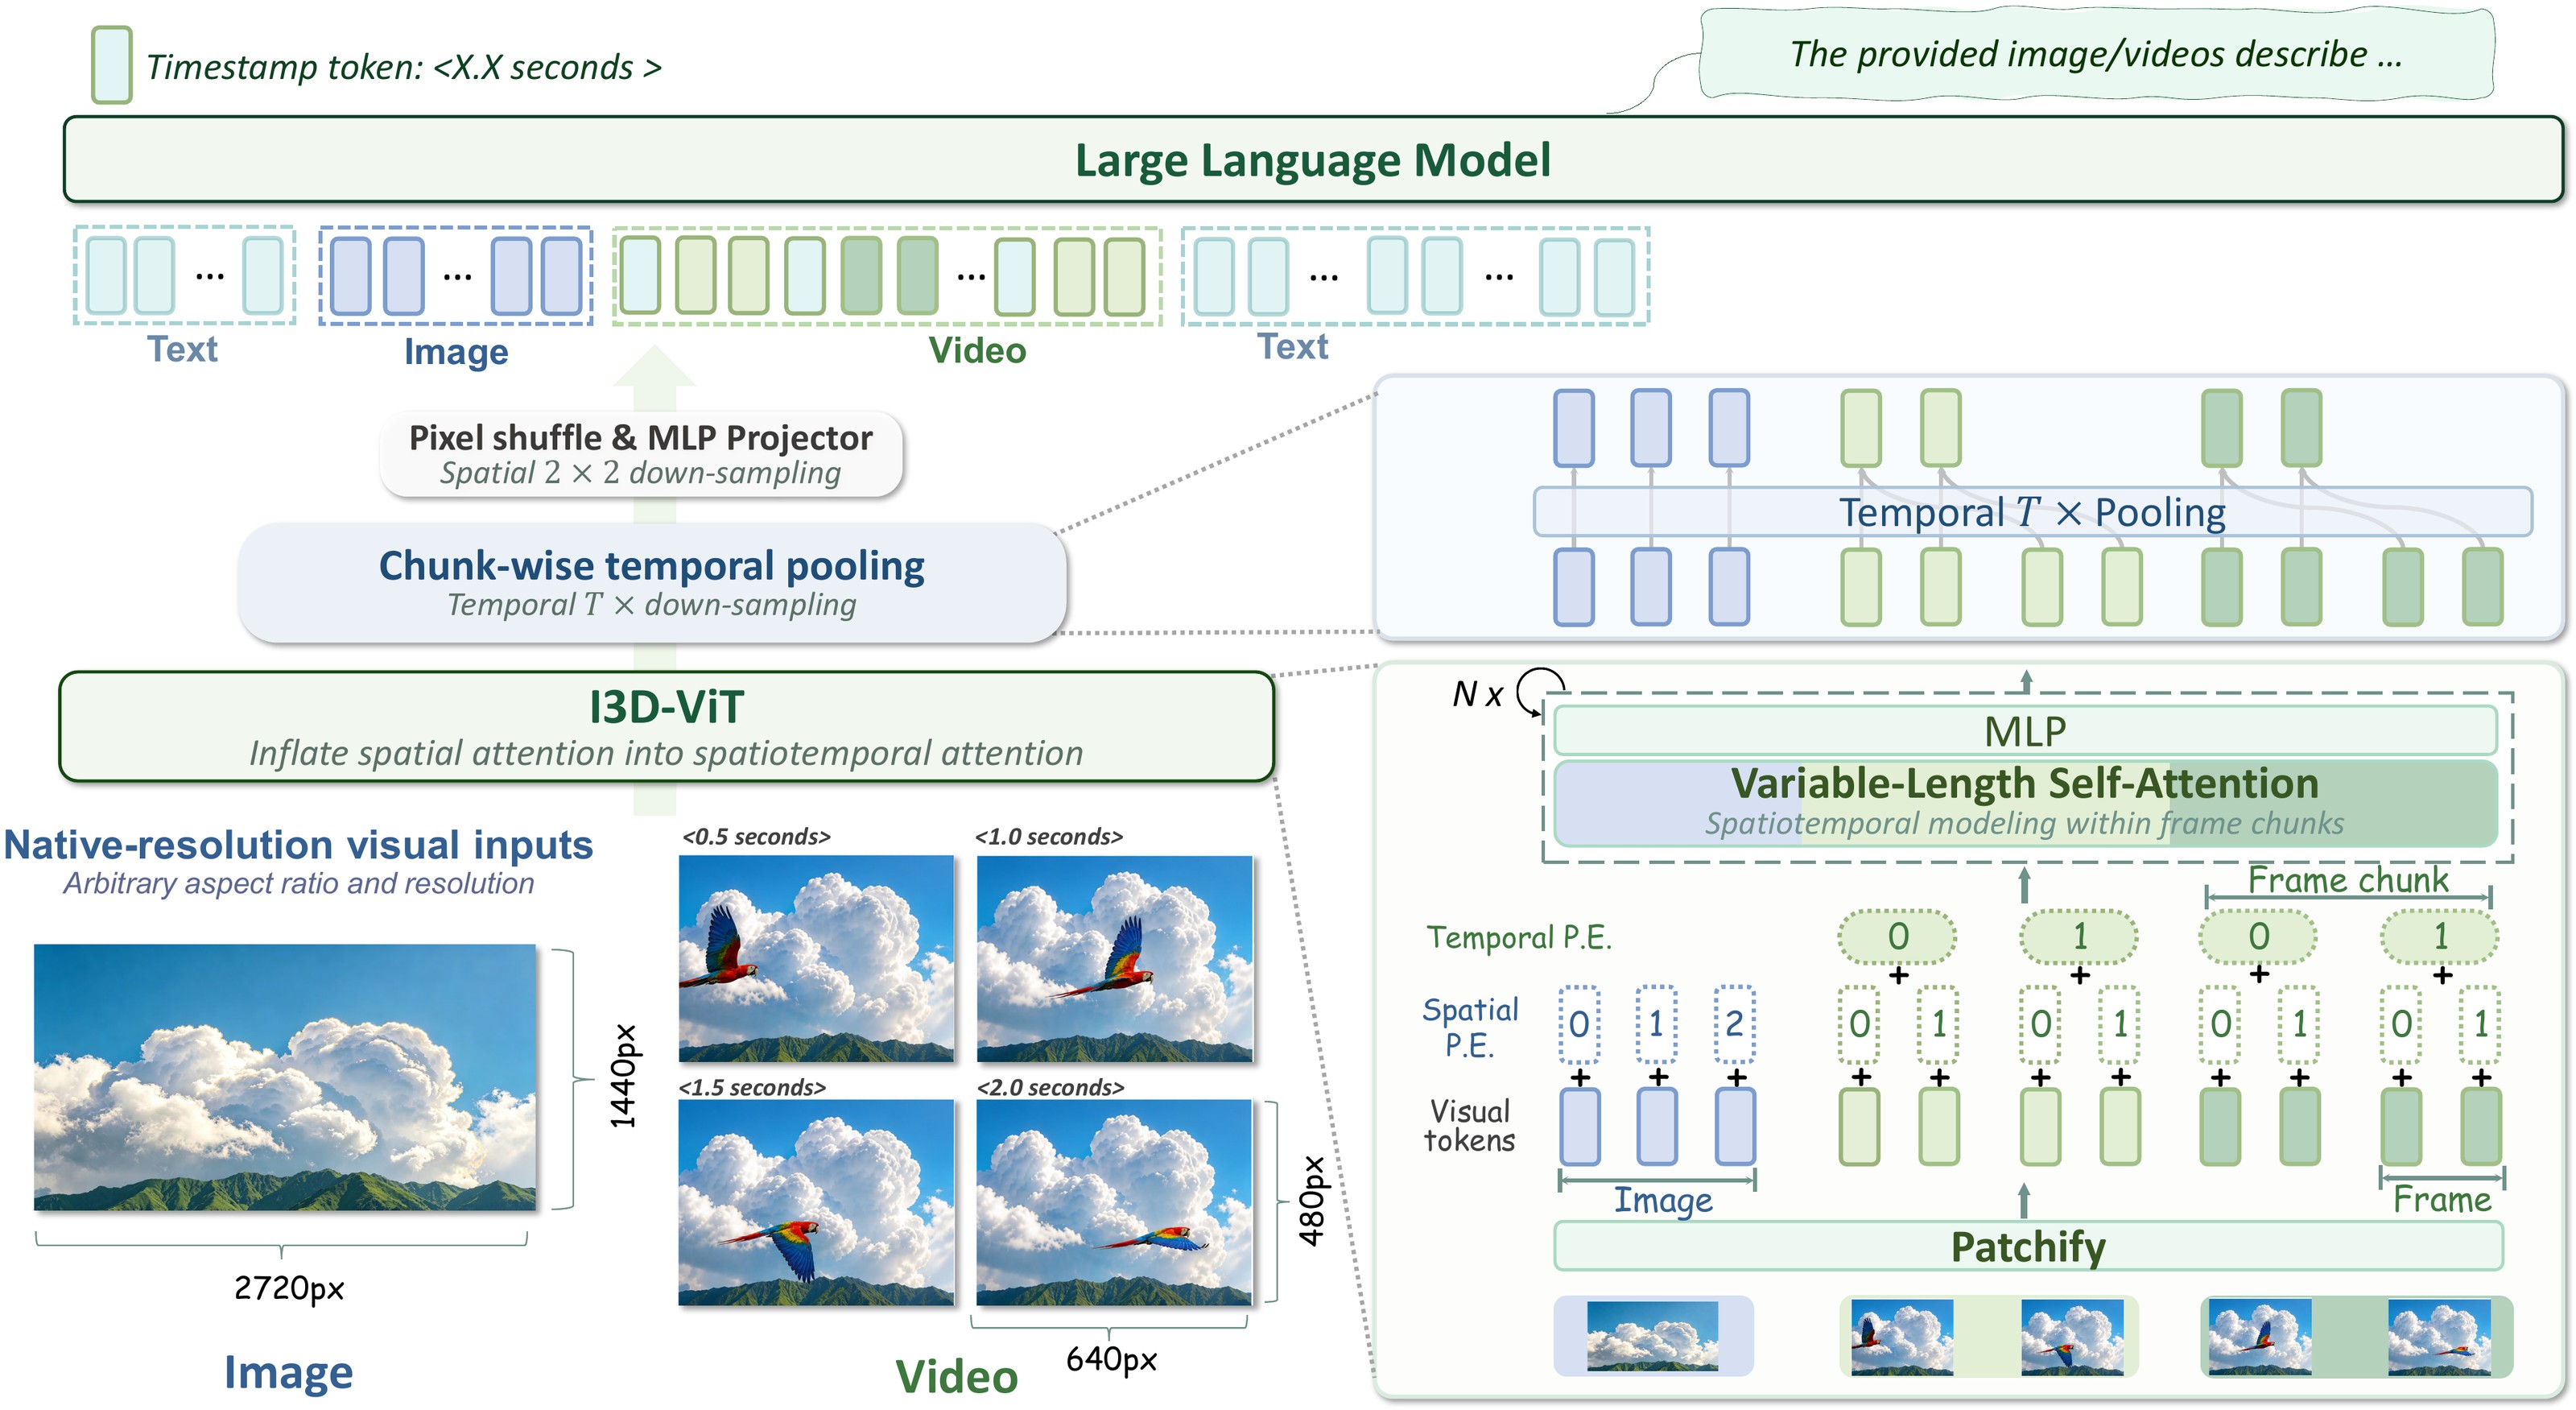
默认 T = 4 T=4 T=4,再结合 pixel shuffle 的 2×2 空间降采样,相对原始 patch 网格形成 4 × 2 × 2 = 16 4\times2\times2=16 4×2×2=16 倍 token 压缩。这里的参照物非常重要:它是相对未经该时空合并的 patch 数,不是相对任意视频模型都少 16 倍 token,更不是端到端速度提高 16 倍。
为了先聚合时空关系,视觉编码器本身会付出额外计算。总体收益取决于减少的语言模型开销能否超过增加的视觉编码开销。长视频中这一交换更有利,因为大量视觉 token 一旦进入语言序列,会影响后续各层的注意力计算和缓存。
压缩也引入信息选择。一个短暂出现的细节是否在池化后保留,取决于视觉训练是否赋予它足够区分度。论文中的视频性能提升支持这条路线,但不能推出时空池化对所有高频事件都无损。
2. VideoChat3 的主动感知:状态控制下一窗口
对实时助手而言,始终使用最高分辨率成本很高;始终低分辨率又可能看不清关键细节。VideoChat3 让每个窗口后的状态 token 同时承担交互判断与下一次感知预算控制。
三个状态分别是 Silence、Standby、Response。Silence 表示当前没有任务相关证据;Standby 表示已经出现线索,但证据尚不充分;Response 表示可以开始生成答案。
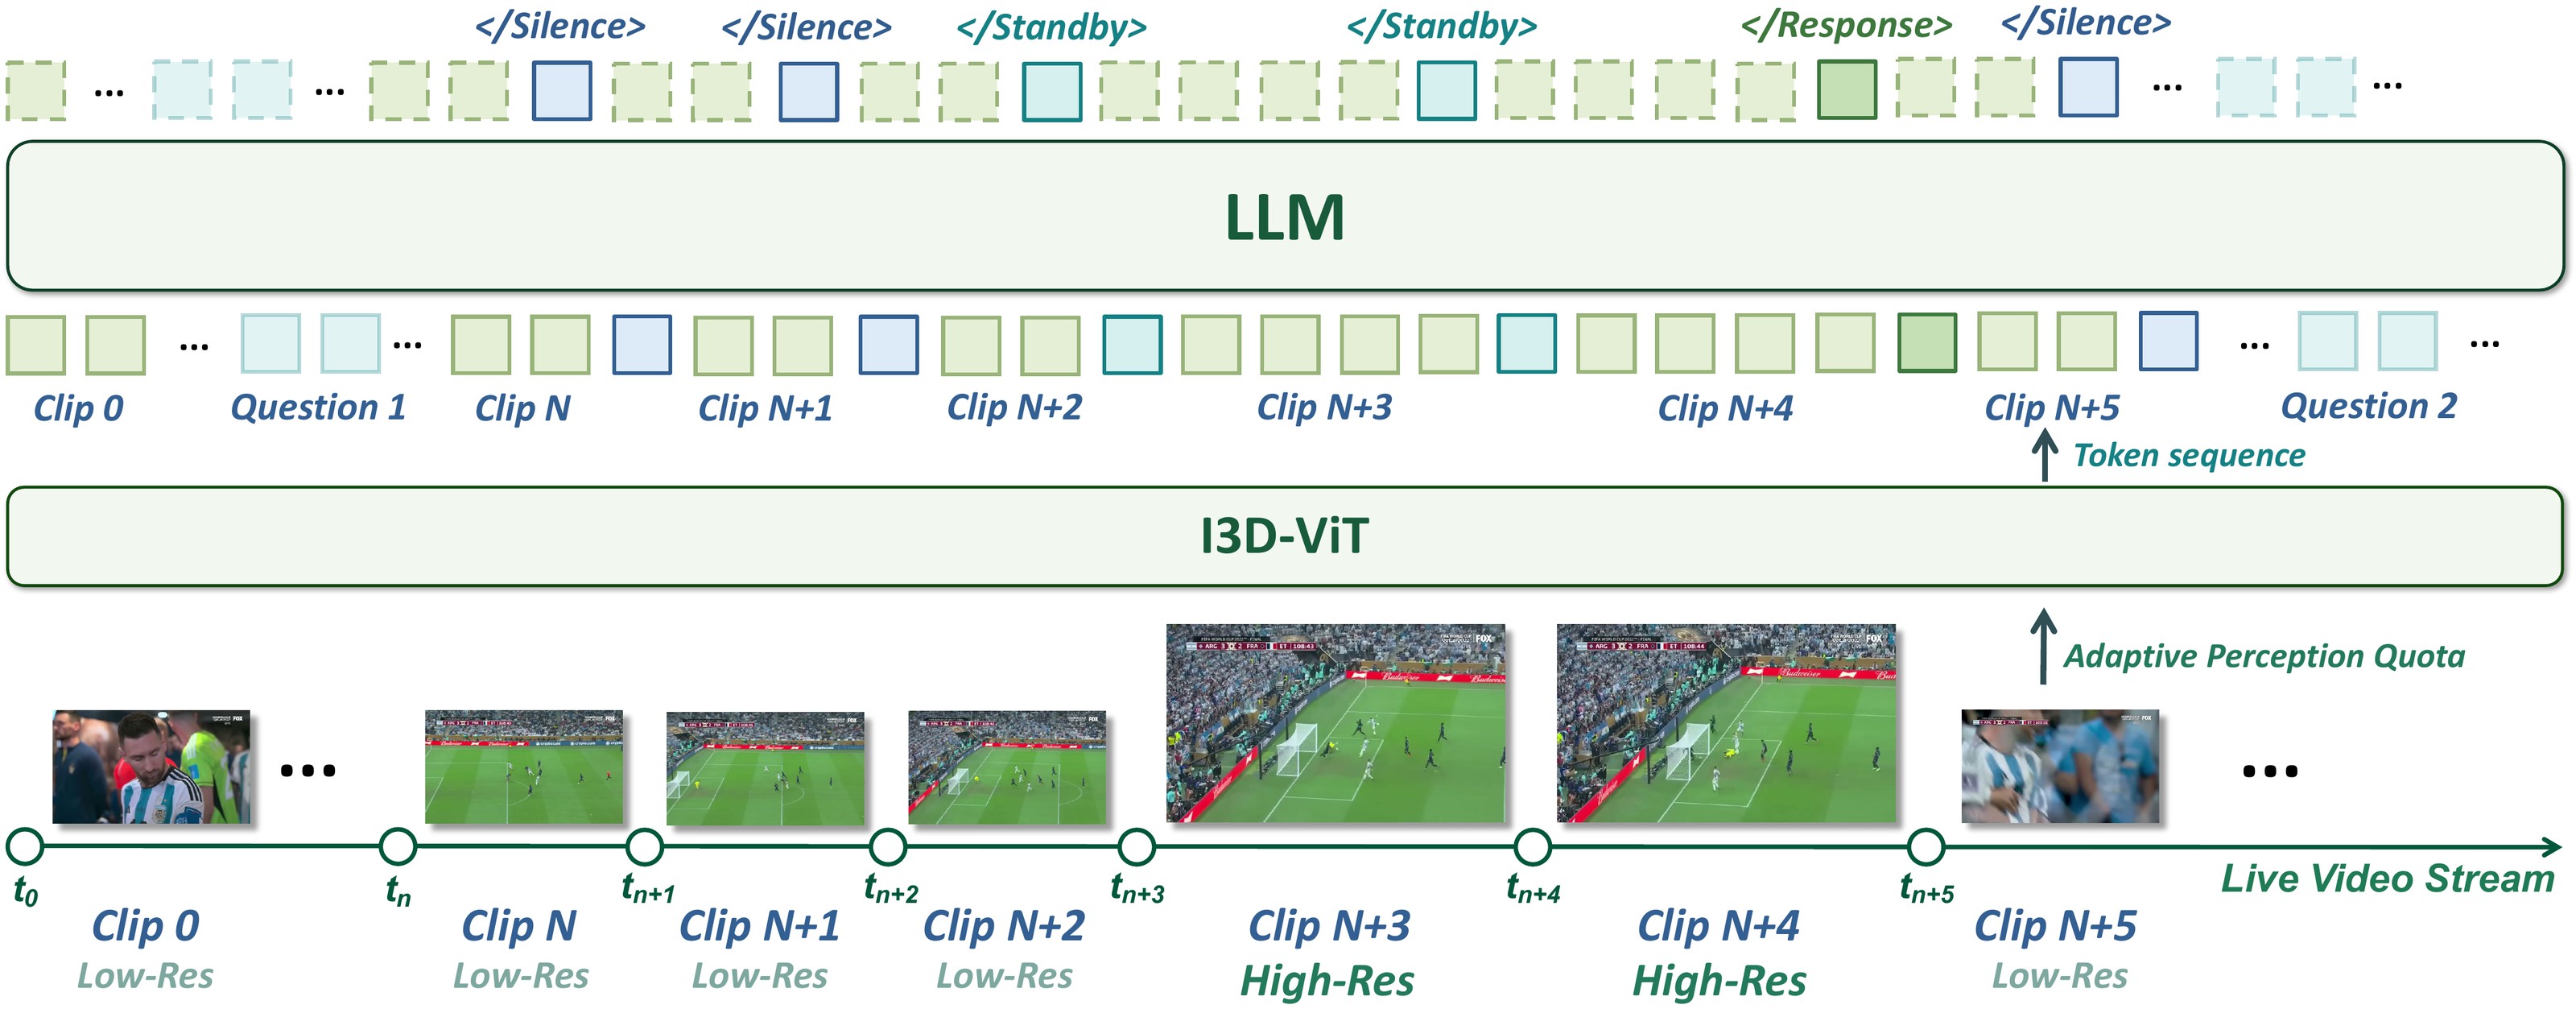
沿用论文的控制器定义,令 s t s_t st 为当前窗口处理后的状态, b t + 1 b_{t+1} bt+1 为下一窗口每帧像素预算:
b t + 1 = { B l o w , s t = S i l e n c e , B h i g h , s t = S t a n d b y , B l o w , s t = R e s p o n s e , B l o w = 224 2 , B h i g h = 448 2 . b_{t+1}=\begin{cases} B_{\mathrm{low}},&s_t=\mathrm{Silence},\\ B_{\mathrm{high}},&s_t=\mathrm{Standby},\\ B_{\mathrm{low}},&s_t=\mathrm{Response}, \end{cases} \qquad B_{\mathrm{low}}=224^2,\quad B_{\mathrm{high}}=448^2. bt+1=⎩ ⎨ ⎧Blow,Bhigh,Blow,st=Silence,st=Standby,st=Response,Blow=2242,Bhigh=4482.
这些数值是像素额度,输入按原始长宽比等比缩放,不要求强制变成正方形。例如 5:3 的画面在低预算下可以编码成 280×168。Standby 后提升的是后续窗口的清晰度,并没有自动回头恢复已经漏掉的短暂事件。
这也揭示了控制器的前提:低成本观察必须足以发现"值得多看"的先兆。足球进攻可以先看到球员冲向球门,再提高预算判断射门;瞬间出现又消失的微小目标未必给系统这种机会。因此,迁移到质检、告警或医疗监测前,应先测低分辨率触发器的召回率。
3. Academic2M:把标签扩展成可落在画面上的证据
压缩后的表示能否保留运动,需要训练信号明确告诉模型哪些变化重要。很多学术视频数据只提供选项字母或简短动作名称,标签可靠,却没有充分表达支持答案的视觉证据。
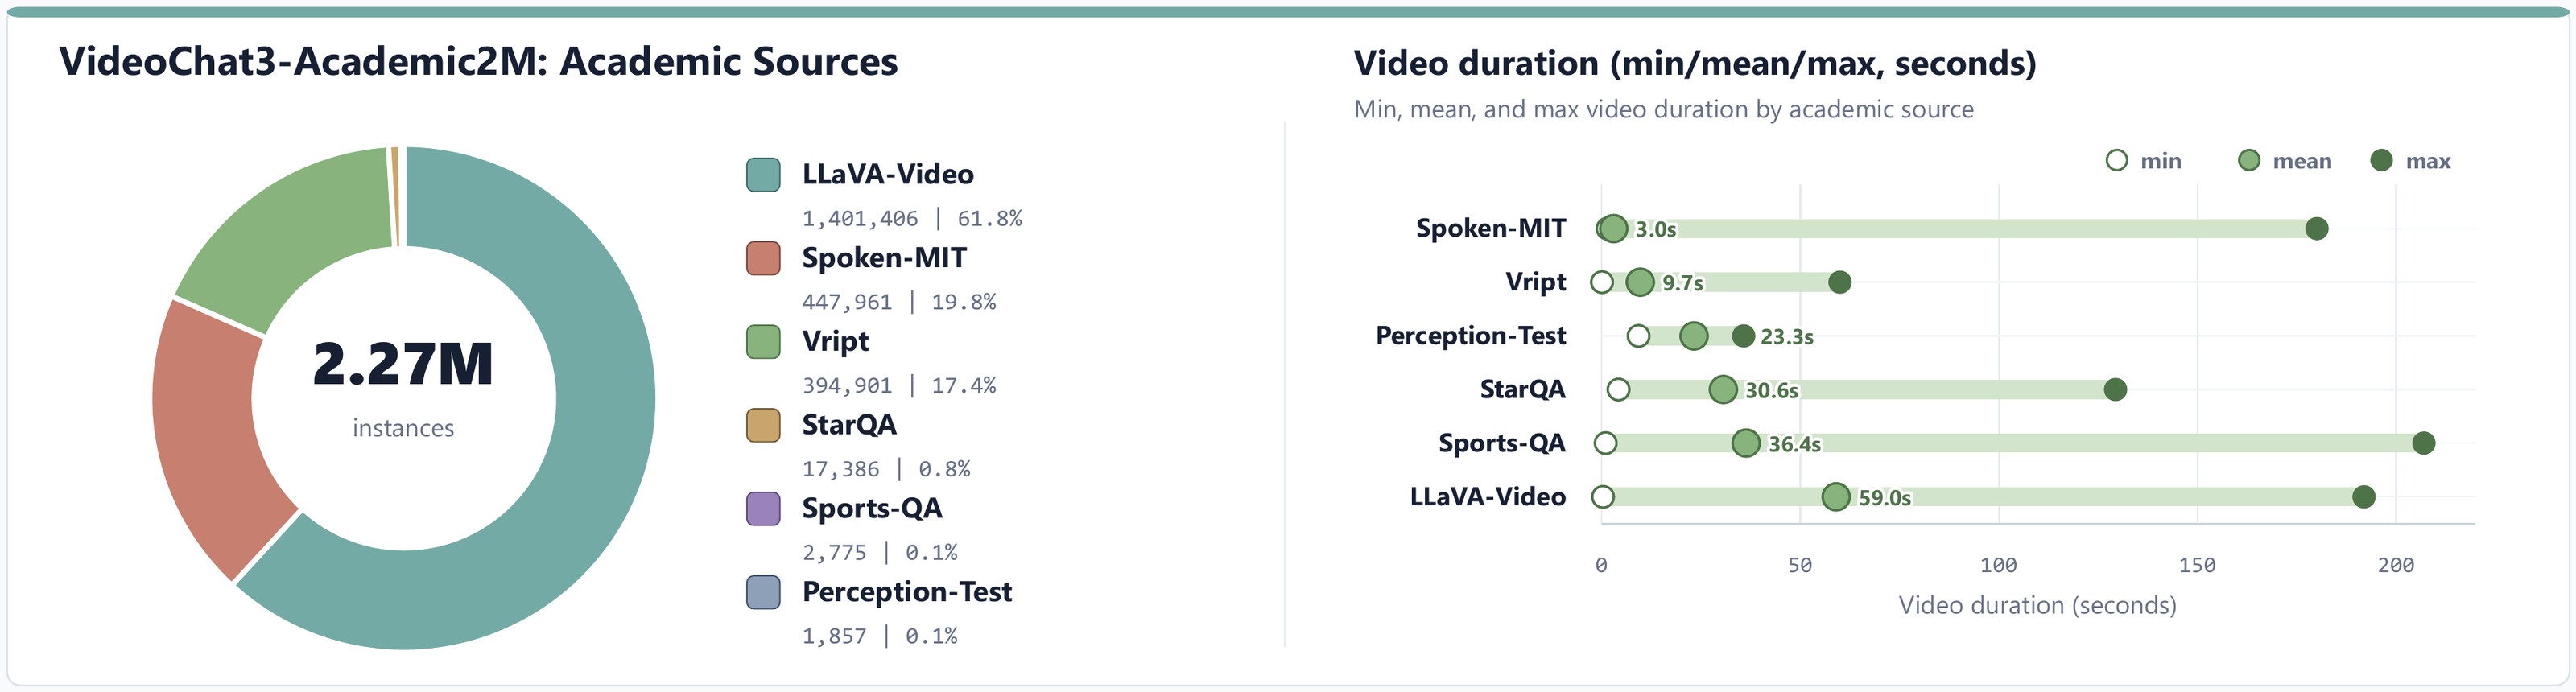
Academic2M 名称中的"2M"是规模简称,完整统计约为 2.27M 个 caption/QA 实例,主要来源包括 LLaVA-Video、Spoken-MIT 和 Vript。实例数不能直接当成不同视频数量,也不能与训练打包后的有效样本数混用。
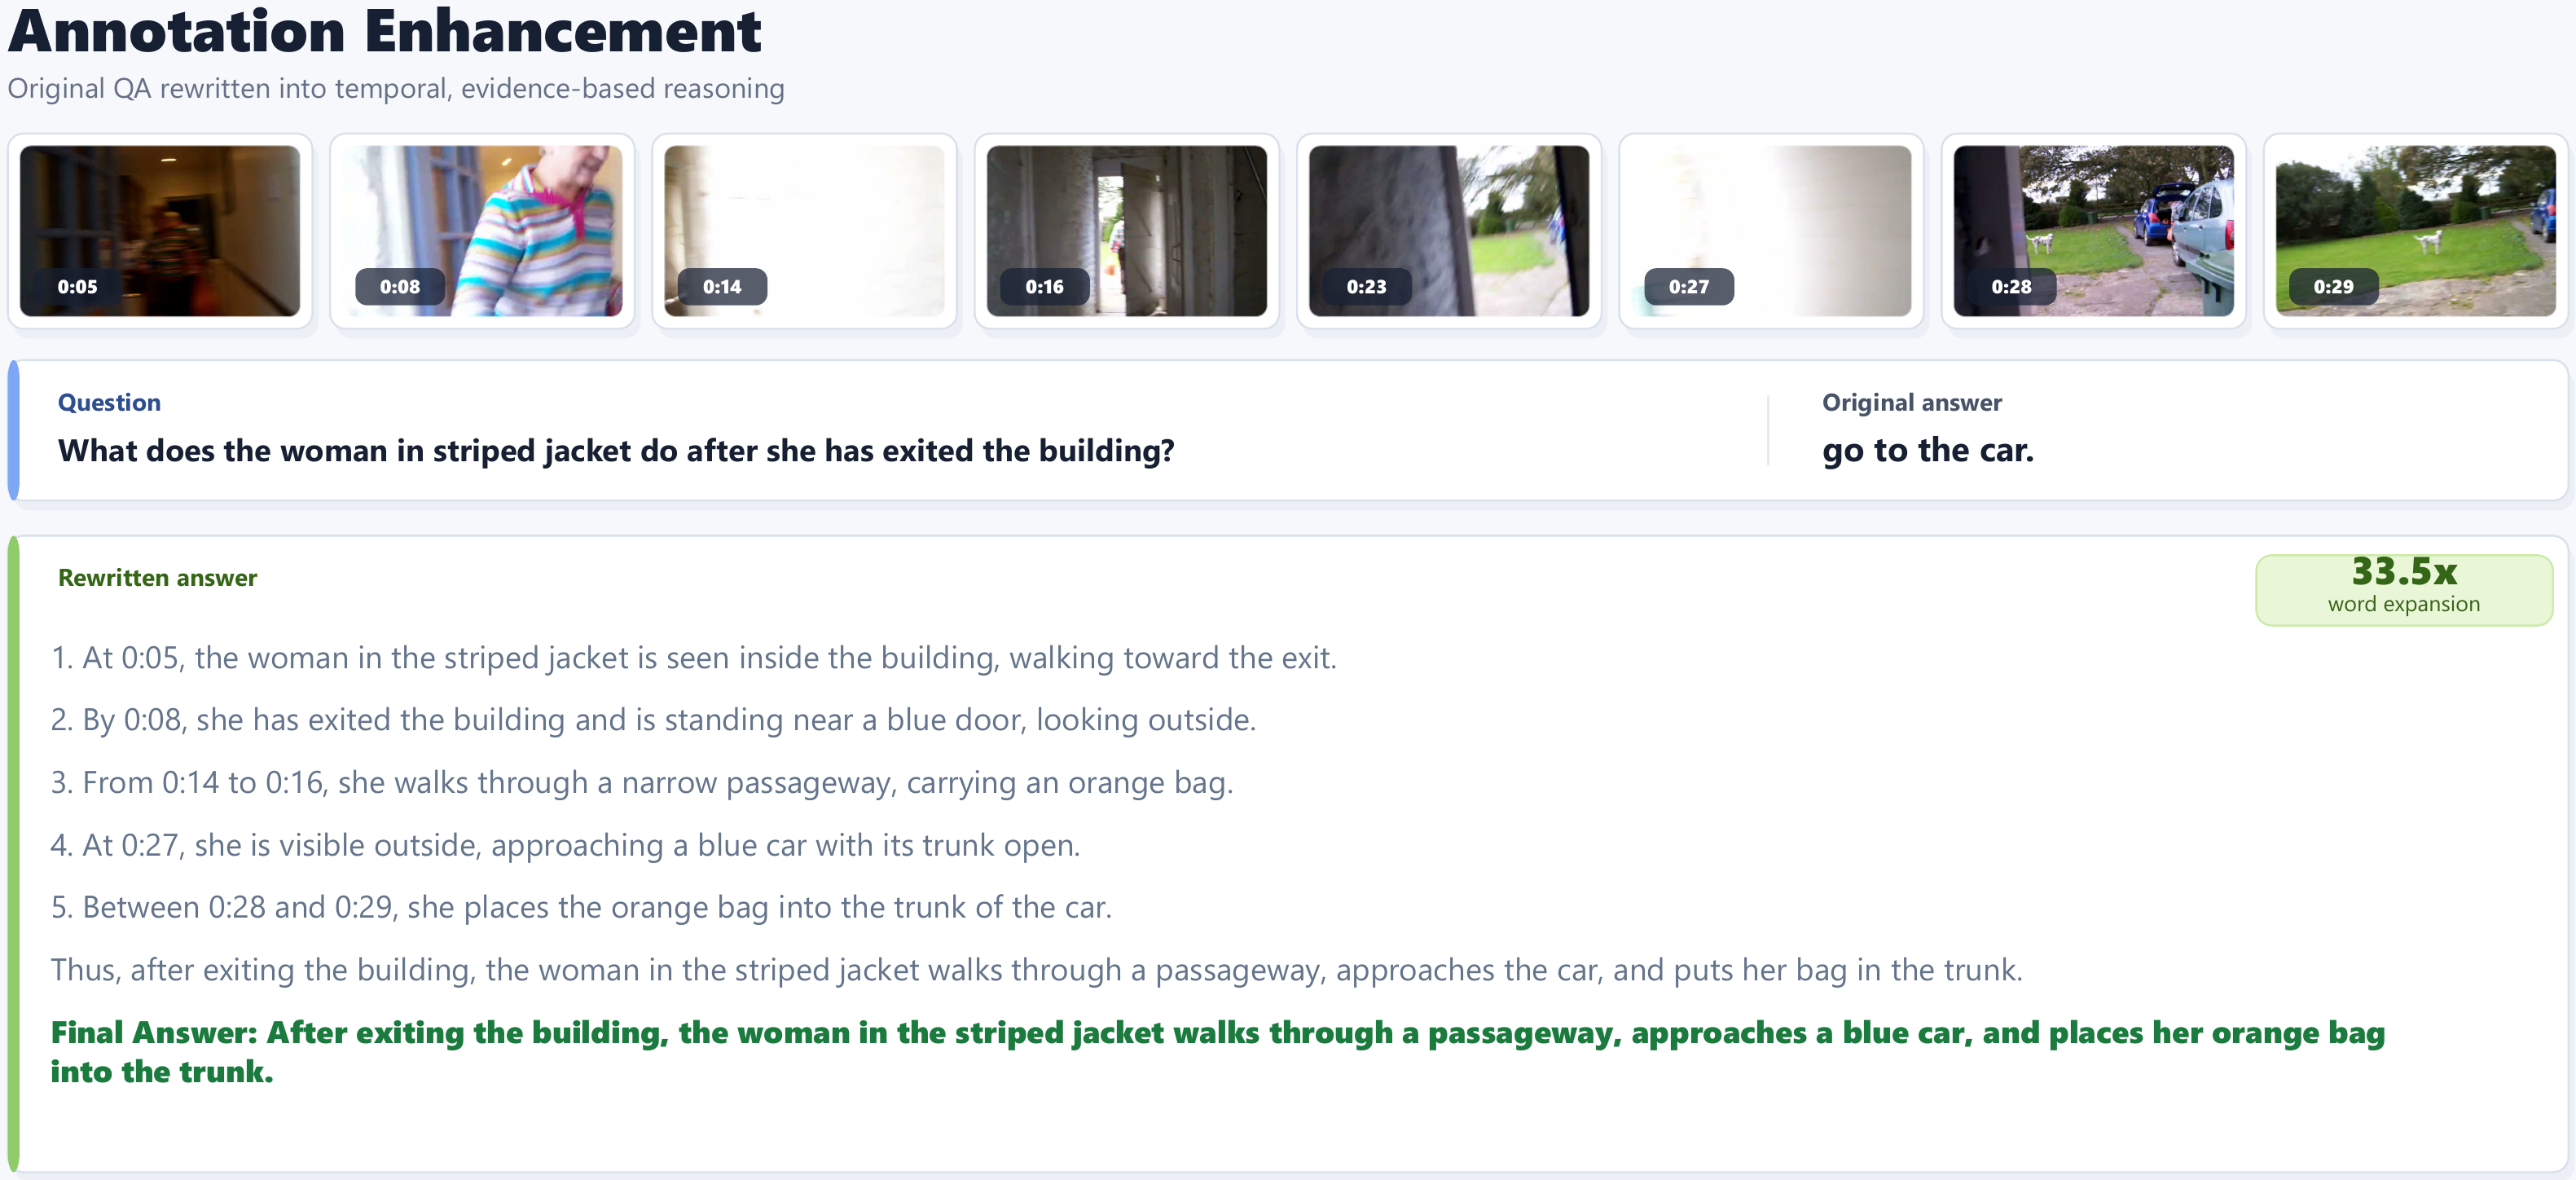
图5对应的方法以已有可靠标注为语义锚点,用教师模型把短答案展开为证据更充分的描述,并通过检查过滤不一致、错误或无依据内容。它的价值是将"答案是什么"与"为什么这段画面支持答案"联结起来。
教师重写仍然可能产生视觉臆测、语言偏好和系统性错误。保留原始标签、进行一致性筛查可以降低风险,但不能保证所有扩写内容都正确。复现时应抽查证据句能否定位到帧,尤其是描述因果和动作顺序的部分。
4. LV116K:长视频需要可核对的事件记录
长视频中的相关片段往往相距很远。仅把整段内容交给教师模型生成问题,容易出现混淆时间线、把相似人物合并,以及提问超出视频证据范围等问题。
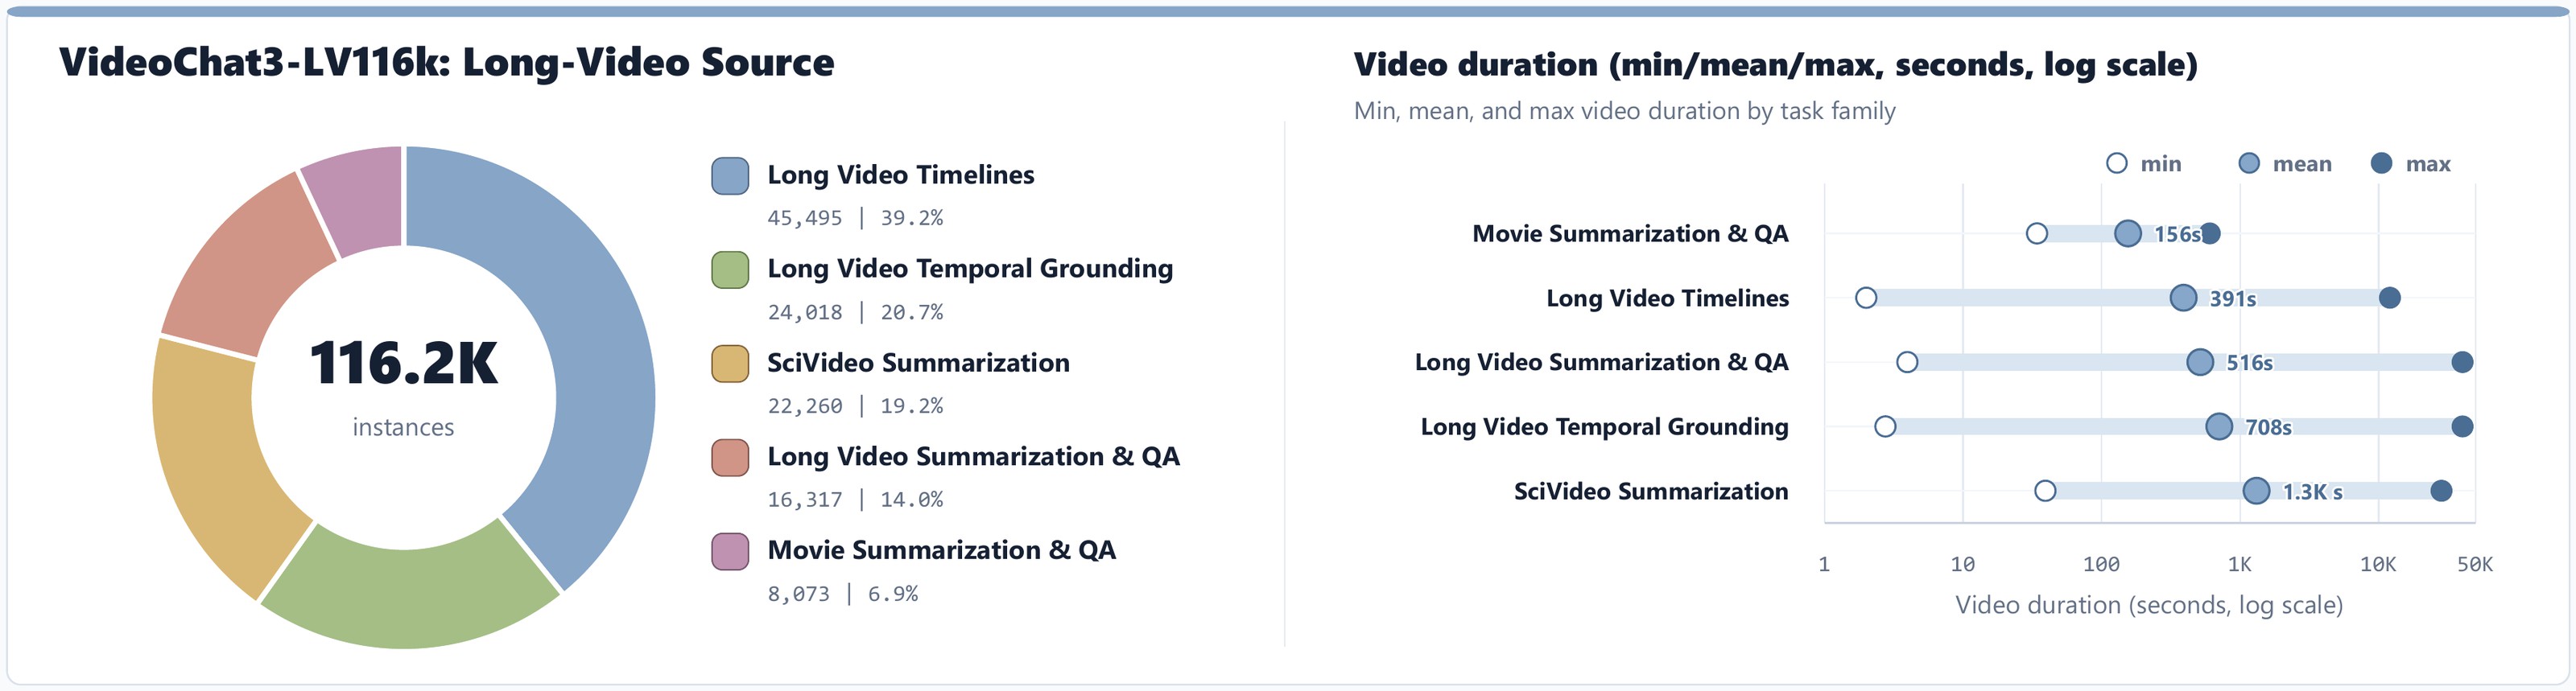
LV116K 包含约 116.2K 条实例,覆盖不同时间长度和任务类型。需要区分数据集名称代表的总实例与各阶段实际抽样使用量,后者会受课程和数据混合比例影响。
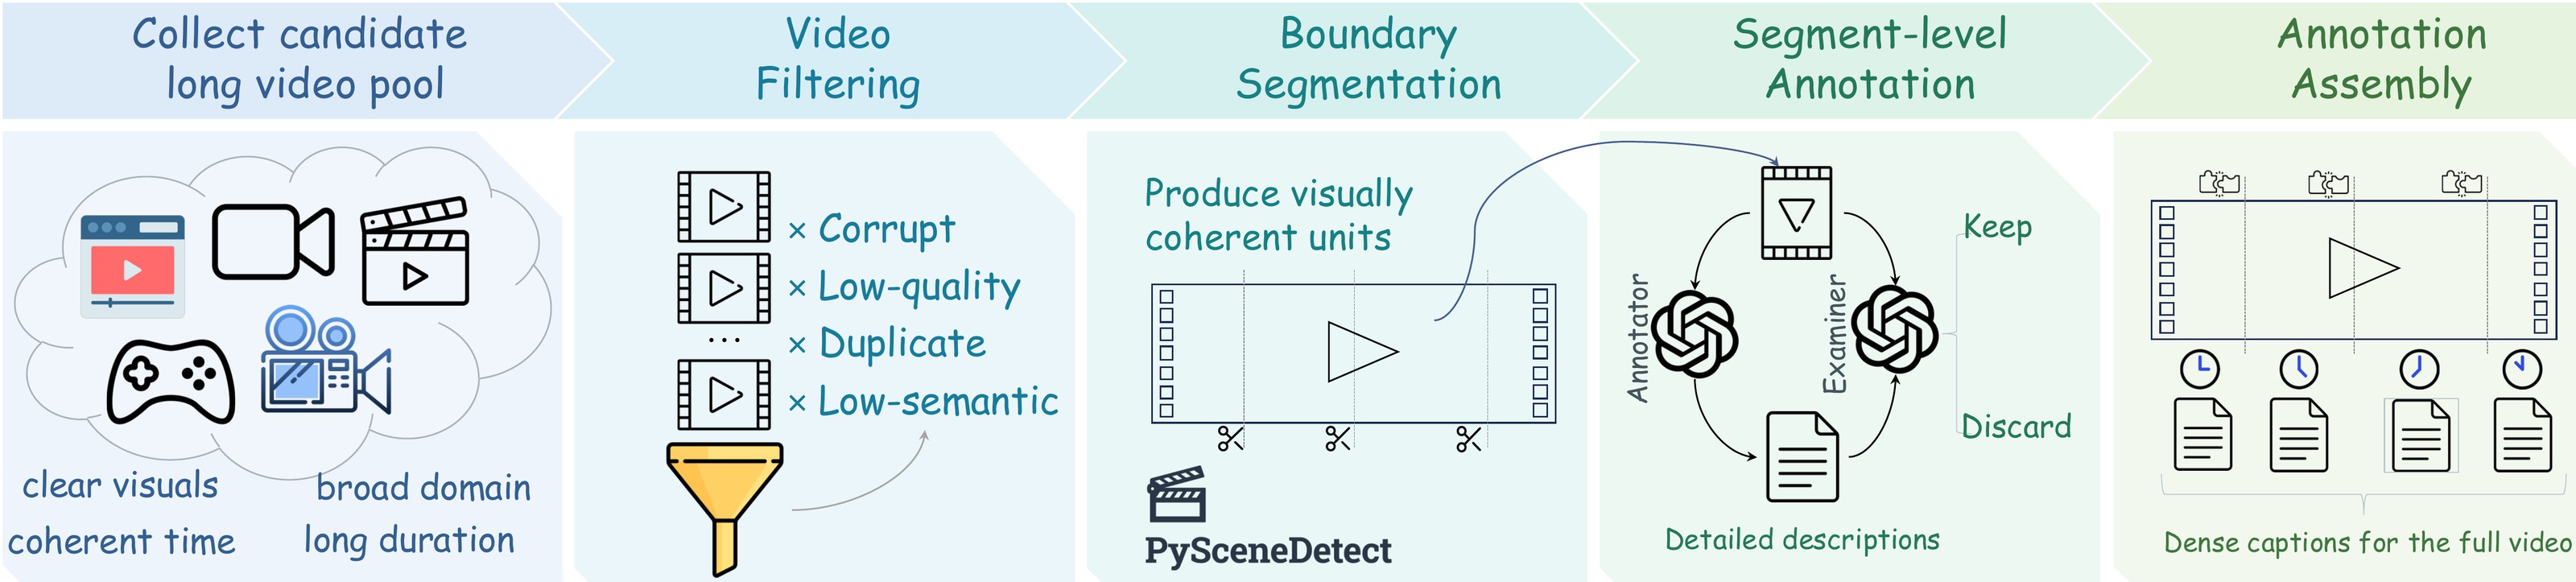
图7把长视频拆成时间连贯的单元,先标注与过滤局部事件,再组合为全局时间线、定位和问答。事件记录提供了一个中间证据层:全局答案可以回到局部片段核查,而不是只靠一份流畅的整体摘要。
对长视频 Agent,这种数据结构比单纯拉长上下文更有复用价值。上下文容量解决装得下多少,事件记录解决如何检索与核对。两者结合,才能减少"视频看得很长,答案仍只抓住开头和结尾"的问题。
5. OL617K:把问答数据变成响应时机数据
离线 QA 只要求答案正确,通常不会惩罚模型过早回答。实时系统则必须在证据尚未出现时等待,在证据足够后及时响应。VideoChat3-OL617K 把高质量问答转化为流式监督。
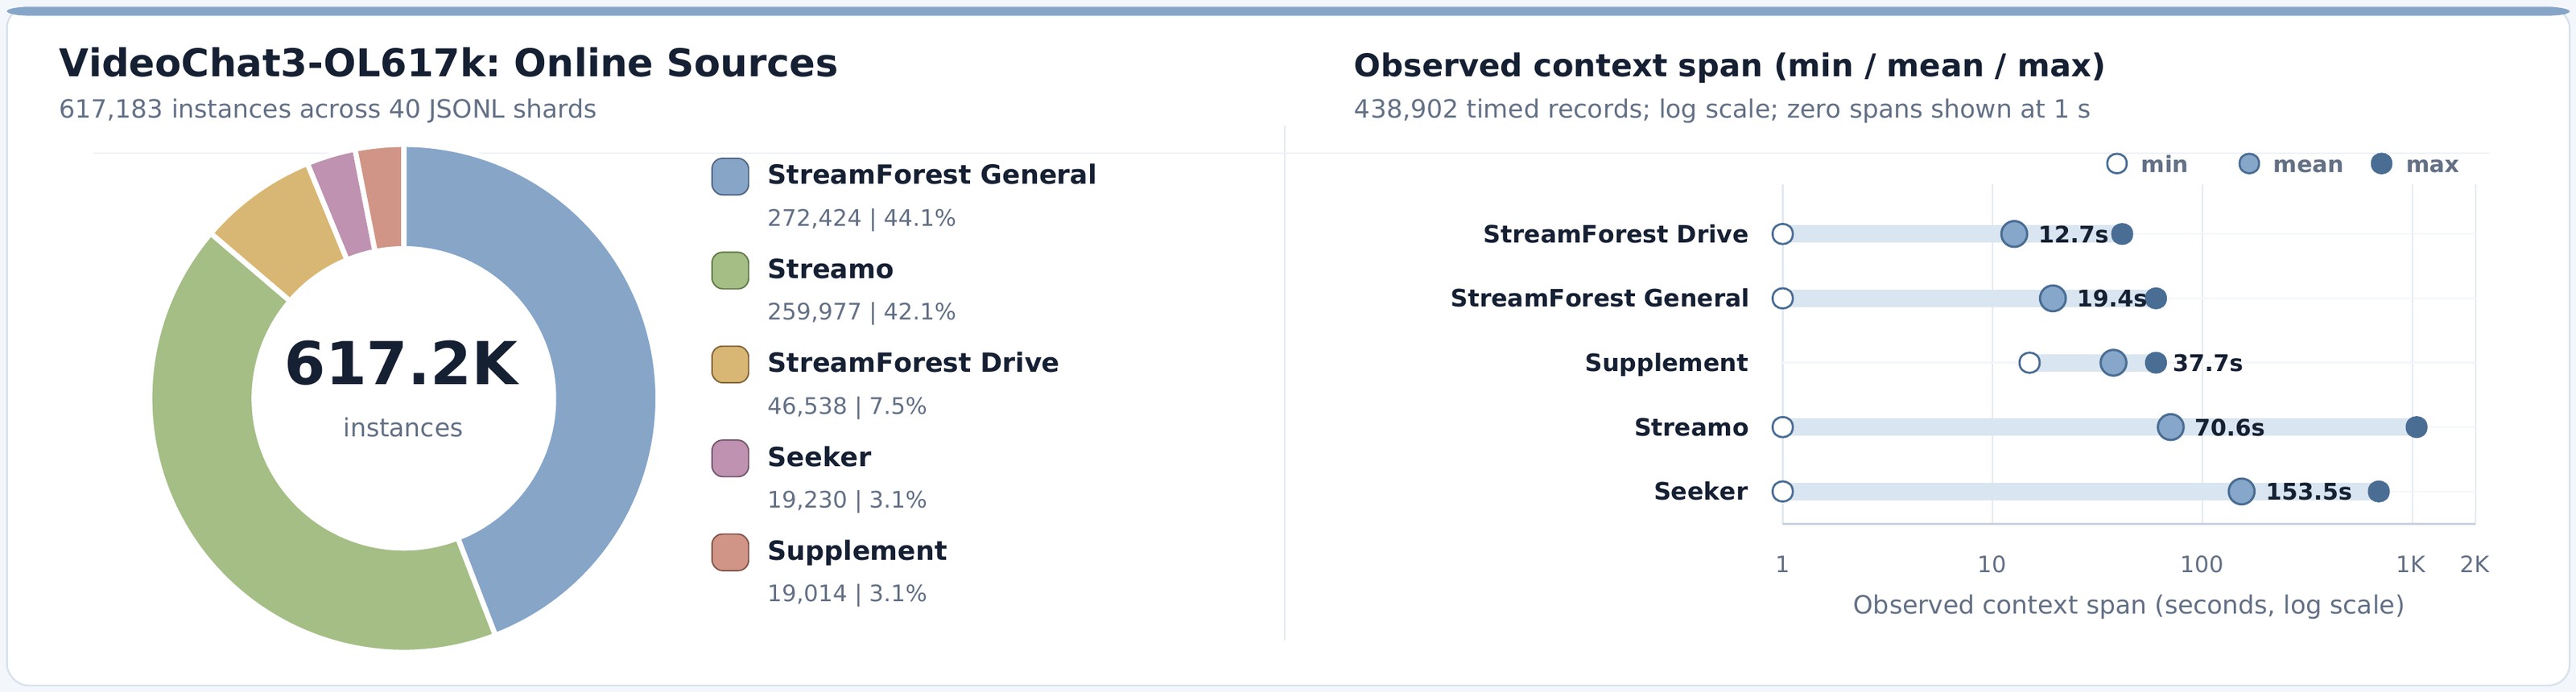
该集合有 617,183 条实例,其中 StreamForest General 约占 44.1%,Streamo 约占 42.1%。图中的时机统计只覆盖有可用时间信息的 438,902 条实例,不能把子集分布直接解释为全部语料的统计。
构造流程先根据问题定位关键线索的时间区间,再只观看裁剪片段验证它是否足以支持答案。线索积累阶段标为 Standby,证据区间结束后触发 Response,其余时刻为 Silence。这样,回答内容与允许开始回答的时刻形成联合监督。
这一转换仍有误差来源。线索区间标注过晚会培养拖延,过早会培养抢答;裁剪验证忽略了前文依赖时,也可能高估局部证据的充分性。人工审核应重点看临界帧,而不只是看最终文本是否合理。
6. VideoChat3 的训练课程与状态损失
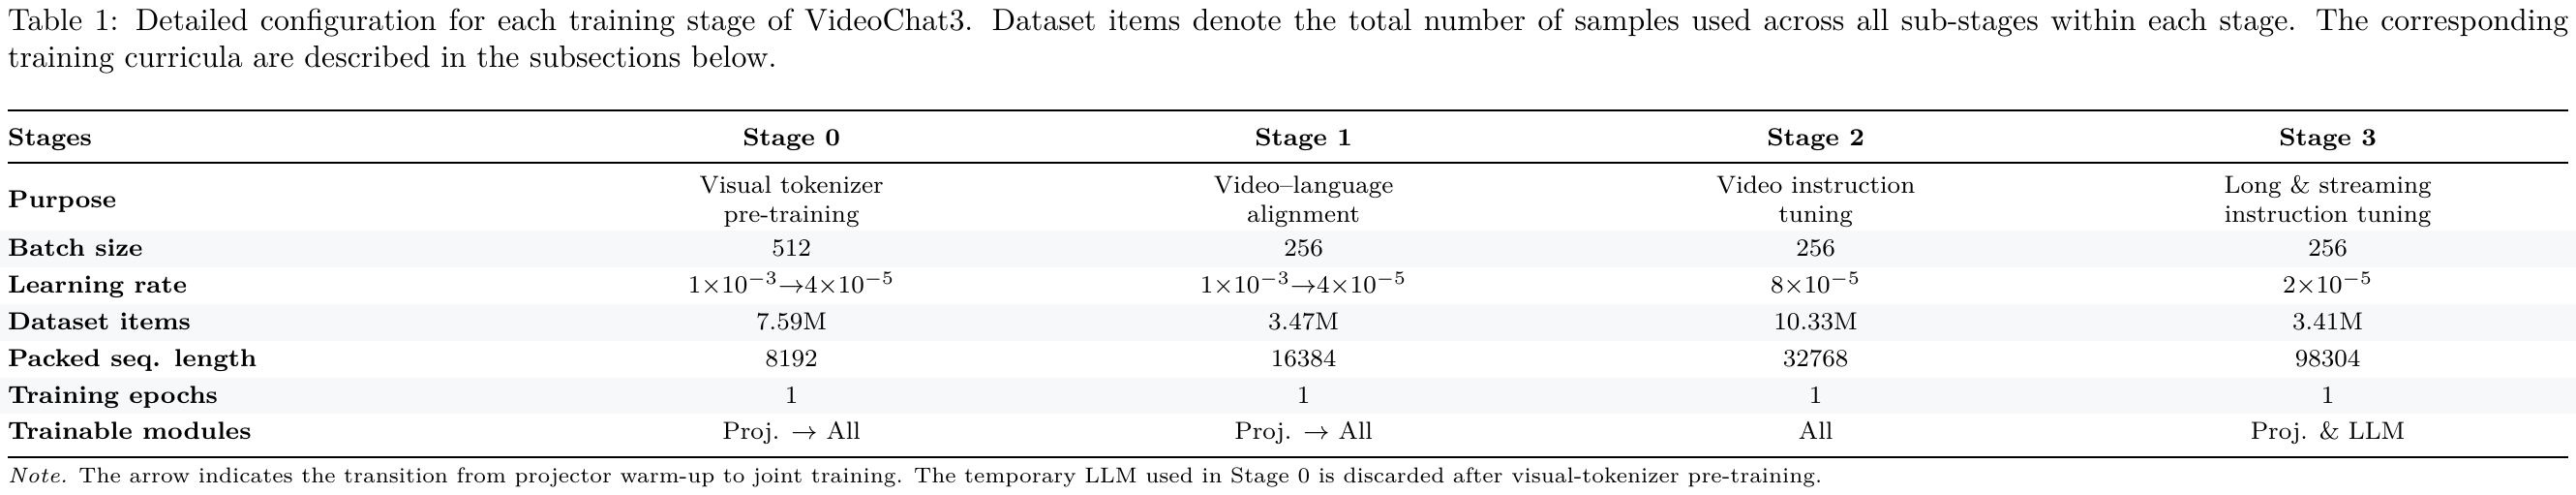
Stage 0 用约 7.59M 样本训练视觉 tokenizer,临时接入 Qwen3-4B 解码器;这一临时解码器在该阶段后被丢弃,保留的是训练后的视觉编码器。Stage 1 再进行视频语言对齐,约 3.47M 样本;Stage 2 使用约 10.33M 样本、23.62M QA,处理约 50B token,形成通用视频指令能力。
Stage 3 面向长视频和流式交互,约 3.41M 有效样本、10.39M QA,处理约 10B token,冻结视觉编码器、训练投影和语言模型。打包序列上限从各阶段的 8,192、16,384、32,768 增加到 98,304。将长视频与离线任务混合,有助于避免模型只学会等待与触发,却损失普通视频问答能力。
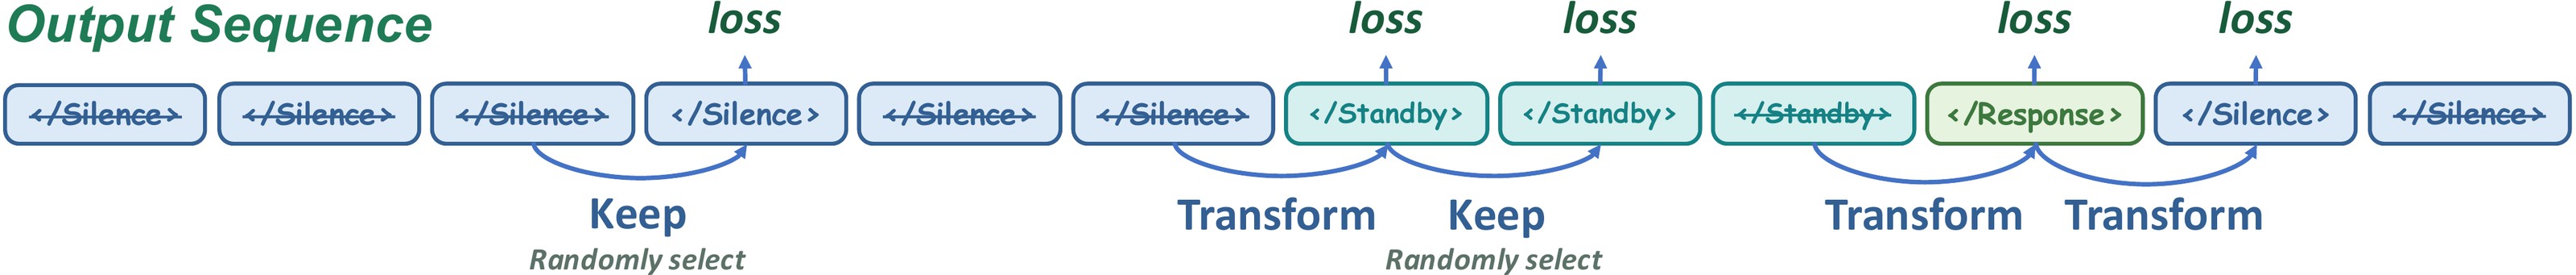
如果所有状态位置都计算损失,连续 Silence 会占据大多数训练信号;如果只监督状态变化,模型又可能按固定状态顺序猜下一步,缺少维持当前状态的训练。VideoChat3 保留全部切换位置,并从保持位置中抽取同样数量的样本。
定义切换集合 T = { t ∣ s t ≠ s t − 1 } \mathcal T=\{t\mid s_t\ne s_{t-1}\} T={t∣st=st−1}、保持集合 C = { t ∣ s t = s t − 1 } \mathcal C=\{t\mid s_t=s_{t-1}\} C={t∣st=st−1},从后者均匀抽样得到 C ~ \widetilde{\mathcal C} C ,使 ∣ C ~ ∣ = ∣ T ∣ |\widetilde{\mathcal C}|=|\mathcal T| ∣C ∣=∣T∣。对应状态损失为:
L s t a t e = − 1 ∑ t m t ∑ t m t log p θ ( s t ∣ V ≤ t , y < t ) , m t = 1 t ∈ T ∪ C \~ . \mathcal L_{\mathrm{state}}=-\frac{1}{\sum_t m_t}\sum_t m_t\log p_\theta(s_t\mid V_{\le t},y_{<t}), \qquad m_t=\mathbb1t\\in\\mathcal T\\cup\\widetilde{\\mathcal C}. Lstate=−∑tmt1t∑mtlogpθ(st∣V≤t,y<t),mt=1t∈T∪C .
论文给出的典型流式周期中,有效状态监督的期望比例为:
S i l e n c e : S t a n d b y : R e s p o n s e = 2 : 2 : 1. \mathrm{Silence}:\mathrm{Standby}:\mathrm{Response}=2:2:1. Silence:Standby:Response=2:2:1.
这个比例描述典型周期的监督结构,不是声称完整数据天然符合固定类别分布。回答文字仍使用普通下一 token 损失。训练中的预算控制来自上一目标状态,推理时来自模型预测状态,因此部署中的状态错误还会继续影响下一窗口可获得的视觉证据,形成反馈误差。
7. VideoChat3 实验:更强时序理解与明确的能力缺口
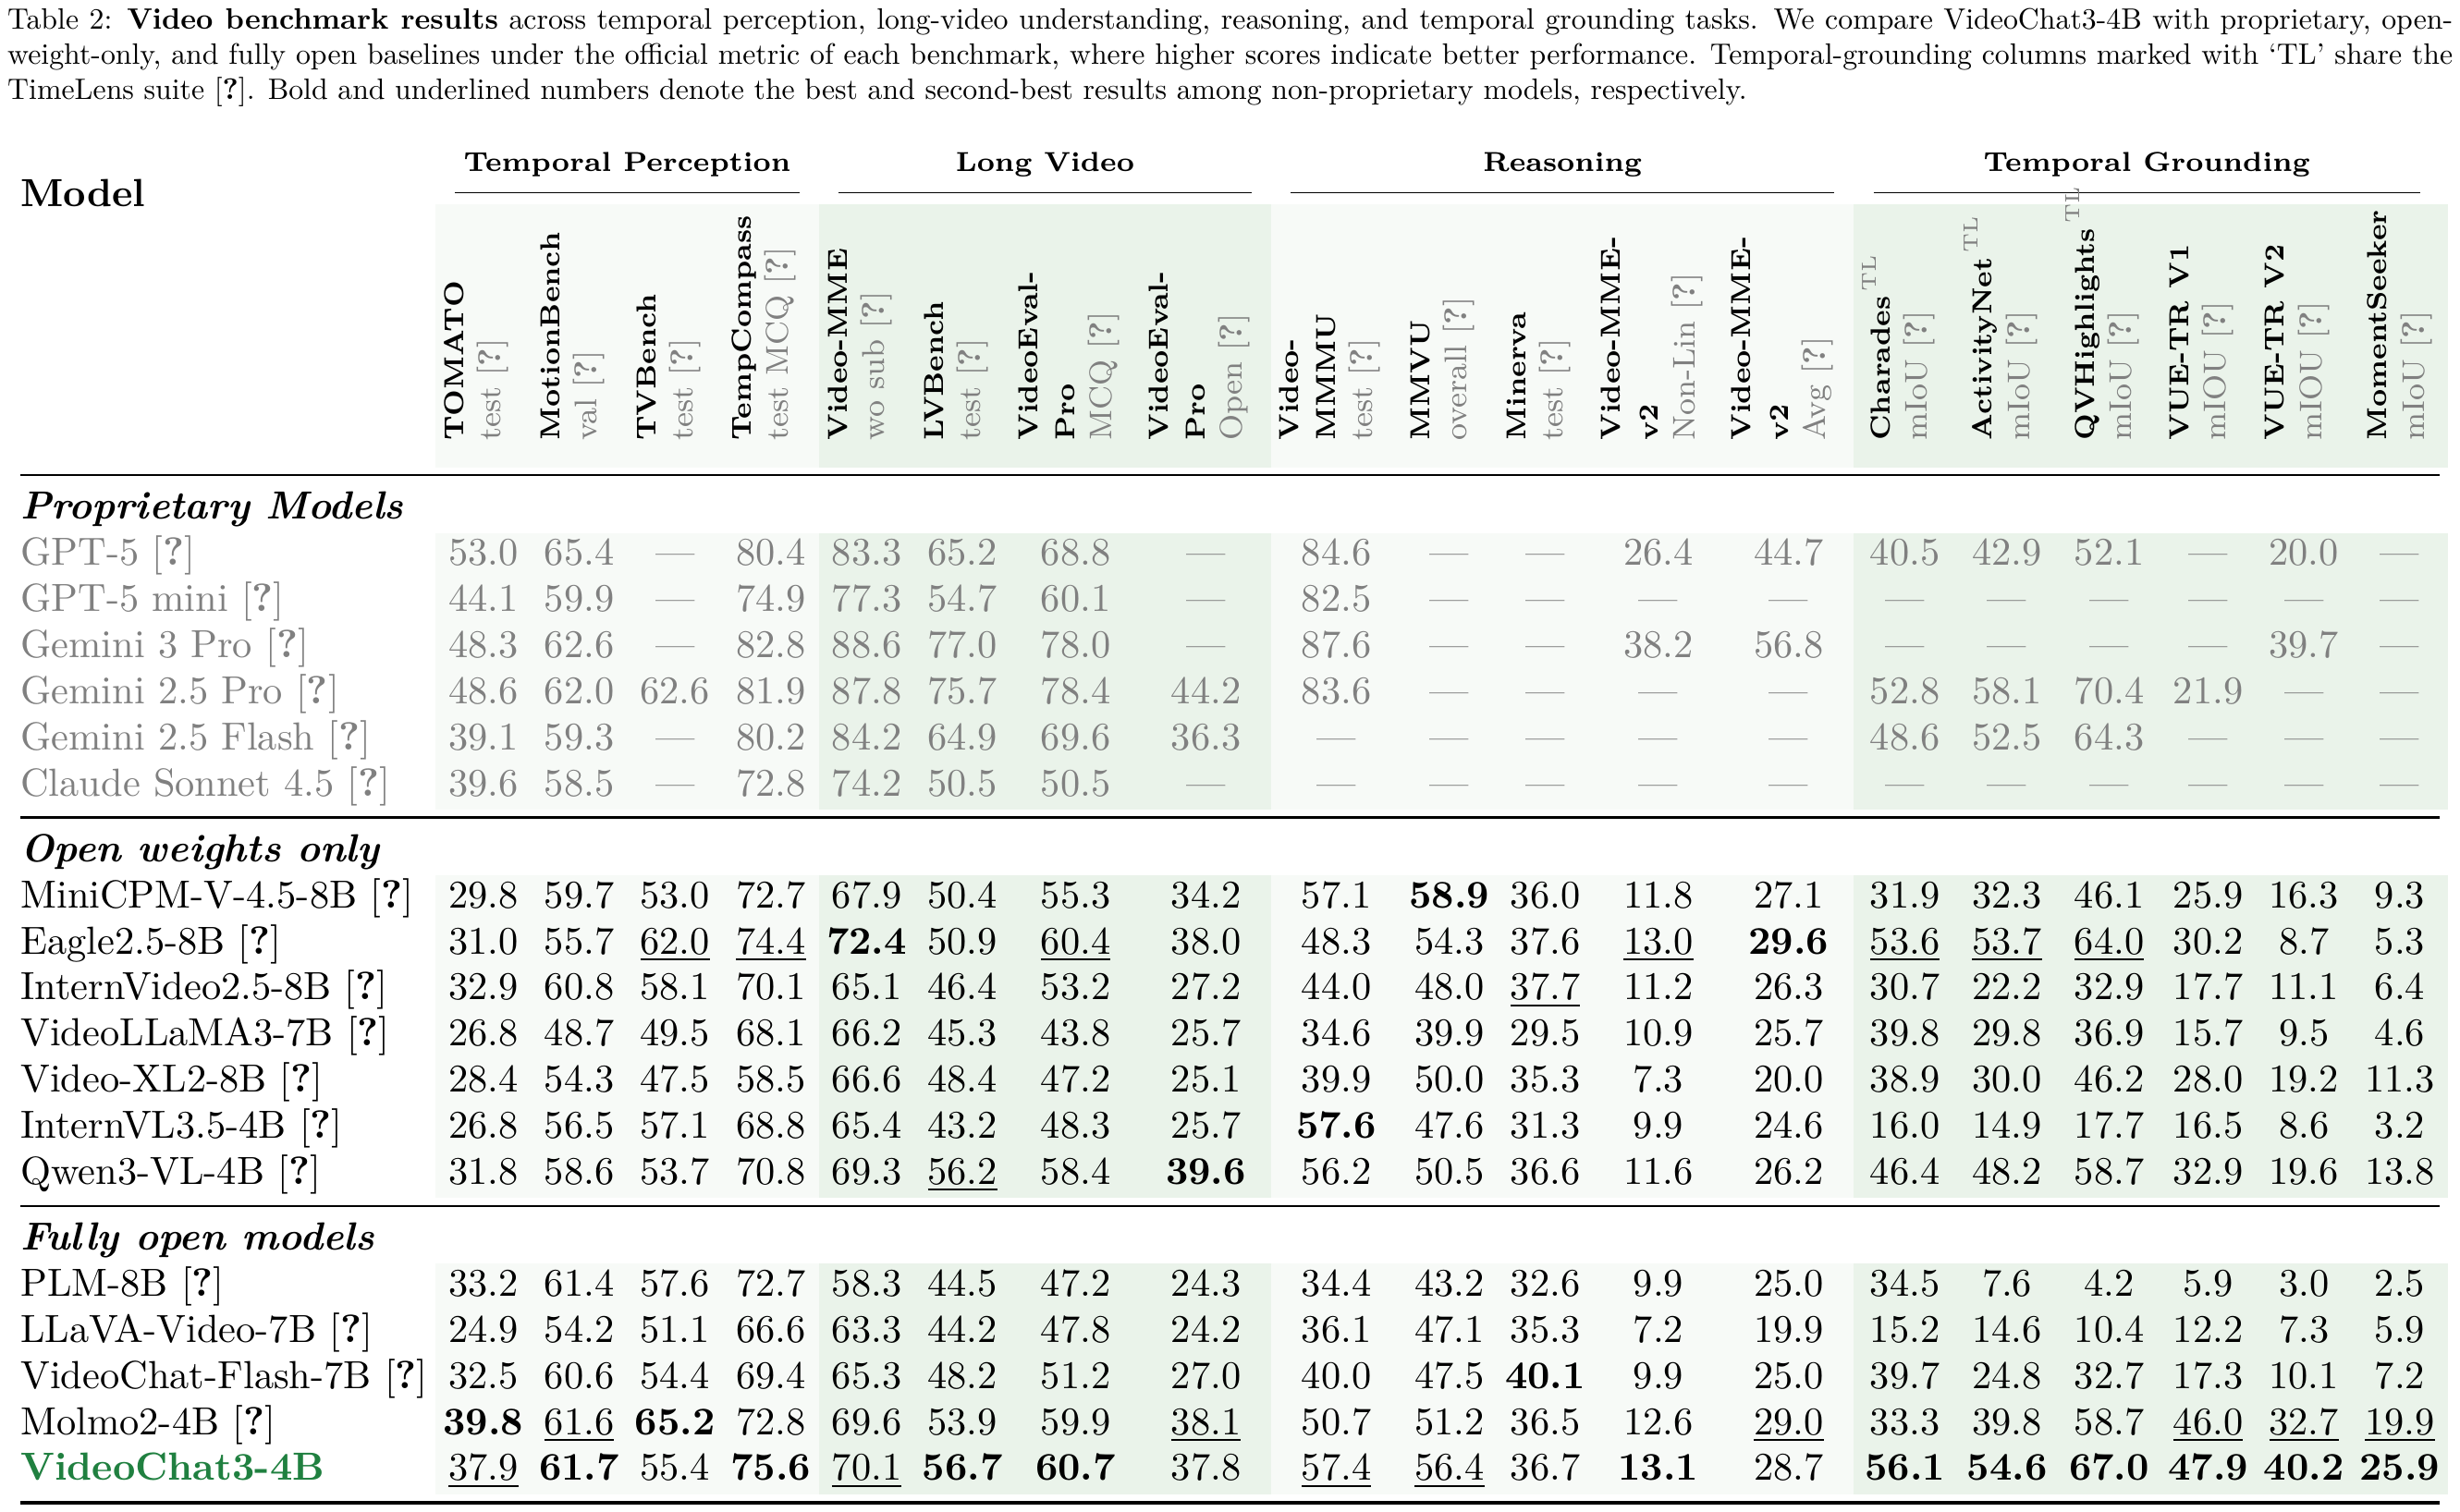
在与 Qwen3-VL-4B 可直接比较的 19 项指标中,VideoChat3 提升了 18 项,MotionBench 为 61.7、TempCompass 为 75.6。不过,与其他模型比较并非处处领先:例如 TOMATO 上 Molmo2 为 39.8、VideoChat3 为 37.9。保留这些非领先项,才能看清它的能力结构。
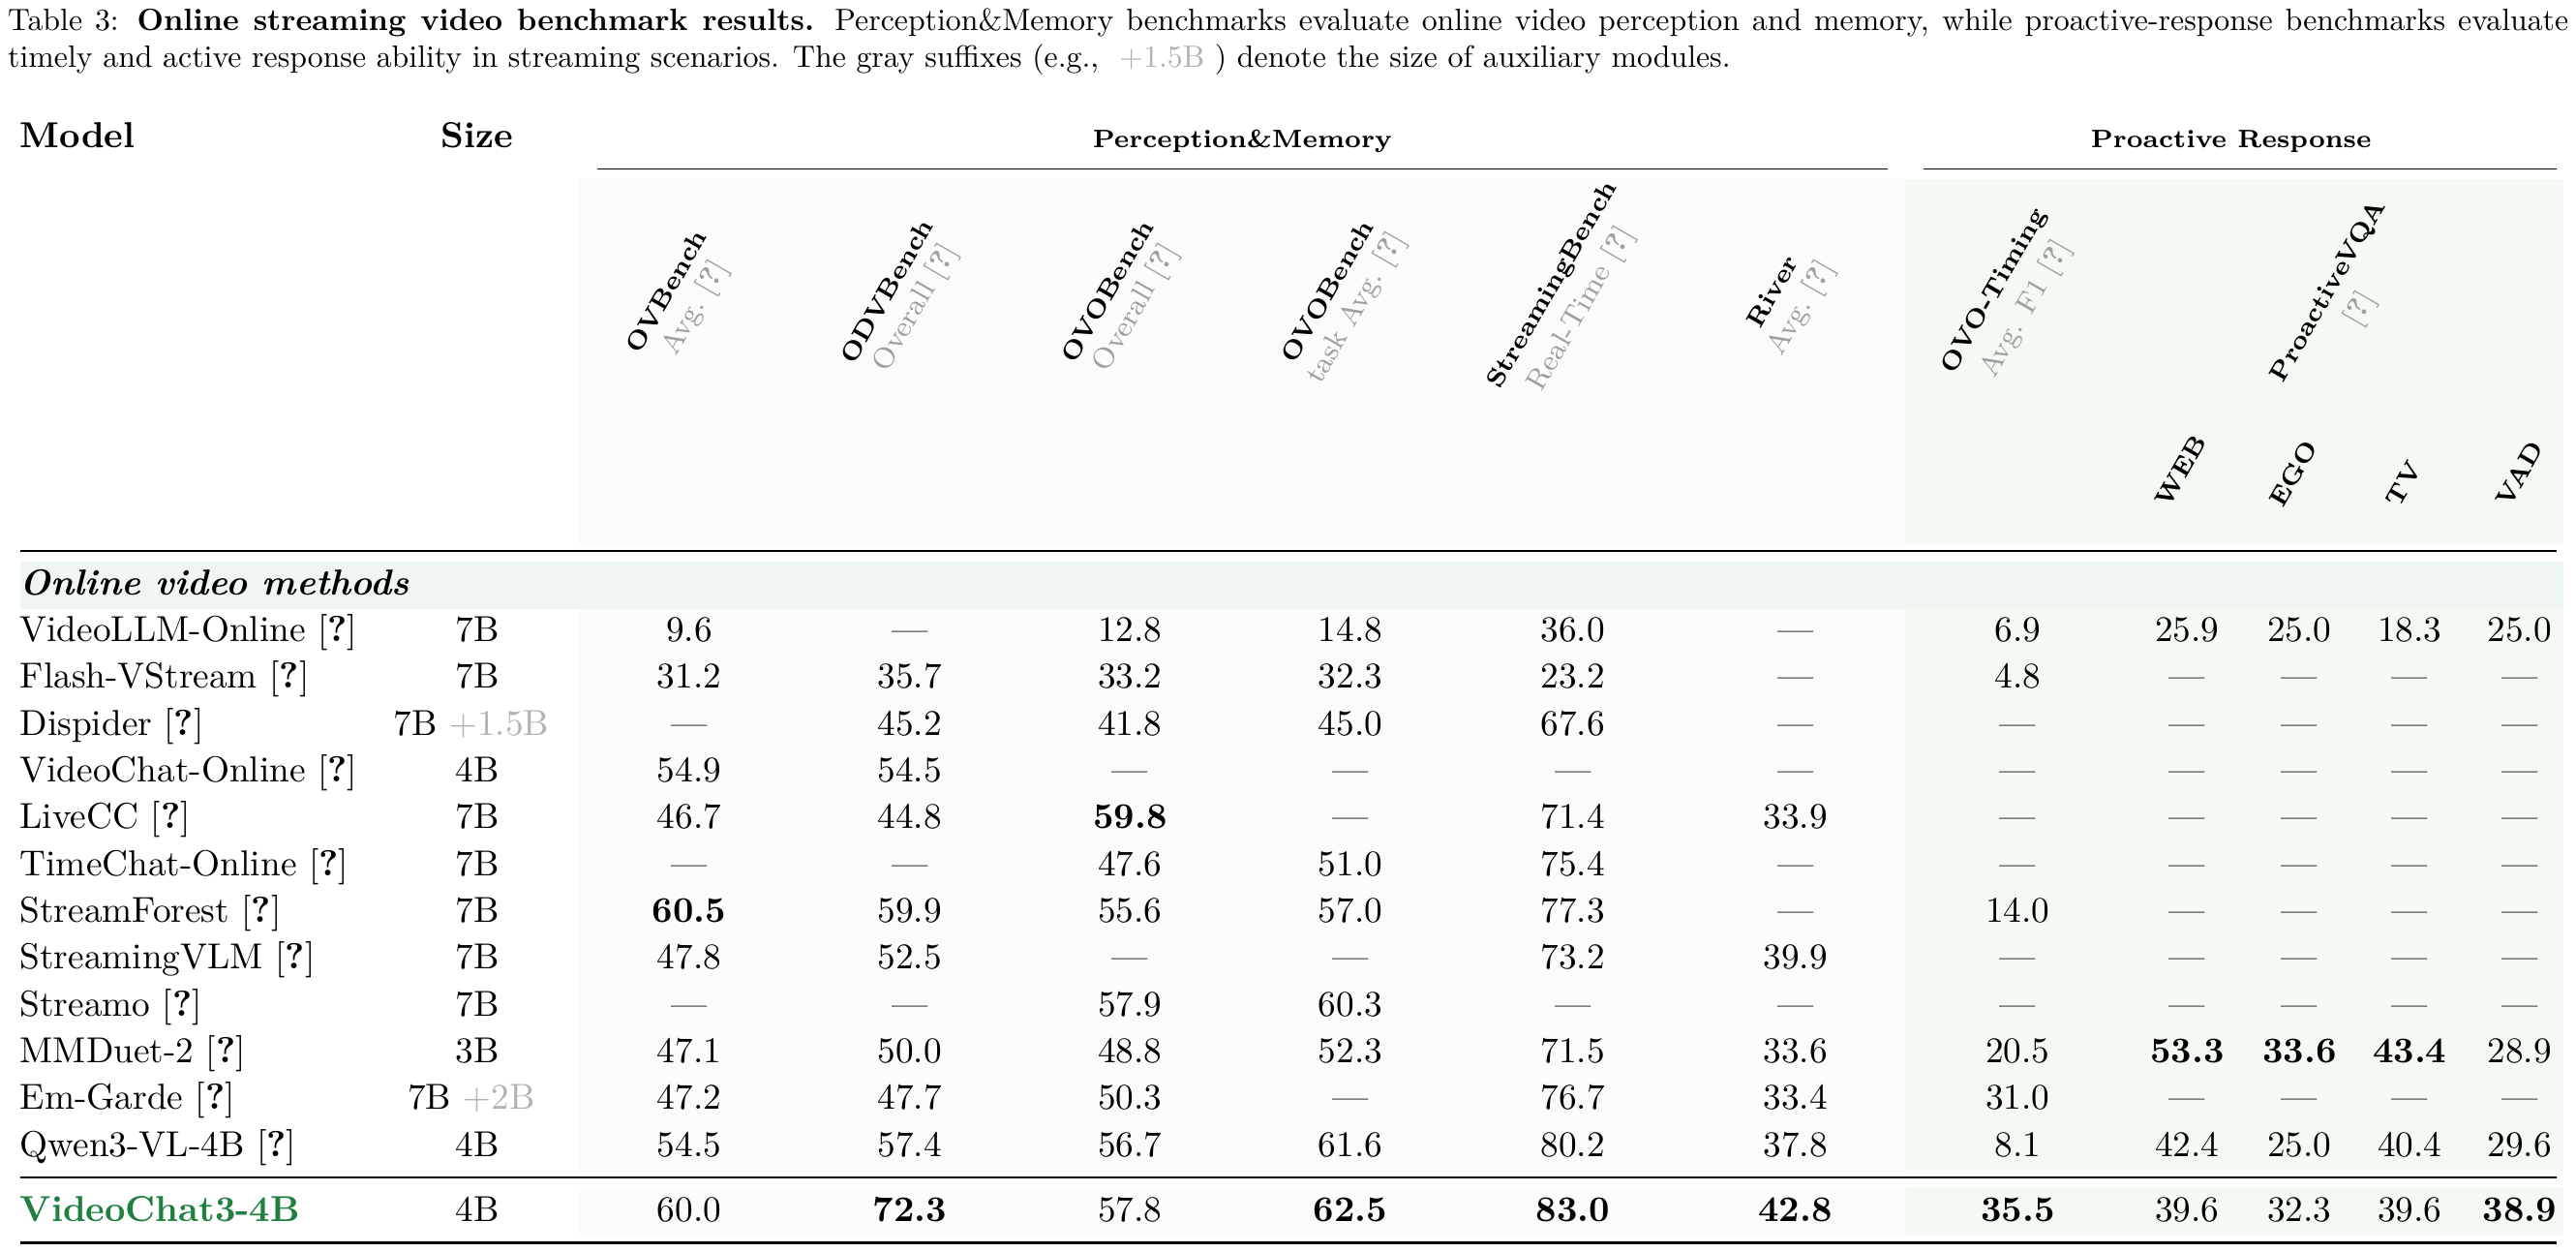
在线评测需要区分"收到问题后从历史作答"和"自主判断何时开口"。VideoChat3 在 ODV-Bench 得到 72.3,在 OVO-Timing 得到 35.5 的平均 F1;后者直接涉及响应时机。ProactiveVQA 的不同子集表现不一致,与专门模型比较也仍有弱项。
这些基准给出了有价值的进展,却没有同时覆盖长期运行、用户打断、错误恢复和多会话争用。4B 参数量降低了潜在部署门槛,能否稳定服务仍取决于真实视频长度、采样、输入分辨率、输出策略与硬件。
8. 效率证据:把计算移到哪一段,比压缩倍数更重要
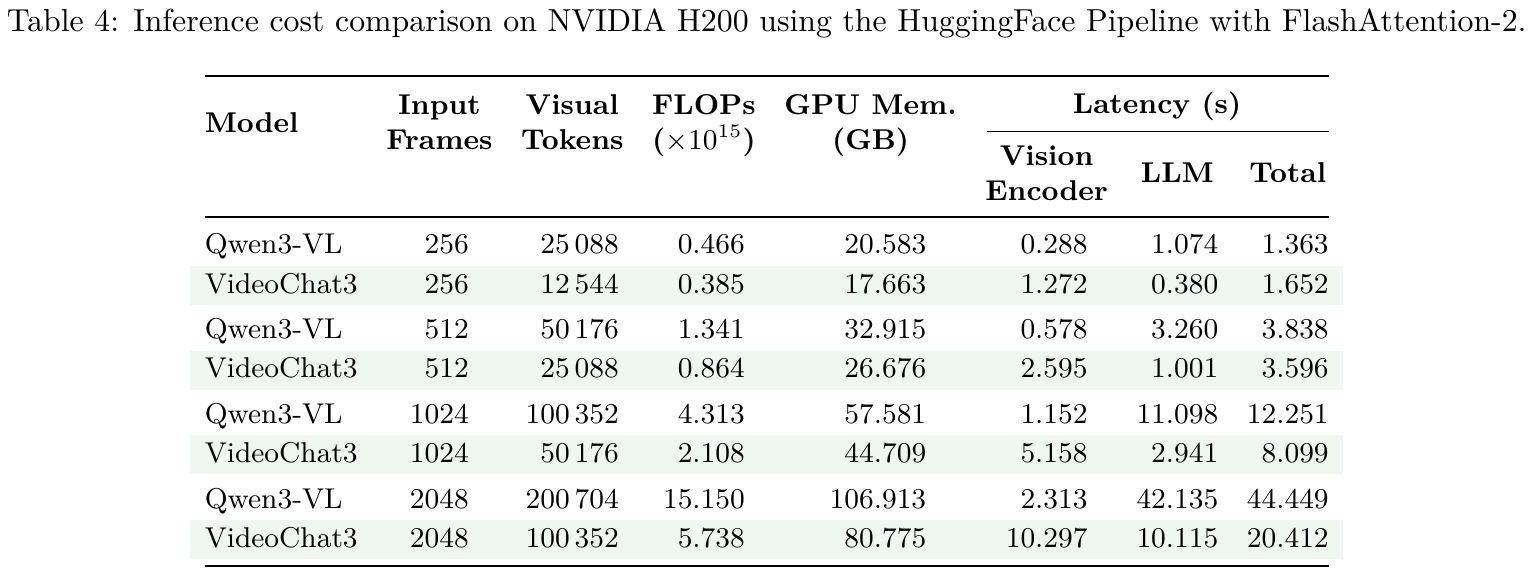
表4在 NVIDIA H200、HuggingFace Pipeline 与 FlashAttention-2 下比较推理开销,匹配每帧 ViT patch 数。VideoChat3 视觉编码更慢,但送入语言模型的视觉 token 为 Qwen3-VL 的一半。512 帧时,FLOPs 从 1.341 × 10 15 1.341\times10^{15} 1.341×10¹⁵ 降到 0.864 × 10 15 0.864\times10^{15} 0.864×10¹⁵,显存从 32.92GB 降到 26.68GB。
1,024 帧时,总延迟从 12.251 秒降到 8.099 秒;2,048 帧时,从 44.449 秒降到 20.412 秒。收益随视频变长扩大,支持"早期局部时空建模换取语言侧长度下降"的解释。
论文用语言注意力随序列长度的二次增长解释趋势,但实际端到端服务还包括投影、MLP、显存访问、缓存与生成。不要把注意力某一项的理论阶数直接当成完整系统的精确成本公式,也不要把离线整段视频延迟当成每个流式窗口的响应延迟。
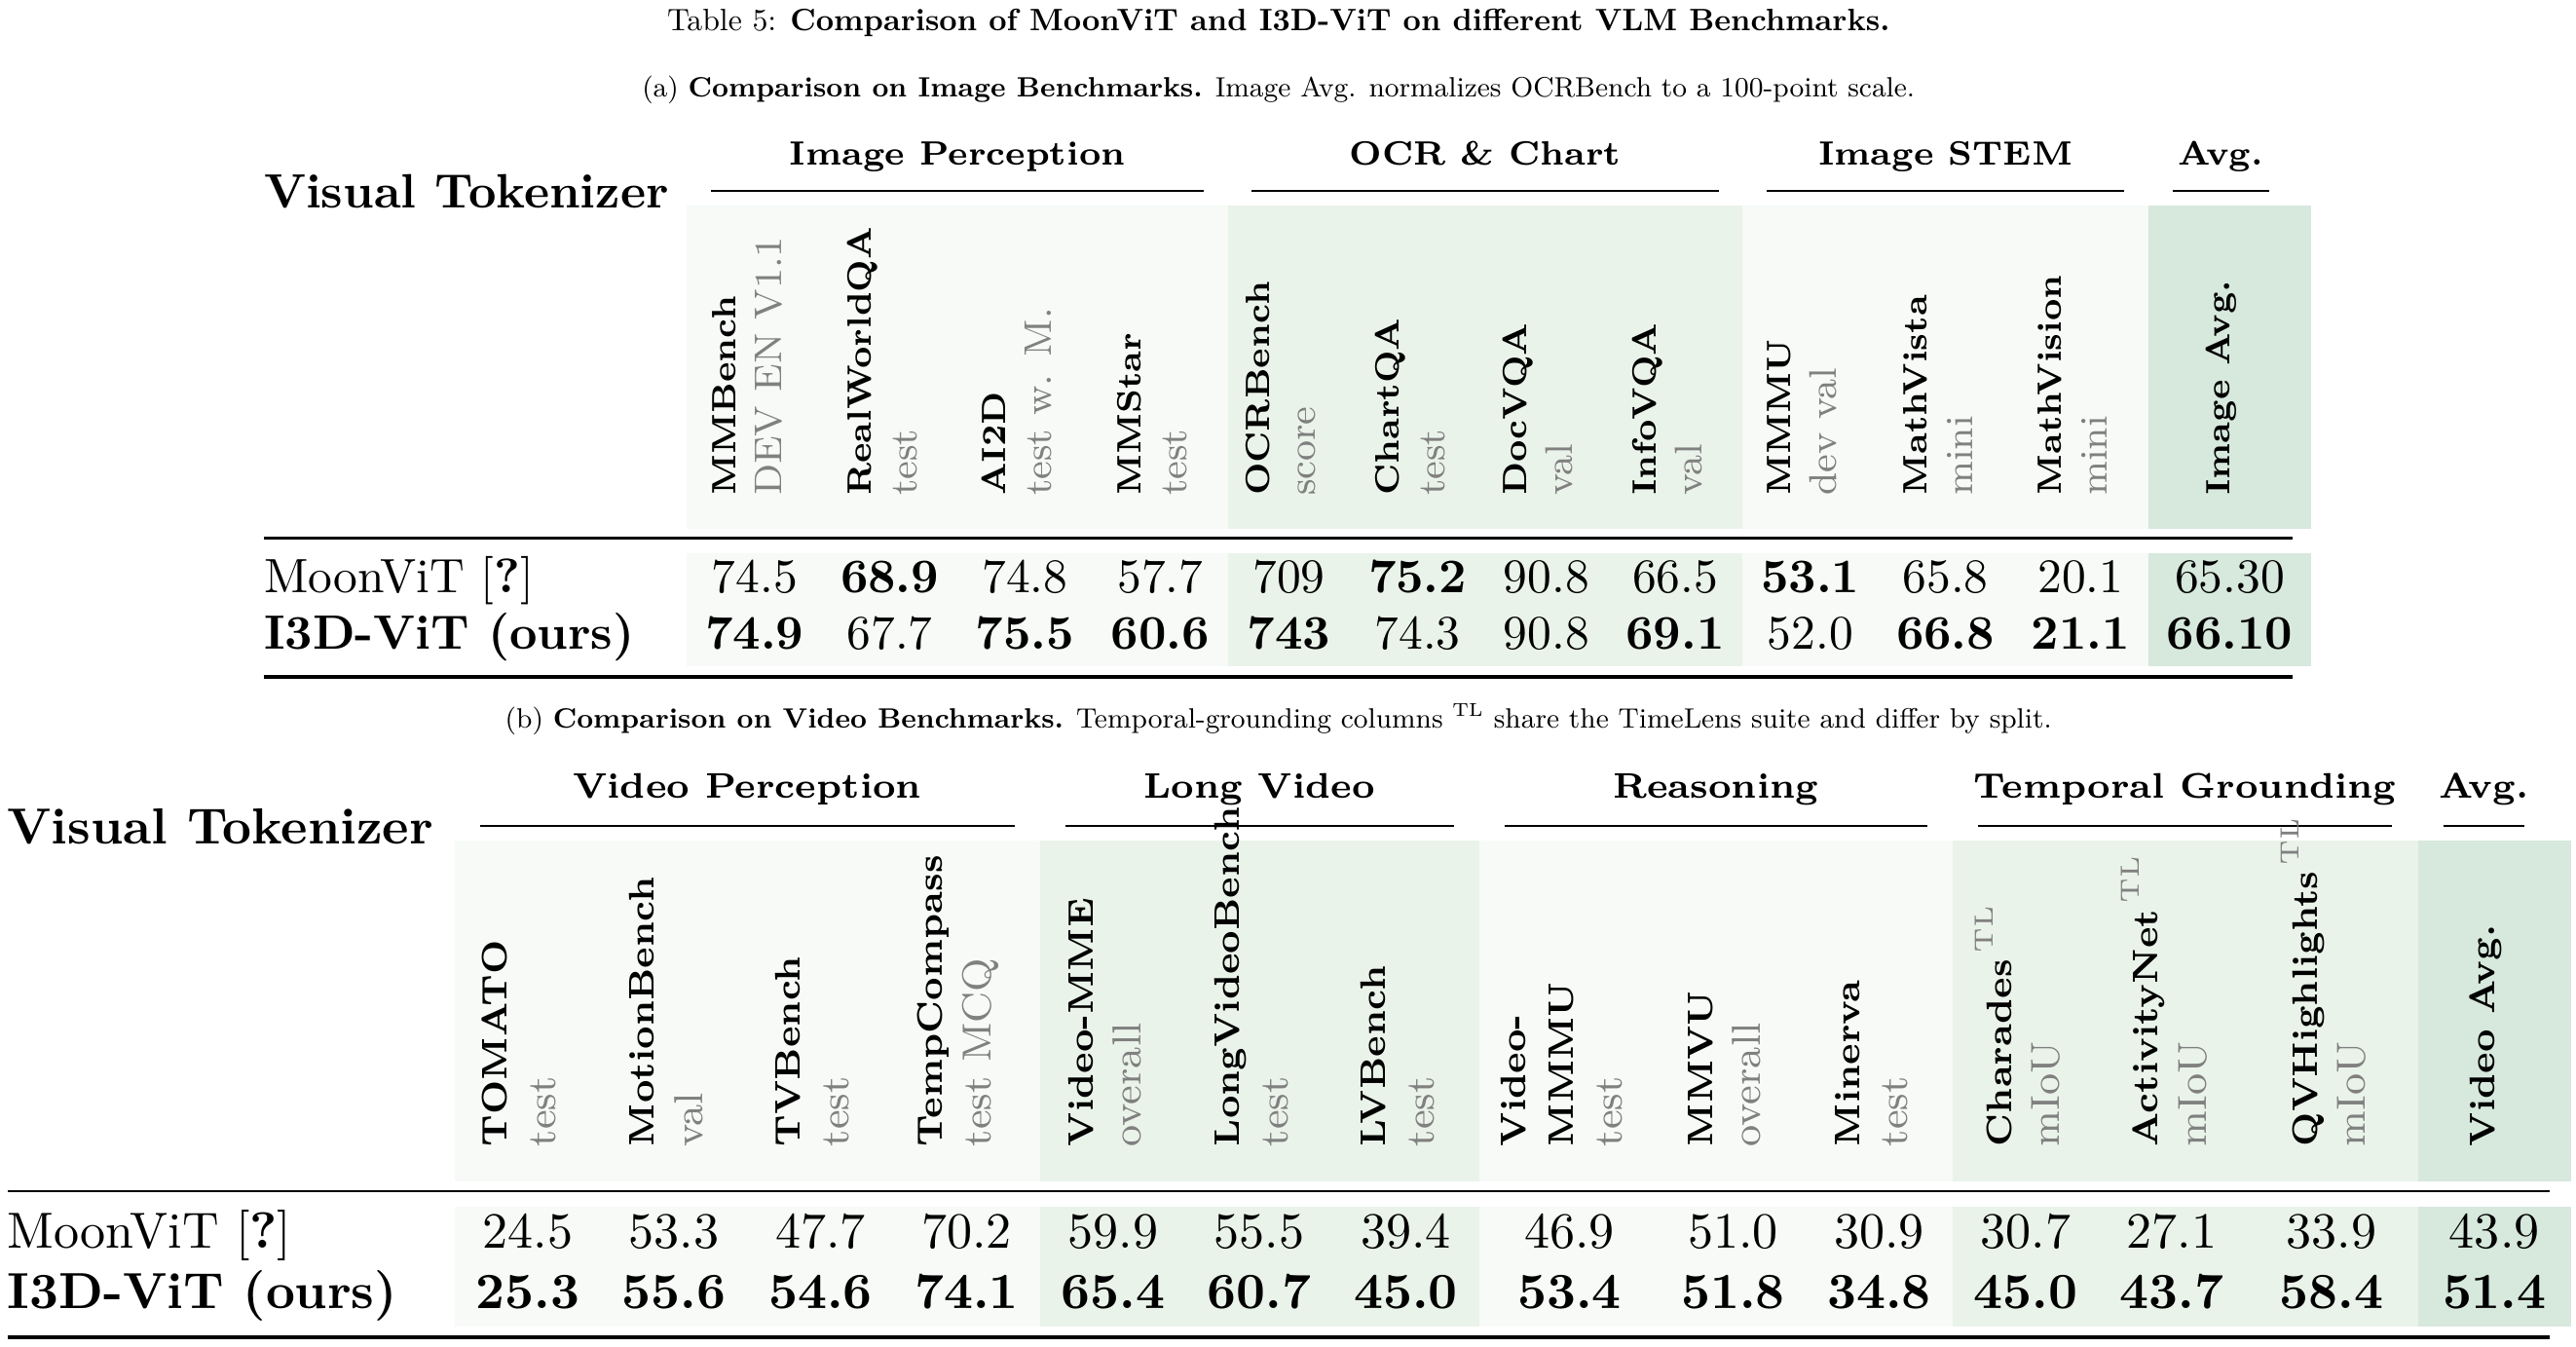
表5比较图像与视频能力。图像能力大致保持,视频能力明显改善;作者将收益归因于时间压缩支持更密集采帧。这个实验展示的是"视觉结构与可用帧数共同变化"的结果,若要孤立时空注意力本身的因果贡献,还需要固定帧数、分辨率与 token 预算进一步比较。
9. 主动感知消融:更多像素不一定带来更准时的回答
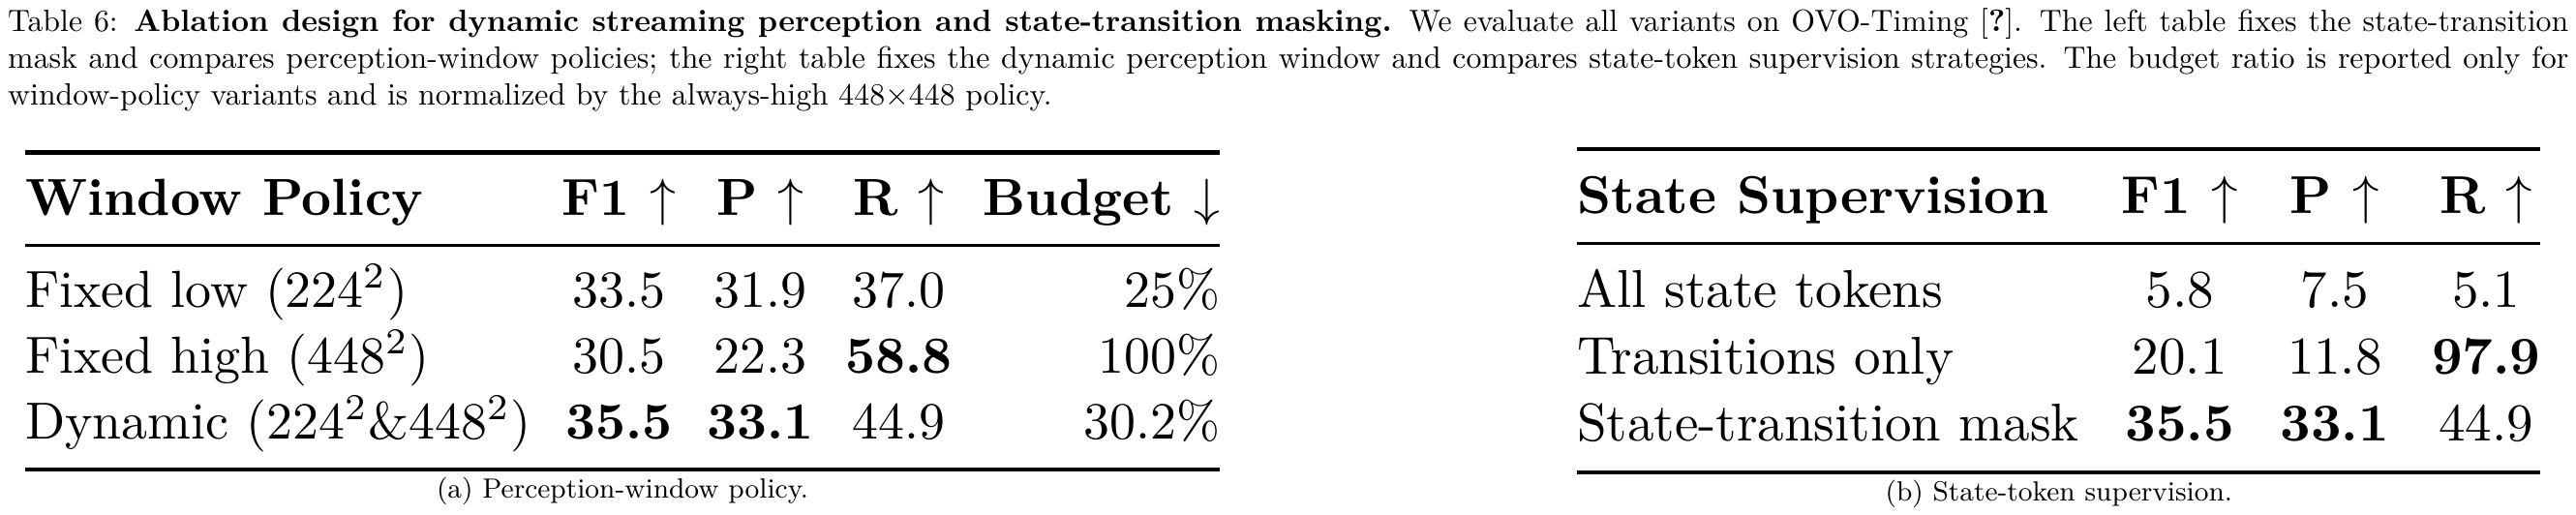
固定低预算时,OVO-Timing 平均 F1 为 33.5,预算比例为 25%;固定高预算 F1 为 30.5,预算为 100%;动态方案达到 35.5,预算约为 30.2%。高预算提高了召回,却降低了精确率,因此整体 F1 没有同步提高。
这一结果说明,视觉清晰度与触发策略不能分开优化。30.2% 是论文定义下、相对始终高分辨率方案的窗口预算比例,不能直接说总 GPU 成本节省了 69.8%。语言解码、固定开销和状态分布仍然影响最终成本。
状态监督消融更能体现数据分布的影响。全部状态计算损失,F1 只有 5.8;只保留切换,F1 为 20.1,召回高达 97.9%,但过度触发;平衡切换与保持后达到 35.5。评测必须同时报告误触发与漏触发,否则一个一直说话的系统可能在某些覆盖指标上显得很好。
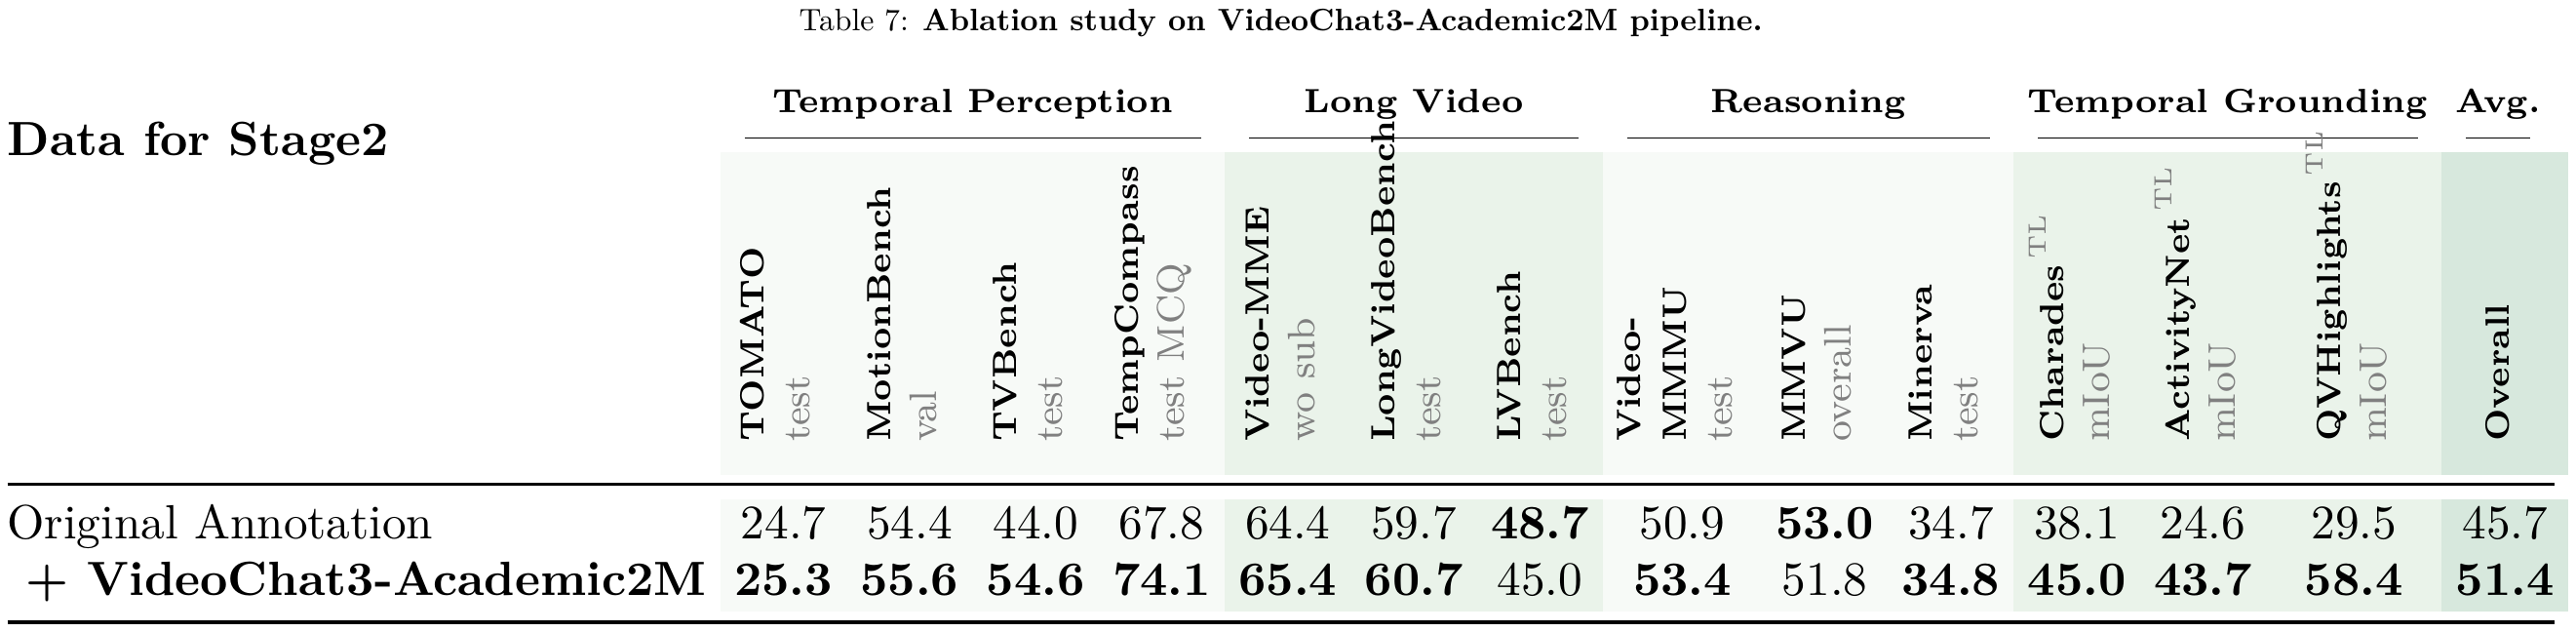
证据增强在多数视频任务上改善结果,尤其涉及时间感知与定位。它支持密集、可落在画面上的监督具有价值;收益并不自动说明教师生成的推理文字都忠实反映学生内部计算。
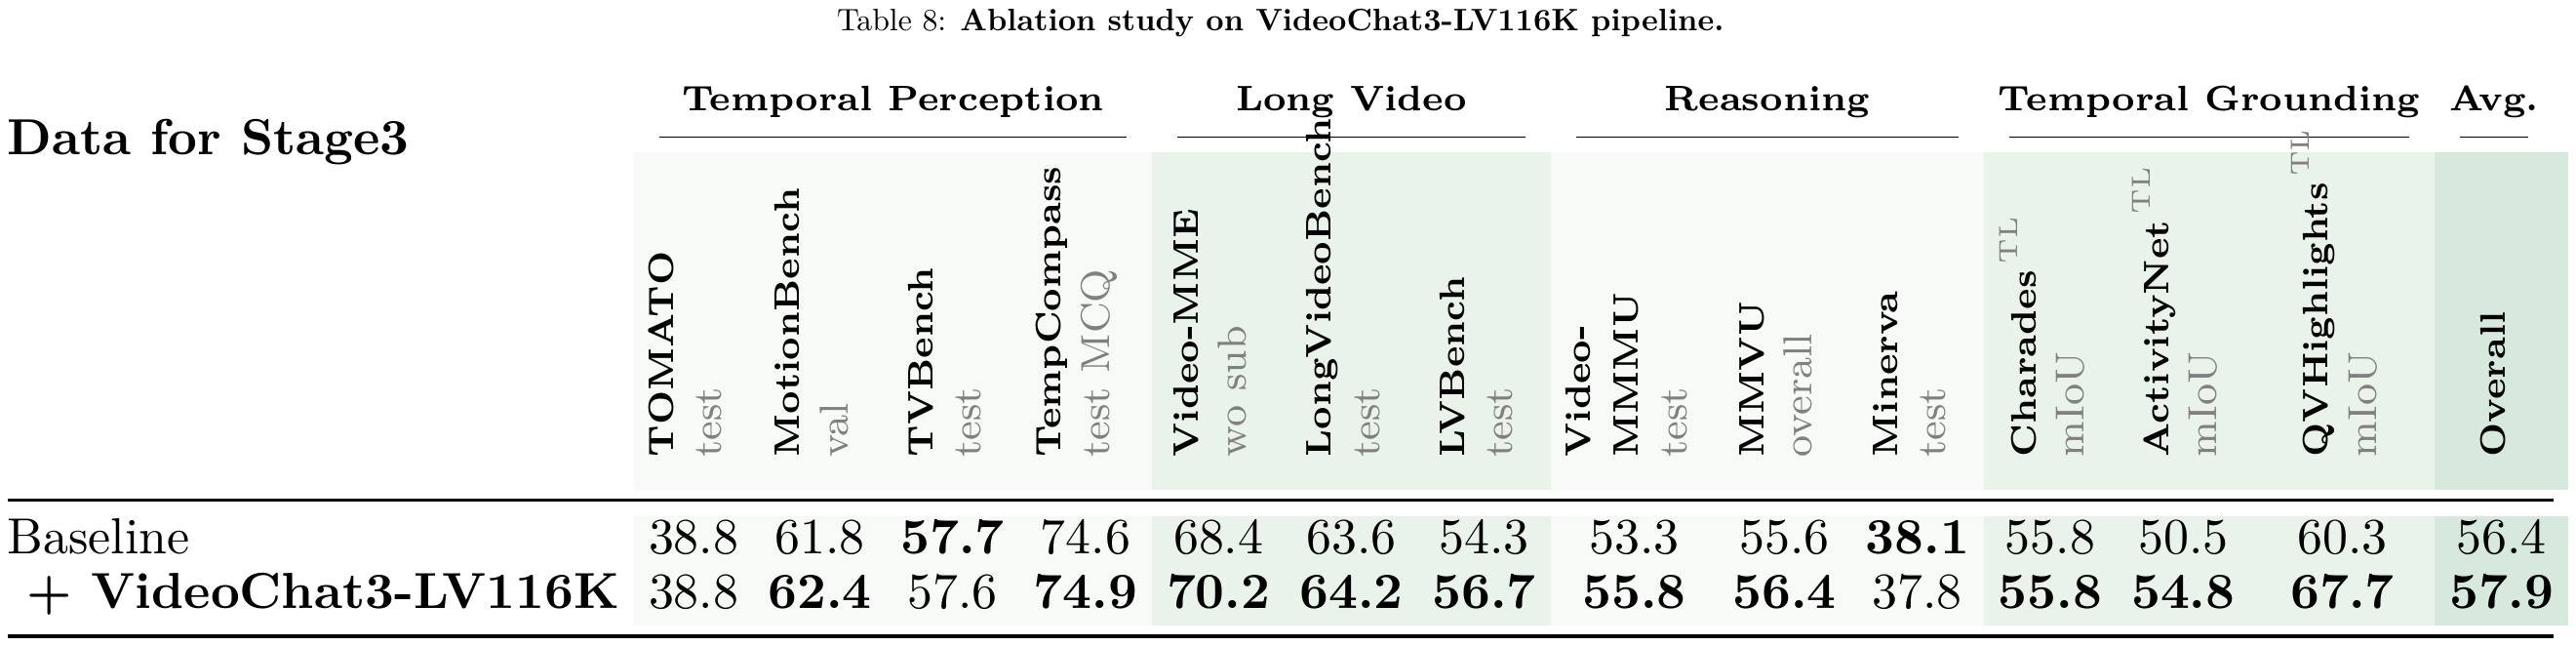
长视频集合改善 Video-MME、LongVideoBench、LVBench 和部分时间定位任务,说明数据课程与更长上下文有协同作用。单独增加 context 参数,没有对应长时依赖训练,不足以得到同样收益。
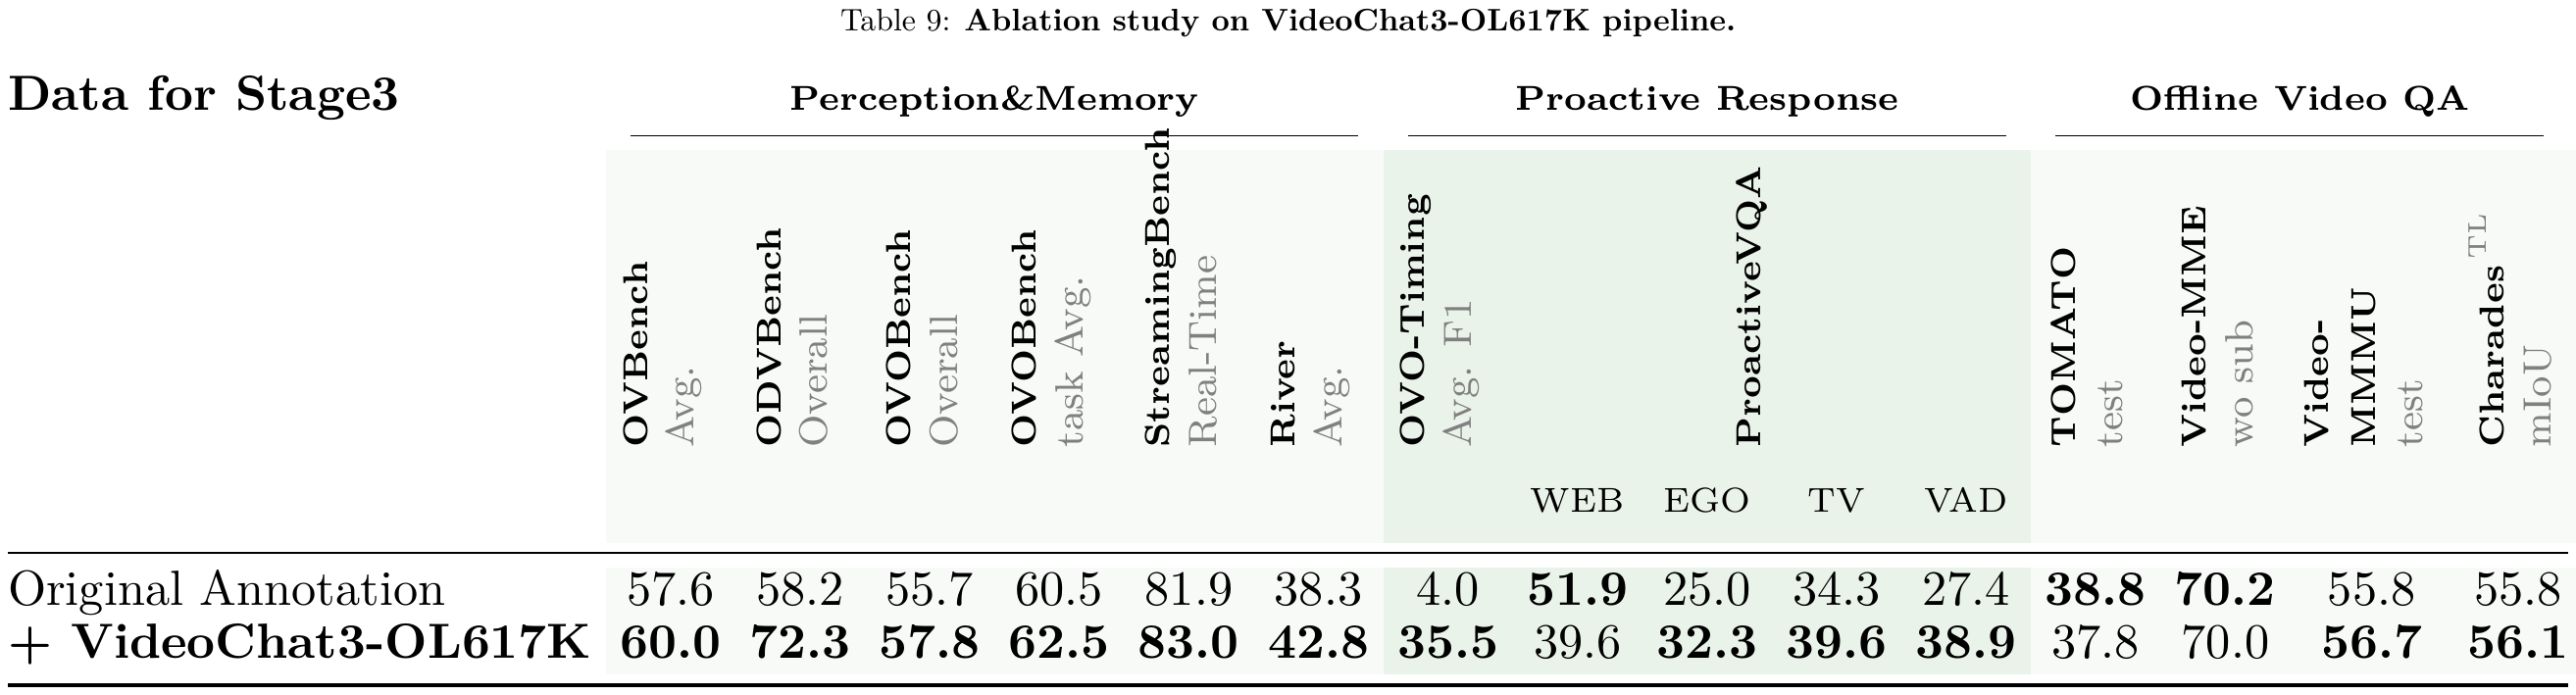
OL617K 将 OVO-Timing F1 从 4.0 提升至 35.5,但 ProactiveVQA WEB 从 51.9 降至 39.6;EGO、TV、VAD 则改善。论文指出 PAUC 没有显式充分惩罚回复频率和精确重复。因此,WEB 下降不能被简单抹去,也不能仅凭一项指标判断交互体验全面变差:需要结合触发次数、重复率和用户任务完成率解释。
10. 附录样例:逐项核对模型到底学到了什么
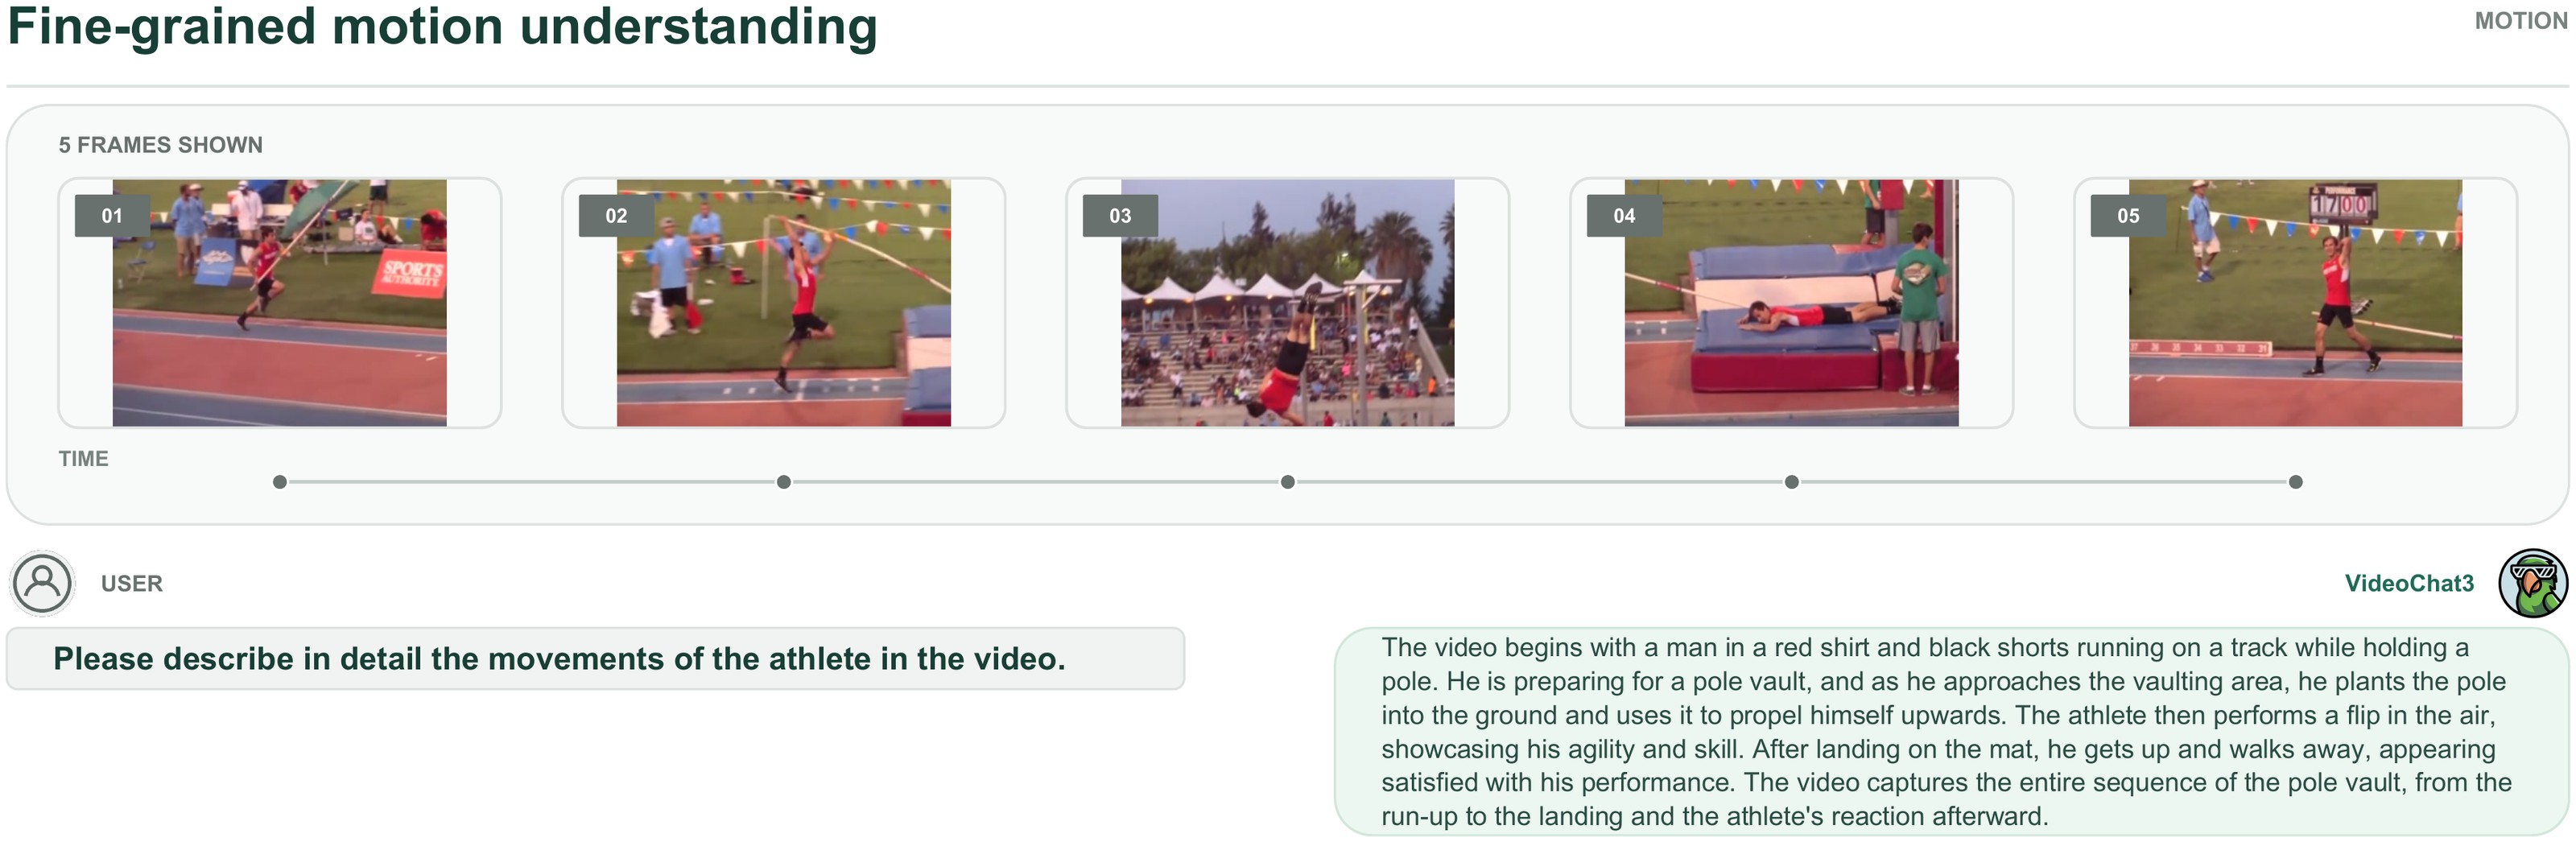
运动描述样例关注动作主体、方式和前后变化。审查时应确认动词是否由连续帧支持,不能让静态场景常识代替实际运动观察。
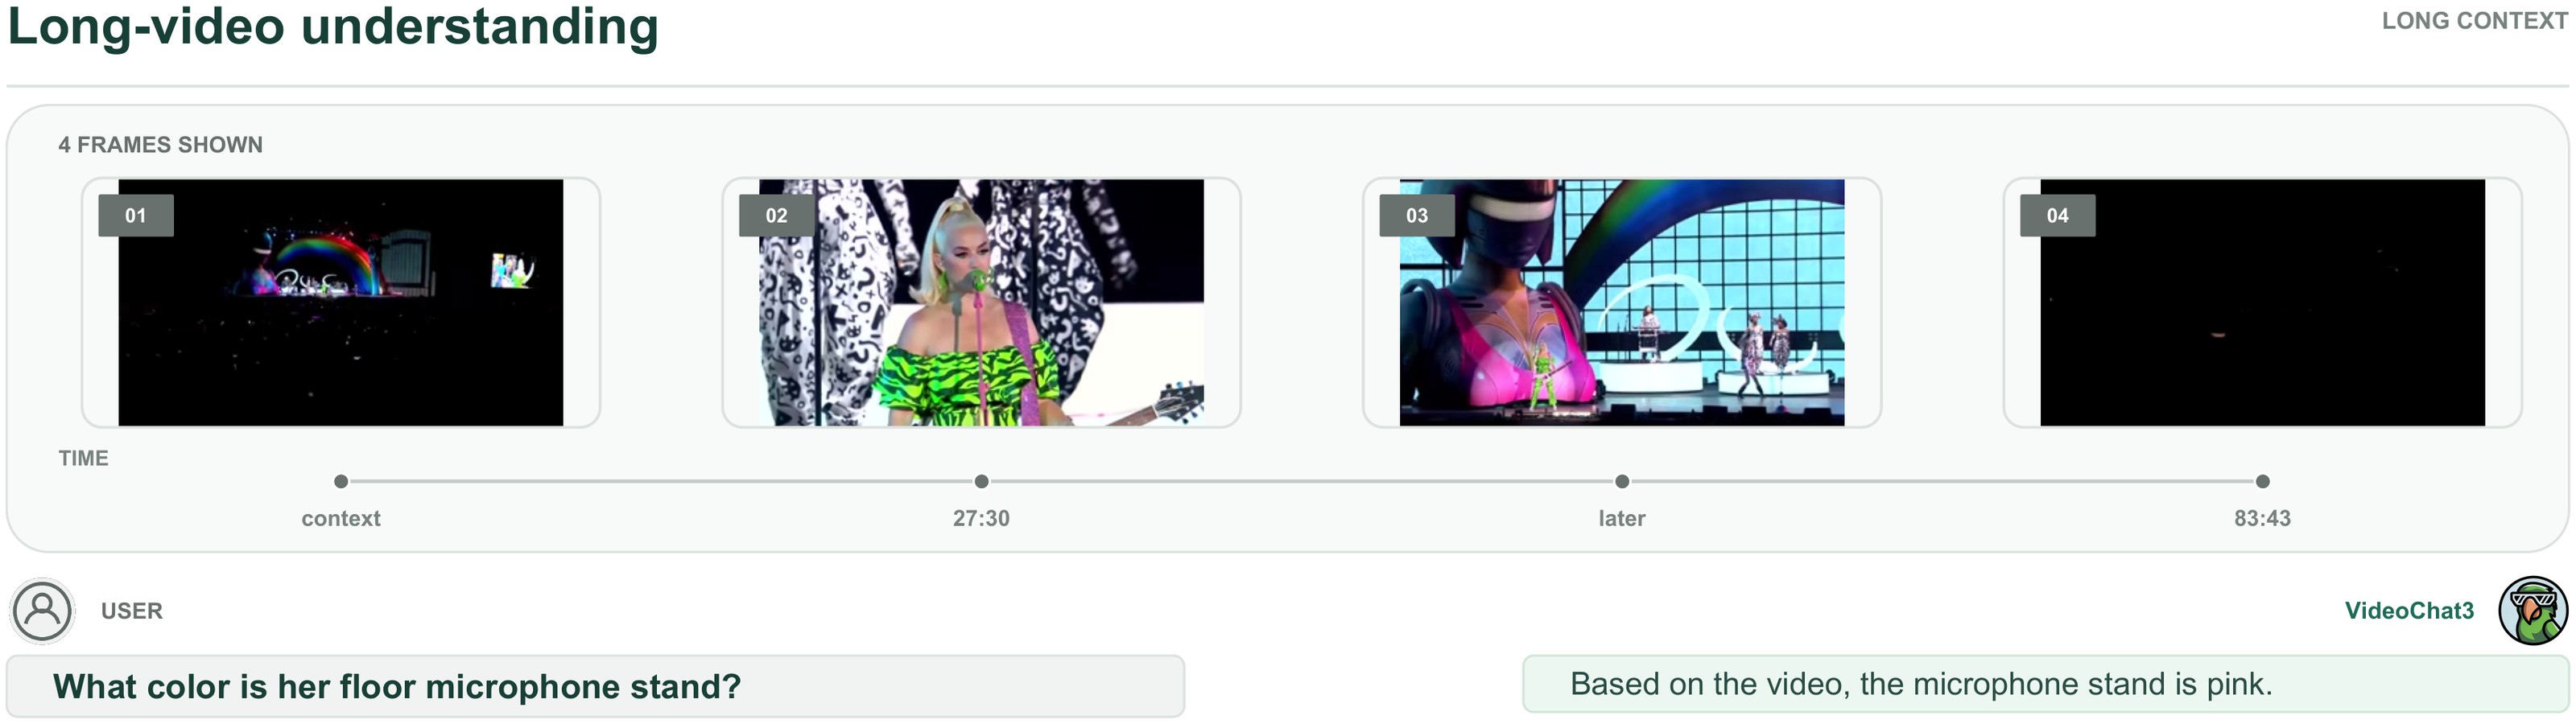
长视频问答展示跨片段证据组合。示例可以帮助理解输出形态,但一次成功回答不等于模型能均匀利用整段上下文,仍应通过证据位置移动和干扰片段检验。
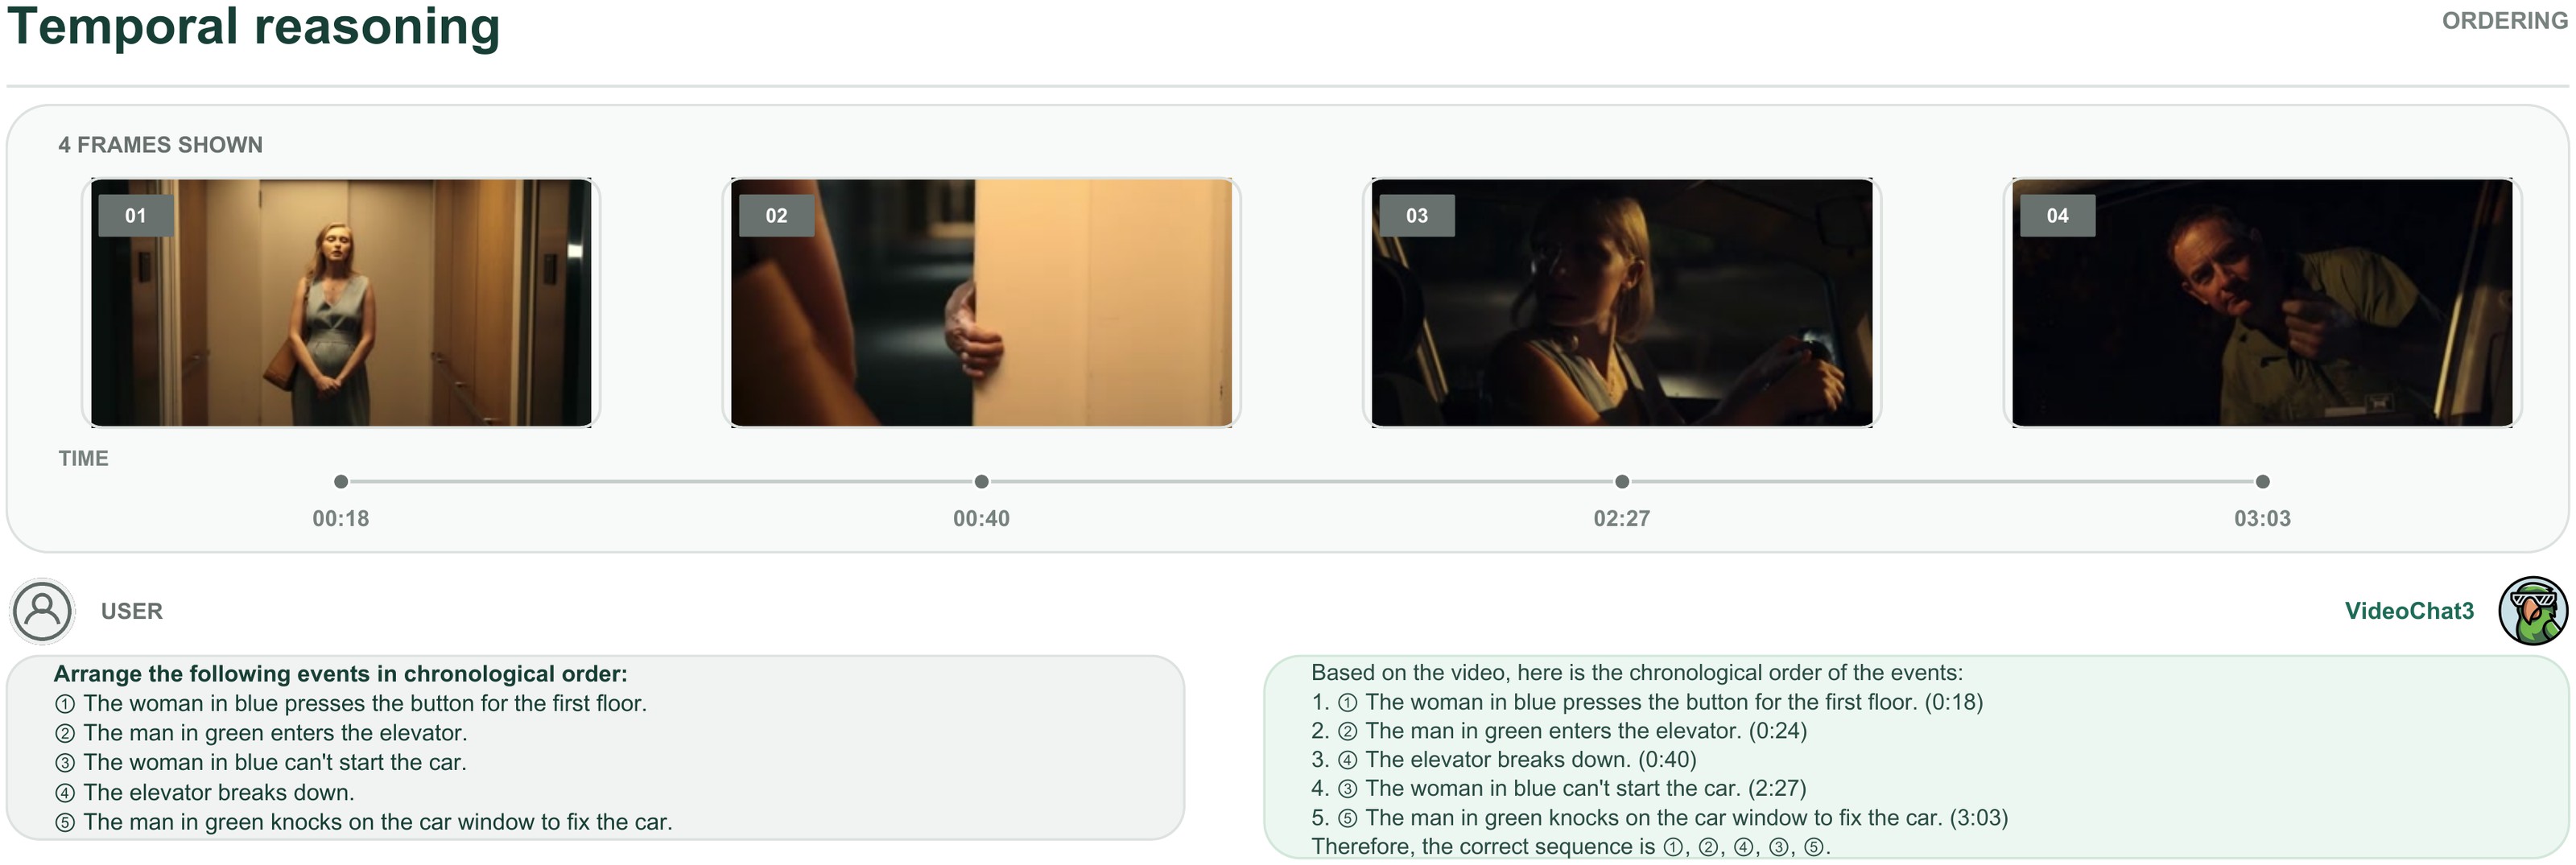
时序推理要求区分先后关系、变化过程与任务因果。画面顺序正确是基础,因果解释还应检查是否超出了可观察证据。
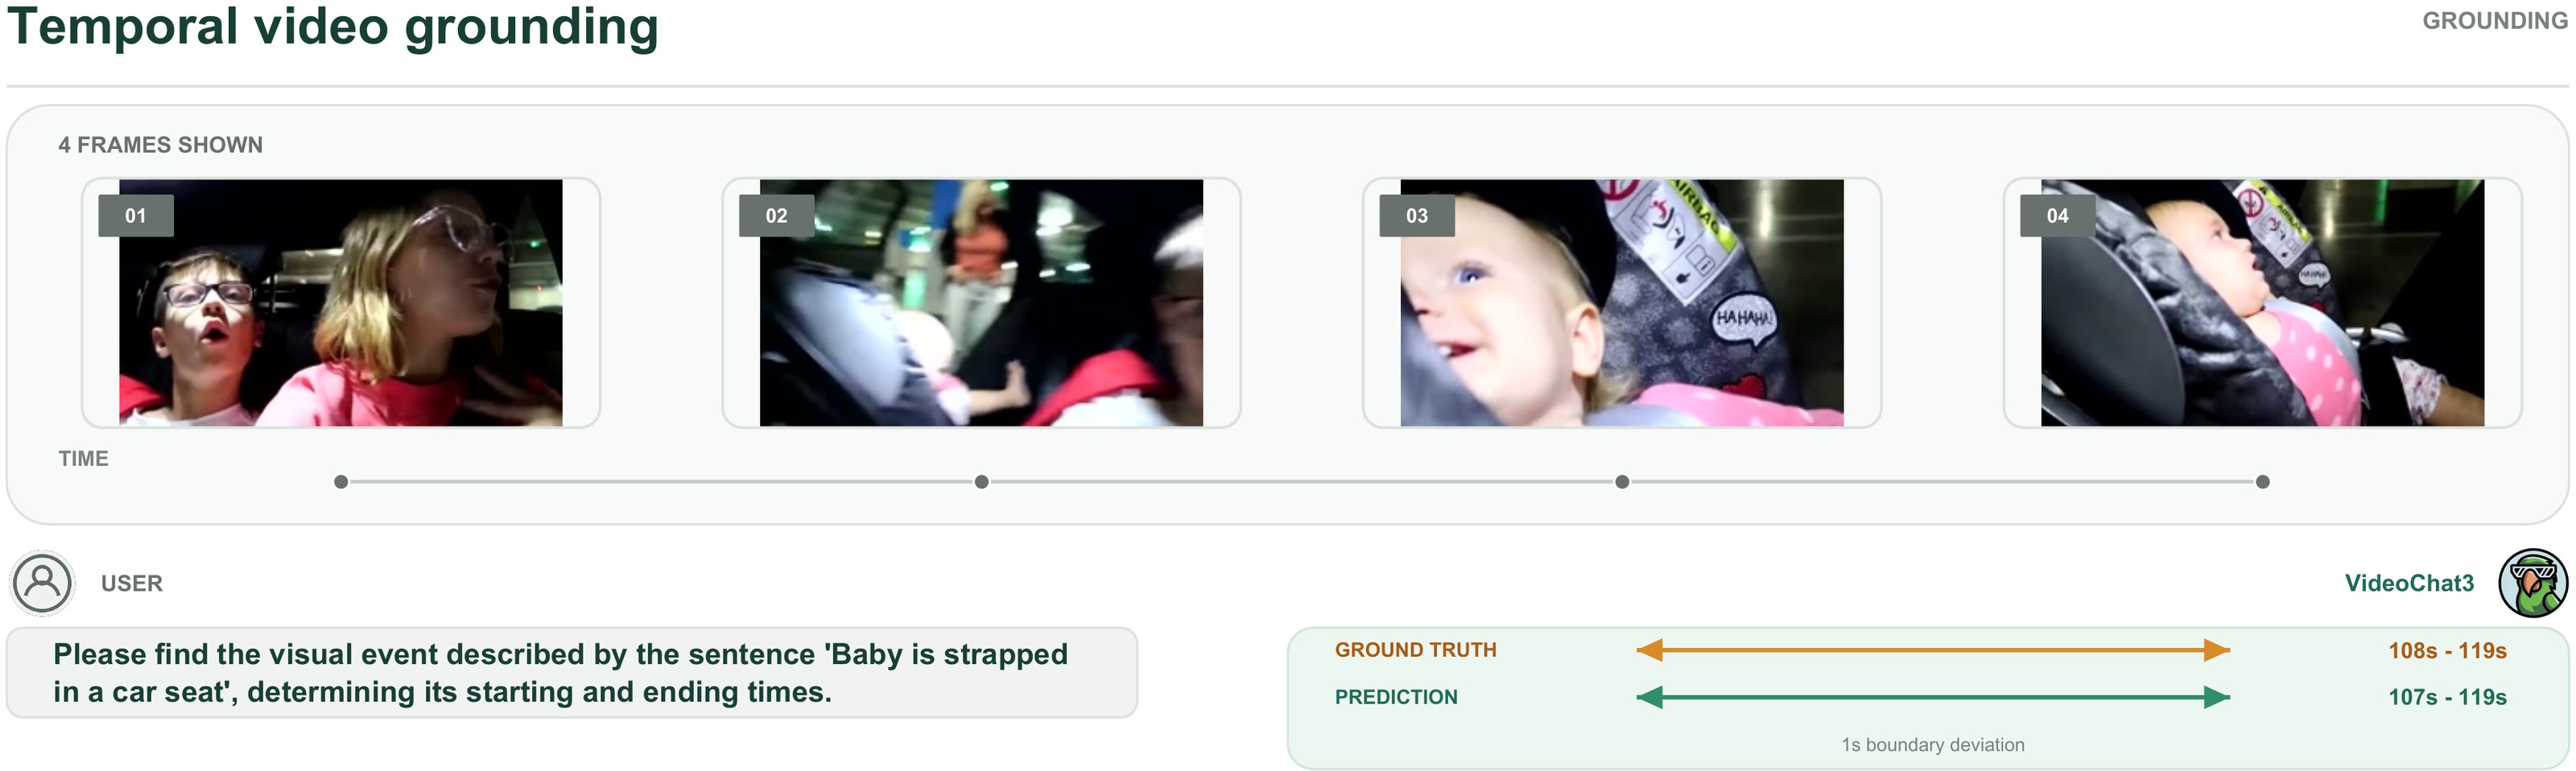
时间定位把语言描述落到区间边界。应用中除了整体区间重叠,还需要关心关键事件开始点误差,因为它直接影响检索跳转和主动提醒。
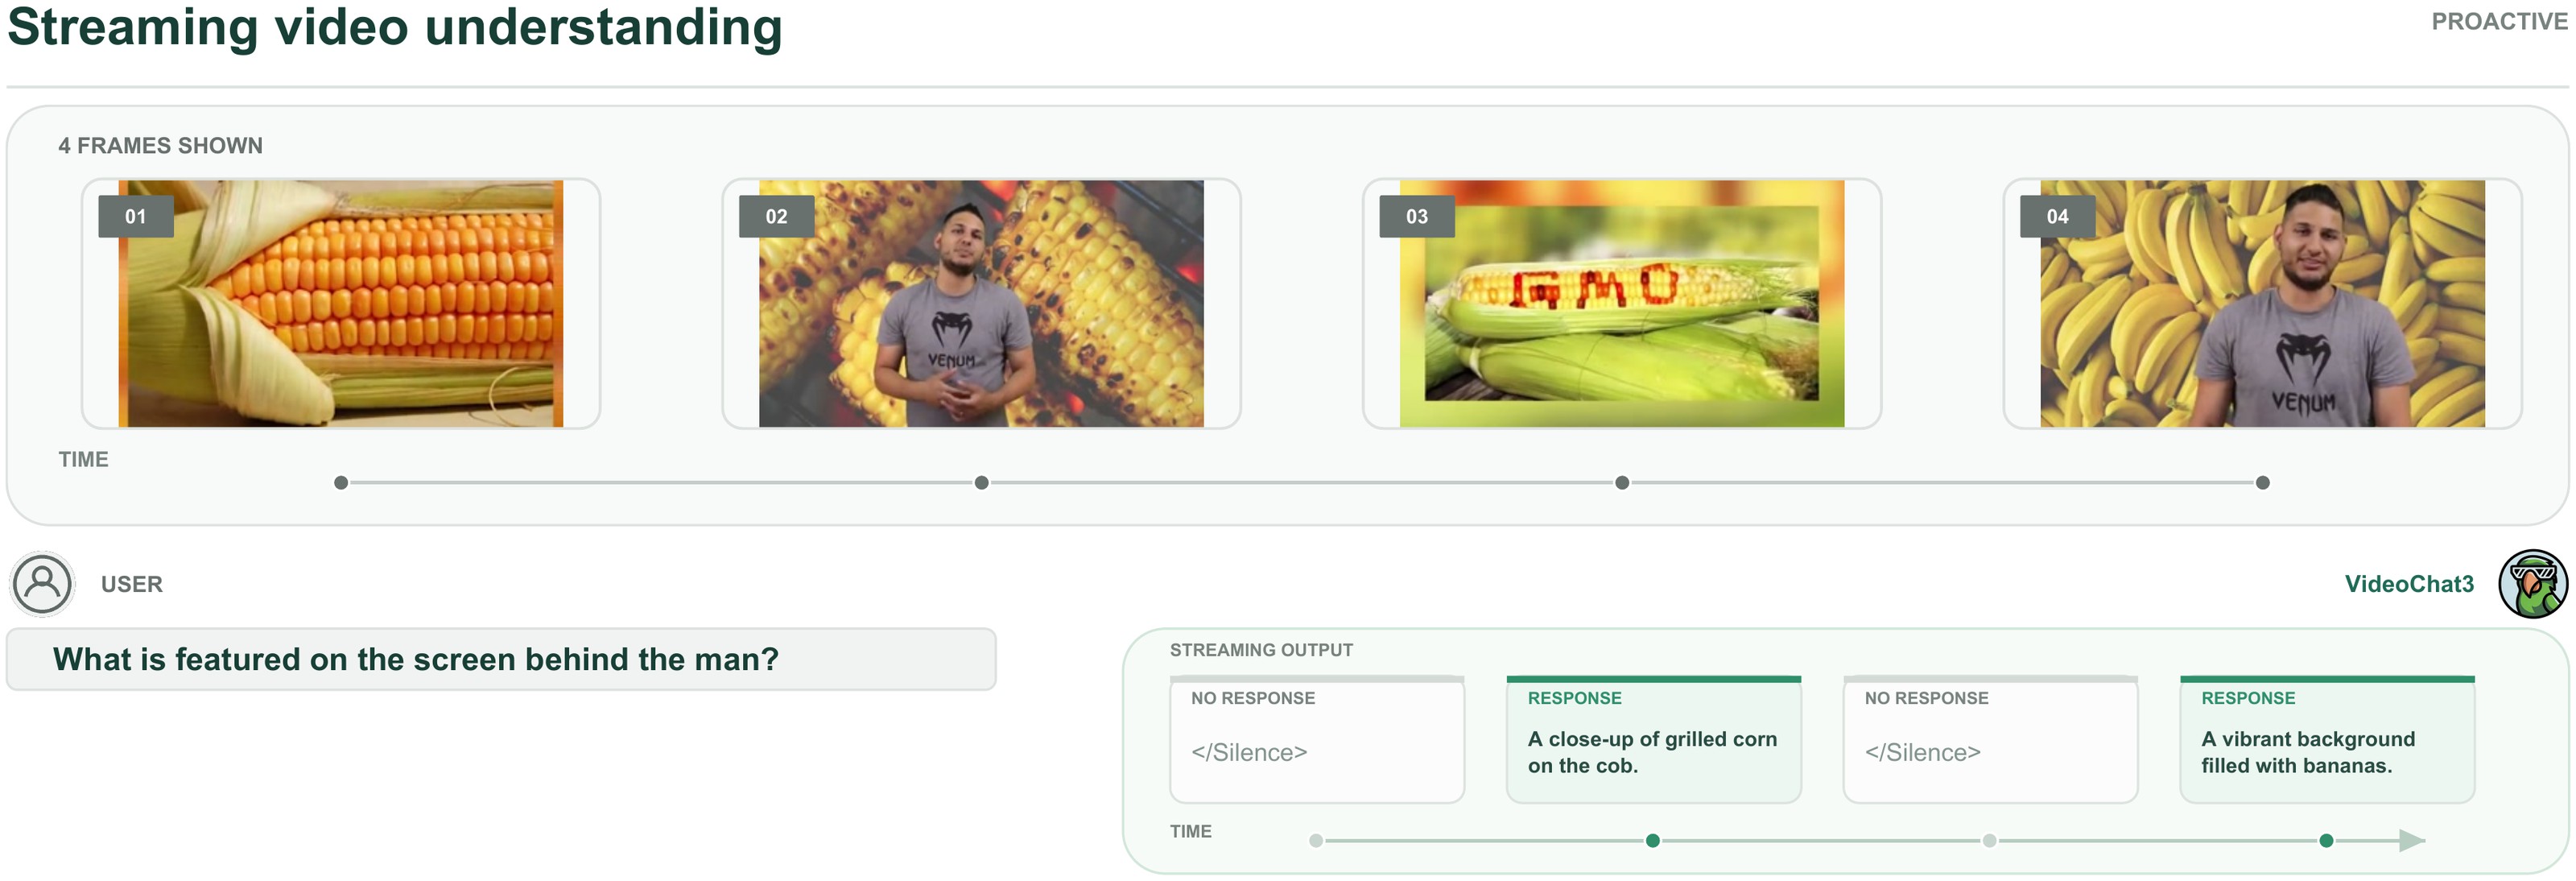
主动响应样例说明模型如何等待线索并开口。它呈现一条成功轨迹,但没有提供长时间无事件情况下的误报率,部署前应加入大量"什么都不该说"的负样本流。
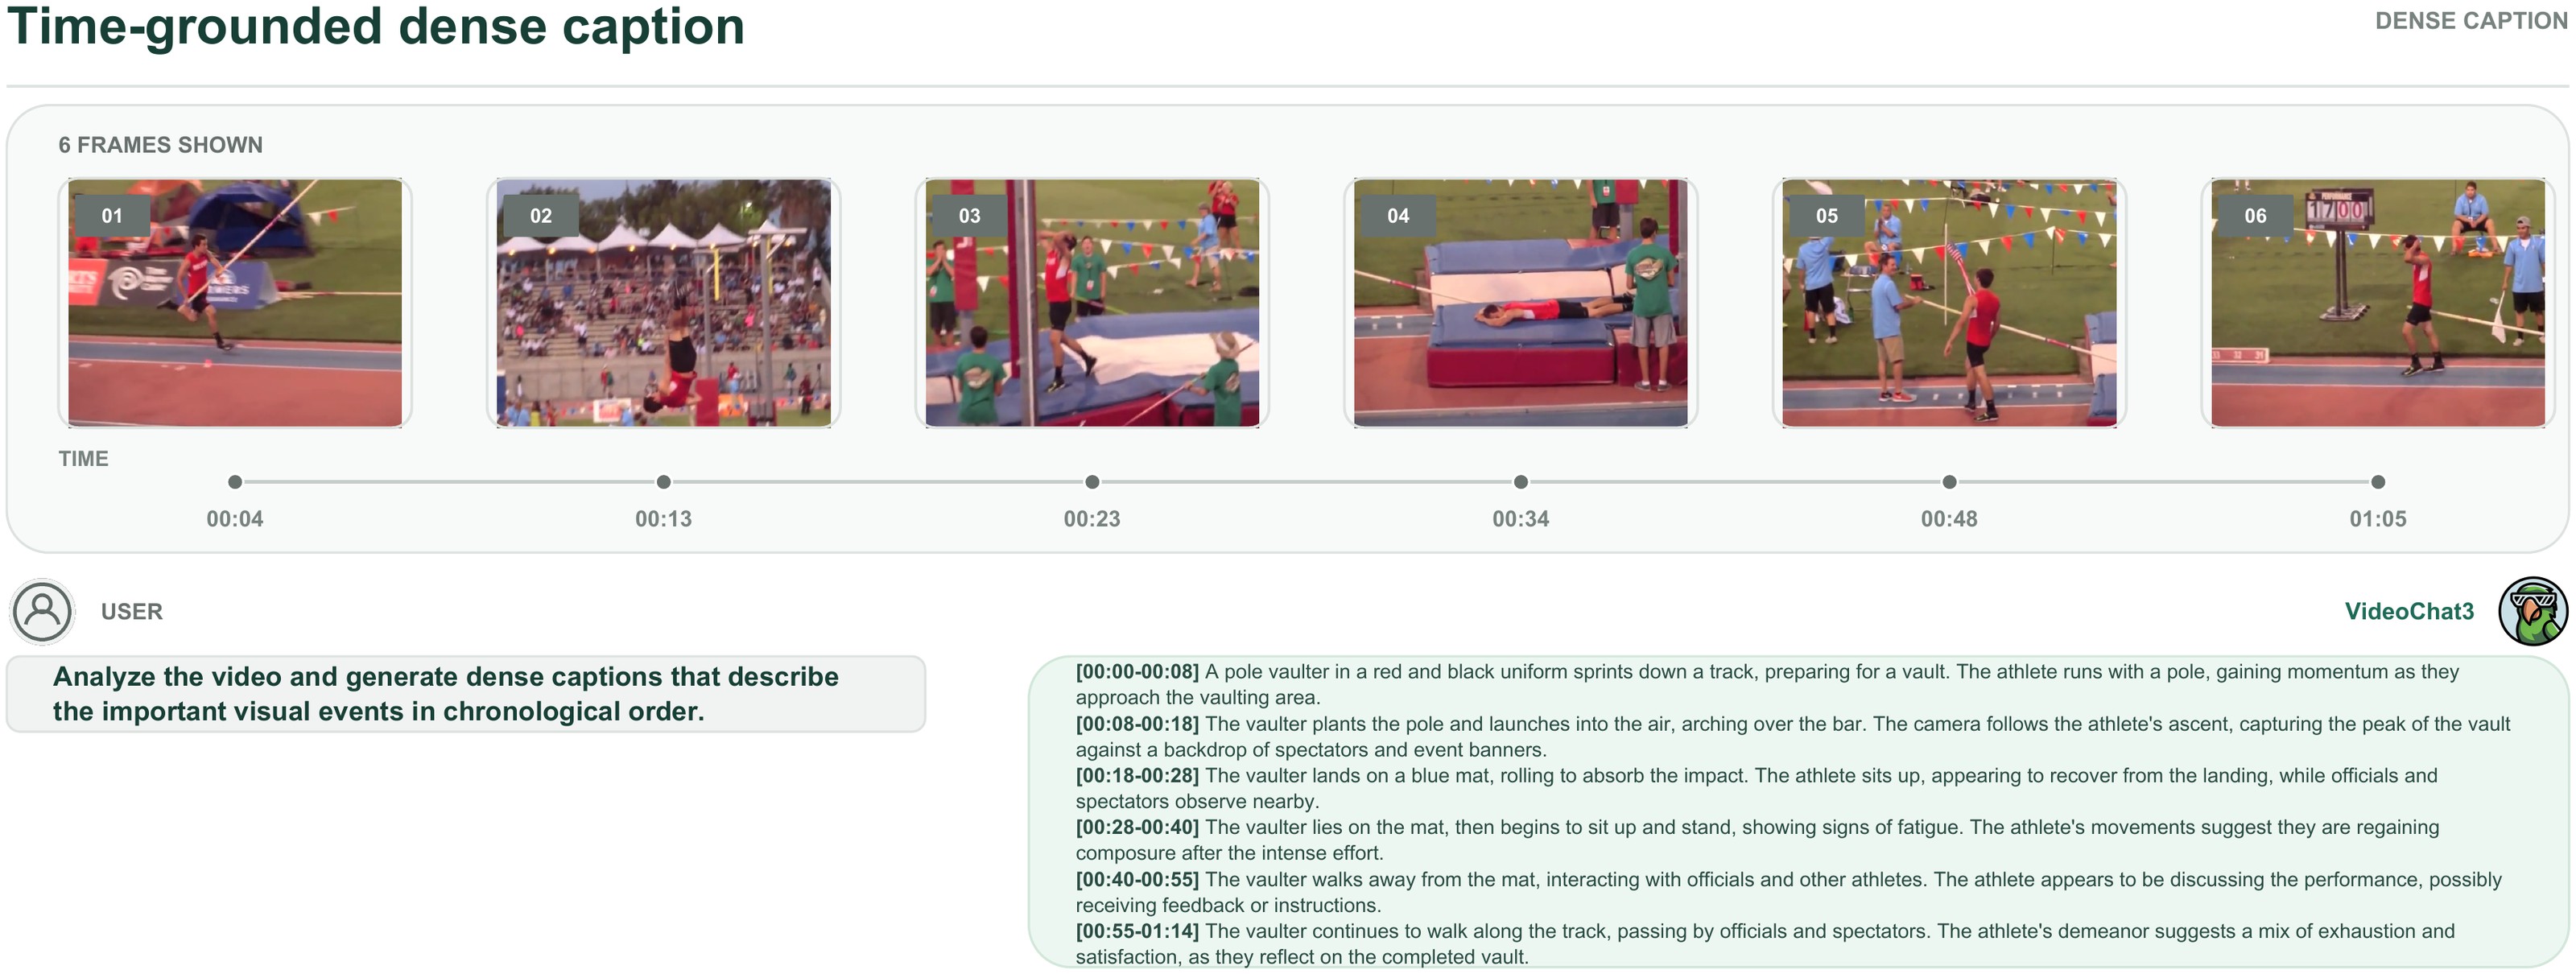
密集描述把多个事件串成时间线。应分别检查事件遗漏、重复描述、实体一致性和错误累积;文字流畅只覆盖其中很小一部分。
11. 评测配置与开放复现:把口径一并保存
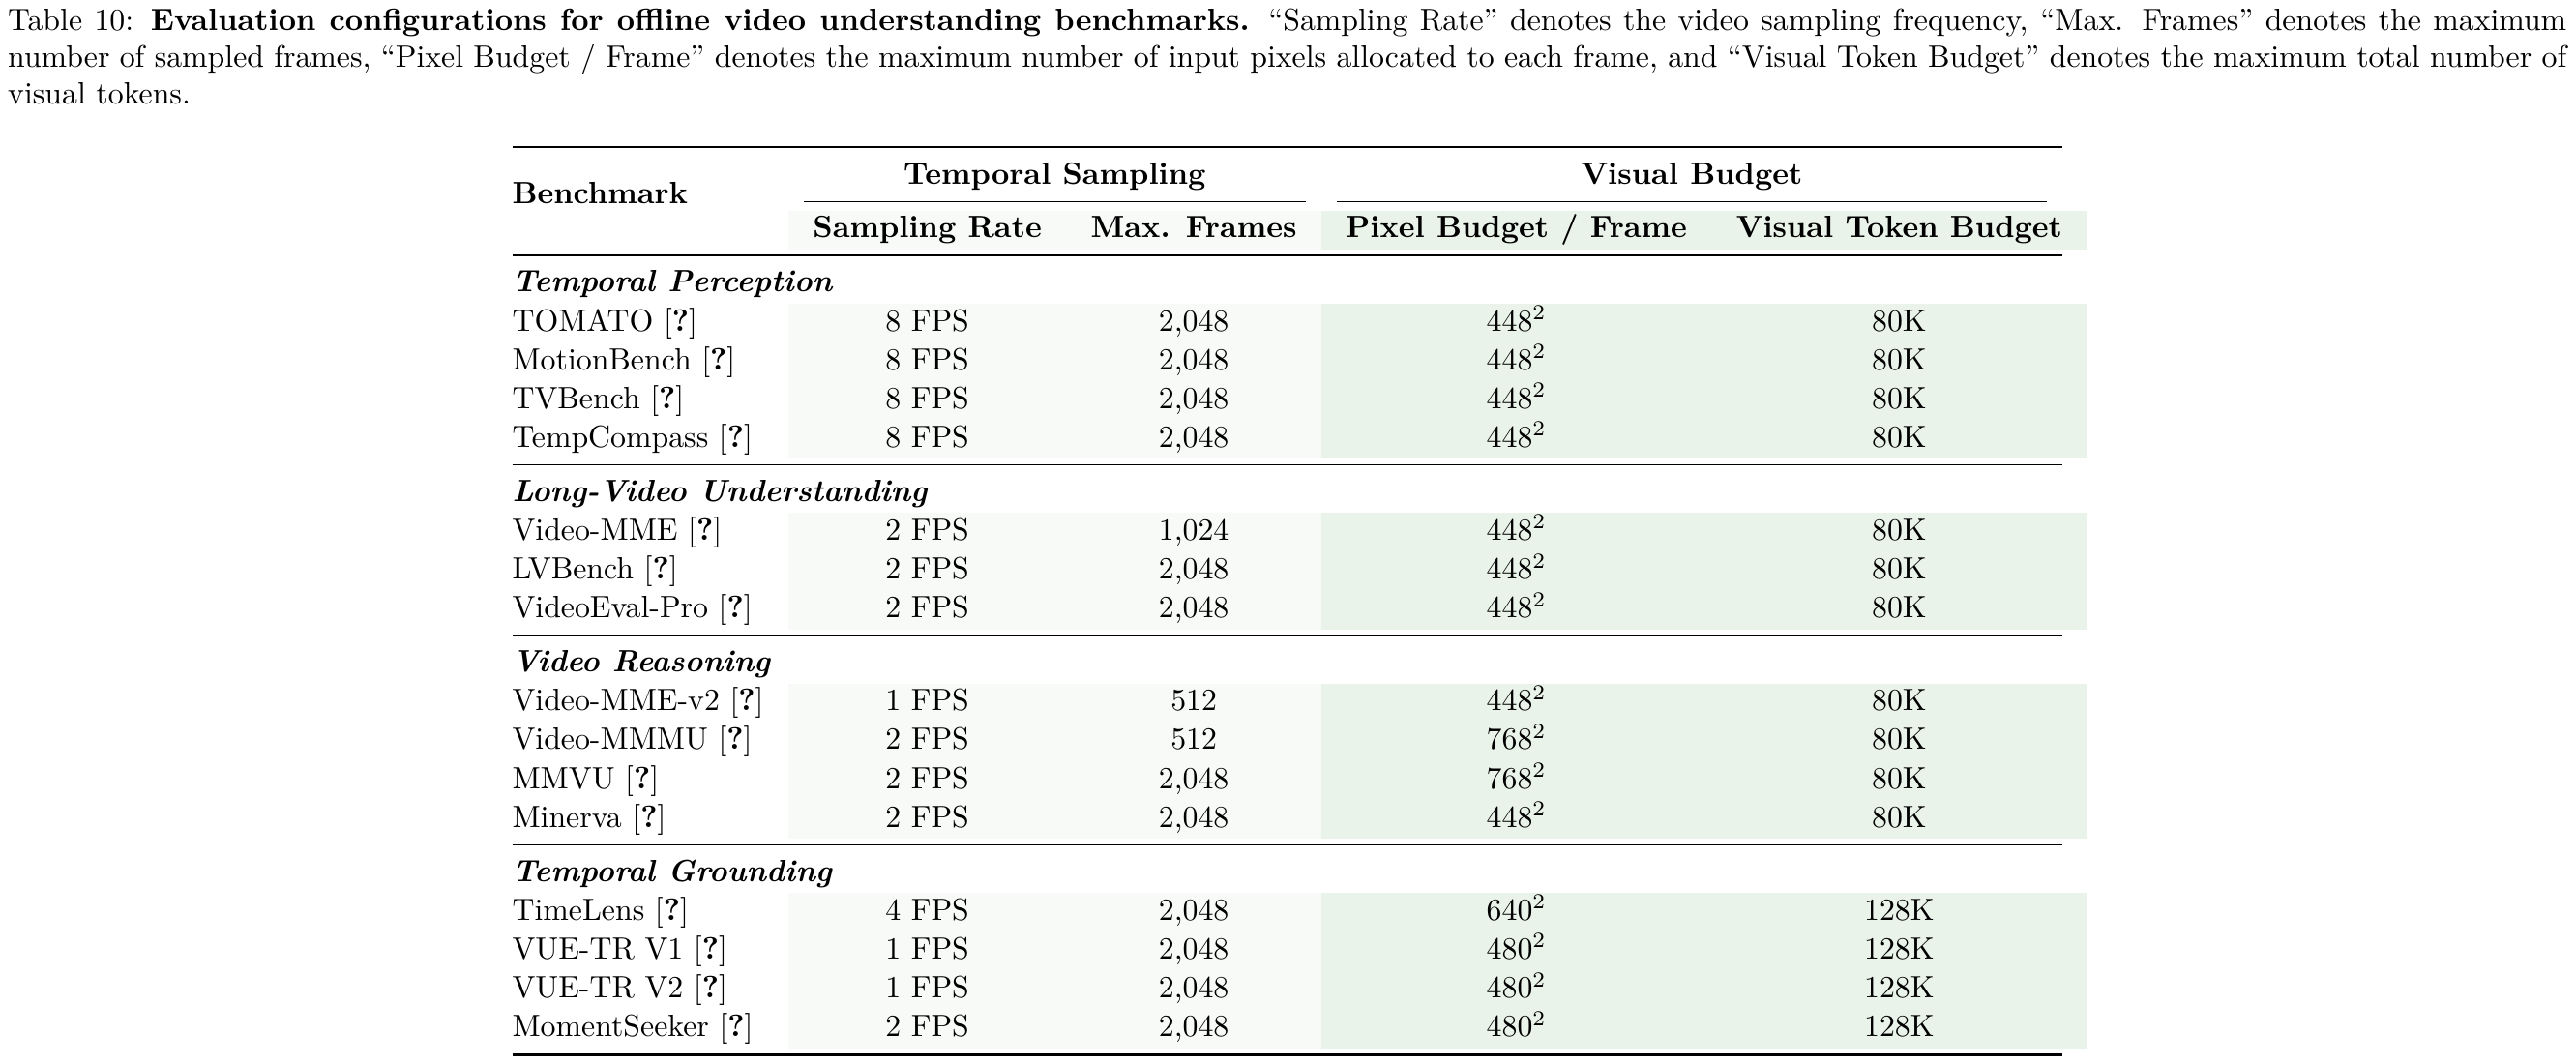
表10保留不同离线基准的帧采样、空间和生成配置。定位任务中的框坐标采用归一化约定时,应依照具体协议处理,例如空间框使用 0,1000 坐标,不能直接按原图像素解释。
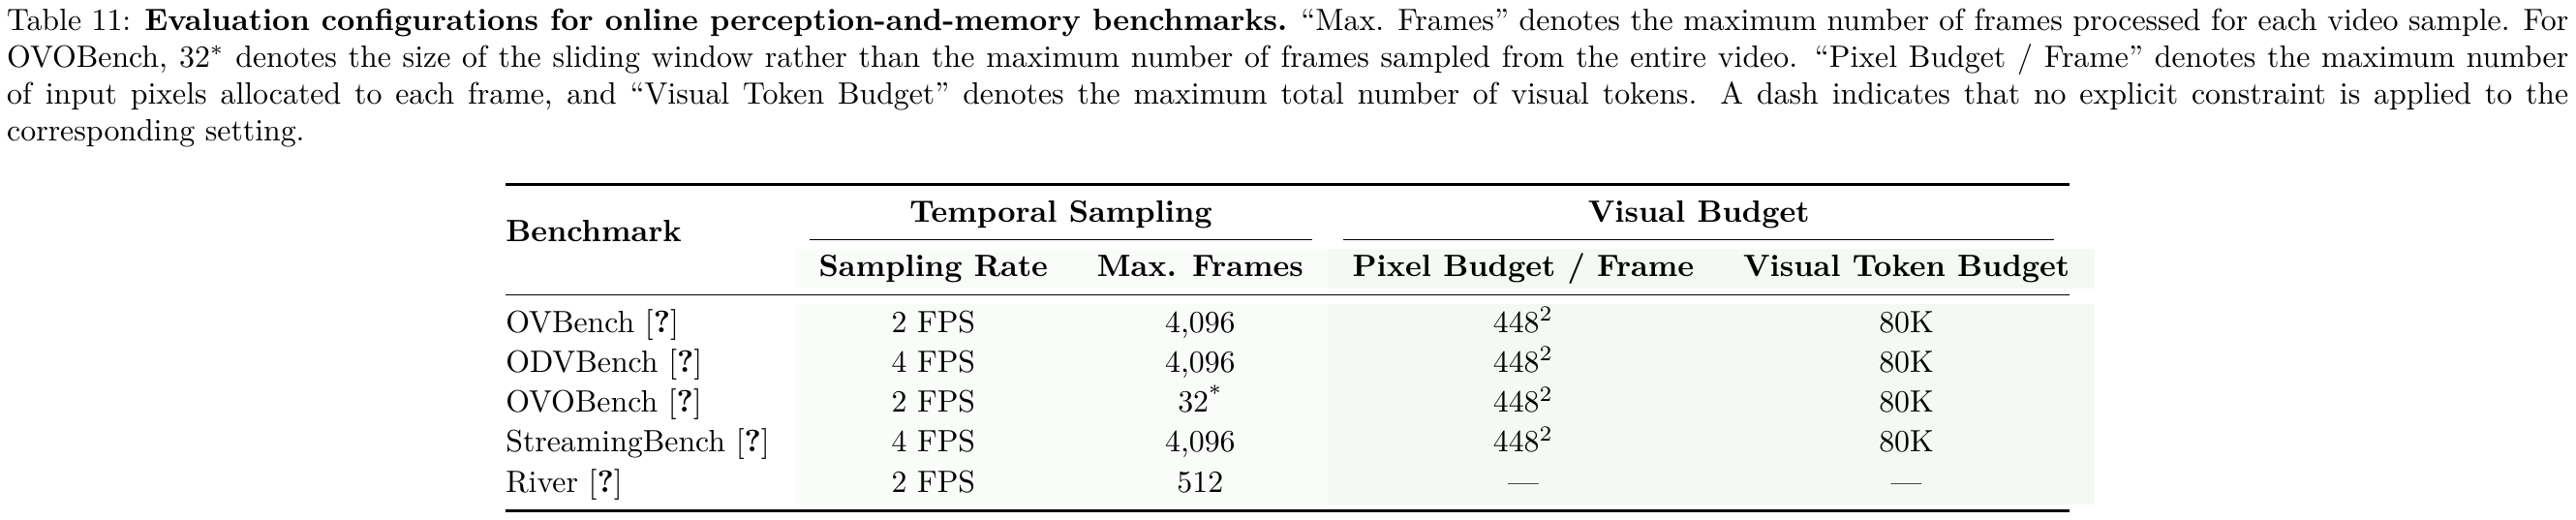
在线窗口上限不等于整个视频总长度。例如 OVO 的 32 帧设置属于滑动窗口配置,不能写成模型最多只能处理 32 帧视频。窗口、历史缓存和当前输入预算共同决定实际上下文。
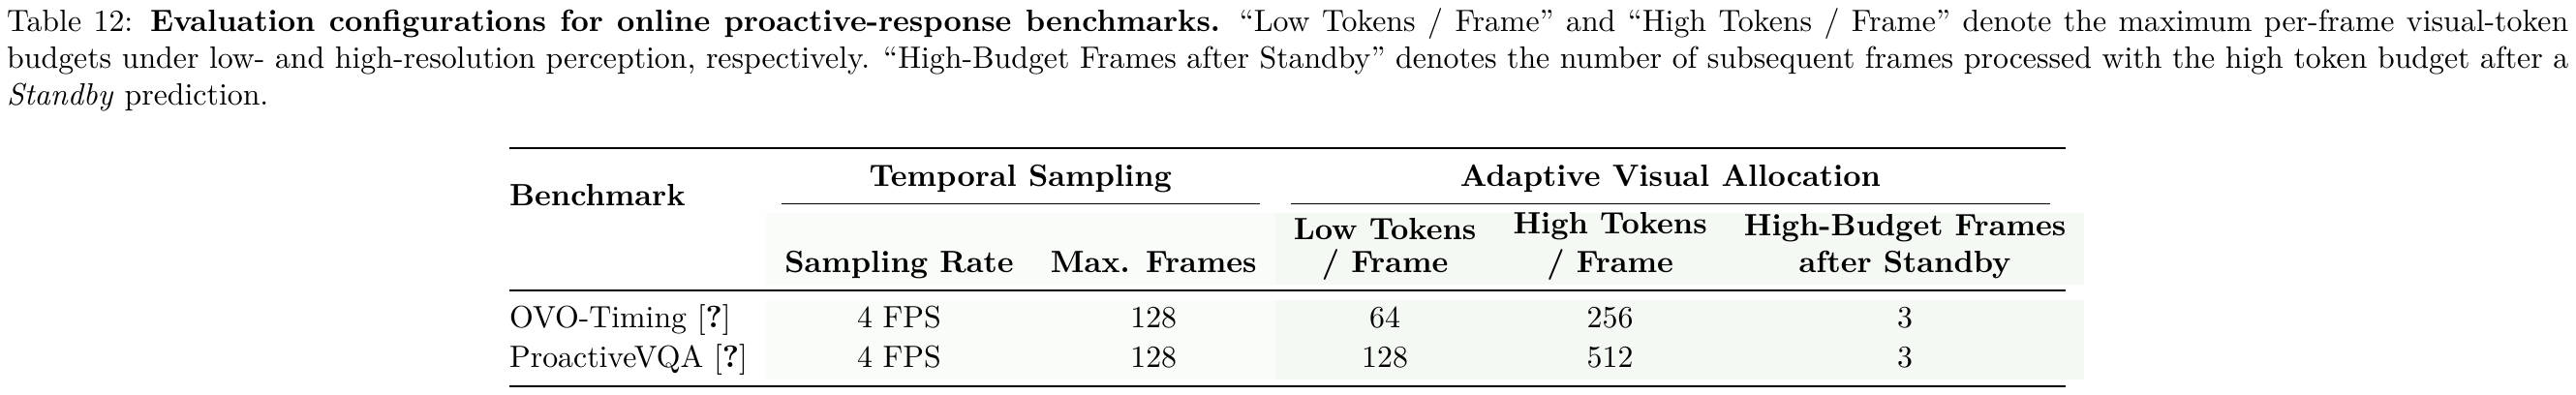
主动响应评测按 4 fps 采样、最多 128 帧,OVO-Timing 的低/高 token 预算为每帧 64/256,ProactiveVQA 为 128/512;Standby 后使用高预算的后续帧数为 3。PAUC 的相关评测还需保留 ω = 0.5 \omega=0.5 ω=0.5 等协议设置。这些参数说明不同任务的预算不能机械套用正文中的示意分辨率。
官方仓库提供训练代码、分阶段数据和检查点,以及评测实现,采用 XTuner V1 训练路线。公开这些环节有助于研究者定位收益来自哪里;完整复现仍需检查每个数据源的获取条件、许可证、筛选过程和具体版本。开放仓库并不使全部上游数据自动拥有统一授权。
12. Rocky 的工程判断:主动感知是一种预算策略
| 设计 | 直接解决的问题 | 后续仍需验证 |
|---|---|---|
| I3D-ViT | 局部时空聚合与 token 压缩 | 高频事件和细小信息的损失 |
| 动态像素额度 | 把分辨率留给潜在线索 | 低预算触发器的漏检与反馈误差 |
| 状态掩码 | 平衡切换与保持监督 | 长时间误报、重复与分布变化 |
| 三类数据课程 | 从短片问答到长时证据与在线时机 | 教师偏差、数据泄漏及跨域迁移 |
对研究团队,可进一步比较可学习预算控制器与固定三态规则,在相同实测成本下绘制质量、时机和延迟曲线。对工程团队,值得把感知预算记入每次任务日志,与事件命中、误报和 GPU 时间一起分析。对产品团队,应先明确哪类事件值得打断用户,再决定模型需要多频繁、多清楚地看。
VideoChat3 提供的跨周期启发,是让感知成为可调度资源。模型的长期价值要由证据覆盖、计算预算和交互行为共同衡量;架构压缩、数据课程和在线控制只有接在同一个验收目标上,效率提升才会变成用户可感知的收益。
推荐阅读
1. 深入浅出完整解析AI Agent(AI智能体)的核心基础知识
2025年可以说是AI Agent全面落地应用的元年,因此Rocky在持续撰写对AI Agent的全维度解析文章:
深入浅出完整解析AI Agent(AI智能体)的核心基础知识
2. 深入浅出完整解析扩散模型DDPM、DDIM、Score-Based、SDE、LDM、Classifier/Classifier-Free Guidance、Rectified Flow核心基础知识
Rocky对扩散模型的本质原理与和核心基础知识进行了全面系统的深入浅出分析讲解,同时不断跟进补充扩散模型的最新技术发展,希望能给大家带来帮助:
深入浅出完整解析扩散模型DDPM、DDIM、Score-Based、SDE、LDM、Classifier/Classifier-Free Guidance、Rectified Flow核心基础知识
3. 入浅出完整解析FLUX.2、Seedream(即梦)、Z-image、GLM-Image核心基础知识
Rocky对AIGC时代"中场时刻"之后的主流AIGC创作大模型的核心基础知识进行了全面系统的深入浅出分析讲解,力求让大家通俗易懂理解AIGC时代的技术浪潮的本质价值:
入浅出完整解析FLUX.2、Seedream(即梦)、Z-image、GLM-Image核心基础知识
4. 深入浅出完整解析FLUX.1 Kontext和FLUX.1 Krea核心基础知识
Rocky对FLUX.1 Kontext和FLUX.1 Krea的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析FLUX.1 Kontext和FLUX.1 Krea核心基础知识
5. 深入浅出完整解析DeepSeek系列核心基础知识
Rocky对DeepSeek系列模型的核心基础知识作了全面系统的梳理与解析:
6. 深入浅出完整解析Stable Diffusion 3(SD 3)和FLUX.1系列核心基础知识
Rocky对Stable Diffusion 3和FLUX.1的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion 3(SD 3)和FLUX.1系列核心基础知识
7. 深入浅出完整解析Stable Diffusion XL(SDXL)核心基础知识
Rocky对Stable Diffusion XL的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion XL(SDXL)核心基础知识
8. 深入浅出完整解析Stable Diffusion(SD)核心基础知识
Rocky对Stable Diffusion 1.x-2.x系列模型的核心基础知识做了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion(SD)核心基础知识
9. 深入浅出完整解析Stable Diffusion中U-Net的前世今生与核心知识
Rocky对Stable Diffusion中最为关键的U-Net结构进行了深入浅出的全面解析,包括其在传统深度学习中的价值和在AIGC中的价值:
深入浅出完整解析Stable Diffusion中U-Net的前世今生与核心知识
10. 深入浅出完整解析LoRA(Low-Rank Adaptation)模型核心基础知识
对于AIGC时代中的"ResNet"------LoRA模型,Rocky进行了深入浅出的全面讲解:
深入浅出完整解析LoRA(Low-Rank Adaptation)模型核心基础知识
11. 深入浅出完整解析ControlNet核心基础知识
AIGC图像创作开源社区已经形成以Stable Difffusion/FLUX为核心,ConrtolNet和LoRA作为首要AI辅助工具的变化万千的AIGC图像创作工作流。
ControlNet正是让AI图像创作社区无比繁荣的关键一环,它让AIGC图像创作过程更加的可控,更有助于广泛地将AIGC算法解决方案应用到各行各业中:
12. 深入浅出完整解析Sora、Seedance、keling等AI视频大模型核心基础知识
AI绘画和AI视频是两个互相促进、相互交融的领域,2024年无疑是AI视频领域的爆发之年,Rocky对AI视频领域核心的Sora、Seedance、Keling等大模型进行了全面系统的梳理与解析:
深入浅出完整解析Sora、Seedance、keling等AI视频大模型核心基础知识
13. 深入浅出完整解析AIGC时代Transformer核心基础知识
在AIGC时代中,Transformer为AI行业带来了深刻的变革。Transformer架构正在一步一步重构所有的AI技术方向,成为AI技术架构大一统与多模态整合的关键核心基座,大有一统"AI江湖"之势。Rocky也对Transformer模型进行持续的深入浅出梳理与解析:
深入浅出完整解析AIGC时代Transformer核心基础知识
14. 深入浅出完整解析ComfyUI、Diffusers、Stable Diffusion WebUI等主流AIGC创作框架核心基础知识
AIGC创作框架正是AIGC算法工作流的运行载体,目前主流的AIGC创作框架有ComfyUI、Diffusers、Stable Diffusion WebUI等 。在传统深度学习时代,PyTorch、TensorFlow以及Caffe是传统深度学习模型的基础运行框架,到了AIGC时代,Rocky相信ComfyUI就是AIGC时代的"PyTorch"、Stable Diffusion WebUI就是AIGC时代的"TensorFlow"、Diffusers就是AIGC时代的"Caffe":
深入浅出完整解析ComfyUI、Diffusers、Stable Diffusion WebUI等主流AIGC创作框架核心基础知识
15. 深入浅出完整解析ComfyUI、Diffusers、Stable Diffusion WebUI等主流AIGC创作框架核心基础知识
在AIGC时代中,如何快速转身,入局AIGC产业?如何成为AIGC/LLM/AI Agent算法/开发工程师?如何在学校中系统性学习AIGC/LLM/AI Agent知识,斩获心仪的AIGC/LLM/AI Agent算法/开发offer?
Don't worry,Rocky为大家总结整理了全面的AIGC/LLM/AI Agent算法/开发工程师成长秘籍,为大家答疑解惑,希望能给大家带来帮助:
手把手教你成为AIGC/LLM/AI Agent算法/开发工程师,斩获AIGC/LLM/AI Agent算法/开发offer!
16. AIGC产业的深度思考与分析
2023年3月21日,微软创始人比尔·盖茨在其博客文章《The Age of AI has begun》中表示,自从1980年首次看到图形用户界面(graphical user interface)以来,以OpenAI为代表的科技公司发布的AIGC模型是他所见过的最具革命性的技术进步。
Rocky也认为,AIGC及其生态,会成为AI行业重大变革的主导力量。AIGC会带来一个全新的红利期,未来随着AIGC的全面落地和深度商用,会深刻改变我们的工作、生活、学习以及交流方式,各行各业都将被重新定义,过程会非常有趣。
那么,在此基础上,我们该如何更好的审视AIGC的未来?我们该如何更好地拥抱AIGC引领的革新?Rocky准备从技术、产品、商业模式、长期主义等维度持续分享一些个人的核心思考与观点,希望能帮助各位读者对AIGC有一个全面的了解:
深入浅出全面解析AIGC时代核心价值与发展趋势(2025年版)
17. AI算法工程师的独孤九剑秘籍
为了方便大家实习、校招以及社招的面试准备,同时帮助大家提升扩展技术基本面,Rocky将符合大厂和AI独角兽价值的算法高频面试知识点撰写总结成《三年面试五年模拟》之独孤九剑秘籍:
【三年面试五年模拟】AIGC时代的算法工程师的求职面试秘籍(持续更新中)
18. 深入浅出完整解析AIGC时代中GAN(Generative Adversarial Network)系列模型核心基础知识
GAN系列模型作为传统深度学习时代的最热门生成式Al模型,在AIGC时代继续繁荣,作为Stable Diffusion/FLUX系列大模型的"得力助手",广泛活跃于AlGC图像创作的产品与工作流中:
深入浅出完整解析AIGC时代中GAN(Generative Adversarial Network)系列模型核心基础知识