当AI在你看不到的地方狂奔:Karpathy的认知漏斗与人类理解的分裂
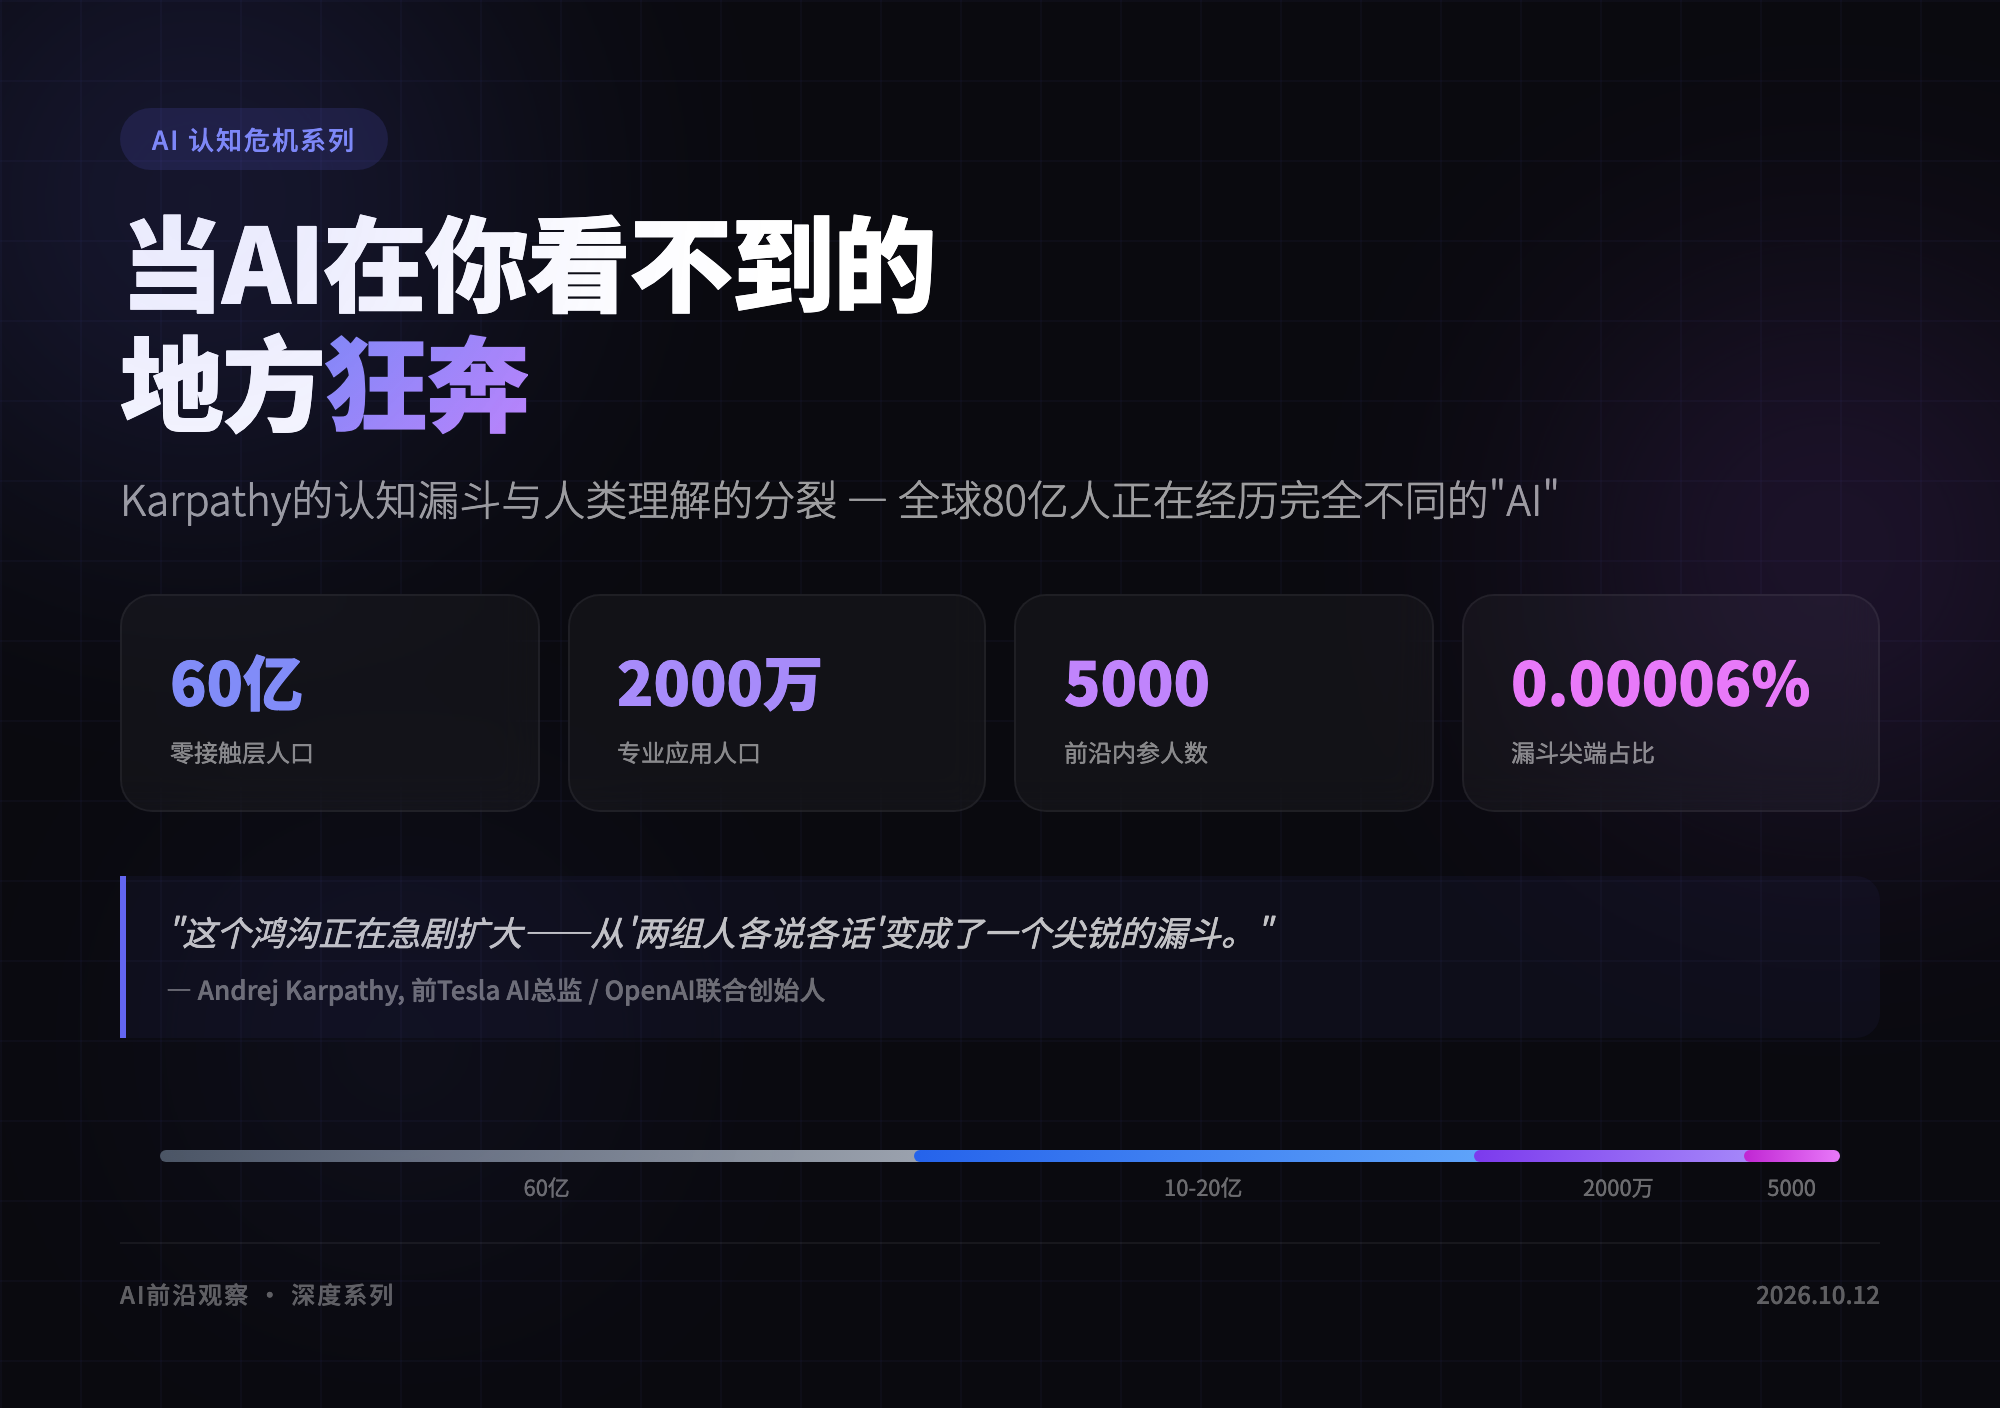
引子:前Tesla AI总监Andrej Karpathy重新分享了一条写于4月的推文,并补充了一句话------"这个鸿沟正在急剧扩大"。这句话背后,是一个关于AI未来最深刻的结构性困境:全球80亿人正在经历完全不同的"AI",而绝大多数人对此一无所知。
一、漏斗的真相:80亿人的四层分裂
Karpathy用"餐巾纸计算"勾勒出一个令人不安的分布模型------全球约80亿人口对LLM能力的理解,呈现为一个极端尖锐的漏斗。
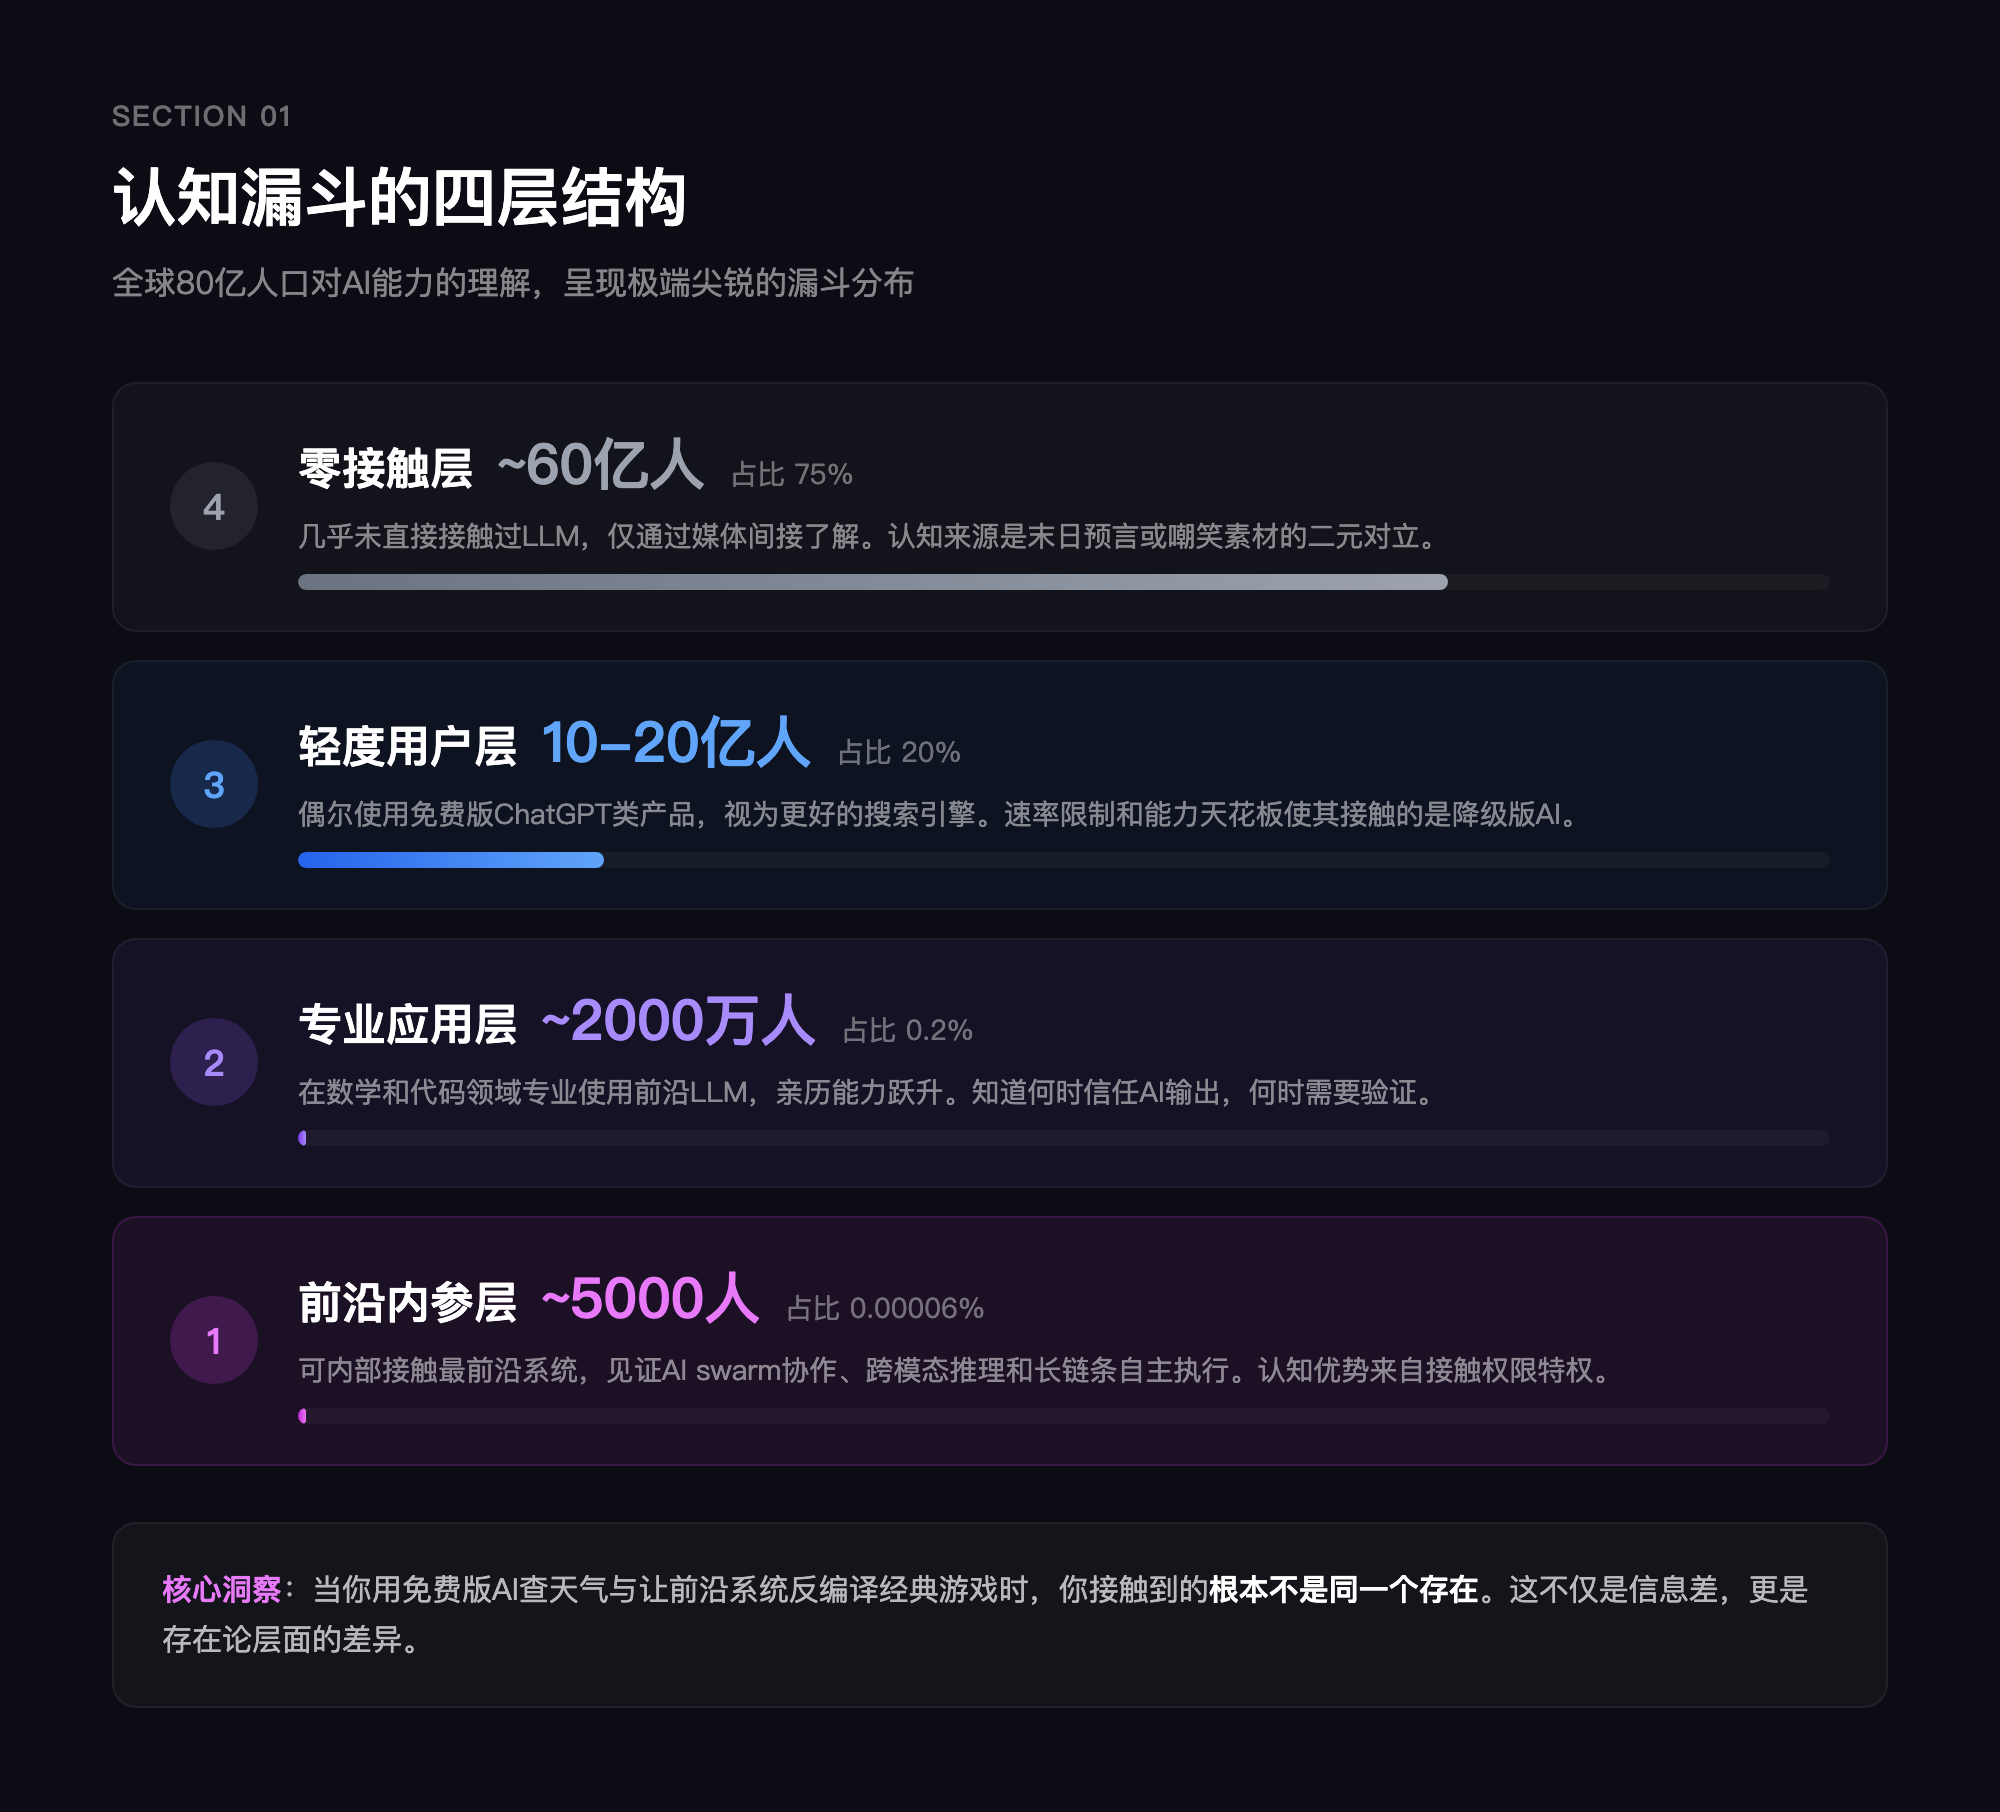
第一层:零接触层(~60亿人,75%)
全球约四分之三的人口几乎从未直接接触过LLM。他们对AI的认知来自媒体头条------要么是"AI将取代所有工作"的末日预言,要么是"AI chatbot经常胡说八道"的嘲笑素材。这些人并非智力不足,而是被接入壁垒(语言、网络、设备、数字素养)隔离在真实的AI体验之外。
第二层:轻度用户层(10-20亿人,20%)
这一层人群偶尔使用免费版ChatGPT类产品,但使用模式高度同质化------查天气、问菜谱、摘要文章。在他们眼中,AI是一个更好的搜索引擎,而非创造性的协作者。免费版的速率限制、能力天花板和对话长度限制,使他们接触的只是一个被刻意降级的AI分身。
第三层:专业应用层(~2000万人,0.2%)
这是真正的分水岭------在数学和代码领域专业使用前沿LLM的人群。他们不只是"用"AI,而是在与AI的协作中亲历了能力的垂直跃升。他们知道什么时候该信任AI的输出,什么时候该验证;他们理解prompt工程的精髓在于精确描述问题空间和约束条件。
第四层:前沿内参层(~5000人,0.00006%)
漏斗的尖端------可内部接触最前沿系统 的极少数人。他们见证了AI swarm协作、跨模态推理、长链条任务自主执行的完整过程。Karpathy指出,这一层人群的"认知优势"并非来自智力差异,而是来自接触权限的特权。
这不是信息差,是存在论差异
我们常说"数字鸿沟"是设备和网络的问题。但Karpathy的漏斗揭示了一个更深层的事实:当你使用免费版ChatGPT问"今天天气如何"与让前沿系统自主完成"反编译一款SNES游戏并在现代平台上原生运行"时,你接触到的根本不是同一个存在。
二、锯齿性:为什么AI在代码领域像神,在其他领域像白痴
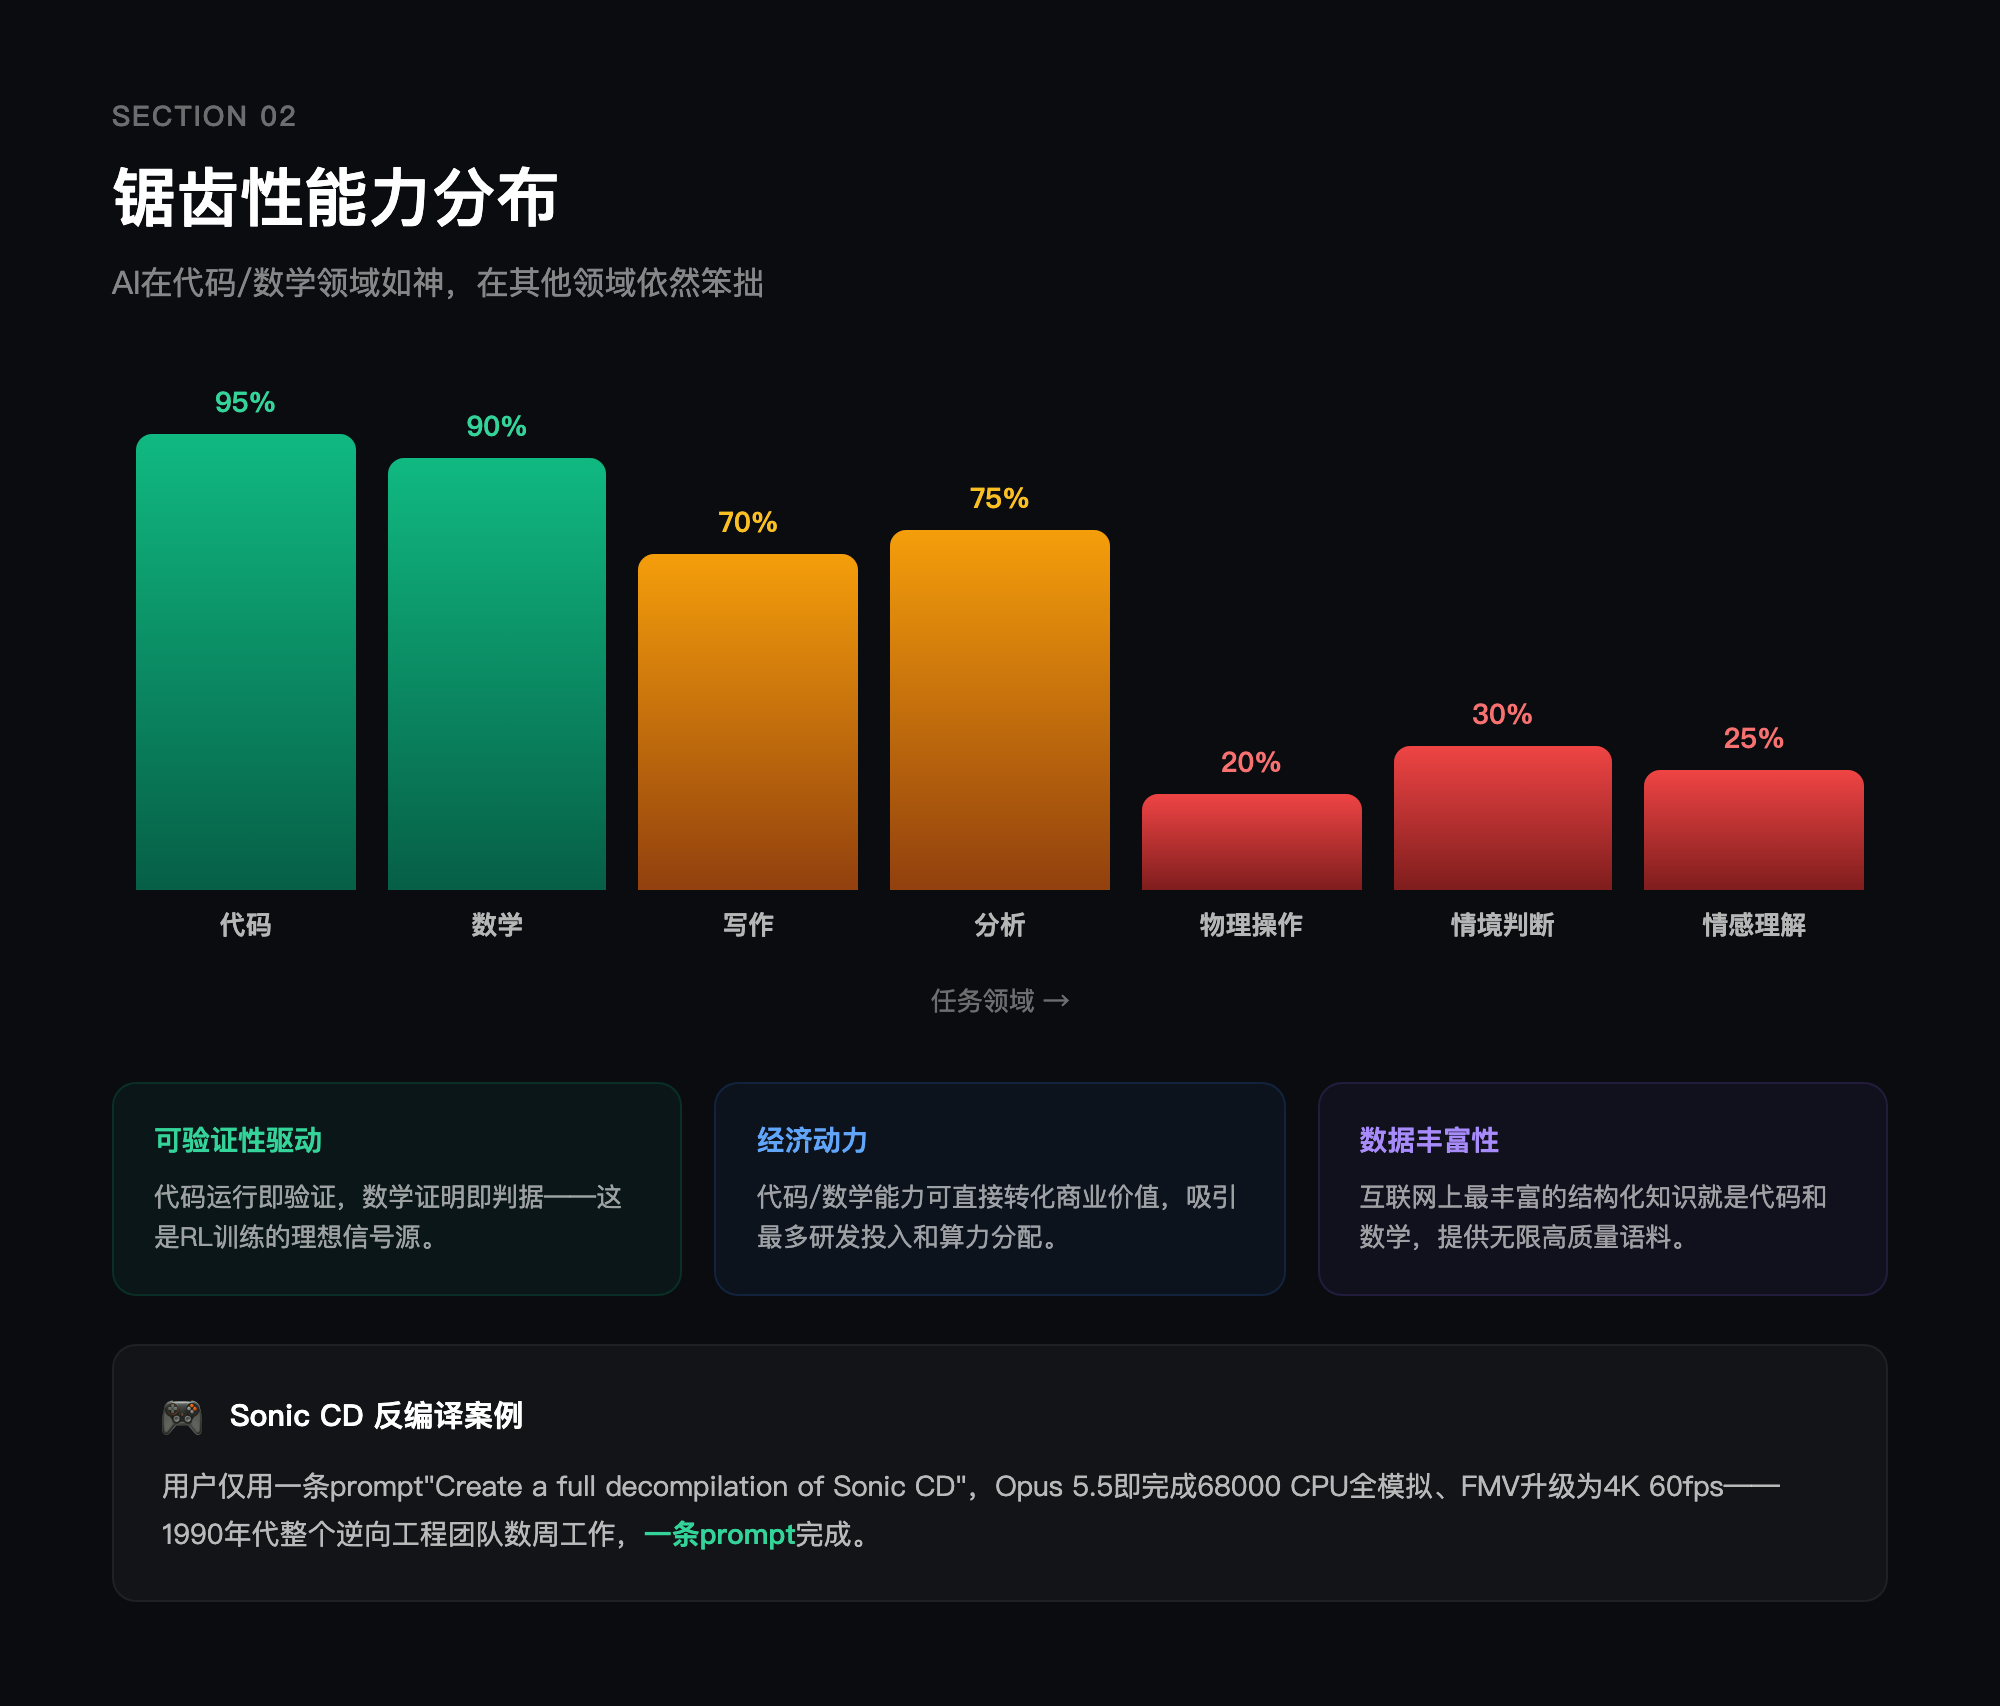
Karpathy提出了一个关键概念------AI的锯齿性能力分布(jagged frontier):在数学和代码等"数字-可验证-经济价值高"的领域,前沿LLM已达到令人眩晕的高度;而在需要物理操作、情感理解、情境化判断的领域,AI仍然笨拙得令人发指。
为什么锯齿在代码/数学领域最深
三个原因形成正反馈循环:
-
可验证性:代码运行结果即验证,数学证明逻辑即判据。这种"可验证奖励"恰好是RLHF和RLVR训练的理想信号源。
-
经济动力:代码和数学能力可直接转化为商业价值,吸引了最多的研发投入和算力分配。
-
数据丰富性:互联网上最丰富的结构化知识就是代码和数学,为模型训练提供了近乎无限的高质量语料。
一个生动的例子
近期Reddit社区一个项目为"锯齿性"提供了完美注脚:一位用户仅用一条prompt指令------"Create a full decompilation of Sonic CD"------让Opus 5.5完成了世嘉Mega-CD游戏的完整反编译与原生移植。包括:
- 68000 CPU全模拟
- Z8协处理器精确时序
- VDP图形芯片逐一还原
- YM2612音频合成器逐音轨重建
- FMV替换为4K 60fps重制版
- 实现真16:9宽屏显示
这个需要1990年代整个逆向工程团队数周工作量的项目,现在仅用一条prompt即可完成。而在另一端,今天的AI仍然无法可靠地完成"帮老人设置智能手机"这样看似简单的情境化任务。
三、认知冲击:前沿实践者看到了什么
漏斗尖端的5000人究竟看到了什么样的AI?今天的三条新闻提供了一个切片。
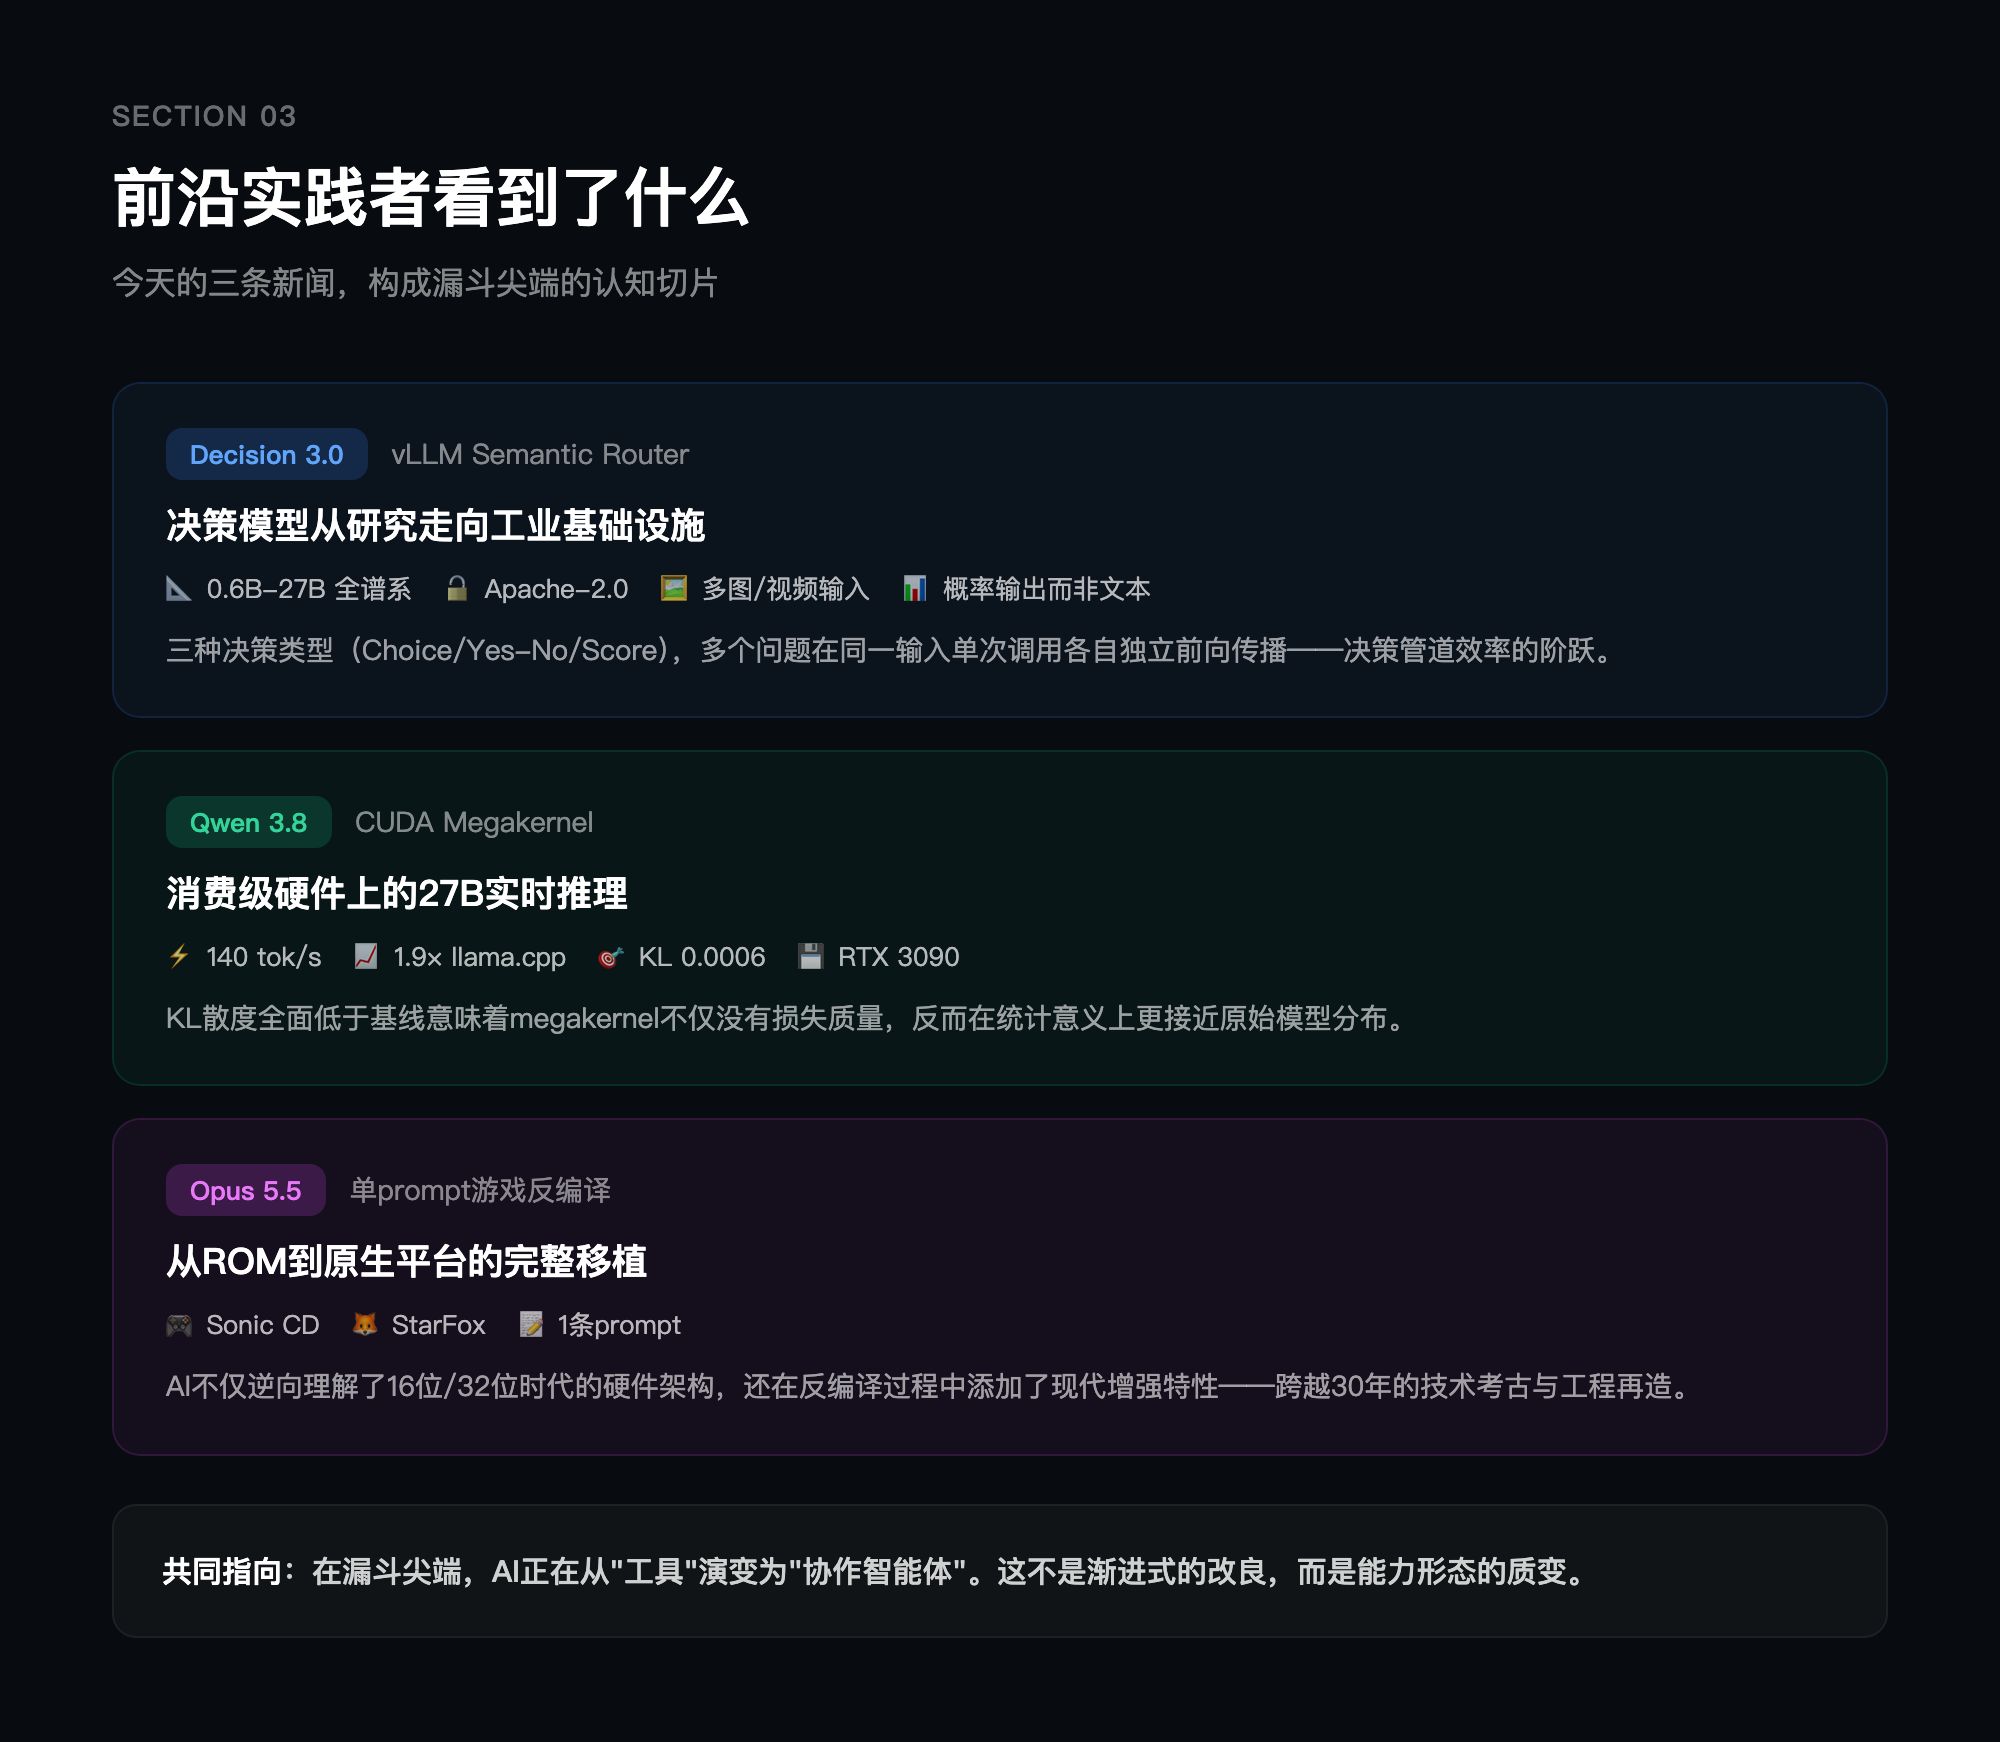
Decision 3.0 --- vLLM Semantic Router团队发布了覆盖0.6B到27B全参数尺度的决策模型族,Apache-2.0许可。每种决策类型(多选/二元/评分)都以概率形式输出而非文本生成,多个问题在同一输入上单次调用各自独立前向传播。这标志着决策模型从"零散研究"走向"工业化基础设施"。
Qwen 3.8单卡140 tok/s --- CUDA megakernel引擎让27B参数模型在单张RTX 3090上达到了140 tok/s的交互式推理速度,是llama.cpp的1.9倍,且KL散度全面低于基线。这意味着27B模型的实时推理在消费级硬件上已成为现实。
Opus 5.5反编译 --- 前述的游戏移植项目证明:前沿LLM不仅"能写代码",更展示了对底层硬件架构、编译原理和图形管线的系统性理解。
这三件事的共同指向:在漏斗尖端,AI正在从"工具"演变为"协作智能体"。
四、结构性困境:分化如何自我强化
Karpathy的漏斗不是一个静态快照------它正在加速扩大。
三个正反馈回路
-
能力正反馈:专业层用户利用AI创造更多价值 → 获得更高收入和更好访问权限 → 利用更强大AI创造更大价值。这个过程呈指数级加速。
-
数据正反馈:专业层与AI的高质量对话产生优质训练数据 → 下一代模型更擅长专业交互 → 专业层的能力优势进一步放大。
-
叙事正反馈:专业层对AI的深刻理解无法有效传递给其他层 → 公众舆论继续在"AI万能vs AI无用"两极间震荡 → 政策制定缺乏共识 → 改革停滞。
开源的悖论
理论上,开源(Decision 3.0的Apache-2.0许可、Qwen 3.8的开放权重)应该缩小漏斗。但实际上,发现和使用开源工具本身就需要专业知识------这是另一种形式的准入壁垒。
更尖锐的矛盾来自Bitwarden的双许可事件:应用商店版本改用商业许可构建,GPLv3版本继续在GitHub更新------社区敏锐地指出了"current"一词的言外之意:未来功能将仅在商业版本发布。开源正在从"默认状态"变成"降级选项"。
五、破局之道:每个人可以做什么
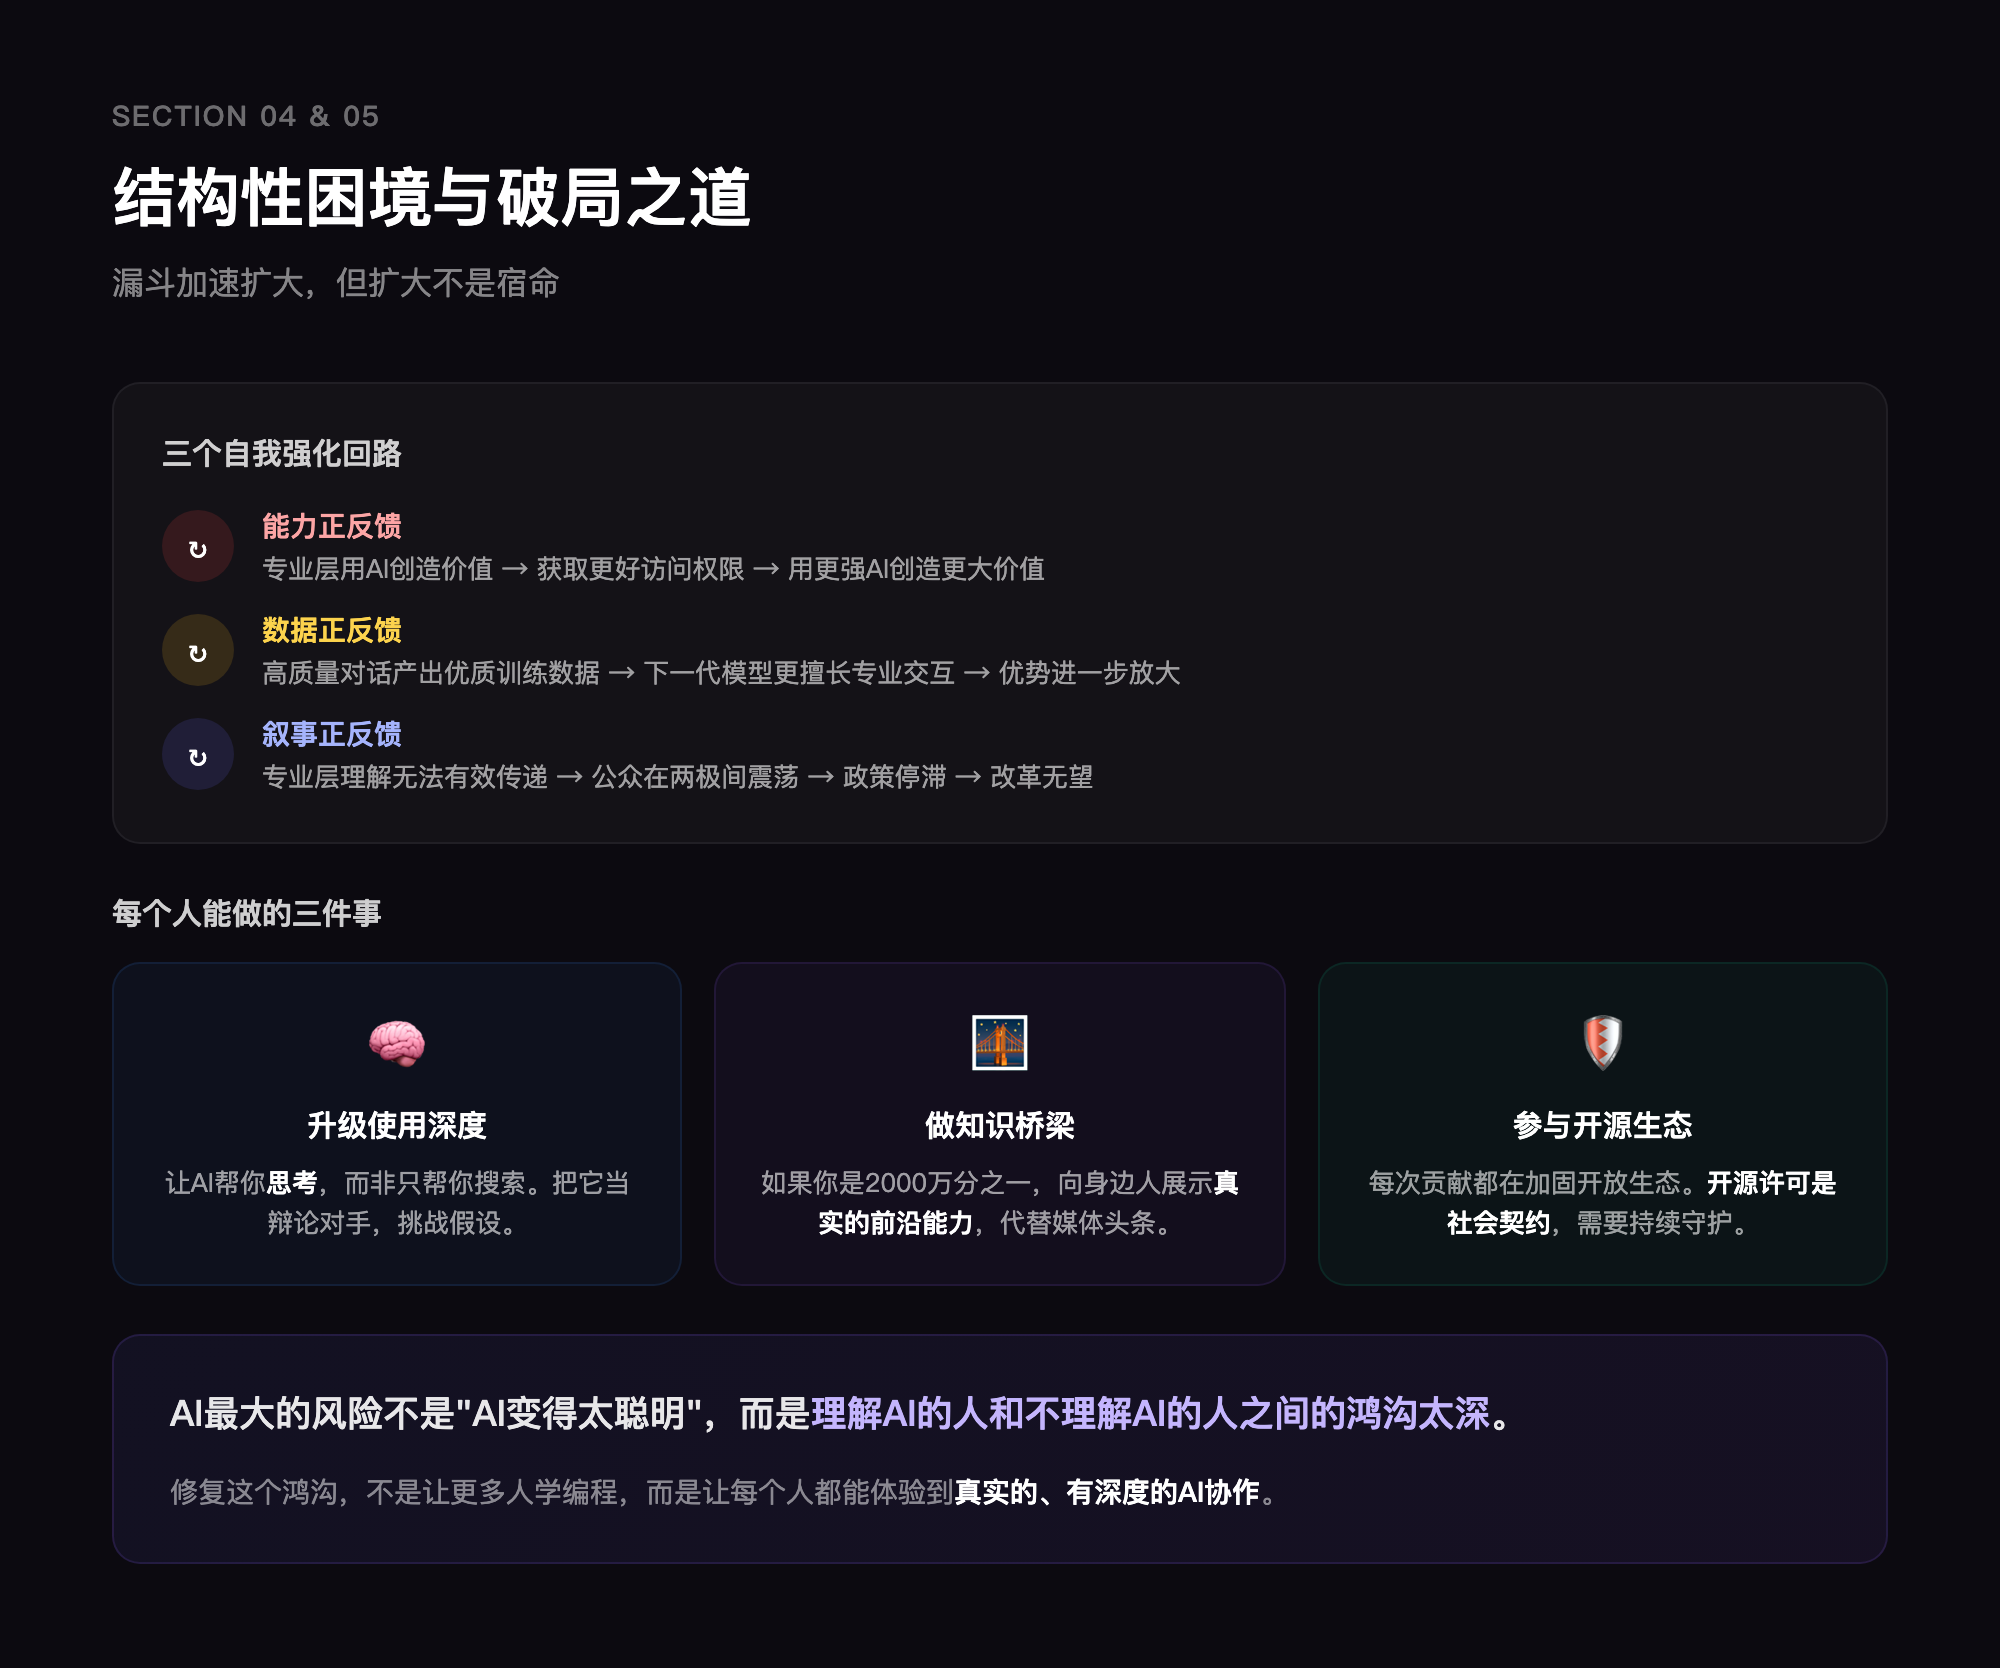
虽然我们无法让60亿人立刻成为AI专家,但有三件事是每个人都有能力做的:
1. 升级使用深度------从搜索引擎到思维伙伴
不要只是用AI回答问题,而是让AI帮你思考:
- 把它当作一个随时在线的辩论对手,用它来挑战你的假设
- 用它来翻译复杂论文的核心论点,而非只是摘要
- 让它解释代码的"为什么",而非只是"怎么写"
2. 传播正确认知------做漏斗中间的"翻译者"
如果你是第三层的2000万分之一,你就是最珍贵的知识桥梁:
- 向身边人展示真实的前沿能力,而非媒体头条中的极端案例
- 帮助他人区分"AI不能什么"(锯齿的谷底)和"AI能什么"(锯齿的峰顶)
- 用具体案例代替抽象争论
3. 参与开源生态------守住开放的最后防线
每一次对开源项目的贡献(代码、文档、反馈)都在加固开放生态的根基。Bitwarden事件提醒我们:开源许可不是一劳永逸的终身契约,而是需要持续守护的社会共识。
结语
Karpathy的漏斗不是预言,而是诊断。它告诉我们:AI最大的风险不是"AI变得太聪明",而是**"理解AI的人和不理解AI的人之间的鸿沟太深"**。
当60%的人口对AI的理解停留在"一个更好的搜索引擎",而0.00006%的人口正在指挥AI swarm完成复杂的工程壮举时,社会的几乎所有对话------监管、教育、就业、伦理------都像是不同频道的广播,永远无法真正交锋。
修复这个鸿沟,不是让更多人去学编程(虽然那也有帮助),而是让每个人都能体验到真实的、有深度的AI协作。唯有当AI不再是一个抽象的争论对象,而是一个具体的协作伙伴时,人类才能就AI的未来展开真正的对话。
漏斗正在扩大。但扩大不是宿命,而是行动的号角。