为什么传统规则管理在工程上不可持续?
规则频繁变更(如信贷政策周更、反洗钱阈值动态调整)与代码发布周期严重错配,迫使业务将逻辑退化至 Excel ------ 这不是偏好,而是工程能力缺失下的权宜之计。其技术后果明确且可验证:
- 多系统重复实现同类判断:同一客户在 CRM 判为高风险,在支付系统却自动放行,根源是规则未统一纳管,各系统各自解析原始数据;
- 人工取数+手工计算成常态:征信 API 返回 JSON、交易库含时序字段、设备日志为文本流,跨源拼接依赖人工导出+Excel 公式,错误定位成本高;
- 黑盒结果缺乏可解释性与可追溯性 :审计要求复现'为何拒贷',系统只能返回
IF(AND(A42>65,B42<550),"拒绝","通过"),无法关联原始数据源、加工路径与执行节点。
本质是能力割裂:数据在 DB,逻辑在 Java,判断在 Excel,审批在线下。当合规要求'可解释、可追溯、可审计'成为刚性约束,规则必须升维为可配置、可测试、可服务的数字资产------而非临时补丁。
主流方案的技术断层在哪?
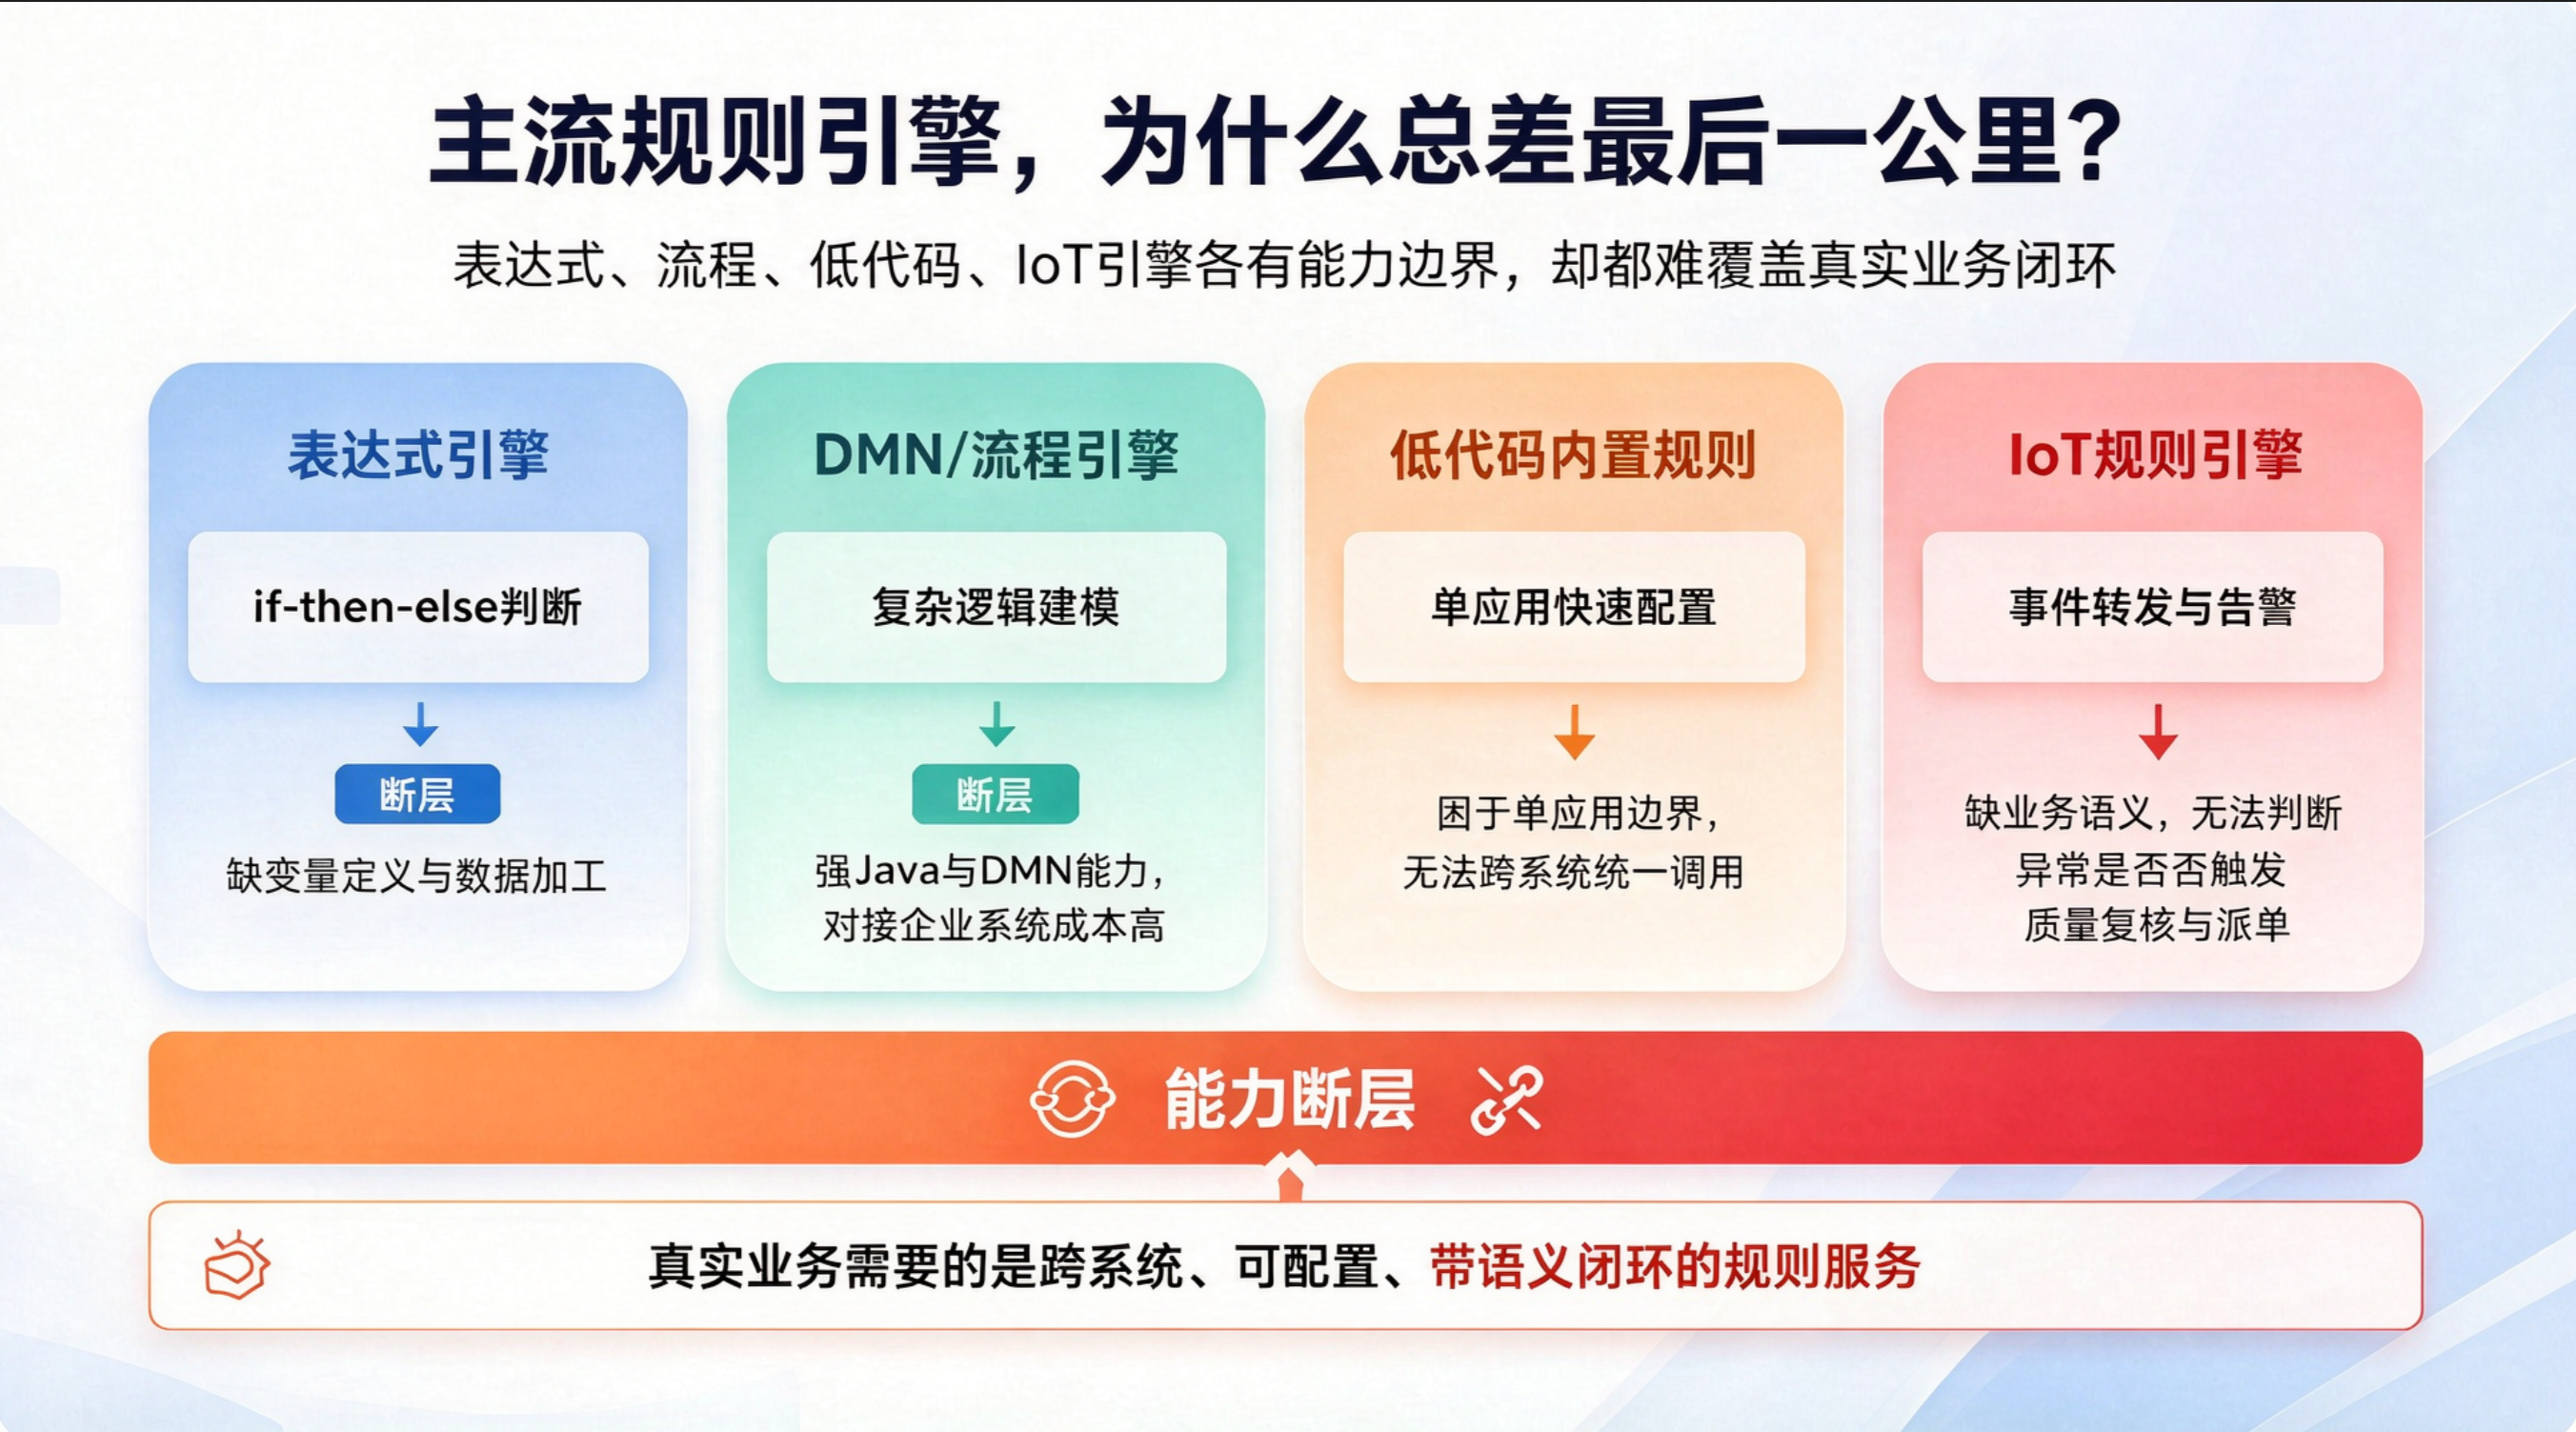
当前规则引擎普遍存在能力断层,无法支撑端到端业务闭环:
- 表达式引擎(如 Jess、OpenL) :仅支持
if-then-else判断,但缺失变量定义与数据加工能力 ------它假设输入已是清洗后的标准字段,而现实中risk_score需聚合征信 API JSON、负债表 SQL 结果、设备日志正则提取值三源数据; - 技术型引擎(如 Drools、Camunda DMN) :虽支持复杂逻辑,但强依赖 Java 开发与 DMN 建模能力,部署后仍需大量二次开发对接企业现有数据库连接池、RBAC 权限体系与消息总线;
- 低代码平台内置规则 :困于单应用边界,无法跨 ERP、MES、风控系统统一注册、发布与调用;
- 云厂商 IoT 规则引擎 :擅长事件转发(如 MQTT 消息触发 HTTP 请求),但缺乏业务语义建模能力------能响应'温度>80℃',但无法表达'该异常是否触发三级质量复核并自动派单至 MES 工单系统'。
共性短板:只解决'怎么判'(逻辑执行),回避'判什么'(变量定义与加工)和'凭什么判'(数据溯源与策略上下文)。真正的规则中枢必须贯通全链路:
- 数据接入(API/DB/日志)
- 变量治理(原子提取 + 复合计算)
- 逻辑判断(决策表/树/评分卡)
- 决策执行(服务调用 + 流程路由)
- 结果追溯(全链路执行日志 + 原始数据快照)
JVS-Rules 双引擎架构:变量加工 + 策略编排
JVS-Rules 不替代开发,而是提供开箱即用的规则基础设施层,技术栈透明、扩展可控。核心由两个可编程引擎驱动:
1. 变量加工引擎:从原始数据到业务语义
变量是规则的'输入契约',JVS-Rules 支持声明式定义,无需预埋字段或修改上游系统:
-
基础变量 :原子化解析原始数据。例如调用央行征信 API(返回 JSON)后,用
jsonPath("$.creditScore")提取为标准化单值credit_score; -
复合变量 :聚合多源变量生成业务指标。例如将
credit_score、monthly_income、device_uptime_rate作为输入,通过 Groovy 函数动态计算risk_adjusted_score:groovydef score = credit_score * 0.4 + (monthly_income / 10000) * 0.3 + device_uptime_rate * 0.3 return Math.round(score * 100) / 100.0
所有变量支持版本管理、依赖图谱可视化及在线调试,确保加工逻辑可复现、可灰度。
2. 策略编排引擎:从布尔判断到端到端流程
规则不再止于 true/false 输出,而是按业务语义串联动作:
- 规则表达层:支持决策表(条件→动作映射)、决策树(逐层路径解释)、评分卡(权重加总定级),所有逻辑可视编辑、支持单元测试;
- 策略编排层 :将变量、规则节点、外部服务(HTTP/SOAP 调用、MQ 发布、DB 更新)按流程图编排。例如贷前筛查策略:
- STEP 1:调用黑名单 API → 若命中,直接跳转人工复核;
- STEP 2:若未命中,计算
debt_to_income_ratio(SQL 变量)与risk_adjusted_score(Groovy 变量); - STEP 3:组合判断
debt_to_income_ratio > 65 && risk_adjusted_score < 550→ 触发短信告警 + 创建工单 + 返回REJECT_WITH_REVIEW状态码; - STEP 4:所有分支最终统一输出结构化 JSON 响应,并写入审计日志表。
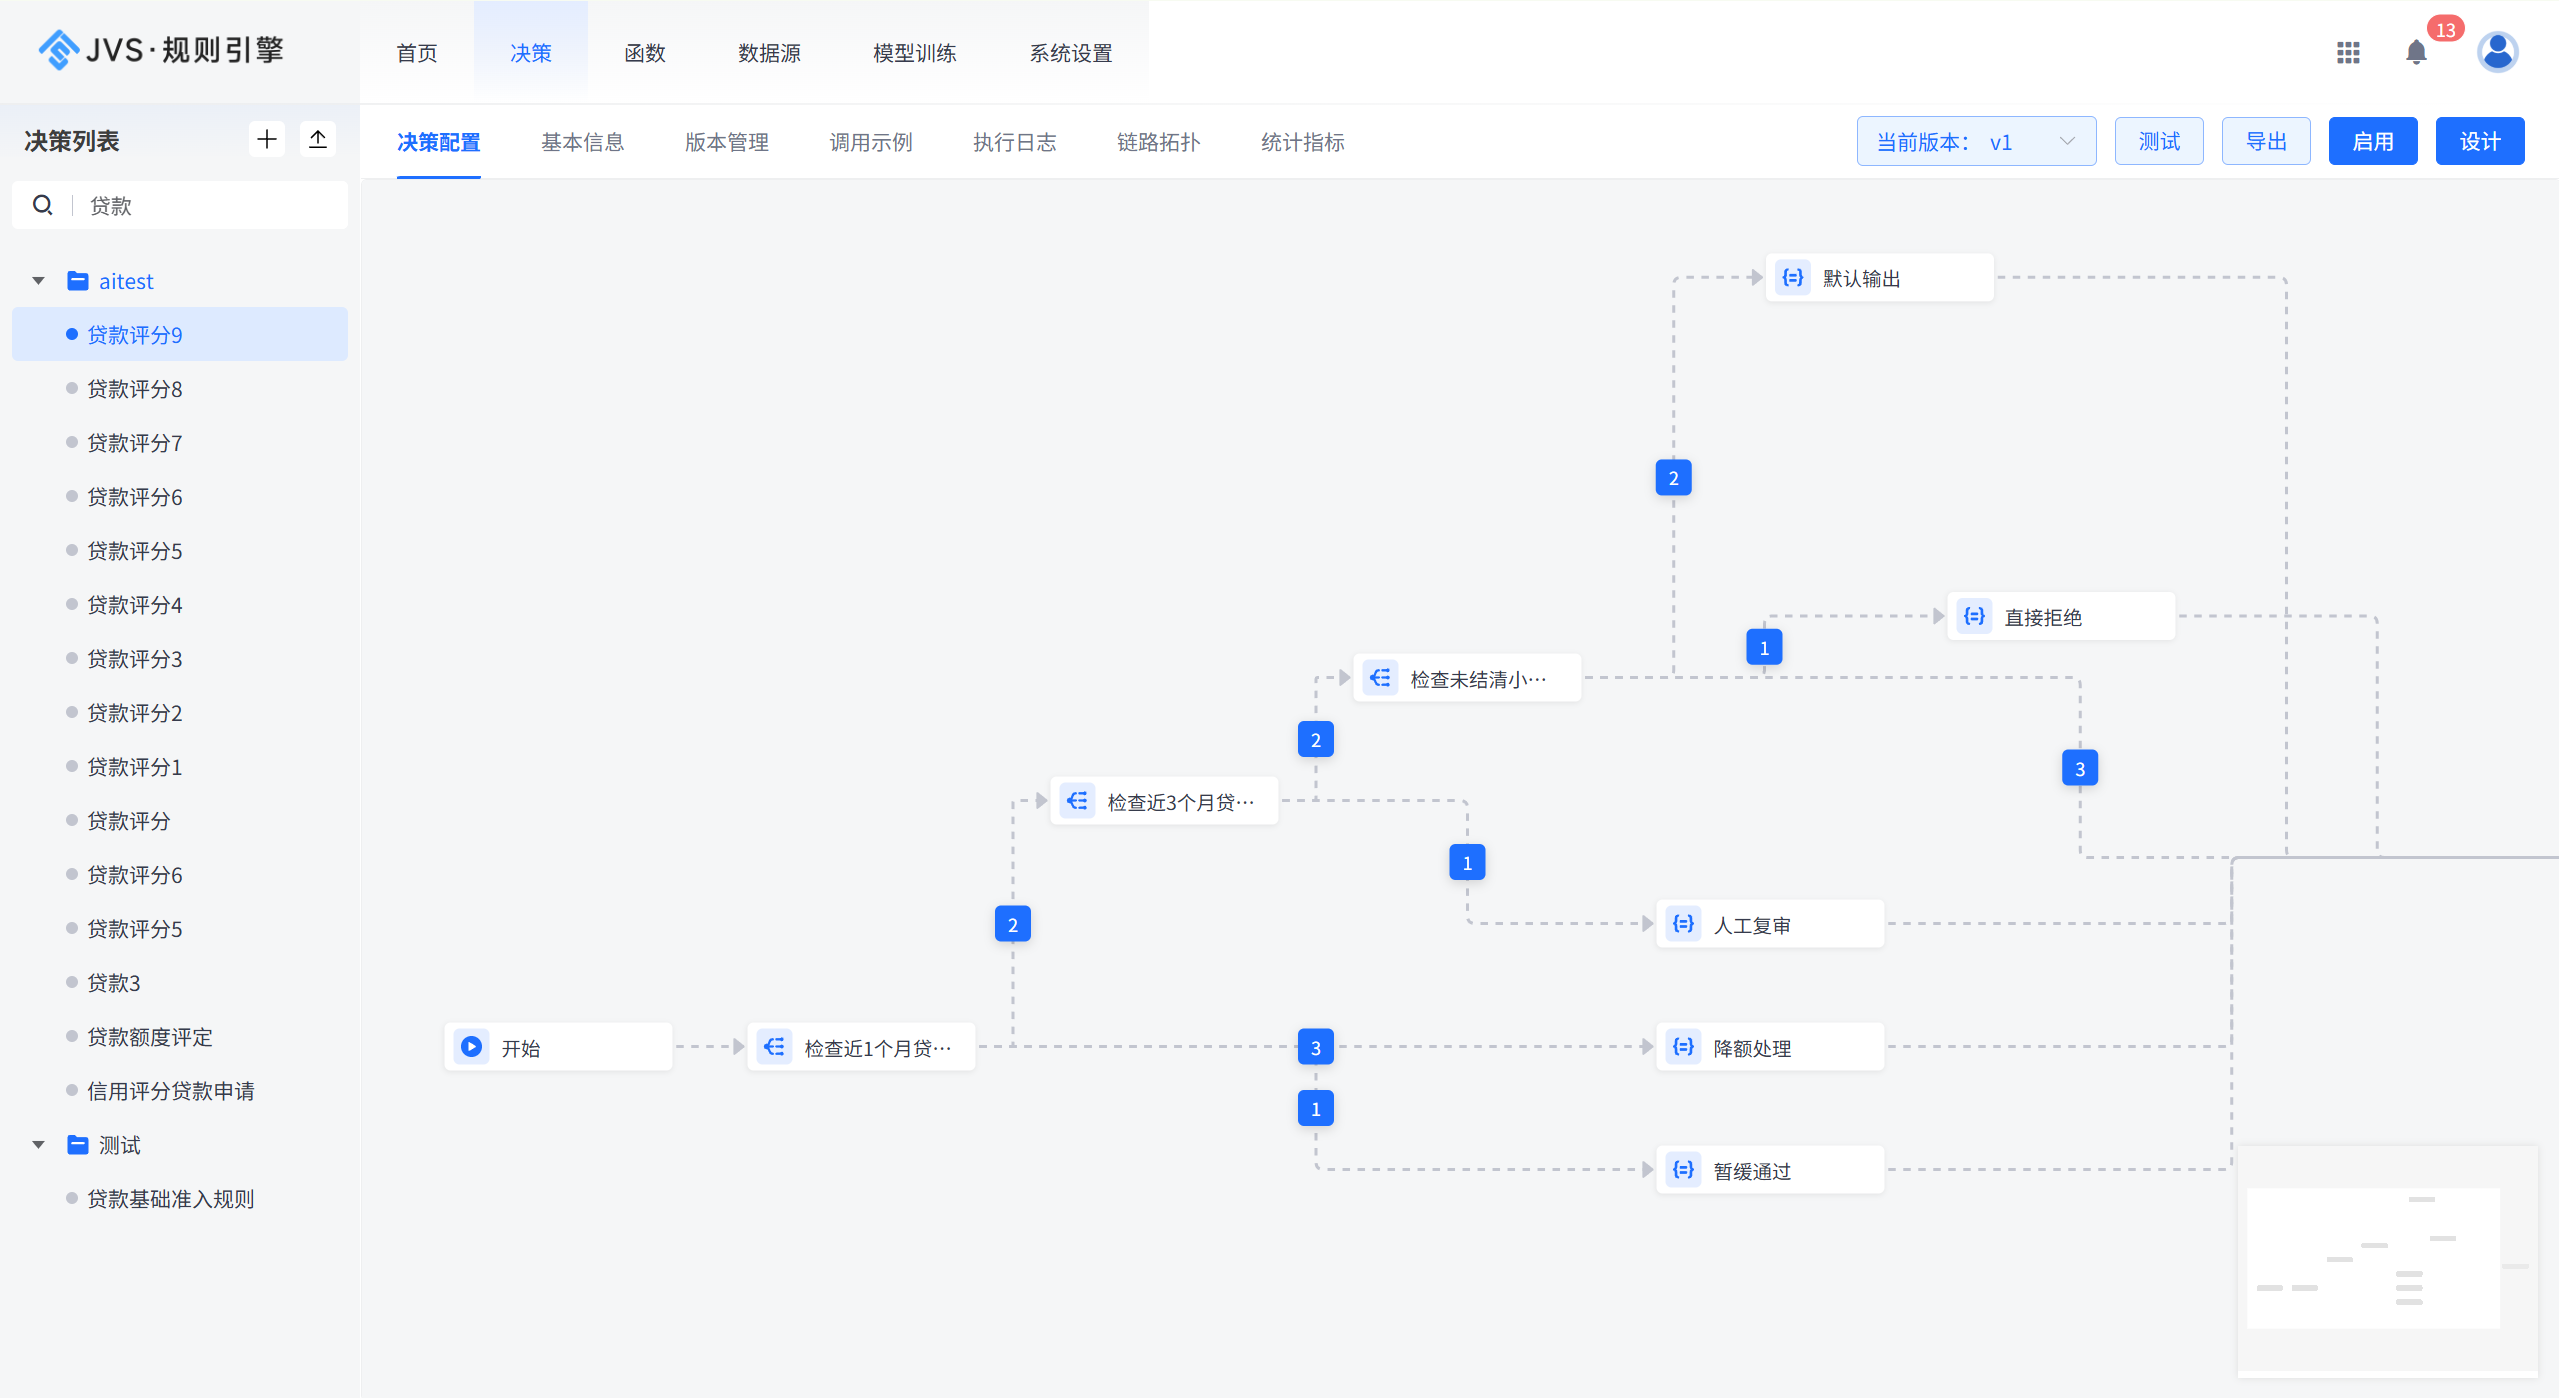
实战落地:银行贷前筛查四步闭环(附关键配置示意)
以真实场景验证技术可行性。整个流程无需 Java 开发,全部通过 JVS-Rules 控制台完成配置与发布。
步骤 1:统一纳管多源数据
- 配置数据源:MySQL(核心系统负债表)、HTTP(央行征信 API)、Kafka(设备日志 Topic);
- 为每个源定义连接池参数、超时策略与失败重试机制。
步骤 2:变量加工(SQL + Groovy 示例)
-
定义 SQL 变量
debt_to_income_ratio:sqlSELECT ROUND(SUM(debt_amount) / :monthly_income * 100, 2) FROM liability_table WHERE customer_id = :customer_id -
定义 Groovy 变量
risk_adjusted_score(输入credit_score,monthly_income,device_uptime_rate):见上文代码块。
步骤 3:策略编排(DSL 关键片段)
yaml
flow: loan-screening-v1
steps:
  - id: check_blacklist
    type: http
    config: { url: "https://api.blacklist/check", method: POST }
    next: ["reject_immediately", "compute_ratio"]
  - id: compute_ratio
    type: sql
    config: { variable: "debt_to_income_ratio" }
    next: ["score_decision"]
  - id: score_decision
    type: rule
    config: { decisionTableId: "dt_loan_risk_v2" }
    next: ["route_by_type"]
  - id: route_by_type
    type: switch
    cases:
      - when: "customerType == 'VIP'" → action: "approve_direct"
      - when: "risk_adjusted_score < 550 && debt_to_income_ratio > 65" → action: ["send_sms_alert", "create_workorder"]
步骤 4:服务化输出与审计追踪
- 发布 REST API
/loan-screening,自动生成 OpenAPI 3.0 文档; - 每次调用自动记录执行链路:
[blacklist=HIT] → [debt_to_income_ratio=68.2] → [risk_adjusted_score=512.4] → [trigger: send_sms_alert + create_workorder]; - 所有日志含 traceId、原始请求体、各变量计算快照、规则匹配路径,满足等保三级与银保监审计要求。
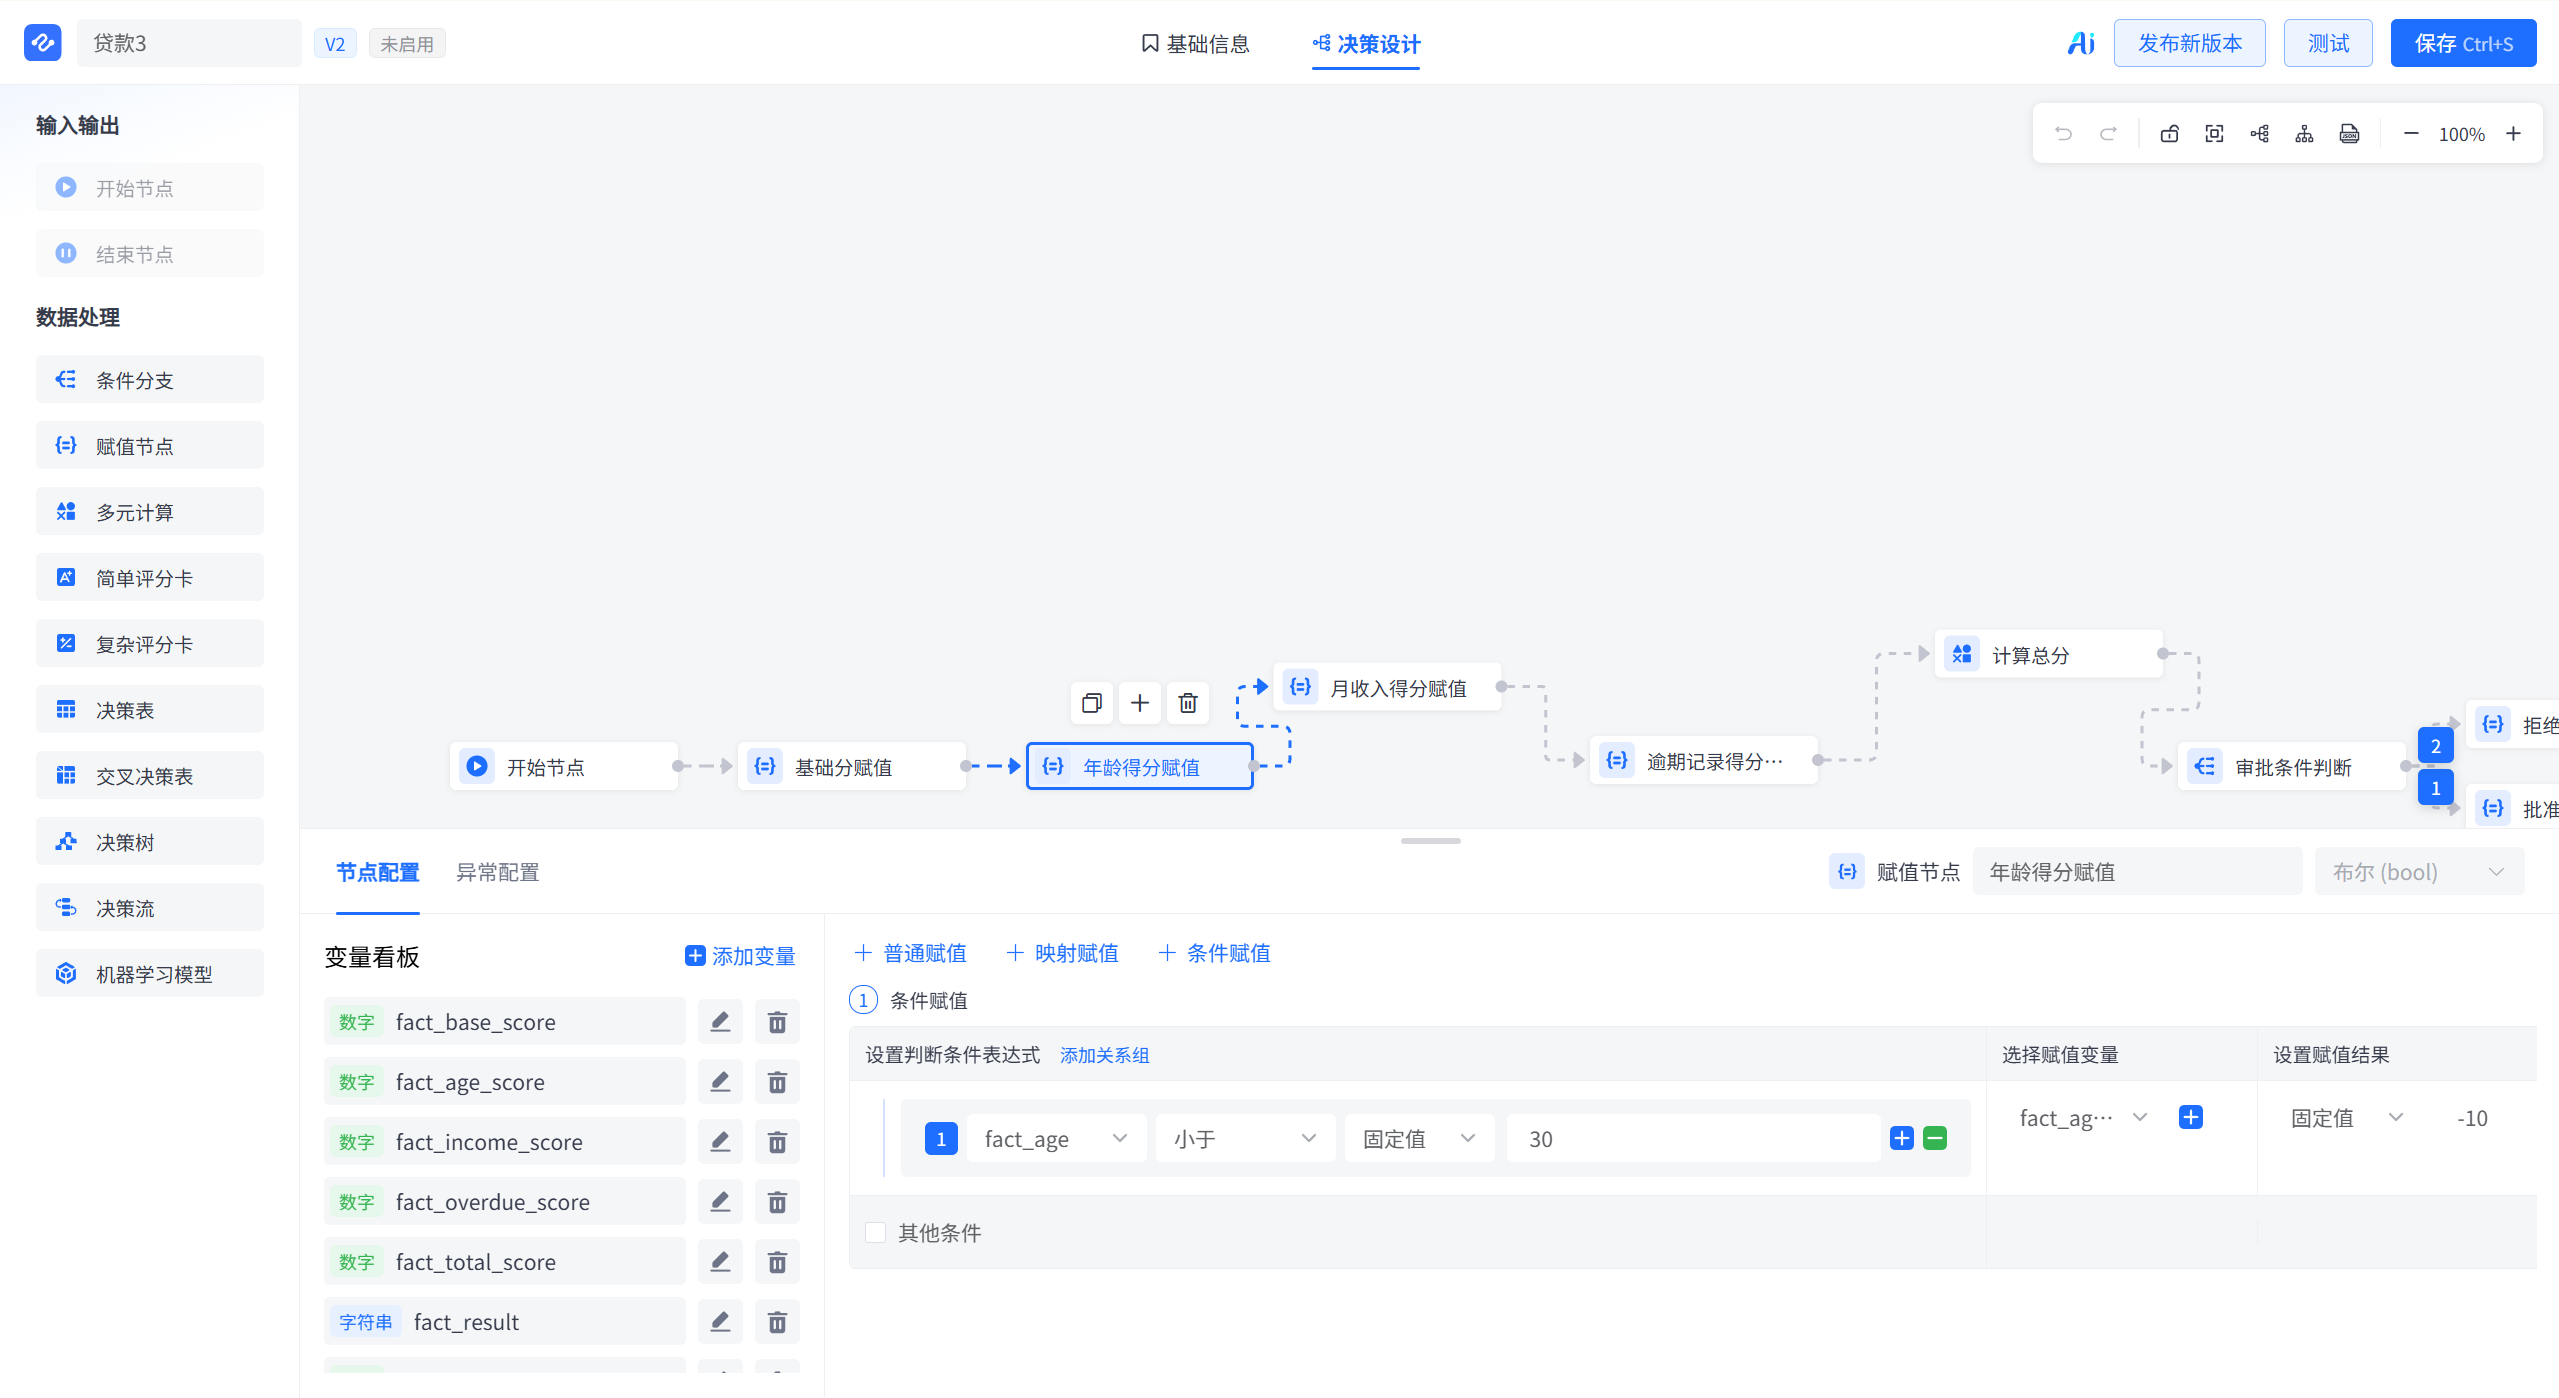
效果可量化:规则迭代周期从 3 周(需求→开发→测试→上线)压缩至业务人员 2 小时内完成配置→在线测试→灰度发布;全链路口径一致性保障信贷系统、手机银行 APP、反欺诈平台调用同一语义化接口,彻底消除'同客不同判'。
结语:规则中枢的本质是工程范式升级
JVS-Rules 的价值不在取代开发,而在重构规则交付的工程链路:
- 变量加工引擎,把 ETL 逻辑从脚本/调度任务中解耦,变为规则系统的标准输入能力;
- 策略编排引擎,把状态机/流程引擎从应用代码中抽离,变为可复用、可编排的决策服务;
- 二者结合,让规则真正成为可配置(业务侧)、可测试(QA 侧)、可服务(研发侧)、可审计(合规侧) 的第一类数字资产。
对于正在推进规则中心化建设的团队,建议从一个高频、高价值、跨系统场景切入(如贷前筛查、质检复核),用变量定义 → 加工验证 → 规则建模 → 策略串联 → 接口发布五步法快速验证闭环能力。