23 种语言随手切,5 秒参考音频就能换个嗓门,全程不联网,也不用敲一行命令。
Resemble AI 的 Chatterbox 是开源 TTS 里名声挺响的一支:MIT 协议、0.5B 参数、自带声音克隆。这轮更新把多语言 V3 推成了官方默认推荐版本,人声相似度比前两代更稳,跑题、重复这类幻觉也少了。同一个声音,换哪国语言都不串味。
想拿它给视频配多语旁白的人,多半卡在两件事上:模型难装,参数难调。下面这几块讲清楚它能干什么,最后给你一条不用碰命令行的路。
🌍 23 种语言,就是表单里点一下
中文写好稿,切成日语、法语、斯瓦希里语出旁白,语言就是个下拉框的事。上游 README 的 Supported Languages 列了 23 个语言代码,覆盖中、英、日、韩、法、德、西、意、俄、阿、印地等常用语种,V3 旁边标着「官方推荐」。听声音比读参数直观,HuggingFace 上有现成的在线试听,23 种语言随便点。
🎤 换个嗓门,再把情绪拧到顺耳
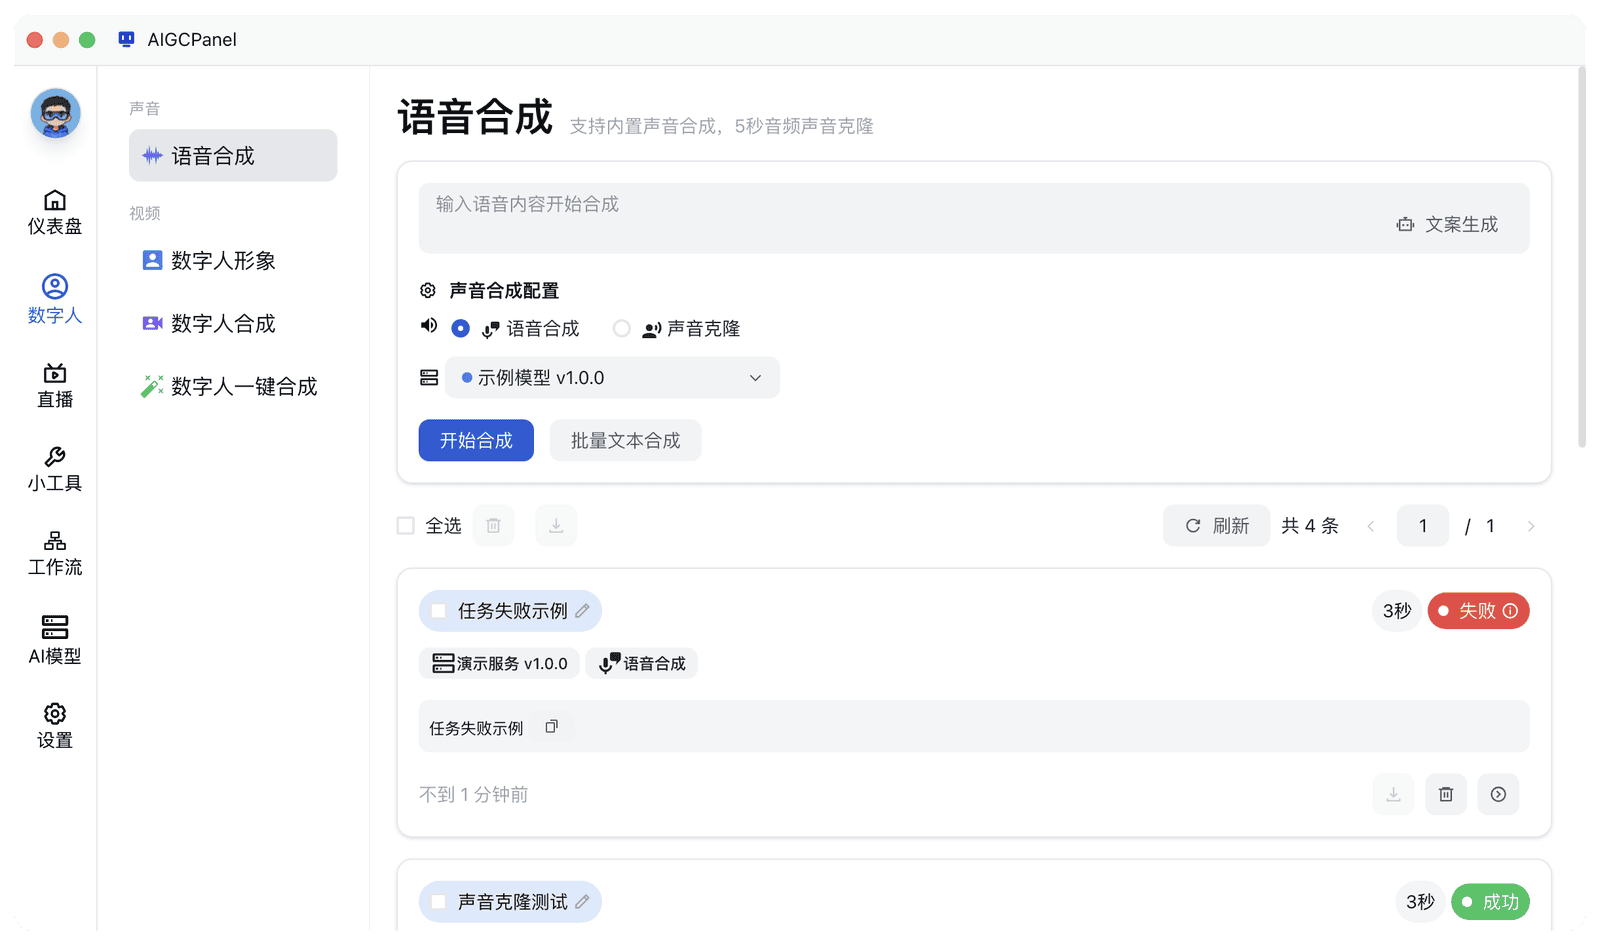
声音克隆只要一段 5~10 秒的清晰人声。模型先把这段音频读一遍、记住音色,之后每句话都用这个音色来说,还能换语言。编码一次全篇复用,所以下一句和上一句不会突然变了个人。
音色定下来之后,四根滑杆管听感:情感强度拧到 0.7 以上,情绪明显外放;参考音色语速偏快,引导强度降到 0.3 就跟得上。剩下的采样温度管发挥稳不稳,重复惩罚管会不会啰嗦,随机种子管下次能不能复现同一段音频。默认值已经能出可用的成品,不满意再动滑杆。
0.5B 的参数量不算大,但「说得像谁」这件事,它交得挺稳。
💻 三步跑起来,全程碰不到命令行
- 装好 AIGCPanel,把 Chatterbox Multilingual 语音合成的一键运行包解压导入;
- 打开语音合成页,选语言、填文本;要换音色就切到声音克隆,传一段参考人声;
- 点开始合成,跑完直接在任务列表里试听。
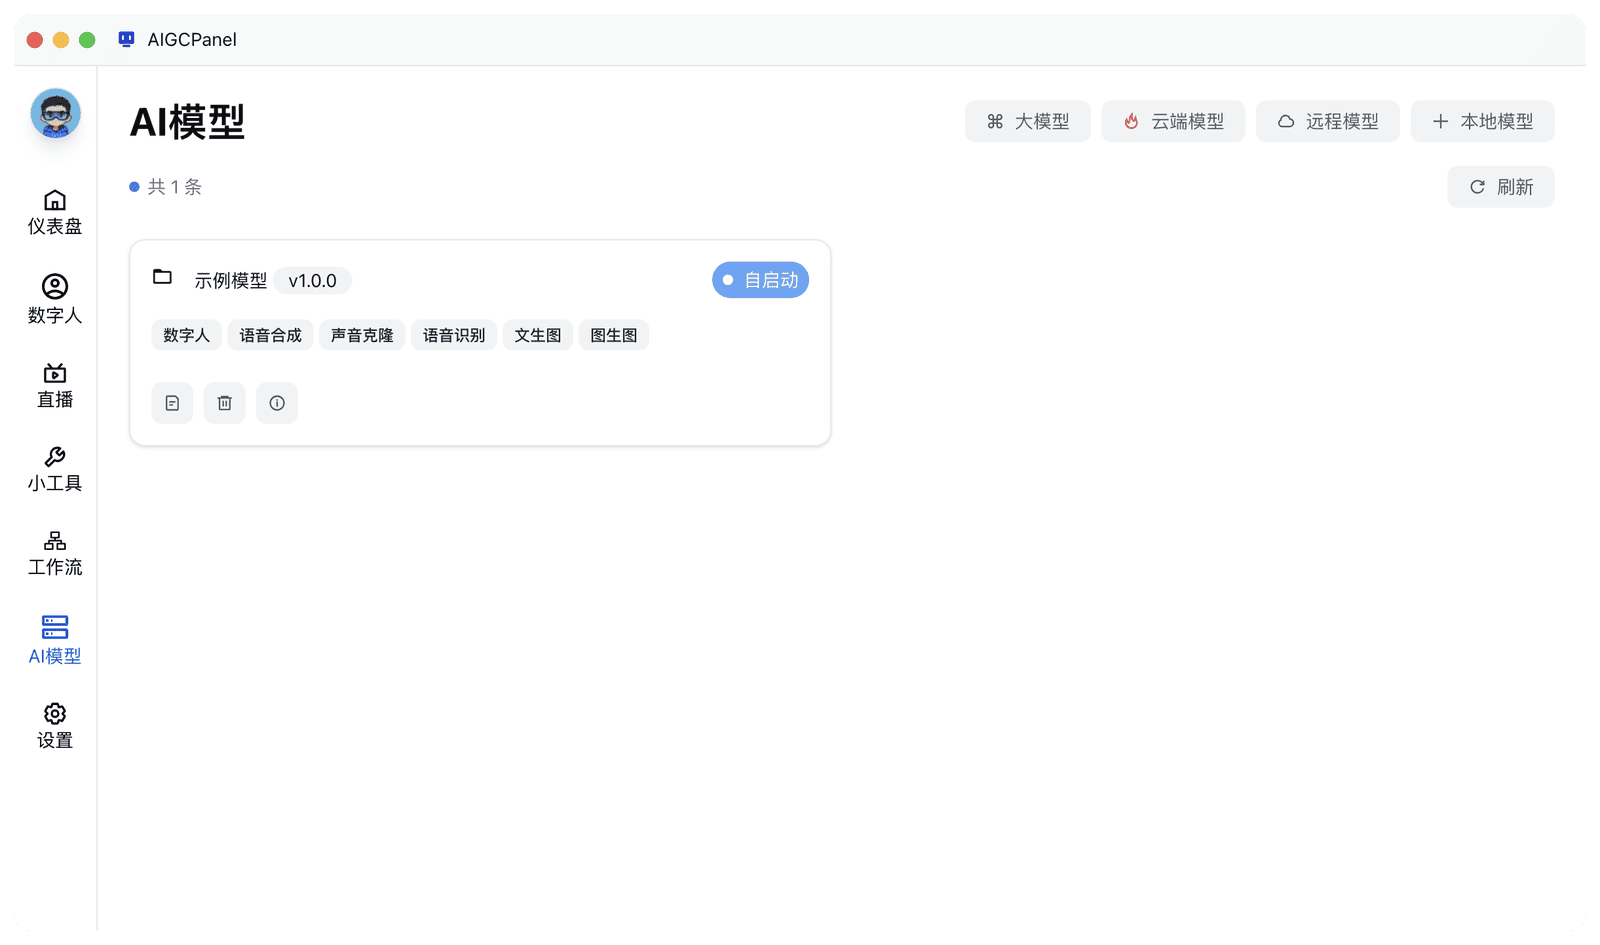
设备会按 CUDA → MPS → CPU 自动降级,用的是哪一块日志里写得清楚。模型只取 V3 推理要用的 6 个文件,运行时完全离线,不联网也照跑。服务标注「GPU 4G+(推荐 8G+),内存 8G+」,显卡机器上五分钟内出声,纯 CPU 也能跑,只是要多等一会儿。想看源码的话,上游仓库在这里。
还有几个细节
- 长稿不会崩。正文超过一句会自动切段,逐句生成后在句间垫 0.1 秒静音,拼出来没有那种硬接的顿挫。
- 没参考音频也能出声。模型自带一套默认音色,直接填字就能合成,想换人再上克隆。
- 输出是 WAV,声音里带 PerTh 隐形水印,压成 MP3 也能检出来源,用来做版权溯源。
- 同门兄弟还有两个:英文的 Turbo(350M,主打低延迟)和 Nano(110M,CPU 上跑得动),多语言场合用 V3。
其他细节
- 随机种子可固定,同一组参数下次还你同一条音频。
- 任务来了自动拉起服务,跑完空闲自动退出,不占着显卡不放。
有显卡的机器上,从解压到听见第一句话,五分钟够了。不用配环境、不用调参数,剩下的只有试哪句话、试哪个声音。 你最想让它用哪种语言开口?评论区聊聊。