把一份 Excel 拆成多份更小的文件,是日常数据处理里非常常见的需求。比如把含有多张工作表的总表,按工作表拆成每人一份的文档;或者把一张长表按固定行数切块,方便分批交付;又或者把若干列单独抽出来做成独立文件。这些"拆文件"的动作如果用鼠标一个一个点,既慢又容易漏。本文介绍如何用 Spire.XLS for Python 把一份 Excel 文件,按工作表、按行、按列、按单元格区域,分别拆分成多个独立的文件。
为什么需要拆分文件
- 分发给不同对象:一张总表按工作表或按部门列拆开,每份只含相关内容,避免把无关数据一并发出去。
- 分批处理与归档:几千行的数据按固定行数切块,既方便逐段核对,也便于按时间或编号归档。
- 按需抽取维度:把某些关键列单独导出,作为后续分析的输入,而不必总是带着整张宽表。
- 降低单文件体量:超大工作簿拆成几个小文件后,打开、传输、再处理都更轻快。
与在界面里反复复制粘贴不同,用代码拆分的"拆几块、按什么拆"都变成了参数,跑一次就能稳定产出多份结果。
环境准备
本文使用 Spire.XLS for Python 来读写和拆分 Excel。它在 Workbook 上提供了工作表集合与复制能力,在 Worksheet 上提供了行、列、区域的复制方法,足以支撑下面的各类拆分。通过以下命令安装:
bash
pip install Spire.XLS安装完成后,在脚本中导入所需模块即可使用。
按工作表拆分
当一份工作簿里包含多张工作表时,最直接的需求往往是"每张表导出成一个独立文件"。做法是为源工作簿里的每一张表,新建一个工作簿、把这张表整体复制进去,再分别保存。Worksheets.AddCopy(sheet, WorksheetCopyType.CopyAll) 可以把整张表(含数据、样式、公式)复制进新工作簿,复制前先用 Worksheets.Clear() 清掉新工作簿自带的那张空白表即可。
python
from spire.xls import *
from spire.xls.common import *
import os

inputFile = "./示例文档.xlsx"
outputDir = "./按表拆分/"

if not os.path.exists(outputDir):
    os.makedirs(outputDir)

src = Workbook()
src.LoadFromFile(inputFile)

for idx, sheet in enumerate(src.Worksheets):
    newbook = Workbook()
    newbook.Worksheets.Clear()
    newbook.Worksheets.AddCopy(sheet, WorksheetCopyType.CopyAll)
    newbook.SaveToFile(os.path.join(outputDir, f"part_{idx+1}.xlsx"), ExcelVersion.Version2013)
    newbook.Dispose()

src.Dispose()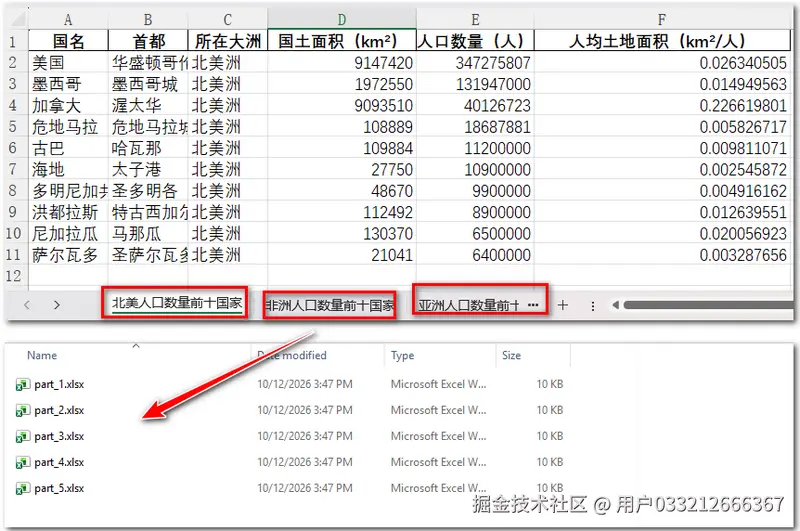
这里 for idx, sheet in enumerate(src.Worksheets) 直接遍历源工作簿里的所有工作表,无需关心表的总数量。Worksheets.Clear() 会移除新工作簿默认创建的那张空表,随后 AddCopy(sheet, WorksheetCopyType.CopyAll) 把当前表原样塞进新工作簿。每处理完一张就 SaveToFile 存成一个文件,并以 part_序号 命名,最后别忘了 Dispose() 释放资源。
按列拆分
有时一份表很宽,你只想把其中某一列或某几列单独拿出来做文件。Worksheet.Copy() 接受"源列"与"目标列"两个位置,再加上三个开关(是否复制样式、值、公式),就能把指定列搬到一个新工作簿的对应列上。下面演示把前若干列逐列拆成独立文件:
python
from spire.xls import *
from spire.xls.common import *
import os

inputFile = "/示例文档.xlsx"
outputDir = "/按列拆分/"

src = Workbook()
src.LoadFromFile(inputFile)
sheet = src.Worksheets[0]

# 获取源表的实际最大行数,确保数据范围完整
last_row = sheet.LastRow

# 假设要把前 3 列分别导出
for c in range(3):
    newbook = Workbook()
    ns = newbook.Worksheets[0]

    # 【核心修改】通过具体单元格区域(列范围)进行精准复制
    source_range = sheet.Range[1, c + 1, last_row, c + 1]
    dest_range = ns.Range[1, 1]
    source_range.Copy(dest_range, True)

    newbook.SaveToFile(os.path.join(outputDir, f"col_{c+1}.xlsx"), ExcelVersion.Version2013)
    newbook.Dispose()

src.Dispose()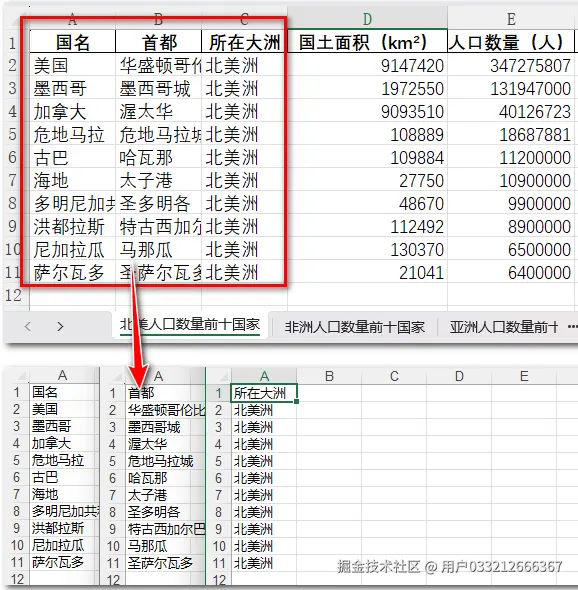
sheet.Range[1, c + 1, last_row, c + 1] 锁定了当前需要导出的具体列范围,并通过 source_range.Copy(dest_range, True) 精准复制到新工作表的首列位置,同时完整保留样式与数据。把循环中的 range(3) 改为对应列数,或换成你关心的具体列索引列表,即可灵活实现任意列的独立拆分。
按行拆分
与按列对应的,是按行切块------最常见的是"每 N 行生成一个文件"。思路是每次取一段连续的行,在新工作簿里从首行开始逐行复制。行的复制同样用 Worksheet.Copy(),只是这次源和目标都是"行"对象。
python
from spire.xls import *
from spire.xls.common import *
import os

inputFile = "E:/Administrator/Python/input/世界各洲人口前十国家.xlsx"
outputDir = "E:/Administrator/Python/output/按行拆分/"

src = Workbook()
src.LoadFromFile(inputFile)
sheet = src.Worksheets[0]
last_col = sheet.LastColumn

# 导出前 4 行
book_top = Workbook()
ns_top = book_top.Worksheets[0]
sheet.Range[1, 1, 4, last_col].Copy(ns_top.Range["A1"], True)
book_top.SaveToFile(os.path.join(outputDir, "前4行.xlsx"), ExcelVersion.Version2013)
book_top.Dispose()

# 倒数第 7 行即从 (总行数 - 6) 到 总行数
total_rows = sheet.LastRow
start_row = total_rows - 6

book_bottom = Workbook()
ns_bottom = book_bottom.Worksheets[0]
sheet.Range[start_row, 1, total_rows, last_col].Copy(ns_bottom.Range["A1"], True)
book_bottom.SaveToFile(os.path.join(outputDir, "后7行.xlsx"), ExcelVersion.Version2013)
book_bottom.Dispose()

src.Dispose()
通过 sheet.Range[1, 1, 4, last_col] 与 sheet.Range[start_row, 1, total_rows, last_col] 能够直接截取并锁定特定的行矩阵区域(如前 4 行与最后 7 行)。借助 sheet.LastRow 动态定位总行数并计算出末尾切片坐标,无需复杂的循环逻辑,即可高效、精准地将特定行数据块分别导出为独立文件。
按单元格区域拆分
如果想导出的不是整行整列,而是某个矩形区域(例如指定的局部数据块),可以直接指定源区域与目标区域进行局部截取。下面我们将 A2:F5 这一块局部区域复制到新工作簿的首位置。
python
from spire.xls import *
from spire.xls.common import *
import os

inputFile = "示例文档.xlsx"
outputFile = "/局部区域拆分.xlsx"

src = Workbook()
src.LoadFromFile(inputFile)
sheet = src.Worksheets[0]

newbook = Workbook()
ns = newbook.Worksheets[0]

# 指定你想要的源数据局部区域,比如只取 A2 到 F5
source_range = sheet.Range["A2:F5"]

# 指定新表中存放的目标起始位置
dest_range = ns.Range["A1"]

# 复制目标区域
source_range.Copy(dest_range, True)

newbook.SaveToFile(outputFile, ExcelVersion.Version2013)
newbook.Dispose()
src.Dispose()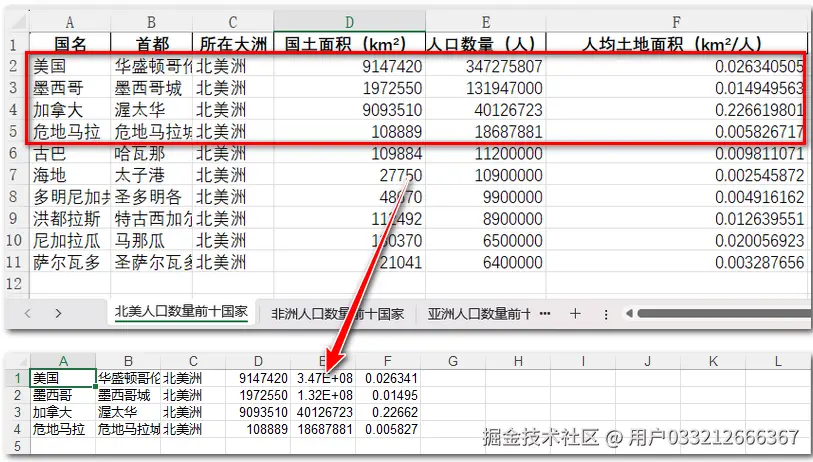
sheet.Range["A2:F5"] 定义了你需要截取的源矩形区域,而 ns.Range["A1"] 指定了新表中的粘贴起始点。其中的 True 参数控制在复制时连同单元格样式、边框与背景色一并保留。需要拆分哪一块数据,只需灵活调整源区域的坐标地址(例如将 A2:F5 改为其他范围)即可,其余核心逻辑无需改动。
综合示例:先按工作表、再按行切块
把两种思路串起来,可以处理更复杂的场景------比如一份多工作表的工作簿,先把每张表拆成独立文件,再对其中较大的表按行切块。下面演示先按工作表拆分,再对第一张表做行级切分:
python
from spire.xls import *
from spire.xls.common import *
import os

inputFile = "./Demos/Data/SplitExcelCombined.xlsx"
outputDir = "./output_combined"

if not os.path.exists(outputDir):
    os.makedirs(outputDir)

src = Workbook()
src.LoadFromFile(inputFile)

# 第一步:每张工作表导出一个文件
for idx, sheet in enumerate(src.Worksheets):
    newbook = Workbook()
    newbook.Worksheets.Clear()
    newbook.Worksheets.AddCopy(sheet, WorksheetCopyType.CopyAll)
    newbook.SaveToFile(os.path.join(outputDir, f"part_{idx+1}.xlsx"), ExcelVersion.Version2013)
    newbook.Dispose()

# 第二步:对第一张表按每 50 行切块
sheet0 = src.Worksheets[0]
total = sheet0.LastRow
start = 0
part = 1
while start < total:
    end = min(start + 50, total)
    newbook = Workbook()
    ns = newbook.Worksheets[0]
    for r in range(start, end):
        ns.Copy(sheet0.Rows[r], ns.Rows[r - start], True, True, True)
    newbook.SaveToFile(os.path.join(outputDir, f"part1_rows_{part}.xlsx"), ExcelVersion.Version2013)
    newbook.Dispose()
    start = end
    part += 1

src.Dispose()
两段逻辑各自独立:前半段用 AddCopy 按表拆分,后半段用 Worksheet.Copy 按行切块。它们共用的只有"新建工作簿 → 复制 → 保存 → 释放"这一固定套路,因此很容易组合或按需取舍。
实用技巧
- 先建好输出目录 :拆分会一次性产生很多文件,用
os.makedirs(outputDir, exist_ok=True)提前把目录准备好,避免首轮就因路径不存在而报错(示例里用if not os.path.exists做了同样的事)。 - 及时 Dispose :每生成一个文件就用
Dispose()释放该工作簿,处理大量拆分时能有效控制内存占用。 - 复制开关要选对 :
Worksheet.Copy末尾的三个布尔值分别是"复制样式 / 值 / 公式"。只想保留数值就关掉样式与公式,想完整还原就三个都开。 - 行数边界用 LastRow :按行切块必须以
sheet.LastRow或已知行数为边界,既不会漏行,也不会对空白行误操作。 - 列数不确定时用 Columns.Count :按列拆分若想遍历全部列,把固定列数换成
sheet.Columns.Count即可,逻辑保持不变。
总结
本文介绍了使用 Python 和 Spire.XLS 拆分 Excel 文件的核心方法。通过"新建工作簿---复制内容---保存释放"的固定流程,你可以根据实际业务需求,将表格灵活拆分为独立文件。掌握这些技巧后,便能用简洁的代码替代繁琐的人工操作,轻松应对分发、归档与分批处理等场景,实现高效的自动化办公。