一、环境与结论先行
环境:Apple 芯片 Mac(macOS 26),Python 3.13,向量服务用 llama.cpp 起 Qwen3-Embedding-0.6B(Q8_0),只依赖标准库 + numpy,不用向量数据库(这个规模不需要)。
索引长这样:
| 项 | 值 |
|---|---|
| 笔记数 | 498 份 |
| 切片总数 | 8825 片 |
| 向量维度 | 1024 |
| 单片刻度 | 平均 390 字(范围 40 ~ 700) |
| 总字符 | 约 345 万 |
| 向量矩阵 | 36 MB(float32) |
先把结论放前面,后面逐条给实测:
- 无改动时 :复用 497 份文件、重编 0 片 、墙钟 1.35 s ,产出与上一版字节级一致;
- 全量重建 :重编 8825 片 、墙钟 434.7 s ------ 两者相差 322 倍;
- 重编出来的向量不可复现 :同样的输入重算一遍,
max|Δ| = 2.8e-4,完全相同的元素只占 76%; - 但检索结果完全可复现:重建前后同一 query 的 Top-3 完全一致。
- 检索端到端 0.14 ~ 0.16 s (含查询编码 + 加载矩阵);纯余弦计算 0.153 ms。
二、增量怎么做:先能"识别没变过的文件"
整件事的前提是:你得能低成本地回答"这个文件自上次索引后动过没有"。
最直接的办法是记下每个文件的 mtime + size ,写进一份清单(index_manifest.json):
json
{
  "built_at": "2026-10-09T04:21:16",
  "model": "qwen3-embedding-0.6b",
  "files": {
    "笔记A.md": {"mtime": 1789180613, "size": 8260},
    "笔记B.md": {"mtime": 1789825245, "size": 7310}
  }
}
下一次重建时对照:
python
st  = f.stat()
key = {"mtime": int(st.st_mtime), "size": int(st.st_size)}
old = prev_manifest.get(rel)

if old and old["mtime"] == key["mtime"] and old["size"] == key["size"]:
    # 没变过 → 复用上一版的向量行
else:
# 变了 / 新文件 → 重新切片 + 重新编码同时还要能"把上一版的向量行按文件定位出来"。这依赖一个前提:同一个文件的切片在矩阵里是连续的 (因为写入时就是按文件顺序追加的)。所以维护一张 rel → (起始行, 片数) 的映射:
python
def build_ranges(meta):
    ranges = {}
    for i, m in enumerate(meta):
        r = m["rel"]
        if r not in ranges:
            ranges[r] = [i, 0]
        ranges[r][1] += 1
    return ranges
有了它,"复用"就退化成一次内存里的行复制。
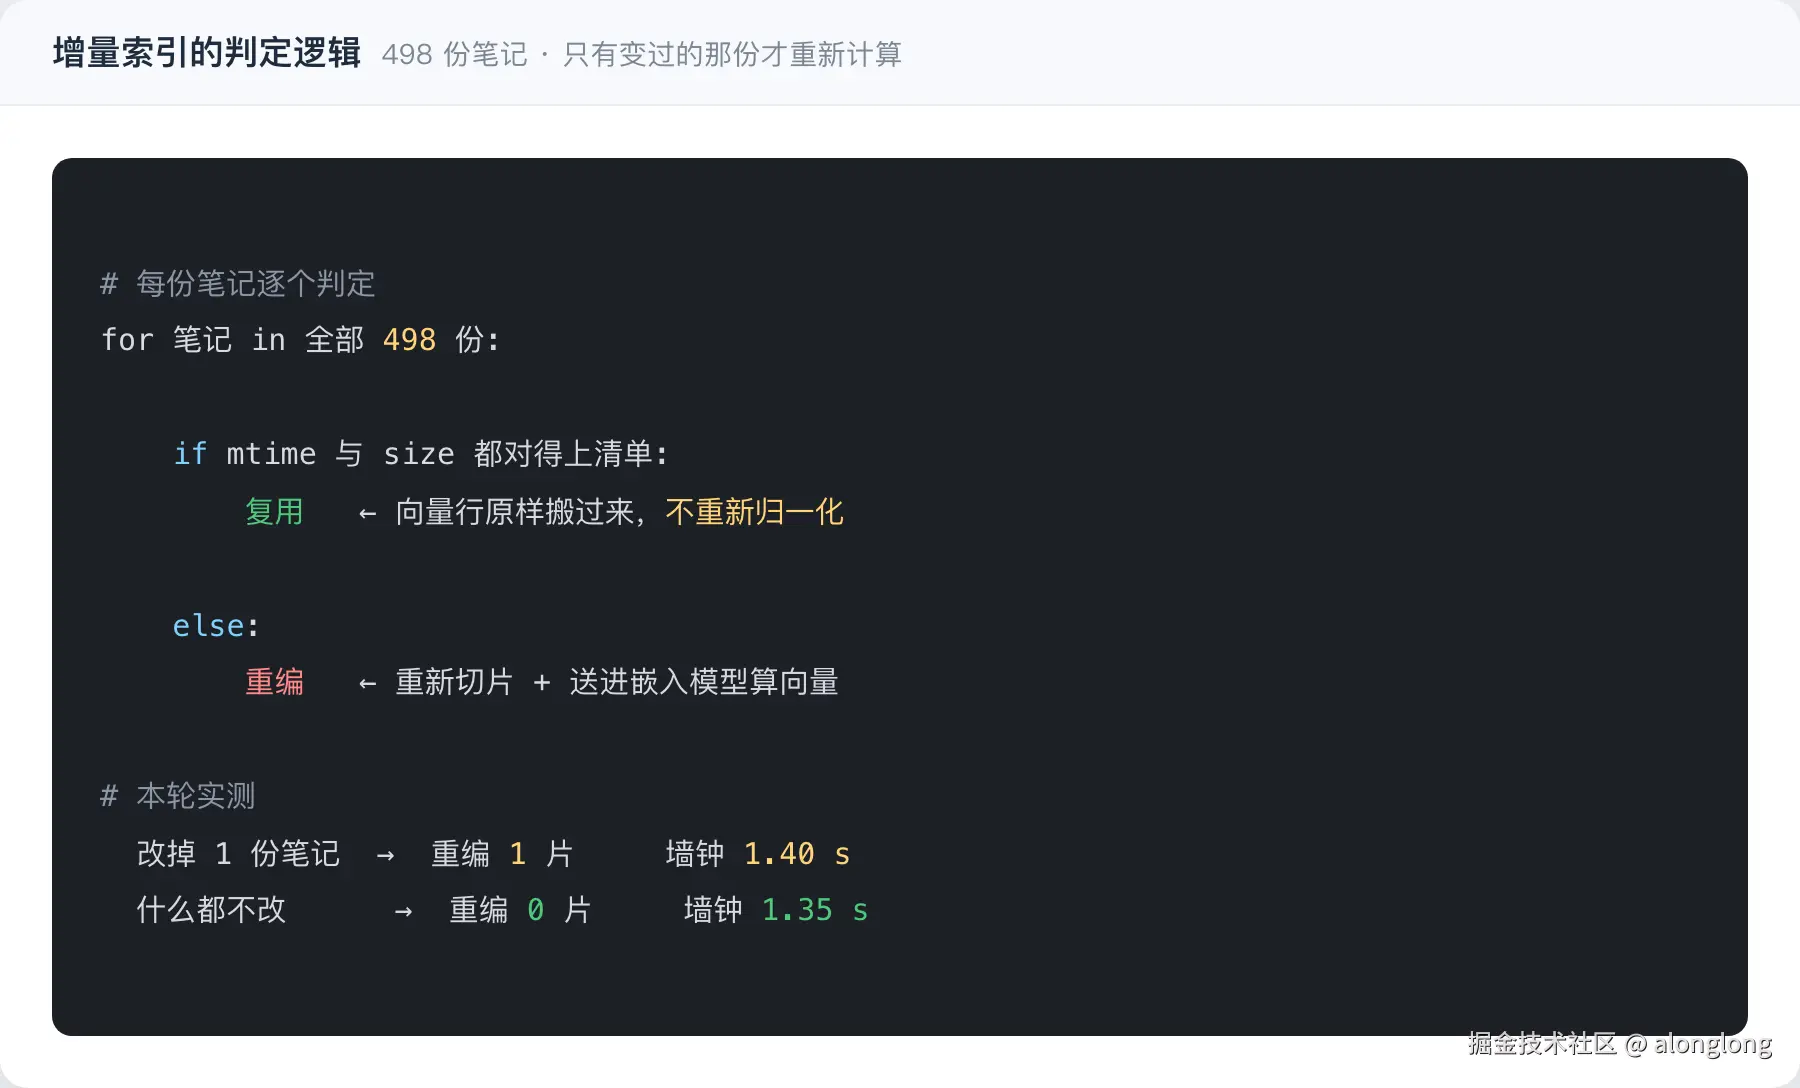
三、🔴 一个决定成败的细节:复用行不重新归一化
这里有个坑,藏着整个方案的成败。
向量服务(llama-server)不做归一化,所以写索引前必须自己做 L2 归一化。那么"复用的行"要不要再归一化一次?
不要。原样搬。
python
mat = np.zeros((len(slots), dim), dtype=np.float32)
for i in reuse_slots:
    mat[i] = prev_mat[old_row[i]]        # ← 原样照搬,一个数都不碰

if new_slots:
    normed = l2norm(new_mat)             # 只有新编的才归一化
    for j, i in enumerate(new_slots):
mat[i] = normed[j]为什么这行注释值得单独拎出来讲------见第六节。一句话:归一化是浮点运算,只要重算,结果就可能和别人算的不一样;只有"不算",才能保证一致。
四、四条路径复现
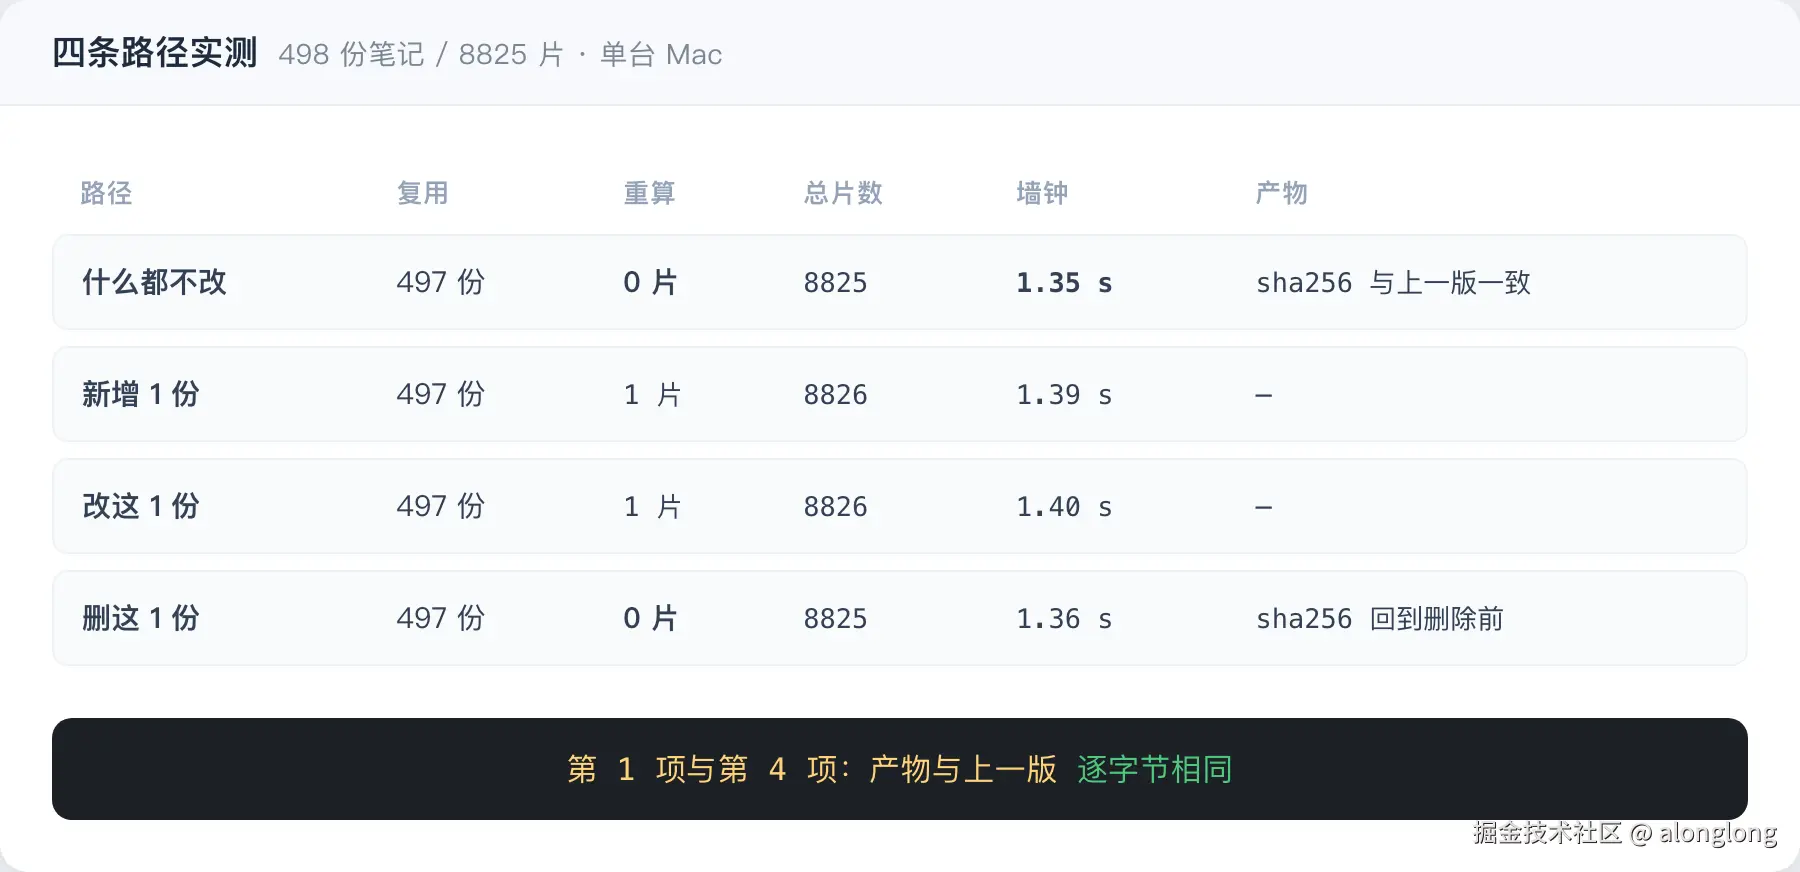
拿真实库跑四条路径,每次记录"复用多少 / 重算多少 / 花了多久":
| 路径 | 复用 | 重算 | 总片数 | 墙钟 | 产物 |
|---|---|---|---|---|---|
| 什么都不改 | 497 份 / 8825 片 | 0 片 | 8825 | 1.35 s | sha256 与上一版一致 |
| 新增 1 份笔记 | 497 份 | 1 片 | 8826 | 1.39 s | --- |
| 修改这 1 份 | 497 份 | 1 片 | 8826 | 1.40 s | --- |
| 删除这 1 份 | 497 份 | 0 片 | 8825 | 1.36 s | sha256 回到删除前 |
 复现命令(
rag-ask.sh / rag-build.sh 会自己起停向量服务):
bash
# 无改动(不需要服务,因为一片都不会编)
python3 rag-index.py

# 造一个临时笔记 → 增量
printf '# 临时笔记\n\n用于验证增量重建的段落。\n' > "$VAULT/临时测试.md"
python3 rag-index.py          # 应只重编这 1 份

# 删除它 → 再增量
rm "$VAULT/临时测试.md"
python3 rag-index.py          # 应删除 1 份,且 sha 回到基线
两条值得单独说的:
- 第一行 :脚本从头到尾一片都没编,1.35 秒跑完,产物与上一版逐字节相同 。这不是"数值接近",是
sha256相等。 - 第四行 :删掉新增的文件,索引回到删除之前的状态------片数对、字节也对。删除路径没有留下残留行。
另外注意一个数字:498 份笔记,但"复用"只报了 497 份。 差的那 1 份是在切片阶段就被静默跳过了 (切不出长度达标的片段,代码里是一句 continue)。日志只有一行提示,不影响退出码。这个我留在最后一节说。
五、全量 vs 增量:434.7 s vs 1.35 s
同一批内容,两种走法:
| 需编码片数 | 墙钟 | |
|---|---|---|
| 增量(无改动) | 0 | 1.35 s |
| 增量(改 1 份笔记) | 1 | 1.40 s |
| 全量重建 | 8825 | 434.7 s |
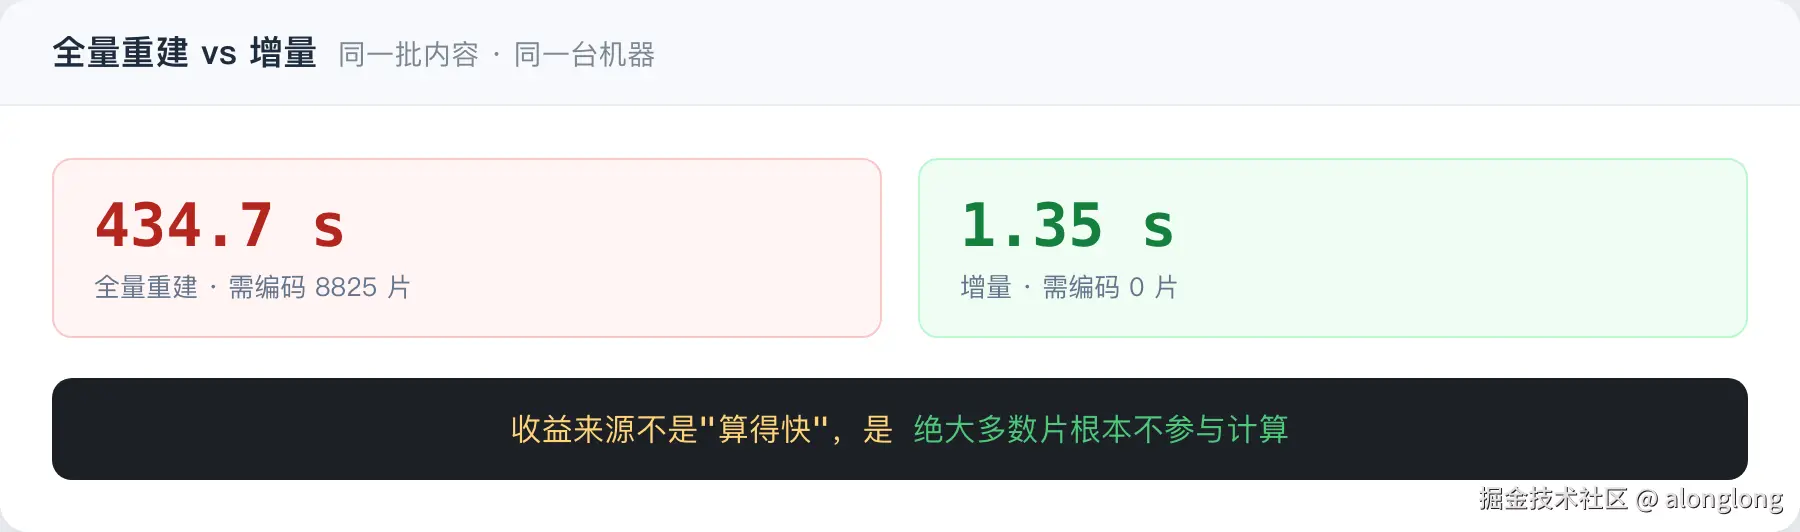 322 倍。 这个收益的来源不是"算得快",是绝大多数片根本不参与计算。
六、🔴 关键发现:重编出来的向量,是不可复现的
这是这轮最有意思的一条。我本以为"同样的输入 + 同样的模型 + 同样的参数,重算一遍应该得到同样的矩阵"。实测:不一样。
我记下当前矩阵的 sha256,强制 --full 全量重建,再取一次 ------ 指纹变了。把两份矩阵逐元素相减:
| 指标 | 值 |
|---|---|
| 形状 | 两次都是 (8825, 1024) |
| max |Δ| | 2.792 × 10⁻⁴ |
| 平均 |Δ| | 4.800 × 10⁻⁶ |
| 完全相同的元素占比 | 75.89 % |
也就是说,四分之一以上的数字变了 ------ 变得极小,但确实在变。
那检索会受影响吗?同一 query 重建前后各查一次:
Top-3 完全一致,连相似度分数都没变。
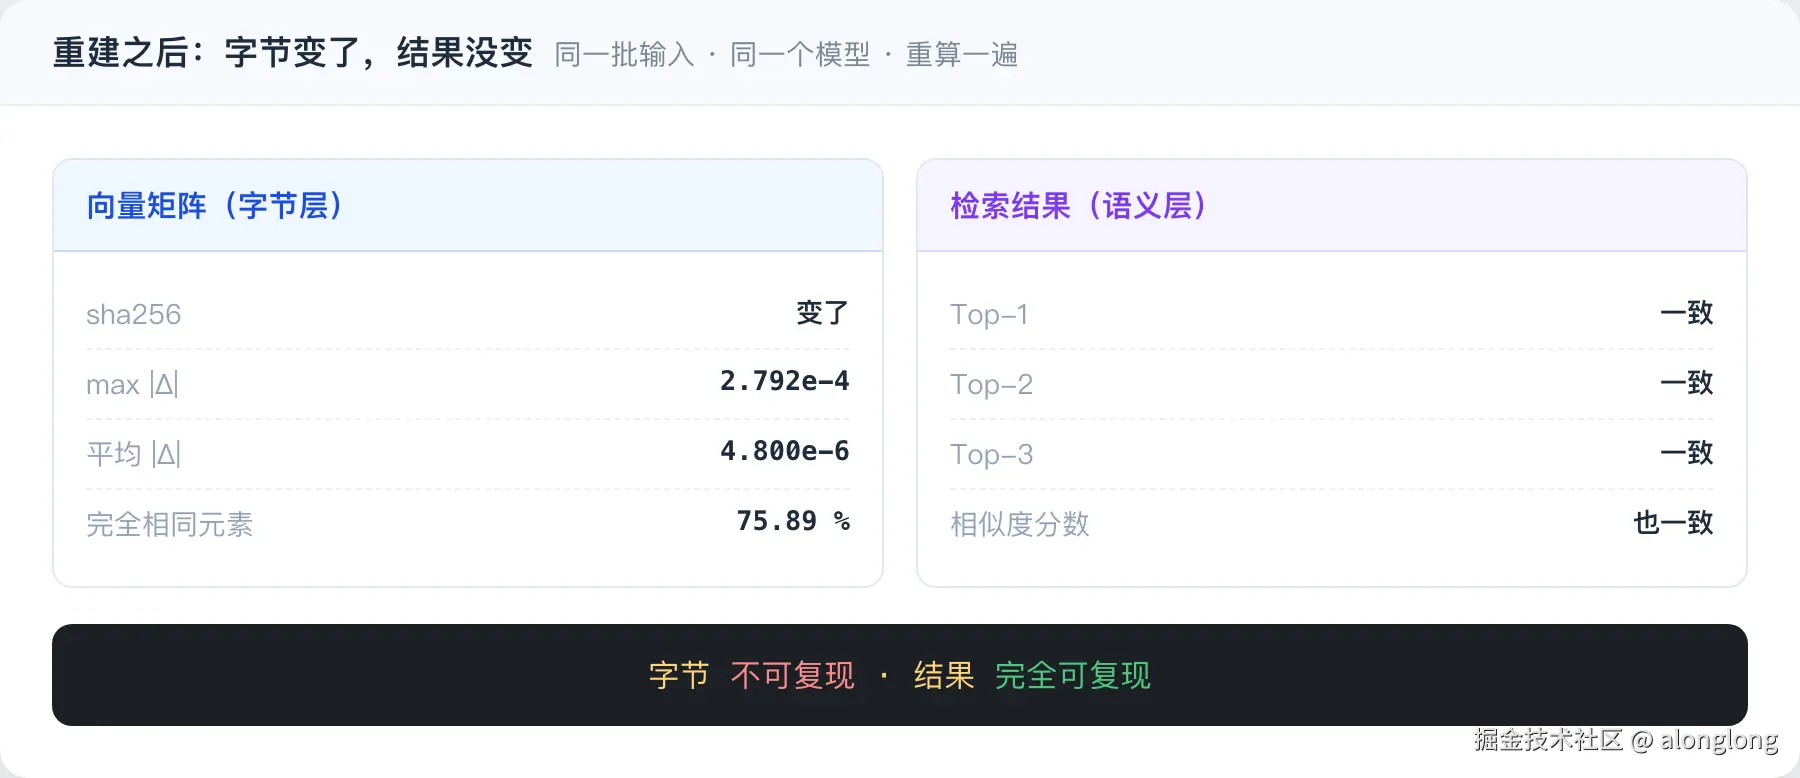 我的理解:
- 向量不可复现。模型内部是浮点并行运算,批处理的切分与调度只要有一点差别,末位就会漂。这是模型的属性,不是 bug。
- 但"漂"不影响排序 。
2.8e-4这个量级,改不动"哪几片最像"。 - 结论:不要用 hash 判断"内容有没有变"。 它会告诉你"变了",然后把你引向一个不存在的问题。
而这恰好回到第三节那个细节:"字节级一致"之所以能成立,是因为那些行根本没有被重算。 一旦把复用路径改成"搬过来再归一化一次",字节级一致会立刻消失,而检索结果依然正确------一个看起来没坏、实际已经悄悄退化的系统就是这么来的。
七、三个把我骗了的外推
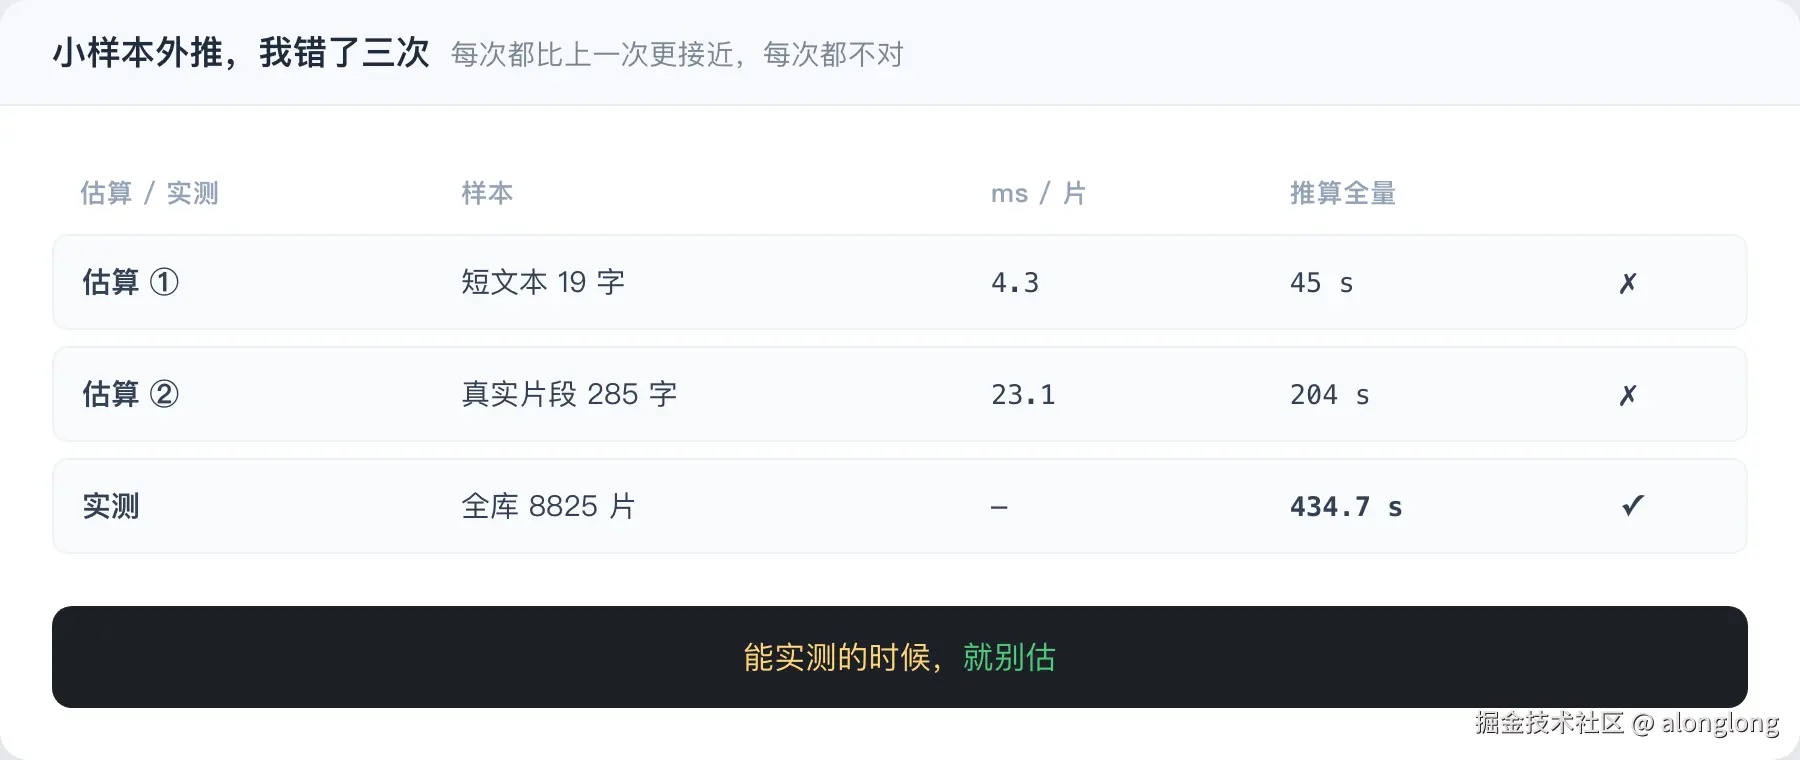
跑全量之前我想先估个时间。随手拿 200 片文本编了一次,得到"约 5 ms/片",推算:
8825 × 5 ms ≈ 45 秒
实测 434.7 秒。差 9.7 倍。
查因,三个假设:
假设一:批大小。 把批大小从 16 加到 512 重测:
| 批大小 | 总耗时(512 片) | ms/片 | 片/秒 |
|---|---|---|---|
| 16 | 2.70 s | 5.3 | 189 |
| 64 | 2.59 s | 5.1 | 198 |
| 128 | 2.56 s | 5.0 | 200 |
| 512 | 2.55 s | 5.0 | 201 |
吞吐几乎不变。假设一,错。
假设二:文本长度。 我估时间用的那 200 片是随手造的短句(十几字),而真实片段平均 390 字。换成真实长度的片段重测:
| 样本 | 平均字数 | ms/片 |
|---|---|---|
| 短文本 | 19 | 4.3 |
| 真实片段 | 285 | 23.1 |
5.4 倍。找到主因了。
假设三:按真实长度重新外推。 23.1 ms × 8825 ≈ 204 秒。
实测 434.7 秒。还是差 2 倍。
到这里我停止猜测。剩下的两倍,可能是样本长度仍偏短(285 vs 全库 390),也可能是模型连跑七分钟后的降速------没有实测支撑,我不写结论。
教训 :小样本外推 在"样本与目标不同分布"时,可能错到没有参考价值。我错的三次分别错在样本太短 → 还是短 → 说不清。能实测就别估。
八、复现清单
| 文件 | 行数 | 职责 |
|---|---|---|
rag-index.py |
380 | 切片 + 编码 + 增量判定 + 落盘 |
rag-search.py |
90 | 查询编码 + 余弦 top-k |
rag-build.sh |
46 | 起向量服务 → 跑索引 → 停服务 |
rag-ask.sh |
42 | 日常检索入口(自动确保服务在跑) |
rag-inc-test.sh |
73 | 四条路径的端到端测试 |
关键 CLI:
bash
python3 rag-index.py            # 增量(默认)
python3 rag-index.py --full     # 忽略清单,全量重建
python3 rag-index.py --dry-run  # 只算切片与增量差异,不调模型
python3 rag-index.py --adopt    # 迁移用:把当前文件状态当作已索引
几个实现上的注意点:
- 复用路径原样搬行,绝不重新归一化------这是"未变更时字节级一致"的根因;
- 新旧维度不一致必须退全量(换了模型就会触发),否则拼出来是个坏矩阵;
--dry-run不调模型,用来在改代码后快速验证切片与增量判定,很省时间;llama-server起服务的头两秒/health已就绪但模型可能仍在加载,首个编码请求要带重试,否则会拿到错误体。
九、还没解决的问题
脚本在切片阶段会静默跳过 那些"切不出有效片段"的笔记------本轮 498 份里有 1 份被跳过,日志只有一行提示,且不影响退出码。
危险的地方在于:"少索引了一份笔记"和"这份笔记本来就该被跳过",在产物上长得一模一样。 没有断言、没有非零退出码,它就会一直安安静静地错下去。
这个我没在这轮修,先记下来。