📚 系列文章
- 第一篇:从零构建微信小程序安全扫描器
- 第二篇:深入浅出:如何用 Python 实现一个小程序污点分析引擎(本文)
- 第三篇:待更新
这事我做 miniapp-scanner(一个微信小程序安全扫描器)时,实现污点分析引擎的完整记录。文章会从原理讲到代码实现,包含 6 个核心模块的详细拆解。读完你也能写出一个简化版。
一、为什么需要污点分析
1.1 传统静态分析的局限
普通静态扫描器只会"看到危险函数就报警":
javascript eval(x); // 报警:用了 eval
问题是:x 是用户输入还是硬编码常量?
a、 eval("console.log(1)") ------ 硬编码,安全 b、 eval(userInput) ------ 用户可控,危险
普通扫描器分不清这两者 ------ 会产生大量误报。
1.2 污点分析的思路
污点分析 = 追踪"用户输入"经过的每一次赋值、拼接、函数调用,看它最终是否流到了"危险函数"。
核心概念:
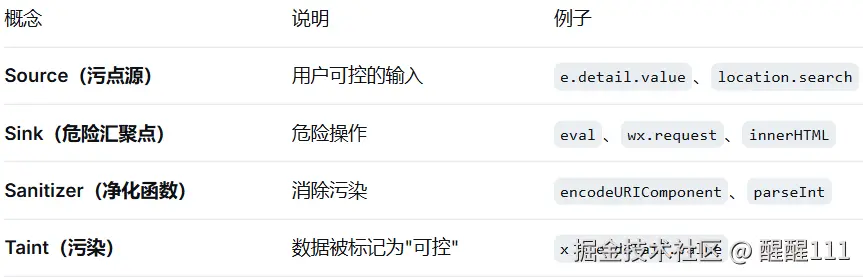
污点分析的输出:
🔴 用户输入 → eval 污点路径: e.detail.value (用户可控) → 存入变量 x → 传入 eval 这比"检测到 eval"精准得多。
二、整体架构
miniapp-scanner 的污点分析引擎由 6 个模块组成:
┌───────────────────────────────────────── │ 1. JS 解析器 (js_parser.py)
│ esprima → AST + 常量折叠
├───────────────────────────────────────── │ 2. 别名追踪 (alias_tracker.py)
│ 并查集 + 对象属性图
├───────────────────────────────────────── │ 3. 跨文件模块图 (module_graph.py)
│ require/exports 解析
├───────────────────────────────────────── │ 4. 污点分析器 (taint_analyzer.py)
│ 表达式求值 + 传播规则 + sink 匹配
├───────────────────────────────────────── │ 5. 规则库 (taint.yaml)
│ sources / sinks / sanitizers
├───────────────────────────────────────── │ 6. 报告生成 (scanner.py)
│ 格式化输出 + 污点路径
└─────────────────────────────────────────
下面逐个拆解: 三、JS 解析器 + 常量折叠
3.1 用 esprima 解析
import esprima
def parse_js(source): tree = esprima.parseScript(source, {"loc": True, "tolerant": True}) return tree.toDict() # 转成 dict,便于遍历
输入:const a = 1;
输出: { "type": "Program", "body": { "type": "VariableDeclaration", "declarations": \[{ "type": "VariableDeclarator", "id": {"type": "Identifier", "name": "a"}, "init": {"type": "Literal", "value": 1} } }] }
3.2 常量折叠(反混淆)
攻击者常用"字符串拼接"绕过静态检测:
window"ev" + "al"; // 实际上就是 window.eval()
常量折叠:在 AST 层面把 "ev" + "al" 合并为 "eval"。
def fold_constants(node): if isinstance(node, list): return fold_constants(n) for n in node if not isinstance(node, dict): return node
css
for k, v in list(node.items()):
    node[k] = fold_constants(v)

t = node.get("type")

# "ev" + "al" → "eval"
if t == "BinaryExpression" and node.get("operator") == "+":
    l, r = node.get("left"), node.get("right")
    if (l and l.get("type") == "Literal" and isinstance(l["value"], str)
        and r and r.get("type") == "Literal" and isinstance(r["value"], str)):
        return {"type": "Literal", "value": l["value"] + r["value"]}

# 计算成员访问:window["eval"] → window.eval
if t == "MemberExpression" and node.get("computed"):
    prop = node.get("property")
    if prop and prop.get("type") == "Literal" and isinstance(prop["value"], str):
        node["computed"] = False
        node["property"] = {"type": "Identifier", "name": prop["value"]}

return node

**效果**:| 原代码 | 折叠后 |
|---|---|
"ev" + "al" |
"eval" |
window["eval"] |
window.eval |
abc${"def"} |
"abcdef" |
四、别名分析:并查集
4.1 问题:变量别名
const a = userInput; const b = a; const c = b; eval(c); // c 污染吗?
如果不处理别名 ------ 只能追踪"直接赋值",c 就断了。
4.2 方案:并查集
并查集(Union-Find) 维护"变量等价类" ------ a、b、c 归入同一组。
class UnionFind: def init(self): self.parent = {}
python
def find(self, x):
    if x not in self.parent:
        self.parent[x] = x
        return x
    # 路径压缩
    root = x
    while self.parent[root] != root:
        root = self.parent[root]
    while self.parent[x] != root:
        self.parent[x], x = root, self.parent[x]
    return root

def union(self, a, b):
    ra, rb = self.find(a), self.find(b)
    if ra != rb:
        self.parent[ra] = rb
4.3 别名追踪器
class AliasTracker: def init(self): self.uf = UnionFind() self.tainted = {} # 代表元 → 污点路径 self.obj_props = {} # "obj.prop" → 污点路径
python
def record_alias(self, lhs, rhs):
    """const lhs = rhs"""
    self.uf.union(lhs, rhs)

def set_taint(self, name, trace):
    """标记 name 污染"""
    self.tainted[self.uf.find(name)] = trace

def get_taint(self, name):
    """查询 name 是否污染"""
    return self.tainted.get(self.uf.find(name))
4.4 效果
const a = userInput; // set_taint("a", ...) const b = a; // record_alias("b", "a") const c = b; // record_alias("c", "b") eval(c); // get_taint("c") → 返回 a 的污点 ✅
c 通过并查集归到了 a 所在的等价类** ------ 污点跟着等价类走。
五、表达式求值:核心逻辑
5.1 递归求值
求值一个表达式,返回"污点路径"或 None:
def _eval_expr(self, node, file_path): if not node: return None t = node.get("type")
ini
# 字面量:不污染
if t == "Literal":
    return None

# 标识符:查别名追踪器
if t == "Identifier":
    return self.aliases.get_taint(node["name"])

# 成员访问:e.detail.value
if t == "MemberExpression":
    full = self._member_name(node)
    if self._is_source_member(full):     # 命中 source
        return [f"读取 {full}(用户可控)"]
    return self._eval_expr(node.get("object"))

# 函数调用
if t == "CallExpression":
    return self._eval_call(node, file_path)

# 字符串拼接
if t == "BinaryExpression" and node["operator"] == "+":
    l = self._eval_expr(node.get("left"))
    r = self._eval_expr(node.get("right"))
    if l or r:
        return (l or []) + (r or []) + ["字符串拼接"]

# ... 其他类型
return None
5.2 例如
e.detail.value:
MemberExpression ├── object: MemberExpression │ ├── object: Identifier "e" │ └── property: Identifier "detail" └── property: Identifier "value"
流程:
full = "e.detail.value"_is_source_member("e.detail.value")→ True- 返回
["读取 e.detail.value(用户可控)"]
"abc" + userInput:
BinaryExpression ├── operator: "+" ├── left: Literal "abc" └── right: Identifier "userInput"
流程:
_eval_expr(left)→ None(字面量)_eval_expr(right)→["读取 userInput..."]- 返回
[...] + ["字符串拼接"]
六、跨文件追踪
6.1 问题
// pages/index.js const { request } = require("../../utils/request"); request("/api?id=" + id, {}); // 跨文件了
// utils/request.js function request(url, data) { return wx.request({ url: url, data: data }); // sink 在这里 }
如何让 id 的污染"跨文件"传到 wx.request?
6.2 模块图
构建依赖图:
class ModuleGraph: def init(self, root): self.modules = {} # 文件路径 → {imports, exports, functions} self._build()
ruby
def _build(self):
    for js in root.rglob("*.js"):
        tree = parse_js(js.read_text())
        self.modules[rel_path] = self._extract(tree)

def _extract(self, tree):
    info = {"imports": {}, "exports": {}, "functions": {}}
    # 遍历:收集函数定义、require、module.exports
    ...
    return info
提取的信息:
{ "pages/index.js": { "imports": {"request": ("utils/request.js", "request")}, ... }, "utils/request.js": { "exports": {"request": <AST 节点>}, "functions": {"request": <AST 节点>} } }
6.3 跨文件追踪
在 _eval_call 里:
def _try_cross_file(self, callee, args, file_path): # 1. 看 callee 是否是导入的函数 imports = self.registry.get_imports(file_path) target_info = imports.get(callee_name) # ("utils/request.js", "request") if not target_info: return None
python
target_file, export_name = target_info
fn_node = self.registry.get_function(target_file, export_name)
if not fn_node:
    return None

# 2. 收集污点实参
tainted_args = [(i, tr) for i, a in enumerate(args)
                if (tr := self._eval_expr(a, file_path))]
if not tainted_args:
    return None

# 3. 跳进目标函数体,把污点实参传给形参
self._enter_cross_file_fn(fn_node, tainted_args, target_file)
效果:
污点路径: → onLoad 的参数 options(用户可控) → 读取 options.id(用户可控) → 字符串拼接 → 跨文件传入 utils/request.js::url ← 关键 → 经 wx.request() 传递
七、链式方法调用传播
7.1 问题
const userInput = location.search.slice(1); // slice() 之后污染还在吗? eval(userInput);
location.search 是 source ------ 但 .slice(1) 是方法调用 ------ 返回值是否污染?
默认实现会断链 ------ 因为 slice 既不是 sink 也不是 source。
7.2 修复
在 _eval_call 里加:
def _eval_call(self, node, file_path): callee = node.get("callee", {}) callee_name = self._member_name(callee) or callee.get("name", "") args = node.get("arguments", \[\])
python
# 1. sink 检查
sink = self._find_sink(callee_name)
if sink:
    ...

# 2. 对象方法调用传播
if callee.get("type") == "MemberExpression":
    obj = callee.get("object")
    obj_trace = self._eval_expr(obj, file_path)    # 检查 obj 是否污染
    if obj_trace:
        method = self._member_name(callee.get("property"))
        return obj_trace + [f"经 {method}() 方法调用传播"]

# 3. sanitizer 检查
if self._is_sanitizer(callee_name):
    return None

# 4. source 检查
if self._is_source_call(callee_name):
    return [f"调用 {callee_name}()(返回用户数据)"]

#
7.3 效果
污点路径: → 读取 location.search(用户可控) → 经 slice() 方法调用传播 ← 关键 → 存入变量 userInput → 传入 eval
同理,input.trim()、data.toString()、result.data.items 等链式访问都支持了。
八、控制流敏感
8.1 问题
const DEBUG = false; if (DEBUG) { eval(userInput); // 不可达代码 }
如果不看控制流 ------ 会误报。
8.2 方案:常量折叠 + 条件求值
维护一个"常量表" :
self.constants = {} # 变量名 → 常量值
遇到 const DEBUG = false ------ 记录 constants["DEBUG"] = False。
遇到 if 语句:
def _handle_if(self, node, file_path): cond = self._eval_condition(node.get("test")) if cond is True: self._exec_stmt(node.get("consequent")) # 走 then elif cond is False: if node.get("alternate"): self._exec_stmt(node"alternate") # 走 else else: # 未知:两个分支都分析 self._exec_stmt(node.get("consequent")) if node.get("alternate"): self._exec_stmt(node"alternate")
_eval_condition:
def _eval_condition(self, test): if test.get("type") == "Literal": return bool(test.get("value")) if test.get("type") == "Identifier": v = self.constants.get(test.get("name")) return None if v is None else bool(v) # ... 支持 !、==、<、> 等 return None
8.3 效果
const DEBUG = false; if (DEBUG) { eval(userInput); // 被跳过,不报 }
九、常见坑
9.1 变量作用域
let x = userInput; function f() { let x = "safe"; // 内层 x 覆盖外层 eval(x); // 应该报吗? }
不应该 ------ 内层 x 是 safe。
方案:函数作用域快照 ------ 进入函数前 snapshot(),退出后 restore() 。
9.2 净化函数短路
const x = encodeURIComponent(userInput); eval(x); // 应该报吗?
不应该 ------ 已被净化。
方案:遇到 sanitizer ------ 参数求值(副作用),但返回值 None。
if self._is_sanitizer(callee_name): for a in args: self._eval_expr(a, file_path) # 触发副作用 return None # 返回干净
9.3 性能
问题:每个文件解析 AST 两次(一次 ModuleGraph,一次扫描)。
方案:加缓存。
_PARSE_CACHE = {}
def parse_js(source): if source in _PARSE_CACHE: return _copy_tree(_PARSE_CACHEsource) tree = esprima.parseScript(source) _PARSE_CACHEsource = tree return _copy_tree(tree)
十、实战效果
用 miniapp-scanner 扫一个真实小程序(noodle_shop,52 文件 / 5774 行):
🔴 1 Sensitive data stored in local storage (high) 📍 pages/authorize/index.js:115 📄 wx.setStorageSync('token', ...)
🔴 2 wx.requestPayment with tainted amount (high) 📍 utils/pay.js:34 📄 wx.requestPayment(tainted)
🟡 3 污点传播: 用户输入 → wx.navigateTo (low) 📍 pages/category/category.js:111 🧬 污点路径: → 读取 e.currentTarget.dataset.id(用户可控) → 字符串拼接
从 30 条误报优化到 5 条真问题 ------ 降噪 83%。
十一、开源地址
- GitHub: github.com/lathuninh/m...
- PyPI: pypi.org/project/min...
- 第一篇: 从零构建微信小程序安全扫描器
欢迎 Star / Issue / PR。
十二、总结
污点分析不难,难在细节:
- 源、汇聚点、净化函数 ------ 定义清楚
- 传播规则 ------ 赋值、拼接、方法调用、跨文件
- 别名分析 ------ 并查集解决间接传播
- 常量折叠 ------ 反混淆
- 控制流 ------ 减少误报
- 缓存 ------ 性能优化
用 Python + esprima 完全可以做一个可用的污点分析引擎 ------ 我这个引擎总共 800 行代码,覆盖了 70% 的常见场景。
关键不是代码多复杂,而是逻辑清晰、测试充分。
参考:
欢迎大家点评修正,不足之处,请大家谅解。