凌晨两点,MySQL CPU 飙到 100%:一次 IoT 数据写入链路重构复盘
设备规模从几十台增长到几千台以后,系统瓶颈往往不再是一条慢 SQL,而是数据进入系统后的整个链路设计。
本文以一次 IoT 数据写入故障演练为背景,复盘从故障现象、现场止血、根因定位,到最终的数据链路优化过程。
说明:本文中的业务场景、架构设计和排查方法来源于 IoT 平台生产环境实践总结,部分容量指标经过抽象处理,用于技术分析。
一、凌晨两点,为什么 MySQL 突然 CPU 100%?
凌晨两点,监控平台出现连续告警:
指标 正常 异常
MySQL CPU 30%左右 持续100% 接口响应时间 200ms左右 秒级 设备数据处理 正常 消息堆积 数据库连接 稳定 接近上限
同时出现:
- 实时大屏刷新延迟
- 历史曲线查询超时
- 部分设备消息重试
第一反应通常是:
- 有没有慢 SQL?
- 有没有异常查询?
- 数据库是不是配置不足?
但最终发现:
问题不是某一条 SQL,而是数据写入模型无法应对设备规模增长。
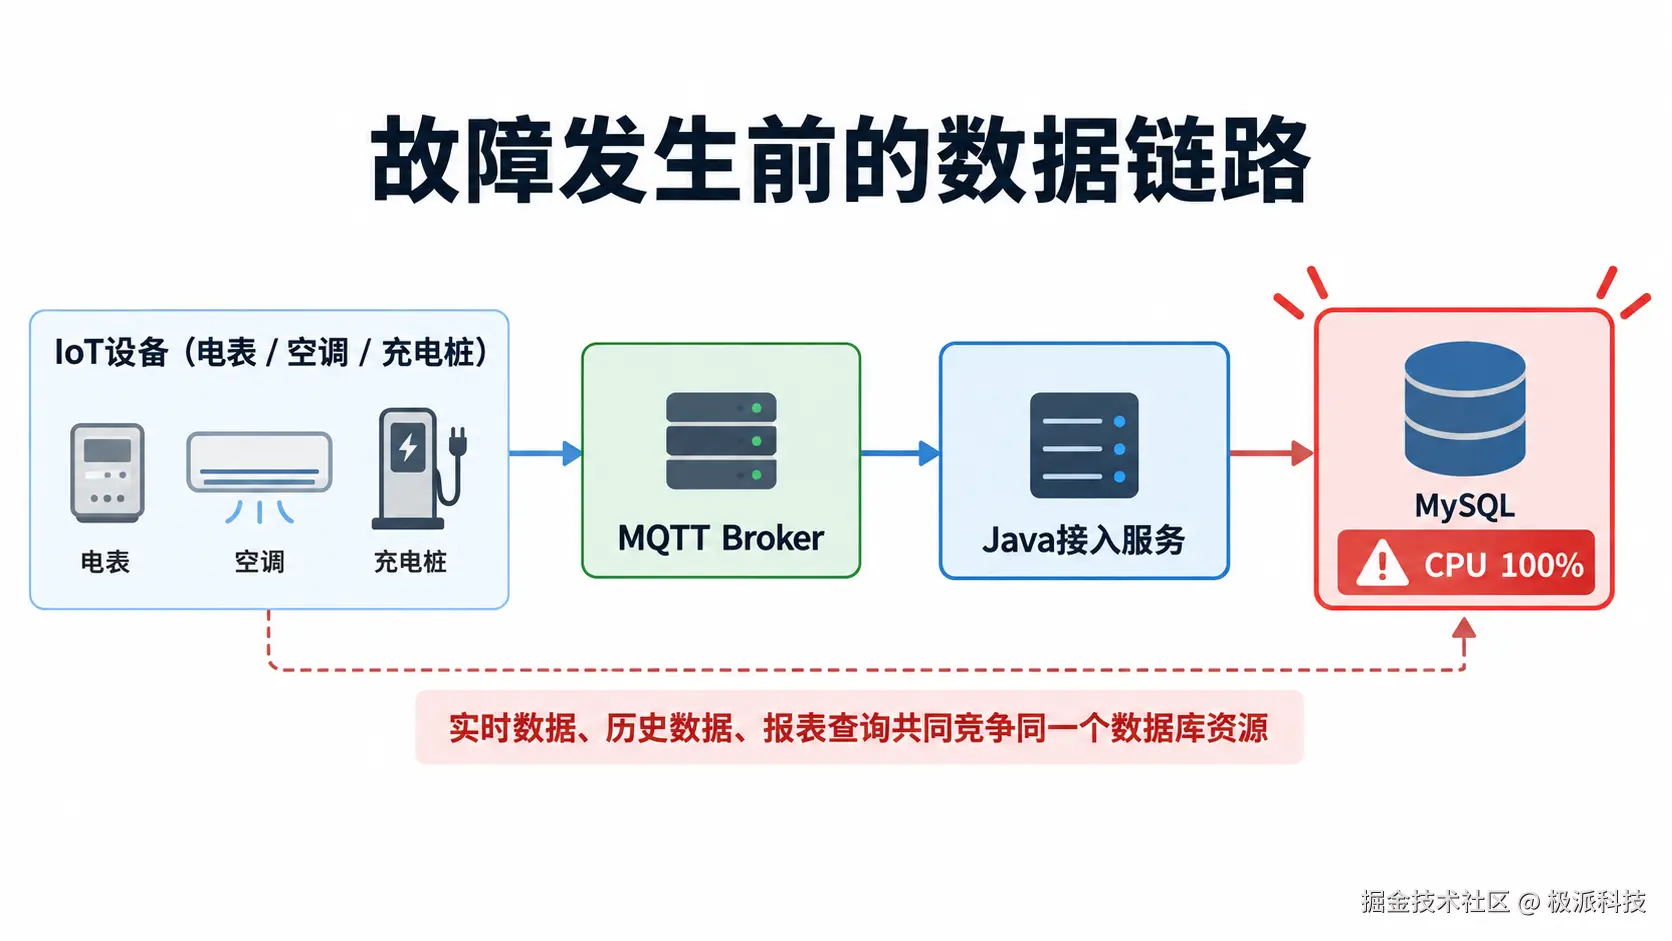
建议展示:
yaml
IoT设备
 电表 / 空调 / 充电桩
        |
        | MQTT
        ↓
 MQTT Broker
        |
        ↓
 Java接入服务
        |
        ↓
 MySQL

CPU 100%
标注:
实时数据、历史数据、报表查询共同竞争同一个数据库资源。
二、现场止血:先恢复服务,再定位原因
生产故障处理第一原则:
不要在系统已经失控时直接进行大规模改造。
当时优先处理:
1. 暂停非核心查询
停止凌晨批量统计任务。
历史曲线接口临时降级:
- 默认查询最近时间范围
- 避免扫描大量历史数据
2. 限制写入压力
接入层增加保护:
- 控制写库线程数量
- 限制单实例消费速度
- 避免数据库连接被快速占满
3. 观察恢复趋势
重点观察:
- MySQL CPU
- 写入延迟
- 消息堆积
- 数据库连接数
恢复稳定后,再开始根因分析。
三、排查过程:到底是谁把数据库压垮?
3.1 查看数据库现场
首先查看当前执行情况:
sql
SHOW PROCESSLIST;确认:
- 当前执行 SQL
- 活跃连接
- 是否存在大量阻塞
随后结合:
text
慢查询日志

performance_schema.events_statements_summary_by_digest

SHOW ENGINE INNODB STATUS
分析:
- SQL执行次数
- 锁等待
- redo压力
- 事务提交情况
3.2 排查结果
1. 没有单条慢 SQL
慢查询中没有发现明显异常 SQL。
但是 SQL 模板统计发现:
大量请求集中在:
sql
INSERT INTO device_power_data问题不是:
"一条 SQL 太慢"。
而是:
"同一种写入方式被大量重复执行"。
2. 写入方式存在问题
原始链路:
sql
MQTT消息到达

↓

Java回调

↓

单条INSERT

↓

自动提交事务
每条数据都会产生:
- SQL执行
- 索引维护
- redo log
- binlog
- 事务提交成本
单次开销不大。
但是:
峰值流量下,累计成本非常明显。
3. 真正影响系统的是峰值,而不是平均值
例如:
5000台设备:
每10秒上报一次。
平均:
ini
5000 ÷ 10

= 500条/秒
这个量对于 MySQL 并不一定不可接受。
真正的问题在于:
设备集中上报
部分设备按照固定周期:
00秒
10秒
20秒
30秒
同时发送。
导致:
平均500条/s。
峰值可能达到数倍。
设备断线补传
网络恢复后:
设备缓存历史数据。
重新连接时:
大量历史数据瞬间补发。
最终形成:
diff
正常数据

+

补传数据

+

实时查询压力

↓

写入峰值
4. 查询任务进一步放大压力
凌晨统计任务同时执行。
例如:
查询设备历史数据:
sql
where device_id = ?
and create_time between ? and ?
即使存在联合索引:
scss
(device_id, create_time)长时间范围聚合仍然需要读取大量数据。
写入和分析查询共同竞争:
- CPU
- Buffer Pool
- IO
四、真正的问题:数据没有按照访问模式分层
很多系统优化第一反应:
- 升服务器
- 换数据库
- 加 CPU
但根因是:
实时状态、历史明细、业务数据,本质上不是同一种数据,却长期存放在同一个存储模型中。
五、数据规模增长后,需要重新设计数据链路
假设:
5000台设备。
10秒采集一次:
yaml
5000 × 8640

≈ 4320万条/天
一年:
约158亿条数据这已经属于典型时序数据场景:
- 高频写入
- 时间范围查询
- 数据持续增长
- 历史数据访问频率降低
六、方案选择:不是换数据库,而是数据分层
方案 适合场景
MySQL扩容 短期应急 MySQL分区+归档 中小规模过渡 分库分表 业务库水平扩展 消息缓冲+时序数据库 IoT时序数据场景
最终采用:
diff
消息缓冲

+

数据分层
七、优化后的 IoT 数据架构
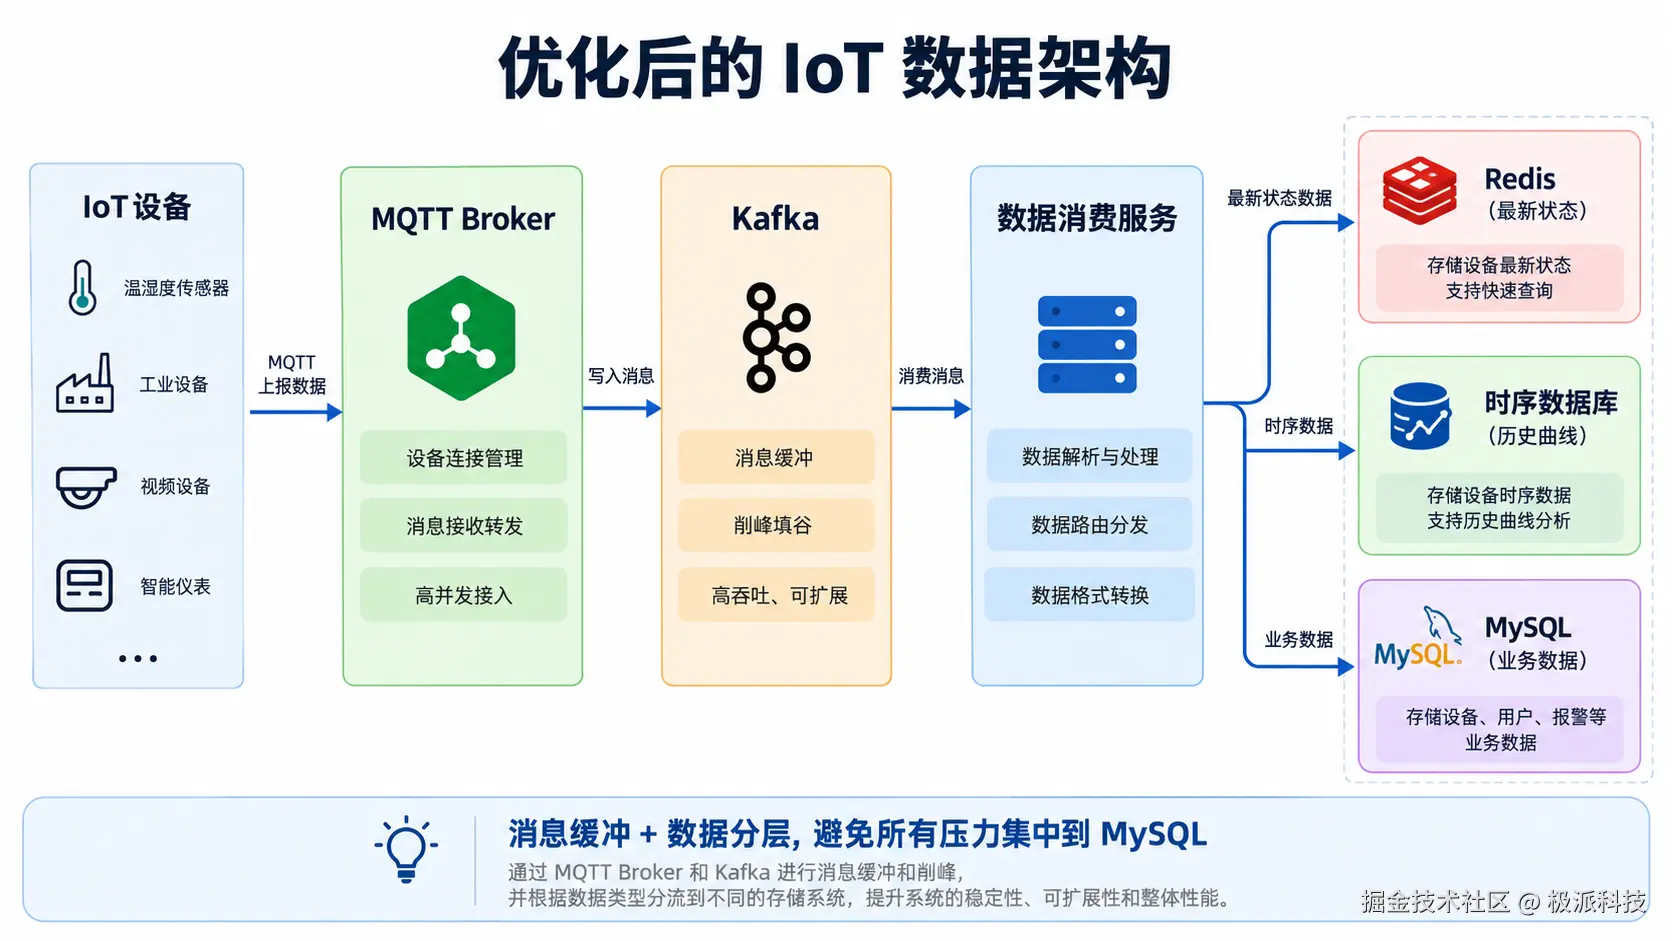
markdown
IoT设备

↓

MQTT Broker

↓

Kafka

↓

数据消费服务

├── Redis
│   最新状态
│
├── 时序数据库
│   历史曲线
│
└── MySQL
    业务数据
为什么 MQTT 后还需要 Kafka?
MQTT主要解决:
- 设备连接
- 协议接入
- 消息传输
Kafka解决平台内部的数据流转:
- 削峰
- 消息回放
- 多消费者
- 水平扩展
例如:
同一份设备数据:
可以被:
- 告警服务
- 数据存储服务
- AI分析服务
分别消费。
八、关键优化实现
1. 批量写入
不要:
java
insert(data);
insert(data);
insert(data);
改成:
java
batchInsert(list);批量提交。
同时开启:
ini
rewriteBatchedStatements=true否则 JDBC 驱动可能仍然逐条发送。
批次建议:
500~1000条

或者

200ms触发一次
2. 数据幂等
消息系统通常采用:
At Least Once因此必须接受重复消费。
例如:
设备数据:
device_id + collect_time建立唯一约束。
重复消息:
直接覆盖或忽略。
3. Redis保存实时状态
大屏只关心:
- 当前功率
- 在线状态
- 最新采集时间
例如:
json
{
 "deviceId":"001",
 "power":235.6,
 "status":"online",
 "timestamp":1760205600000
}
在线状态:
通过 TTL 判断。
4. 历史数据进入时序数据库
历史曲线特点:
- 写入多
- 查询时间范围
- 数据量大
适合:
- TDengine
- InfluxDB
- TimescaleDB
生产中通常:
原始数据:
↓
小时级聚合
↓
日报/月报
避免每次查询扫描海量明细。
九、迁移不是一次切换,而是逐步演进
推荐流程:
双写

↓

数据校验

↓

切换查询

↓

停止历史表写入

↓

迁移旧数据

↓

归档
避免一次性切换风险。
十、复盘总结
这次问题表面看:
是 MySQL CPU 100%。
但真正原因:
不是 MySQL 不够强。
而是:
数据规模增长后,系统仍然使用早期的数据处理方式。
IoT 平台随着设备增长,需要重新考虑:
- 数据如何进入系统
- 如何削峰
- 如何存储
- 如何查询
- 如何保证数据可靠
从几十台设备到几千台设备:
系统面对的已经不是 CRUD。
而是一整套数据处理架构。